Detectie van synthetische content & nepreviews

Geloofwaardige reviews kunnen nog steeds deel uitmaken van een gecoördineerde campagne.

Campaign Firewall laat zien hoe relatiebewijs een menselijke beoordelingsroute kan ondersteunen wanneer formulering alleen het patroon mist. Alle hier getoonde reviews en accountgeschiedenissen zijn synthetisch.

4 van de 15

Gemarkeerd door de lokale baseline op basis van alleen tekst

Gemodelleerde volledig menselijke campagne, dezelfde fixture

15 van de 15

Doorgestuurd voor menselijke beoordeling door het ensemble

Synthetische records, geen platformactie

105 accountparen

Gekoppeld via gedeelde productgeschiedenis

Relatiebewijs in hetzelfde cluster

Deze fixture-waarnemingen verklaren een ontwerpkeuze. Beide methoden gebruiken uit het corpus afgeleide tekstpercentielen, en de beoordelingsdrempel van het ensemble is afgestemd op dezelfde labels; dit zijn geen prestaties op ongeziene gegevens.

Een aannemelijk bericht laat de coördinatievraag open

Een merkbeschermingsteam moet weten waarom reviews gerelateerd lijken alvorens te beslissen wat te escaleren. Vloeiende formulering alleen kan niet aantonen dat accounts onafhankelijk handelden, en een negatieve mening alleen vormt geen bewijs van fraude.

Ons synthetische voorbeeld modelleert een campagne van 15 reviews op de vermelding van een concurrent. Elf records vertonen weinig stylometrische afwijkingen, maar hun overlappende productgeschiedenissen verbinden de accounts. De lokale baseline op basis van alleen tekst markeert vier van de 15; het ensemble stuurt alle 15 door voor beoordeling.

Die route behoudt onzekerheid. Het gemodelleerde volledig menselijke label is de grondwaarheid van de fixture, geen bewijs dat echte mensen deze reviews schreven of dat iemand werd betaald.

Scoor de signalen, licht vervolgens de bevinding toe

Combineer vier signaalfamilies

Schrijfpatronen, accountgedrag, piektiming en accountrelaties dragen bij aan een gemaximeerde heuristische score. De fixture modelleert 90 dagen geschiedenis; de temporele detector onderzoekt piekvensters van 72 uur. De score is geen gekalibreerde waarschijnlijkheid.

Vereis een accountrelatie

Gedeelde apparaten of voldoende overlappende productgeschiedenissen creëren graaf-edges. Productoverlap vereist ten minste 0,5 Jaccard-overeenkomst binnen dezelfde vermelding en niet meer dan 72 uur tussen records. Timing alleen creëert geen koppeling.

Houd de route inspecteerbaar

Samenhangende componenten worden campagneclusters wanneer omvang en cohesie voldoen aan geconfigureerde regels. Deterministische scoring wijst CLEAR, REVIEW of gemodelleerde AUTO-geschiktheid toe voordat een narratief wordt geschreven. REVIEW blijft een route voor menselijk oordeel, geen afgerond onderzoek.

Behoud bewijs achter het proza

Het vastgelegde onderzoek speelt een gecachte Codex-respons af na scoring. Een deterministisch filter controleert getallen, token-overlap en oordeelomkeringen; het stelt niet elke behouden zin vast als waar. JSON behoudt campagnelidmaatschap, numerieke componentscores en een niet-ingediend geschilconcept. Afdrukbare HTML toont het campagneprofiel, signaalnamen per review en het concept; het toont geen numerieke componentuitsplitsingen.

De graaf maakt gebruik van interpreteerbare clustering via samenhangende componenten. Er is geen getraind grafisch neuraal netwerk of productieplatformintegratie geïmplementeerd in deze demonstratie.

Volg een reviewcampagne van signalen tot bewijs

Alle reviews, accountgeschiedenissen, apparaten en platformfeeds in deze feitelijke applicatiescreenshots zijn synthetisch. Het primaire voorbeeld volgt 15 gemodelleerde concurrentreviews van een campagnebevinding via een menselijke beoordelingsroute naar het geëxporteerde record.

Uitgewerkt voorbeeld: 15 aannemelijke reviews, één relatiepatroon

De fixture labelt deze casus als een volledig menselijke betaalde campagne, maar noch het auteurschap noch de betaling wordt vastgesteld door de detector. Elf van de 15 reviews hebben een stylometrische component van maximaal 4: weinig afwijking in het schrijfpatroon in deze implementatie. Hun accountgeschiedenissen vormen de reden om ze gezamenlijk te onderzoeken.
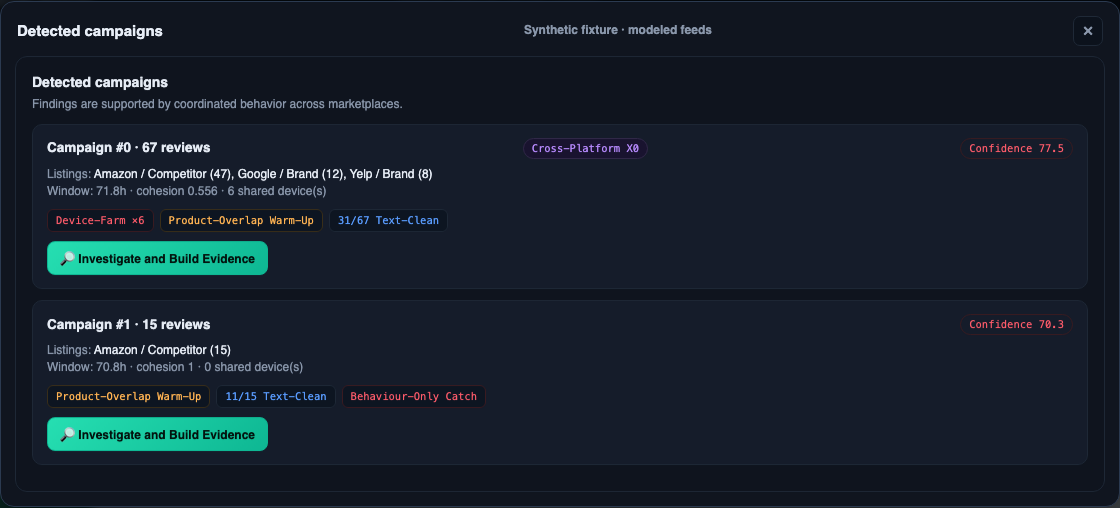
Twee synthetische campagnekaarten: een cross-platform cluster van 67 reviews en een productgeschiedeniscluster van 15 reviews.
De tweede kaart vat de casus van 15 reviews samen over 70,8 uur. Het gemiddelde betrouwbaarheidslabel is een heuristische score van 70,3/100, geen waarschijnlijkheid van fraude. Open de afbeelding voor inspectie op volledige grootte.

1. Inspecteer wat de accounts verbindt

De 15 reviews delen voldoende overlappende productgeschiedenissen op dezelfde vermelding binnen de geconfigureerde limiet van 72 uur. Dit creëert 105 productoverlap-paaredges, die elk paar in het cluster verbinden, met cohesie 1,0. Er zijn in deze casus geen edges van gedeelde apparaten; de bevinding is niet afhankelijk van apparaathergebruik. Timing alleen zou geen edge creëren.
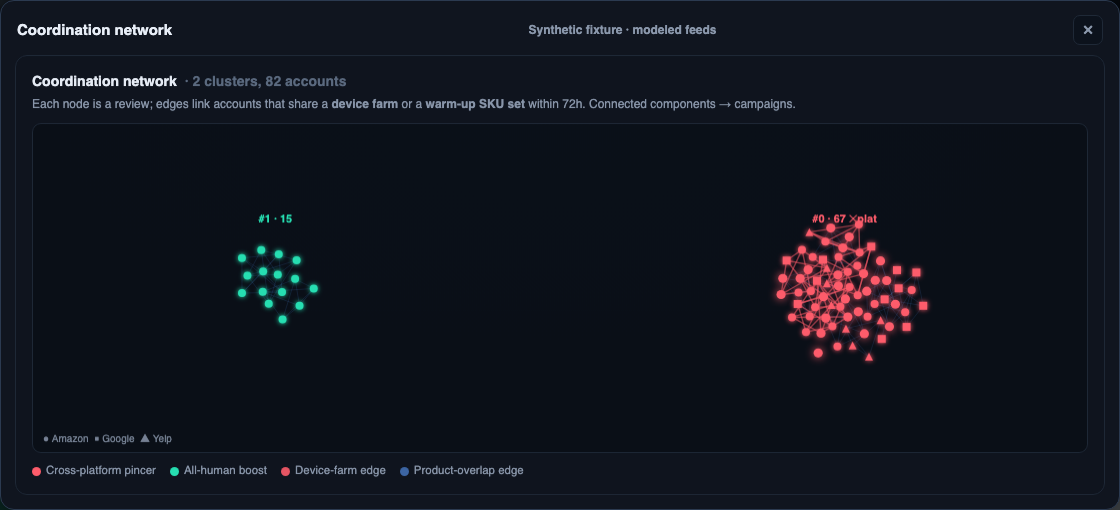
Coördinatiegraaf die afzonderlijke synthetische clusters van 15 reviews en 67 reviews toont met platformvormen.
De graaf toont twee clusters en een deelverzameling van hun edges. Elk knooppunt vertegenwoordigt een review; kleuren onderscheiden clusters, niet de routes CLEAR en REVIEW. Het groene cluster van 15 reviews wordt nog steeds naar REVIEW gerouteerd. Open de afbeelding voor inspectie op volledige grootte.

2. Vergelijk het tekstsignaal met de resulterende route

De lokale baseline op basis van alleen tekst markeert vier van de 15 records. Daarmee mist deze detectie op campagneniveau onder de regel van deze testomgeving dat ten minste 60% van een geplaatst label moet worden gemarkeerd. Het ensemble combineert schrijf-, gedrags-, timing- en netwerkcomponenten en stuurt alle 15 door naar REVIEW, in plaats van AUTO.

Wat de volledige synthetische casus van 15 reviews vaststelt
Bewijs of beslissingWaargenomen resultaatInterpretatie
Signaal voor schrijfpatroon11 van de 15 hebben stylometrische component maximaal 4Lage anomalie is geen certificaat van menselijk auteurschap.
Accountrelatie105 productoverlap-paaredges; geen edges van gedeelde apparatenEen gedeeld geschiedenispatroon ondersteunt het gezamenlijk onderzoeken van de accounts.
Lokale baseline op basis van alleen tekst4 van de 15 gemarkeerdDeze geïmplementeerde vergelijker mist de campagne onder de 60%-regel.
Ensembleroute15 REVIEW; 0 AUTOAlle 15 worden doorgestuurd voor menselijk oordeel. Er wordt geen review verwijderd.
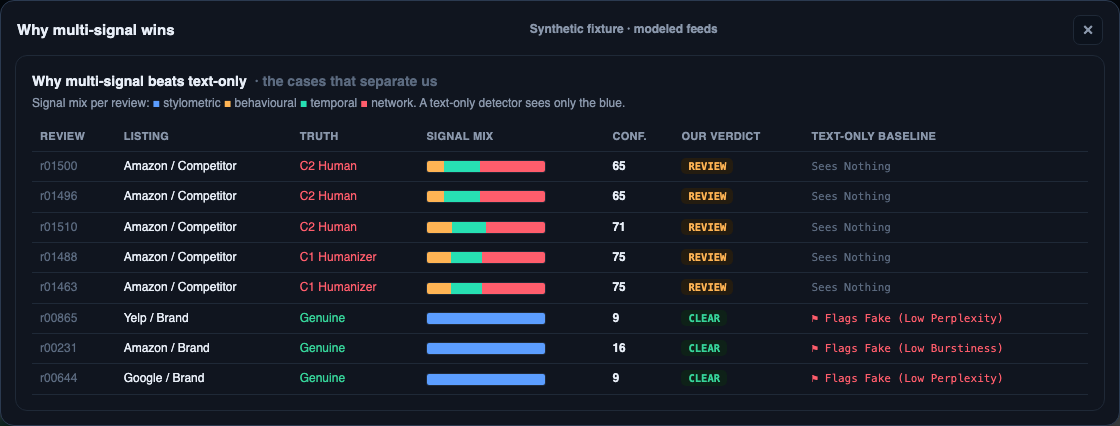
Acht geselecteerde synthetische reviewrijen die componentsignalen, REVIEW- en CLEAR-routes en beslissingen van de baseline op basis van alleen tekst vergelijken.
Deze geselecteerde vergelijking van acht rijen illustreert zowel REVIEW- als CLEAR-uitkomsten; het is niet het volledige cluster van 15 reviews. Oranje REVIEW betekent een route voor menselijk oordeel. Groen CLEAR betekent onder de geconfigureerde drempel, niet onafhankelijk geauthenticeerd. Open de afbeelding voor inspectie op volledige grootte.

3. Houd het narratief gescheiden van de beslissing

Deterministische scoring bepaalt de niveaus voordat het optionele model de bevinding beschrijft. Het vastgelegde onderzoek speelt een gecachte respons af van de echte Codex-bridge. Het aardingsfilter controleert getallen, token-overlap en oordeelomkeringen; behouden proza vereist nog steeds beoordeling door een analist en kan de score of het niveau niet wijzigen.
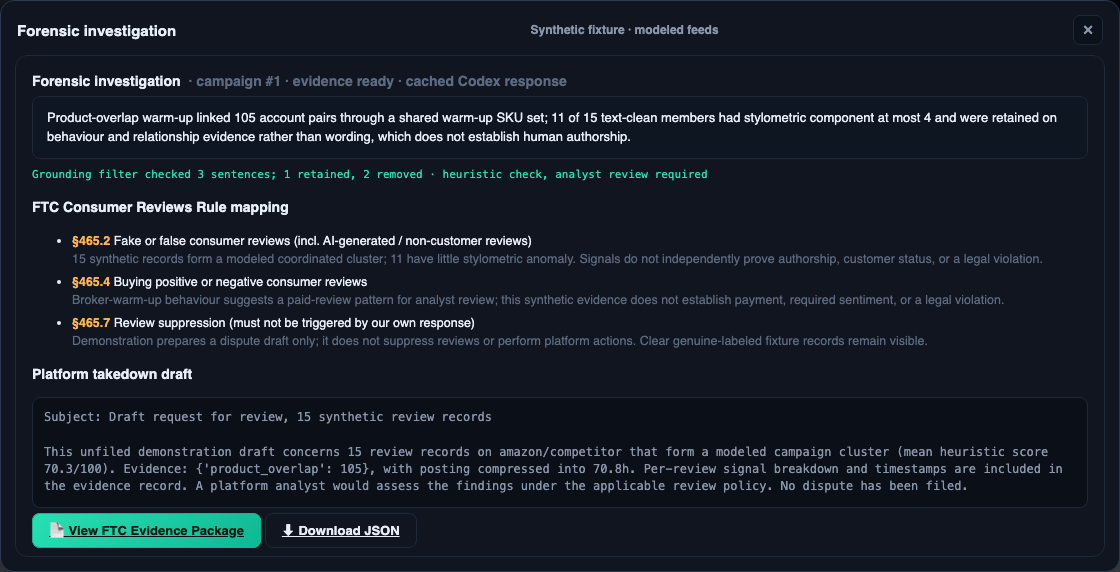
Synthetisch onderzoek van 15 reviews met gecachte Codex-herkomst, heuristisch filter, indicatieve regelkoppeling en een niet-ingediend concept.
Het onderzoek behoudt het productoverlap-bewijs en identificeert de gecachte narratiefbron. De regelkoppeling is indicatief. UI-formuleringen zoals Concept voor platformverwijdering beschrijven een niet-ingediend sjabloon, geen uitgevoerde platformactie. Het oorspronkelijke concept stelt dat tijdstempels per review zijn opgenomen, maar deze export bevat alleen een tijdstempel van recordaanmaak, geen tijdstempels per review. Open de afbeelding voor inspectie op volledige grootte.

4. Behoud de bevinding in een inspecteerbare export

De feitelijke JSON-export behoudt campagnelidmaatschap, niveau-uitsplitsing, bijdragende signalen en de componentscores van elk record. De afdrukbare HTML rendert een campagneprofiel, het gecachte narratief, indicatieve regelkoppeling, een niet-ingediend geschilconcept en alle 15 gemarkeerde rijen. Een analist kan controleren waarom een record werd doorgestuurd in plaats van uitsluitend op het narratief te vertrouwen. Het oorspronkelijke geschilconcept overschat de tijdstempeldekking: het JSON- en afdrukbare rapport bevatten een tijdstempel van recordaanmaak, maar geen tijdstempels per review. Die zouden moeten worden toegevoegd en geverifieerd vóór extern gebruik.
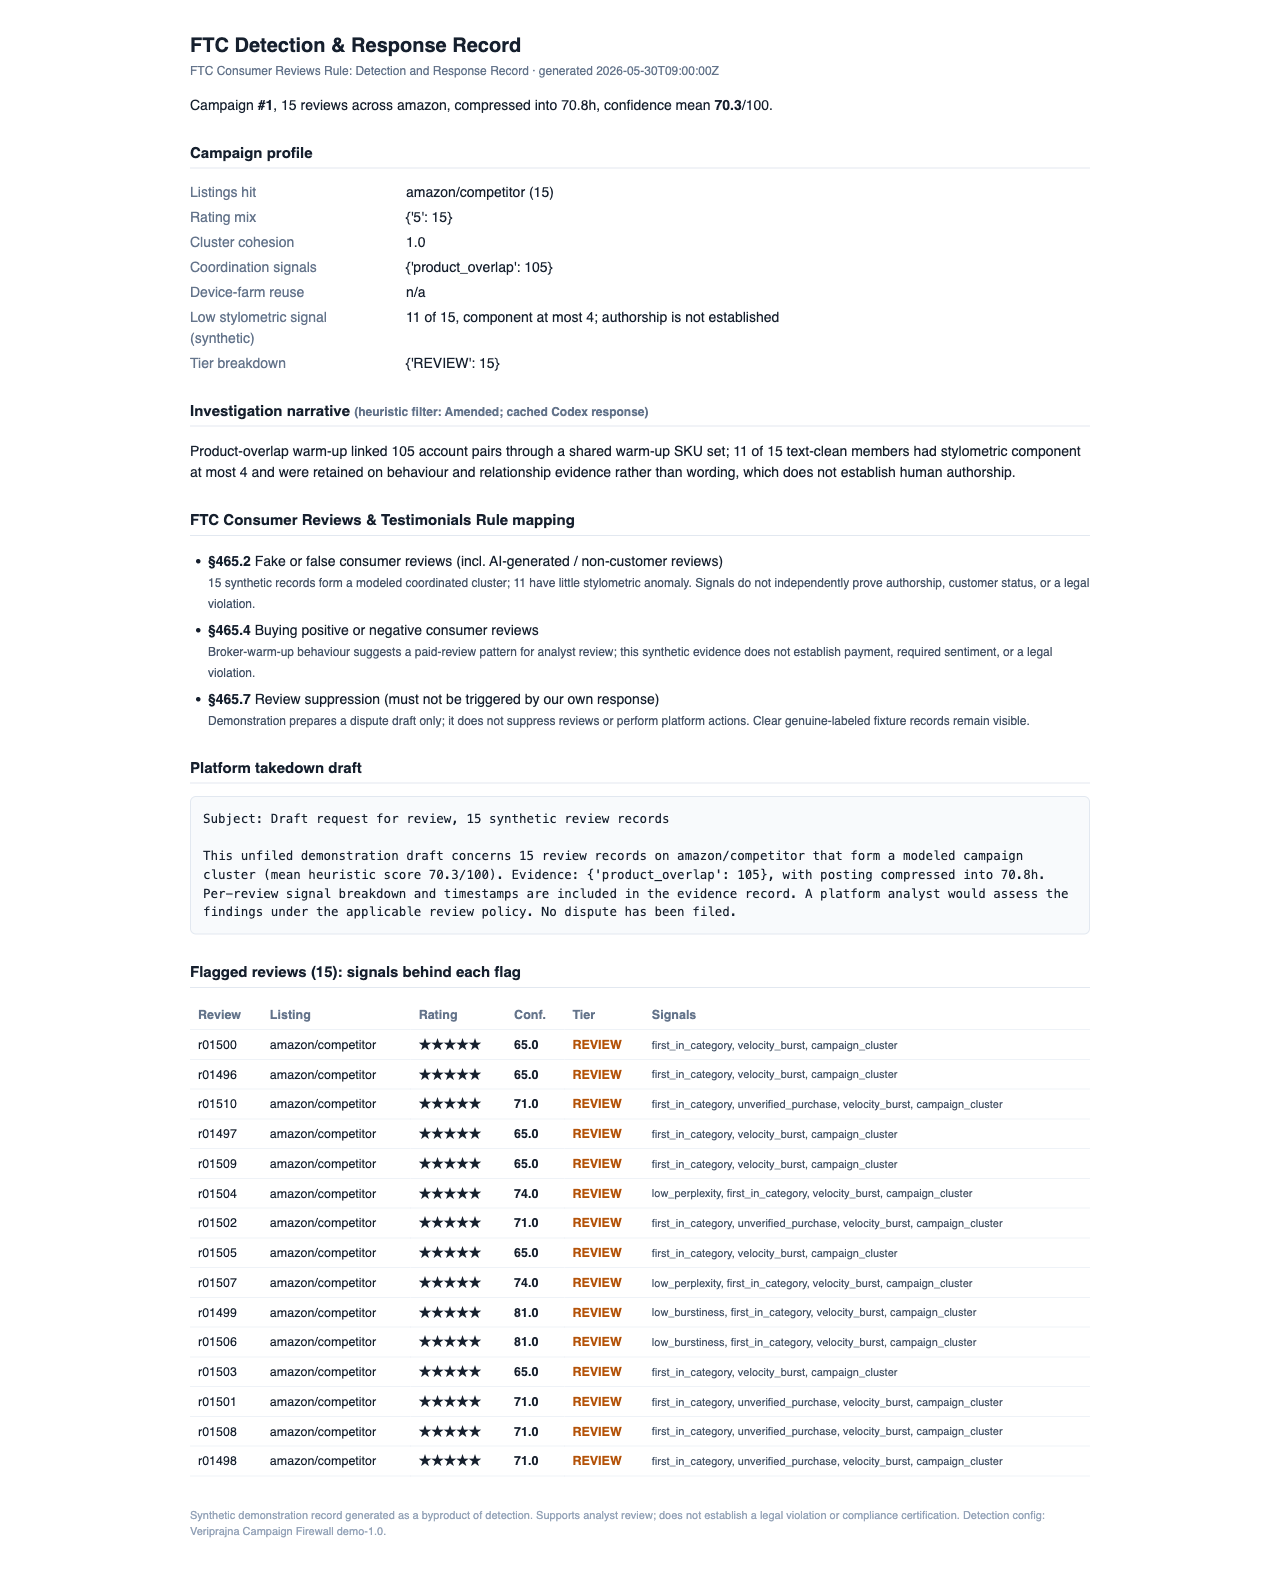
Volledig afdrukbaar synthetisch bewijsrapport van 15 reviews met campagneprofiel, narratief, concept en alle 15 REVIEW-rijen.
Dit is het oorspronkelijke afdrukbare rapport van de applicatie, gerenderd vanuit de feitelijk gedownloade JSON. Alle 15 rijen blijven REVIEW. Betrouwbaarheidswaarden zijn heuristische scores; het record is beschrijvende documentatie, geen bewijs van een wettelijke overtreding, een ingediend geschil of onafhankelijke bewijsketen. Het oorspronkelijke concept stelt dat tijdstempels per review zijn opgenomen, maar deze export bevat alleen een tijdstempel van recordaanmaak, geen tijdstempels per review. Open de afbeelding voor inspectie op volledige grootte.

Een cross-platform contrast: positieve en negatieve reviews in één cluster

Een afzonderlijk synthetisch cluster verbindt 67 records: 47 vijfsterrenreviews op de gemodelleerde vermelding van de Amazon-concurrent, plus 12 Google- en acht Yelp-reviews gericht op het gemodelleerde merk. Over 71,8 uur heeft het cluster 90 edges van gedeelde apparaten en 1.175 productoverlap-paaredges. Het bevat 24 AUTO- en 43 REVIEW-records; AUTO is geschiktheid onder een gemodelleerd beleid, geen automatische verwijdering.

Deze casus laat zien waarom een beoordelaar mogelijk relaties over gemodelleerde feeds heen nodig heeft in plaats van alleen een telling van negatieve berichten. Eenendertig van de 67 records vertonen weinig stylometrische afwijkingen. Zelfs met een verbonden patroon stelt de detector geen daadwerkelijke betaling, klantstatus of schuld vast.
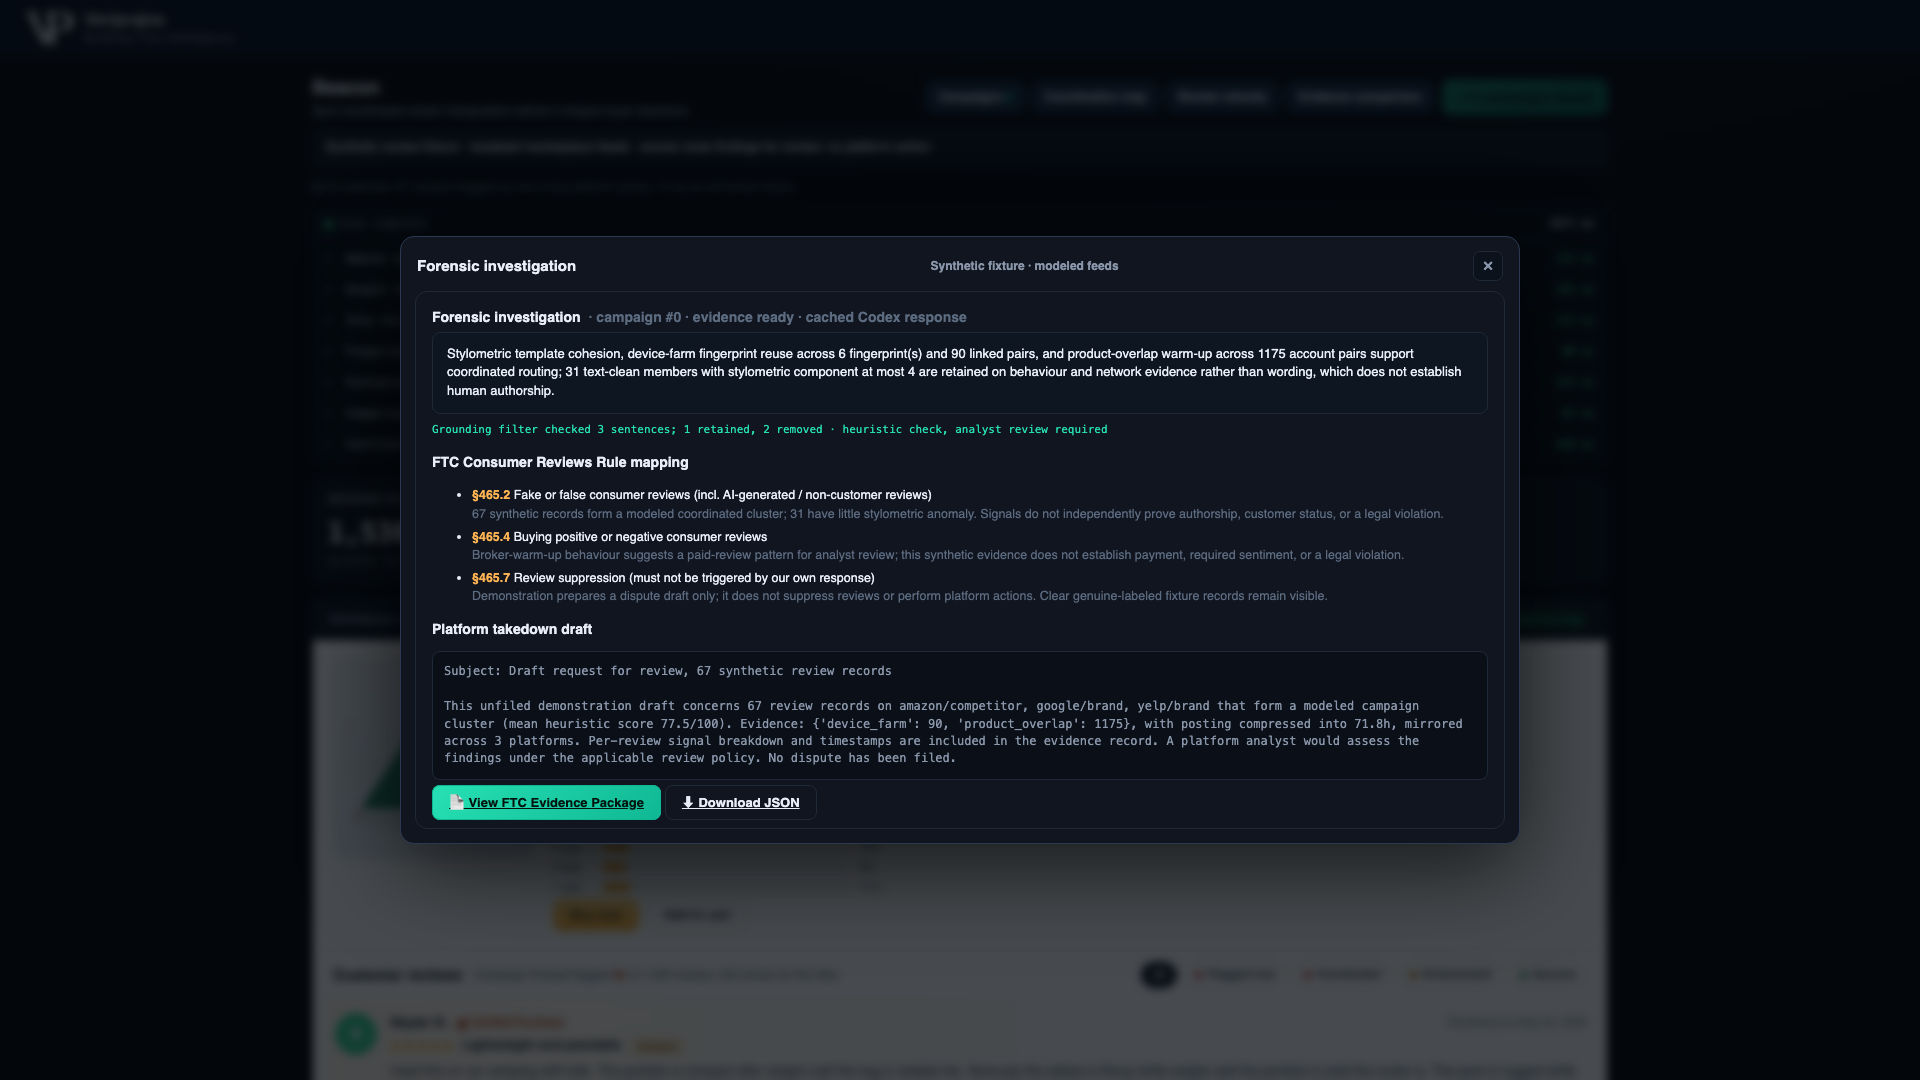
Synthetisch onderzoek van 67 reviews dat bewijs van gedeelde apparaten en productoverlap, gecacht narratief en een niet-ingediend geschilconcept toont.
Het tweede voorbeeld combineert gemodelleerde concurrentbevordering en op het merk gerichte reviews over drie platformlabels heen. Het oorspronkelijke onderzoek identificeert het cluster van 67 records en behoudt het relatiebewijs ervan. Geen enkele connector haalt live reviews op en er wordt geen geschil ingediend. Het oorspronkelijke concept stelt dat tijdstempels per review zijn opgenomen, maar deze export bevat alleen een tijdstempel van recordaanmaak, geen tijdstempels per review. Open de afbeelding voor inspectie op volledige grootte.

Een timingpiek is context, niet het aantal campagteleden

De gemodelleerde vermelding van de Amazon-concurrent piekt op 69 reviews in een venster van 72 uur tegen een verwachte 7,8, ongeveer 8,85 keer de geconfigureerde baseline. Dat aantal binnen het vermeldingsvenster is niet de omvang van het cross-platform cluster van 67 records. Een piek draagt bij aan een temporeel signaal; accountrelaties leveren de graafkoppelingen.
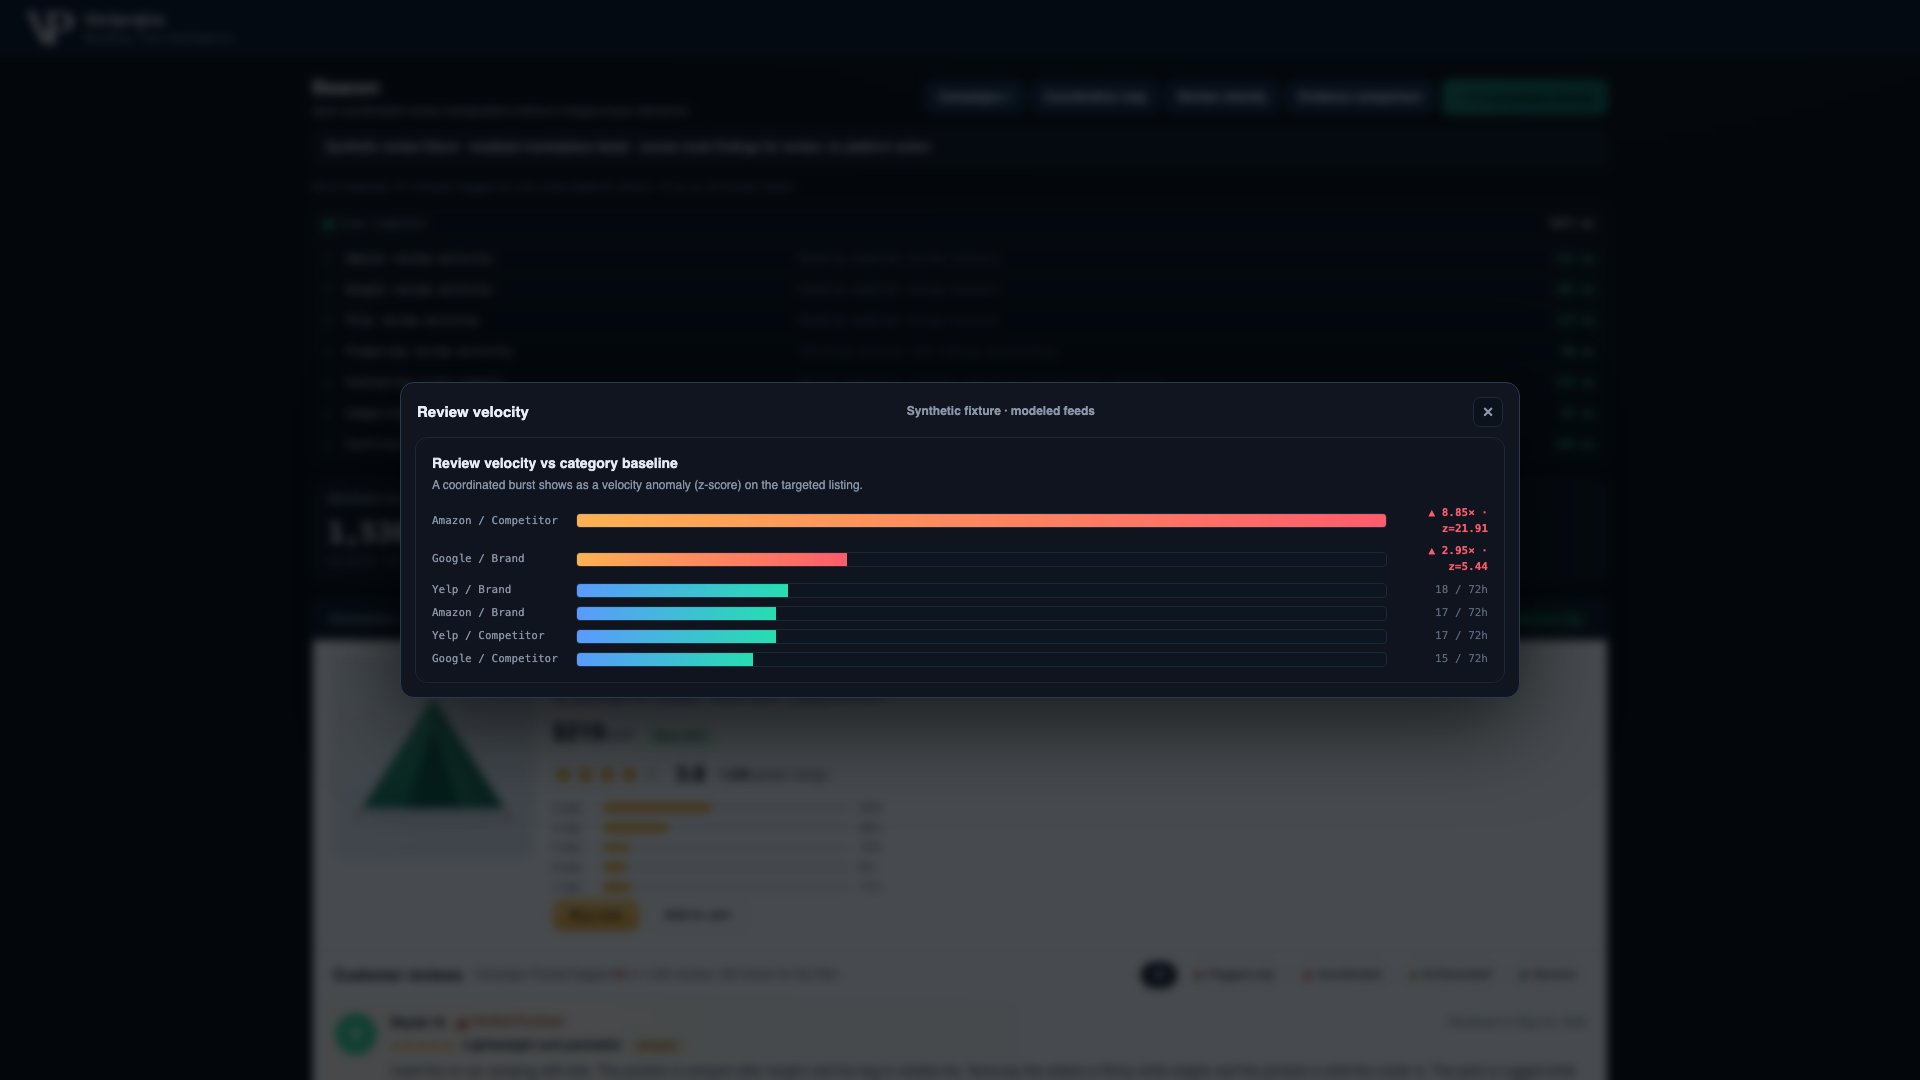
Vergelijking van synthetische vermeldingssnelheid die een piek bij de Amazon-concurrent toont van ongeveer 8,85 keer de geconfigureerde baseline.
De temporele weergave vergelijkt piekvensters op vermeldingsniveau. De piek bij de Amazon-concurrent biedt temporele context, geen bewijs dat elke review in dat venster behoort tot een gecoördineerde campagne. Open de afbeelding voor inspectie op volledige grootte.

Lees de vergelijking binnen dezelfde fixture met bijbehorende beperkingen

De bredere fixture bevat 1.530 synthetische records over een gemodelleerde geschiedenis van 90 dagen. De volgende resultaten reproduceren de huidige geladen drempels op datzelfde gelabelde corpus. Beide methoden leiden hier tekstpercentielen uit af, en de REVIEW-drempel van het ensemble werd afgestemd op de labels ervan. Dit zijn geen resultaten op basis van een evaluatieset of productienauwkeurigheid.

Huidige in-sample synthetische vergelijking
MetingCampaign Firewall-ensembleLokale baseline op basis van alleen tekst
Geplaatst reviewrecords gemarkeerd82 van de 8240 van de 82
Als authentiek gelabelde records onterecht gemarkeerd0 van de 1.448306 van de 1.448
Geplaatst campagnelabels gedetecteerd3 van de 30 van de 3

Markering omvat REVIEW en AUTO, geen verwijderingen. De drie geplaatste labels vormen twee graafclusters omdat de promotie- en spiegellabels verbinding maken in hetzelfde cross-platform cluster. Het fout-positieve contrast is alleen van toepassing op deze geïmplementeerde baseline en afgestemde fixture, niet op commerciële detectors of nieuwe reviews.
Wat elke laag kan ondersteunen

LaagNuttig bewijsGrens
Lokale baseline op basis van alleen tekstSchrijfpatroonafwijkingen in individuele recordsMarkeert vier van de 15 in de gemodelleerde campagne; geen claim over commerciële detectors
Campaign Firewall-ensembleSchrijfpatroon, gedrag, timing en accountrelatiesStuurt alle 15 door voor beoordeling in deze afgestemde synthetische fixture
OnderzoeksdocumentatieLidmaatschap, componentscores, narratief en geschilconceptOndersteunt inspectie; dient noch een geschil in, noch bewijst het een overtreding

Wat deze demo niet doet

Alle reviewrecords, accountgeschiedenissen, apparaatvingerafdrukken en platformverbindingen zijn synthetisch. De feeds zijn gemodelleerd, zonder live connectors of gescrapete reviews. De demonstratie authenticeert geen echte auteurs, verwijdert geen reviews, rondt geen menselijke onderzoeken af en dient geen geschillen in.

Er is geen evaluatie op ongeziene gegevens, fout-positief percentage in productie, besparing op analisturen, ROI of succespercentage bij geschillen gemeten. De resultaten binnen dezelfde fixture tonen reproduceerbaar geconfigureerd gedrag; ze tonen geen generalisatie aan.

Vragen die kopers stellen

Kan het nepreviews vinden die klinken alsof een echt mens ze heeft geschreven?

Campaign Firewall combineert schrijfpatronen met accountgedrag, timing en relatiebewijs. In één synthetische campagne van 15 reviews markeert de lokale baseline op basis van alleen tekst vier records, terwijl het ensemble alle 15 doorstuurt voor menselijke beoordeling. Deze gemodelleerde casus demonstreert coördinatiedetectie; het toont geen echt menselijk auteurschap of prestaties op nieuwe reviews aan.

Welk bewijs verbindt de accounts met een campagne?

Gedeelde apparaatvingerafdrukken en overlappende productgeschiedenissen creëren accountrelaties in de gemodelleerde gegevens. Koppelingen via productgeschiedenis vereisen een gedeelde vermelding, ten minste 0,5 Jaccard-overeenkomst en tijdstempels met niet meer dan 72 uur ertussen; timing alleen creëert geen edge. Campagnelidmaatschap, componentscores en bijdragende signalen blijven beschikbaar in de bewijsexport.

Haalt het reviews rechtstreeks op van Amazon, Google en Yelp?

De demonstratie gebruikt synthetische records en gemodelleerde geschiedenissen gelabeld voor Amazon, Google en Yelp. Het beschikt niet over live platformconnectors, gescrapete reviews of toegang tot echte account-, apparaat- of aankoopgeschiedenissen. Toegang tot productiegegevens, machtigingen en integraties zouden afzonderlijke implementatie en validatie vereisen.

Verwijdert het reviews of dient het een geschil voor ons in?

Campaign Firewall exporteert beschrijvend JSON- en afdrukbaar HTML-bewijs met een niet-ingediend geschilconcept. REVIEW betekent een menselijke beoordelingsroute, en AUTO betekent geschiktheid onder het gemodelleerde beleid. Geen van beide statussen verwijdert een review, dient een geschil in of rondt een onderzoek af.

Hoe weet ik dat het geen oprechte klanten zal markeren?

Het huidige ensemble keurt alle 1.448 als authentiek gelabelde synthetische records in deze fixture goed. De beoordelingsdrempel werd afgestemd op dezelfde labels, en beide methoden leiden tekstpercentielen af uit dit corpus, waardoor dat resultaat geen fout-positief percentage voor ongeziene gegevens kan vaststellen. Een evaluatie op onafhankelijke gegevens is nog steeds nodig alvorens deze routes operationeel te gebruiken.

Bewijst een gemarkeerde campagne een overtreding van de FTC-regelgeving?

Coördinatiesignalen tonen geen betaling, verplicht sentiment, klantstatus of een wettelijke overtreding aan. De FTC maakt onderscheid tussen neppe of valse reviews enerzijds en beloningen afhankelijk van positief of negatief sentiment en reviewonderdrukking anderzijds. De demo biedt indicatieve regelkoppeling en een niet-ingediend concept voor inhoudelijke beoordeling; het certificeert geen naleving.

Juridische context: Federal Trade Commission, Consumer Reviews and Testimonials Rule Q&A (gecontroleerd 2026). De koppeling is beschrijvend en vereist inhoudelijke juridische toetsing vóór extern gebruik.

Technisch onderzoek

Verken gerelateerd onderzoek voor een bredere context rond deze demonstratie.

Maak reviewbevindingen inspecteerbaar alvorens te handelen

Bespreek uw bewijs- en escalatievereisten met Veriprajna.

We kunnen de gegevensinvoer, onafhankelijke evaluatie en beoordelingsworkflow vaststellen die nodig zijn voor uw use case. De demonstratie biedt een concrete basis voor dat gesprek.

Beoordeling en evaluatie

  • ✓ Breng bewijsvereisten in kaart
  • ✓ Definieer onafhankelijke testgegevens
  • ✓ Beoordeel kosten van fout-positieven
  • ✓ Beoordeel escalatiegrenzen

Implementatieplanning

  • ✓ Bepaal toegestane gegevenstoegang
  • ✓ Ontwerp inspecteerbare scoring
  • ✓ Plan beoordelingsroutes voor analisten
  • ✓ Specificeer bewijsexports