Eerlijkheidsaudit & bias-mitigatie voor AI
Wij auditen AI-systemen op discriminerende uitkomsten in werving, kredietverstrekking, verzekeringen en gezondheidszorg, en bouwen vervolgens de mitigatiepijplijnen die de grondoorzaken aanpakken.
Uw bias-audit is geslaagd. Uw systeem discrimineert nog steeds.
De meeste AI-bias-audits passen de vier-vijfde-regel toe op ras en geslacht, produceren een pdf en verklaren dat aan de regels wordt voldaan. Die aanpak kent drie problemen.
- De vier-vijfde-regel is een bot instrument. Afkomstig uit de Uniform Guidelines (29 CFR 1607), is het een screeningsdrempel die ontworpen is voor wervingspraktijken uit 1978. Het kan geen proxydiscriminatie detecteren, waarbij postcode, woon-werkafstand of onderwijsinstelling dezelfde informatie coderen als ras zonder deze bij naam te noemen.
- Geaggregeerde metrieken verbergen intersectionele ongelijkheden. Een onderzoek van de University of Washington toonde aan dat op LLM's gebaseerde cv-screeningtools de voorkeur gaven aan namen die met witte mensen worden geassocieerd 85% van de tijd en nooit de voorkeur gaven aan namen die met zwarte mannen worden geassocieerd boven namen die met witte mannen worden geassocieerd. Geaggregeerde rasmetrieken zouden het cumulatieve effect volledig missen.
- Een eenmalige audit behandelt eerlijkheid als iets permanents. Modellen driften, invoerdistributies verschuiven en er worden nieuwe kenmerken toegevoegd. Een systeem dat in januari door een audit kwam, kan in maart discrimineren, en niemand zal het weten totdat er een klacht binnenkomt.
Onze aanpak is het bouwen van eerlijkheidsaudits die dieper gaan dan statistische screening, zoals uiteengezet in ons onderzoek naar architecturen van vertrouwen die verder gaan dan oppervlakkige AI. Het uitgangspunt is te begrijpen wat "eerlijk" betekent voor uw specifieke systeem, want de wiskunde garandeert dat u niet alles tegelijk kunt hebben.
Elke audit is een expliciete keuze, geen standaardinstelling
Chouldechova's onmogelijkheidstheorema (2017) bewijst dat wanneer basispercentages tussen groepen verschillen, geen enkele imperfecte classifier tegelijkertijd kan voldoen aan kalibratie en gelijke foutpercentages. Kleinberg, Mullainathan en Raghavan bewezen een breder resultaat: drie intuïtieve eerlijkheidsvoorwaarden kunnen niet tegelijkertijd gelden, behalve in triviale gevallen.
Dit zijn geen academische voetnoten. Ze betekenen dat elke eerlijkheidsaudit een expliciete keuze vereist over welke criteria prioriteit krijgen, en die keuze heeft juridische, ethische en zakelijke gevolgen. Wij brengen de afweging aan het licht voordat iemand begint met optimaliseren.
Proxydiscriminatie: de kenmerken die u hebt verwijderd, zitten nog steeds in het model
Het verwijderen van ras, geslacht of leeftijd uit modelinvoer elimineert discriminatie niet. Het verwijdert het directe bewijs ervan terwijl de mechanismen intact blijven.
- Een kredietverstrekkings model dat ras weglaat maar postcode behoudt, erft de patronen van residentiële segregatie die postcode in veel gebieden tot een bijna perfecte proxy voor ras maken.
- Een wervings tool die leeftijd weglaat maar afstudeerjaar, jaren ervaring en de leeftijd van de technologiestack (COBOL versus Kubernetes) gebruikt, reconstrueert leeftijd met hoge nauwkeurigheid.
Onze methode gebruikt causale-grafenanalyse om te traceren hoe beschermde kenmerken door de kenmerkruimte in voorspellingen stromen, een aanpak die is uiteengezet in ons onderzoek naar causale AI voor eerlijke werving en aanwerving. De vraag is niet of een kenmerk correleert met ras. Het is of de ongelijkheid die door dat kenmerk stroomt een legitieme zakelijke factor vertegenwoordigt (kredietgeschiedenis voorspelt daadwerkelijk terugbetaling) of een proxy voor beschermde status (kredietscores coderen historische discriminatie bij kredietverstrekking).
Dit onderscheid vereist domeinspecifiek oordeel, niet alleen statistische toetsing. De opdracht bouwt het causale diagram voor elk systeem in samenwerking met de mensen die het domein begrijpen, identificeert elk pad van beschermde kenmerken naar uitkomsten, en classificeert elk pad als legitiem, problematisch of nader onderzoek vereisend. De beoogde output is een kaart van waar discriminatie het systeem binnenkomt, niet slechts een getal dat zegt dat het bestaat.
Intersectionele audits: waar toetsing op één as faalt
Ras en geslacht onafhankelijk toetsen mist de ergste ongelijkheden. Algoritmische bias tegen zwarte vrouwen kan niet worden verklaard als de som van anti-zwarte bias plus anti-vrouw bias. Het cumulatieve effect creëert een uniek nadeel dat alleen zichtbaar wordt wanneer u de intersectie onderzoekt. Een gezichtsanalyseonderzoek uit 2024 toonde aan dat geslachtsclassificatie-algoritmen misclassificatiepercentages hadden van ongeveer 30% voor vrouwen met een donkere huidskleur, veel hoger dan de foutpercentages voor elke afzonderlijke demografische as.
De praktische uitdaging is statistische power. Intersectionele subgroepen (zwarte vrouwen boven de 50 in landelijke postcodegebieden) zijn klein, en standaard hypothesetoetsen verliezen snel power naarmate de steekproefomvang krimpt. Naïeve subgroepanalyse mist ofwel echte ongelijkheden omdat de steekproeven te klein zijn om significantie te bereiken, of produceert vals alarm door instabiele schattingen.
Onze methode pakt dit aan met Bayesiaanse hiërarchische modellen die kracht ontlenen aan verwante subgroepen en zo geloofwaardige intervallen bieden, zelfs voor kleine populaties. Ze past ook sequentiële toetsingskaders toe die in de loop van de tijd bewijs verzamelen in plaats van alle statistische power in één momentopname te vereisen. Het resultaat is intersectionele monitoring die is ontworpen om opkomende ongelijkheden te detecteren voordat ze de niveaus bereiken waarop geaggregeerde metrieken ze zouden opvangen.
Audits over domeinen heen: werving, kredietverstrekking, verzekeringen, gezondheidszorg
Elk domein heeft zijn eigen regelgevingskader, eerlijkheidscriteria en patronen van proxydiscriminatie.
| Domein | Regelgevingslandschap |
|---|---|
| Werving | NYC LL144 verplicht jaarlijkse onafhankelijke bias-audits met openbare publicatie van een samenvatting. De audit van de New York State Comptroller van december 2025 toonde aan dat 75% van de klachtoproepen over AEDT verkeerd werden doorgestuurd, en het agentschap identificeerde slechts 1 geval van niet-naleving waar auditors 17 mogelijke overtredingen vonden. De handhaving wordt aangescherpt: Illinois HB 3773 (van kracht januari 2025) verbiedt discriminerende AI-beslissingen op het gebied van werkgelegenheid, en Mobley v. Workday werd in mei 2025 de eerste gecertificeerde landelijke collectieve actie inzake AI-bias. |
| Kredietverstrekking | De federale handhaving versnippert. De CFPB stelde in november 2025 voor om de analyse van ongelijke impact onder ECOA af te schaffen, maar de aanklagers-generaal van de staten vullen het gat op. Massachusetts schikte in juli 2025 een $2,5 miljoen grote zaak over discriminatie bij AI-acceptatie. |
| Verzekeringen | Colorado SB 21-169 verbiedt oneerlijk discriminerend gebruik van algoritmen en voorspellende modellen, waarbij auto- en zorgverzekeraars uiterlijk juli 2026jaarlijkse nalevingsrapporten indienen. |
| Gezondheidszorg | Op ras gebaseerde correcties in klinische algoritmen worden aanhoudend kritisch bekeken: pulsoximeters die het zuurstofgehalte overschatten bij patiënten met een donkere huidskleur hebben geleid tot vertraagde diagnose. Maar het verwijderen van ras kan populaties ook schaden wanneer het als proxy dient voor echte risicofactoren die het model anders niet kan vastleggen. |
Voor wervings-AI wordt een opdracht zo afgebakend dat deze verder gaat dan het minimum van LL144, met intersectionele analyse, toetsing van proxykenmerken en contrafeitelijke eerlijkheidscontroles, geïnformeerd door ons onderzoek naar aansprakelijkheid bij AI-werving.
Mitigatie die grondoorzaken aanpakt, niet symptomen
Bias-mitigatie splitst zich op in drie pijplijnfasen, en het kiezen van de verkeerde verspilt inspanning of introduceert nieuwe problemen.
| Fase | Technieken | Waar het goed in is | Waar het misgaat |
|---|---|---|---|
| Pre-processing | Herbemonstering, herweging, leren van eerlijke representaties | Verhelpt bias die ontstaat bij dataverzameling | Faalt wanneer de bias voortkomt uit legitieme verschillen in distributie |
| In-processing | Eerlijkheidsbeperkingen, adversariële debiasing, eerlijkheidsregularisatoren | Geeft directe controle over de afweging tussen nauwkeurigheid en eerlijkheid | Het afdwingen van demografische pariteit wanneer basispercentages werkelijk verschillen, verslechtert de kalibratie. Bij kredietverstrekking keurt het model ofwel te veel hoogrisicoaanvragers goed of te weinig laagrisicoaanvragers in de beperkte groep. |
| Post-processing | Groepsspecifieke drempels, Fairlearn's ThresholdOptimizer | Snelst te implementeren | Werkt alleen voor classificatie, vereist groepslabels op het moment van inferentie en behandelt symptomen zonder de mechanismen aan te pakken |
Onze aanpak selecteert de interventiefase op basis van waar bias de pijplijn binnenkomt, wat het regelgevingskader vereist en welke afweging tussen nauwkeurigheid en eerlijkheid de organisatie kan verdragen. Elke mitigatie wordt zo afgebakend dat er een gedocumenteerde evaluatie wordt geproduceerd die het effect ervan op zowel eerlijkheidsmetrieken als systeemprestaties toont, met de afweging expliciet vermeld.
Continue monitoring versus jaarlijkse audits
Een jaarlijkse audit is een regelgevend minimum, geen technische toereikendheid. Modellen die interageren met feedbackloops kunnen tussen audits door bias ontwikkelen: wervingstools waarbij beslissingen uit het verleden toekomstige kandidatenpools vormen, of kredietverstrekkingsmodellen waarbij goedkeuringspatronen de gegevens van kredietbureaus beïnvloeden.
Onze aanpak is het bouwen van continue eerlijkheidsmonitoring met behulp van sequentiële hypothesetoetsing die opkomende ongelijkheden in realtime detecteert in plaats van te wachten tot er genoeg data is om een traditionele significantietoets uit te voeren, een verantwoordingsmodel dat is verkend in ons onderzoek naar retentie-engineering en algoritmische verantwoording. De monitoring activeert meldingen wanneer eerlijkheidsmetrieken configureerbare drempels overschrijden, met afzonderlijke tracking voor geaggregeerde en intersectionele subgroepprestaties. Dit is het verschil tussen het ontdekken van een discriminatieprobleem in uw jaarlijkse auditrapport en het opvangen ervan twee weken nadat het begint.
Voor agentic AI-systemen is eerlijkheidsmonitoring nog crucialer: multi-agent-orkestraties kunnen emergente bias ontwikkelen door interacties tussen agents en feedbackloops die geen enkele single-agent-audit zou detecteren.
Waar toolkits en platforms stoppen en maatwerk begint
IBM AIF360 biedt 71 eerlijkheidsmetrieken en 13 algoritmen voor bias-mitigatie. Fairlearn biedt ThresholdOptimizer, ExponentiatedGradient en GridSearch-reductie. Beide zijn waardevolle uitgangspunten. Geen van beide doet het moeilijke deel.
- Beide vereisen labels van beschermde kenmerken als invoer, die organisaties vaak niet kunnen verzamelen.
- Beide gaan ervan uit dat de gebruiker weet welke eerlijkheidsmetriek geoptimaliseerd moet worden, wat vereist dat men door de onmogelijkheidstheorema's voor het specifieke domein navigeert.
- Geen van beide bouwt de causale grafiek die proxydiscriminatie scheidt van legitieme risicofactoren.
- Geen van beide behandelt de intersectionele analyse waar standaard statistische toetsen power verliezen.
Governanceplatforms zoals Holistic AI en Credo AI bieden nalevingstracking, modelinventarisatie en risicoscoring. Ze vertellen u welke modellen geaudit moeten worden en of de auditresultaten actueel zijn. Ze voeren de auditmethodologie zelf niet uit: de causale analyse, de intersectionele toetsing, de mitigatieselectie, de documentatie van de afweging tussen nauwkeurigheid en eerlijkheid. Onze opdrachten integreren met welk platform of welke toolkit de klant ook al gebruikt. De methodologielaag is wat wij inbrengen.
Belangrijkste conclusies
- De vier-vijfde-regel (29 CFR 1607) is een screeningsdrempel uit het tijdperk van 1978 die proxy- en intersectionele discriminatie mist.
- Chouldechova (2017) en Kleinberg, Mullainathan & Raghavan bewijzen dat geen enkele classifier tegelijk aan alle eerlijkheidscriteria voldoet, dus elke audit is een expliciete prioriteringskeuze.
- Causale-grafenanalyse brengt in kaart hoe verwijderde kenmerken zoals ras en leeftijd opnieuw binnenkomen via proxy's zoals postcode en afstudeerjaar.
- Bayesiaanse hiërarchische en sequentiële toetsingsmethoden brengen intersectionele ongelijkheden aan het licht die metrieken op één as en geaggregeerde metrieken verbergen.
- Regelgeving verschilt per domein — NYC LL144, Illinois HB 3773, ECOA, Colorado SB 21-169 — dus de mitigatiefase en monitoring moeten per systeem worden gekozen.
- Toolkits (AIF360, Fairlearn) en governanceplatforms (Holistic AI, Credo AI) zijn uitgangspunten; de causale, intersectionele en afwegingsmethodologie is het maatwerk.
Eerlijkheidsaudit & bias-mitigatie voor AI
 Bekijken
Ethical Subscription Retention AI | Veriprajna
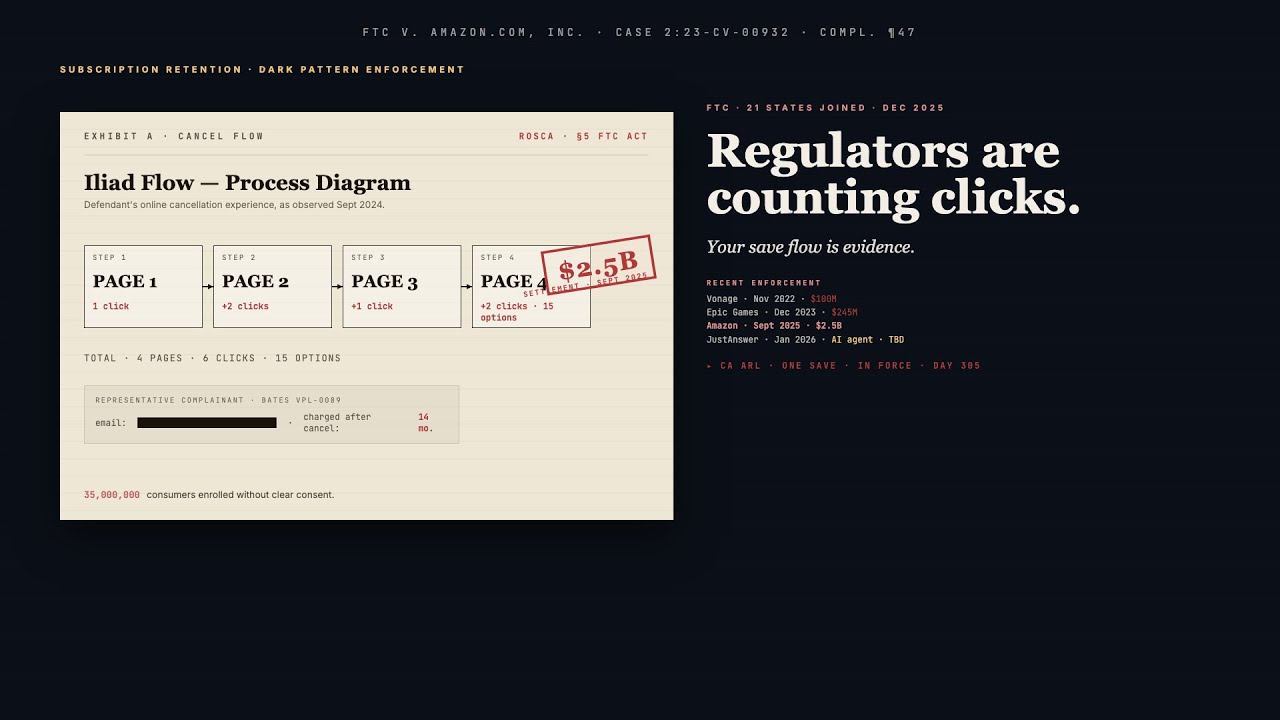
Amazon betaalde $2,5 miljard voor een opzegproces dat 6 klikken vergde. Uber staat tegenover 21 procureurs-generaal van staten vanwege 23 schermen om op te zeggen.
Veelgestelde vragen
Hoeveel kost een AI-bias-audit, en hoe lang duurt het?
De scope bepaalt de kosten meer dan enige andere factor. Een gerichte, LL144-conforme audit van één enkele wervingstool met standaardanalyse volgens de vier-vijfde-regel kan in twee weken worden voltooid. Dat is het vinkje. Een uitgebreide audit met causale proxyanalyse, intersectionele subgroeptoetsing, contrafeitelijke eerlijkheidsevaluatie en gedocumenteerde mitigatie-aanbevelingen duurt 6-10 weken, afhankelijk van de complexiteit van het systeem, de beschikbaarheid van data en hoeveel regelgevingskaders van toepassing zijn. De kostenvraag die de meeste kopers eigenlijk zouden moeten stellen, is wat niet-naleving kost. NYC LL144-boetes lopen op tot $500-$1.500 per overtreding per dag. Colorado SB 205 staat tot $20.000 per overtreding toe. Massachusetts schikte zojuist een zaak over AI-discriminatie bij kredietverstrekking voor $2,5 miljoen. De investering in de audit is een fractie van één enkele handhavingsactie.
Welke eerlijkheidsmetriek moeten we gebruiken als we er niet aan allemaal tegelijk kunnen voldoen?
U kunt er niet aan allemaal voldoen. Chouldechova (2017) bewees dat wanneer basispercentages tussen groepen verschillen, geen enkele imperfecte classifier tegelijkertijd kalibratie en gelijke fout-positieve en fout-negatieve percentages kan bereiken. Kleinberg, Mullainathan en Raghavan bewezen een bredere onmogelijkheid. De keuze van de metriek hangt af van het domein en het juridische kader. Bij kredietverstrekking is kalibratie van belang omdat risicoscores de werkelijke wanbetalingskansen moeten weerspiegelen om de prijsstelling te laten werken. Gelijkgestelde kansen (equalized odds) zijn van belang omdat ongelijke foutpercentages aansprakelijkheid voor ongelijke impact onder ECOA creëren. Bij werving is pariteit van selectiepercentage (demografische pariteit) het uitgangspunt omdat de vier-vijfde-regel dit operationaliseert, maar gelijkgestelde kansen en voorspellende pariteit zijn van belang voor testvalidatie onder de Uniform Guidelines. Wij doorlopen de onmogelijkheidsafwegingen voor het specifieke systeem en de regelgevingscontext van elke klant voordat iemand begint met optimaliseren.
We hebben ras uit ons model verwijderd. Waarom vertoont het nog steeds ongelijke impact?
Omdat andere kenmerken dezelfde informatie dragen. Postcode codeert residentiële segregatie. Afstudeerjaar en de leeftijd van de technologiestack reconstrueren leeftijd. Hiaten in het arbeidsverleden correleren met arbeidsongeschiktheid en mantelzorg. Onderwijsinstelling correleert met ras en sociaaleconomische status. Woon-werkafstand correleert met de samenstelling van de buurt. Het verwijderen van het label verwijdert het signaal niet. Wij gebruiken causale-grafenanalyse om elk pad van beschermde kenmerken door de kenmerkruimte naar de output van het model te traceren. Sommige van die paden lopen via legitieme zakelijke factoren (kredietgeschiedenis voorspelt daadwerkelijk terugbetaling). Andere lopen via proxy's die historische discriminatie coderen. De audit identificeert welke paden welke zijn, en de mitigatie richt zich op de proxypaden zonder de legitieme te verstoren.
Kunnen we worden aangeklaagd voor AI-discriminatie wanneer we de wervingstool van een leverancier gebruiken?
Ja. Werkgevers blijven aansprakelijk voor discriminerende uitkomsten van AI-tools van leveranciers onder Title VII, FCRA en arbeidswetten van de staten. In Mobley v. Workday (mei 2025) oordeelde de rechter dat een AI-leverancier direct aansprakelijk kan zijn voor arbeidsdiscriminatie als agent van de werkgever. In de collectieve actie tegen Eightfold AI (januari 2026) lopen zowel het platform als de werkgevers die het gebruiken risico. Colorado SB 205 legt afzonderlijke verplichtingen op aan de gebruikers, ongeacht wie het systeem heeft gebouwd. Het gebruik van een tool van een leverancier verschuift het juridische risico niet. Het verschuift de technische complexiteit, omdat u een systeem moet auditen dat u niet zelf hebt gebouwd. Wij auditen AI-tools van leveranciers met op output gebaseerde toetsingsmethoden die geen toegang vereisen tot de broncode of de interne werking van het model van de leverancier.
Wat is het verschil tussen een LL144-nalevingsaudit en een uitgebreide eerlijkheidsaudit?
LL144 vereist een onafhankelijke bias-audit die selectiepercentages onderzoekt naar categorieën van ras/etniciteit en geslacht/gender, met resultaten die openbaar worden gepubliceerd. Dat is een ondergrens, geen bovengrens. De audit van de New York State Comptroller van december 2025 constateerde dat de handhaving door DCWP oppervlakkig was: 75% van de klachten werd verkeerd doorgestuurd, en auditors identificeerden 17 mogelijke overtredingen waar DCWP er slechts 1 vond. Een uitgebreide audit gaat verder: intersectionele analyse over gecombineerde beschermde kenmerken, causale proxydetectie voor kenmerken die beschermde informatie indirect coderen, contrafeitelijke eerlijkheidstoetsing, sensitiviteitsanalyse die kwantificeert hoe robuust eerlijkheidsclaims zijn tegen niet-gemeten verstorende variabelen, en gedocumenteerde analyse van de afweging tussen nauwkeurigheid en eerlijkheid, met de implicaties van het onmogelijkheidstheorema uitgeschreven. De uitgebreide versie is wat de toets der kritiek doorstaat wanneer de handhaving serieus wordt.
Hoe toetsen we op bias wanneer we geen toegang hebben tot data over beschermde kenmerken?
Dit is een van de moeilijkste praktische problemen bij eerlijkheidsaudits. Alle belangrijke toolkits (AIF360, Fairlearn) vereisen beschermde kenmerken als invoer. In de praktijk kunnen veel organisaties geen data over ras, geslacht of arbeidsongeschiktheid op individueel niveau verzamelen, met name buiten arbeidscontexten. Opties zijn onder meer Bayesian Improved Surname Geocoding (BISG) om ras af te leiden uit naam en geografie (gebruikt door de CFPB voor analyse van eerlijke kredietverstrekking), ecologische inferentiemethoden die groepsniveau-ongelijkheden schatten uit geaggregeerde data, en outputperturbatietoetsing waarbij u contrafeitelijke invoer construeert die alleen proxy's van beschermde kenmerken varieert en beslissingswijzigingen meet. Elke methode heeft beperkingen. BISG introduceert zijn eigen bias voor multiraciale individuen en bepaalde etnische groepen. Wij selecteren en valideren de proxymethode tegen de specifieke populatie en regelgevingscontext, waarbij we de door de imputatie geïntroduceerde onzekerheid documenteren in plaats van geschatte kenmerken als grondwaarheid te behandelen.
Hebben we continue bias-monitoring nodig, of volstaat een jaarlijkse audit?
Een jaarlijkse audit is wat toezichthouders als minimum vereisen. Het is niet wat u veilig houdt. Modellen die interageren met feedbackloops ontwikkelen tussen audits door bias: een wervingstool die kandidaten met bepaalde achtergronden afwijst, traint op zijn eigen uitsluitingen en versterkt zo het patroon. Kredietverstrekkingsmodellen waarbij goedkeuringspatronen de gegevens van kredietbureaus beïnvloeden, creëren zichzelf waarmakende voorspellingen. Invoerdistributies verschuiven naarmate de demografie van klanten of kandidatenpools verandert. Wij bouwen continue monitoring met sequentiële hypothesetoetsing die opkomende verslechtering van eerlijkheid in realtime detecteert en meldingen activeert wanneer metrieken drempels overschrijden. De monitoring volgt zowel geaggregeerde als intersectionele subgroepprestaties afzonderlijk. Het praktische verschil: een jaarlijkse audit vertelt u dat het model maandenlang bevooroordeeld was. Continue monitoring vertelt het u binnen enkele weken.
Hoe auditen we LLM's en generatieve AI op bias wanneer traditionele eerlijkheidsmetrieken niet van toepassing zijn?
Traditionele eerlijkheidsmetrieken (gelijkgestelde kansen, demografische pariteit) waren ontworpen voor binaire classifiers met gedefinieerde beschermde groepen en meetbare uitkomsten. Generatieve AI produceert open tekst, afbeeldingen of aanbevelingen waarbij bias zich manifesteert als stereotype associaties, verschillende kwaliteit of weigeringspatronen over demografische contexten heen. Wij evalueren LLM-bias via scenariogebaseerde probing (systematisch variëren van demografische signalen in prompts en het meten van outputverschillen), benchmarksuites (BBQ, StereoSet, CrowS-Pairs) aangepast aan de specifieke implementatiecontext, en outputaudits waarbij productie-outputs worden bemonsterd en geëvalueerd op patronen van ongelijke behandeling. De uitdaging is dat LLM's tot 77% van de tijd stereotype-conforme fouten vertonen in ambigue contexten (BBQ-benchmarkonderzoek), en deze biases zijn moeilijker te mitigeren dan classifier-bias omdat ze verdeeld zijn over miljarden parameters in plaats van geconcentreerd in enkele kenmerken.
Wat zijn de daadwerkelijke boetes voor het niet doorstaan van een bias-audit of het niet uitvoeren ervan?
De boetes escaleren snel in verschillende jurisdicties. NYC LL144: $500-$1.500 per overtreding per dag, vermenigvuldigd met elke getroffen aanvrager. Colorado SB 205 (van kracht juni 2026): tot $20.000 per overtreding onder de Consumer Protection Act. EU AI Act (handhaving augustus 2026): tot EUR 35 miljoen of 7% van de wereldwijde omzet voor verboden praktijken, EUR 15 miljoen of 3% voor niet-naleving met hoog risico. Naast wettelijke boetes is de blootstelling aan rechtszaken reëel: de aanklager-generaal van Massachusetts wist $2,5 miljoen af te dwingen uit één enkele schikking over AI-discriminatie bij kredietverstrekking in juli 2025. SafeRent betaalde $2,275 miljoen voor discriminatie door een screeningsalgoritme voor woningen. Mobley v. Workday is de eerste gecertificeerde landelijke collectieve actie inzake AI-bias. De kosten van een uitgebreide audit zijn een afrondingsfout vergeleken met elk van deze uitkomsten.
Welke regelgevende vereisten gelden voor AI-bias bij verzekeringsacceptatie?
Colorado SB 21-169 is het meest voorschrijvend. Het verbiedt verzekeraars om externe consumentendata, algoritmen en voorspellende modellen te gebruiken op manieren die oneerlijk discriminerende uitkomsten produceren op basis van beschermde kenmerken. Auto- en zorgverzekeraars moeten uiterlijk 1 juli 2026 jaarlijkse nalevingsrapporten indienen. De Colorado Division of Insurance heeft kwantitatieve toetsing voorgesteld waarbij modellen met en zonder geschatte rasvariabelen worden vergeleken om discriminerende kenmerken te identificeren. Daarnaast hebben 24 staten de NAIC Model Bulletin aangenomen die verzekeraars verplicht transparantie en eerlijkheid op te nemen in hun AI-governanceprogramma's. De vraag naar actuariële eerlijkheid verschilt van statistische eerlijkheid: actuarieel gerechtvaardigde risicodifferentiatie kan statistische ongelijkheden produceren die juridisch toegestaan zijn onder verzekeringsrecht, maar discriminerend zouden zijn onder arbeids- of kredietverstrekkingsrecht. Wij helpen verzekeringsteams door dit onderscheid te navigeren met toetsingskaders die zijn gebouwd voor de verzekeringsspecifieke regelgevingscontext.
Bouw uw AI met vertrouwen.
Werk samen met een team met diepgaande ervaring in het bouwen van de volgende generatie enterprise-AI. Laat ons u helpen bij het ontwerpen, bouwen en implementeren van een AI-strategie waarop u kunt vertrouwen.
Veriprajna Deep Tech-adviesbureau is gespecialiseerd in het bouwen van veiligheidskritische AI-systemen voor de gezondheidszorg, de financiële sector en gereguleerde domeinen. Onze architecturen worden gevalideerd aan de hand van gevestigde protocollen met uitgebreide compliancedocumentatie.