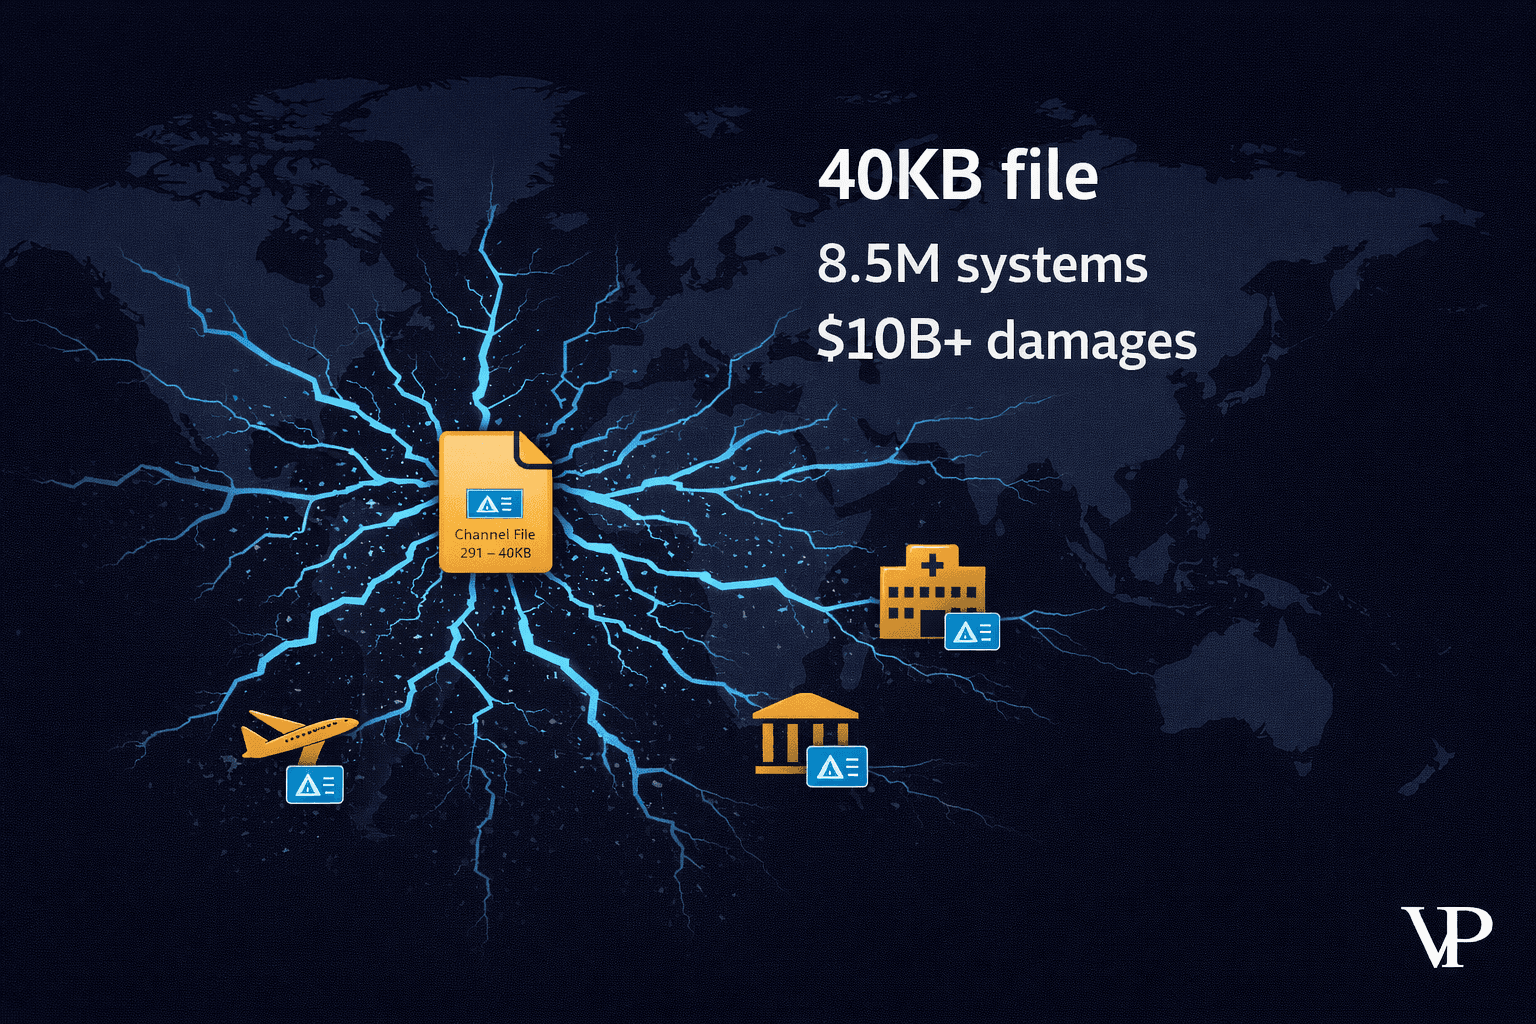
A falha da CrowdStrike resumiu-se a uma contagem de campos: 21 onde o kernel esperava 20. Nenhuma camada independente verificava.

Em 19 de julho de 2024, uma única atualização de fornecedor derrubou milhões de máquinas Windows em menos de 90 minutos, e a causa foi um número. Um arquivo de canal "Rapid Response Content" da CrowdStrike declarava 21 campos onde o interpretador de kernel implantado esperava 20. O campo extra produziu uma leitura fora dos limites (out-of-bounds read), uma tela azul instantânea e, como o travamento ocorreu tão cedo na inicialização, o agente com falha nunca conseguiu reiniciar para receber um comando de reversão (rollback). A recuperação exigiu ir fisicamente até cada máquina e repará-la manualmente no Modo de Segurança.
Li a própria análise de causa raiz da CrowdStrike, publicada naquele mês de agosto, mais de uma vez antes que ficasse evidente o que realmente me incomodava. Não foi um ataque hacker. Não foi um modelo defeituoso. Foi um fato aritmético decidível, 21 contra 20, alojado em uma carga útil que nenhuma camada independente jamais verificou antes de atingir a produção. O validador do fornecedor a aprovou. As empresas que ficaram paralisadas não eram donas daquele validador. Elas arcaram com as consequências.
Passei o último período construindo uma demonstração em torno dessa lacuna: um console que chamei de Kestrel, que fica entre um fornecedor de software e uma frota de produção e decide, em código, o que o fornecedor tem permissão para enviar. Você pode ver como funciona em veriprajna.com/demos/software-update-integrity. O que me surpreendeu durante a construção foi onde a solução realmente se encontrava. Comecei convencido de que precisaria de um modelo mais inteligente, e algumas linhas de Python simples capturaram o travamento primeiro.
Reconstruí o travamento e depois deixei o código decidir
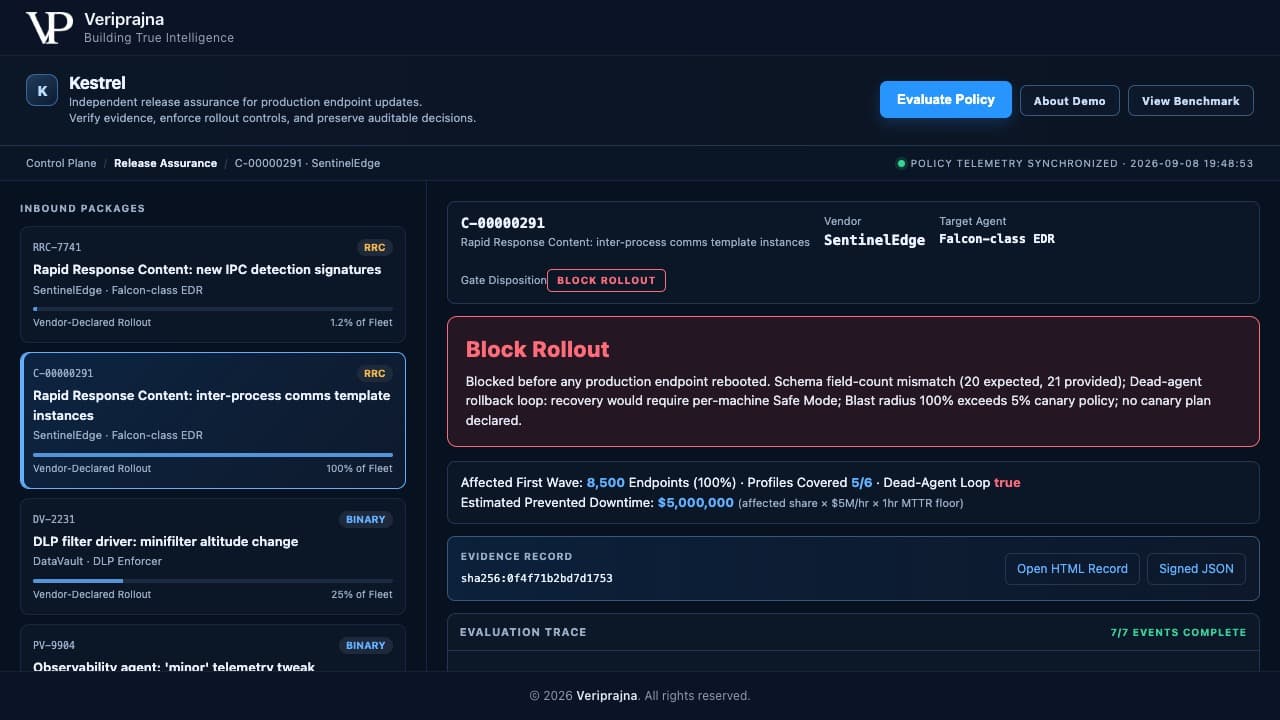
Reconstruí a assinatura de falha de 19 de julho como um fixture de teste e apontei meu próprio sistema para ela, quase esperando ficar desapontado com meu próprio replay. O pacote é o C-00000291, um arquivo de canal Rapid Response Content de um fornecedor fictício que chamei de SentinelEdge, enviado para uma frota sintética de 8.500 endpoints chamada Acme Financial. Nenhuma dessas empresas é real. A assinatura de falha é a verdadeira: um esquema declarado de 20 crescendo para 21, enviado para 100% da frota em uma única onda, sem plano de canary.
O gate dispara em quatro verificações simultâneas, e cada uma delas é aritmética pura ou uma consulta direta, nunca um julgamento subjetivo. O diff de esquema detecta 21 campos onde o interpretador espera 20 e sinaliza a leitura fora dos limites. Um sandbox simulado, que é um modelo determinístico de resultados por perfil e não uma fazenda de máquinas virtuais Windows reais, coloca 5 dos 6 perfis da frota em loop de reinicialização ao longo dos ciclos de reboot. Ele deriva isso de um sinal de compatibilidade de driver independente da verificação de esquema, de modo que as duas conclusões se corroboram mutuamente em vez de serem um mero eco. O detector de agente inerte marca o loop de reversão como verdadeiro, porque o agente em travamento é ele próprio o componente que receberia a reversão, e ele está inerte antes do fim da inicialização. O raio de impacto é de 100% contra uma política de canary de 5%. Veredito: BLOCK. Na tela lê-se: bloqueado antes que qualquer endpoint de produção fosse reiniciado.
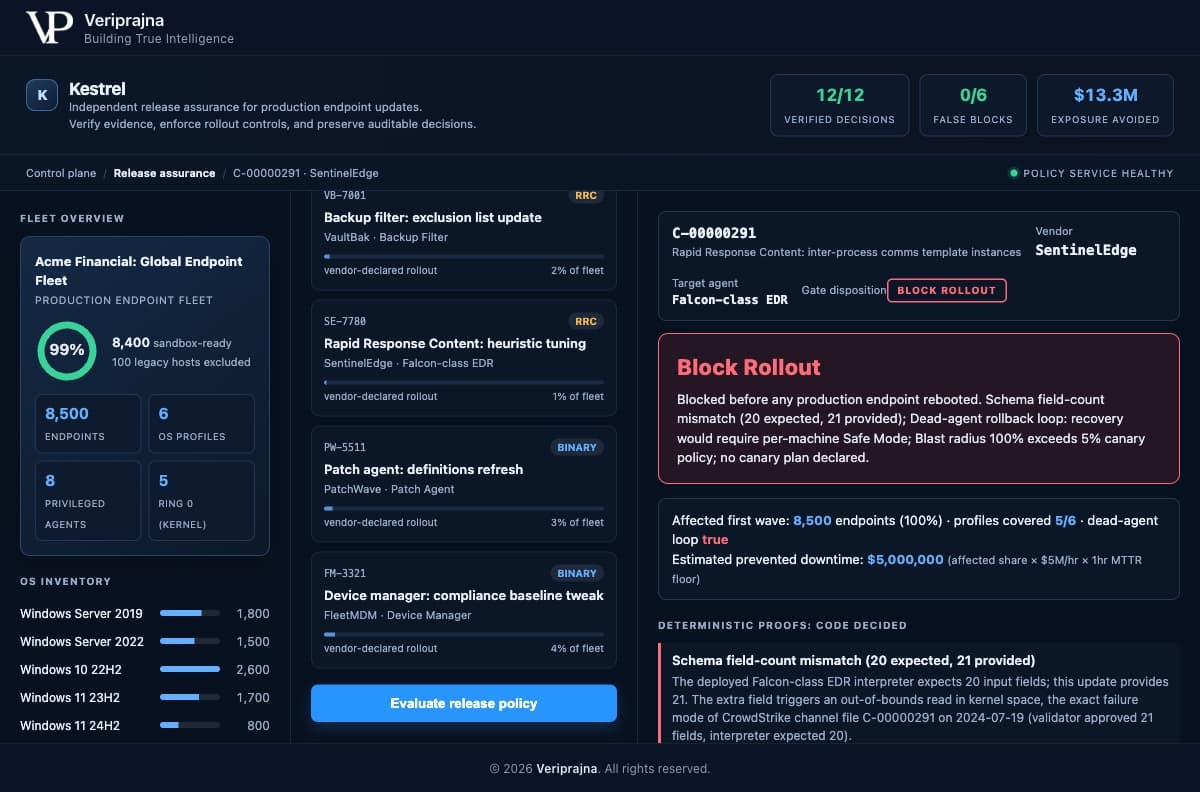
O tempo de inatividade evitado estimado nessa única atualização marca US$ 5.000.000, e quero ser exato sobre o que essa cifra representa. É o modelo próprio da demo: a fatia afetada vezes um parâmetro de US$ 5 milhões por hora vezes um piso de recuperação de uma hora, com a fórmula impressa na tela. Não é dinheiro que um cliente economizou. A recuperação real de 19 de julho levou dias, não uma hora, portanto o piso é deliberadamente conservador.
O caso verde me assustou mais do que o vermelho
Fiquei mais apreensivo com o caso verde do que com o vermelho, porque uma camada de governança que bloqueia a atualização perigosa e também estrangula a segura nada mais é do que uma interrupção agendada por você mesmo. O mesmo fornecedor fictício envia o RRC-7741, uma atualização benigna de assinaturas de detecção, com esquema declarado de 20 para 20 e um plano de canary escalonado de 1,2%. A equipe de agentes executa, o esquema corresponde, 5 de 6 perfis superam seus ciclos de reinicialização, o loop de agente inerte é falso, o raio de impacto permanece dentro da política. Veredito: APPROVE ROLLOUT, liberado para um anel de canary de 102 endpoints. Verde, rápido, sem sobressaltos.
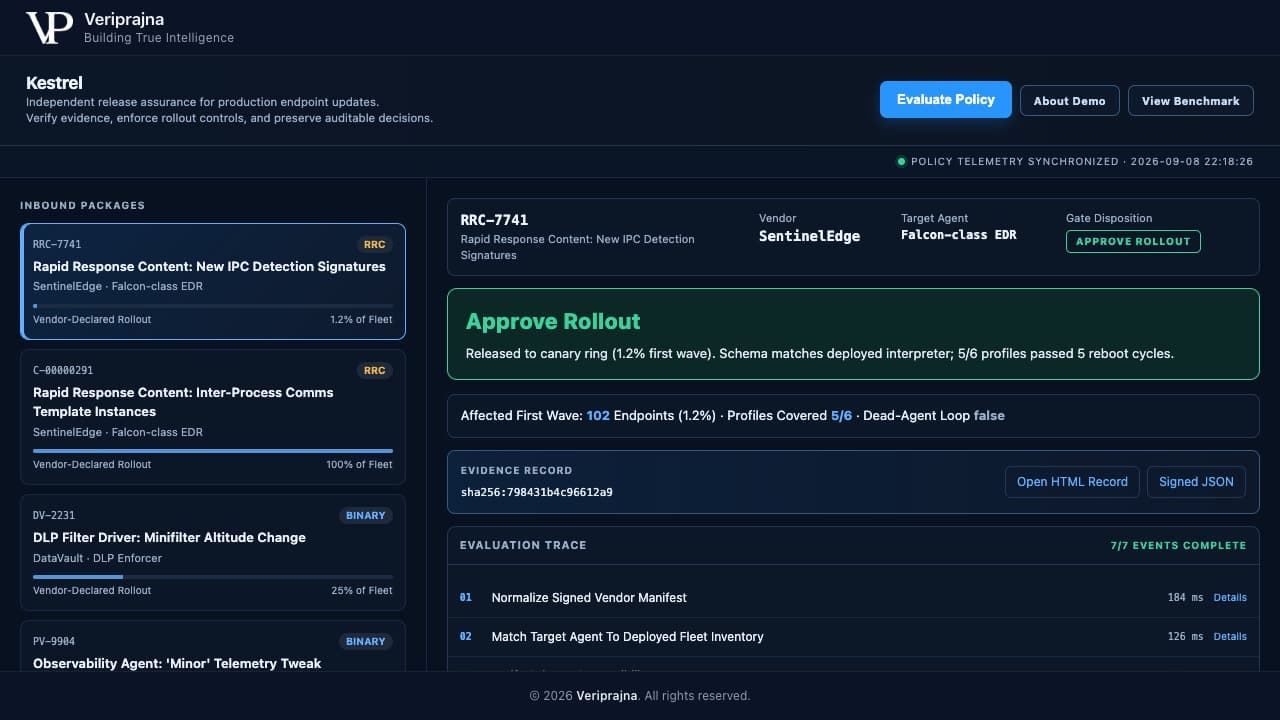
Nas seis atualizações benignas do conjunto, o gate produziu zero falsos bloqueios. Digo isso explicitando o denominador, porque seis é seis, e não permitirei que isso seja arredondado como uma promessa sobre a sua frota. O valor do caso ALLOW é mais restrito e mais importante do que uma porcentagem. Um gate só é crível se for invisível no tráfego normal e inabalável no único evento capaz de derrubar sua infraestrutura.
Por que tirei o veredito do modelo
Comecei esta construção presumindo que a parte difícil residia no raciocínio, e que um modelo mais perspicaz ou um crítico mais astuto seria o elemento que capturaria a atualização incorreta. Eu estava enganado, de uma forma que levei algum tempo para admitir. Há uma equipe de LLM dentro do Kestrel: um normalizador, um interpretador de sandbox e dois críticos opostos, um argumentando que a atualização é segura para envio e outro sustentando que ela vai falhar. O par contraditório justifica seu espaço porque submete o veredito a um teste adversário (red-teaming) de ambas as direções antes que qualquer decisão seja tomada. Mas nenhum desses agentes define o veredito.
O veredito é definido por dois arquivos Python simples, verifier.py e gate.py, que residem inteiramente fora da estrutura de agentes. A equipe opera sobre Pydantic AI com o modelo padrão claude-opus-4-8, e todo o sistema também funciona offline, sem chave de API, por meio de um mecanismo consultivo determinístico de contingência. Em cada um desses modos, o gate é idêntico e retorna a mesma decisão, porque a decisão é aritmética, não inferência. Os agentes aconselham, o código decide. Um agente consultivo inclinado a "permitir" não pode anular um achado determinístico crítico, e isso não é uma questão de preferência.
Uma camada construída para auditar o fornecedor não pode confiar na palavra do fornecedor quanto à segurança. Também não pode confiar na palavra de seu próprio modelo.
Essa frase é a razão pela qual a arquitetura tem essa estrutura. A confiança em um produto cuja única função é governar o que um fornecedor distribui nunca deve passar por um componente que possa ser convencido a dizer sim.
O que eu entregaria a um auditor
Mantive o Cyber Resilience Act da UE aberto em um segundo monitor enquanto construía o registro de evidências, porque esse registro é o artefato que eu realmente teria que defender. Cada decisão exporta um arquivo HTML imutável e um arquivo JSON assinado contendo um hash de conteúdo SHA-256, o veredito, as provas determinísticas, os resultados de sandbox por perfil, os vereditos dos agentes consultivos com o ID de seu modelo, as regras de política disparadas e um rastreamento de avaliação passo a passo no qual cada etapa registra sua própria latência.
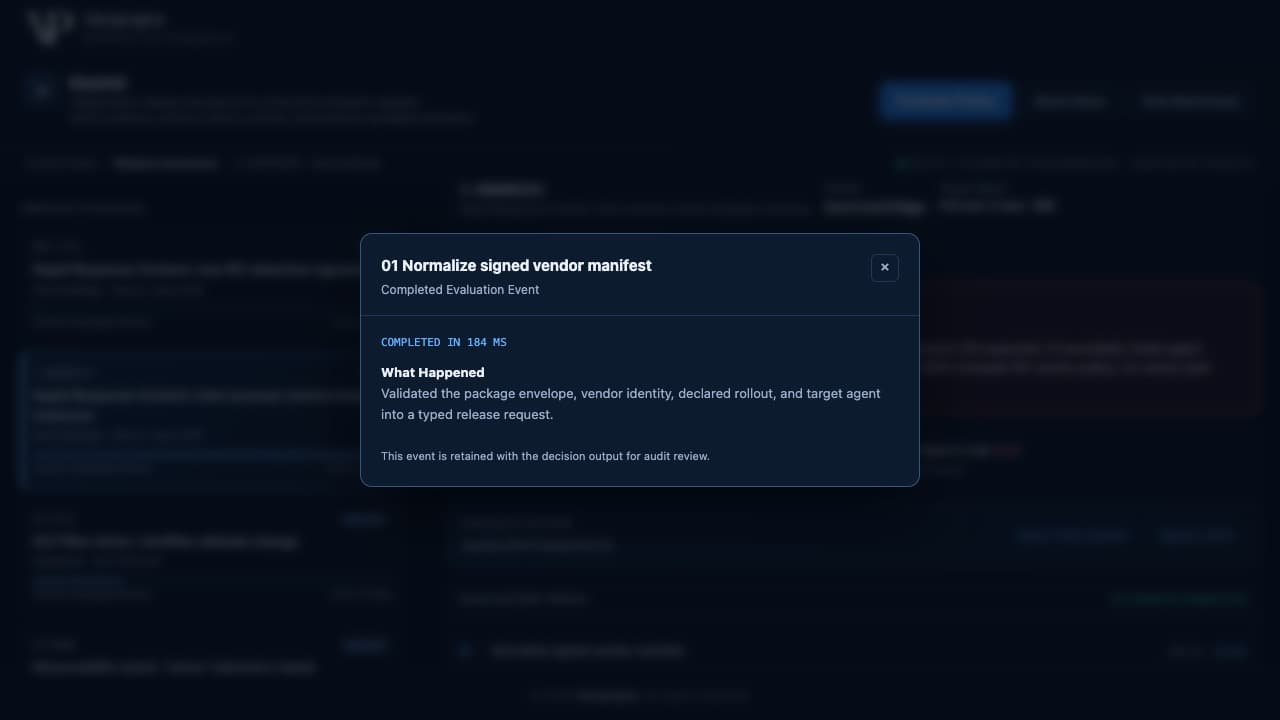
O rastreamento é a peça que subestimei até clicar em uma etapa individual. Um evento registra: "Normalizar manifesto assinado do fornecedor, concluído em 184 ms", e é retido com a saída da decisão para revisão de auditoria. Cada etapa é recalculável. Um regulador não precisa confiar cegamente no meu painel. Ele pode recalcular a aritmética e obter a mesma resposta.
Sou cuidadoso sobre o que a assinatura é e o que não é. Trata-se de um hash SHA-256 local, não de uma infraestrutura corporativa de chave pública (PKI). O feed de atualizações do fornecedor e os tickets de ITSM por trás dele são stubs de teste, não conectores em tempo real. O registro foi projetado para se alinhar aos requisitos regulatórios: a notificação tempestiva de incidentes exigida pelo CRA, a divulgação em até quatro dias úteis de incidentes cibernéticos materiais exigida pela SEC e as questões de responsabilidade de fornecedores levantadas no caso Delta v. CrowdStrike no condado de Fulton em 2025. Projetado para se alinhar com. Ele não certifica ninguém, não constitui assessoria jurídica, e quem lhe vender um registro de auditoria alegando que ele o torna em conformidade está apenas tentando lhe vender algo.
Há mais uma decisão da qual me orgulho, e é uma recusa. O caso XX-0000 é um blob de conteúdo proprietário criptografado que o gate não consegue analisar, portanto ele não faz suposições. Ele retorna ABSTAIN e encaminha para um operador humano, porque um gate que dá sinal verde para o que não consegue ler é pior do que gate nenhum. Hosts legados que o sandbox não pode modelar são sinalizados e excluídos, nunca presumidos seguros. O vocabulário é composto por quatro termos: ALLOW, HOLD, BLOCK, ABSTAIN, e este último é o que eu defenderia com mais vigor.
O que 12 de 12 tem o direito de significar
Preciso desacelerar aqui, porque é exatamente neste ponto que um fundador começa a arredondar para cima. E dei à empresa o nome de Veriprajna, «verdadeira sabedoria», portanto o arredondamento está fora de cogitação. Em um conjunto fixo e rotulado de doze atualizações, o gate toma a decisão correta em todas as doze. Seis delas são benignas e ele não bloqueia nenhuma. Uma delas corresponde ao honesto ABSTAIN. O placar exibe 12/12 decisões verificadas, 0/6 falsos bloqueios e US$ 13,3 milhões em tempo de inatividade evitado estimado em todo o conjunto, dos quais US$ 5 milhões decorrem do único bloqueio de classe CrowdStrike.
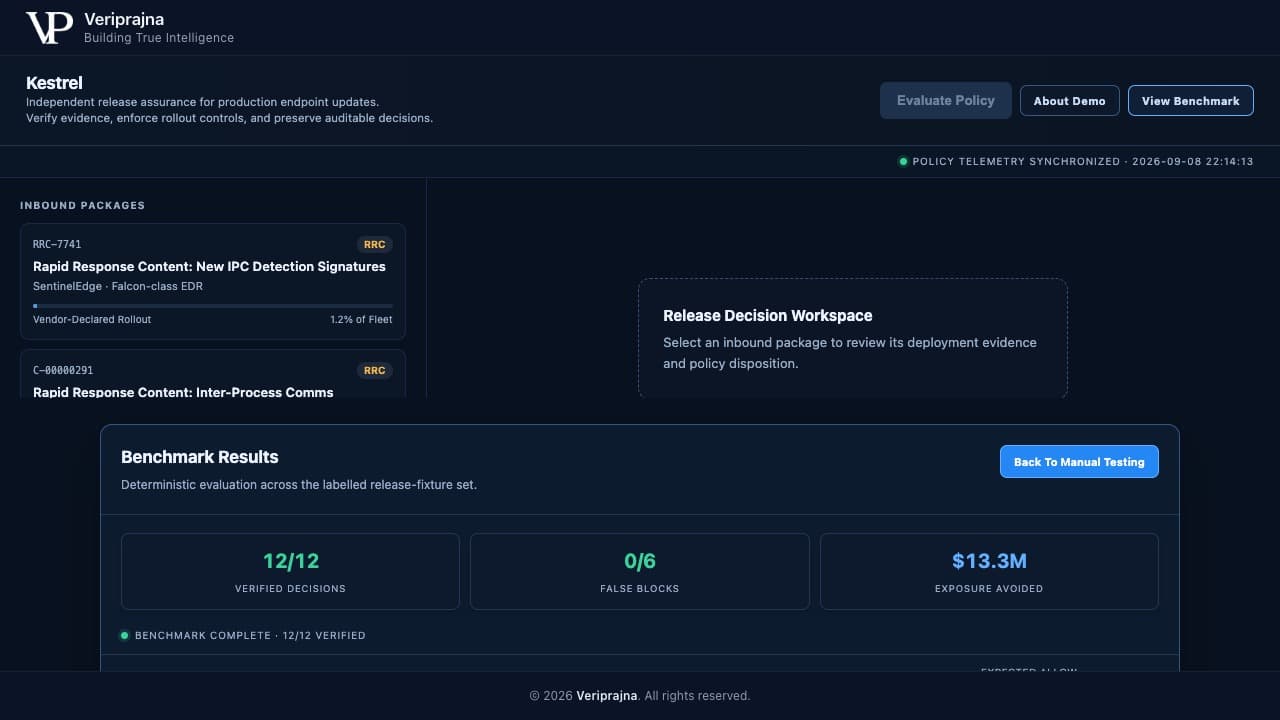
Agora a parte que me recuso a abreviar. São resultados em doze itens rotulados, não uma promessa sobre a próxima atualização que chegar à sua frota. Seis itens benignos são seis. Isso não significa «bloqueia 100% das atualizações ruins», nunca significará, e se algum dia você me flagrar escrevendo essa frase, deveria parar de me ler. O número que defendo é de outra natureza: mesma entrada, mesma decisão, em cada execução, porque o veredito não carrega temperatura de modelo. Execute o conjunto de testes novamente amanhã e ele retornará resultados idênticos byte a byte, o que permite auditar uma camada determinística de uma forma que jamais seria possível com uma camada probabilística.
A pergunta que permanece comigo
O que fica comigo após esta construção é o quão comum foi a falha. Vinte e um campos onde se esperavam vinte. Um número que qualquer verificador independente poderia ter capturado por pura aritmética antes que uma única máquina reiniciasse, caso houvesse um verificador independente posicionado entre o fornecedor e a frota. Não havia nenhum. Até hoje, na maioria das vezes, continua não havendo.
Toda empresa executa entre oito e doze agentes com privilégios de kernel provenientes de fornecedores que ela não controla, e cada um deles pode injetar um arquivo diretamente no ring 0. As ferramentas SBOM monitoram dependências de código aberto. A gestão de identidades monitora acessos. Ninguém lê a atualização proprietária do fornecedor na chegada para comprovar sua segurança. O Kestrel não é um EDR e nunca toca o kernel. Ele se posiciona acima desses agentes e governa o que eles têm permissão para distribuir. Essa é a camada que tentei construir, e o detalhamento completo está em veriprajna.com/demos/software-update-integrity.
E se você preferir ver isso em ação em vez de me ler descrevendo, aqui está o sistema completo funcionando de ponta a ponta.
Portanto, aqui está o que agora pergunto sobre cada frota que conheço: quando a próxima atualização de fornecedor chegar, o que estará entre esse arquivo e a produção, e isso é capaz de comprovar seu trabalho? Se a resposta for um comitê de aprovação de mudanças (CAB) que confia cegamente no fornecedor, então a aritmética que derrubou milhões de máquinas continua sendo executada sem qualquer verificação. Ela não se anunciará. Parecerá exatamente igual a todas as atualizações que vieram antes dela, até o exato instante da reinicialização.