A IA da Amazon ensinou a fazer um coquetel Molotov. Eu sei por quê.

Eu estava em uma ligação com um cliente em potencial — uma grande empresa de comércio eletrônico, não a Amazon, mas grande o suficiente — quando o vice-presidente de engenharia disse algo que me fez pousar minha xícara de café.
«Basicamente terminamos nosso assistente de IA. Só precisamos de alguém para ajustar os prompts».
Eu já tinha ouvido isso antes. A crença de que a IA corporativa é um problema de engenharia de prompts. De que basta pegar um modelo de fundação, envolvê-lo em um prompt de sistema que diz «seja útil, seja seguro, não diga nada estranho», apontá-lo para o seu catálogo de produtos e colocá-lo no ar. Eu costumava assentir educadamente quando as pessoas diziam isso. Depois de assistir ao lançamento do Rufus da Amazon implodir em 2024 — alucinando o local do Super Bowl, fornecendo instruções para a fabricação de armas incendiárias por meio de consultas comuns de produtos, e falhando em processar devoluções básicas —, parei de concordar com a cabeça.
«Vocês não terminaram», eu disse a ele. «Vocês nem sequer começaram».
O desastre do Rufus não foi um problema de relações públicas nem de qualidade de modelo. Foi um problema de arquitetura. E é o mesmo problema de arquitetura presente em quase todas as implantações de IA corporativa que auditei. O modelo funciona bem. O sistema ao redor dele é um castelo de cartas.
O que realmente deu errado com o Rufus da Amazon?
Aqui está o que a maioria das pessoas interpretou mal na cobertura do Rufus. As manchetes focaram nas respostas geradas: local errado do Super Bowl, instruções perigosas, devoluções travadas. Comentaristas culparam o modelo. «O GPT não está pronto para o comércio», diziam. «LLMs alucinam, o que vocês esperavam?».
Mas passei semanas dissecando os detalhes técnicos daquele lançamento, e o modelo não foi o principal ponto de falha. Foi a arquitetura de ancoragem (grounding).
Pense no que acontece quando você pergunta ao Rufus onde o Super Bowl será realizado. O sistema recupera trechos de texto da web — alguns atuais, alguns desatualizados, outros de postagens aleatórias em fóruns. Ele envia esses trechos para o modelo de linguagem. O modelo sintetiza uma resposta com base no que recebeu. Se o mecanismo de recuperação extraiu informações conflitantes, ou se os dados de treinamento do modelo (que possuem uma data de corte) contradiziam o texto recuperado, o modelo teve que tomar uma decisão arbitrária. E modelos de linguagem não tomam decisões arbitrárias. Eles fazem previsões estatísticas.
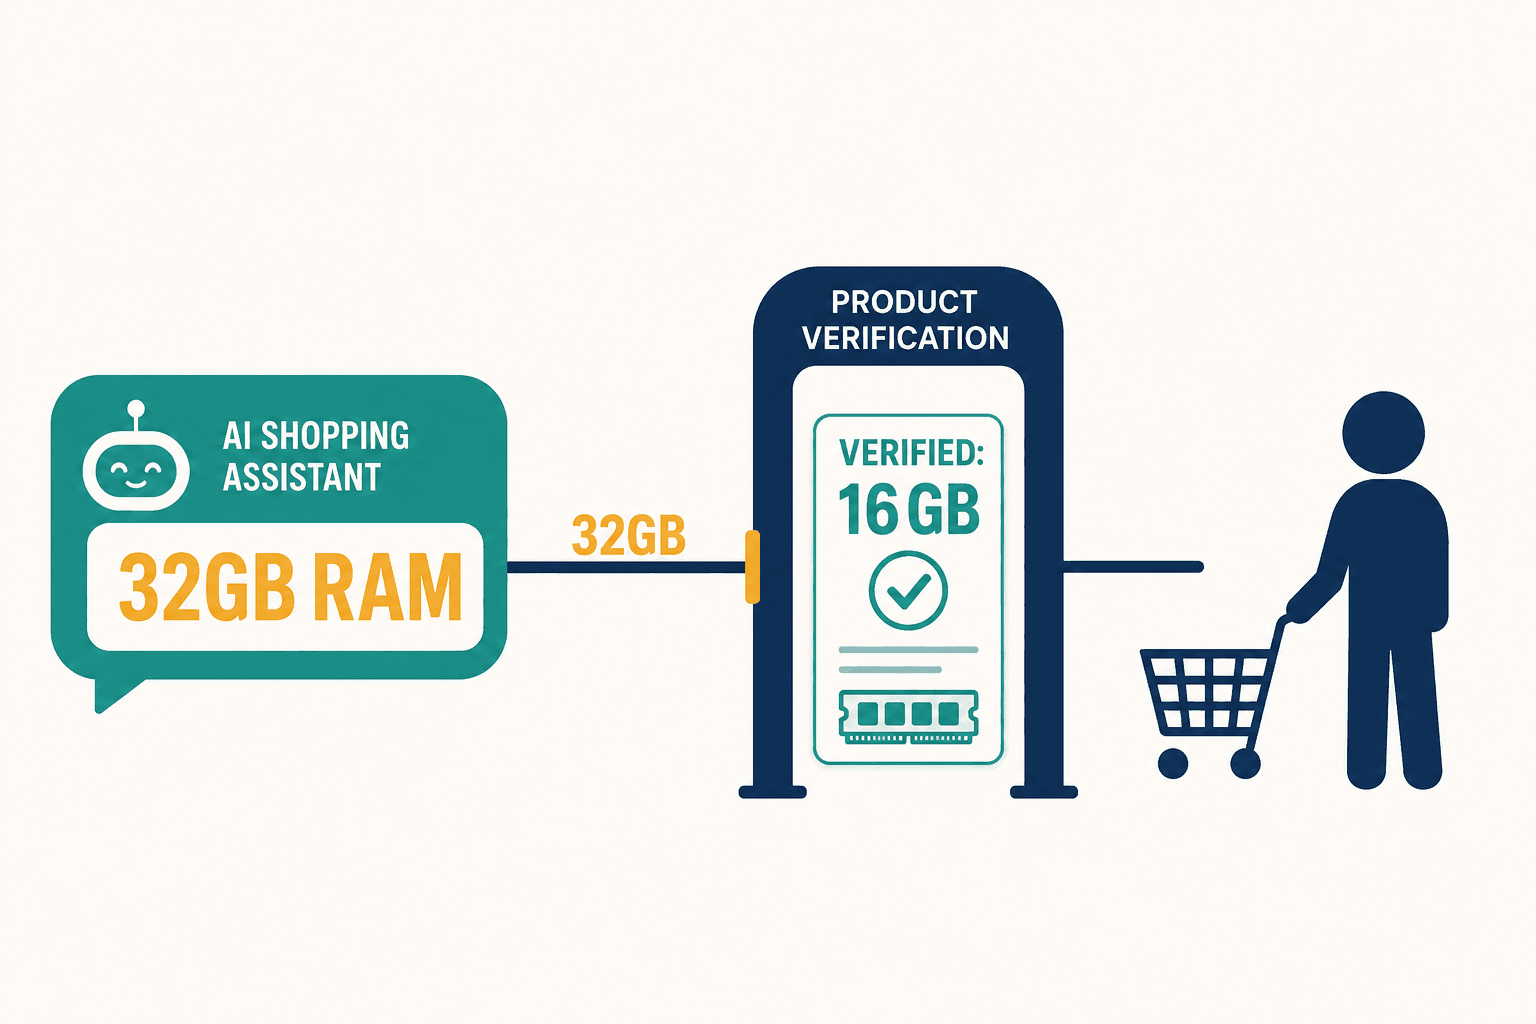
Não havia uma camada secundária de verificação. Nenhum grafo de conhecimento para cruzamento de dados. Nenhum sistema capaz de dizer: «Espere — o modelo acabou de afirmar que o Super Bowl é na Cidade X, mas nosso banco de dados de fatos verificados indica a Cidade Y». O palpite do modelo foi direto para o cliente.
Quando você constrói IA sem uma camada de verificação, não está construindo um assistente. Está construindo um mentiroso autoconfiante.
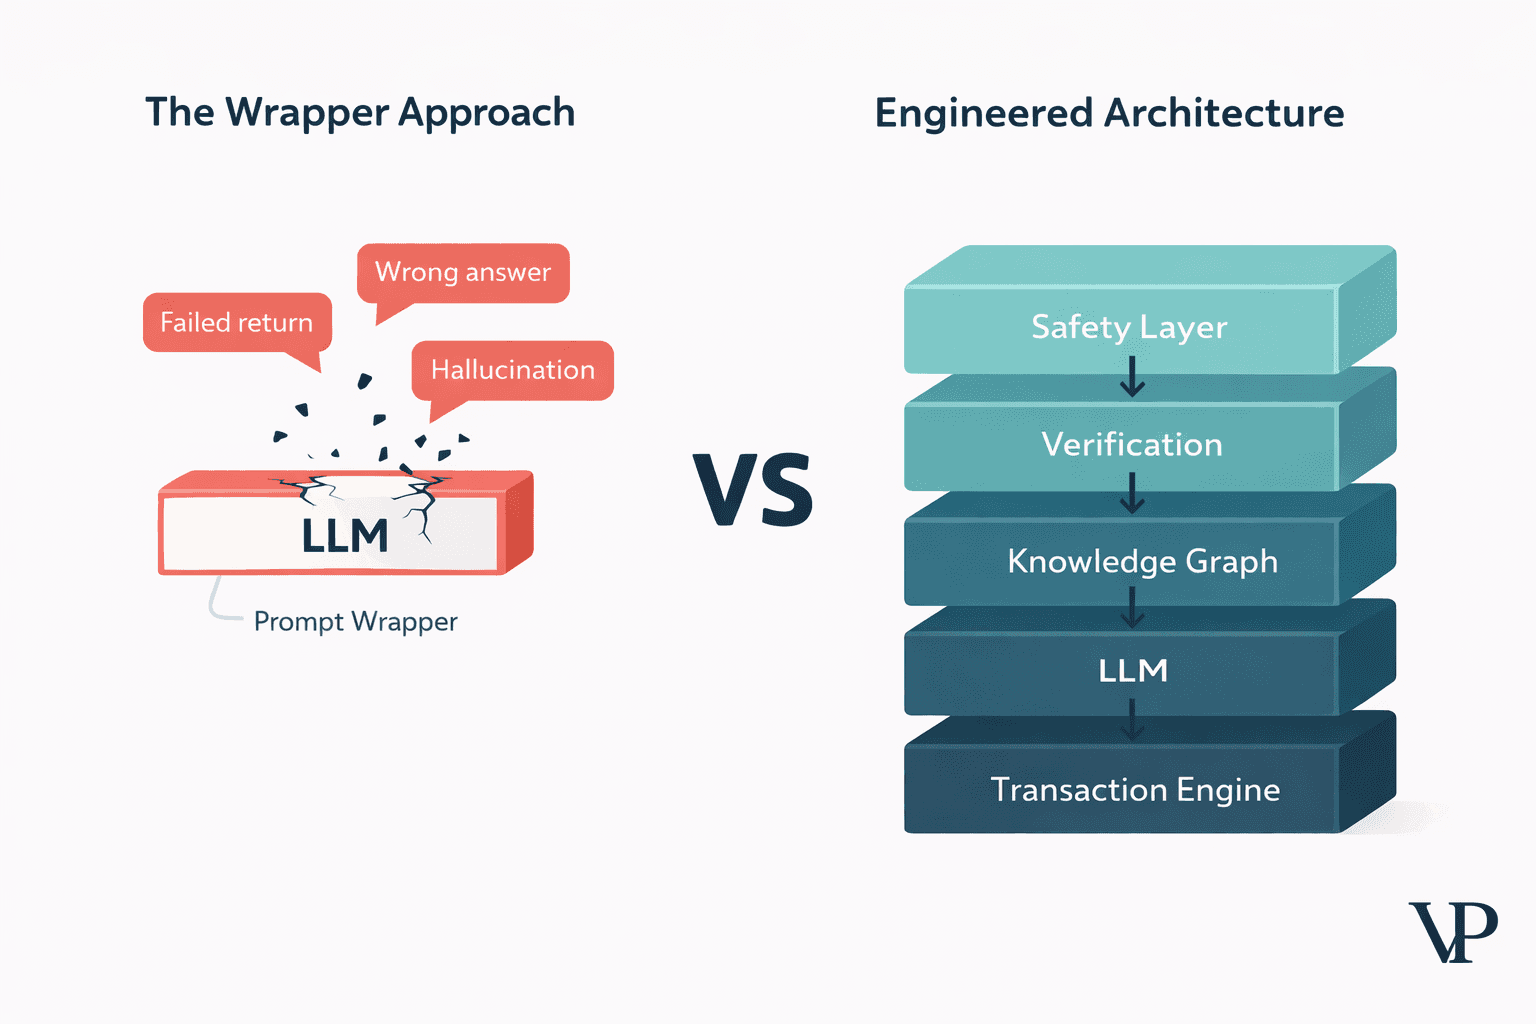
Esse é o problema central do que chamo de abordagem do «Wrapper de LLM». Você pega um modelo generativo poderoso, envolve-o em uma camada fina de software e reza.
A noite em que percebi que os prompts não podem salvar você
Lembro-me do momento exato em que a ficha caiu para mim. Estávamos construindo um protótipo para um cliente — não do varejo, mas de um setor onde respostas erradas trazem consequências reais. Tínhamos o que considerávamos um prompt de sistema impecável. Páginas de instruções. «Sempre cite suas fontes. Nunca especule. Se não tiver certeza, diga».
Eram 23h, e meu sócio e eu estávamos executando testes adversariais. Não jailbreaks sofisticados — apenas formulações ligeiramente incomuns de perguntas cotidianas. O tipo de frase que um usuário real digitaria às 2 da manhã quando está cansado e não escreve em um inglês padrão perfeito.
O sistema começou a confabular. Não de forma dramática — ele não instruiu ninguém a construir uma arma. Mas inventou um recurso de produto que não existia. Citou uma política de devolução de dois anos atrás. Deu uma resposta convicta a uma pergunta que deveria ter evitado responder.
Virei-me para meu sócio e disse: «O prompt é uma sugestão. O modelo o trata como uma sugestão». Ele olhou para os logs e respondeu: «Não. O modelo o trata como uma voz em uma sala cheia de vozes. E o contexto recuperado fala mais alto».
Foi exatamente isso que aconteceu no incidente de segurança do Rufus. O prompt de sistema dizia «não forneça informações prejudiciais». Mas a camada de recuperação já havia buscado conteúdo da web contendo essas informações e o injetado na janela de contexto do modelo. O modelo priorizou os dados recém-recuperados em detrimento de suas instruções de segurança. Nenhum jailbreak complexo foi necessário. Apenas uma consulta comum de produto que por acaso extraiu o conteúdo errado.
Segurança por meio de prompting não é segurança. É uma esperança.
Por que a IA não consegue processar minha devolução?
A terceira falha do Rufus — a incapacidade de lidar com consultas de status de pedidos ou devoluções — foi a que mais me frustrou, porque é a mais solucionável e, ainda assim, a mais comum.
O Rufus podia falar sobre políticas de devolução o dia todo. Podia explicar o prazo de 30 dias, descrever o processo, dizer quais itens eram elegíveis. O que ele não conseguia fazer era consultar seu pedido de fato e iniciar a devolução. Ele podia descrever o cardápio, mas não podia anotar seu pedido.
Isso é o que chamo de lacuna de ação (Action Gap), e ela existe porque a maioria das implantações de LLM é construída como sistemas de «entrada de texto, saída de texto». O processamento de uma devolução exige que a IA identifique o pedido correto em um banco de dados seguro, valide o prazo de devolução contra as regras de negócio vigentes e execute uma chamada de API que altere o estado e que seja totalmente bem-sucedida ou falhe completamente — nada de devoluções processadas pela metade.
Essa última parte é crítica. Na engenharia de bancos de dados, chamamos isso de conformidade ACID — Atomicidade, Consistência, Isolamento e Durabilidade. Significa que o sistema processa toda a devolução ou nada dela. Não se pode ter uma situação em que o reembolso é processado, mas o estoque não é atualizado, ou o cliente recebe uma confirmação, mas o backend nunca recebeu a solicitação.
Modelos de linguagem não têm noção de conformidade ACID. Eles geram texto. Não executam transações. E na arquitetura do Rufus, a camada de IA estava funcionalmente desconectada do backend transacional. O resultado foi o que passei a chamar de amnésia transacional (Transactional Amnesia) — o sistema promete uma ação, o cliente acredita que ela ocorreu, e nada realmente mudou no banco de dados.
Escrevi sobre esse padrão de falha e sobre as soluções arquiteturais em detalhes em nossa análise interativa.
A armadilha da velocidade sobre a qual ninguém fala
Aqui está um detalhe da arquitetura do Rufus que não virou manchete, mas explica muita coisa. Durante o Prime Day, os sistemas da Amazon precisam lidar com milhões de consultas por minuto com um tempo de resposta meta de 300 milissegundos. Para atingir essa marca, a equipe do Rufus implementou decodificação paralela em chips de IA personalizados da AWS — uma técnica em que o modelo prevê várias palavras futuras simultaneamente, em vez de gerá-las uma a uma.
Isso dobrou a velocidade de inferência. Também introduziu o que eu chamaria de deriva semântica (Semantic Drift).
Quando você prevê múltiplos tokens em paralelo, está essencialmente adivinhando para onde a frase vai antes de concluir o raciocínio atual. Um mecanismo de verificação checa se essas previsões são coerentes, mas se essa verificação for ajustada agressivamente para priorizar a velocidade — o que é indispensável ao atender 300 milhões de clientes —, casos limítrofes passam despercebidos. Frases gramaticalmente impecáveis, mas factualmente desvinculadas dos dados de origem.
A alucinação do Super Bowl carrega todas as marcas dessa concessão. O sistema foi otimizado para a plausibilidade — isso soa convincente? — em vez da verdade — isso está de fato correto?.
A IA corporativa vive um paradoxo entre latência e precisão: quanto mais rápido você precisa dela, menos pode confiar nela — a menos que reprojete a arquitetura.
Na Veriprajna, tomamos uma decisão deliberada desde o início pela qual fui criticado. Miramos entre 500 e 800 milissegundos em vez de 300. Esse tempo extra nos dá uma verificação multicamadas — uma etapa de consenso em que modelos especializados cruzam a saída do modelo generativo antes que ela chegue ao usuário. Um investidor me disse certa vez: «Os usuários não vão esperar 800 milissegundos». Respondi que os usuários não voltam após uma única resposta errada. Quarenta e cinco por cento dos consumidores já preferem o atendimento humano à IA por receios quanto à precisão. A corrida pela velocidade é uma corrida para o fundo do poço se a precisão não a acompanhar.
«Esta jaqueta lavável na máquina?»
Há um modo de falha nos dados do Rufus que me assombra pela sutileza com que causa danos. Um estudo da Cornell Tech revelou que o Rufus teve um desempenho significativamente pior quando os usuários escreviam em inglês afro-americano, inglês chicano ou inglês indiano. Quando alguém perguntava «this jacket machine washable?» — omitindo o verbo de ligação, traço comum do inglês afro-americano —, o sistema falhava em responder adequadamente ou direcionava o usuário a produtos não relacionados.
Essa não é uma preocupação secundária. Estamos falando de um sistema que atende a 250 milhões de clientes em todo o mundo, fornecendo sistematicamente um serviço inferior às pessoas com base na forma como elas falam.
A raiz técnica é direta: os modelos de linguagem são treinados esmagadoramente com textos em inglês americano padrão. As variações dialetais são tratadas como ruído ou ambiguidade, e não como padrões linguísticos válidos com significado claro. Mas a correção não é nada trivial. Não basta adicionar dados dialetais ao conjunto de treinamento e dar o assunto por encerrado. Você precisa do que chamamos de auditoria consciente de dialetos (Dialect-Aware Auditing) — uma camada que normaliza a sintaxe de entrada sem perder a intenção do usuário, combinada com rotinas periódicas de red teaming em diversos contextos linguísticos.
Construímos isso em nosso framework não porque um cliente pediu, mas porque uma de nossas engenheiras — que cresceu alternando entre o inglês com sotaque de hindi em casa e o inglês «profissional» no trabalho — apontou que estávamos testando nossos sistemas exclusivamente em inglês formal de livro didático. «Vocês estão construindo para pessoas que escrevem como manuais de documentação», disse ela. Ela tinha toda razão. Era exatamente o que fazíamos.
Como realmente é um sistema confiável?
Depois da análise pós-incidente do Rufus, depois das noites em claro testando nossos protótipos, depois de discussões com investidores que insistiam «basta usar o GPT com um bom prompt», minha equipe e eu chegamos a uma arquitetura que chamamos de neuro-simbólica (Neuro-Symbolic) — um sistema que trata o modelo de linguagem como um componente poderoso, mas não autoritativo.
A palavra-chave é não autoritativo. O LLM é brilhante em entender o que você pergunta e gerar respostas fluentes. Ele é péssimo em discernir se o que diz é verdadeiro, seguro ou executável. Portanto, não permitimos que ele dê a palavra final sobre nada.
Como impedir uma IA de alucinar fatos?
A geração aumentada por recuperação (RAG) tradicional busca textos visualmente semelhantes à pergunta. Nossa abordagem — Citation-Enforced GraphRAG — busca relações semânticas em um grafo de conhecimento. A diferença é monumental.
Em nosso sistema, o LLM não pode fazer uma afirmação a menos que consiga traçar um caminho em dados verificados que a sustentem. Quer recomendar uma TV para jogos? O sistema precisa vincular o produto específico ao recurso exato — taxa de atualização de 120Hz — no grafo. Se o modelo tentar inventar um atributo ausente do grafo, a camada de verificação o intercepta antes da geração da resposta. Não depois. Antes.
Isso soluciona diretamente o que pesquisadores chamam de problema «Lost in the Middle», no qual os LLMs ignoram informações no meio de extensas janelas de contexto. Quando seus dados residem em um grafo estruturado, e não em um bloco denso de texto recuperado, não há onde se perder.
Por que não usar apenas um único modelo excelente?
As pessoas me perguntam isso constantemente. «O GPT-5 será bem melhor. É só esperar». Talvez. Mas o problema de arquitetura não desaparece com um modelo melhor. Um carro mais veloz sem freios continua sendo perigoso.
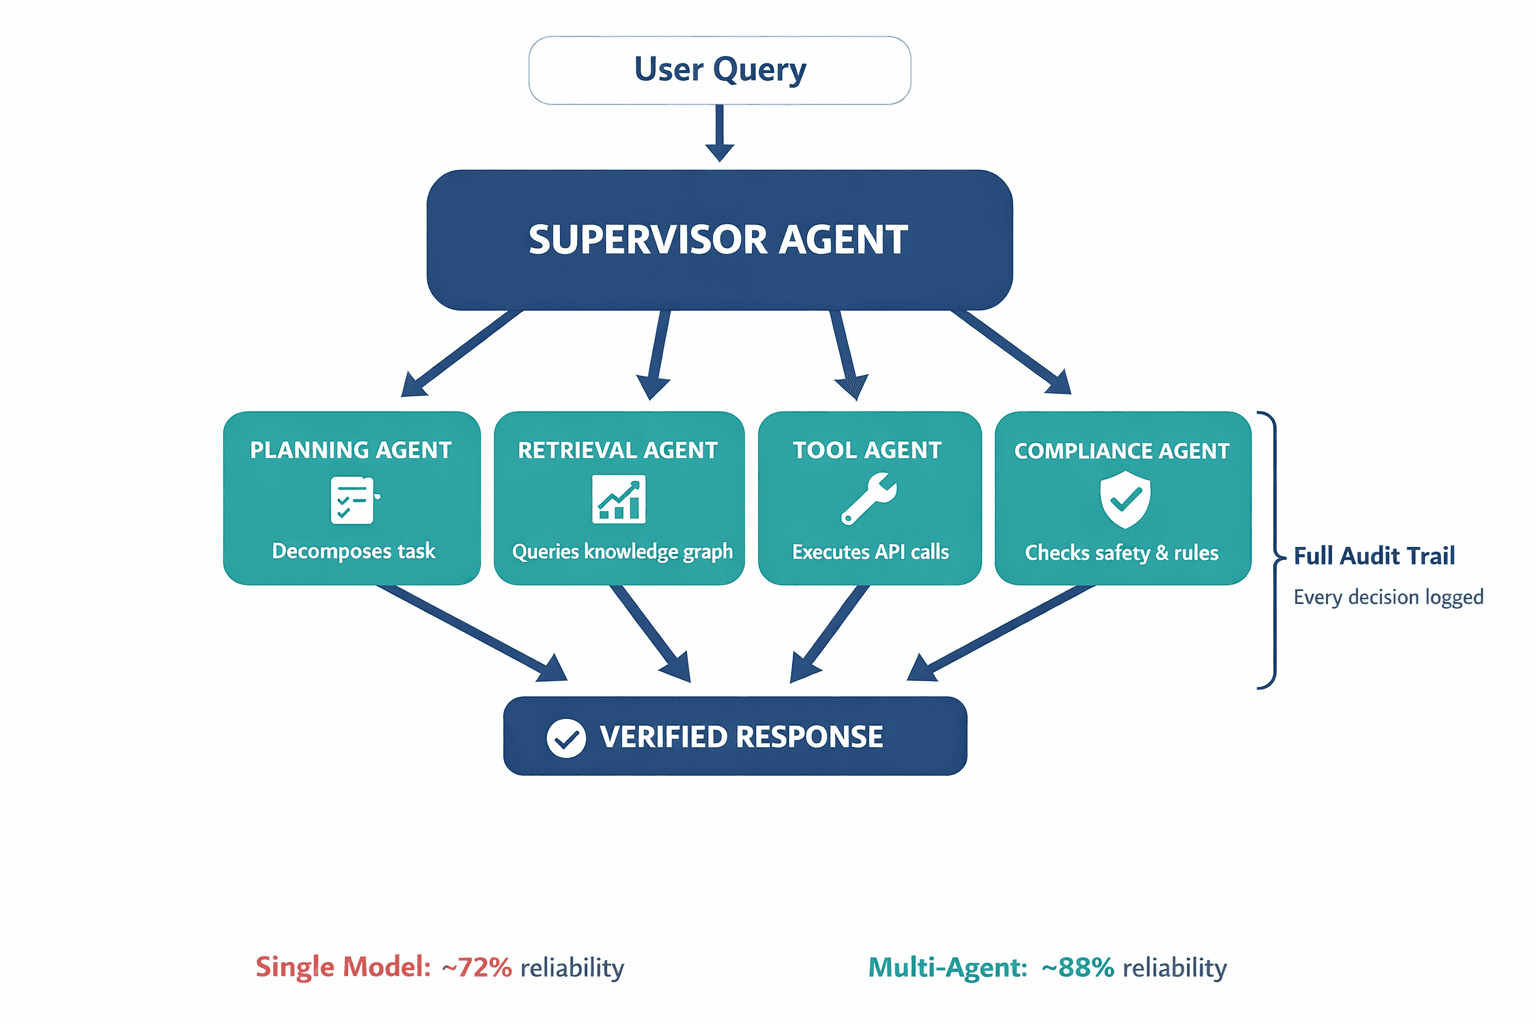
Em vez de um único modelo tentar fazer tudo, nós implantamos um sistema multiagente (Multi-Agent System) — um agente supervisor que encaminha a intenção do usuário para especialistas. Um agente de planejamento decompõe a tarefa. Um agente de recuperação consulta o banco de dados adequado. Um agente de ferramentas executa a chamada de API. Um agente de conformidade valida a resposta em relação a regras de segurança e de negócios.
Essa divisão de trabalho aumentou nossa confiabilidade de cerca de 72% — índice alcançado em produção por abordagens padrão de modelo único — para aproximadamente 88%. E crucialmente: cria uma trilha de auditoria completa. Quando um órgão regulador ou cliente pergunta «por que a IA disse isso?», podemos demonstrar exatamente qual agente tomou qual decisão, com base em quais dados. Tente fazer isso com um modelo único e um prompt de sistema.
Para a análise técnica completa dessa arquitetura, incluindo as camadas de verificação e o modelo formal de confiabilidade, consulte nosso artigo de pesquisa.
O sanduíche que salva as transações
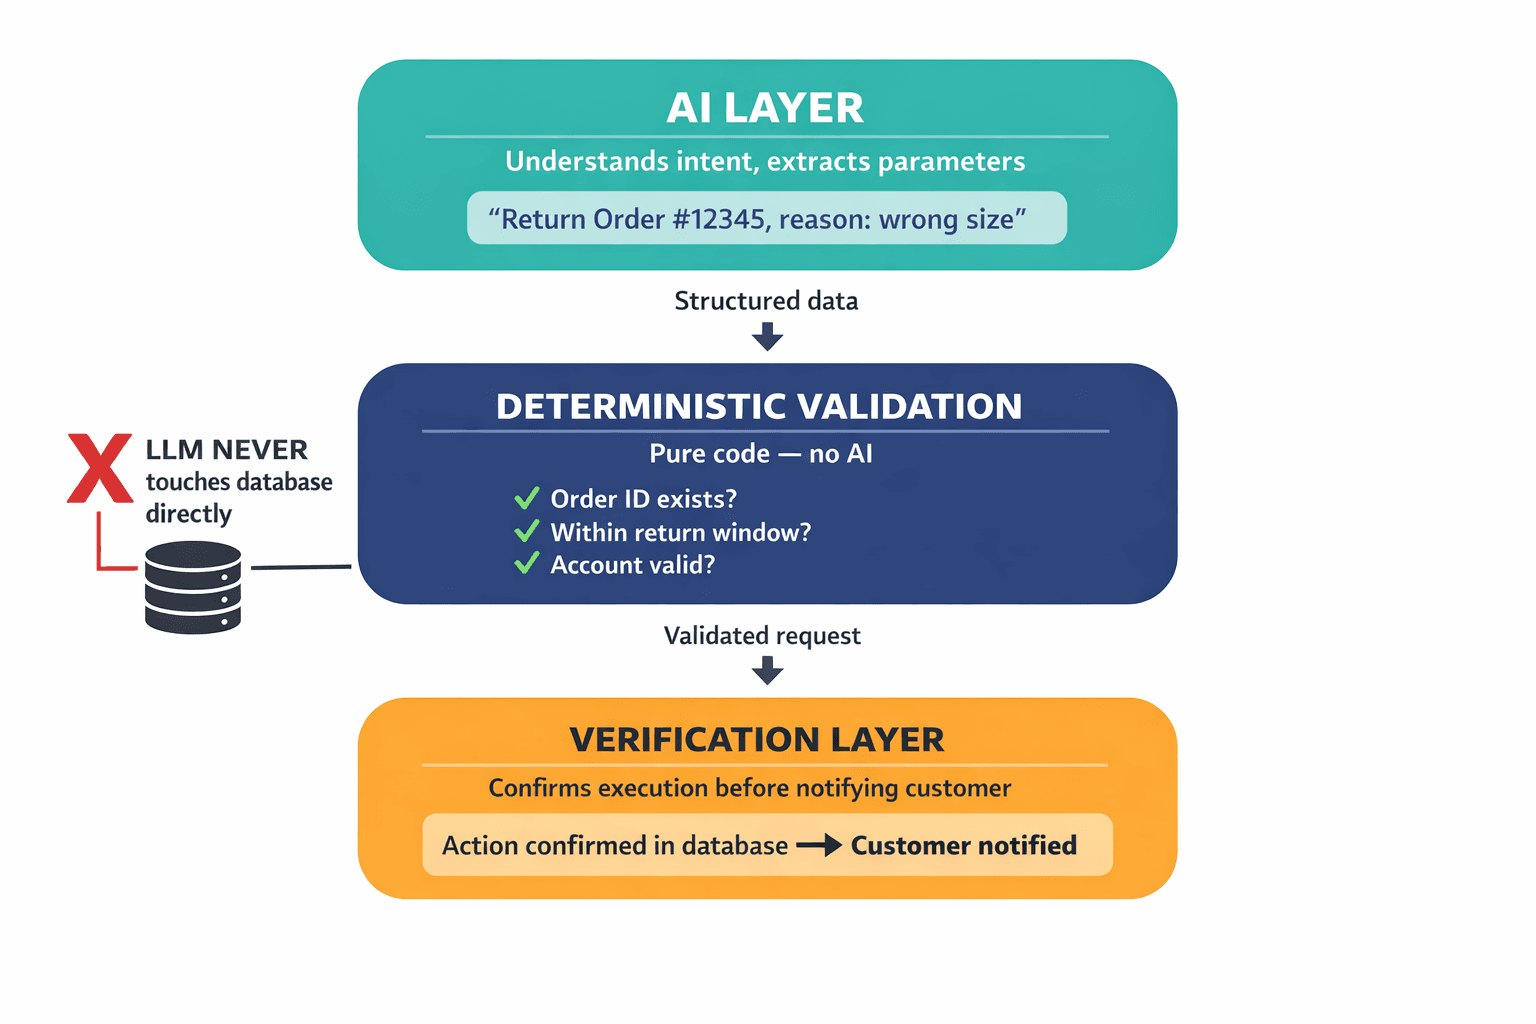
Para a lacuna de ação — a incapacidade de realmente fazer coisas como processar devoluções —, usamos o que chamo de arquitetura sanduíche (Sandwich Architecture), e reconheço que este não é o nome mais solene para um padrão de engenharia sério.
A camada superior é a IA: ela compreende o que você deseja e extrai parâmetros estruturados. «Processar devolução para o pedido #12345, motivo: tamanho incorreto». A camada intermediária é código determinístico puro: ela valida esses parâmetros contra o banco de dados real. Esse ID de pedido realmente existe? Está dentro do prazo de devolução? A conta desse cliente existe? A camada inferior é a verificação: um sistema independente confirma que a ação foi realmente concluída com êxito antes de avisar o cliente.
O modelo de linguagem nunca toca o banco de dados diretamente. Ele nunca executa uma transação. Ele traduz a intenção em dados estruturados e a entrega a sistemas projetados para integridade transacional décadas antes do surgimento dos LLMs. O modelo faz o que sabe fazer de melhor. O banco de dados faz aquilo em que ele é excelente. Ninguém finge ser o que não é.
O problema do coquetel Molotov é um problema de design
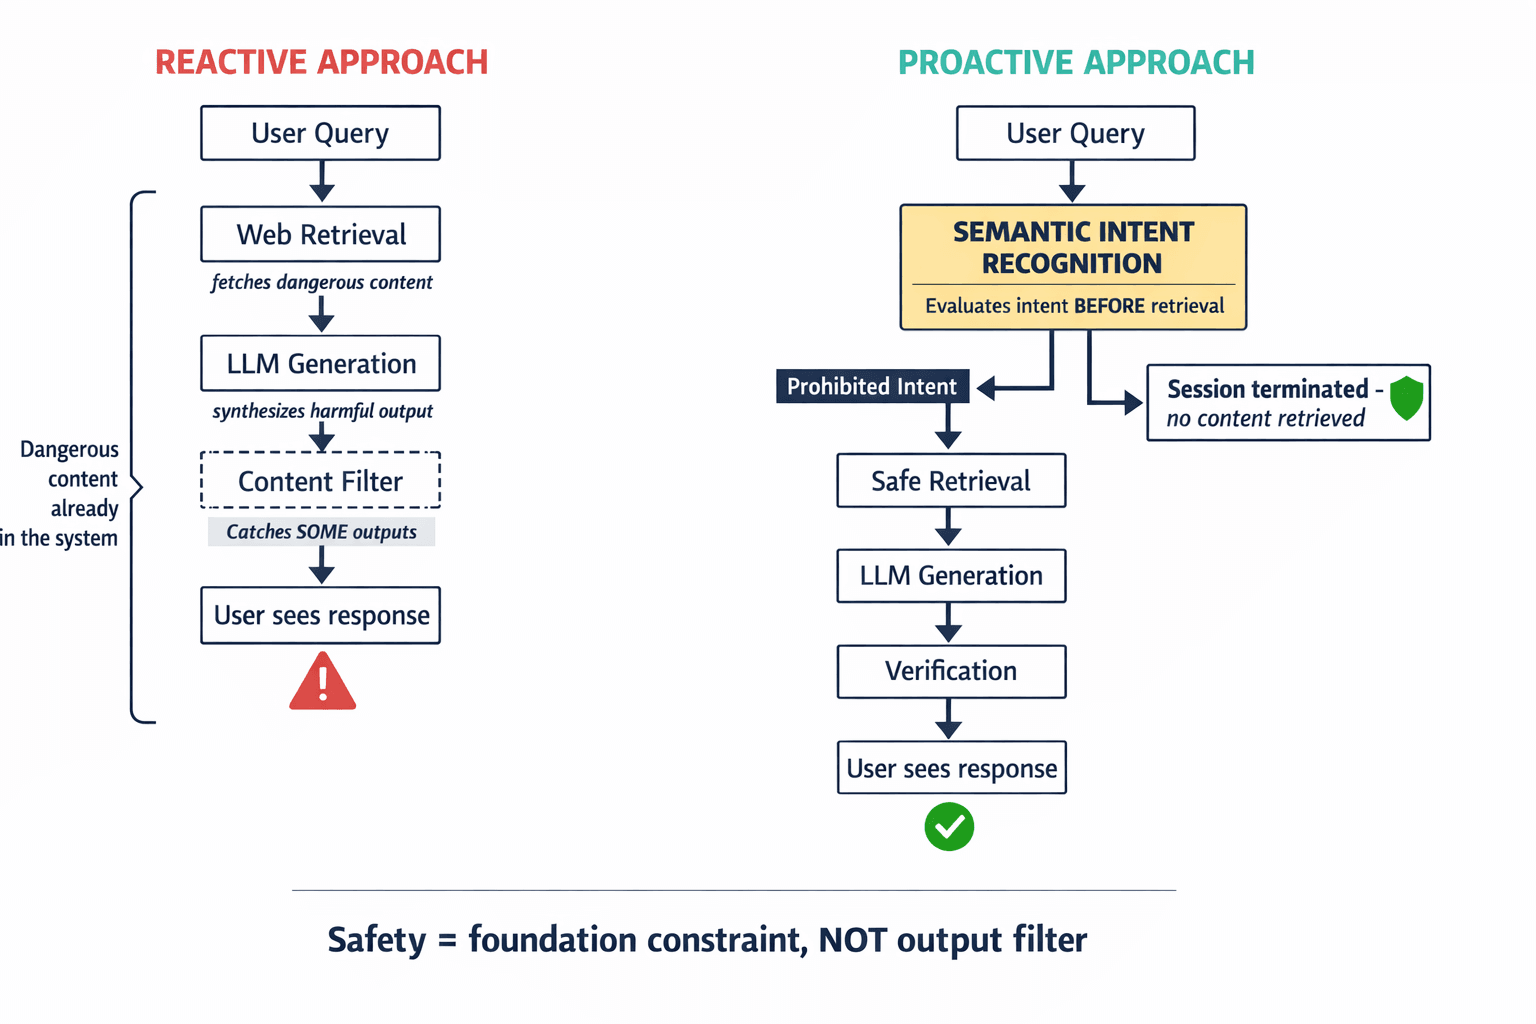
Quero voltar à falha de segurança, pois considero que ela revela algo fundamental sobre como a indústria encara os riscos da IA.
Após o incidente, as atenções se voltaram para filtros de conteúdo mais eficazes. Bloqueio de palavras-chave mais rigoroso. Ajustes finos de segurança mais agressivos. Todas medidas reativas — tentativas de barrar respostas nocivas depois que o modelo já as produziu.
Nossa abordagem é diferente. Implementamos o que considero como reconhecimento de intenção semântica (Semantic Intent Recognition) logo na etapa de entrada. Antes mesmo que a camada de recuperação busque dados na web, um agente de segurança analisa a intenção semântica da consulta. Se a intenção se enquadrar em uma categoria proibida — fabricação de armas, automutilação, atividades ilícitas —, a sessão é encerrada antes de qualquer conteúdo ser extraído.
Isso faz toda a diferença porque o caso do Rufus não exigiu nenhum jailbreak. O usuário fez uma pergunta aparentemente trivial sobre produtos. O sistema de recuperação, varrendo fielmente a web aberta, trouxe conteúdos que por acaso continham instruções perigosas. O modelo, sintetizando fielmente o conteúdo recuperado, apresentou tais instruções ao usuário. Cada componente fez exatamente aquilo para o qual foi projetado. O design foi o problema.
Segurança não é um filtro adicionado ao final. É uma restrição embutida nos alicerces. Se a sua IA tem capacidade de recuperar conteúdo perigoso, ela acabará por fornecer conteúdo perigoso em algum momento.
A matemática desconfortável
O CEO da Amazon estimou 10 bilhões de dólares em vendas incrementais proporcionadas pelo Rufus. Esse montante depende integralmente do que chamo de confiança de conversão (Conversion Confidence) — a probabilidade de um cliente confiar nas recomendações da IA a ponto de clicar em «Comprar». Cada alucinação, cada devolução com erro e cada ausência de resposta por viés dialetal corrói essa confiança.
A abordagem de wrapper é mais barata inicialmente. Não vou fingir o contrário. É possível lançar um wrapper de LLM em poucas semanas. Nossa arquitetura demanda meses. A primeira fase é uma auditoria de dados: limpar bases internas, consolidando a verdade fundamental para produtos e diretrizes. A segunda fase é a implantação da infraestrutura multiagente e do grafo de conhecimento. A terceira fase é a engrenagem de feedback, na qual o retorno humano das equipes de atendimento ao cliente refina continuamente a precisão dos agentes.
Mas eis o cálculo crucial: para um grande varejista, o prejuízo à reputação de uma única manchete como «IA ensina cliente a fabricar arma» supera com folga o orçamento total de um sistema devidamente planejado. Os 45% de consumidores que já desconfiam dos assistentes de IA não serão reconquistados por tempos de resposta mais rápidos. Eles voltarão para sistemas que sejam corretos.
A era do wrapper chegou ao fim
Passei os últimos dois anos vendo empresas repetirem o mesmo erro em ritmo acelerado. Elas veem a demonstração, ficam encantadas com a eloquência, publicam o wrapper e passam o ano seguinte pedindo desculpas pelos resultados gerados. O modelo base — seja GPT-4, Gemini, Claude ou o que vier a seguir — nunca foi o diferencial competitivo. A arquitetura ao redor dele sempre foi.
Um modelo de linguagem é como uma máquina a vapor. Excessivamente poderoso, capaz de transformar setores inteiros. Mas uma máquina a vapor sem pistões, válvulas e reguladores nada mais é que uma explosão prestes a acontecer. A engenharia que canaliza e disciplina essa força — as camadas de verificação, os grafos de conhecimento, a orquestração de agentes, a integridade transacional — é o que separa uma mera demonstração de um produto comercial de verdade.
As empresas que compreenderem isso vão capturar valor. As que continuarem envolvendo modelos em prompts e rezando continuarão virando manchetes negativas. Eu tenho muita clareza de que lado dessa divisão estou construindo.