Uma câmera automatizada seguiu uma cabeça careca durante todo um jogo de futebol. Construí o gate de física que diz não.

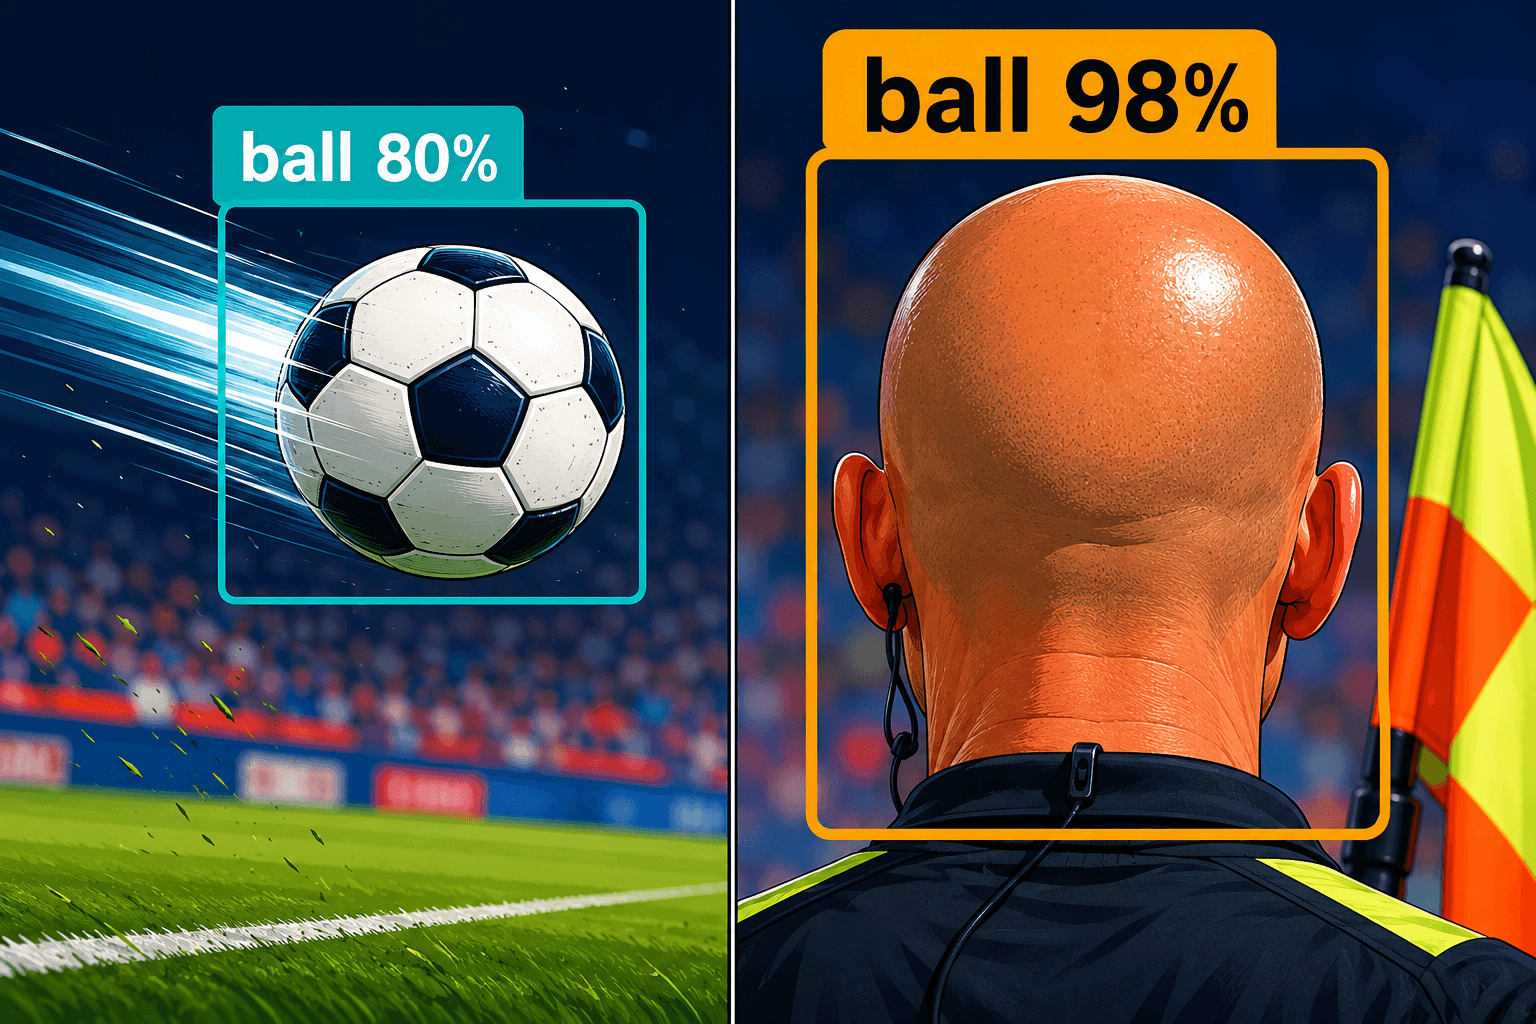
Em outubro de 2020, uma câmera automatizada no Inverness Caledonian Thistle passou grande parte de uma partida de futebol rastreando a cabeça careca de um bandeirinha em vez da bola. Sob os refletores, a cabeça brilhava como uma bola, a câmera Pixellot seguiu a detecção de maior confiança que recebeu, e os telespectadores em casa assistiram a um longo e persistente close-up de um homem careca trotando pela linha lateral enquanto a partida acontecia fora de quadro (documentado em nossa página da solução WP43).
Essa história me acompanhou durante todo este desenvolvimento, porque é o retrato mais claro que conheço de uma falha que todos em visão computacional já sentiram e quase ninguém nomeia corretamente. O detector não estava quebrado. Ele fez exatamente o que um detector faz. Avaliou uma região de pixels, o brilho na cabeça recebeu uma pontuação alta e todos os sistemas posteriores confiaram nessa pontuação. O Plumbline, a demonstração que construí, está disponível em https://veriprajna.com/demos/physics-constrained-computer-vision, e tudo nele é um único argumento: a solução não está dentro do detector.
O momento em que parei de culpar o modelo
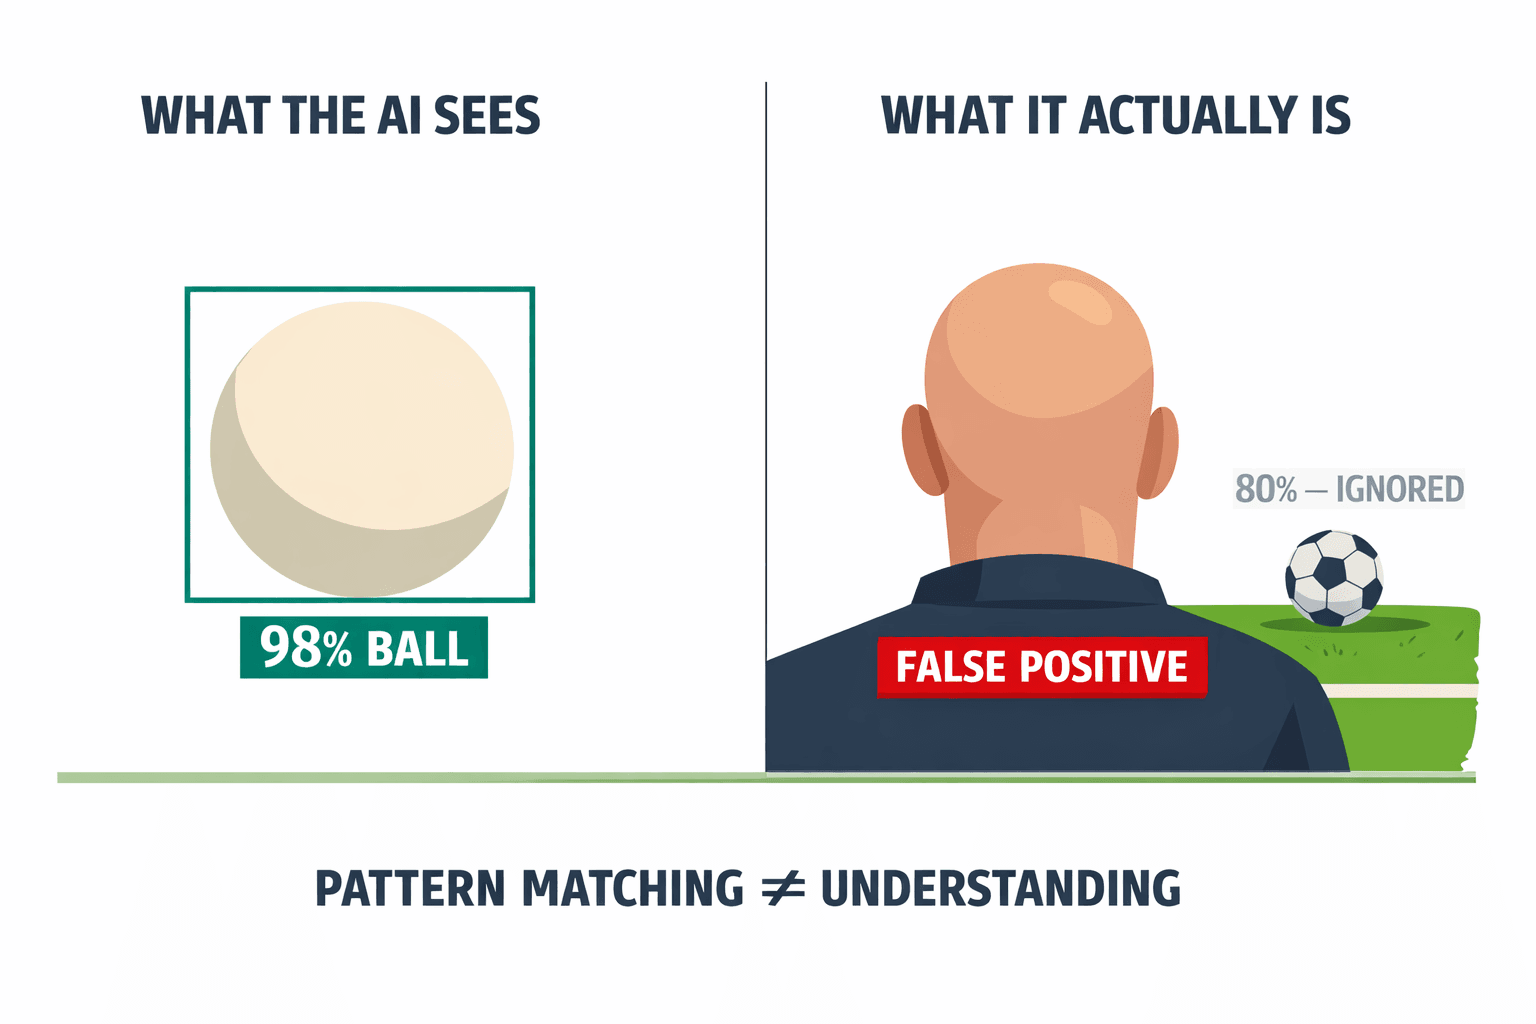
Passei o primeiro dia tentando imaginar um detector melhor, e não consegui fazer o problema desaparecer. Um detector de objetos é independente de quadros. Ele avalia cada imagem por textura e formato, sem memória de onde um objeto real estava um instante atrás ou de onde ele pode estar fisicamente a seguir. Portanto, sob a iluminação de um estádio, uma cabeça careca é localmente uma bola excelente. Você pode treinar um modelo mais preciso e ele ainda assim, no quadro em que o brilho atinge o pico, entregará uma bola com 98% de confiança na cabeça de um homem. A confiança não está mentindo sobre os pixels. Ela está respondendo a uma pergunta que nada tem a ver com a possibilidade de uma bola estar ali.
Foi aí que a perspectiva mudou para mim.
Seu sistema de visão não tem um problema de confiança. Ele tem um problema de física.
Uma bola de verdade obedece a restrições que uma cabeça careca não obedece, e nenhuma dessas restrições reside na pontuação do detector. Essa única mudança de perspectiva definiu toda a arquitetura. Parei de tentar deixar o detector mais inteligente e comecei a construir uma camada que atua depois dele e impõe a física que o detector nunca conheceu.
Como é o "fisicamente impossível" no código
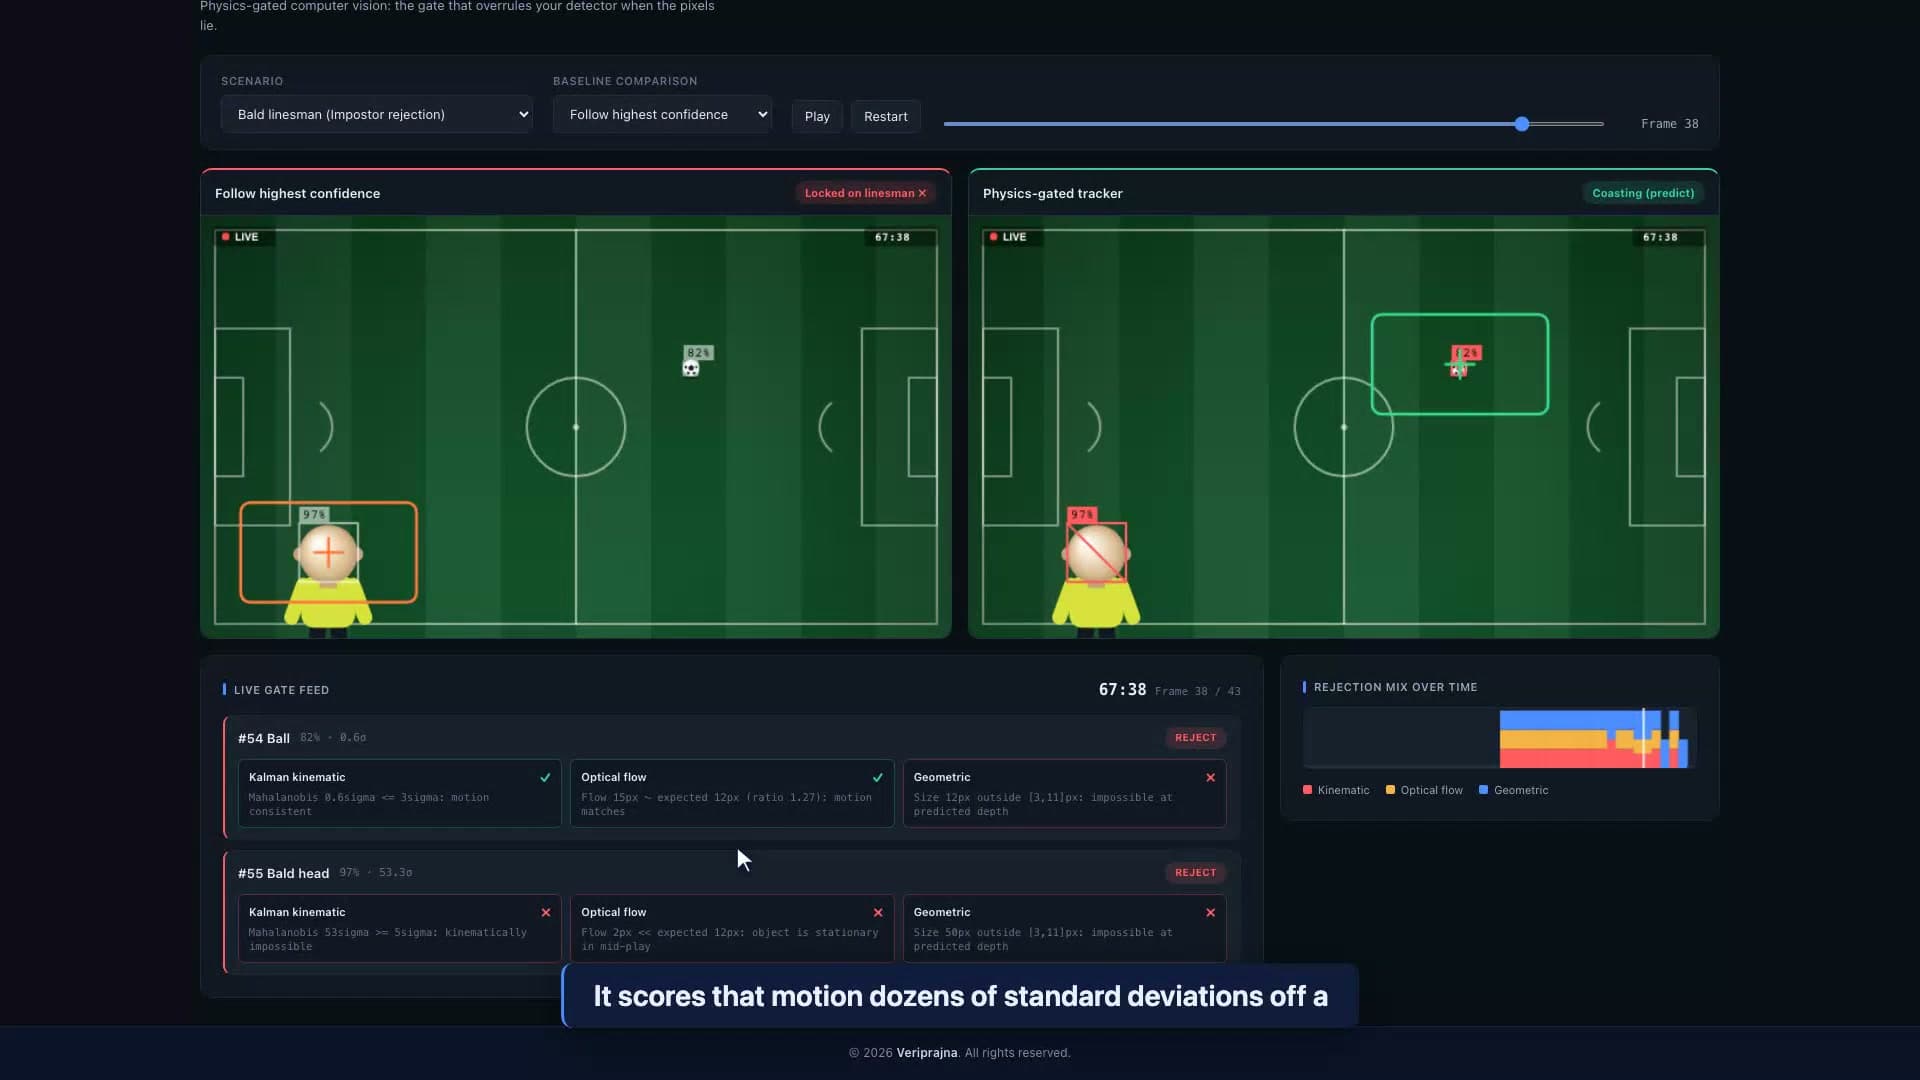
Eu queria ver uma detecção ser rejeitada por um motivo que pudesse ler em linguagem simples, então foi isso que construí primeiro. O Plumbline atua depois de qualquer detector e executa três gates determinísticos em cada candidato antes que qualquer ação seja tomada. O gate cinemático usa um filtro de Kalman — um Unscented Kalman Filter no trajeto sintético com um modelo de movimento de projétil — para prever onde uma bola real pode estar a seguir, medindo em seguida a que distância cada candidato fica dessa previsão como uma distância de Mahalanobis: aceita abaixo de 3 sigma, rejeita acima de 5 sigma e sinaliza a faixa de 3 a 5 sigma para revisão. O gate de fluxo óptico compara o movimento local de pixels do candidato com a velocidade esperada da trajetória e rejeita uma "bola" cujo fluxo aponta na direção errada ou que quase não se move durante o jogo aberto. O gate geométrico usa um modelo pinhole para estimar quantos pixels uma bola de 22 cm pode subtender na profundidade implícita do candidato e descarta tamanhos que não podem ser reais.
Nenhum deles é um modelo. São puro numpy e scipy que você pode ler linha por linha, fora de qualquer rede neural, e essa é a razão pela qual confio neles. A confiança aqui não depende de uma caixa-preta se explicando depois do ocorrido.
A cabeça careca falha nos três gates de uma só vez. Inseri esse impostor deliberadamente, como uma reprodução do incidente de Inverness em 2020 em vez de um erro orgânico fortuito, porque o caso que quebra uma câmera é exatamente aquele que nunca aparece no conjunto de testes de um detector. No pior quadro do clipe sintético, a cabeça atinge 82.3 sigma de desvio em relação ao movimento previsto da bola, o que não é uma dúvida limítrofe: é cinematicamente absurdo. A bola real, com 0.87 de confiança e 0.4 sigma, passa com facilidade e a câmera permanece nela.
Cada rejeição deixa um motivo registrado
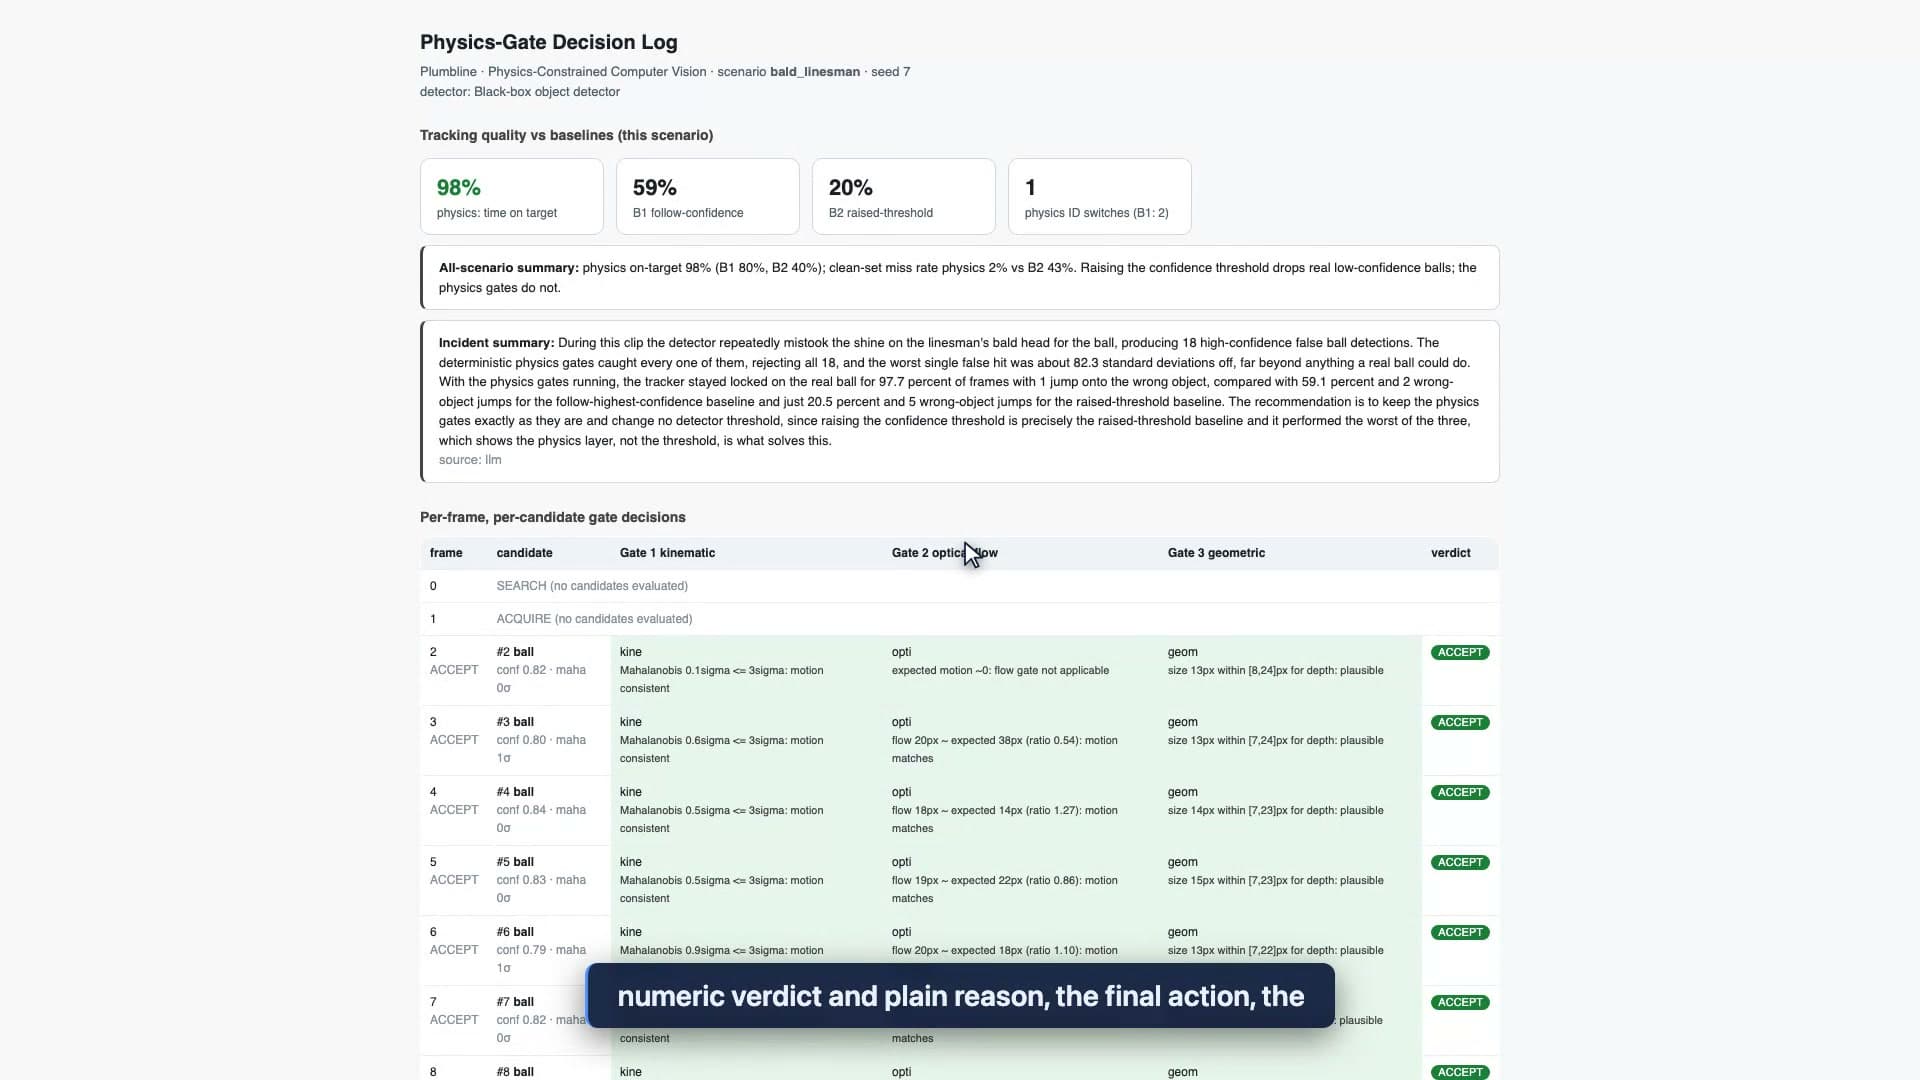
Eu não queria que nada disso fosse algo aceito por fé, então cada decisão grava um registro que você pode abrir. O log de decisões exportado traz a semente, o cenário, o identificador do detector e os limites dos gates no topo; em seguida, uma linha por quadro por candidato: a classe e a confiança emitidas pelo detector, o veredito numérico de cada gate com sua justificativa em linguagem clara ("Mahalanobis 82 sigma >= 5 sigma: kinematically impossible") e a ação final. No cenário do bandeirinha careca, os gates rejeitam todas as 18 detecções falsas de alta confiança do impostor, e o rastreador de física mantém a bola 97.7% do tempo, contra 59.1% do método de seguir a maior confiança e 20.5% de um limite elevado (cena sintética, semente 7).
Para qualquer pessoa com responsabilidade por uma decisão visual automatizada, esse registro é a diferença entre um relatório de incidente e um mero dar de ombros. Ele foi projetado para ser uma evidência arquivável de por que a câmera fez o que fez — não um certificado de conformidade, apenas o motivo físico, registrado, quadro a quadro.
Aumentar o limite de confiança é o ajuste errado
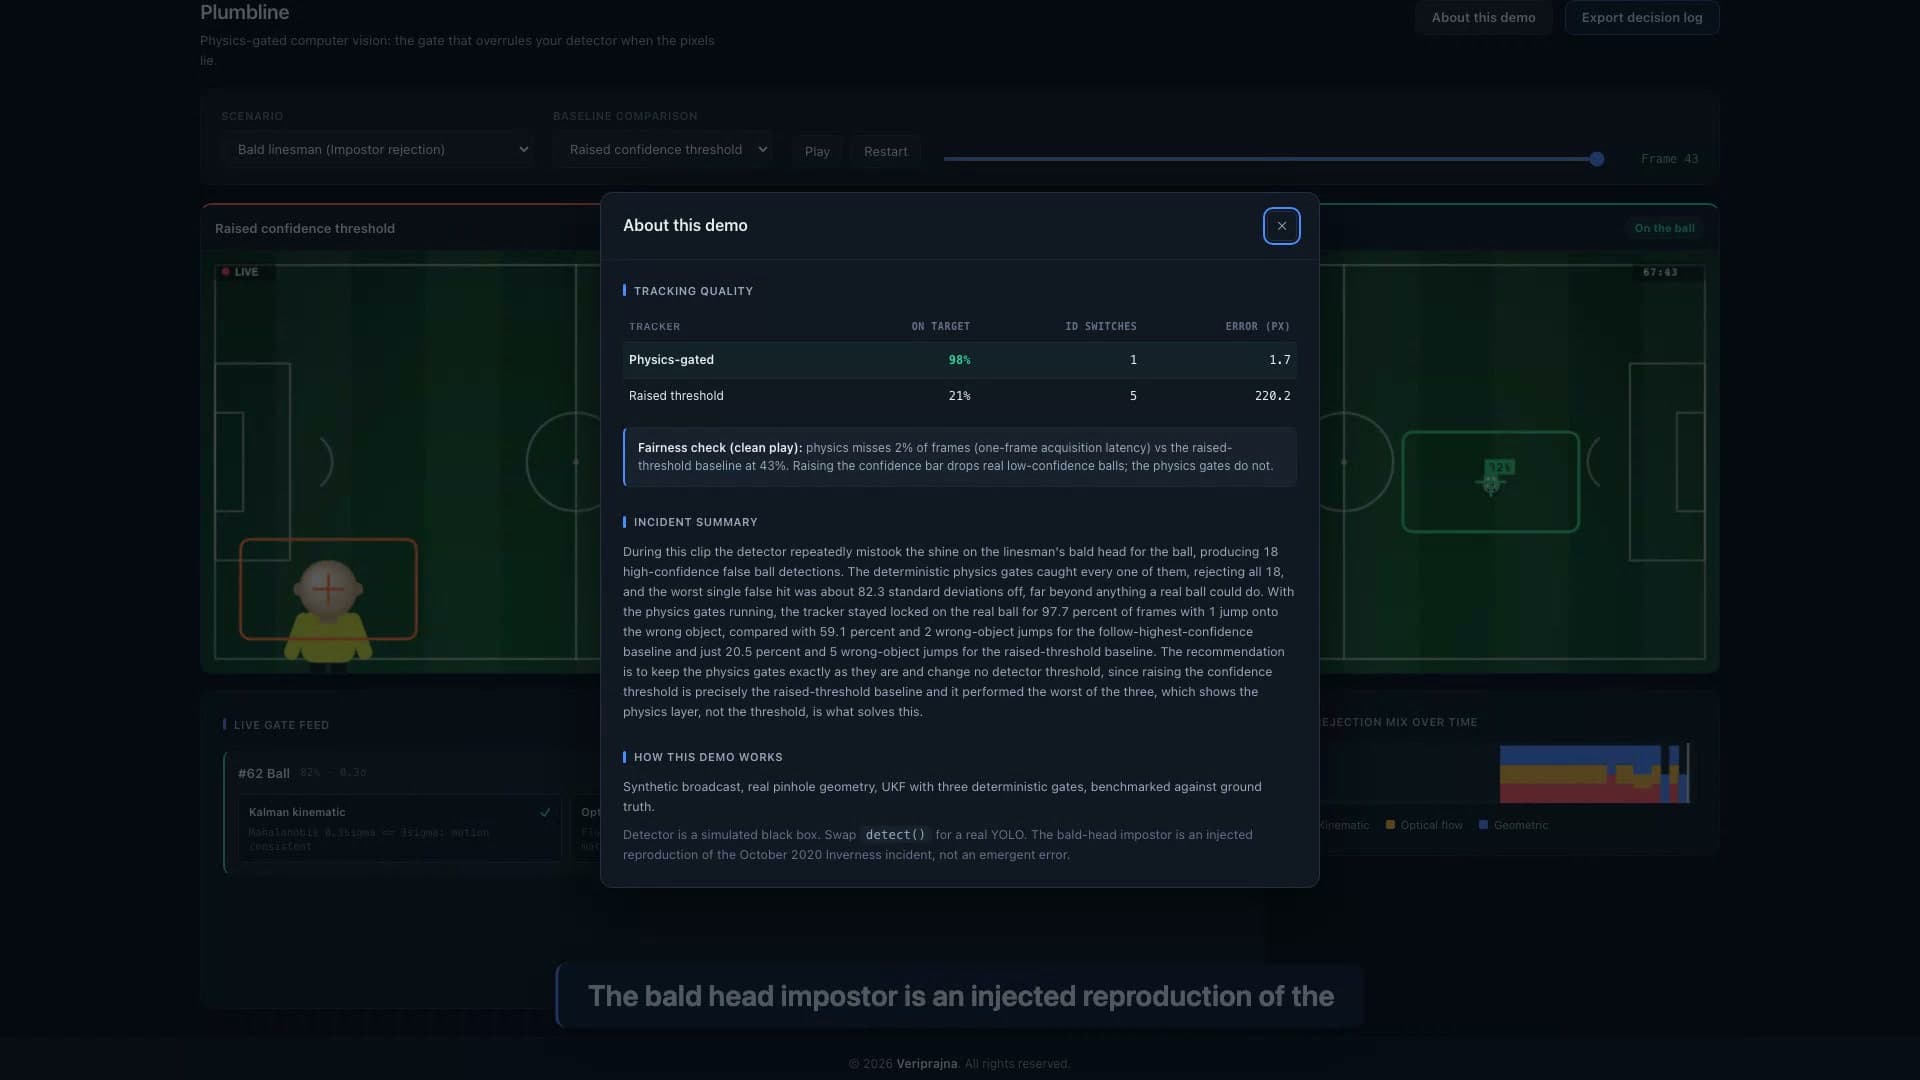
Quando mostro a rejeição da cabeça careca a engenheiros, o primeiro instinto é quase sempre o mesmo: basta aumentar o limite de confiança até que a bola falsa desapareça. Construí a demonstração para responder a esse instinto com números, porque parece certo, mas está errado. Na cena sintética limpa sem nenhum impostor, aumentar o limite descarta 43.2% das bolas reais de baixa confiança, enquanto os gates de física mantêm as perdas no conjunto limpo em 2.3% — o que representa apenas um único quadro de latência de aquisição, e não uma bola perdida. O limite troca um falso positivo por uma pilha de falsos negativos.
Os gates de física funcionam em um eixo totalmente diferente. Eles conseguem rejeitar a detecção impossível sem descartar a detecção real e sutil, porque o que eles verificam (uma bola pode estar aqui, movendo-se assim, com este tamanho?) não tem relação com a convicção com que o detector votou. Foi essa ortogonalidade que construí o teste de cena limpa para tornar inegável.
Há um detalhe menor ao qual me apeguei durante os testes: o caso de oclusão. Um jogador passa na frente da bola por uma dúzia de quadros, todos os candidatos são rejeitados e, em vez de capturar o jogador, o rastreador de física segue por inércia com base em sua própria previsão ao longo do intervalo e recupera a bola quando ela reaparece. Vê-lo manter uma trajetória vazia em vez de arriscar um palpite errado foi a primeira vez em que a camada pareceu menos um filtro e mais uma forma de discernimento.
O número que quase não mostrei
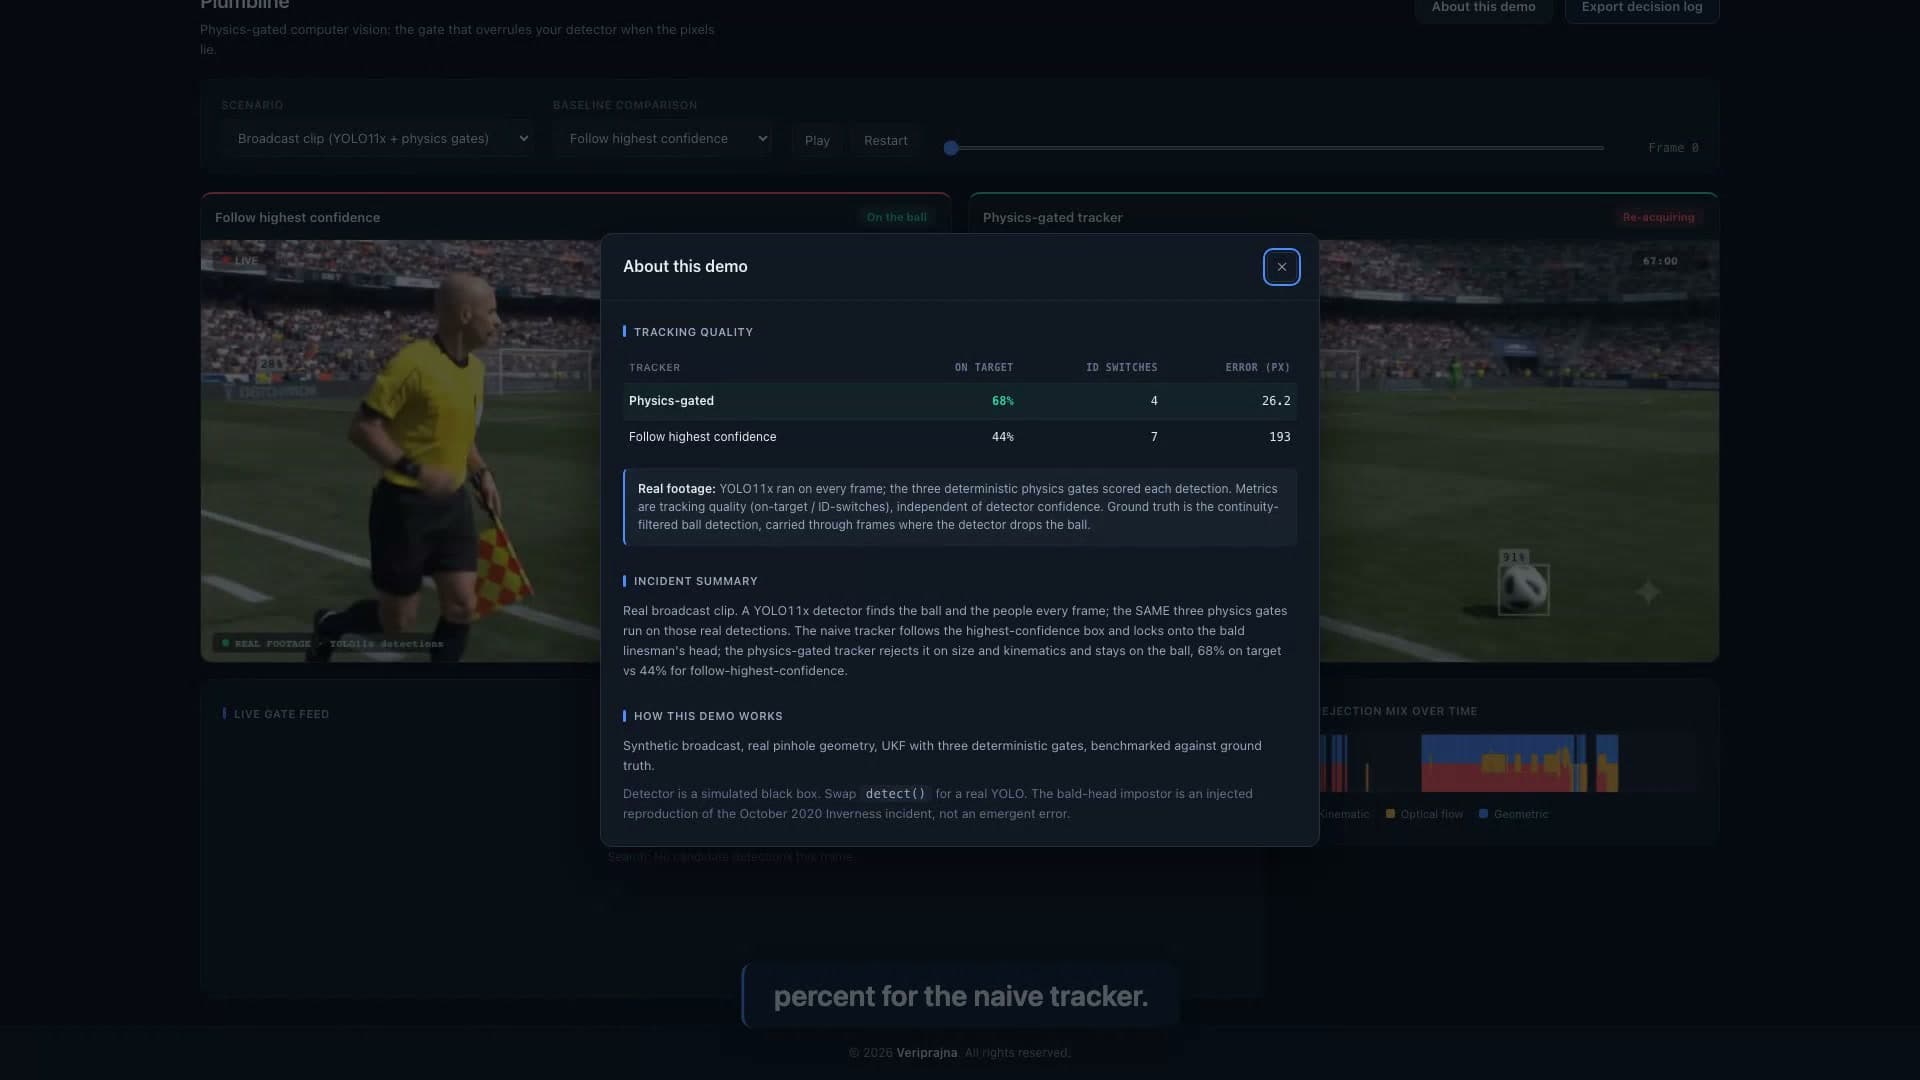
Quase cortei a execução com imagens reais, e mantê-la é a decisão de que mais me orgulho em todo este desenvolvimento. Tudo o que vimos acima roda em uma cena sintética com ground truth conhecido, o que viabiliza um benchmark limpo, mas uma vitória sintética é fácil de desconfiar. Então, peguei um clipe de transmissão real, executei detecções reais do YOLO11x quadro a quadro, injetei a cabeça do bandeirinha como uma falsa bola a partir da detecção real da pessoa e executei os mesmos três gates sem alterações. Duas concessões honestas se seguiram. Um único clipe de transmissão não calibrado não possui profundidade métrica, portanto o gate cinemático ali roda no plano da imagem como um filtro de Kalman 2D, e não no espaço tridimensional do mundo real — simular um filtro 3D teria sido uma farsa. E a pontuação caiu. No clipe real, os gates de física mantêm a bola em 68.3% do tempo, contra 43.8% do método de seguir a maior confiança e 30.0% do limite elevado.
Pensei bastante sobre esses 68.3%, porque 97.7% é o número que vende e 68.3% é o número real em vídeos difíceis. Mantive o número honesto no placar, dentro do aplicativo, onde qualquer pessoa pode lê-lo. Uma camada de verificação que faz promessas exageradas já falhou na única tarefa que se propõe a realizar. O que realmente valida o argumento é a direção: o mesmo código de gates, sem alterações, supera ambas as linhas de base tanto em detecções reais quanto em simuladas, sendo transparente sobre seus próprios limites.
Para o que isto realmente serve de base
Não comecei este projeto para criar um produto de futebol, e quero ter cuidado sobre o que esta demonstração é e o que ela não é. Não é uma alegação de que superamos qualquer sistema comercial de câmeras no rastreamento, já que o firmware posterior da Pixellot já lida com o caso literal da cabeça careca, e o detector não é o produto. O produto é a camada fina e inspecionável entre um detector e qualquer sistema que aja sobre sua saída. Essas métricas dizem respeito à qualidade do rastreamento, não à taxa de erro do detector, e é por isso que o valor se sustenta independentemente de quão bom o detector subjacente se torne.
Essa camada importa mais agora do que quando comecei. A visão computacional está se tornando agêntica, com sistemas que não apenas rotulam um quadro, mas agem sobre ele, e a questão de governança ainda sem resposta sob todos eles é como impedir que um agente autônomo aja com base em uma detecção fisicamente impossível. O SoccerNet ainda classifica o rastreamento de múltiplos objetos como "longe de estar resolvido", sem nenhum método ciente da física integrado aos seus benchmarks até agora. A cabeça careca nunca foi a parte interessante para mim. A parte interessante é que a restrição que a captura — a de que um objeto real deve obedecer à física — se mantém mesmo diante de um detector futuro perfeito, porque uma bola flutuando a uma altura constante e se movendo a três milhas por hora está errada em qualquer nível de confiança. Se você quiser ver uma detecção ser rejeitada e ler o motivo exato dessa rejeição, a demonstração está em https://veriprajna.com/demos/physics-constrained-computer-vision, executando o clipe real e as cenas sintéticas lado a lado.
E se você prefere assistir a apenas acreditar na minha palavra, aqui está a demonstração completa rodando de ponta a ponta, com o clipe real e as cenas sintéticas lado a lado.
A câmera seguiu uma cabeça careca porque ninguém nunca ensinou a ela o que uma bola pode fazer. Tudo o que construí é apenas essa instrução, registrada onde você pode verificar.