Uma estimativa menor de risco de firmware não é permissão de release

Um hotfix de firmware pode melhorar drasticamente uma estimativa de risco e ainda assim deixar uma release inaceitável sob a política declarada. Para uma equipe de engenharia que decide se deve atualizar uma frota de medidores, esses são julgamentos distintos. A melhoria diz algo sobre o candidato. A permissão depende do risco remanescente, da população sob avaliação e das evidências por trás da estimativa.
Construí o MeterGuard para manter esses julgamentos visíveis. É uma demonstração de pré-lançamento de rollout de firmware que usa populações sintéticas de medidores e manifestos sintéticos de firmware. Ele estima o comportamento a partir de um changelog, modela esse comportamento em relação à saúde da frota e emite uma recomendação local. Não envia firmware para medidores nem bloqueia uma atualização real. A questão útil é o que essa separação permite que um responsável pelo release inspecione e o que ela ainda não é capaz de estabelecer.
Melhoria e aceitabilidade respondem a perguntas diferentes
Considere a população sintética rotulada como Plano Water. Um candidato inicial produz uma taxa de falha média modelada de 74.22% dos endpoints avaliados. Um hotfix produz 2.85%. Ambos os resultados usam perfis comportamentais assistidos por modelo em cache, em vez de comportamento medido a partir de binários de firmware. Dentro dessas premissas, o hotfix é uma melhoria substancial. Essa comparação vale a pena ser preservada mesmo quando a recomendação final permanece NO-GO.
O gate de release verifica primeiro a extremidade superior do intervalo modelado de 90%. Em 3.0% ou mais dos endpoints avaliados, ele retorna NO-GO. Para o hotfix, a média é de 2,449 falhas modeladas entre 86,078 endpoints avaliados, com um intervalo de 1,536 a 3,531. A taxa superior é de 4.10%, de modo que a regra de bloqueio estrito se aplica. Outros 1,922 endpoints não possuem telemetria suficiente e são excluídos dessa previsão, sendo recomendada revisão manual.
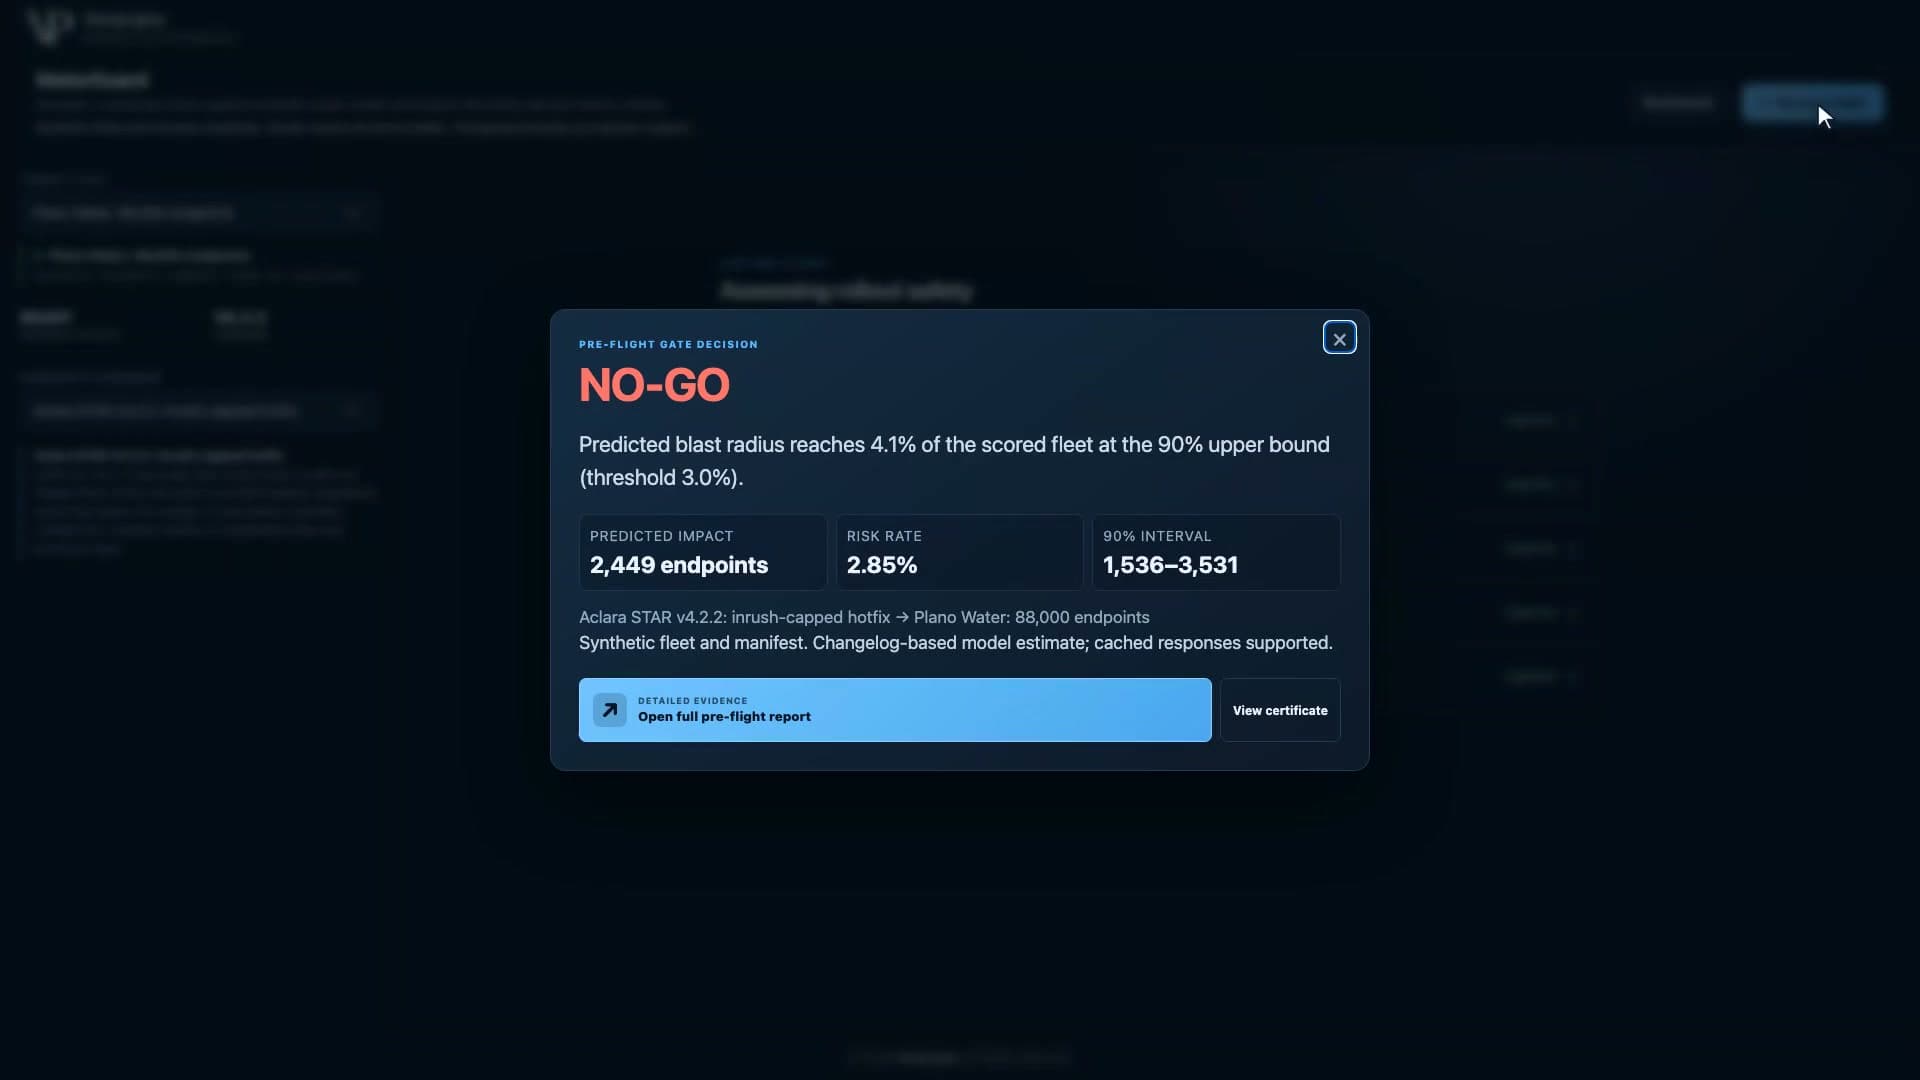
Uma leitura focada apenas na média ignoraria por que este é um bloqueio estrito. Tampouco tornaria o candidato elegível para GO segundo o restante da política: GO exige uma média igual ou inferior a 0.5%, após aprovação nas verificações de limite superior e de confiança. O risco numérico intermediário leva a STAGED-CANARY. A distinção importa porque «melhor», «elegível para uma etapa limitada de coleta de evidências» e «dentro da regra GO» não devem entrar em colapso em um único rótulo tranquilizador.
Prefiro manter a melhoria visível sem permitir que ela renegocie o limite. Se uma equipe responde a uma recomendação decepcionante afrouxando o limiar, ela mudou sua política de aceitação. Essa pode ser uma decisão defensável em um contexto específico, mas é uma decisão separada que exige suas próprias razões. A evidência de que um candidato é melhor que outro não fornece essas razões por si só.
Há um custo para essa posição. Um limite conservador pode adiar um candidato que teria tido sucesso. A extremidade superior de um intervalo modelado não é um resultado de campo observado, e chamar o intervalo de «90%» não estabelece sua cobertura em uma frota de concessionária. Esta demonstração não pode determinar qual limiar uma concessionária real deve adotar. O que ela pode mostrar é se uma recomendação segue o limiar declarado, em vez de um limiar ajustado silenciosamente para se adequar ao resultado.
A permissão pertence a um candidato e a uma população
A mesma estimativa de comportamento do hotfix produz um resultado muito diferente em relação à população gerada rotulada como Hill Country Electric Co-op. Sua taxa de falha média modelada é de 0.02%, com uma taxa de intervalo superior de 0.03%, e o gate retorna GO para 118,222 endpoints avaliados. A população tem uma distribuição de bateria mais saudável e menos sinal de rádio fraco do que a população sintética de Plano. Seus 1,778 endpoints excluídos permanecem fora dessa recomendação.
Esta é uma comparação do comportamento de escrita estimado através de distribuições de saúde geradas. Não diz nada sobre instalar a imagem de um fabricante no hardware de outro fabricante. Compatibilidade e validação derivada de binários são trabalhos separados que a demonstração não executa.
A comparação muda a forma como quero que uma recomendação de release seja expressa. «Este firmware é de baixo risco» deixa o escopo indefinido. «Este comportamento estimado atende a esta política nesta população avaliada» preserva as condições sob as quais o resultado se sustenta. A condição da bateria e a recuperação de rádio são entradas para o resultado modelado, de modo que um resultado favorável não pode ser desvinculado delas e transportado para outra frota.
Para um responsável pelo release, isso cria duas maneiras distintas de responder a uma recomendação desfavorável. Uma é melhorar o comportamento do candidato ou as evidências usadas para estimá-lo. Outra é considerar uma população mais restrita cujas condições sustentem uma avaliação diferente. Elas respondem a problemas diferentes. Uma avaliação mais restrita pode reduzir a exposição modelada, mas deixa o restante da população não resolvido. Evidências melhores sobre o candidato podem refinar a estimativa, mas não podem fazer surgir a telemetria ausente da frota.
Essas alternativas são escolhas de engenharia prospectivas, não operações que esta demonstração executa. Seu valor é direcionar o trabalho para a fonte da incerteza. O veredito por si só não pode dizer a uma equipe se ela precisa de um candidato melhor, de um perfil melhor ou de informações melhores sobre os destinatários pretendidos. As entradas e exclusões ao lado dele podem.
Um gate em código não pode validar o que o modelo acredita
O MeterGuard mantém a política em código simples. O memorando de governança assistido por modelo vem após o veredito e não tem autoridade direta para substituí-lo. Quero essa separação porque uma explicação fluente não deve se tornar silenciosamente uma nova regra de release.
O modelo ainda tem influência consequente no início do fluxo de trabalho. Seu perfil de firmware estima consumo de corrente, recuperação após reinicialização e comportamento de escrita em flash a partir do texto sintético do changelog. Essas estimativas alimentam o simulador. Um perfil diferente pode alterar as falhas modeladas e, portanto, mudar o veredito, mesmo que o código do gate nunca seja alterado. Uma política inspecionável estabelece como as entradas foram julgadas; ela não estabelece que as entradas estavam corretas.
O caso do changelog suscinto torna a distinção visível. Em relação à mesma população gerada da cooperativa, sua média modelada é de apenas 0.05% e sua taxa superior é de 0.06%. Esses números superam os limites numéricos. O perfil, no entanto, carrega baixa confiança, portanto o gate recomenda STAGED-CANARY em vez de GO. Evidências esparsas de firmware estão sendo tratadas como uma razão independente para reter a recomendação mais ampla.
Essa é uma proteção útil, com seu próprio limite. O rótulo de confiança de um modelo não é certeza empírica calibrada. Exigir um rótulo não baixo pode impedir que uma lacuna de evidência reconhecida seja ignorada; não pode certificar um rótulo «alto» como preciso. Para dependência em produção, o perfil precisaria de validação em relação ao comportamento real do firmware e aos resultados observados. Isso permanece um trabalho além da demonstração sintética.
A amostra mais segura deixa uma pergunta mais difícil
A rota em etapas proposta usa 500 endpoints da coorte de menor risco modelado, com retenção de 72 horas e reavaliação usando telemetria observada antes da ampliação. A demonstração recomenda este plano; ela não executou um canary nem coletou suas observações. O critério de ampliação configurado é uma taxa de falha observada abaixo de 0.1%.
Vejo um equilíbrio real na escolha da coorte mais segura primeiro. Isso reduz a exposição proposta para a etapa inicial. Mas a mesma lógica que fez a condição da frota importar também limita o que essa etapa poderia estabelecer sobre endpoints em piores condições. Em uma campanha hipotética, observar uma atualização bem-sucedida em baterias saudáveis e boas conexões de rádio sustentaria uma afirmação sobre essa amostra testada. Deixaria em aberto como o candidato se comporta em baterias desgastadas ou conexões de rádio fracas.
Existem pelo menos duas respostas defensáveis a essa lacuna. Uma equipe poderia manter a ampliação restrita a populações suficientemente semelhantes à amostra observada, aceitando cobertura mais lenta e deixando endpoints degradados pendentes. Ou poderia buscar evidências direcionadas às condições degradadas, como validação controlada do comportamento relevante de bateria e recuperação, antes de considerar esses endpoints. O segundo caminho exige mais trabalho; o primeiro aceita uma conclusão mais estreita. Nenhum dos dois torna uma amostra segura representativa por mera declaração.
É por isso que trato STAGED-CANARY como uma solicitação de evidência especificada, não como um sinônimo brando para GO. Um plano em etapas precisa dizer o que suas observações justificarão e onde elas param. Sem esse escopo, um processo aparentemente cauteloso ainda pode produzir uma conclusão excessivamente ampla.
Aqui está a demonstração do fundador sobre essas decisões de release de medidores inteligentes no MeterGuard.
O explicativo do MeterGuard mostra o fluxo de trabalho de pré-lançamento e seus registros de decisão. Minha postura de design é manter o comportamento estimado, a população avaliada, as exclusões e a regra declarada ao lado da recomendação. Para um responsável pelo release, o teste é se o próximo passo proposto resolve a incerteza que causou a retenção. Se observar apenas as condições mais fáceis enquanto a decisão envolve as mais difíceis, o limite continuará esperando por evidências.