“我们在模型中去除了种族和收入”是导致动态定价诉讼败诉的辩词

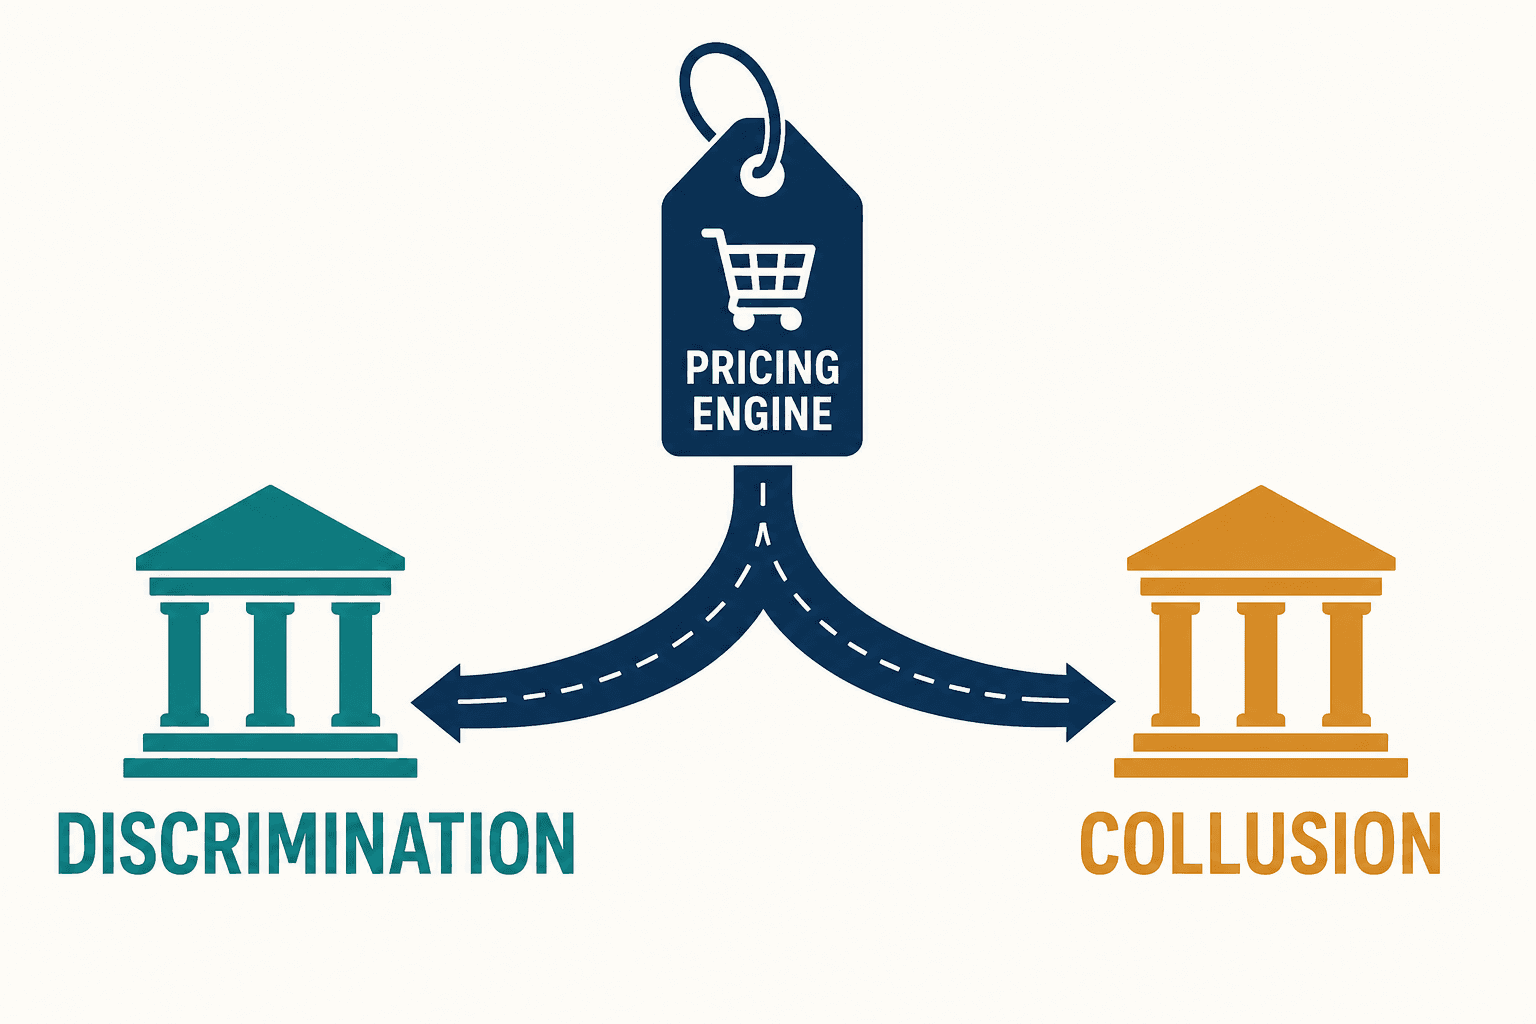
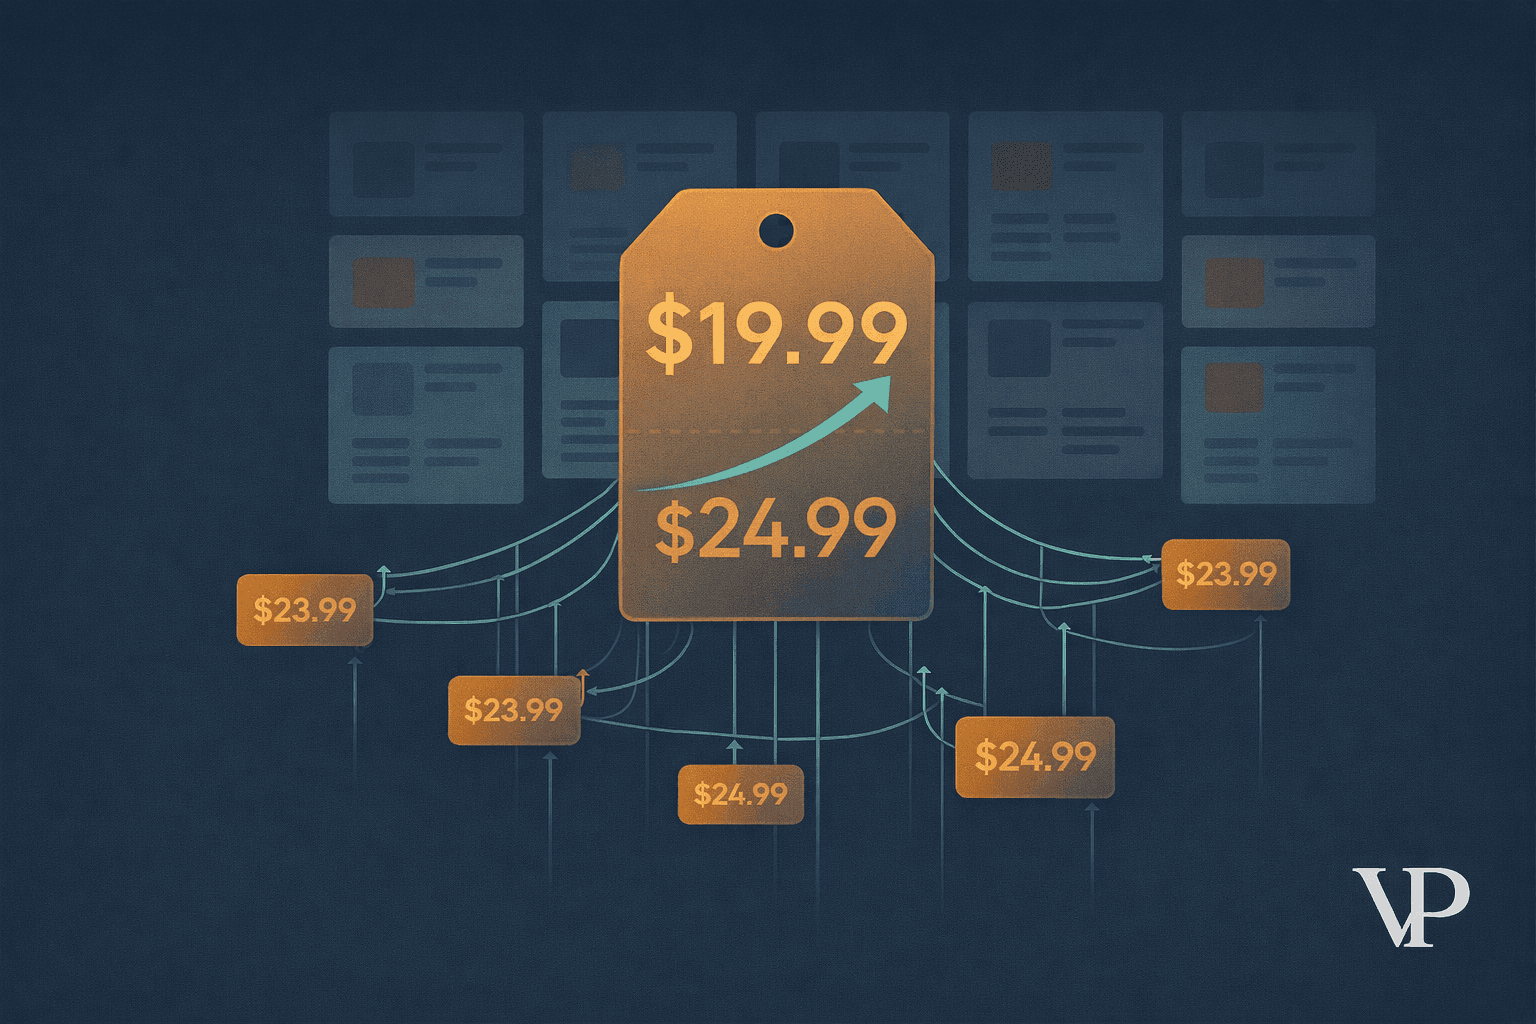
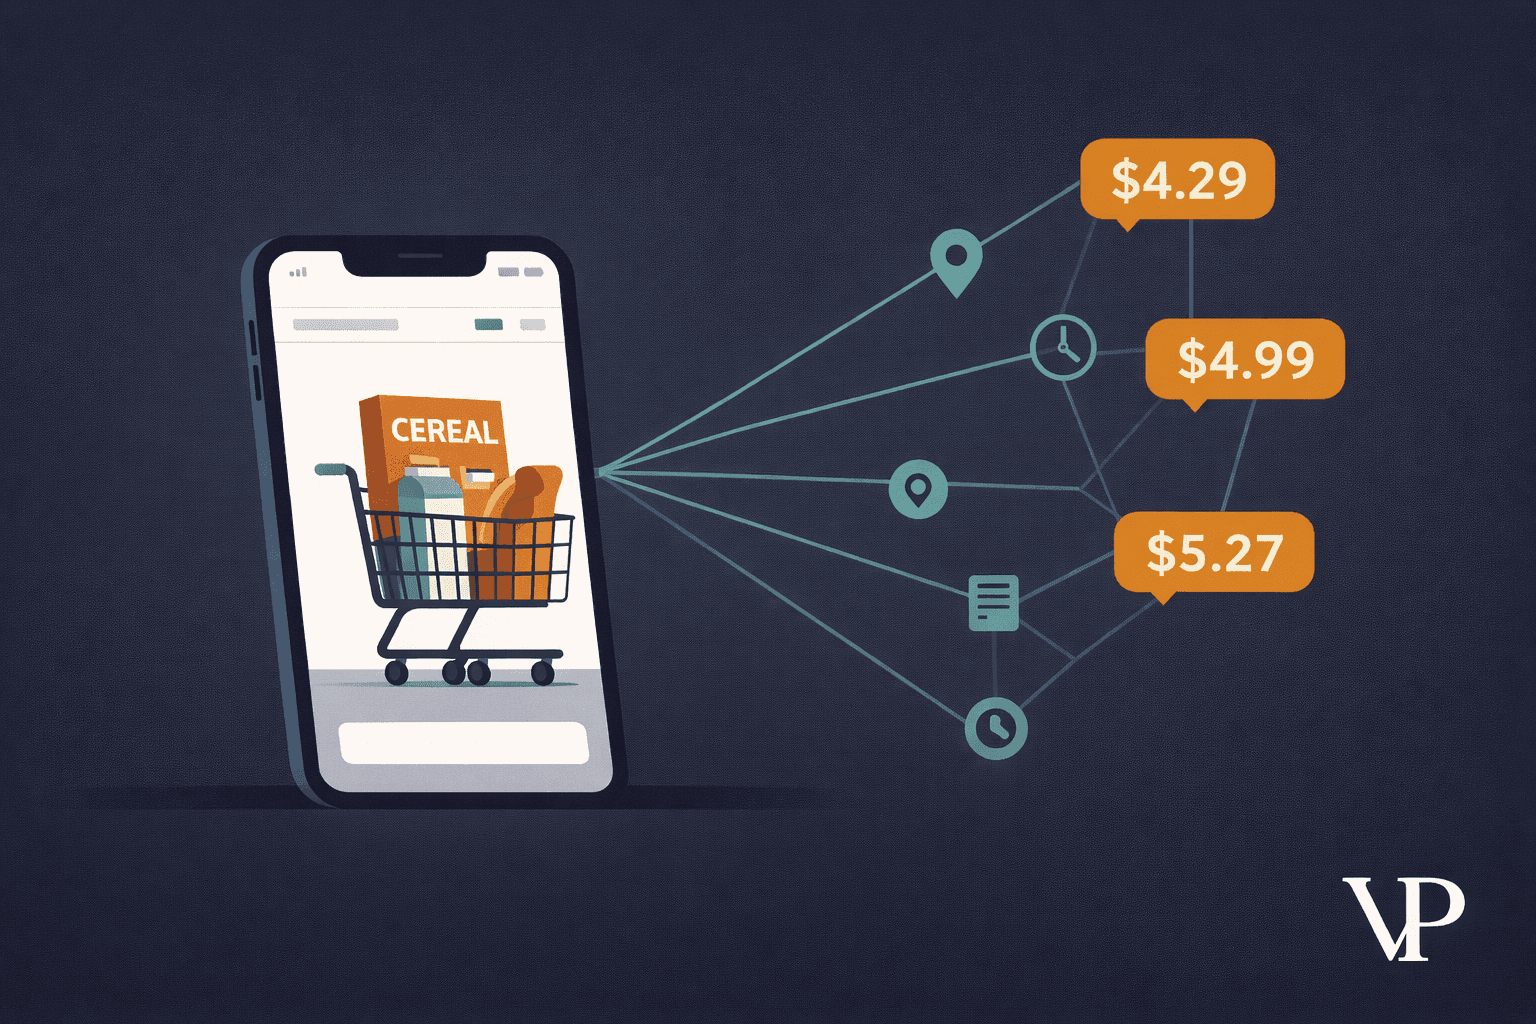
2025年12月,美国联邦贸易委员会(FTC)就Eversight动态定价实验与Instacart达成6000万美元的和解协议,诉状记录了完全相同商品的价格差异高达23%。FTC从不需要查明算法接收了什么指令;诉讼完全建立在不同买家针对同一商品实际被展示的价格之上。
每个定价团队惯常诉诸的话语恰恰与结果责任论背道而驰:我们在模型中去除了种族和收入特征。我相信说出这句话的团队是真诚的。但我也认为,这正是导致败诉的辩词。与其进行抽象辩论,我构建了一个能够如实自我声明此点的定价引擎,随后对其进行了审计。该引擎是一个拥有7个价格臂(arms)的LinUCB上下文老虎机(contextual bandit),随机种子设为42,在故意植入了代理变量结构的10,000名合成消费者群体上进行以收益最大化为目标的训练。我将该虚拟零售商命名为ShopMart。没有真实零售商接受审查,也没有真实顾客被多收费,这正是我知晓客观基准(ground truth)并能据此评估审计的原因。其上层的系统是一个我命名为Equity的控制台,旨在运行于零售商已有的任何定价引擎之上;在本次构建中,接受审计的引擎正是我自己的老虎机。完整执行过程请访问veriprajna.com/demos/ai-pricing-compliance。
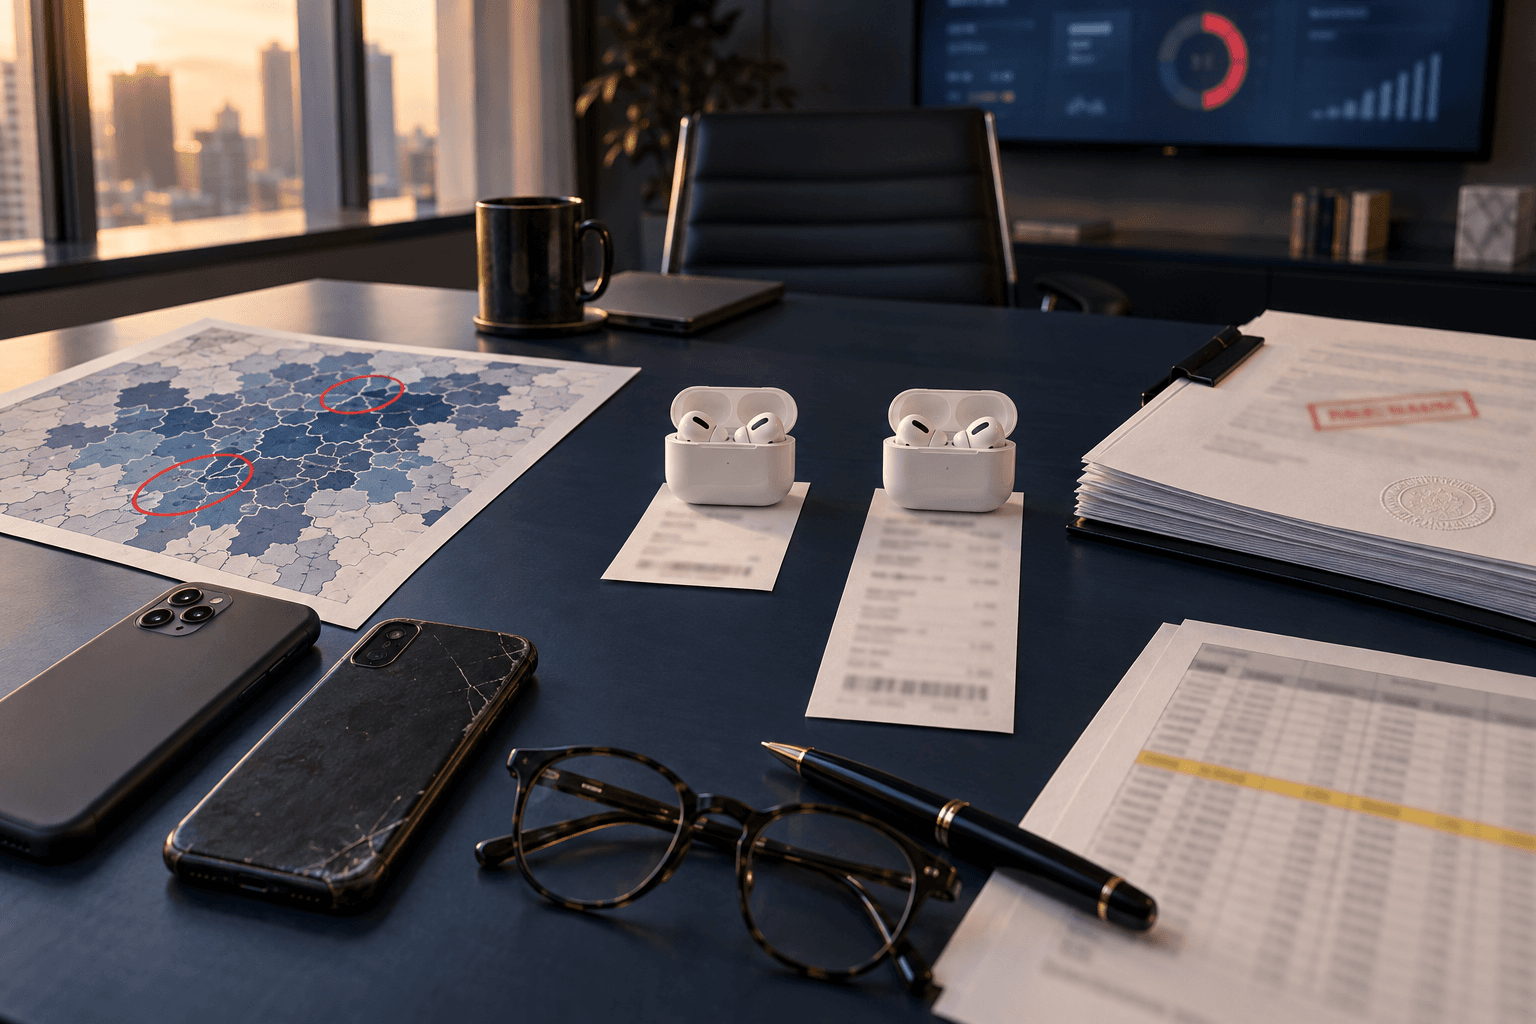
同款耳机,需求匹配,加价26%
我为老虎机提供了9个输入变量,没有一个是受保护属性:邮政编码(ZIP)收入指数、设备档次、引流渠道、停留时间、购物车金额、复购率、会话次数、高级会员资格以及一天中的时段,外加引流渠道与停留时间的交叉项。因为现实中的许多引擎包含交叉项或决策树,我希望自己的引擎能够具备同等能力。然后我让它在全部10,000次决策中,为单一SKU——官方标价79.00美元的Aura Wireless Earbuds——制定价格。
控制台上的核心概览卡是运行任何操作前屏幕上首先呈现的内容。两个群体,同一款产品,匹配的需求信号。决策集A是高收入邮编与最新设备群体(2,880次决策),在卡片上由上东区邮编和新款iPhone代表:显示价格为74.06美元。决策集B是少数族裔占多数的邮编与旧设备群体(3,037次决策),由南布朗克斯邮编和旧款Android手机代表:显示价格为93.47美元。测得的差异为+26.2%。这些是基于各自约3,000次决策的群体平均值,因此这是定价策略的系统性行为,而非某位偶发消费者的运气问题。每张卡片上的邮编与手机是该群体的代表性画像,而非其定义。
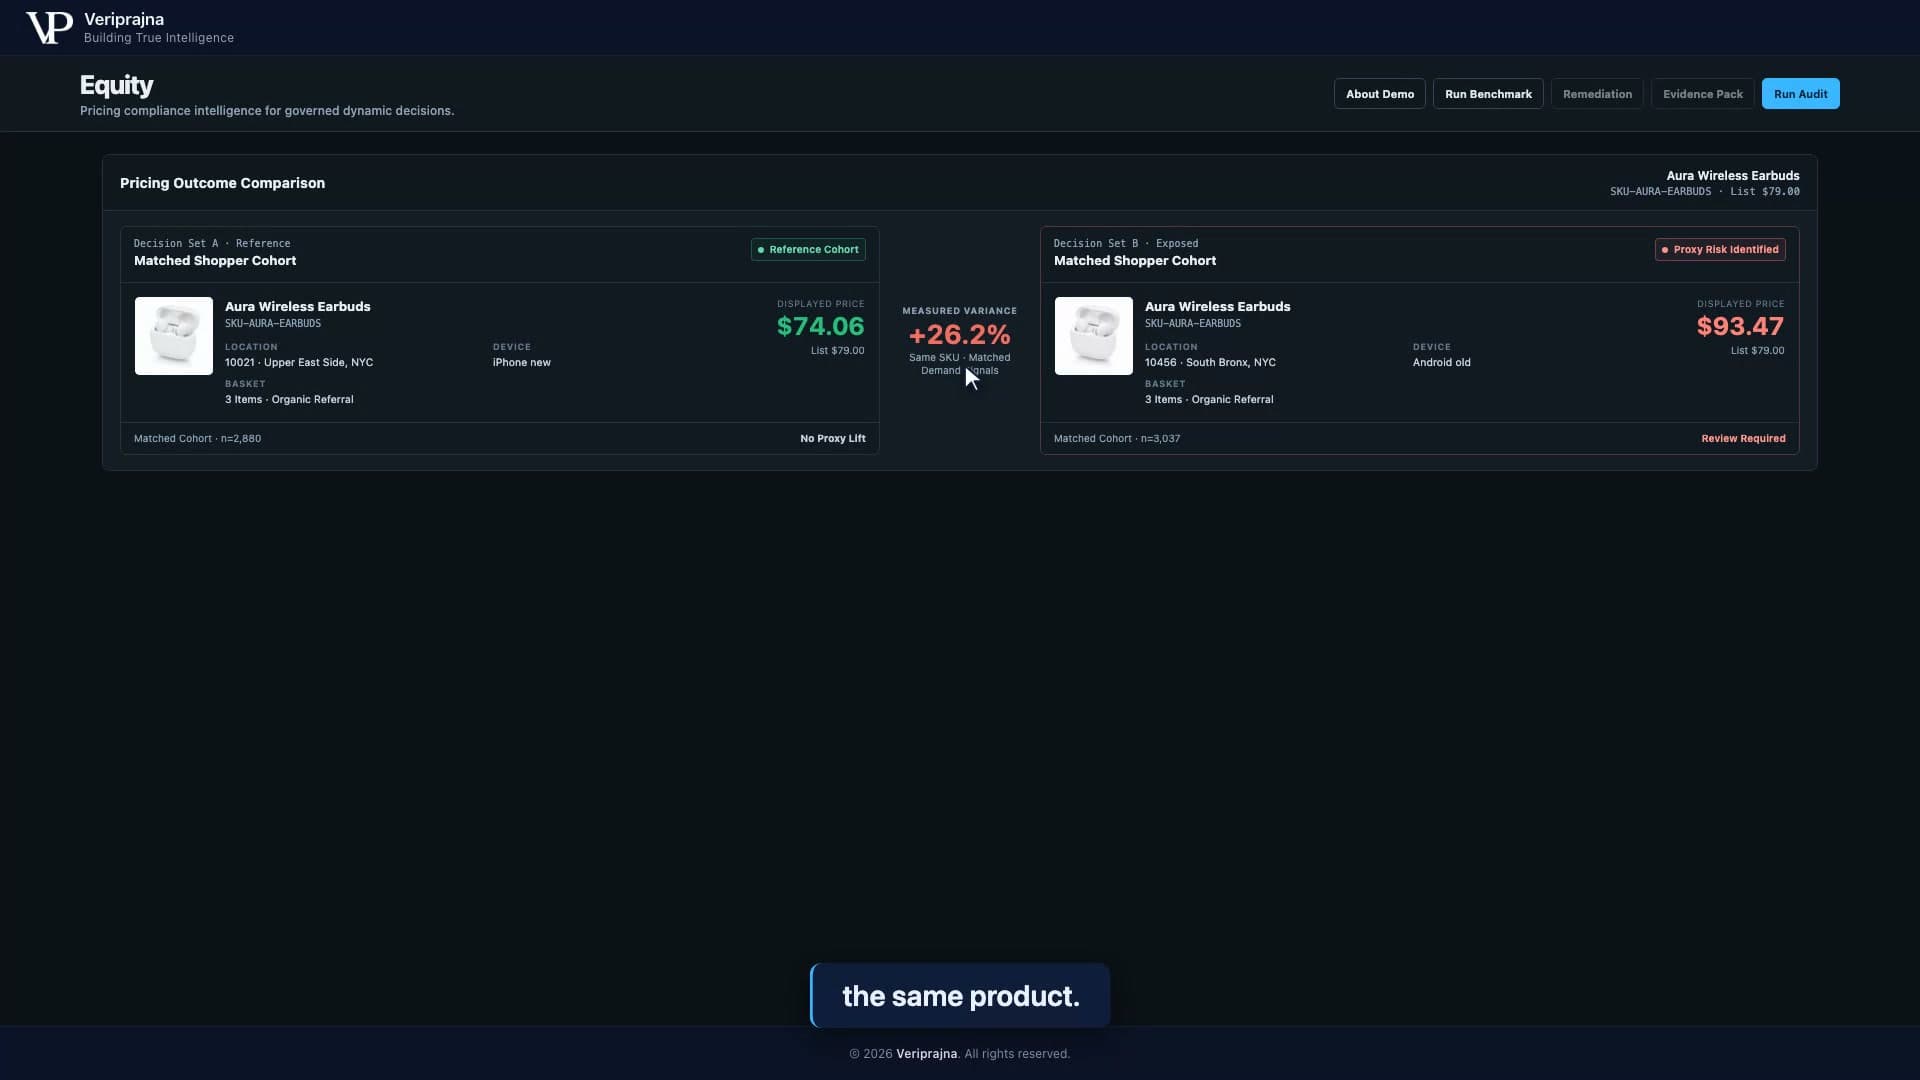
令我感到不安的是,我未曾写过任何可以被称为歧视性规则的代码。我编写了一个收益最大化程序,并向其输入了预测支付意愿的信号。邮编预测收入,收入预测价格敏感度,旧款Android手机预测比价行为更少。这些都不是种族。但它们都与种族同向变动,而以收益为奖励的老虎机会捕获每一个关联。当信号承载了群体信息时,这26%就是收益最优化的必然表现。
隐藏在两个干净特征之间的代理变量
我设计的审计方案通过三种方式评估每个输入特征,因为我能想到的每一个单项测试都存在漏洞:针对受保护群体的绝对皮尔逊相关性(审计本身从不接收该标签)、归一化互信息(NMI),以及反事实价格重放。反事实重放将受保护群体的该特定输入替换为优势群体的参考基准值,保持所有其他输入不变,重新运行引擎的自身策略,并衡量受保护群体的价格位移幅度。重放机制与模型无关:它通过扰动输入并观察输出,因此无需在乎引擎是老虎机、决策树还是黑盒。
Input Audit表的前两行完全符合所有人的预测。邮编收入指数:|r| 0.95,MI 1.00,反事实位移+7.8%,判定为VIOLATION。地理位置在该人群中完全编码了受保护群体,引擎据此定价。设备档次:0.32,0.08,+2.9%,VIOLATION,这是一个表面中立但超出了我在代码中设定的0.30相关性阈值和0.05互信息阈值的信号。
第三个VIOLATION是单特征审计无法察觉的。引流渠道单独测试:|r| 0.00,MI 0.00,PASS。停留时间单独测试:0.17,0.03,PASS。单特征审计会放行这两项并继续。引流渠道×停留时间的交互项读数为:|r| 0.00,联合互信息为0.73,反事实位移+1.7%,VIOLATION。这相比最佳单项特征产生了0.71的交互增益。
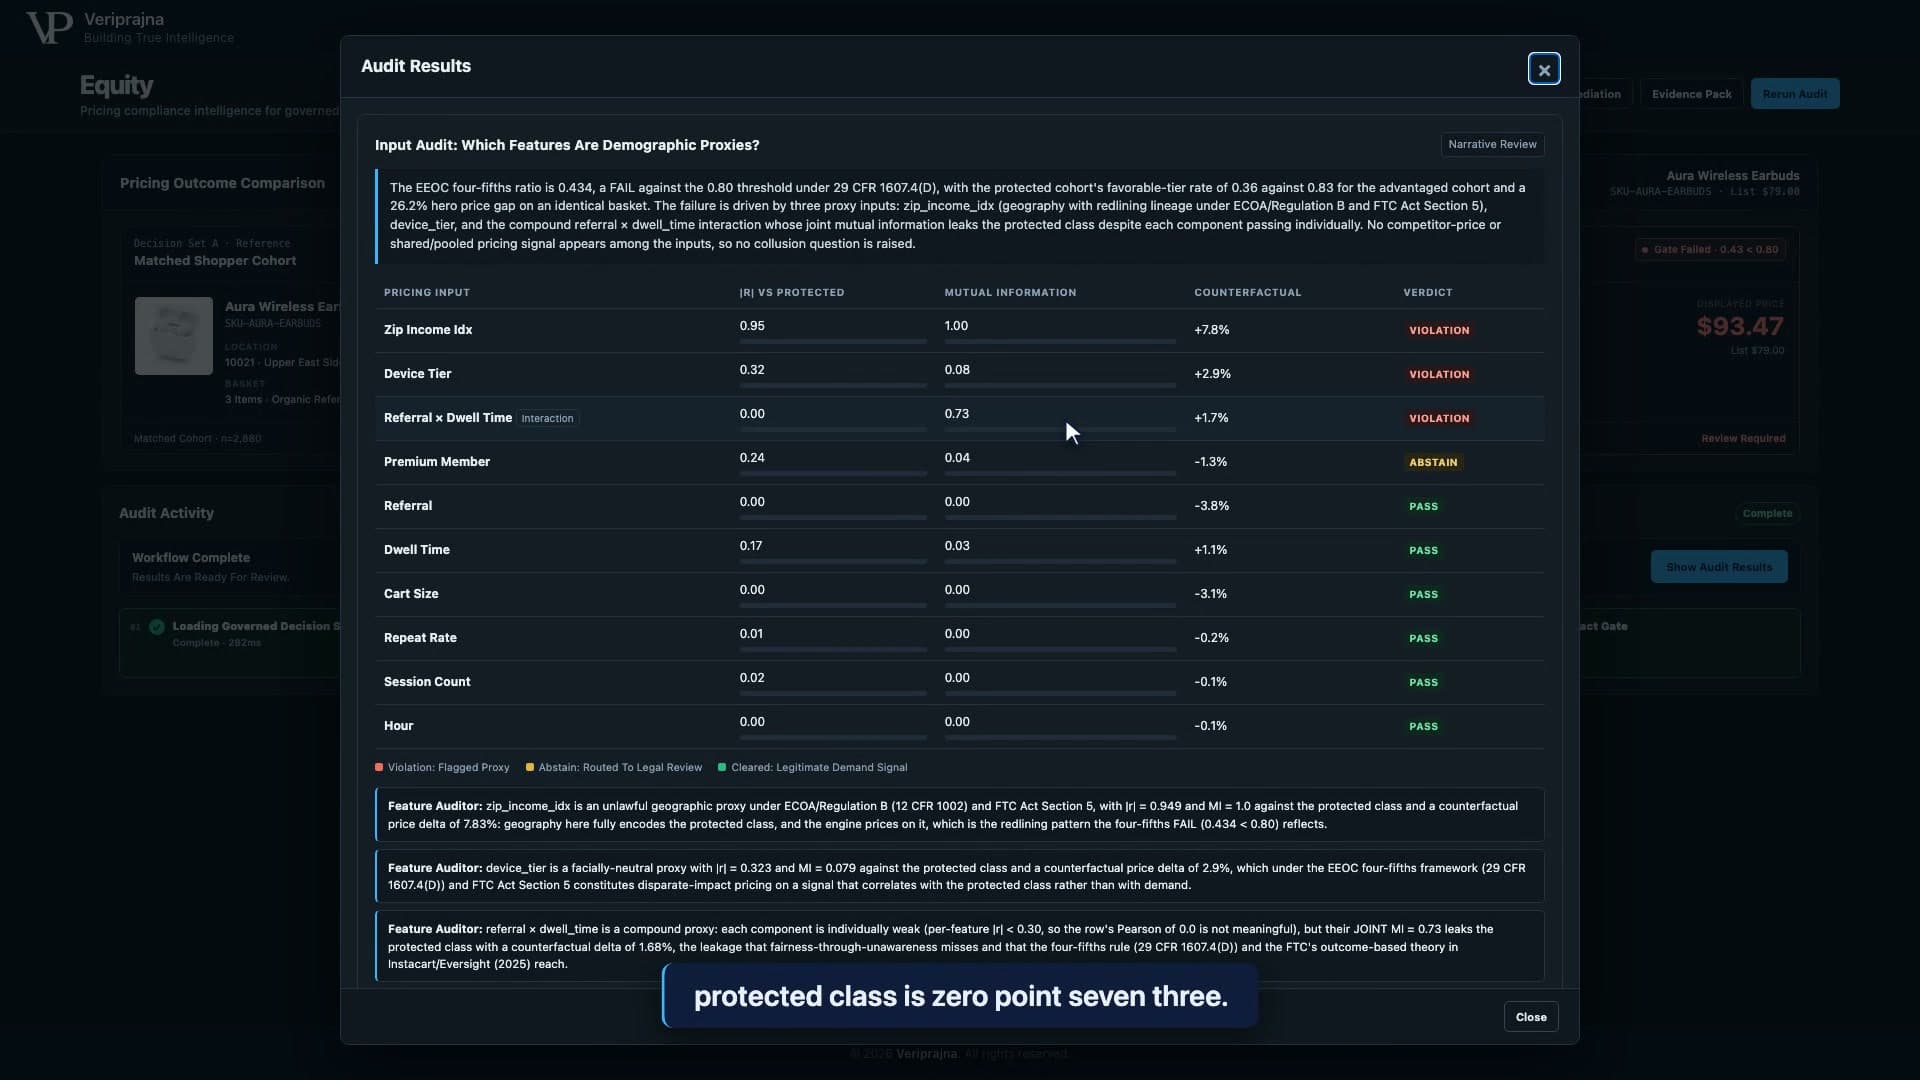
我以异或(XOR)门控方式植入了这种结构。自然搜索且长停留时间标记了受保护群体。比价渠道且短停留时间同样标记了受保护群体。自然搜索配短停留、比价渠道配长停留则标记了优势群体。无论是引流来源还是停留时间单独都无法区分群体;唯有两者结合才能区分。相关性分析作为单列工具对此视而不见。双变量联合互信息则洞若观火。逐个审计输入特征的合规程序审计的是错误的对象,而如果不构建一个单特征分析确定性失效的受控群体,我无法证明这一点。
我曾经也会采用的辩护策略
我测试了自己以往面对监管机构时也会提出的抗辩,即不知情下的公平性(fairness through unawareness):移除邮编和设备特征,重新训练引擎,汇报结果。我知道复合代理依然存在。我不知道的是,在0.43的比例中,究竟有多少仅由邮编和设备导致,又有多少源自隐藏的交互对。去除邮编和设备并重新训练后,五分之四比例从0.43上升到0.59。仍然不合规,而遗留的差距正是逃避单特征审计的部分。基准卡用四个词直指根源:Compound Proxy Still Leaks。
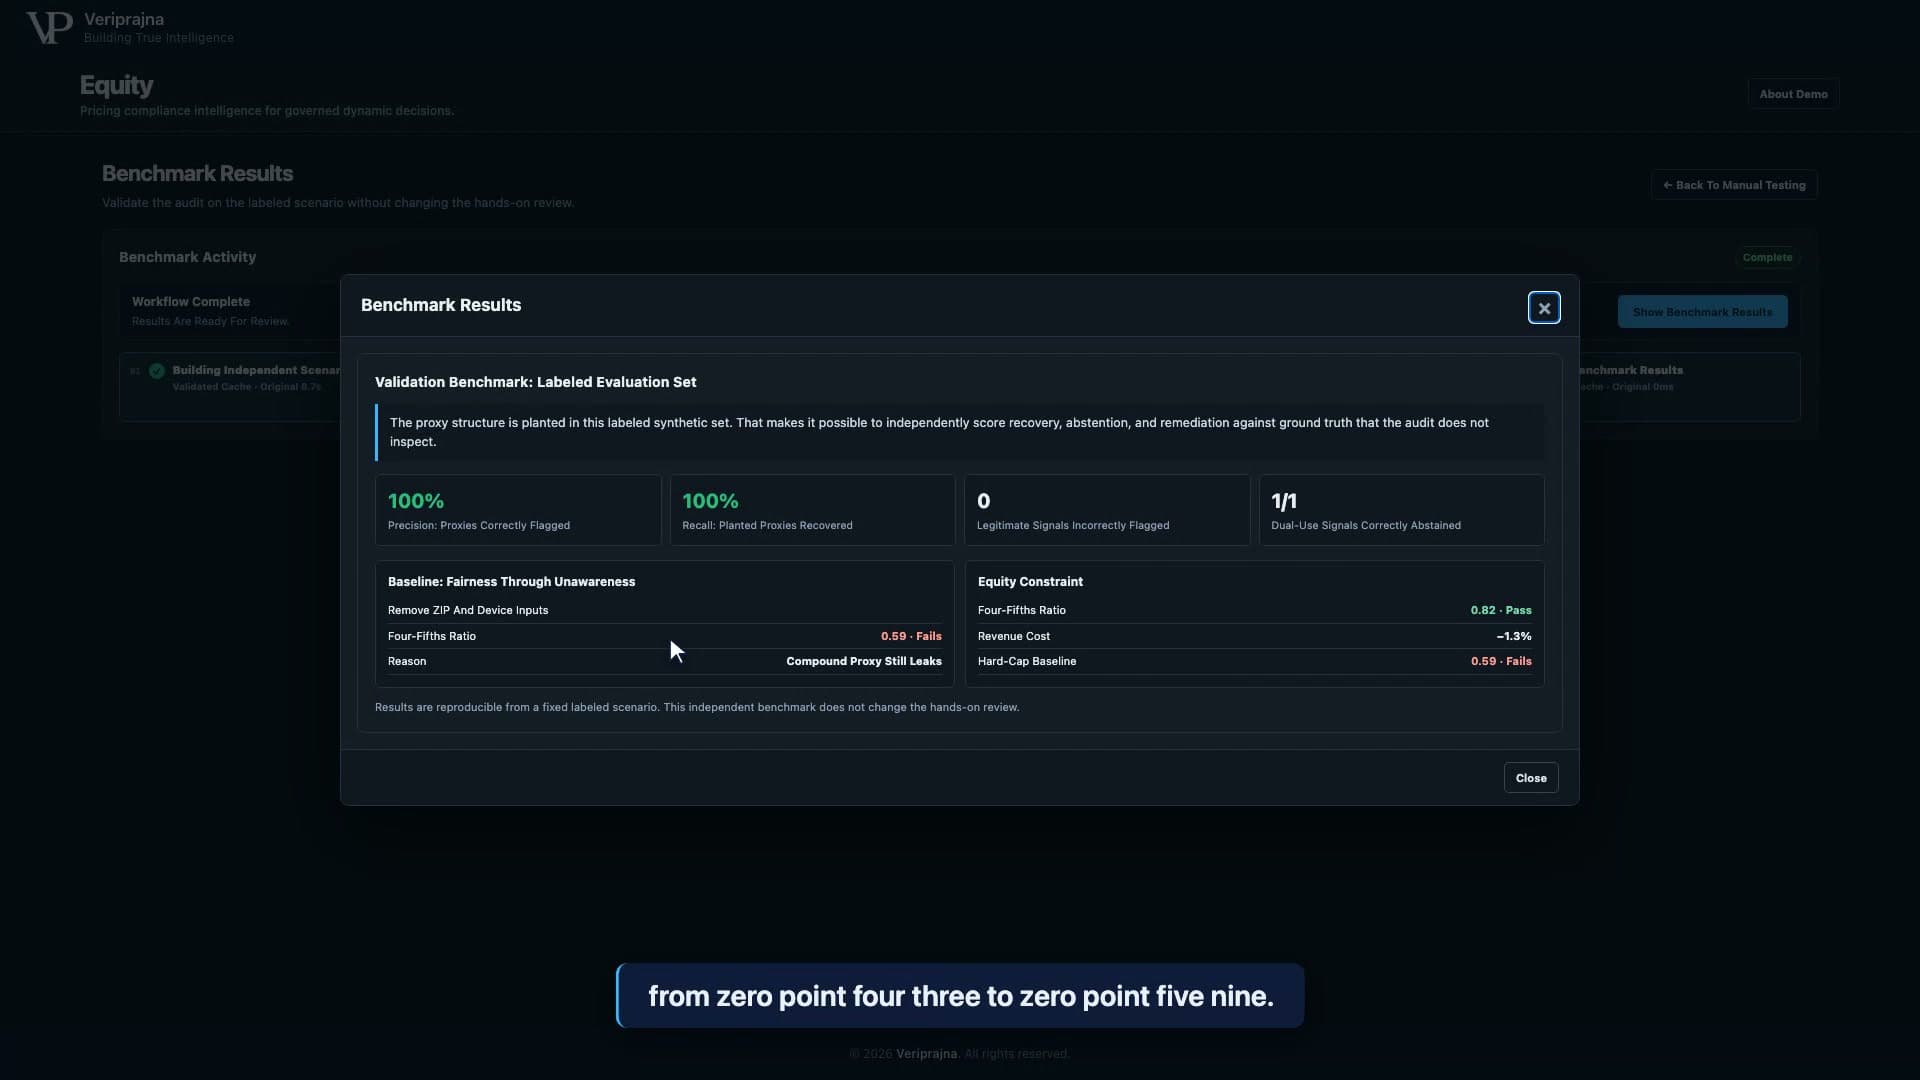
这一结果彻底改变了我对那句辩词的理解。引擎通过两个在单列测试中完全合格的信号,依然锁定了该群体,并且会一直锁定下去——因为找出这一关联正是收益最大化算法获得奖励的原因。主张不知情对团队而言没有任何成本,但却交出了一个他们日后必须在法庭上解释的数据。
卡片上的100%具有严格界定的含义。该基准重建了种子为42的同一人群,并针对我植入的标签对审计进行评分,因此100%的精确率与召回率意味着在带标签的合成数据集上以零误报识别出全部3个预埋代理。这是针对已知基准的自我验证,我不会将其援引为真实企业定价日志中的准确率,因为真实日志存在着合成环境中无法模拟的复杂混淆变量。
0.43的含义以及为何不由模型做出判定
我拒绝捏造一套自创的内部合规指标,因为自制指标没有理由得到监管机构的认可。Equity中的准入标准是一项外部法定标准:EEOC五分之四规则(29 CFR 1607.4(D)),已从录取率适配至价格阶梯。在此,有利待遇意味着未被分配至最高价格档。在交付的原始引擎中,36%的受保护群体获得了优惠档位,相比之下优势群体则有83%。0.36除以0.83得出0.43,法定门槛为0.80,表盘亮红灯显示Fail。旁边标明:受保护群体中有64%被置于最高价档,相比优势群体的平均溢价高达+15.6%。
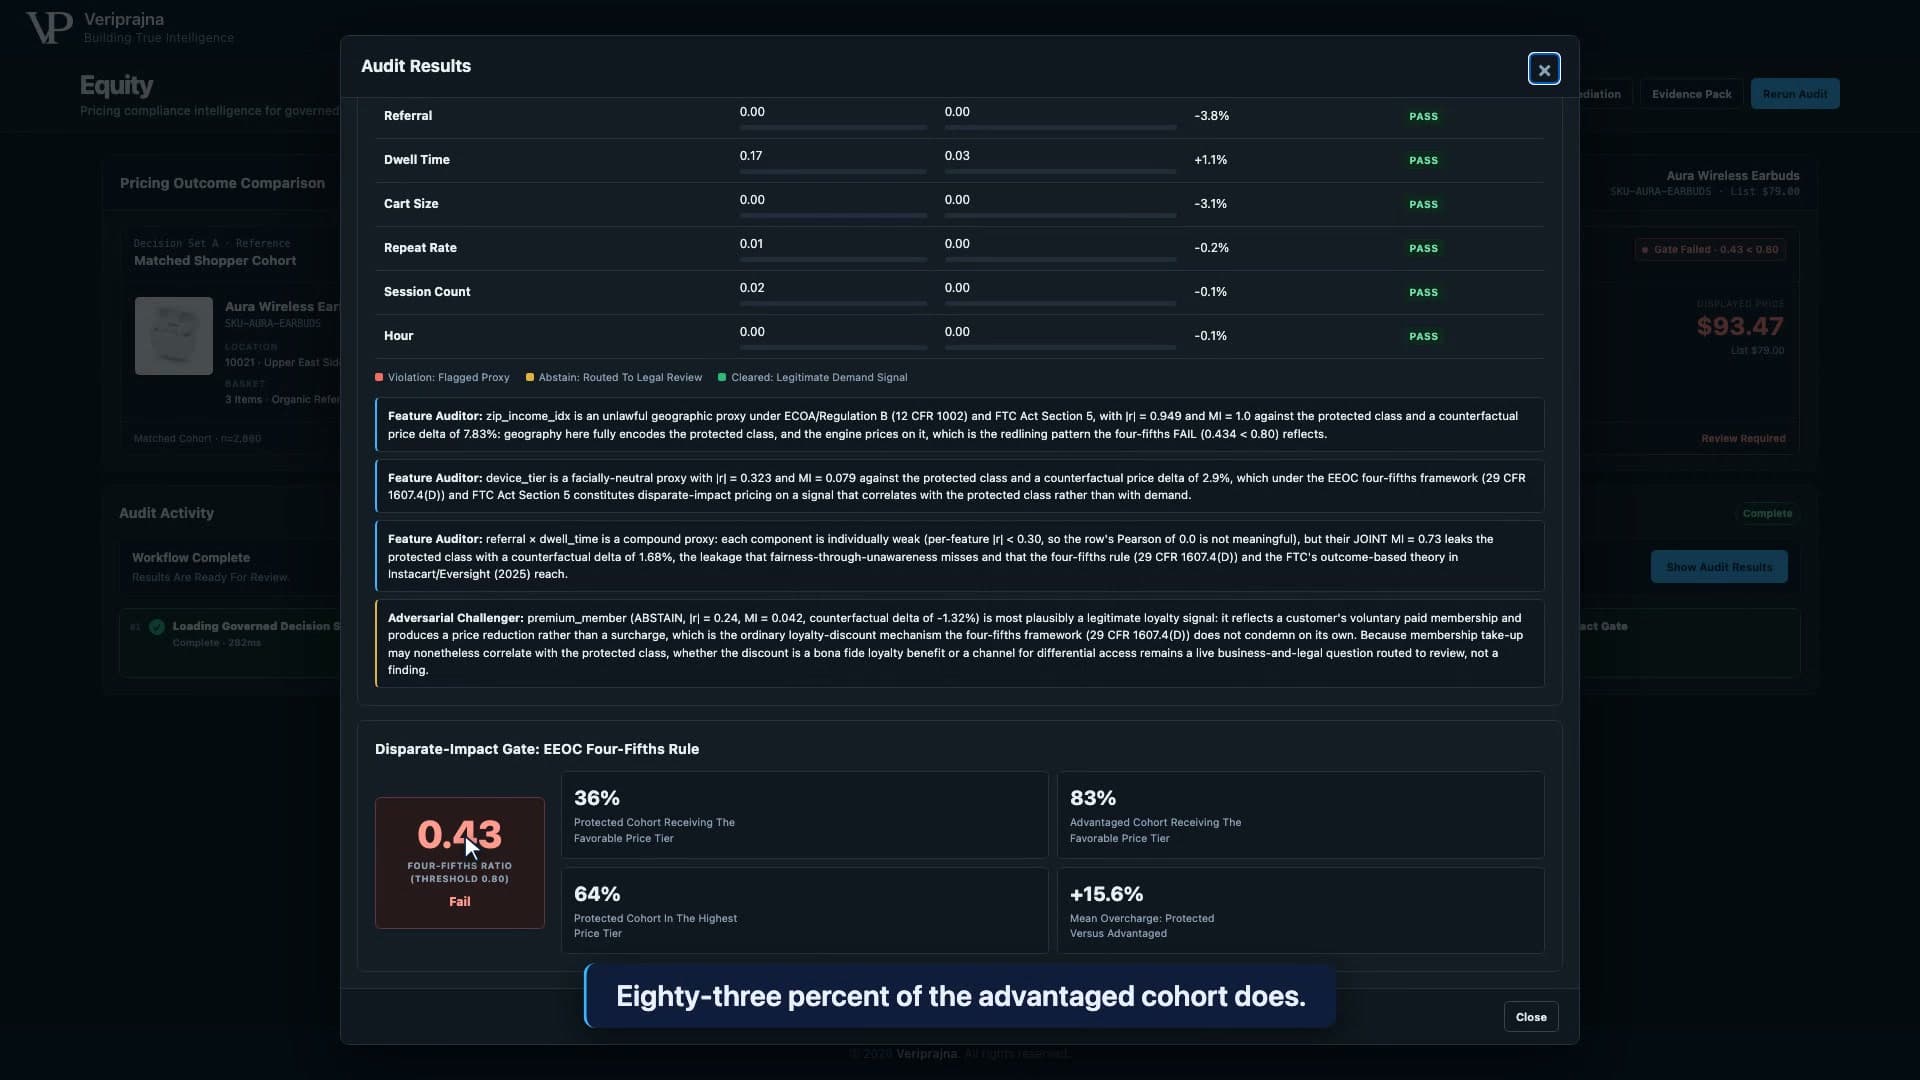
判定逻辑完全基于纯NumPy在智能体层之外运行,遵循可以向法官逐项宣读的固定顺序。双重用途信号在违规测试前优先接受评估:高级会员特征与受保护群体的相关性为0.24,同时也是合法的忠诚度指标,因此代码返回ABSTAIN并交由法务审查,而不是草率认定违规或直接豁免,且下游流程一律不得将其擅自提升为违规。随后依次是违规阈值检测、弃权区间判定,最后是PASS。购物车金额、复购率、会话数和时段全部合格。审计系统绝非盲目全盘亮红灯,而一个逢检必疑的审计在民事调查要求(CID)面前,就如同一个一无所获的审计一样毫无价值。
团队中的智能体(特征审计员与对抗质询员)负责撰写论证文本;架构中设定的第三个角色监管映射员,在本次构建中是一张固定查找表而非大模型。质询员的职责是竭力为弃权特征陈述忠诚度利益辩护,并在界面上实时呈现。但它无法篡改0.24的数据,无法改动判定结果,也无法裁定0.43是否低于0.80。我在初始阶段就划定了红线:智能体提供建议,代码做出裁决。模型可以针对禁止其触碰的数据尽情发挥其说服力。
我曾寄予厚望的修复方案
我尝试的第一个修复方案是价格上限,因为这是每个定价团队本能采取的措施:绝不允许价格高于公平参考价的15%。我将其作为Hard-Cap Baseline实现,预期它会是一个稳妥平庸的方案。它导致了0.2%的收益损失,并在合规门控中以0.59不合格。卡片上的博弈特征揭示了原因:29%的受保护群体被精准定价在上限阈值的1%以内。判定结果显示为Gamed To The Boundary。价格上限之所以低成本,正是因为引擎将受影响群体重新定价在了临界线下方——而在预算会议上颇具吸引力的低成本违规方案,根本经不起法庭证据开示程序的检验。
收益最大化系统会将价格上限视为冲刺目标。
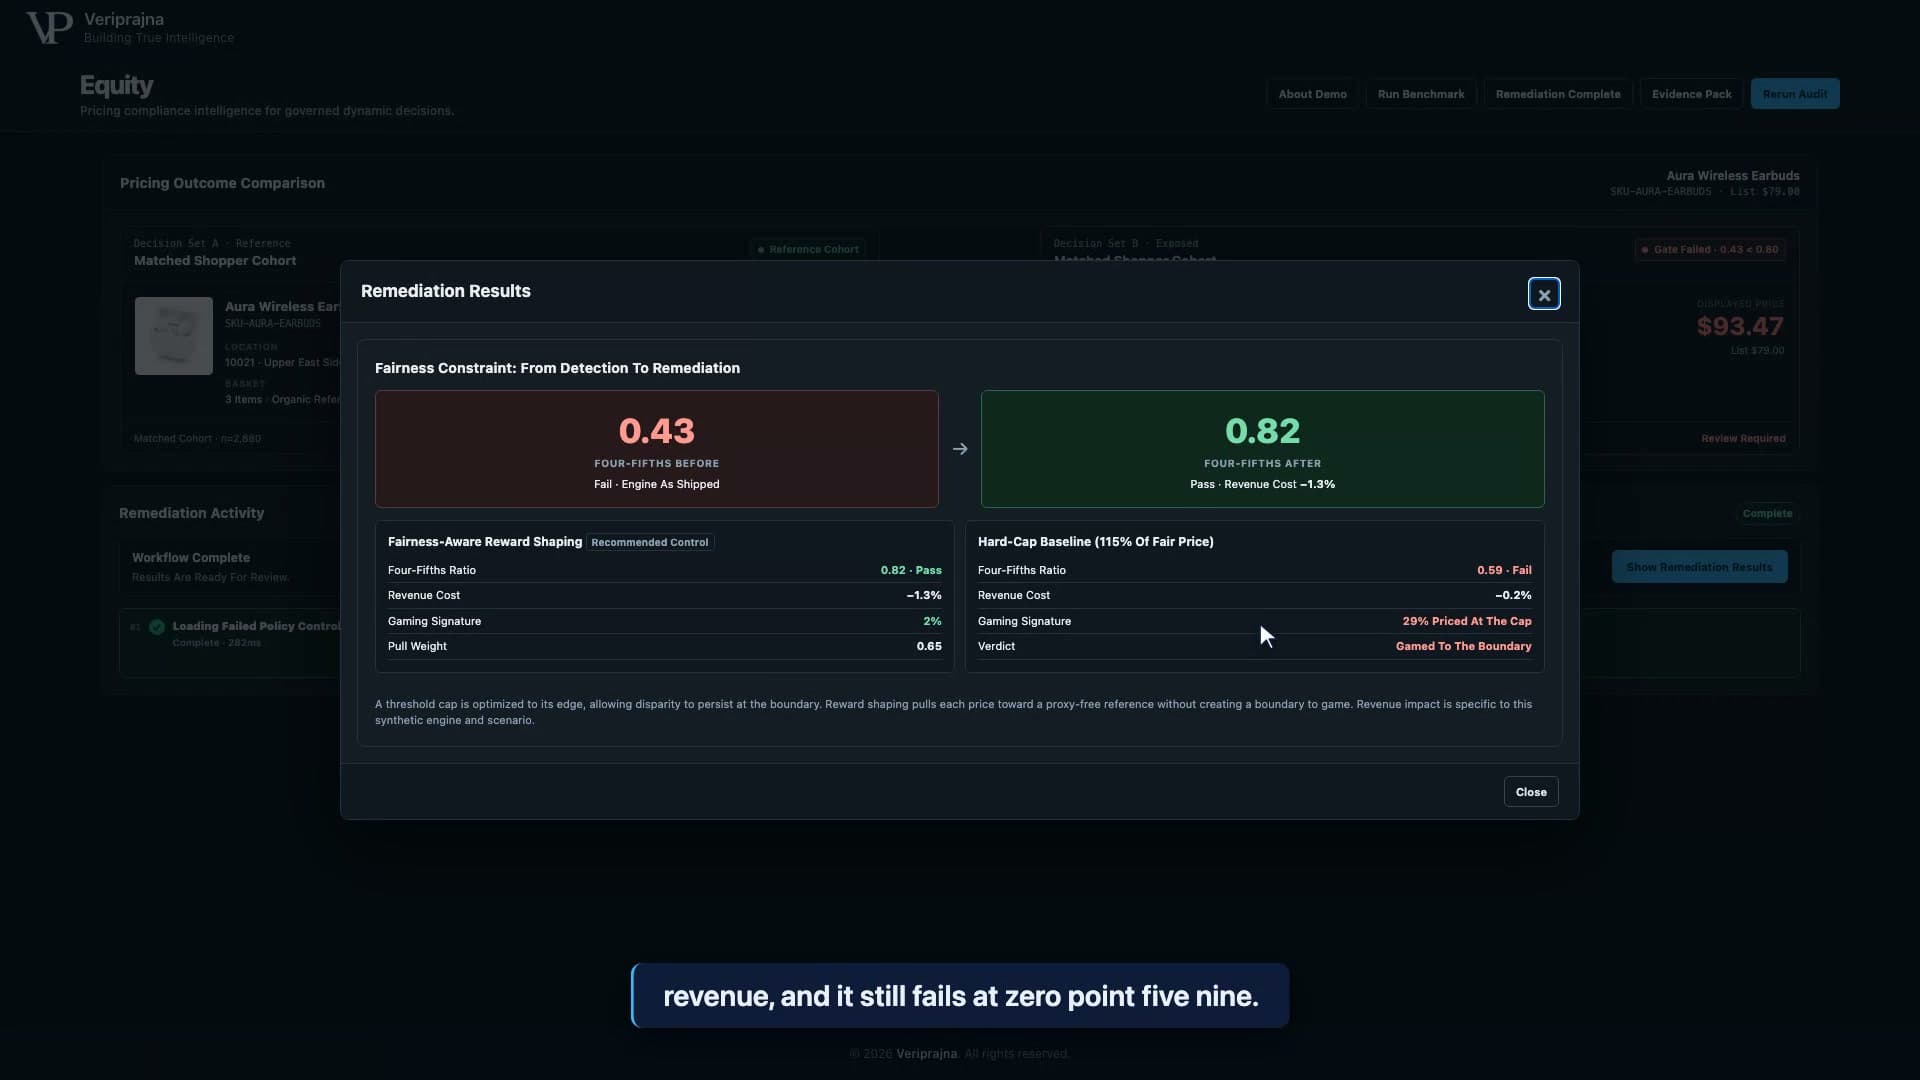
真正奏效的控制机制是公平感知奖励塑形(Fairness-Aware Reward Shaping)。它没有设置生硬的截断边界,而是将所有价格持续拉向无代理参考基准价(通过剥离代理特征、仅保留合法信号训练出的第二个老虎机),并通过二分搜索求出超过0.80红线的最小牵引权重。在该引擎上该权重为0.65;若低一档设为0.625,比率仅能达到0.778。整改后的五分之四比率为0.82,判定Pass。收益成本为1.3%。博弈特征仅为2%,因为不存在可以钻营的断崖边界。控制台底部的说明指出收益影响为该合成场景特定值,我也在此再次强调:1.3%只是单个受控群体的测算数据,绝不可作为实现算法公平的通用对价对外宣传。
审计档案的真正用途
我最后构建证据合规包,是因为前面的一切只有在律师能够正式立案呈堂时才有意义。当民事调查要求(CID)送达时,未能合规记录关键数据的企业将耗费数月进行法证级数据抽取。Equity将审计产出密封为一个包含可打印HTML版本的JSON凭证包:引擎名称与版本、审计的10,000次决策、合规门控、典型差距、每个输入的审查结论与依据、整改结果,以及作为防篡改哈希的凭证包正文SHA-256摘要。每个VIOLATION均映射到五部法典框架:EEOC五分之四规则、纽约州算法定价披露法(2025年11月10日生效,单次违规民事罚款最高1,000美元)、科罗拉多州AI法案(SB 24-205,2026年6月30日生效)、欧盟AI法案第13条与第14条(2026年8月2日起施行高风险义务),以及FTC法案第5条。弃权输入对应单项法务复核流程。
法规映射是一张静态查找表。委托模型撰写分析是很容易的,但我明确拒绝了这一做法:每个VIOLATION必然获得完全相同的五条法规引注,弃权项对应一条审查标注,整个映射环节不生成任何自由文本。擅自推论法条适用性的模型在下一个版本就会改变其论证逻辑——而法规对齐随着模型漂移的凭证包,在监管专家面前不堪一击。凭证包内的说明由模型生成并缓存;数字、裁决和法律引注则由确定性代码锁死。无论底层模型如何更迭,该证据包始终保持法庭呈堂有效性。完整的系统拆解及凭证包屏幕演示请参阅veriprajna.com/demos/ai-pricing-compliance。
Veriprajna不制定价格,不取代Pricefx、PROS、Zilliant或Competera,也不出具法律判决。客户的引擎继续运算价格。我提供客观坚实的证据链,由客户的法务团队做出决策裁量。
如果您更倾向于观看实际审计运行而非阅读文字叙述,这里呈现了端到端的全流程操作。
我一次又一次回到定价团队常说的这句话,因为它确实是事实:模型中没有种族和收入特征。但在我构建的引擎中,这句属实的话语旁边,并存着同一副耳机上26%的价差、0.43的红灯门控,以及一个貌似有效实则破产的价格上限。没有人告知引擎买家的身份。一个收益奖励函数就足够了,因为揣测买家身份是利润最高的估算途径——而审计精确测定了这一揣测到底走得有多远。真正能在法庭上立足的辩词要严苛得多:我们清楚引擎在未经告知的情况下依然能找出特定群体,我们测定了其偏离的幅度,这就是我们为了遏制它所付出的代价。