2026年,近1000亿美元正涌入主权AI算力。将AI基础设施保持在受控边界之内,已不再是小众的国防需求——它正在成为全球受监管企业与政府的默认姿态。我们的做法是打造让主权AI在运营层面真正落地、而非仅停留在战略宣示的基础设施。
"主权"究竟意味着什么(以及它不意味着什么)
主权不等于数据驻留。数据驻留告诉你数据存放在哪里;主权告诉你谁控制着数据运行所依赖的技术栈。AWS于2026年1月推出其欧洲主权云(European Sovereign Cloud),以一家在德国注册、物理隔离的实体提供90多项服务。这满足了数据驻留要求,却不满足结构性主权,因为 US CLOUD Act 无论数据实际存放于何处,都授予对其的域外访问权。
一份 2026年2月的Callista基准测评 发现,Scaleway等欧盟本土供应商所提供的 每欧元价值约为4.8倍 ,相比AWS而言,同时提供真正的 第3层独立性(Layer 3 independence):欧盟所有权、欧盟运营控制权,以及零CLOUD Act暴露风险。
我们的方法首先是精确定位买方需求落在主权谱系的哪个位置,这一做法在 我们关于为后信任时代企业架构主权智能的研究中有详细阐述。以下每种姿态都对应不同的架构、不同的成本曲线和不同的合规映射——而这三种我们都能架构:
- 完全气隙隔离(Full air-gap) ,配备数据二极管,零外部网络连接。
- 私有云 ,控制路径中不含任何美国总部的供应商。
- 符合ITAR的基础设施 ,其中处理受控技术数据的AI工作负载始终保持在仅限美籍人员(US persons-only)的边界之内。
别人都不做的依赖审计
大多数"主权"部署其实并不主权。它们会泄漏。单独来看,每一处泄漏只是一个小的配置疏忽;但汇总起来,它们意味着你的气隙部署根本没有气隙。常见元凶包括:
- NVIDIA GPU Operator的 默认Helm chart会在每次Pod重启时从 nvcr.io 拉取容器镜像。
- HashiCorp Vault自2023年其许可证变更为BSL以来,默认包含会回连(call home)的许可证验证端点。
- 默认的Kubernetes DNS配置会向上游根服务器进行解析。
- NTP同步以此为目标: pool.ntp.org。
- Prometheus导出器会回连以检查更新。
OpenBao,即Linux基金会的分支(2.5.0版本,2026年2月),在MPL 2.0许可证下消除了Vault的回连依赖,同时增加了命名空间和水平读扩展等企业级功能。
我们的实践是在环境被声明为主权之前,先运行一次系统性的依赖审计,这正是以下研究背后的准则: 我们关于软件完整性与弹性系统的研究:每一条DNS查询路径、每一个NTP目标、每一条容器镜像溯源链、每一个许可证验证端点,以及每一个埋藏在子chart的values.yaml中的遥测信标。一次交付会产出一份经过审计的物料清单,其中每一项外部依赖要么被镜像到内部服务,要么被可证明地消除。
这是硬件供应商、云服务商和托管平台公司都不会做的工作——因为他们的商业模式不激励去发现并修复最后那2%的泄漏,而正是这些泄漏会让主权声明在审计中站不住脚。
真正能离线工作的气隙GPU基础设施
气隙AI集群并不是把网线拔掉的标准Kubernetes部署。NVIDIA GPU Operator通过本地镜像仓库支持断网安装,但该配置要求预先暂存每一个容器镜像、驱动包和CRD定义。
MIG(多实例GPU) 分区在共享节点上提供硬件级的租户隔离,为A100和H100 GPU提供19种受支持的混合策略配置文件。NVIDIA的 KAI Scheduler于2025年以Apache 2.0协议开源,增加了GPU分数分配和拓扑感知调度,在生产基准测试中将集群利用率从 13%提升至37% 。
我们的做法是架构完整的离线制品供应链:一个带漏洞扫描的Harbor镜像仓库、带密码学校验的镜像化软件包仓库、用于双向TLS的内部证书颁发机构,以及使用GPS或铷原子钟源的内部NTP层级——这也是我们以下成果背后的同一套基础: 主权私有LLM的可运行演示。
对于涉密环境,我们集成来自Owl Cyber Defense等供应商的单向数据二极管,它们以基于物理原理的方式保障单向数据流,速率最高可达 100 Gbps。模型权重(一个700亿参数模型运行时超过130 GB)通过这些二极管移动,全程处于密码学的监管链之下:签名的制品包、每一次交接时的校验和验证,以及从预发布提升到生产时的双人完整性规则。
主权硬件上的机密计算
NVIDIA H100 是首款配备硬件可信执行环境(TEE)的GPU,其信任根锚定于片上。在机密计算模式下,加密的反弹缓冲区在CPU与GPU的TEE之间传输数据,确保管理程序(hypervisor)和主机操作系统都无法以明文访问模型权重或推理数据。
Intel Trust Authority 在单一验证工作流中为Intel TDX CPU TEE和NVIDIA H100 GPU TEE提供复合式远程证明。当威胁模型包含内部人员访问时,这一点尤为重要:在标准部署中,一名在主机上拥有root权限的系统管理员可以读取GPU内存,这一风险我们在以下研究中有所探讨: 我们关于保护私有企业LLM的研究。
我们的方法是配置完整的远程证明链,从固件度量到针对主权验证服务的远程证明,使该环境能够产出密码学证明,证明代码与数据未被篡改——即便是被设施运营方篡改也无法逃过验证。
出口管制决定你能构建什么、在哪里构建
用于主权AI的GPU采购如今已是一个出口管制问题。归入 ECCN 3A090和4A090 的芯片(H100、H200、A100、B200、GB200、AMD MI300X)带有因目的地而异的出口许可要求。一项自 2026年1月15日 起生效的BIS规则,将面向中国的H200审查改为逐案审批,尽管随后中国海关又独立地封堵了进口。2025年12月的一项调查发现,有芯片以伪造的"Sandkyan"品牌装运,以规避管制。
对于美国境外的主权买家而言,这带来了实实在在的架构约束。即便没有出口方面的复杂情况,采购周期也长达 8至16周 ,而那些在设计完成之后才启动采购的组织,通常会再增加两到三个月。
我们的做法是将采购规划纳入架构阶段:识别哪些芯片可在哪些许可例外下获得、哪些替代硅片可避开限制性层级,并将软件栈设计为具备硬件可移植性,从而使未来的芯片更换不会迫使重新架构。
监管映射是架构,而非文书工作
合规要求会塑造基础性的架构决策,而不是事后再拴上去。每一套监管制度都映射到具体的技术约束:
- GDPR第44条 限制个人数据向欧盟/欧洲经济区(EU/EEA)以外的转移,从而决定训练数据可以驻留在何处。
- ITAR 将在非美国基础设施上对受控技术数据进行的AI处理视为未经授权的出口,强制要求使用GovCloud或Azure Government。
- CMMC二级(Level 2) 要求使用通过FIPS 140-3一级验证的加密——而许多商用AI工具无法满足这一点,因为它们使用的是不带FIPS验证模块的标准TLS。
- 印度2025年DPDP Rules 采用黑名单方式实施数据本地化,BFSI领域的行业监管机构施加了更严格的强制要求。
- GAIA-X标签3级 认证是EUCS High+方案的先声,要求完全免受非欧洲司法管辖的干预。
在海湾地区,沙特阿拉伯的 1000亿美元 主权AI基金以及阿联酋的 5吉瓦 AI园区正在推动大规模的基础设施建设。
我们的方法是将每一套监管制度映射到具体的架构决策:加密标准、数据驻留边界、人员访问控制、审计日志粒度,以及事件响应流程。这套映射被设计为与基础设施即代码(infrastructure-as-code)共存,而不是放在一份会与现实脱节的独立合规文档夹里。
关于成本与周期的对话
联想2026年的TCO研究发现,对于高利用率工作负载,本地部署(on-premises)的AI基础设施在不到四个月内即可达到与云的成本持平,每百万token的成本优势最高可达 18倍 ,相较于MaaS API而言。对于典型工作负载,盈亏平衡点落在 10至15个月之间。
构建周期为3到9个月,裸机构建则延长至12个月。初始成本方面,LLM/RAG流水线搭建为 5万至20万美元 ,另加企业集成的 7.5万至35万美元 。
我们会坦诚说明主权基础设施在何时是错误答案:低于TCO交叉点的低量工作负载、缺乏平台工程能力来支撑持续运营的组织,以及托管式主权云服务商无需定制基础设施即可满足监管要求的情形。在这些情况下,我们的建议是选择合适的服务商,而非自行构建定制方案。
为什么不雇一家大公司
埃森哲(Accenture)向其AI业务投入了30亿美元。德勤(Deloitte)与NVIDIA合作提供AI Factory即服务。麦肯锡(McKinsey)旗下的QuantumBlack拥有约5,000名AI专家。他们的主权项目在首次投产之前要耗时4到10个月。
我们是基础设施工程师。一次交付的范围被界定为产出一个可运行的主权环境:基础设施即代码(Terraform、Helm、Ansible)、运维手册、容量规划模型、经过演练的灾难恢复流程,以及CIS基准加固报告。
德勤报告称, 42%的公司 在2025年放弃了大部分AI计划,平均每个项目 720万美元 的沉没成本。解药是一次以产出可运行基础设施为目标的交付,而不是又一个被放弃的计划。
关键要点
- 主权是对技术栈的控制,而非数据的存放位置 ——无论数据实际存放于何处,US CLOUD Act都能穿透仅做数据驻留的方案。
- 我们能架构全部三种姿态: 完全气隙隔离、 不含美国供应商的私有云,以及 符合ITAR的 基础设施。
- 一次系统性的 依赖审计 能封堵那些会让大多数主权声明在审计中失效的泄漏(nvcr.io拉取、Vault回连、DNS/NTP/遥测)。
- 气隙GPU集群采用MIG隔离、KAI Scheduler(利用率13%→37%)、离线制品供应链,以及速率最高100 Gbps的数据二极管。
- H100硬件TEE 加上Intel Trust Authority远程证明,可保护模型权重,即便面对拥有root级权限的内部人员或设施运营方也是如此。
- 各监管制度(EU AI Act、GDPR第44条、ITAR、CMMC二级、印度DPDP、GAIA-X)被直接映射进基础设施即代码。
- 在高利用率下,本地部署可在不到四个月内达到与云持平(每token优势最高18倍);预期产出是可运行的基础设施,而不是一份耗时4到10个月的幻灯片。
基础设施与主权部署
 观看
企业级深度伪造检测与视频通话欺诈防护 | Veriprajna
2024年2月,攻击者利用AI生成的整个高管团队深度伪造影像,在一次视频通话中从Arup窃取了2,560万美元。自2026年1月起,标准网络保险保单明确将深度伪造欺诈排除在外。
 观看
智能电表 AI:AMI 预测性维护与固件验证 | Veriprajna
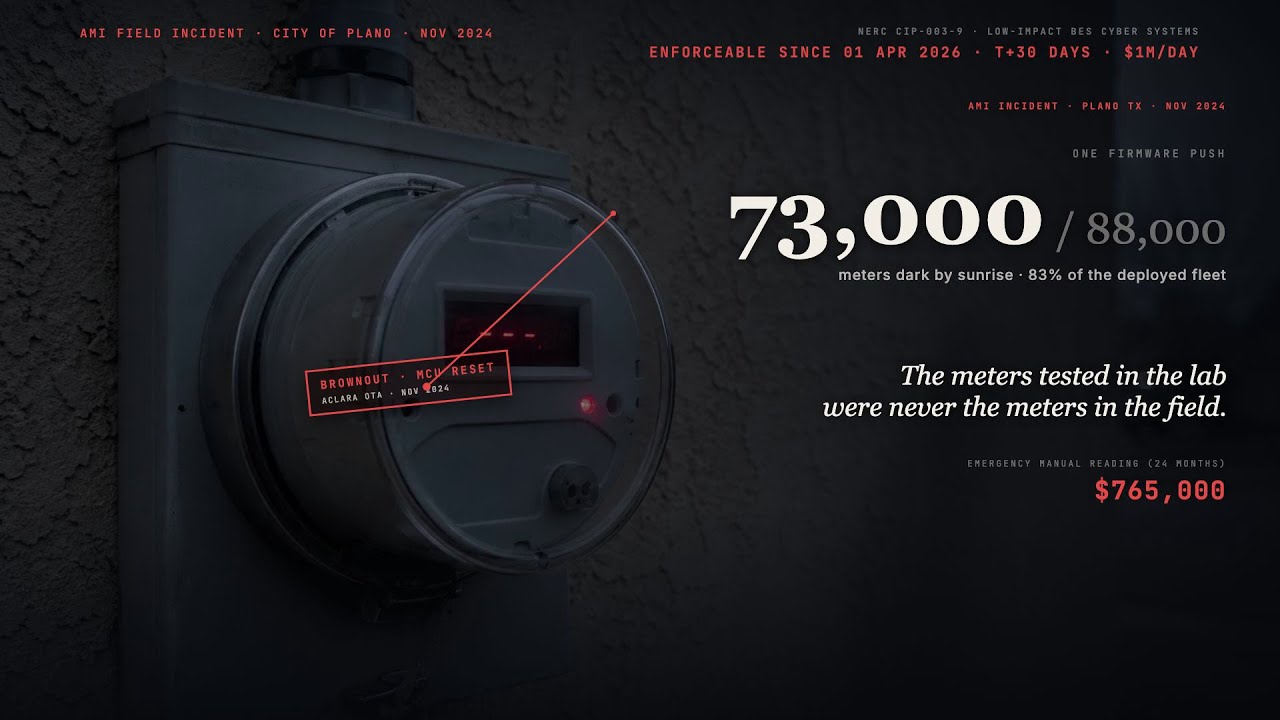
一次糟糕的固件推送让德克萨斯州普莱诺市付出了 765,000 美元的代价,并导致 73,000 块电表掉线。孟菲斯正在花费 900 万美元进行修复。您的 AMI 主站系统能追踪哪些电表停止了通信。


常见问题解答
相比云,主权AI基础设施的成本是多少?
经济性取决于利用率。联想2026年的TCO研究发现,对于高利用率工作负载,本地部署的AI基础设施在不到四个月内即可达到与云的成本持平,每百万token的成本优势最高可达18倍,相较于模型即服务(MaaS)API而言。对于典型的企业工作负载,盈亏平衡点落在持续使用的10至15个月之间。初始部署成本方面,LLM与RAG流水线搭建为5万至20万美元,另加企业集成的7.5万至35万美元。对于无法达到TCO交叉点的组织,更适合选择OVHcloud或Scaleway等托管式主权云服务商,它们以约每欧元4.8倍于AWS的价值提供真正的欧盟主权(Callista基准测评,2026年2月)。
部署主权AI基础设施需要多长时间?
周期为3到9个月,对于从裸机开始的完整本地部署构建则延长至12个月。最常见的瓶颈是硬件采购:NVIDIA H100和H200集群的交付周期为8到16周。那些在设计完成之后才启动采购的组织,通常会再增加两到三个月。我们将采购规划纳入架构阶段,并让各工作流并行推进:硬件订购、软件栈设计、依赖审计和监管映射同时进行。已拥有现有私有云基础设施的组织可以大幅压缩周期。
AWS GovCloud或Azure Government是真正的主权吗?
它们满足数据驻留和特定的合规框架(FedRAMP High、DoD IL4-6、CMMC二级),但并不提供结构性主权。US CLOUD Act授予对由美国总部公司持有的数据的域外访问权,无论数据实际存放于何处。对于ITAR工作负载和美国国防用例,GovCloud和Azure Government是正确选择,因为ITAR本身强制要求使用美国控制的基础设施。对于寻求摆脱美国司法管辖触及的欧盟组织,或正在构建国家AI能力的政府而言,这些平台并不满足第3层主权要求。这一区别至关重要:目前61%的西欧CIO正专门为缓解这一风险而优先选择本地云服务商。
在大多数部署中,哪些隐藏依赖会破坏主权?
我们发现的最常见泄漏包括:NVIDIA GPU Operator的Helm chart在Pod重启时从nvcr.io拉取容器镜像。HashiCorp Vault的许可证验证回连(随2023年切换到BSL而引入)。默认的Kubernetes DNS向上游根服务器解析。NTP同步以pool.ntp.org为目标。Prometheus导出器检查更新。Helm子chart的values.yaml文件中硬编码的外部仓库URL。监控代理中的遥测信标。证书吊销检查访问外部OCSP响应器。单独来看微不足道,但汇总起来,它们意味着你的气隙部署正在对外通信。我们在将环境声明为主权之前,会对每一条网络依赖运行系统性审计。
在美国境外做主权部署,我可以采购哪些NVIDIA GPU?
GPU可获得性取决于你所在的司法管辖区。归入ECCN 3A090和4A090的先进计算芯片(H100、H200、A100、B200、GB200、AMD MI300X)带有因目的地国家和最终用途而异的出口许可要求。一项自2026年1月15日起生效的BIS最终规则,调整了针对特定芯片-国家组合的审查政策,但执行情况仍在变动。我们帮助客户驾驭采购:识别哪些芯片可在哪些许可例外下获得、AMD MI300X或Intel Gaudi是否能为你所在的司法管辖区避开最具限制性的层级,并将软件栈设计为具备硬件可移植性,从而使未来的芯片更换不会迫使完全重新架构。
你们如何在气隙环境中更新AI模型?
通过一条密码学监管链流水线。一个700亿参数模型超过130 GB,因此传输需要规划。对于配备单向数据二极管的环境(Owl Cyber Defense、Waterfall Security),签名的制品包通过基于物理原理的单向通道向内流动,速率最高可达100 Gbps。对于依靠物理拷贝(sneakernet)的环境,我们使用加密的物理介质,在每一次交接时进行校验和验证,并对生产提升采用双人完整性规则。该流水线包括:带有可追溯至训练环境的密码学签名的模型打包、摄入时的完整性验证、带自动化验证测试的预发布部署,以及需要双重授权的提升关卡。每一步都记录到防篡改的审计轨迹中。
哪些法规要求使用主权AI基础设施?
多套监管框架如今强制要求或强烈激励采用主权部署。EU AI Act(2026年8月2日全面适用)要求对高风险系统进行自动事件日志记录和数据血缘追踪。GDPR第44条限制个人数据向欧盟/欧洲经济区(EU/EEA)以外的转移。ITAR将在非美国基础设施上对受控技术数据进行的AI处理视为未经授权的出口。CMMC二级(2026年11月9日前纳入国防部合同)要求使用通过FIPS 140-3验证的加密。印度2025年DPDP Rules支持特定行业的数据本地化。欧盟的DORA和NIS2指令正在使主权云对某些金融和关键基础设施工作负载成为强制要求。GAIA-X标签3级是EUCS High+认证的先声,该认证要求免受非欧洲司法管辖的干预。
在什么情况下主权AI基础设施不是正确选择?
三种情形。第一,无法达到本地部署投资回本的TCO交叉点的低量推理工作负载。如果你每年的云AI支出低于10万美元,主权基础设施的资本成本和运营负担很可能超过其带来的节省。第二,缺乏内部平台工程能力(或缺乏托管运营预算)来在交接后运行GPU加速的Kubernetes集群的组织。主权基础设施需要持续的运营投入。第三,托管式主权云服务商(OVHcloud、Scaleway、Deutsche Telekom)已能满足你的监管要求、而定制基础设施只会徒增复杂度却无收益的工作负载。我们帮助客户在投入资本之前划清这条界线。
满怀信心地构建您的 AI。
与一支在打造新一代企业级 AI 方面拥有深厚经验的团队携手合作。让我们助您设计、构建并部署一套值得信赖的 AI 战略。
Veriprajna 深度科技咨询公司 专注于为医疗健康、金融和监管等领域构建安全攸关的 AI 系统。我们的架构均依据成熟的规范进行验证,并配有完善的合规文档。