您的 AI 应用距离一场诉讼可能仅仅相隔一次糟糕的输出。加拿大航空(Air Canada)的聊天机器人承诺了违反公司政策的抚恤票价退款,加拿大法院裁定该航空公司承担法律责任。一家雪佛兰(Chevrolet)经销商的聊天机器人在遭遇提示词注入攻击后,同意以一美元出售一辆 Tahoe 汽车。DPD 的快递机器人被越狱并生成脏话,在 24 小时内获得了 800,000 次浏览。
这些绝非假设场景。它们是那些在缺乏充分安全层的情况下推出 AI 的企业所发生的真实生产事故。“在演示中可行”与“在生产中安全”之间的鸿沟,正是大多数 AI 部署停滞不前的原因——而这正是我们安全基础设施旨在弥合的鸿沟。
生产级护栏的真实形态
生产级护栏栈绝非单一工具。它是一个分层架构,每一层都能捕获其他层遗漏的问题,且任何单一层的故障都不会危及整个系统。我们的方法是由五个独立层设计并构建这些栈。
输入筛查
提示词注入检测采用微调分类器,而非正则表达式。顶尖开源检测器的 F1 分数约为 0.91,但生产级检测需要针对新型攻击模式进行持续再训练。我们部署混合检测:快速分类器对不可信输入进行高吞吐量扫描,不确定案例则路由至基于推理的 LLM 兜底保障。金丝雀令牌(canary token)监控可捕获绕过这两层的注入尝试(详见 我们关于对抗性 AI 防御的研究)。
内容分类
安全分类器根据可配置的分类体系对输入和输出进行评估。Llama Guard 3、ShieldGemma 和 Qwen3Guard 各自覆盖不同的风险类别,具有不同的准确率特征。来自 2025-2026 年基准测试的关键发现: Llama Guard 在良性输入上实现了 97-99% 的准确率,但仅能检测出 4.5-21.8% 的对抗性内容。
综合表现最佳的 Qwen3Guard-8B 准确率为 85.3%,但在非源自公开数据集的新型提示词上骤降至 33.8%。现成的分类器只是基准线,而非完整的防御体系。我们根据您的具体威胁模型对它们进行选型、组合与增强。
策略执行
运行时规则限制了 AI 可以表达、承诺或执行的内容。这正是加拿大航空与雪佛兰事故的根源所在:模型可以生成任何输出,包括合同承诺和定价决策,而在模型生成与用户之间没有任何防线。
我们的方法是实现确定性策略引擎,旨在每个输出到达任何下游使用者之前对照您的业务规则进行评估(参见 我们关于在确定性架构中封装概率模型的技术白皮书)。定价承诺、法律措辞、授权范围和数据披露边界均被定义为机器可评估的规则,而非提示词指令。
输出验证
该层涵盖个人身份信息(PII)脱敏、有害内容过滤、事实一致性检查以及特定领域的约束验证。PII 检测阐明了分层的必要性:基于正则表达式的检测召回率约为 65%,会导致多达 35% 的敏感数据泄露。基于命名实体识别(NER)的检测在标准实体上的 F1 达到 94-96%,但在新型格式和对抗性混淆下失效。
我们同时运行二者——由正则表达式处理结构化模式(信用卡、社保号、电话号码),由机器学习模型捕获依赖上下文的实体(姓名、地址、自由格式标识符)——并根据您的误报容忍度进行校准。
智能体安全
对于使用工具、执行代码或调用 API 的 AI 系统,仅靠输出过滤是远远不够的。护栏必须在执行前介入,而非事后补救。我们的方法是构建规划阶段验证,旨在任何操作触发前检查工具调用、参数值和执行计划(参见 企业级 AI 责任护栏的在线演示)。分级风险审批机制会自动放行低风险操作,标记中风险操作以供日志记录,并对数据库写入、金融交易或外部通信等高风险操作强制要求人工授权。
鲜有人提及的误报问题
在仔细算清数学账之前,堆叠安全分类器听起来像是不错的工程实践。如果每个护栏达到 90% 的准确率,而您同时运行五个,那么在给定的请求中所有五个护栏均准确的概率将降至 59%。这意味着 41% 的合法请求会被错误标记。您的用户将不再信任系统,您的支持团队将陷入海量上报升级之中,而您的安全投资也将沦为用户体验的负资产。
我们的方法通过分层架构解决这一问题,而非暴力堆叠。快速的基于规则的检查(微秒级延迟)处理明显的违规行为。机器学习分类器(50-200ms)处理细微的内容。大模型充当裁判(LLM-as-judge,数秒级)仅处理更低成本层无法解决的模棱两可的边缘案例。
每一层都配备经过校准的置信度阈值,只有当前一层的置信度低于其阈值时,请求才会逐级升级到更高成本的层。这种设计使得 90%+ 的请求的总护栏开销控制在 200ms 以内,同时对真实威胁保持高检出率。
为何现成护栏必不可少但仍远远不够
护栏市场分散在开源框架、托管平台和云提供商特性之间。每个方案都解决了拼图中的一块;但没有一个能够端到端解决问题。
| 工具 | 提供功能 |
|---|---|
| Guardrails AI | 具有 50+ 预置检查项的可组合验证器。 |
| NeMo Guardrails | 基于 Colang 的对话策略管理。 |
| AWS Bedrock Guardrails | 跨模型提供商运行,具备 PII 脱敏与自动化推理(Automated Reasoning)检查功能。 |
| Lakera Guard | 跨 100+ 种语言的 50ms 以内提示词注入检测。 |
2026 年的生产团队通常在同一系统中运行 NeMo Guardrails 进行对话管理,并运行 Guardrails AI 进行输出验证。这种集成属于定制化工作。云提供商提供了强大的基准覆盖,但在特定领域策略的定制化方面十分有限。
多模态护栏(图像、音频和视频输入)几乎缺乏工具支持,尽管攻击者通过对前沿模型进行简单的图像变换即可实现 75-82% 的攻击成功率。平台所提供的能力与生产安全实际需求之间的差距,正是我们服务项目所要攻克的工作。
监管压力切实存在而标准尚未就绪
《欧盟 AI 法案》的高风险条款将于 2026 年 8 月 2 日全面生效。CEN/CENELEC JTC 21 正在制定协调一致的技术标准,以界定高风险 AI 系统“适当的风险缓解”所指的内涵,但他们错过了最初设定的 2025 年 8 月截止期限,目前目标调整为 2026 年第四季度。决定合规性的具体技术标准目前尚不存在。
NIST AI RMF 1.0 与生成式 AI 概况(AI-600-1)将包含内容过滤在内的护栏列为预期控制措施。OWASP 针对大语言模型应用的 2025 年十大安全漏洞新增了系统提示词泄露(System Prompt Leakage)与向量/嵌入漏洞(Vector/Embedding Weaknesses)作为新类别,反映出大多数企业安全团队尚未建立防护监测的威胁。
等待最终标准出台才着手构建安全架构的企业,届时将在毫无缓冲期的情况下疲于应对最后期限。我们设计的护栏架构既能在当前监管框架下站得住脚,又能灵活适配仍在起草中的标准(参见 我们关于企业级 AI 智能体责任防火墙的研究)。
我们的交付成果
每个咨询项目均始于针对您的应用程序、数据及监管风险敞口的专属威胁模型。我们不销售平台。我们的方法是构建护栏架构,旨在根据您的延迟预算、误报容忍度及合规要求,将顶尖工具(开源和托管)整合为一个连贯的整体技术栈。
咨询项目的交付范围包括:
- 分层护栏架构,包含对每一层实测的延迟预算。
- 具备混合检测的提示词注入防御(分类器 + LLM 兜底保障 + 金丝雀监控)。
- 根据您的实体类型和误报容忍度进行校准的 PII 脱敏流水线。
- 源自您实际业务约束的策略执行规则,而非通用模板。
- 面向工具使用、代码执行和 API 调用的智能体安全控制。
- 对抗性测试套件,尝试利用当前攻击技术(PAIR、GCG、间接注入、多模态注入)绕过各个层。
- 具备漂移检测、分类器性能退化告警及由事件触发的再训练流水线的护栏可观测性体系。
- 与《欧盟 AI 法案》、NIST AI RMF 及 OWASP LLM Top 10 控制措施的监管映射对照。
我们同时提供客观诚恳的评估:您现有的平台护栏已涵盖哪些风险、哪些缺口需要定制化开发,以及哪些威胁更适合通过上游架构变更(数据治理、模型选型、访问控制)来化解,而非仅在上层盲目叠加更多安全层。
AI 安全护栏与验证层
 观看
AI 定价合规与算法公平性 | Veriprajna
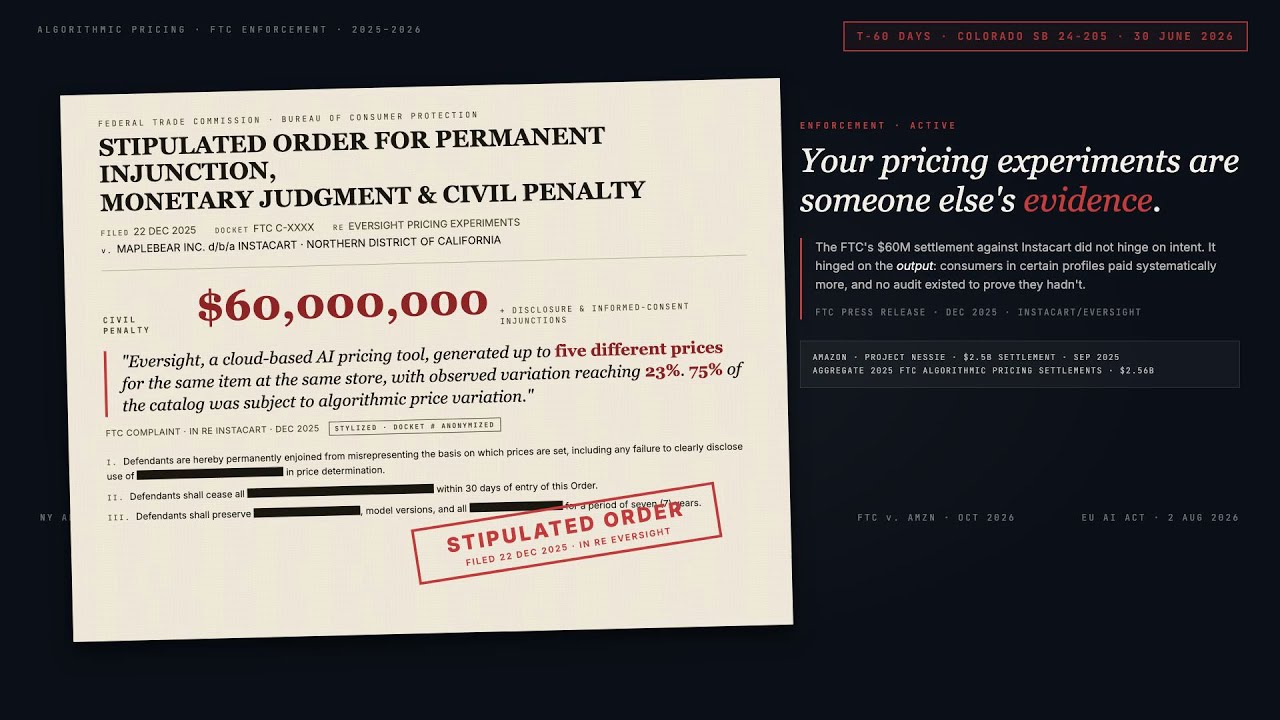
2025 年,FTC 从两家公司收取了 25.6 亿美元的算法定价和解金。纽约州、加利福尼亚州和科罗拉多州相继出台法律,使每一个由 AI 驱动的价格都可能构成违规。
 观看
AI 验证与反 AI 洗白合规 | Veriprajna
在监管机构发问之前佐证你的 AI 主张。Veriprajna 为应对 SEC、FTC 及各州总检察长合规要求的企业构建 AI 验证架构、AIBOM 系统和主张佐证材料包。
 观看
企业 AI 责任与护栏 | Veriprajna
2023 年 12 月,一个聊天机器人同意以 1 美元的价格出售一辆价值 76,000 美元的雪佛兰 Tahoe。2024 年 1 月,一个快递聊天机器人写了一首诗,称自己所在的公司毫无用处。2024 年 2 月,一个丧亲服务聊天机器人编造出一个根本不存在的退款期限,仲裁庭判定该航空公司承担责任。


常见问题解答
实施 AI 护栏需要多少成本,决定预算的关键因素是什么?
成本取决于三个变量:您需要多少层、您的延迟预算是多少,以及您的策略具有多强的领域专属性。使用开源分类器(Llama Guard、Guardrails AI 验证器)结合云提供商护栏(Bedrock、Azure)的基础技术栈实施成本较低,但需要持续微调。定制提示词注入分类器、特定领域的策略引擎以及智能体安全控制则需要更多工程投入。拥有针对 AI 的特定安全控制措施的企业,其数据泄露成本平均降低了 $2.1M,而忽略护栏的代价始终高于构建护栏。我们根据您的实际威胁模型确定项目范围,而非按平台收取固定费用。
在堆叠多个安全分类器时,如何减少误报?
复合准确率问题切实存在:五个准确率均为 90% 的分类器意味着只有 59% 的合法请求能够顺利通过全部五个检查。解决方案是分层架构,而非增加更多分类器。我们设计分层技术栈,其中快速规则检查(微秒级延迟)处理明显的违规行为,机器学习分类器(50-200ms)处理细微内容,大模型充当裁判(LLM-as-judge,数秒级)仅处理低成本层无法解决的模糊案例。每一层都配备校准的置信度阈值,因此请求仅在必要时逐级升级。这使得 90%+ 的流量总开销保持在 200ms 以下,同时确保检出质量。
NeMo Guardrails 对比 Guardrails AI 与 Llama Guard:在生产环境中应该使用哪一个?
它们解决不同的问题,并且通常协同使用。NeMo Guardrails 使用基于 Colang 的策略跨五个流水线阶段管理对话流(100-300ms 延迟,在 NVIDIA 基础设施上更低)。Guardrails AI 提供包含 50+ 预置检查项的可组合输出验证器(每次验证 50-200ms)。Llama Guard 是用于内容审核的安全分类器(1B 变体在总体准确率上实际上以 59.9% 对比 48.4% 优于 8B)。2026 年的生产团队通常在同一系统中运行 NeMo 进行对话管理,并运行 Guardrails AI 进行输出验证,同时由 Llama Guard 或 ShieldGemma 负责内容分类。我们根据您的延迟预算和威胁暴露面来设计集成架构。
对于使用工具并调用 API 的 AI 智能体,我们需要哪些护栏?
对于智能体系统,仅靠输出过滤是远远不够的。当 AI 智能体可以执行代码、调用 API、写入数据库或发送通信时,护栏必须在执行前的规划阶段进行干预。我们构建工具使用验证机制,在任何操作触发前检查每个函数调用、参数值和执行计划。这包括参数类型检查(智能体会伪造参数名称并传递错误的数据类型)、作用域执行(智能体仅能访问明确允许的工具),以及分级风险审批路由:低风险操作自动放行,中风险操作进行日志记录和标记,而高风险操作(金融交易、数据库变更、外部通信)则强制需要人工授权。
在生产环境中如何阻止提示词注入攻击?
没有任何单一技术能够阻止所有提示词注入。最佳的生产级防御是分层的:快速微调分类器(特定领域检测器的 F1 约为 0.91)以高吞吐量筛查所有不可信输入。不确定的案例路由至基于推理的 LLM 进行更深入分析。嵌入在提示词中的金丝雀令牌(canary tokens)可检测提取尝试。基于困惑度(perplexity)的异常评分可捕获对抗性令牌序列。针对间接注入(检索文档、图像、PDF 中的隐藏指令),内容在进入模型上下文之前会被单独扫描。防御体系需要持续演进,因为提示词注入依然高居 OWASP 大语言模型风险首位,且理由充分:在缺乏充分防御的情况下,自动化攻击对专有模型的成功率可达 80-94%。
符合《欧盟 AI 法案》合规要求需要哪些 AI 安全护栏?
《欧盟 AI 法案》的高风险条款将于 2026 年 8 月 2 日全面生效,但界定“适当风险缓解”的协调一致技术标准(由 CEN/CENELEC JTC 21 制定)错过了最初截止期限,目前目标调整为 2026 年第四季度。该法案要求为高风险 AI 建立包含书面缓解措施的风险管理系统。NIST AI RMF 及其生成式 AI 概况(AI-600-1)规定了包含内容过滤在内的护栏。OWASP 2025 年大模型十大漏洞将系统提示词泄露和向量嵌入漏洞列为新的威胁类别。我们设计的护栏架构在当前框架下具备抗辩力,并能灵活适配仍在敲定中的标准。违规行为最高可面临 3500 万欧元或全球年营业额 7% 的罚款。
在生产环境中,我们如何监控护栏是否切实有效运行?
安全分类器往往会悄无声息地发生退化。在 2025-2026 年基准测试中综合表现最佳的 Qwen3Guard-8B(总体准确率为 85.3%),在不在其训练分布内的新型提示词上准确率暴跌至 33.8%。如果没有监控,当这种情况发生时您将毫不知情。我们构建护栏可观测性系统,持续跟踪检出率、误报率、各层延迟以及分类器置信度分布的变化情况。当输入分布偏离分类器的训练分布时,漂移检测会发出告警。当识别出新型攻击模式时,由事件触发的再训练流水线会更新分类器。这绝非单纯的仪表板,而是随着威胁演进而使您的护栏保持有效的运行基础设施。
模型级安全(RLHF、宪政 AI)是否足够,还是我们同样需要运行时护栏?
模型级安全必不可少,但单凭它显然是不充分的。RLHF 和宪政 AI(constitutional AI)建立的是行为偏好,而非架构层面的约束。OWASP 2025 年指南明确指出:系统提示词不是安全控制措施,因为大语言模型具有随机性而非确定性,本质上无法充当可审计的安全边界。自动化越狱攻击利用行为对齐与结构性强制执行之间的差距,对专有模型的攻击成功率达到 80-94%。运行时护栏在模型生成过程之外的确定性代码中运行,使其具备可审计性、可测试性,且完全独立于模型行为。您需要双管齐下:以模型级安全降低有害输出的基准频率,并通过运行时护栏捕获模型对齐所遗漏的内容。
满怀信心地构建您的 AI。
与一支在打造新一代企业级 AI 方面拥有深厚经验的团队携手合作。让我们助您设计、构建并部署一套值得信赖的 AI 战略。
Veriprajna 深度科技咨询公司 专注于为医疗健康、金融和监管等领域构建安全攸关的 AI 系统。我们的架构均依据成熟的规范进行验证,并配有完善的合规文档。