2025年,AI系统的威胁态势已从学术研究转向实际业务利用。数百万开发者所依赖的生产级AI工具如今携带具有高CVSS评分的CVE漏洞,攻击面正在软件、供应链和硬件层面同时扩大,而监管合规倒计时已经开启。单点方案供应商和治理框架只能解决其中部分环节,但都无法从架构层面构建起运行中AI部署的安全态势。这正是我们为之构建解决方案的差距所在。
生产级AI正遭受主动攻击,而多数安全体系未能跟上步伐
2025年使AI利用从概念验证转变为数百万开发者所依赖工具中记录在案的CVE漏洞:
- Microsoft 365 Copilot ——一个零点击提示注入漏洞(CVE-2025-32711, CVSS 9.3),其中单封精心构造的恶意邮件即可触发远程数据外泄。
- GitHub Copilot ——通过嵌入公开代码仓库的代码注释被攻陷(CVE-2025-53773),并提权升级至远程代码执行。
- Cursor IDE ——一个大小写敏感漏洞(CVE-2025-59944),允许攻击者操纵智能体行为以执行任意命令。
这些并非概念演示。它们是生产级工具中具有确切CVSS评分的真实CVE。同时,攻击面正在三个方向上同时扩大。
智能体系统与信任边界
智能体AI系统带来了传统边界安全无法解决的信任边界难题。仅有 29%的机构 表示已准备好保障智能体部署的安全,而 MITRE ATLAS v5.4.0 (2026年2月)新增了针对智能体专属威胁的专用技术,包括“发布受投毒的AI智能体工具”与“逃逸至宿主机”。
AI供应链攻击
供应链攻击已从理论演变为现实实践。 JFrog 发现了约 100个恶意模型 在Hugging Face上带有内嵌代码执行有效载荷,而 Palo Alto Unit 42 证实已删除的Hugging Face命名空间可被任何人重新注册,从而实现供应链劫持。
硬件层漏洞
这项 GDDRHammer攻击(2026) 表明,非特权CUDA内核可以通过GDDR6行锤击(rowhammer)获得对GPU内存的任意读写访问权限——这意味着多租户GPU环境存在任何软件层防御都无法封堵的硬件攻击面。
不断叠加的监管压力
监管正在同步收紧。 《欧盟人工智能法案》的 禁止类实践于2025年2月生效,高风险系统要求将于2026年8月强制实施,罚款高达 3500万欧元或全球营业额的7%。 CISA 于2025年9月将提示注入归类为关键AI漏洞; NIST 发布了 AI RMF 2.0 ,并在2026年1月提供了专门的提示注入防御指南。在生物识别隐私法案 CUBI管辖下,得克萨斯州罚没了 Google的$1.375 billion以及Meta的$1.4 billion (仅在2025年)。合规负担每个季度都在持续加重。
AI供应链是多数机构毫无可见度的薄弱地带
当我们评估企业AI部署时,供应链漏洞始终是最具危险性的发现。大多数机构无法提供其生产环境中正在运行哪些模型的完整清单,更不用说验证它们的来源(这也是 我们关于保护企业模型免受投毒的研究的主题)。一份 Lineaje调查报告(2025年6月) 发现, 48%的安全专业人员 表示其机构已经在基础软件物料清单(SBOM)要求上掉队。而机器学习物料清单(ML-BOM)的采用率则要低得多。
这一风险已得到证实,绝非停留在理论层面:
- Anthropic、英国AI安全研究所与阿兰·图灵研究所 证实,仅需 250份恶意文档 即可成功在参数量涵盖 600 million至13 billion参数的语言模型中植入后门。
- DeepSeek的DeepThink-R1 模型(2025年1月)被发现存在后门,该后门由训练期间植入GitHub代码注释中的隐藏提示生成。即使在训练完成数月后且无需任何互联网连接,该模型在遇到特定触发词时仍会执行攻击者预埋的指令。
- Qwen 2.5的 搜索工具通过对抗性网络内容遭到投毒,导致经过对齐的模型仅凭一条 11个单词的查询语句便产生有害输出。
传统的安全扫描无法发现这些问题。Hugging Face运行 Picklescan 以检测恶意pickle文件,但恶意LoRA适配器、受投毒的训练数据集以及重新注册的命名空间均可绕过模型级扫描。标准已经存在—— CycloneDX 于2023年发布了ML-BOM规范, SPDX 3.0.1 定义了AI与数据集规范文件(Profiles),而 OWASP 推出了AI-BOM项目——但规范的可用性与机构的实际采用之间仍存在巨大鸿沟。构建AI供应链完整性需要十年前应用安全对待软件依赖项时的同等严谨纪律:自动化扫描、来源验证、持续监控,以及在风险穿透时的应急响应预案。
为何现有安全生态留下了架构层面的空白
AI安全供应商格局正在快速扩张,其单点解决方案实力强劲:
- Protect AI 融资超过 $108 million 并运营针对AI/ML漏洞的huntr.com漏洞赏金计划;它负责扫描模型产物中的已知漏洞。
- HiddenLayer ($56 million)专注于运行时模型行为监控。
- Lakera 打造了被广泛视为最佳提示注入检测产品之一的Lakera Guard。
- Cisco 于2024年收购了Robust Intelligence; F5 收购了 CalypsoAI(金额为$180 million) (2025年)。
单是AI红队测试市场规模预计就将从 2025年的$1.3 billion增长至2035年的$18.6 billion。但这些工具只是传感器和过滤器,而非结构性控制措施——它们都无法从架构层面设计AI部署的整体安全态势。利用这些组件构建安全计划的CISO仍需有人来设计:智能体系统中的信任边界置于何处、模型来源验证如何与CI/CD管线集成、部署后激活的后门由何种监控捕获,以及当合规团队要求推理过程不得离开特定管辖区域时主权部署究竟该如何落地。
四大跨国咨询机构已投资超过 $10 billion (自2023年以来在AI领域的总投入): PwC 运营着一项 $1 billion生成式AI计划 并建立了OpenAI合作伙伴关系; KPMG 拥有一套正式的 10大支柱AI治理框架,并映射至ISO 42001标准; Deloitte 构建了 100多个生成式AI加速器; EY 正在为受监管行业部署NVIDIA AI Factory基础设施。它们的治理与合规工作切实有效。
但当客户需要对RAG管线进行实战对抗性测试、在多智能体系统中防范间接提示注入的架构加固,或落地部署带有模型权重完整性验证的主权AI基础设施时,治理框架是远远不够的。这其中的差距在于:仅仅知晓风险所在,与拥有从结构上规避风险的工程实现能力之间,存在着根本区别。
我们为AI安全体系构建的工程能力
我们在架构层面开展工作,因为唯有在架构层面,安全决策才具备结构性效力。在输入层过滤提示注入已被证实会在遭遇自适应攻击时失效。下载后扫描模型虽能捕获已知特征,却会遗漏新型供应链攻击。治理框架指明了应当监控什么,却无法替你搭建监控体系。我们专注于架构决定安全态势能否经受考验的四大核心领域——包括主权部署,这一点我们已在 私有化LLM实操演示中得到验证。
主权AI基础设施
对于在数据主权约束下进行部署的机构,我们的方法是构建使模型、推理及训练数据均保留在受控边界内的基础设施。这绝非针对API调用的简单VPC包装。这意味着需要针对本地硬件选型并量化模型——在 GPTQ、AWQ与GGUF 量化方案之间的权衡对性能与安全皆至关重要——配置面向多租户环境的GPU隔离、实施模型权重的密码学证明,并构建可检测异常推理行为的监控技术栈。主权部署被定义为一项 为期六个月的工程项目,而非简单的配置变更——它是端到端工程化实现的成果,绝非通过外壳拼凑而成。
供应链完整性
我们设计了在任何模型进入生产环境之前运行的验证管线(详见 我们关于ML全生命周期AI供应链完整性的研究):涵盖模型权重与训练数据的自动化来源检查、序列化格式验证(始终选用safetensors而非pickle)、LoRA适配器完整性验证,以及针对命名空间劫持或权重篡改对上游代码仓库进行的持续监控。其预期交付成果是一份 ML-BOM ,详细映射每个组件的来源、每个依赖项的版本以及每个训练数据集的谱系。
对抗性加固
我们将红队测试与架构修复相结合,对照 MITRE ATLAS 分类法以及 OWASP LLM Top 10 v2.0 开展全面测试——但仅凭测试并不能解决问题。当智能体系统的工具调用接口容易受到检索文档引发的间接提示注入攻击时,我们会构建信任边界架构,在结构上将不可信内容与特权操作严格隔离(参见 我们关于捍卫人机交互前沿安全的研究)。当RAG管线因精心构造的查询而泄露系统提示词时(OWASP LLM07,2025年版新增条款),我们会重新设计检索与生成管线以彻底杜绝此类泄露。
法规映射
我们将具体的各项技术控制措施直接映射至适用于您部署环境的合规要求: 《欧盟人工智能法案》 高风险合规义务、 NIST AI RMF 2.0、 OWASP LLM Top 10、美国各州生物识别法规(BIPA、CUBI、科罗拉多州H.B. 24-1130)以及特定行业合规要求。我们预期的交付成果绝非电子表格中的静态合规对照表,而是已经落地实施的控制措施,附带持续监控、合规证据生成与审计追踪,以此满足监管审查并降低 $4.63 million 的AI相关数据泄露平均损失。
核心要点
- AI利用已成实战而非学术探讨:2025年暴露出Microsoft 365 Copilot、GitHub Copilot及Cursor IDE中的真实CVE漏洞,且2026年出现了GPU硬件级的GDDRHammer攻击。
- 供应链是最危险的盲区——仅需250份恶意文档即可在模型中植入后门,而CycloneDX ML-BOM、SPDX 3.0.1和OWASP AI-BOM等标准的发展速度远快于企业的实际采用。
- 单点方案供应商与四大咨询机构的治理项目遗留了同样的空白:无人从架构层面构建部署的整体安全态势。
- 我们横跨四大领域在架构层开展构建——主权AI基础设施、供应链完整性、对抗性加固以及法规映射——将风险意识转化为具备结构性约束力的强制控制措施。
AI安全与弹性
 观看
AI 供应链安全与模型完整性 | Veriprajna
AI 供应链安全咨询。我们为受监管企业的 CISO 构建模型审查流水线、ML-BOM 架构与影子 AI 治理,符合 NIST AI 100-2 与 EU AI Act 合规要求。
 观看
生物识别与人脸识别合规审计 | Veriprajna
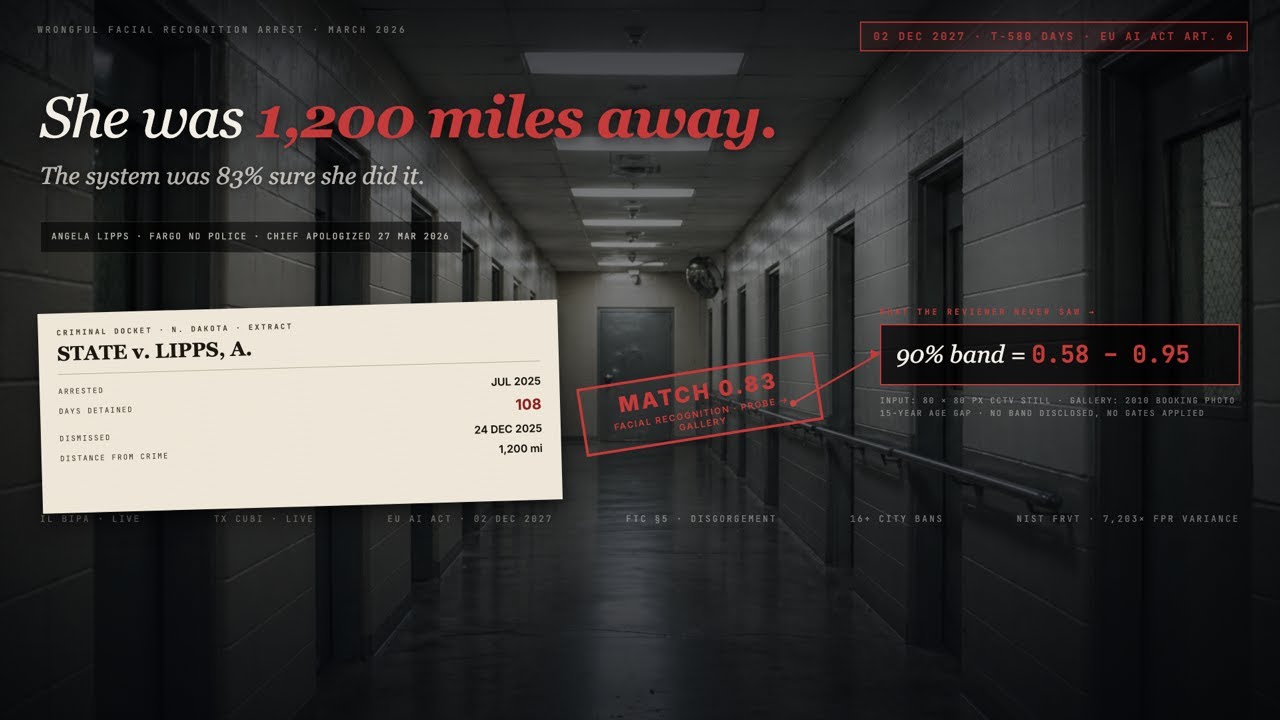
无论您已经部署了人脸识别、需要了解自身的风险敞口,还是正在评估供应商、希望一次就做对,我们都会依据真正重要的法规、基准和运营标准来审计生物识别系统。


常见问题解答
我们应该聘请AI安全咨询机构,还是自建内部AI安全团队?
坦率的答案是两者皆不可或缺,关键在于时机。从零组建内部AI安全团队需要12至18个月来完成招聘、培训与实战化运作。当前人才储备极度匮乏:既能对生产级LLM系统实施红队测试、又能从架构层面设计修复方案的实战型AI安全研究员极为罕见。在您逐步建立内部能力的同时,咨询机构能助您以更快速度确立具备防御力的安全态势。我们的典型咨询周期为3至6个月,涵盖评估现有AI部署态势、构建安全架构(供应链验证、信任边界、监控体系)、对关键系统开展红队测试,并将安全体系完整文档化以便您的内部团队接管维护。实现平稳交接是我们的最终目标:我们负责构建体系与工具链,由您的团队负责日常运营。为期6个月的咨询投入,仅占单起AI安全事件损失或生物识别集体诉讼和解金的一小部分(得克萨斯州仅在2025年就从Google和Meta罚没索赔了28亿美元)。
一次AI安全评估需要多长时间,涵盖哪些内容?
一项全面的AI安全评估通常持续4至8周,具体取决于评估范围内的AI系统数量。第一周进行AI资产测绘:盘点生产环境中的每个模型及其来源、部署方式、数据流向和访问控制。大多数机构都会在此阶段发现此前未察觉正在运行的影子模型。第二周至第四周对照MITRE ATLAS分类法与OWASP LLM Top 10 v2.0开展对抗性测试,包括提示注入(直接与间接)、供应链完整性验证、数据外泄测试以及通过工具调用接口的提权测试。最终阶段交付带有架构改造建议的优先级整改计划,而非仅仅罗列漏洞发现。我们将每一项发现映射至适用的法规要求(《欧盟人工智能法案》、NIST AI RMF,以及涉及生物识别系统时的BIPA/CUBI),从而使整改措施能够同步消除安全缺陷与合规缺口。
在生产环境中,究竟什么手段能真正有效防御提示注入?
没有任何单一防御手段能可靠抵御提示注入。潜在的注入攻击空间是无限的,而规则过滤器仅能针对有限的模式特征。在受控测试中,针对任何单层防御的自适应攻击成功率均超过85%。真正行之有效的是分层架构防御。输入验证能够拦截显而易见的粗糙攻击;利用LLM-as-critic开展输出验证,相比仅进行输入过滤可将检测精度提升21%(基于HackAPrompt数据集中超过60万条对抗性提示的实测结果)。但最为核心的是结构性控制:在架构层面将不可信内容与特权指令彻底物理隔离、在工具调用接口上严格执行最小特权原则、对高风险高影响操作引入人工审批确认机制,并精心设计检索管线以确保检索到的文档无法篡改或覆盖系统级指令。特别是对于智能体系统,智能体之间的信任边界必须是明确界定并强制执行的,绝不能凭空预设安全信任。我们将这些架构控制深度嵌入系统肌理,而非仅仅在外部加挂过滤外壳。
当我们使用来自Hugging Face的开源模型时,该如何保障AI模型供应链的安全?
首先必须清醒认识到:Hugging Face只是一个公开的开源仓库,绝非经过严格安全审查的供应链。JFrog发现了约100个内嵌代码执行有效载荷的恶意模型;Palo Alto Unit 42证实已删除的命名空间可被攻击者重新注册;在缺乏完整性验证的情况下,恶意LoRA适配器与正常的微调权重在外表上毫无二致。行之有效的实战防御包含四个层级:第一,绝不在生产环境中加载pickle序列化模型,强制要求采用在设计上天然不具备可执行性的safetensors格式;第二,验证模型来源谱系:对照已知良好的基准,审查代码提交历史、贡献者信誉以及模型权重校验和;第三,采用CycloneDX或SPDX 3.0.1标准构建机器学习物料清单(ML-BOM),详尽追踪模型每个组件的来源、版本与依赖关系;第四,在每次模型更新进入CI/CD管线之前执行自动化安全扫描,并持续监控上游仓库是否存在命名空间变更或异常权重变动。我们将这一套验证管线深度内嵌为您MLOps工作流的有机组成部分,而非脱节的手工流程。
将于2026年8月生效的《欧盟人工智能法案》对高风险AI系统提出了哪些安全要求?
《欧盟人工智能法案》的高风险要求(于2026年8月2日正式生效)强制规定了多项具体安全控制措施,包括抵御对抗性攻击的鲁棒性、训练数据集的数据治理、AI系统设计与测试的技术文档记录、人机协同监督机制,以及全生命周期内的准确性与可靠性监控。针对最严重违规行为的罚款高达3500万欧元或全球年度营业额的7%。企业面临的现实挑战在于该法案的要求是基于原则性而非规定性的。“适当的鲁棒性水平”并未明确告知您需要执行哪些具体的对抗性测试。我们将法案要求精准映射至具体技术控制:对齐MITRE ATLAS的对抗性测试协议、满足法案透明度要求的供应链完整性检查、生成监管机构所需合规证据的监控系统,以及将法规条款追溯至已实施控制的技术文档。如果企业仅将其视为打勾应付的形式主义合规,必将发现该法案的执法机制旨在穿透纸面治理材料,直接审查底层的实际技术落地实现。
我们如何全面掌握企业内部影子AI(Shadow AI)的使用情况?
影子AI是当前企业面临的头号运营级AI风险。调查显示,69%的企业怀疑员工在使用未经审批的生成式AI工具,平均每家公司每月发生223起向AI应用传输敏感数据的事件。影子AI引发的数据泄露平均损失达463万美元,显著高于常规泄露。一味封禁AI工具行不通;多项研究一致表明员工总会设法绕过禁令。SANS研究所提出的“Sunlight AI”理念更为契合实际方案:将影子使用置于透明可见之下,而非徒劳禁止。在技术层面,这意味着部署针对AI API流量的网络级检测、建立带有完善数据分类控制的合规工具目录、实施专门针对AI服务端点的数据泄露防范(DLP)规则,并制定使用规范为员工提供经过授权的安全AI使用途径。我们负责构建该技术监控层并将其与您现有的SIEM/SOAR安全技术栈深度整合,使AI使用态势能够直接呈现在安全运营中心(SOC)已有的监控大屏上。
当智能体能够调用外部工具并自主决策时,我们该如何保障此类智能体AI系统的安全?
智能体AI带来了单模型部署中所不存在的新型安全问题。受控实测显示,针对多智能体系统的攻击成功率高达84%,而单智能体架构约为50%。其核心痛点在于信任链传递:当智能体A信任智能体B的输出并据此发起工具调用时,一旦智能体B的输入被攻陷(例如通过检索文档中的间接提示注入),恶意影响就会在整个智能体网络中引发连锁级联反应。MITRE ATLAS v5.4.0现已将针对智能体的专项技术收录在册,包括发布受投毒工具和宿主机逃逸等。架构级防御要求在智能体之间建立清晰明确的信任边界、在每个工具调用接口上贯彻最小权限原则(仅需读权限的智能体绝不可拥有写权限)、在所有智能体间的信息交接处进行严格的输入净化,并针对具有现实影响的敏感操作设置人机协同确认关卡。我们针对具体的智能体部署环境量身定制信任架构,因为边界的合理划分完全取决于每个智能体的职能、可调用的工具以及所处理的数据资产。
我们应该选用MITRE ATLAS还是OWASP LLM Top 10作为AI安全框架?
两者应当并用。它们的设计目标截然不同且优势互补。OWASP LLM Top 10 v2.0(2025年版)是一份针对大语言模型应用的优先级风险清单,涵盖提示注入、敏感信息泄露、供应链脆弱性、过度授权代理(excessive agency)、系统提示词泄露以及向量/嵌入弱点等,它明确指出了哪些风险应优先处置。MITRE ATLAS则是一套对抗性威胁分类法,包含16种战术、84种技术和56种子技术,揭示了攻击者在现实中究竟如何攻破机器学习系统。ATLAS绘制攻击链条;OWASP确立风险优先级。在实务中,我们使用OWASP来界定评估涵盖的范围,并利用MITRE ATLAS来设计和组织对每个风险领域的测试方法。对于正在构建AI安全体系的企业,NIST AI 600-1(AI风险管理框架的生成式AI专篇)提供了连接上述两大框架与企业全面风险管理的顶层治理架构。三者结合,共同构成了风险优先级排序(OWASP)、攻击模拟方法论(ATLAS)与治理合规框架(NIST)的完整闭环。
满怀信心地构建您的 AI。
与一支在打造新一代企业级 AI 方面拥有深厚经验的团队携手合作。让我们助您设计、构建并部署一套值得信赖的 AI 战略。
Veriprajna 深度科技咨询公司 专注于为医疗健康、金融和监管等领域构建安全攸关的 AI 系统。我们的架构均依据成熟的规范进行验证,并配有完善的合规文档。