挽留AI做出提供优惠的决定需要充分理由

可能取消订阅的订户显然是提供挽留优惠的当然人选。这使得流失预测成为自动化极具吸引力的切入点。但真正有价值的问题在于,这一特定干预是否能充分改善结果以证明其成本合理。有人可能很有可能会离开,但不太可能从折扣中获益;而另一个人可能本来很有可能会留下,直到干预使情况变得更糟。
我希望挽留系统在获得撰写优惠文案的能力之前,先获得做出提供优惠这一决策的资格。一段有说服力的草案无法弥补干预是否有效的缺失证据。而表明优惠可能有所帮助的证据,也不能证明实际的消息内容是可以接受的。这是独立的判断,各有其暂不采取行动的独立理由。
相同数量的优惠可以产生不同的价值
我们的“Ethical Subscription Retention AI”演示使用合成订阅群组来使这种区别变得可检查。该对比根据隐藏的合成结果评估策略,因此可以将采取干预措施发生的情况与不采取干预措施发生的情况进行对比。这些隐藏结果用于评估,并不作为训练标签提供给模型。
在当前具有取消意向的群组6,000名订户中,预测性流失定向和因果增益分别触达了其中的2,239人。前者对流失风险进行排序;后者则针对扣除配置的折扣成本后的预估干预收益。相对于不对群组采取任何行动,预测性定向产生了$144,162的年化增量收入;增益则产生了$187,956。这些是合成策略评估,独立于演示的完整订户路由约束。它们既不是已实现的收入,也不是针对已部署服务的预测。
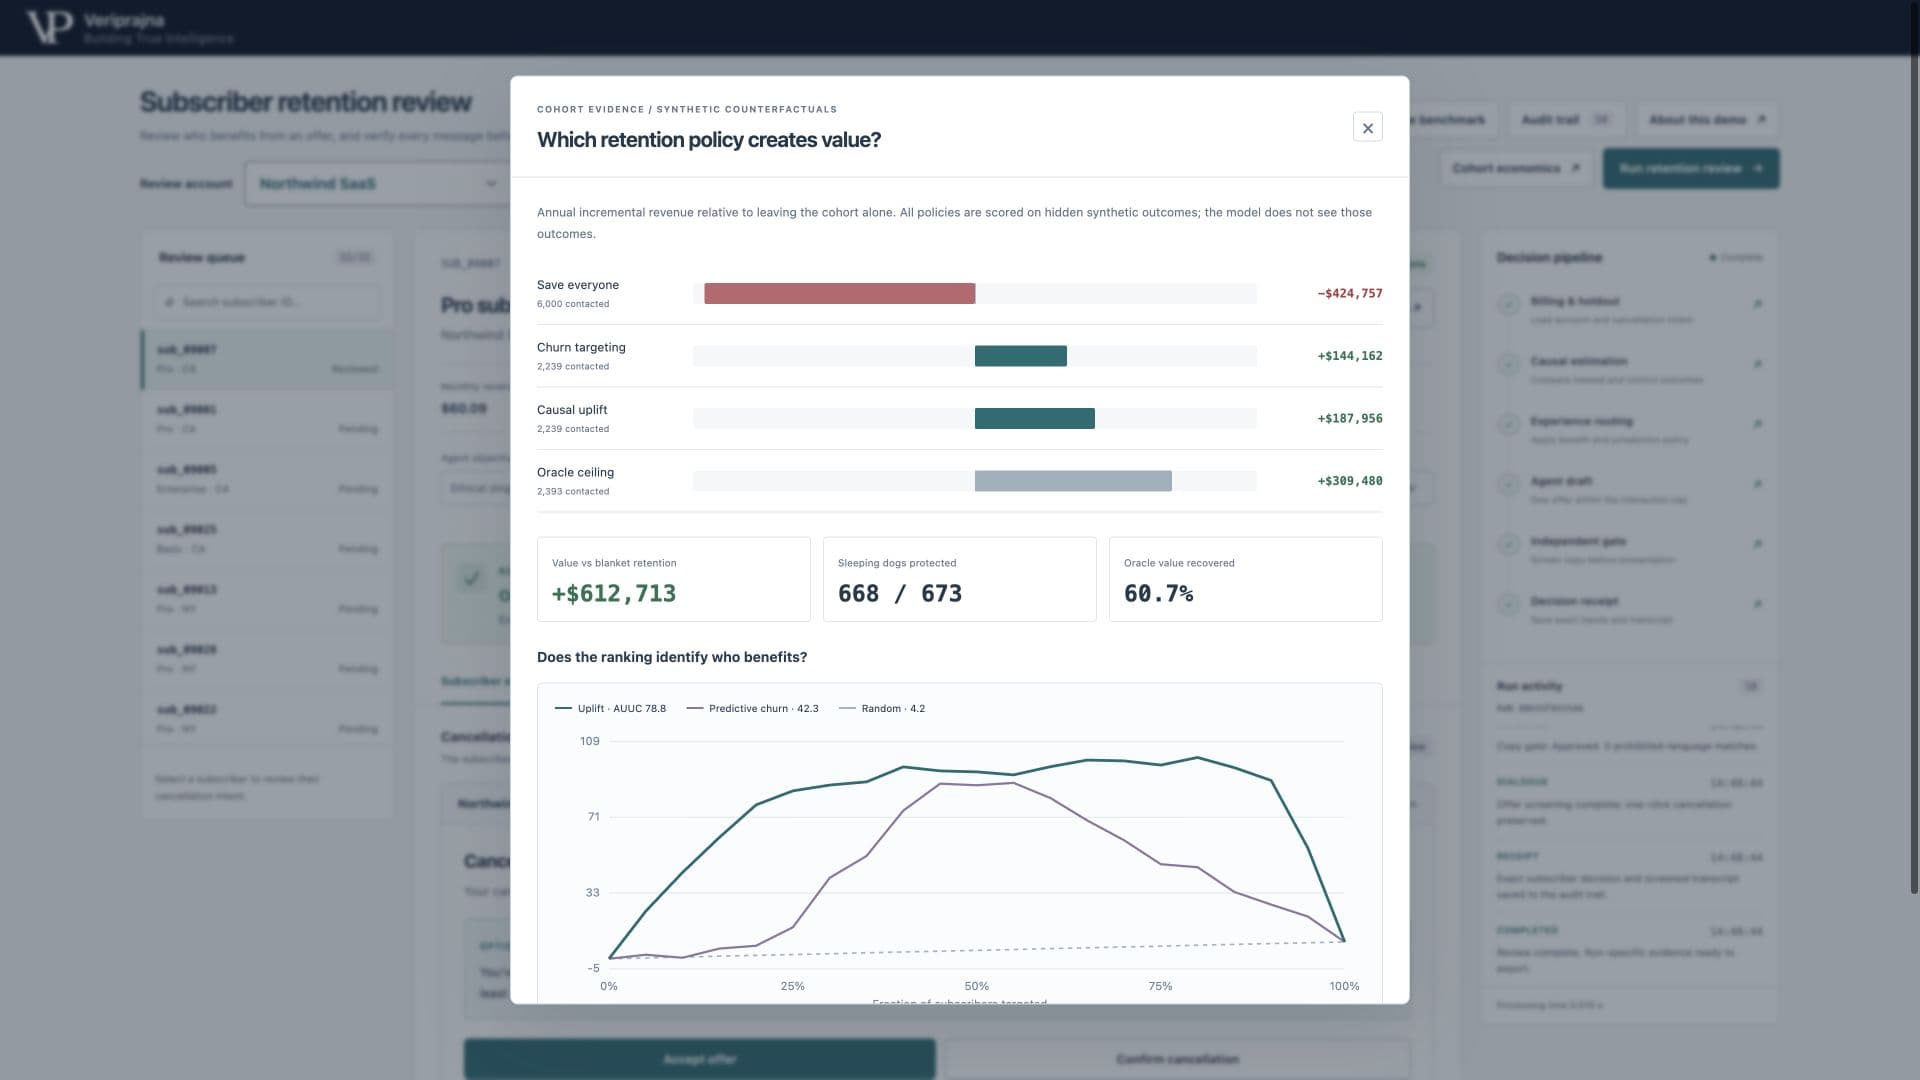
相同的触达预算至关重要。此处增益策略的优势并不在于减少优惠的发送量,而在于选择了不同的受众群体。一个团队完全可以在达成触达量目标的同时,依然把折扣浪费在无论如何都会留下来的人、优惠无法说服的人,或是因干预而受到负面影响的人身上。
这也改变了我对成功挽回的理解方式。接受折扣的订户对于优惠流程而言是一次显而易见的成功。如果该订户本会全价续订,那么该流程就买下了一个本无需花钱买下的结果。仅凭统计接受优惠的数量并不能揭示这一成本。评估需要与无干预情况进行对比,同时也需要考虑优惠本身的成本。
克制需要路由,而不仅仅是一个分数
该演示根据随机分配的干预组和对照组历史数据来估算存在干预和不存在干预时的留存率。二者之差即为预估因果增益:即模型下归因于干预的变化。这是一个预估值,并非单个订户已知的因果结果。
一个合成订户在有干预情况下的预估留存率大幅低于无干预情况。所选订户路由不记录任何挽留触达,并跳过草案起草。这些因干预受损情况的模型标签是Sleeping Dogs(受扰即走)。在该路由中,克制发生在有说服力的消息成为默认下一步之前。
整体策略并不完美。在合成群组中,它让673个真正的Sleeping Dogs中的668个免受触达,但依然触达了5个。隐藏的测试夹具(fixture)标签使我们能够统计这些遗漏。在已部署的系统中,这些并不能作为单一个体的基准事实(ground truth)。我将该结果视为检查有害干预的理由,而非声称因果模型消除了它们的凭证。
对于挽留团队而言,这是一个让人不适的边界:拒绝优惠可能会错失一次真正的挽回,而批准优惠可能会浪费折扣或使留存情况恶化。我的设计立场是让这两项成本都清晰可见。保守路由是不确定性下的选择,并且应该附带一个任何人都可以质疑的理由。
证据不足时该怎么做
演示中的第二个合成账户对于其配置的证据要求而言数据太少。该界面暂不提供因果决策预测,跳过智能体,并提供清晰的退出路径。这些阈值是演示规则,并非统计充分性的普遍检验。内部计算可能依然存在;关键的执行逻辑在于它们不会成为自动提供优惠的证据。
用流失分数替代这一缺失的因果建议很容易。这样做保留了自动化,但回答的却是不同的问题。流失的可能性高,并不能证明提议的折扣会改变决策。将这种替代称为后备方案(fallback),可能会掩盖系统原本旨在保留的核心区别。
对于处于这种情况下的假设性生产团队,我倾向于在收集与干预相关的证据期间,暂不提供自动化挽留折扣并临时退出。这在短期内会牺牲潜在的挽回机会,但也避免了基于一个无法衡量其收益的分数来做出大范围的折扣决策。该选择应当在评估中明确体现,而不是作为一个成功的弃权指标隐而不见。
如果团队选择通过新实验来学习,那么该实验需要一个干预组、一个无干预对比组以及一个明确定义的优惠成本。在那样的假设场景中,只有当相关人群的对比结果支持扣除成本后的增量价值时,我才会恢复自动化折扣。仅凭更多被接受的优惠并不能改变我的决定。该实验仍需要独立的消息和取消控制。仅仅积累更多流失观察数据并不能回答优惠改变了什么。这是一项独立的、经审慎授权的行动;该演示并没有实现这一生产学习过程。
优惠价值并不等同于批准消息
即使是一项经济上有前景的优惠,在触达订户之前也需要另一项决策。演示中编写的人工倒计时基准(artificial-countdown benchmark)使这一点具象化:起草模型外部的确定性词法把关(lexical gate)拦截了施压消息,这些字句不会出现在订户预览中。取消操作仍然可用。这是一个参考文案案例,而不是被拒绝的模型响应。它证明了在做出考虑提供优惠的决定之后暂扣消息的控制权。
该把关检测已配置的语言模式,因此通过把关并不意味着认证了每一个事实或含义。优惠和取消按钮也仅影响本地预览,未与生产计费系统集成。在这些限制范围内,该控制措施提供了一个有用的评估测试:不被允许的草案必须在把关处停下。如果仅发出警告却任由相同字句继续传递给订户,是无法实现这种行为的。
因此,评估此架构的团队应独立测试两件事:定向是否在扣除成本后创造增量价值,以及不被允许的消息是否确实被暂扣。强大的经济效益不能成为消息中施加压力的借口;干净的用词也无法挽救预期收益无法覆盖成本的优惠。
以下是该演示的创始人演练,包括做出提供优惠或不对订户采取行动的决策。
该演示说明展示了合成工作流及其决策证据。我希望构建者能从中领悟到的采购与评估标准是:追问提供某项优惠的原因、暂扣另一项优惠的原因,以及能够改变任一决定的证据。一个只能解释其成功优惠的系统,把更艰难的判断留给了下游的每一个人。