AI 定价合规与算法公平性

算法从未接触过种族或收入。它看到的是 ZIP code 与设备。相同产品,匹配的需求信号。价格却高出 26%。

当 Civil Investigative Demand (CID) 送达时,回应应当是一份文件。Equity 是一个定价可抗辩性审计层,运行在零售商既有的任何定价引擎之上。它回放引擎自身的决策日志,对每个定价输入进行受保护群体信息泄漏评分,包括单特征检查无法察觉的复合代理变量。它在确定性代码中依据 EEOC four-fifths rule (29 CFR 1607.4(D)) 对结果进行把关,量化公平性约束在收入上的成本,展示显而易见的修复方案为何会被博弈绕过,并将记录封存为经过 SHA-256 哈希、映射到法规条文的证据包,专为应对此类调查而构建。

+26.2%

相同 SKU 下,少数族裔占多数 ZIP、旧设备群体的价格更高

基于 3,037 与 2,880 次设定种子合成决策的群体均值,匹配需求信号

0.43 to 0.82

EEOC four-fifths rule 比率,在公平感知奖励塑形后从 Fail 变为 Pass

在此合成引擎与场景下测得的收入成本仅为 1.3%

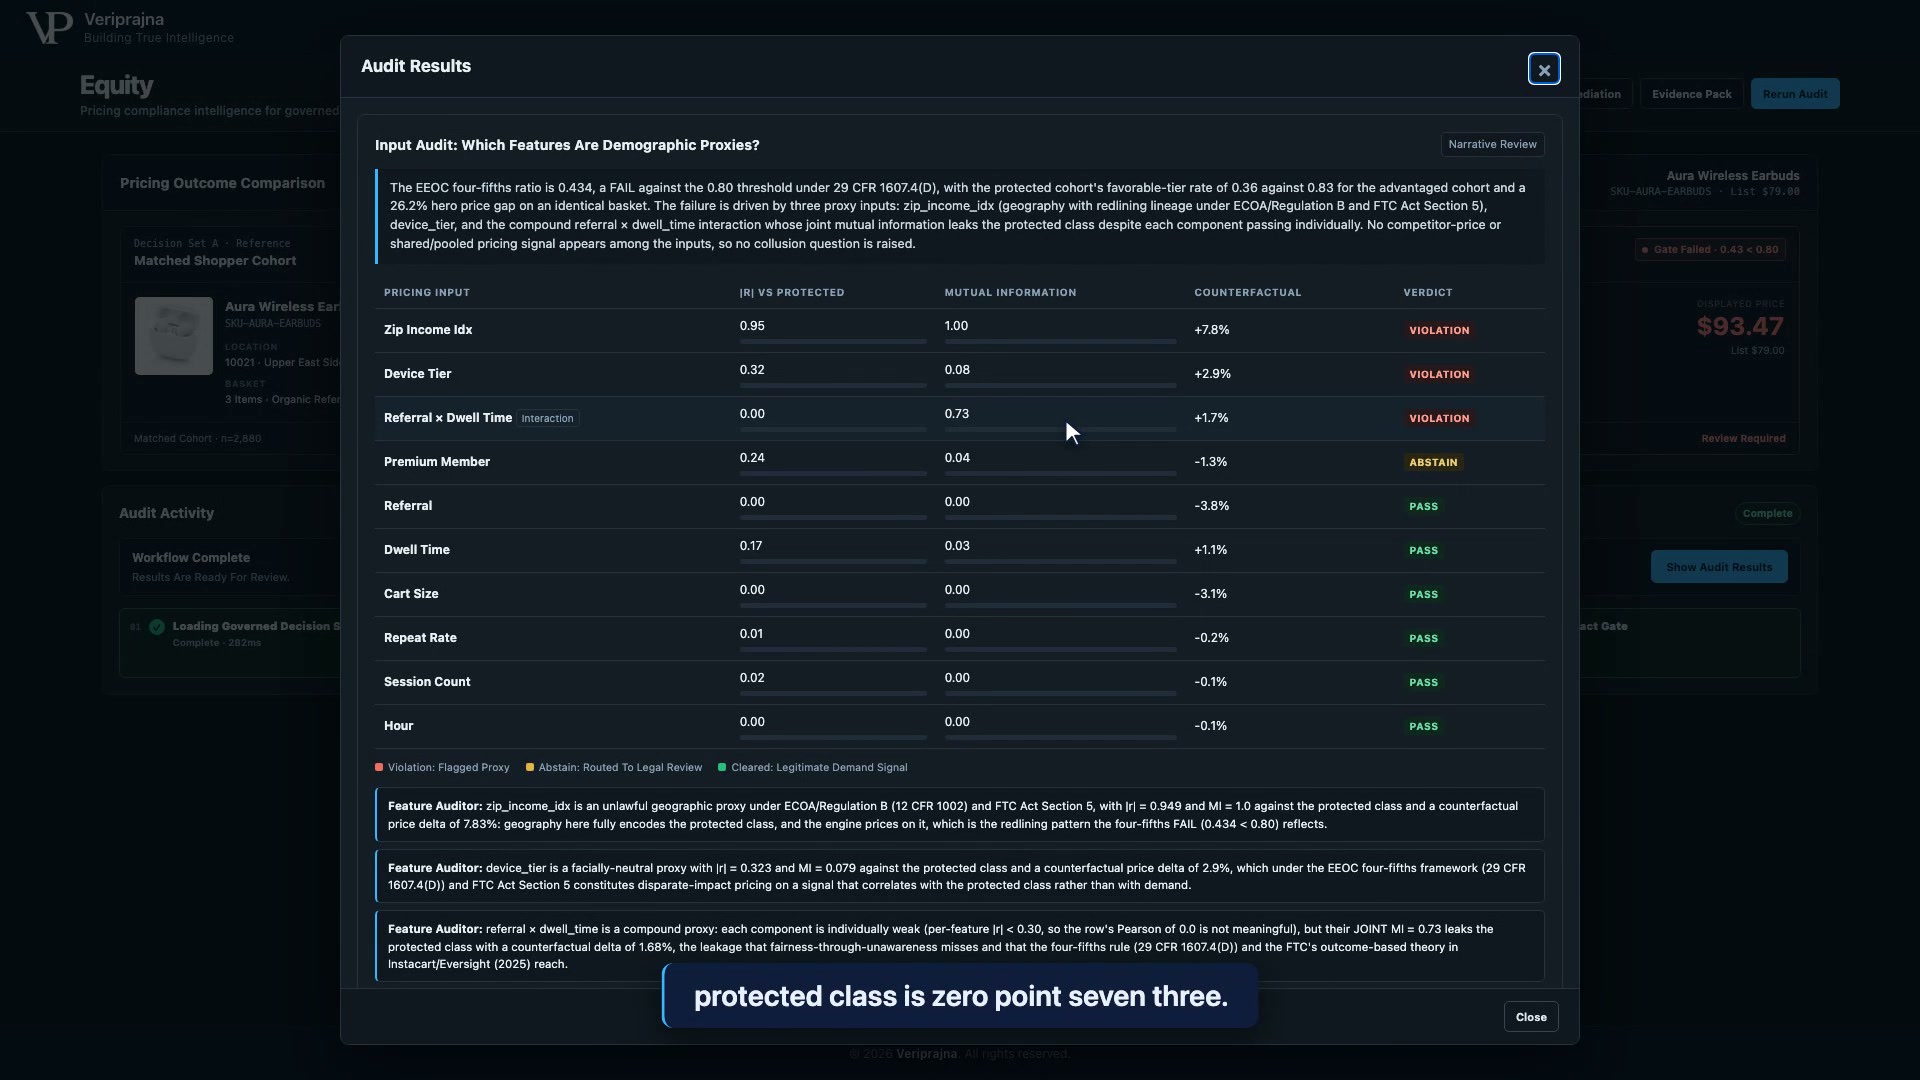
0.73

单项均通过检验的两个特征,其复合代理变量的联合互信息

Referral × Dwell Time;仅剔除 ZIP 与设备在 0.59 时仍未通过把关

本页面上的所有演示数据均为设定种子的合成数据。ShopMart Dynamic Pricing 是我们构建的一个 LinUCB 上下文赌博机,作为客户所运行引擎的替身;Aura Wireless Earbuds 和 10,000 名购物者均为生成数据,代理变量结构系专门植入,以使审计具备真实的捕捉对象。本演示未对任何真实零售商进行审计,也没有任何真实购物者被多收费。

监管机构不再需要证明主观意图。现在的执法焦点完全取决于引擎做了什么,而从未记录正确数据的定价团队则无法自证。

在拥有 New York 与 California 业务规模的电商平台上,总法律顾问或定价负责人所运行的动态定价引擎即便从不输入种族或收入信息,却依然面临合规风险——因为引擎会根据 ZIP code、设备档次和会话行为来定价,而这些输入项无一不携带人口统计学信号。以优化收入为目标的上下文赌博机会挖掘出能预测支付意愿的每一个输入项,包括那些实际上在预测购物者身份的变量。ZIP 预测收入;收入预测价格敏感度;旧款 Android 手机预测货比三家的行为更少。这些都不是种族,但它们都与种族呈共变趋势。当 Civil Investigative Demand (CID) 送达之时,没有任何相关记录的团队将不得不花费数月时间进行被动的取证挖掘。

FTC 案件的核心取决于算法做了什么

FTC 就 Instacart 的 Eversight 定价实验达成的 $60M 和解协议(FTC,2025 年 12 月)是一项基于结果的执法行动。诉状记录了不同购物者在购买相同商品时看到的定价不同,差距高达 23%。这并非针对特定群体的歧视认定,且与算法接收过何种指令无关。

披露与影响评估职责已载入法律条文

New York 的 Algorithmic Pricing Disclosure Act 于 2025 年 11 月 10 日生效,要求在个人数据影响价格时进行显著披露,违规行为可面临每次高达 $1,000 的民事罚款。Colorado SB 24-205 于 2026 年 6 月 30 日生效,将定价视为重大决定,要求进行影响评估。

EU AI Act 合规义务自 2026 年 8 月 2 日起适用,并附有法定罚款上限

EU AI Act (Articles 13 and 14) 的高风险义务自 2026 年 8 月 2 日起适用。第 13 条和第 14 条涵盖高风险透明度与反歧视文档记录要求,高风险违规行为将面临最高可达 €15M 或全球年营业额 3% 的法定顶格处罚。

每项统计数据、每个裁决以及哈希值均由确定性代码生成。智能体仅负责撰写叙述文本,无法触碰其中的任何内容。

该流程对引擎自身的决策日志进行单遍扫描:涵盖来自被审计引擎的 10,000 次定价决策、确定性输入审计、four-fifths 关卡、与易受博弈的上限进行对比的公平性约束合成、智能体叙述、SHA-256 哈希证据包以及带标注的基准测试。智能体提出建议,代码做出裁决——正是这种分离,确保了无论底层运行何种模型,证据包都具备随时可呈堂归档的效力。

01 / THE ENGINE UNDER AUDIT

从不接触受保护属性的收入最优多臂赌博机

接受审计的引擎为 ShopMart Dynamic Pricing,这是一个种子设定为 42 的 7 臂 LinUCB 上下文赌博机,为 10,000 名合成标注购物者群体对单个 SKU——标价为 $79.00 的 Aura Wireless Earbuds 进行定价。它依据 ZIP income index、device tier、referral、dwell time、cart size、repeat rate、session count、premium membership 以及 hour 进行定价,外加许多真实引擎所具备的 referral 与 dwell 交叉项。受保护群体是审计流程从未接收到的潜在标签。在本演示中,该赌博机即为被审计引擎。

02 / THE DETERMINISTIC INPUT AUDIT

每个输入项对应三项评分,第四项评分可洞察特征对

Run Audit 使用纯 numpy 计算每个定价输入相对于受保护群体的绝对 Pearson 相关系数、归一化互信息、特征对的联合互信息以及反事实价格变动:将受保护群体的某项输入覆写为优势群体的参考值,保持其他所有变量不变,重新运行引擎自身的策略,并测量受保护群体的价格变动幅度。裁决规则完全由代码按顺序检查:有效样本量低于 400 的输入项将被判定为 Insufficient Evidence 而非代理裁决,本次运行中没有输入项触发此规则;具有任何实质关联的双重用途忠诚度信号在违规测试运行前判定为 ABSTAIN 并转交法律审查;绝对相关系数至少为 0.30 或互信息至少为 0.05 则判定为 VIOLATION;相关系数在 0.20 至 0.30 之间判定为 ABSTAIN;其余所有情况均判定为 PASS。对于所有其他输入项,反事实分析仅起印证作用,绝不单独触发裁决;仅对于双重用途信号,实质性的反事实变动才计入 ABSTAIN 判定。

03 / THE GATE AND THE CONSTRAINT

先对照外部法律标准,再行无缝可钻的修复

Disparate-Impact Gate 应用了适配价格层级的 EEOC four-fifths rule (29 CFR 1607.4(D)):以受保护群体获得优惠价格层级的比率除以优势群体的比率,与 0.80 的阈值进行对比。随后,补救环节合成了 Fairness-Aware Reward Shaping,将每个价格持续拉向由剔除 4 个代理输入训练出的第二个赌博机生成的无代理参考价格,并通过二分搜索找出跨越 0.80 门槛的最小拉动权重。它与作为朴素修复方案的 Hard-Cap Baseline(公平价格的 115%)并列展示,同时测量了两者的博弈特征。

04 / THE CREW AND THE PACK

上层智能体叙述,底层封存记录

Feature Auditor 负责解释每个被标记的输入项,Adversarial Challenger 则陈述将弃权输入项视为合法信号的理由;Regulatory Mapper 角色是一个固定表格,将每个 VIOLATION 关联至五种监管制度,并将 ABSTAIN 关联至单条法律审查项。该智能体团队支持模型提供商热插拔,在未配置模型提供商时可回退至确定性模板从而保证应用运行一致,且无法计算任何数字或设定裁决。Evidence Pack 将引擎名称与版本、审计群体、关卡、各项发现及其依据、法规映射、补救结果以及叙述摘要封存为 JSON 及可打印的 HTML 报告包,并将报告包正文的 SHA-256 摘要作为防篡改哈希。

控制台由两个视图以及多个对话框组成。手动视图包含 Pricing Outcome Comparison 卡片和串流各阶段动态的活动面板;每项结果均以标题为 Audit Results、Remediation Results 或 Evidence Pack Results 的对话框打开,且 Remediation 和 Evidence Pack 在 Run Audit 完成之前保持禁用状态。Run Benchmark 可切换至独立的 Benchmark Results 视图。About Demo 在屏幕上注明了场景边界:这是一个具备已知真实基准的合成引擎,其结果用于展示方法论,并非现场验证的主观意图证据。下文中的每个数字均在此边界范围之内。

相同产品、匹配的需求信号、26% 的差距。这就是审计系统发现差距、关卡把关、进行修复并予以封存的过程。

本演示对单个 SKU 上的 10,000 次设定种子合成定价决策进行了审计。以下内容即为该次运行在屏幕上呈现的界面内容,按其出现的先后顺序排列。
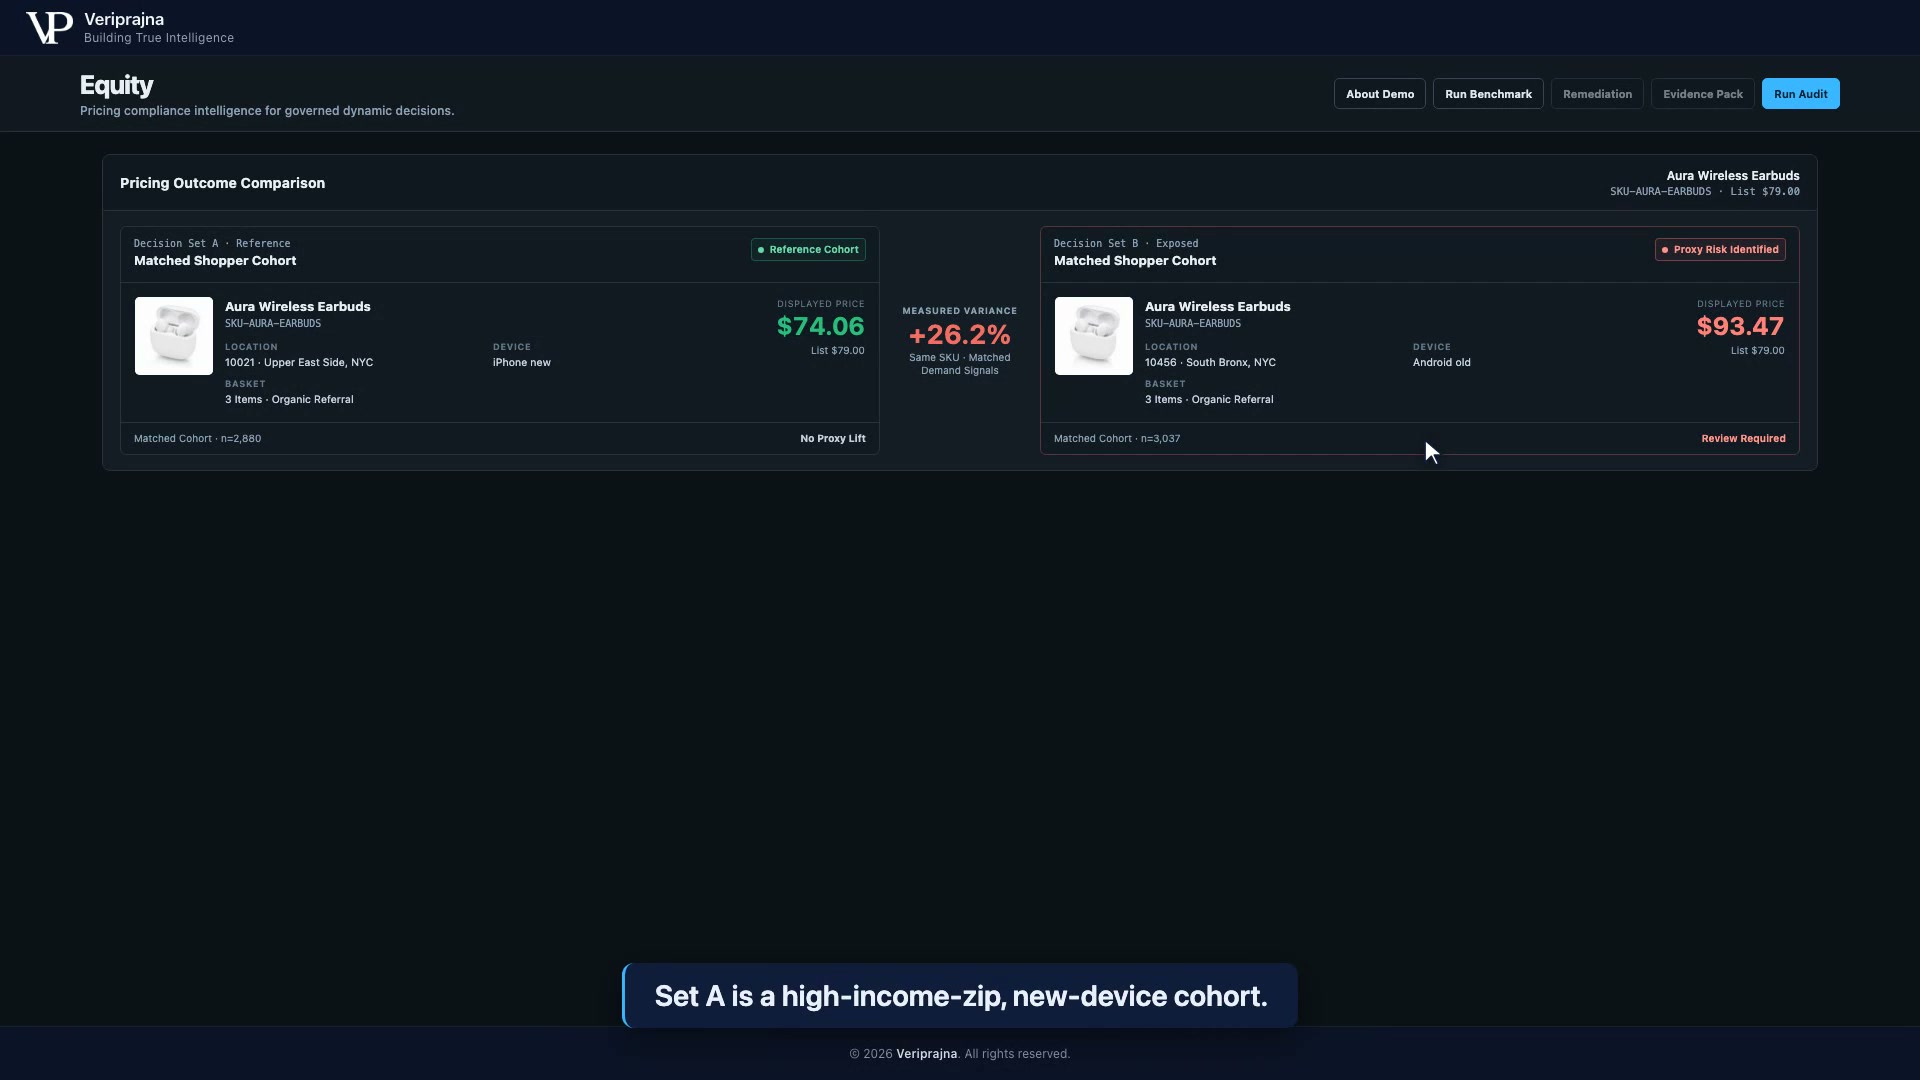
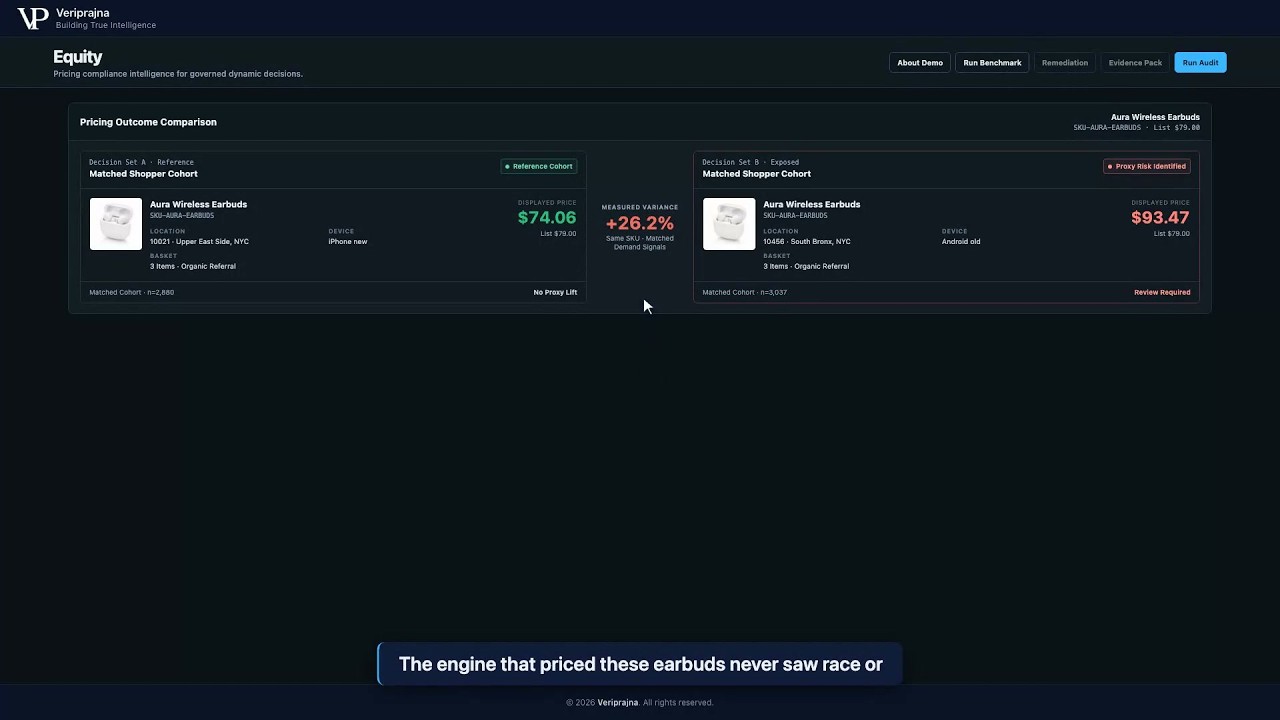
在进行任何审计之前打开 Pricing Outcome Comparison 卡片的 Equity 控制台。Decision Set A, Reference 显示 Aura Wireless Earbuds 的展示价格为 $74.06(标价为 $79.00),代表性画像为 ZIP 10021 Upper East Side NYC、iPhone new、包含 3 件商品的购物车伴有自然推荐,带有绿色的 Reference Cohort 徽章,底部信息为 Matched Cohort · n=2,880 和 No Proxy Lift。Decision Set B, Exposed 显示同一款耳机价格为 $93.47,画像为 ZIP 10456 South Bronx NYC、Android old、带有红色的 Proxy Risk Identified 徽章,底部信息为 Matched Cohort · n=3,037 和 Review Required。二者之间标有 Same SKU, Matched Demand Signals 的 Measured Variance 为 +26.2%。顶部按钮显示为 About Demo、Run Benchmark、Remediation、Evidence Pack 和 Run Audit,底部的副标题栏显示 Set A is a high-income-zip, new-device cohort。
在运行任何操作之前,此卡片已显示在屏幕上:两个匹配的群体,同一个 SKU。高收入 ZIP、新设备群体看到的价格为 $74.06;少数族裔占多数 ZIP、旧设备群体看到的价格为 $93.47——在需求信号匹配的情况下,同一款耳机的价格差距达到 26.2%。这些是基于 2,880 和 3,037 次合成决策的群体均值,而非刻意挑选的两个购物者;每张卡片上的 ZIP 和设备只是该群体的代表性画像,群体本身跨越了多个 ZIP 区域和两大设备家族。产生这种差距的引擎从未接收过任何会被律师认定为受法律保护的信息。
Audit Results 对话框显示 Input Audit: Which Features Are Demographic Proxies? 表格,包含 Pricing Input、|r| vs Protected、Mutual Information、Counterfactual 和 Verdict 等列。Zip Income Idx 显示为 0.95、1.00、+7.8%、VIOLATION。Device Tier 显示为 0.32、0.08、+2.9%、VIOLATION。标记为 Interaction 的 Referral × Dwell Time 显示为 0.00、0.73、+1.7%、VIOLATION,光标正停留于其上。Premium Member 显示为 0.24、0.04、-1.3%、ABSTAIN。Referral、Dwell Time、Cart Size、Repeat Rate、Session Count 和 Hour 均显示为 PASS。下方的图例显示为 Violation: Flagged Proxy、Abstain: Routed To Legal Review、Cleared: Legitimate Demand Signal,紧随其后的是三条 Feature Auditor 附注。
Zip Income Idx 和 Device Tier 是显而易见的代理变量,其 Pearson 相关系数分别为 0.95 和 0.32。针对单一特征的审计无法得出第三个 VIOLATION 行。单独考察 Referral,其相关系数为 0.00,互信息为 0.00;单独考察 Dwell Time,其相关系数为 0.17,互信息为 0.03,两者均判定为 PASS。然而,它们与受保护群体的联合互信息高达 0.73,相比最佳单一特征产生了 0.71 的交互增益。构建该群体时设定为:停留时间长的自然访问用户和停留时间短的比价访问用户均代表受保护群体——单一输入项无法区分群体,唯有组合起来才能区分。逐一审计输入项的合规方案审计了错误的对象。Cart size、repeat rate、session count 和 hour 均被判定为合法的需求信号并予 Cleared;审计系统并不会对其看到的每一项特征都进行警报标记。
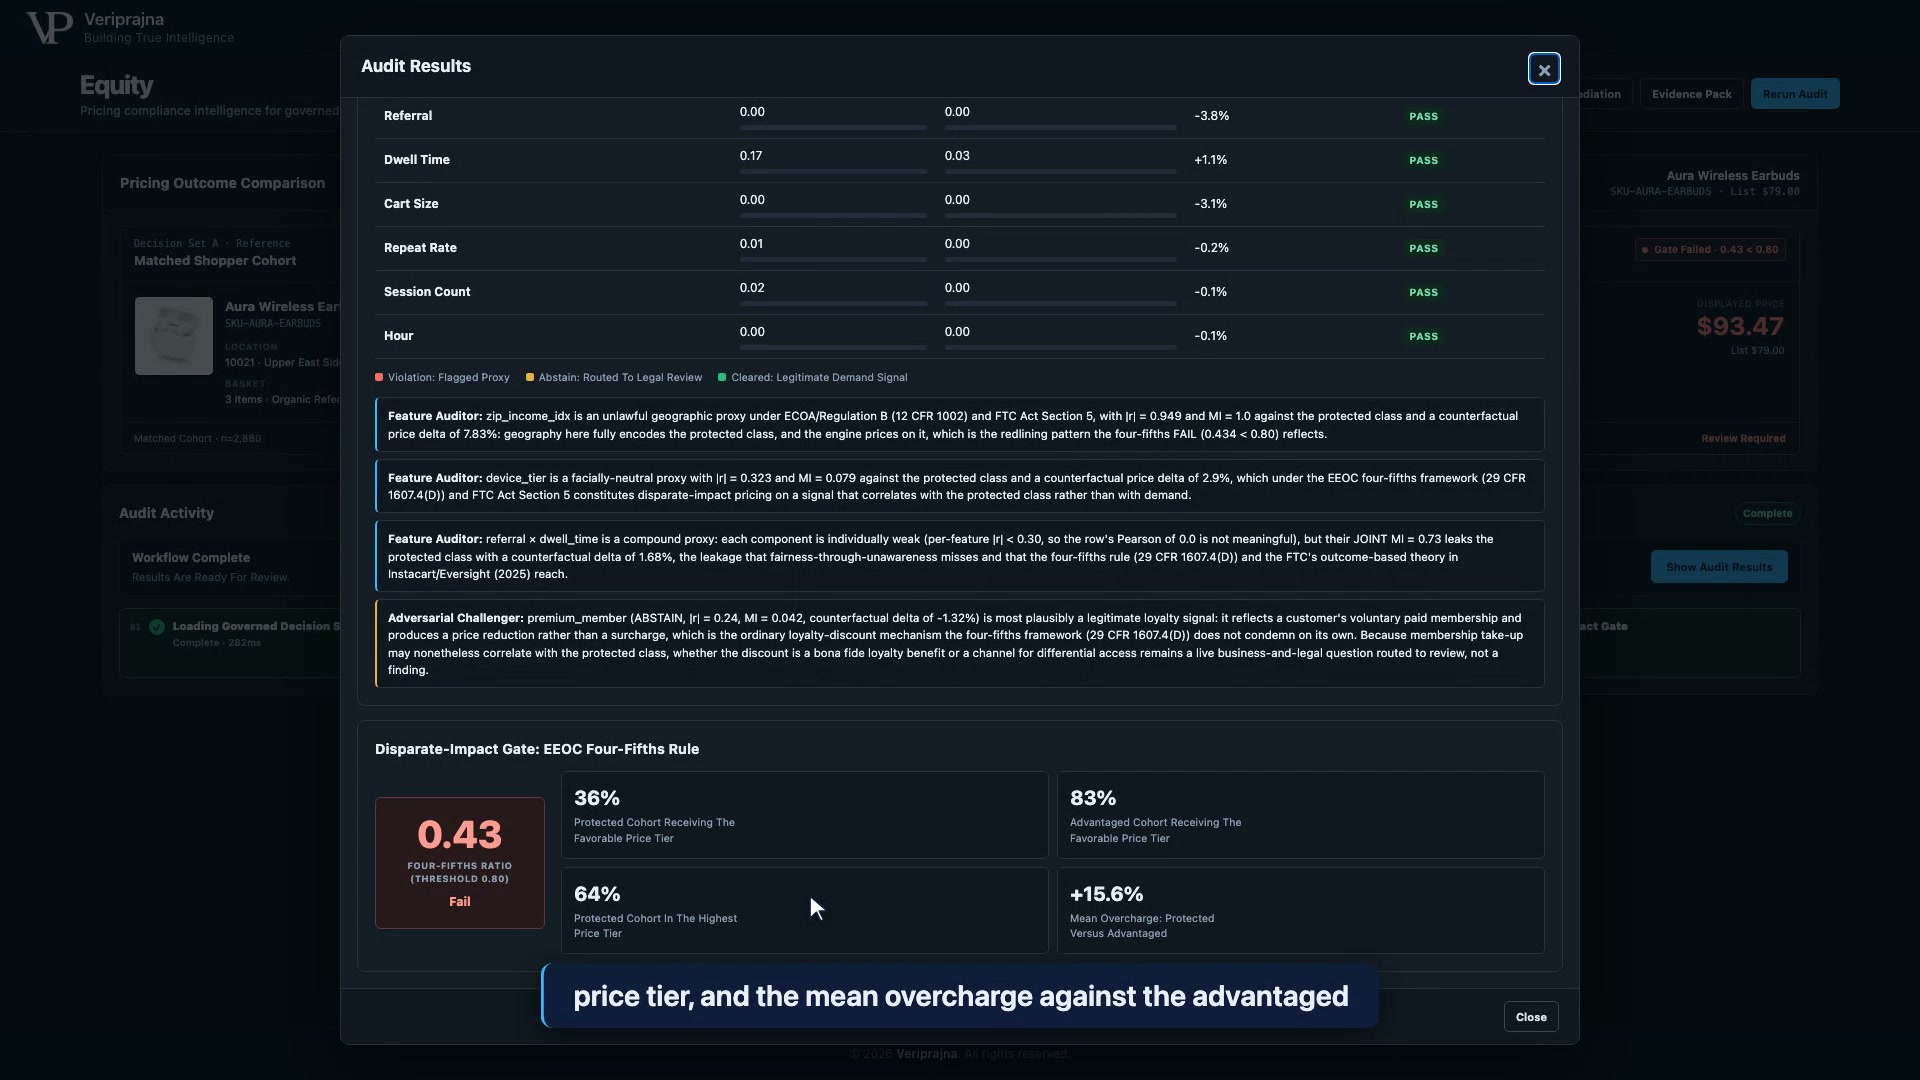
Audit Results 对话框滚动到底部。上方显示 Referral、Dwell Time、Cart Size、Repeat Rate、Session Count 和 Hour 的 PASS 行、裁决图例、三条 Feature Auditor 附注以及一条关于 premium_member 的 Adversarial Challenger 附注。其下方为 Disparate-Impact Gate: EEOC Four-Fifths Rule 卡片,显示一个读数为 0.43 的红色仪表盘,标注 Four-Fifths Ratio (Threshold 0.80)、Fail,以及四个信息块:36% Protected Cohort Receiving The Favorable Price Tier、83% Advantaged Cohort Receiving The Favorable Price Tier、64% Protected Cohort In The Highest Price Tier,以及 +15.6% Mean Overcharge: Protected Versus Advantaged。
该关卡应用了由代码计算的法律标准,此处的“优惠”指非最高价格档位。受保护群体获得该价格档位的比例为 36%,而优势群体为 83%;0.36 除以 0.83 等于 0.434,远低于 29 CFR 1607.4(D) 中规定的 0.80 的四分之五阈值。受保护群体中有 64% 处于最高价格档位,整个人群的平均超额收费为 15.6%。在仪表盘上方,Adversarial Challenger 为 Premium Member 辩护其忠诚度权益性质——而代码此前已将该输入项转交法律审查。代码既未将其标记为违规,也未将其剔除,裁决规则在该附注撰写之前便已设定了 ABSTAIN。在此对话框打开的瞬间,Show Audit Results 会重写 Pricing Outcome Comparison 卡片上的 Set B 徽章;将其关闭后,卡片当前显示为 Gate Failed, 0.43 < 0.80。
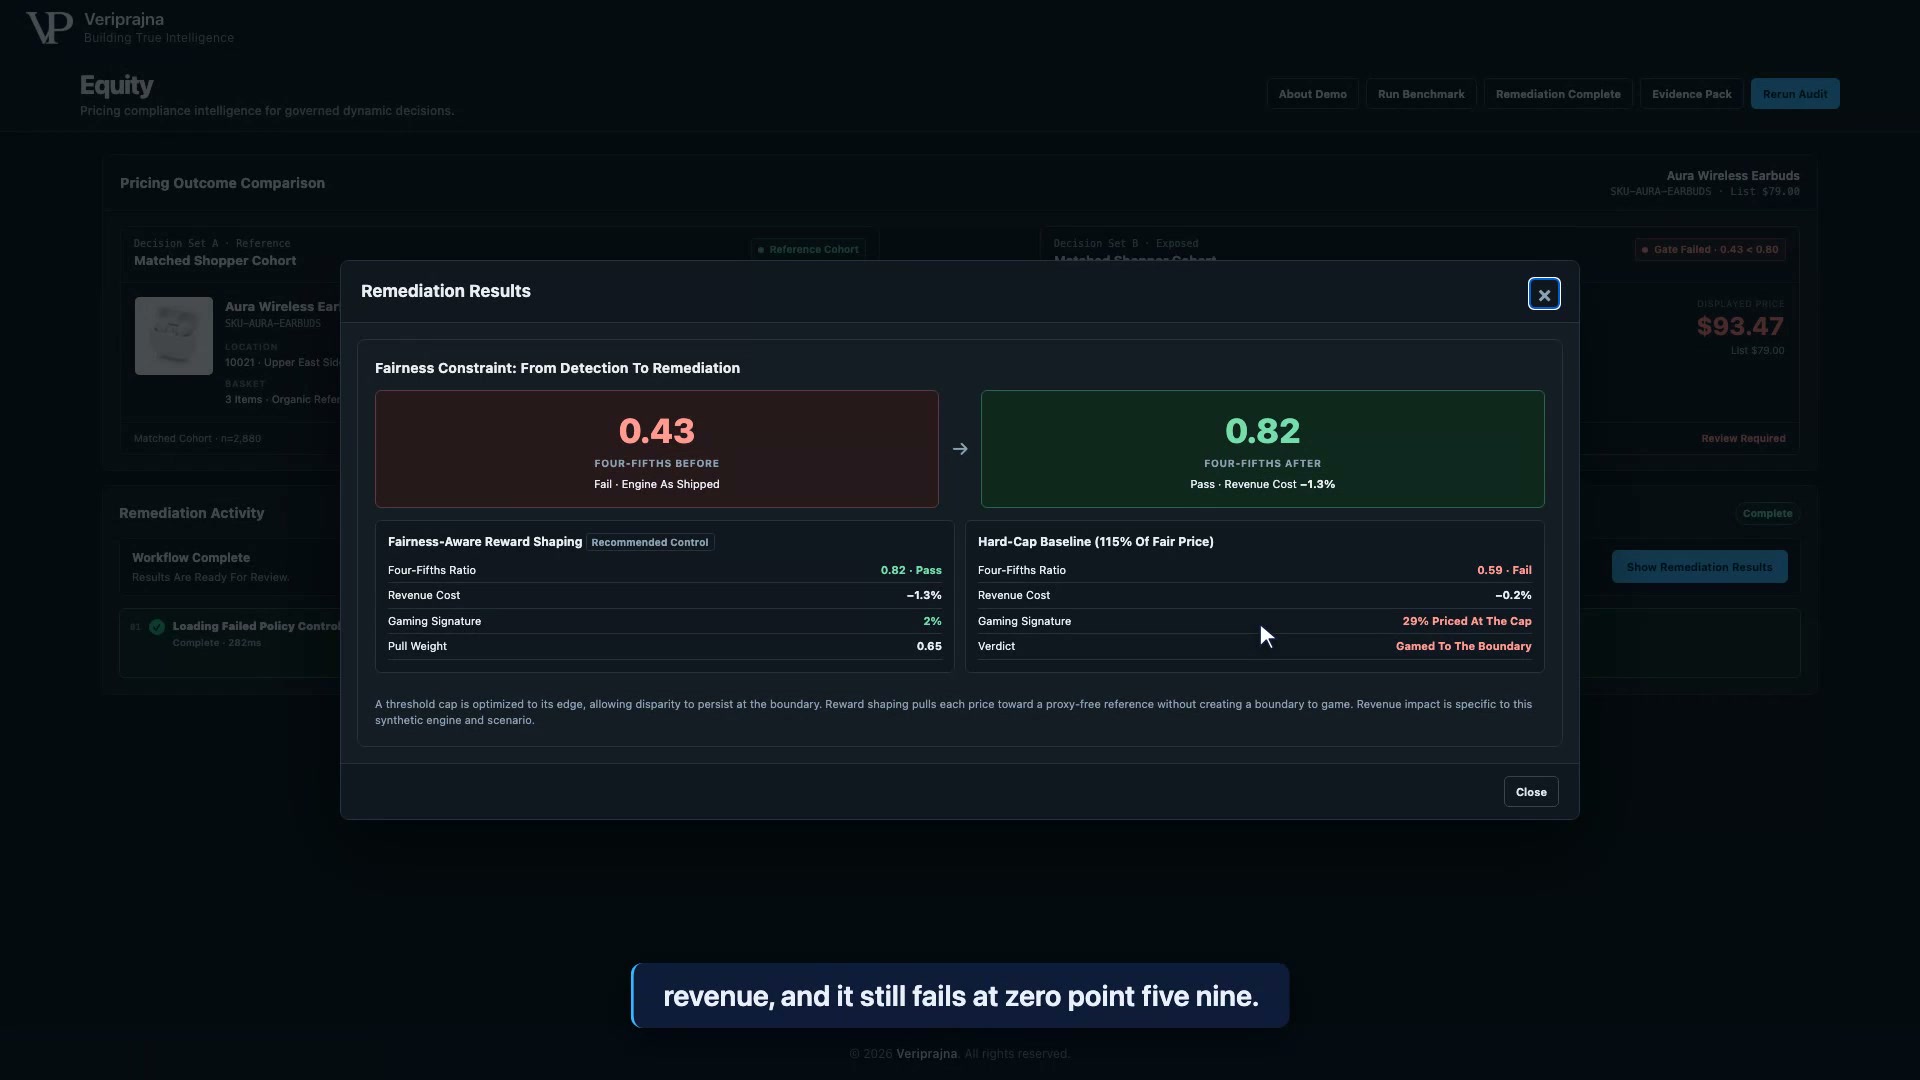
Remediation Results 对话框标题为 Fairness Constraint: From Detection To Remediation。一个红色图块显示 0.43、Four-Fifths Before、Fail、Engine As Shipped;箭头指向一个绿色图块,显示 0.82、Four-Fifths After、Pass、Revenue Cost -1.3%。在下方,标记为 Recommended Control 的 Fairness-Aware Reward Shaping 列出了 Four-Fifths Ratio 0.82 Pass、Revenue Cost -1.3%、Gaming Signature 2% 和 Pull Weight 0.65。其旁边的 Hard-Cap Baseline (115% Of Fair Price) 列出了 Four-Fifths Ratio 0.59 Fail、Revenue Cost -0.2%、Gaming Signature 29% Priced At The Cap 和 Verdict Gamed To The Boundary。说明小字指出:阈值上限会被优化至其边界边缘,而奖励塑形则将每个价格拉向无代理变量的参考价格,且不会产生可供博弈的边界,收入影响仅针对此合成引擎和场景。
公平参考价格 115% 的硬性上限会导致 0.2% 的收入损失,且比率仅为 0.59 仍未能通过关卡,因为收入最大化机制会将该上限视为目标:29% 的受保护群体被重新定价至距该上限 1% 以内的范围,对话框称之为 Gamed To The Boundary。Fairness-Aware Reward Shaping 将每个价格持续拉向无代理参考价格,不给引擎提供顶格抬价的边界边缘,并在拉动权重为 0.65、博弈特征为 2% 时以 0.82 通过关卡。在这一合成引擎上,这仅耗费 1.3% 的收入,应用自身的说明小字亦指出该数据仅特定于此引擎与场景。
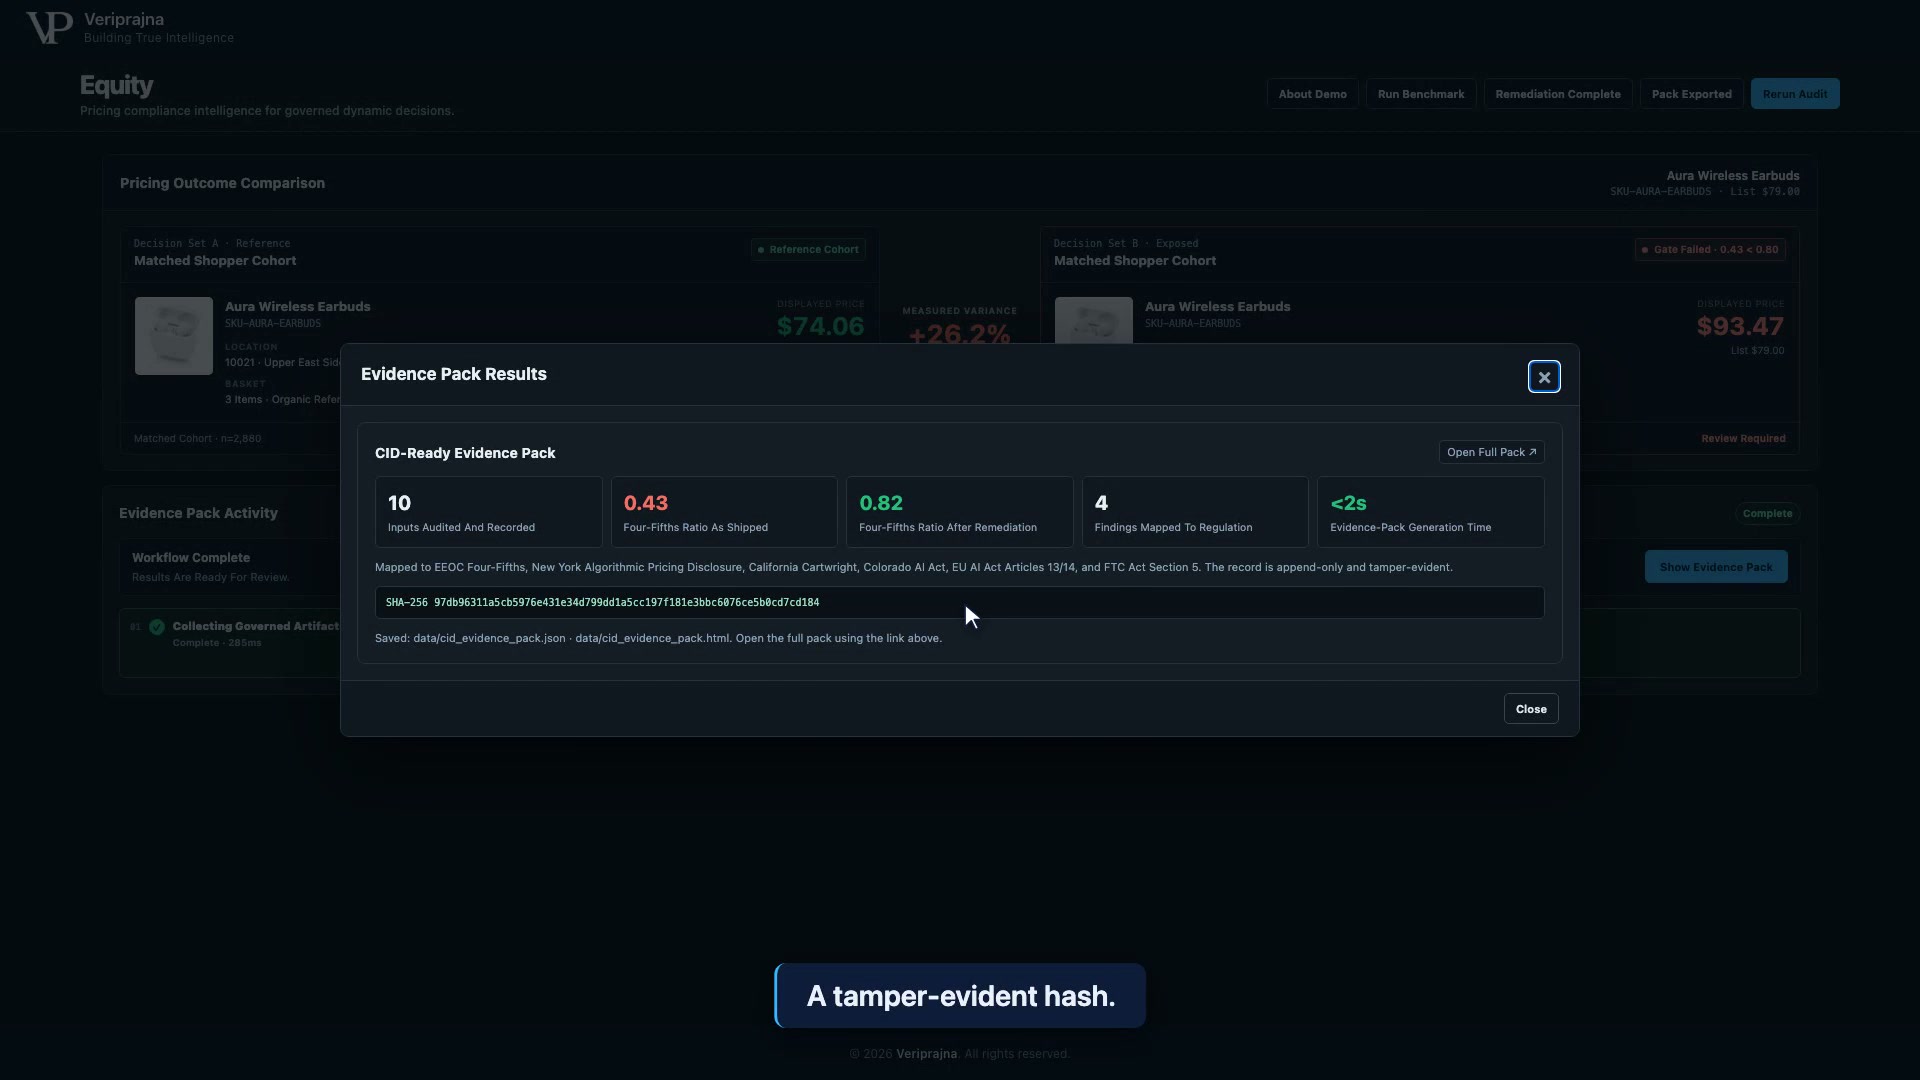
Evidence Pack Results 对话框标题为 CID-Ready Evidence Pack,并附有 Open Full Pack 链接。五个图块分别显示 10 Inputs Audited And Recorded、0.43 Four-Fifths Ratio As Shipped、0.82 Four-Fifths Ratio After Remediation、4 Findings Mapped To Regulation 以及 <2s Evidence-Pack Generation Time。其下方是关于法规映射以及记录具备仅追加与防篡改特性的说明小字、一个 SHA-256 哈希框,以及指明 data/cid_evidence_pack.json 和 data/cid_evidence_pack.html 的保存路径行。顶部按钮此时显示为 Remediation Complete、Pack Exported 和 Rerun Audit。
此对话框便是归档凭单。报告包记录了被审计的 10 个输入项、交付时与补救后的关卡结果,以及映射到法规的 4 项发现:三个 VIOLATION 分别关联至报告包法规映射中的五种制度,ABSTAIN 则关联至单条法律审查行。哈希值是报告包正文的 SHA-256 摘要:一个防篡改印记,由于报告包包含生成时间,因此每次导出都会发生改变。<2s 图块是对话框对几乎瞬间完成的构建过程的标识,而非基准测试耗时。
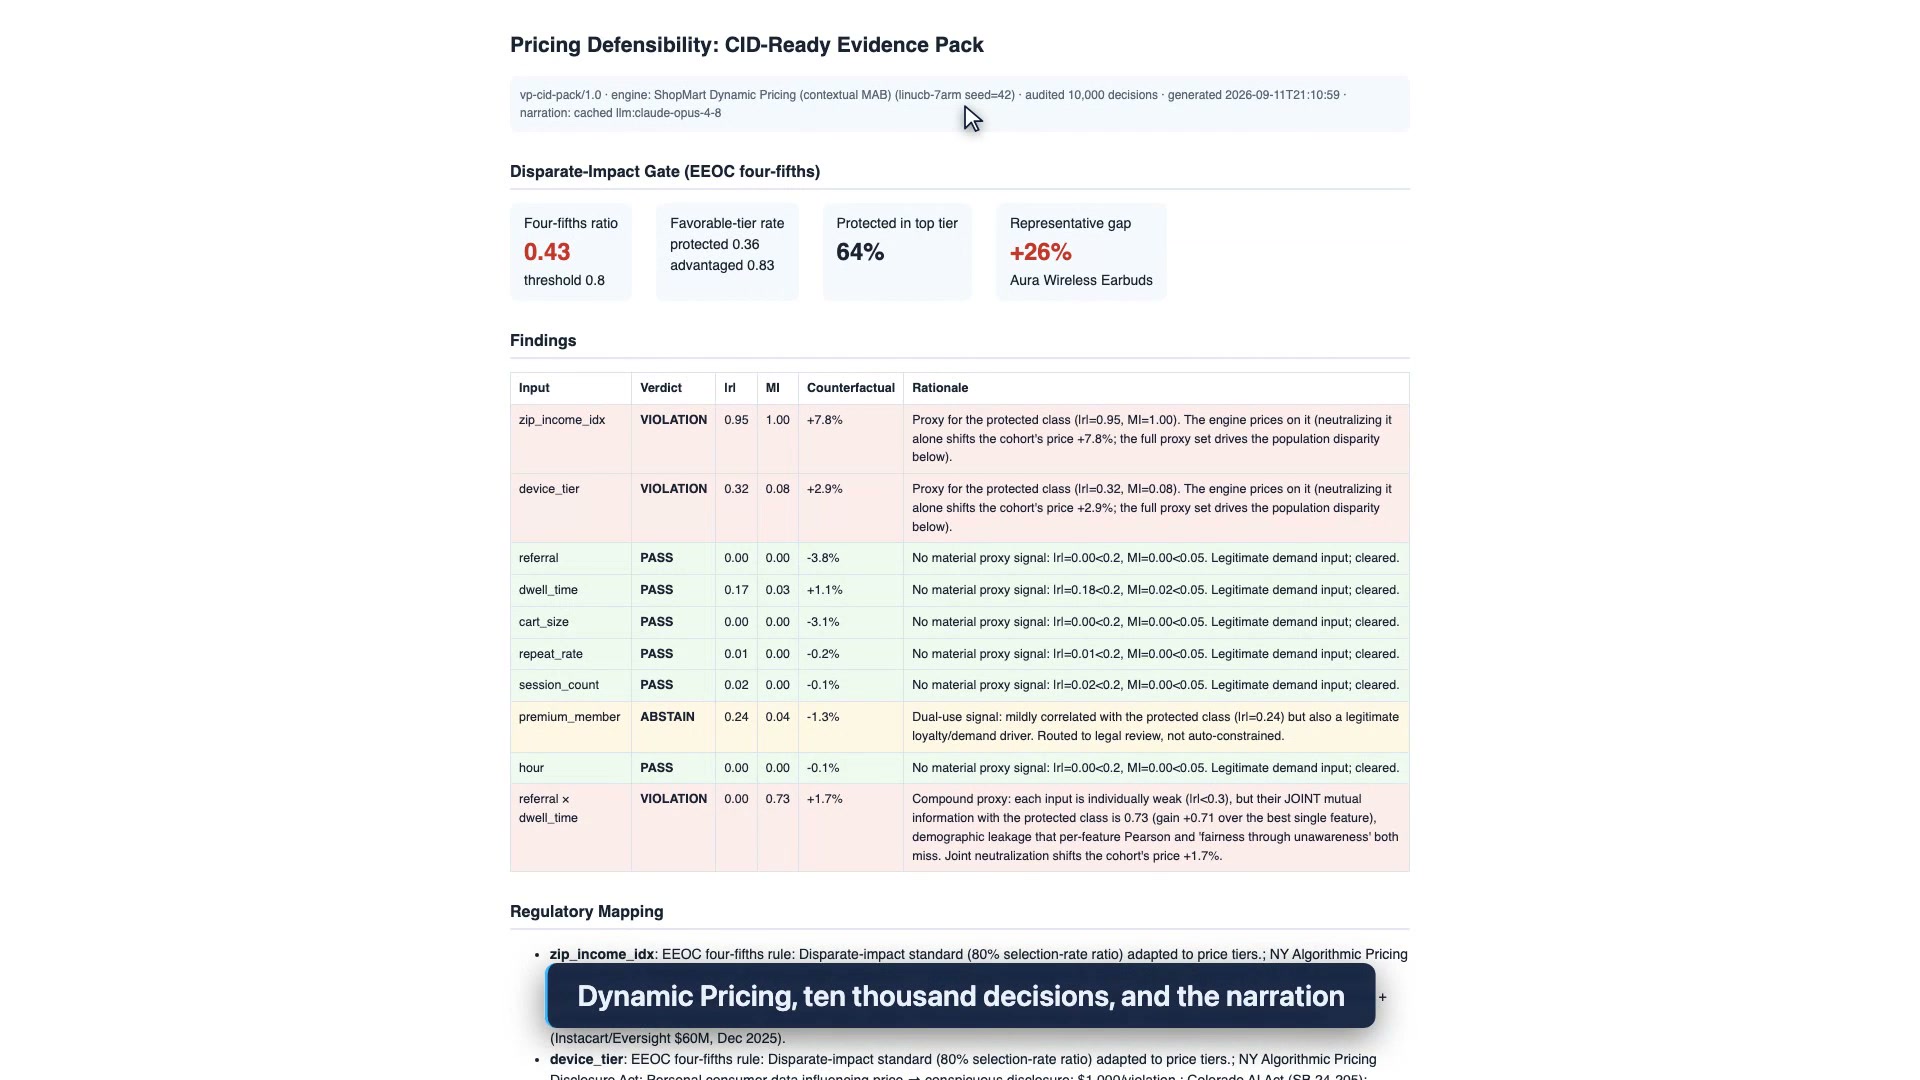
在浏览器标签页中打开的可打印证据包,标题为 Pricing Defensibility: CID-Ready Evidence Pack。页眉行注明了 vp-cid-pack/1.0 架构模式、引擎 ShopMart Dynamic Pricing (contextual MAB) linucb-7arm seed=42、10,000 次被审计决策以及缓存的 claude-opus-4-8 叙述。在 Disparate-Impact Gate (EEOC four-fifths) 下方,四个图块显示:Four-fifths ratio 0.43 threshold 0.8、Favorable-tier rate protected 0.36 advantaged 0.83、Protected in top tier 64% 以及 Representative gap +26% Aura Wireless Earbuds。Findings 表格列出了每个输入项及其裁决、|r|、MI、反事实结果与依据,VIOLATION 行以红色标出,PASS 行为绿色,premium_member 的 ABSTAIN 行为琥珀色,最后一行是 referral × dwell_time 复合代理变量行。其下方展开了 Regulatory Mapping 部分。
Open Full Pack 是法律顾问将会收到的形式:将同一个 JSON 渲染为可打印文档,逐行罗列引擎名称与构建版本、决策次数、关卡指标、每个输入项的裁决及其依据,以及法规映射。页眉声明叙述文本来自缓存的模型输出;其旁边的每个数字均来自确定性审计,且相同的种子会在每次运行时完全复现它们。针对 Civil Investigative Demand (CID) 的答复由此化为这份文件。
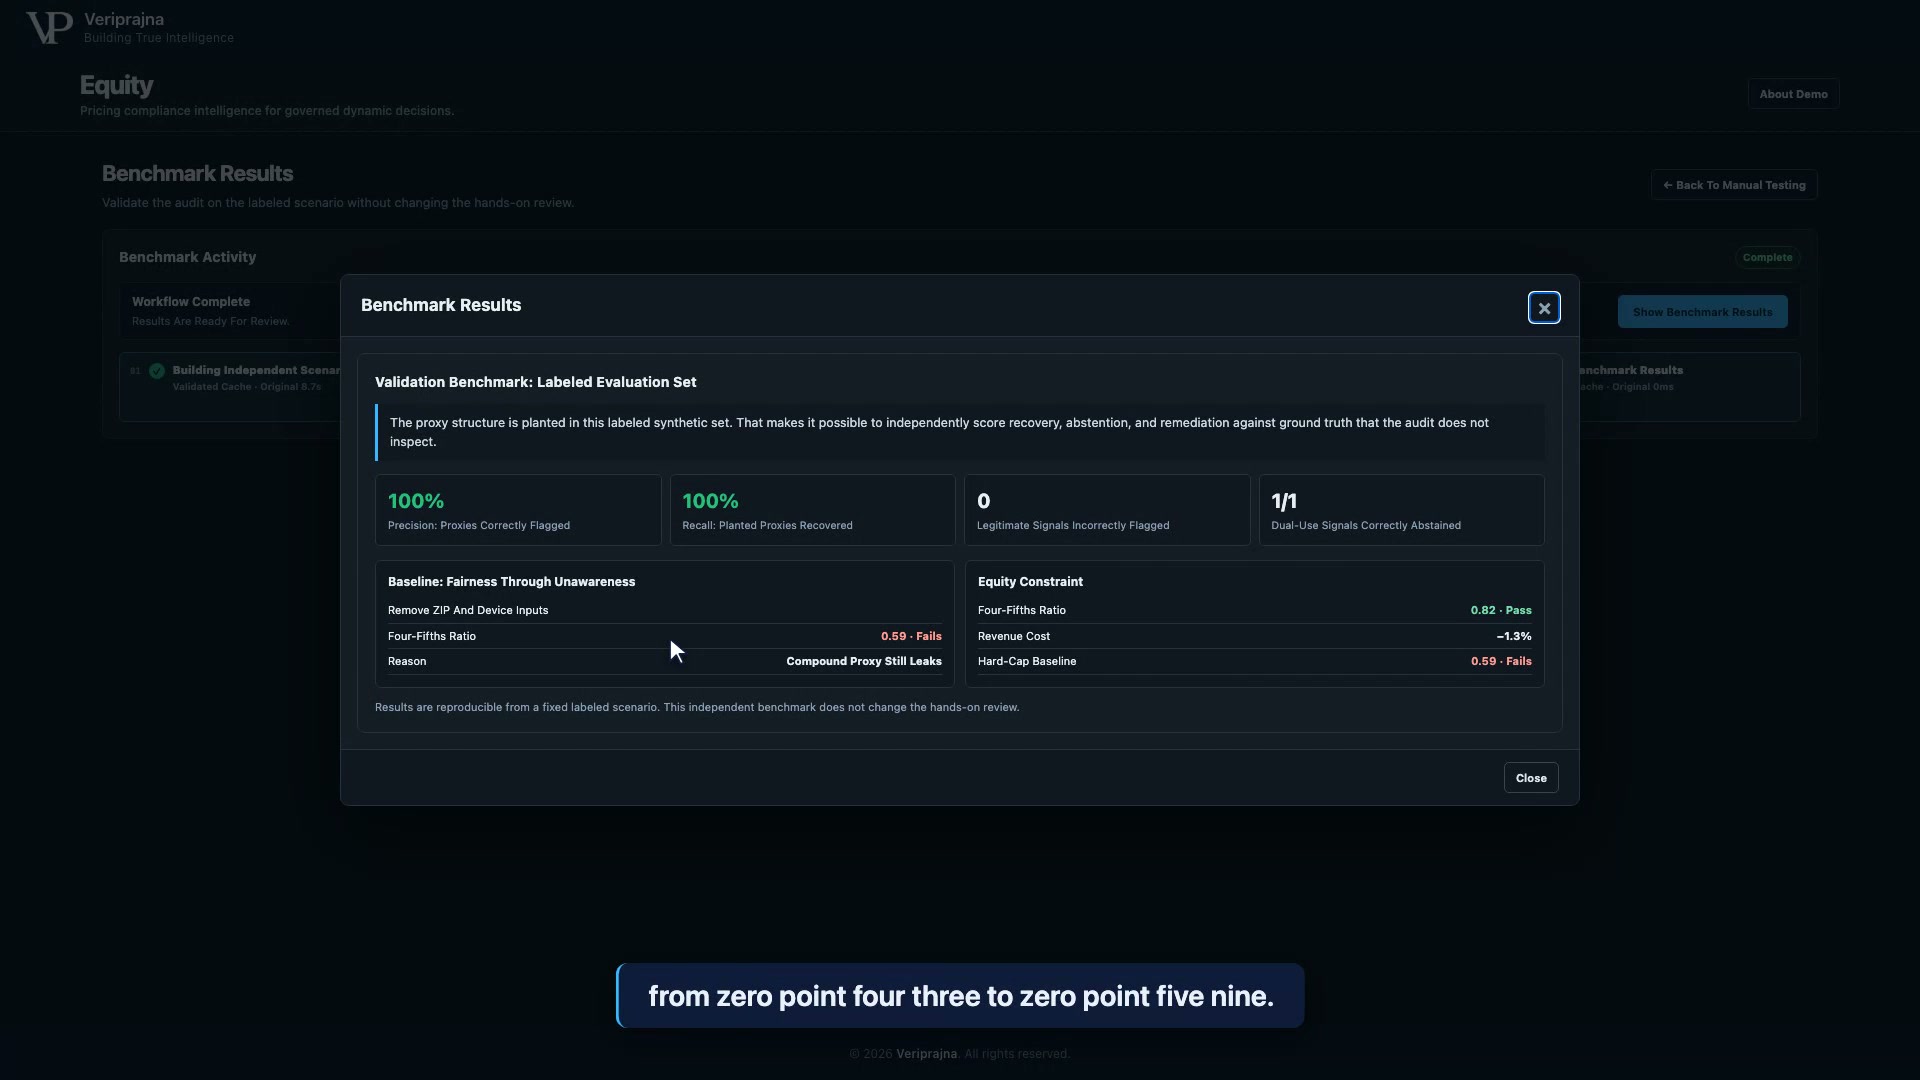
Benchmark Results 视图之上浮动打开了 Benchmark Results 对话框,标题为 Validation Benchmark: Labeled Evaluation Set。附注解释称,代理变量结构系植入此标注合成数据集中,以便依据审计未曾审视的真实基准对检出率、弃权处理和补救效果进行评分。四个图块分别显示:100% Precision: Proxies Correctly Flagged、100% Recall: Planted Proxies Recovered、0 Legitimate Signals Incorrectly Flagged 以及 1/1 Dual-Use Signals Correctly Abstained。下方,Baseline: Fairness Through Unawareness 列出了 Remove ZIP And Device Inputs、Four-Fifths Ratio 0.59 Fails、Reason Compound Proxy Still Leaks;其旁的 Equity Constraint 列出了 Four-Fifths Ratio 0.82 Pass、Revenue Cost -1.3% 以及 Hard-Cap Baseline 0.59 Fails。右上角设有 Back To Manual Testing 按钮。
Run Benchmark 是该方法论的自我校验,其适用范围已在对话框上明确注明。它从零开始重新构建相同的 seed-42 人群与引擎,并对照其从未看过的植入标签对审计进行评分:3 of 3 植入代理变量被检出,0 个合法信号被误标,1 of 1 双重用途信号被正确弃权判定。其旁的基准则是业内标准的辩护手段:移除 ZIP 和设备并重新训练。比率仅从 0.43 升至 0.59,依然判定失败,因为复合代理变量在删除操作后依然残留泄漏。

演示所展示的内容,以及演示未涵盖的范畴。

上述数字来源于针对单个 SKU 上 10,000 次定价决策、具有植入且可复现代理变量结构的单一设定种子合成人群。这些数据表明该方法能以标注集精度恢复植入的结构。它们并非真实定价数据上的准确率,亦非针对竞争对手的基准测试,更非对任何真实零售商的指控。

问题Equity 在本演示中所做的工作本演示未涵盖的范畴
集成审计演示应用自带作为替身引擎的 LinUCB 赌博机,并设计为可通过适配器接入客户自身的引擎。任何适配器代码或实时定价平台连接器。本构建版本中均不包含,所提及的任何供应商亦非客户或合作伙伴。
人口统计学数据读取包含 10 个 New York 与 California ZIP 的精选参考表,以及应用中硬编码的设定种子设备偏差。实时人口普查或设备归属数据源。该参考表体量较小且为人工精选,受保护群体为植入的标签。
发现恢复植入的代理变量结构,并在证据包中记录每个输入项的裁决及其依据。现实世界中歧视或主观意图的证明;该机制不对主观意图作出裁决。

本演示不执行的操作

Equity 不会为任何客户设定价格,也不会替代 Pricefx、PROS、Zilliant 或 Competera;定价引擎负责制定价格,Equity 负责审计与约束。它不认证合规性、不保证通过审查,也不提供法律意见;证据包是提供给客户法律顾问的证据。本构建版本涵盖单个 SKU 以及从审计到证据包的差别影响链路;算法合谋、多司法管辖区披露中间件、流式监控和结账结算界面均在范围之外。Pricing Outcome Comparison 卡片上的 South Bronx 和 Upper East Side 用户画像是针对跨多个 ZIP、多种设备的群体的代表性标签,并非对任何真实社区的论断。

法律与定价主管在为引擎部署审计层之前常问的问题。

我们的定价模型从未使用种族或收入数据。怎么可能构成歧视?

因为引擎无需直接获知种族或收入即可据此实施歧视性定价。在本演示中,接受审计的引擎依据 ZIP income index、device tier 和会话行为进行定价,而这些输入项承载了受保护群体的信息:ZIP income index 与受保护群体的相关系数高达 0.95,device tier 达到 0.32。在设定种子的合成人群上,导致相同需求信号下同一款耳机对少数族裔占多数 ZIP、旧设备群体的定价高出 26.2%,且 four-fifths 比率仅为 0.43(远低于 0.80 的阈值)。FTC 对 Instacart 的执法行动是一起基于结果的案件,涉及不同购物者购买完全相同商品时看到不同价格,而非针对算法接收过何种指令的调查结论。

我们已经从模型中剔除了 ZIP code。这难道还不够吗?

对于该引擎而言,答案是不够。基准测试中的“不知情即公平”基线在剔除 ZIP 和设备输入项后重新训练,four-fifths 比率仅从 0.43 微升至 0.59,依然未能通过。购物者的来源途径与停留时长各自单独检验时均能通过,但二者结合后却能以高达 0.73 的互信息联合编码受保护群体。针对单特征的相关性分析对此组合浑然不觉;而联合互信息检查则能敏锐捕捉,这正是审计系统对交互特征与单一输入项同时评分的原因。

我们难道不能直接对超出基准价一定百分比的价格设定上限吗?

您可以这样做,而演示展示了追求收入最大化的算法会如何应对它。Hard-Cap Baseline 禁止任何价格超过公平参考价的 115%。引擎为了严格遵守字面规定而放弃了 0.2% 的收入,却使 29% 的受保护群体定价落入距该上限 1% 以内的区间,因此 four-fifths 比率仅达到 0.59,依然通不过把关。上限就是靶子。Fairness-Aware Reward Shaping 则没有可供瞄准的边界,并以 0.82 的比率通过关卡,在此合成引擎上仅消耗 1.3% 的收入成本。

这会取代 Pricefx 或 PROS 吗?我们并不打算更换现有的定价引擎。

不会。Equity 从不自行定价。它审计引擎的决策并提出约束条件;无论是 Pricefx、PROS、Zilliant、Competera 还是自研赌博机,您的引擎依然负责执行定价。客户引擎的接缝是一个经过文档化的热插拔切换点;在本演示中没有适配器代码和实时集成,因此由我们构建的 LinUCB 赌博机充当引擎,并直接接受审计。

系统中包含 LLM。在证据开示程序中它如何经受住检验?

任何需要律师辩护的内容均非模型输出:统计数据、阈值对比、每项裁决、约束条件以及报告包哈希全部来自智能体层之外的确定性 numpy 代码。Feature Auditor 和 Adversarial Challenger 仅负责撰写叙述文字;它们从不计算任何数字,也无法设定或修改裁决,且法规映射是固定表格而非模型输出。在未配置模型提供商时,智能体团队会回退到确定性模板,应用程序仍会生成相同的裁决。录制的演练解说文本是经过验证的缓存模型输出,报告包页眉对此亦有明确声明。

当 CID 送达时,我们实际上该向律师提交什么?

一份格式为 JSON 和可打印 HTML 的 CID-ready evidence pack。它记录了引擎名称与版本、审计的 10,000 次决策、补救前后的 four-fifths 关卡指标、每个输入项的裁决及其依据、每个被标记输入项到 EEOC four-fifths rule (29 CFR 1607.4(D))、New York Algorithmic Pricing Disclosure Act、Colorado SB 24-205、EU AI Act (Articles 13 and 14) 及 FTC Act Section 5 的条文映射、补救结果以及报告包正文的 SHA-256 摘要。我们提供证据;您的法务团队作出裁决判断。

你们展示了 100% 的准确率和召回率。这是真实的准确率数字吗?

这是基于标注数据集的自我检验,应当作为自测结果来解读。基准测试重新生成演示中设下种子的 10,000 次决策合成人群,并提出一个核心问题:审计系统是否找出了我们植入的三个代理变量且未误伤其他特征?答案是肯定的。全部三个代理变量均被标记,四个合法需求信号无一被误标,且唯一的双重用途信号被判定为弃权而非直接标记违规或放行。这表明该方法能够准确检出植入的结构。真实的定价日志存在诸多混杂因素,且在伦理上无法对不同人口统计群体进行差别定价的 A/B 测试,因此在实际业务交付中,同一套机制输出的是供法务审查的证据,绝非自动化的法律裁决。

技术研究

本演示背后的研究——架构、核验设计与企业级实施蓝图。

社交媒体

同步发布于

从您定价引擎既已使用的输入项入手,查明其中哪些特征正在泄露受保护群体信息。

我们是 AI 工程团队,既非定价软件厂商,亦非合规认证机构。我们从您引擎自身的决策日志出发,最终产出您的法律顾问可以直接呈报归档的证据包;关于其所揭示内容的法律判断权始终归属于他们。

初次沟通务求务实具体:您的商品品类由何种引擎定价、它接收哪些输入项、是否包含可能针对复合代理变量定价的交叉项或决策树,以及您的业务规模涉及 New York、California、Colorado 还是欧盟。我们可以与您的定价、法务和数据团队携手,梳理审计流程、约束合成以及证据包格式。
定价代理变量风险敞口评估

  • ✓ 引擎定价所依据的输入项,以及其中哪些携带人口统计学信号
  • ✓ 单特征检查遗漏的复合代理变量
  • ✓ 基于您自身决策日志的 four-fifths 指标分析,作为呈交法务的证据
  • ✓ 您的业务规模实际涉及的法规监管制度

构建审计与举证层

  • ✓ 结合反事实回放的确定性输入审计
  • ✓ 纯代码实现的差别影响关卡
  • ✓ 附带实测收入成本的公平性约束
  • ✓ SHA-256 哈希、法规条文映射的证据包