ClaimLens · AI 声称实证

循着 AI 声称, 追溯其背后的证据。

Synthetic Nimbus Capital AI 宣传其内容检测准确率达 98%。然而其提供的测试记录仅为 53%。ClaimLens 将原句、证据与判定规则绑定留存,以便审查人员检视两者之间的差距。

6 min 56 sec · 合成记录 · 缓存建议回复

宣称 98%

内容检测准确率

Synthetic Nimbus 网站声明

记录 53%

所提供的混合文本测试结果

Synthetic Nimbus 测试装置

45 个百分点差距

超出所配置的容差

演示规则:超过 5 个百分点

面向法务、合规、市场营销和工程团队的所提供记录审查。演示判定结果不构成法律合规证明,亦不对证据进行独立验证。

言之凿凿的表述仍需匹配的记录作证

准确率声称让团队对某项任务及其衡量结果做出承诺。关于完全自主的表述同样对人类参与程度做出了承诺。审查工作需要充分留存这些承诺,以便将其与措辞背后的记录进行比对。

在 Nimbus 示例中,核心发现是宣传的准确率与所提供的测试之间的对应关系。审查人员能够看清哪句话需要引起注意以及原因何在。同一份记录也让接下来的问题变得具体明确:究竟是措辞有误、证据不全,还是底层测试本身需要展开调查?

审查流程如何达成判定

我们演示了一个涵盖 3 项合成披露声明和 14 份所提供证据记录的有界工作流。它提取十项声称,将其主体与记录关联,并保留每项所配置判定结果的依据理由。

01 / EXTRACT

保留原句

确定性分句以及 AI 关键词或主体匹配技术从捆绑的披露材料中筛选声称。源文本措辞始终保持直观可见。

02 / LINK

寻找所提供的支持证据

检索机制将结构化主体字段与测试及运行记录进行匹配。它不执行语义搜索,亦不对这些记录进行真伪鉴别。

03 / DECIDE

指明规则

采用纯 Python 代码执行所配置的检查项。在所示指标示例中,超过 5 个百分点的数值差距将产生 CONTRADICTED 判定。

Substantiation Judge 提供建议但不会改动门禁决策。Adversarial Examiner 针对门禁判为实证的声称运行,当其返回 REFUTED 时可将其降级为 PARTIALLY_SUBSTANTIATED;但它无法升级声称。录制内容在执行确定性检查的同时回放缓存的建议回复。所有 4 份缓存的审查员回复均维持其支持的结果。

运行完成后可导出 JSON Substantiation Package。它保留声称、来源、判定结果、规则、理论依据和证据标识符以备后续跟进,并附带摘要和版本信息。它引用底层记录,并不嵌入完整的证据归档库。

检视标签背后的成因

这些视图源自本地 ClaimLens 演示。此处展示的所有 Nimbus 公司、披露材料、测试与运行记录皆为合成数据。
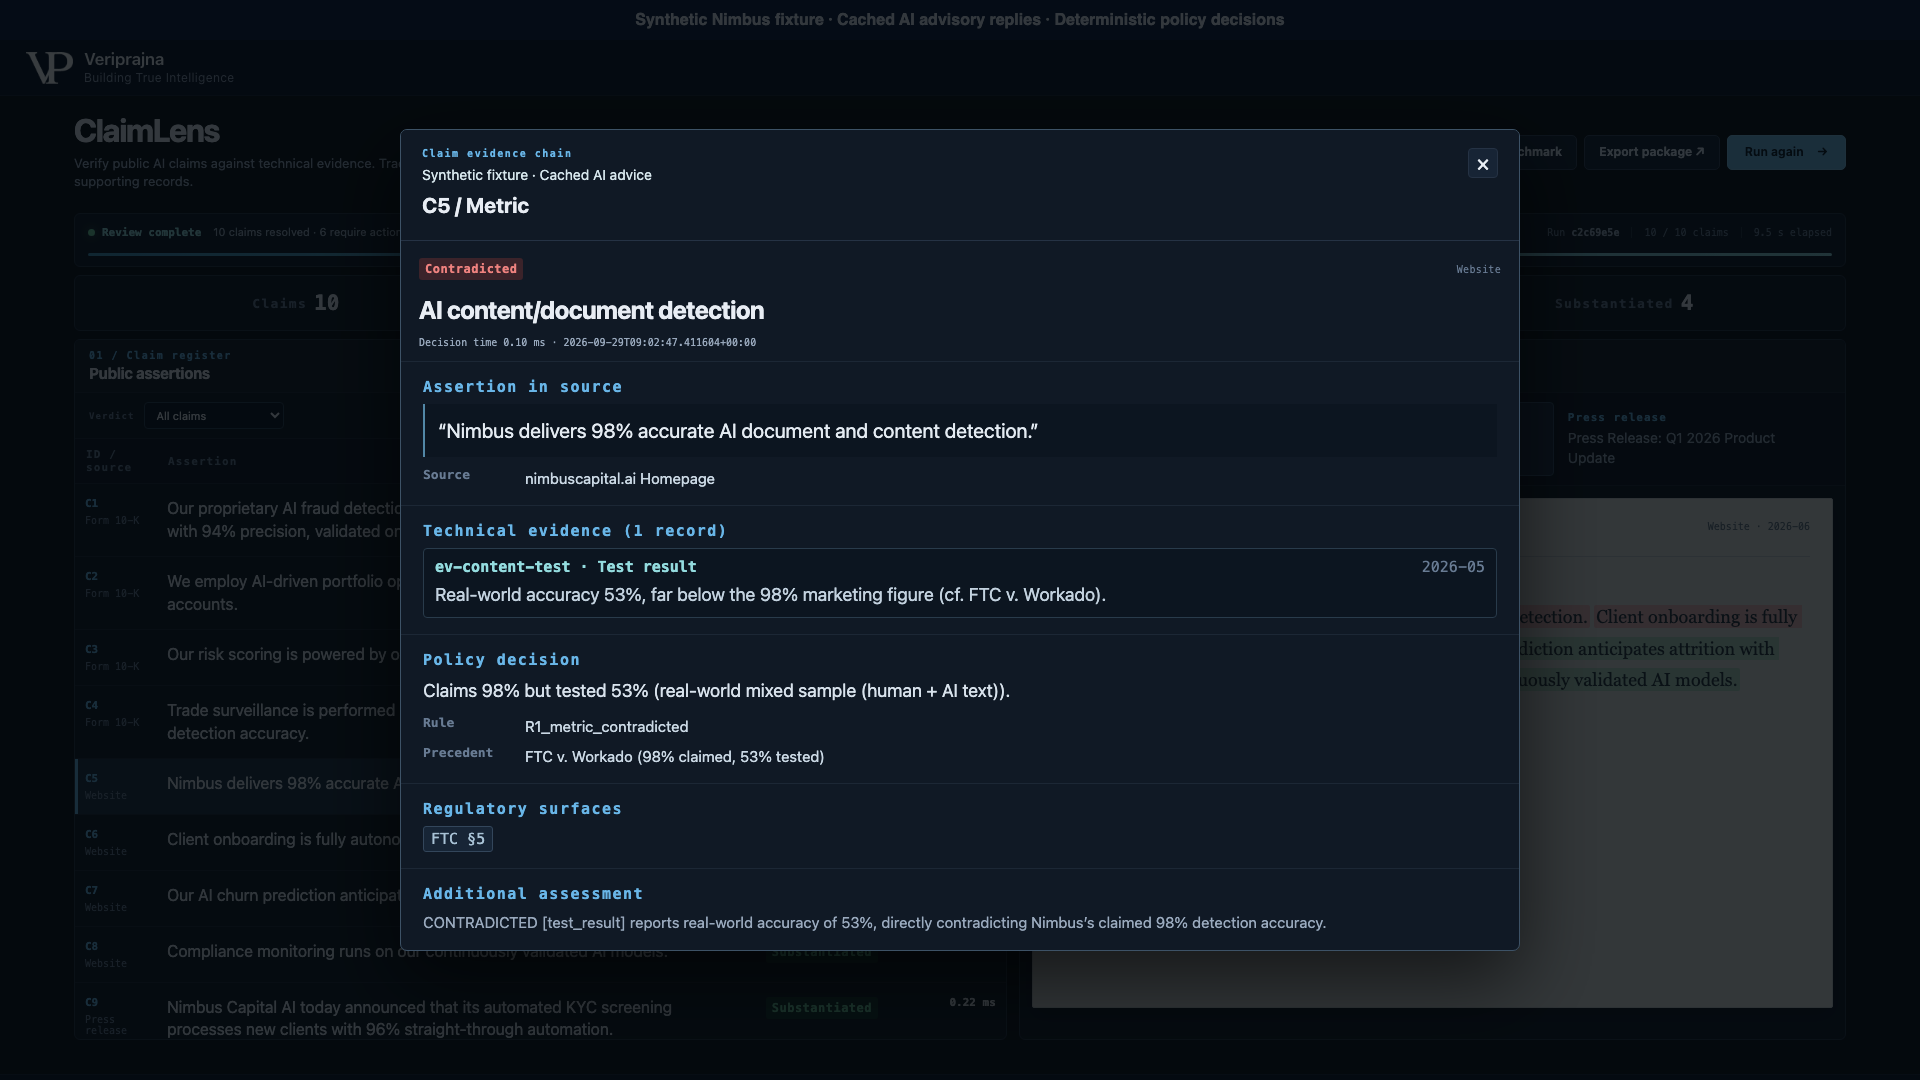
ClaimLens 内容检测明细:98% 宣称准确率、53% 所提供测试结果以及 CONTRADICTED 策略判定。
内容检测明细完整保留了原句、测试记录与判定规则。其 45 个百分点的差距超出了所配置的 5 个百分点容差。界面中的先例与监管标签仅用于说明展示,并非法律适用性结论。 查看全尺寸视图

矛盾判定直接指出冲突所在

另一项关于入驻流程的声明承诺无人工干预(no human in the loop)。其合成运行日志却记录了 68% 的人工干预。所配置的无人工规则在干预率超过 10% 时返回 CONTRADICTED;该阈值为演示设定,并非法律层面的充分界限。

留存差距以供调查

投资组合模型确实存在,但其提供的日志记录显示它仅对 1.5% 的配置决策产生影响。门禁返回 NEEDS_PROOF。缓存的裁判将其称为矛盾,说明了为何建议性意见与最终结果需要采用独立的标签。
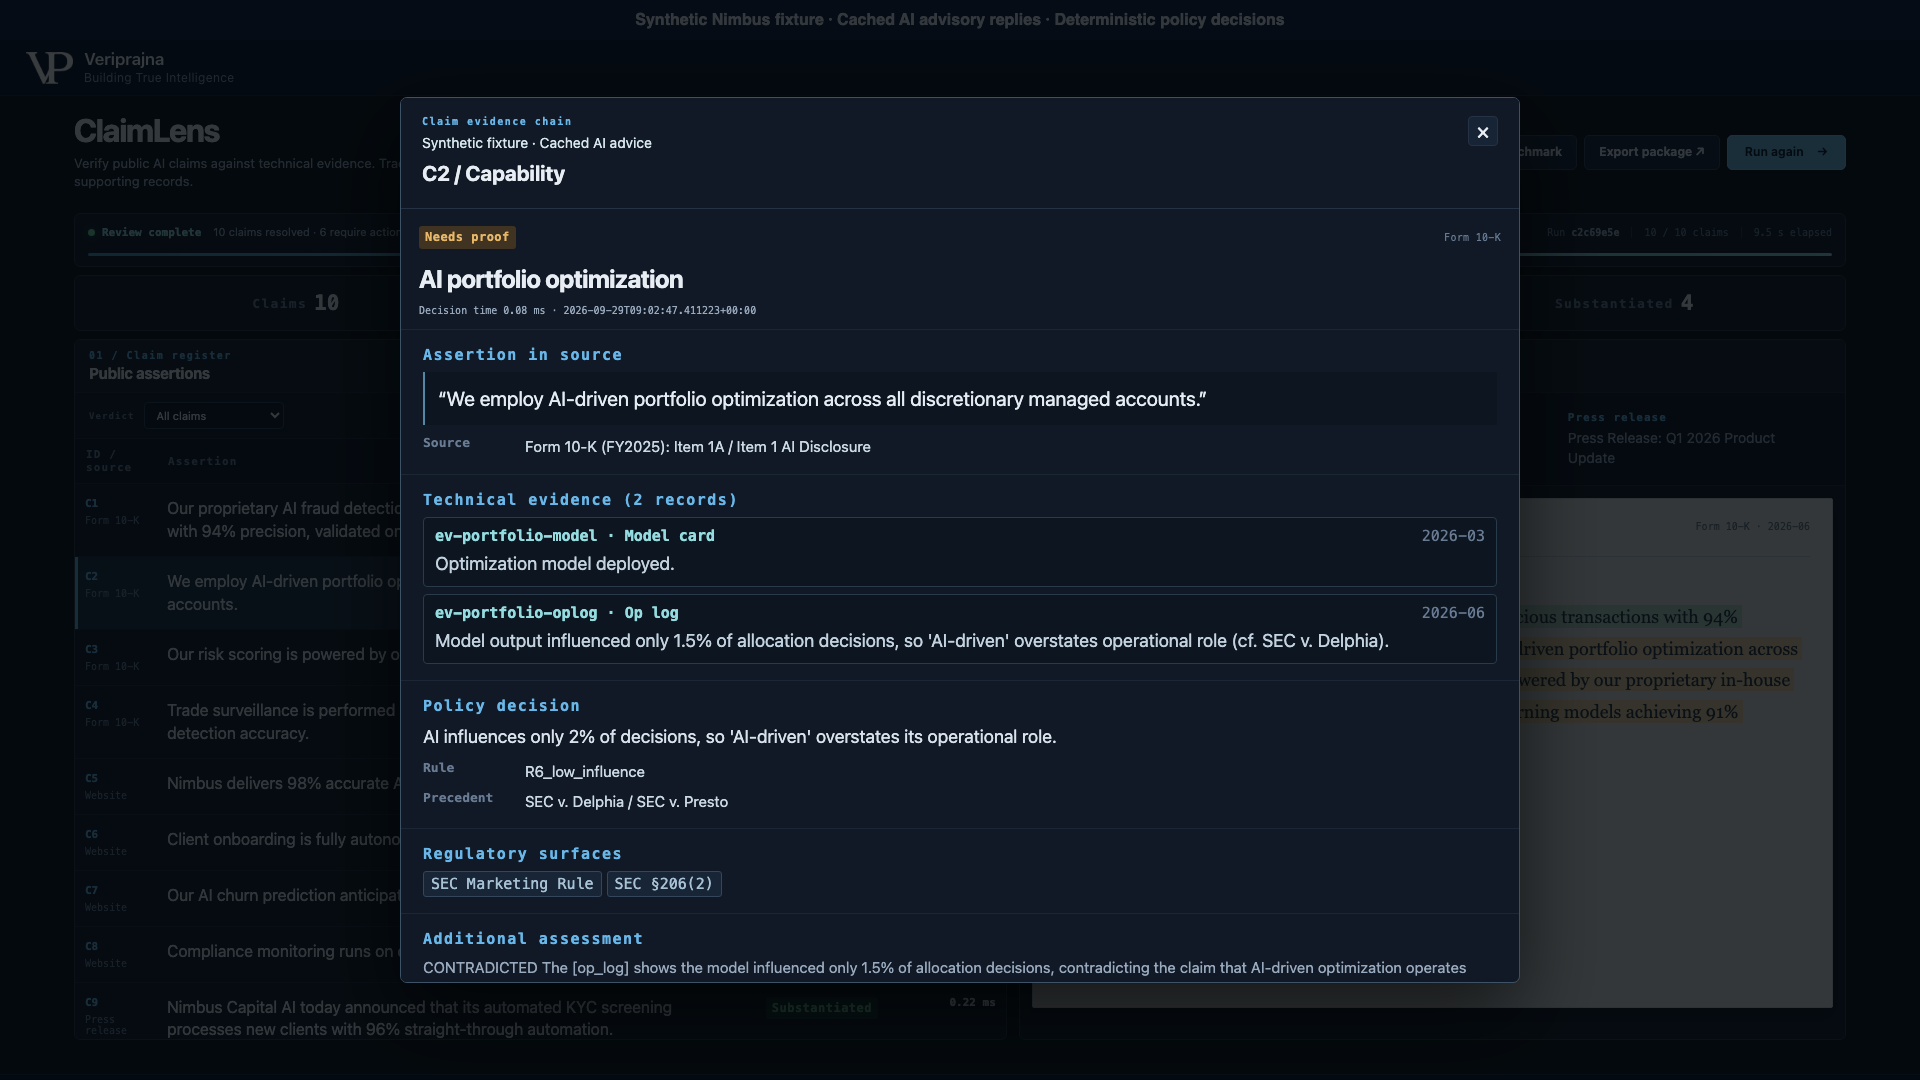
ClaimLens 合成投资组合声称,显示 1.5% 运行影响力、NEEDS_PROOF 门禁及缓存的 CONTRADICTED 建议。
投资组合视图在证据记录中保留了精确的 1.5% 运行数值。其策略文本将此四舍五入为 2%;判定结果仍为 NEEDS_PROOF,而缓存的建议文本显示为 CONTRADICTED。先例标签仅为用于说明的装置注解,而非法律定论。 查看全尺寸视图
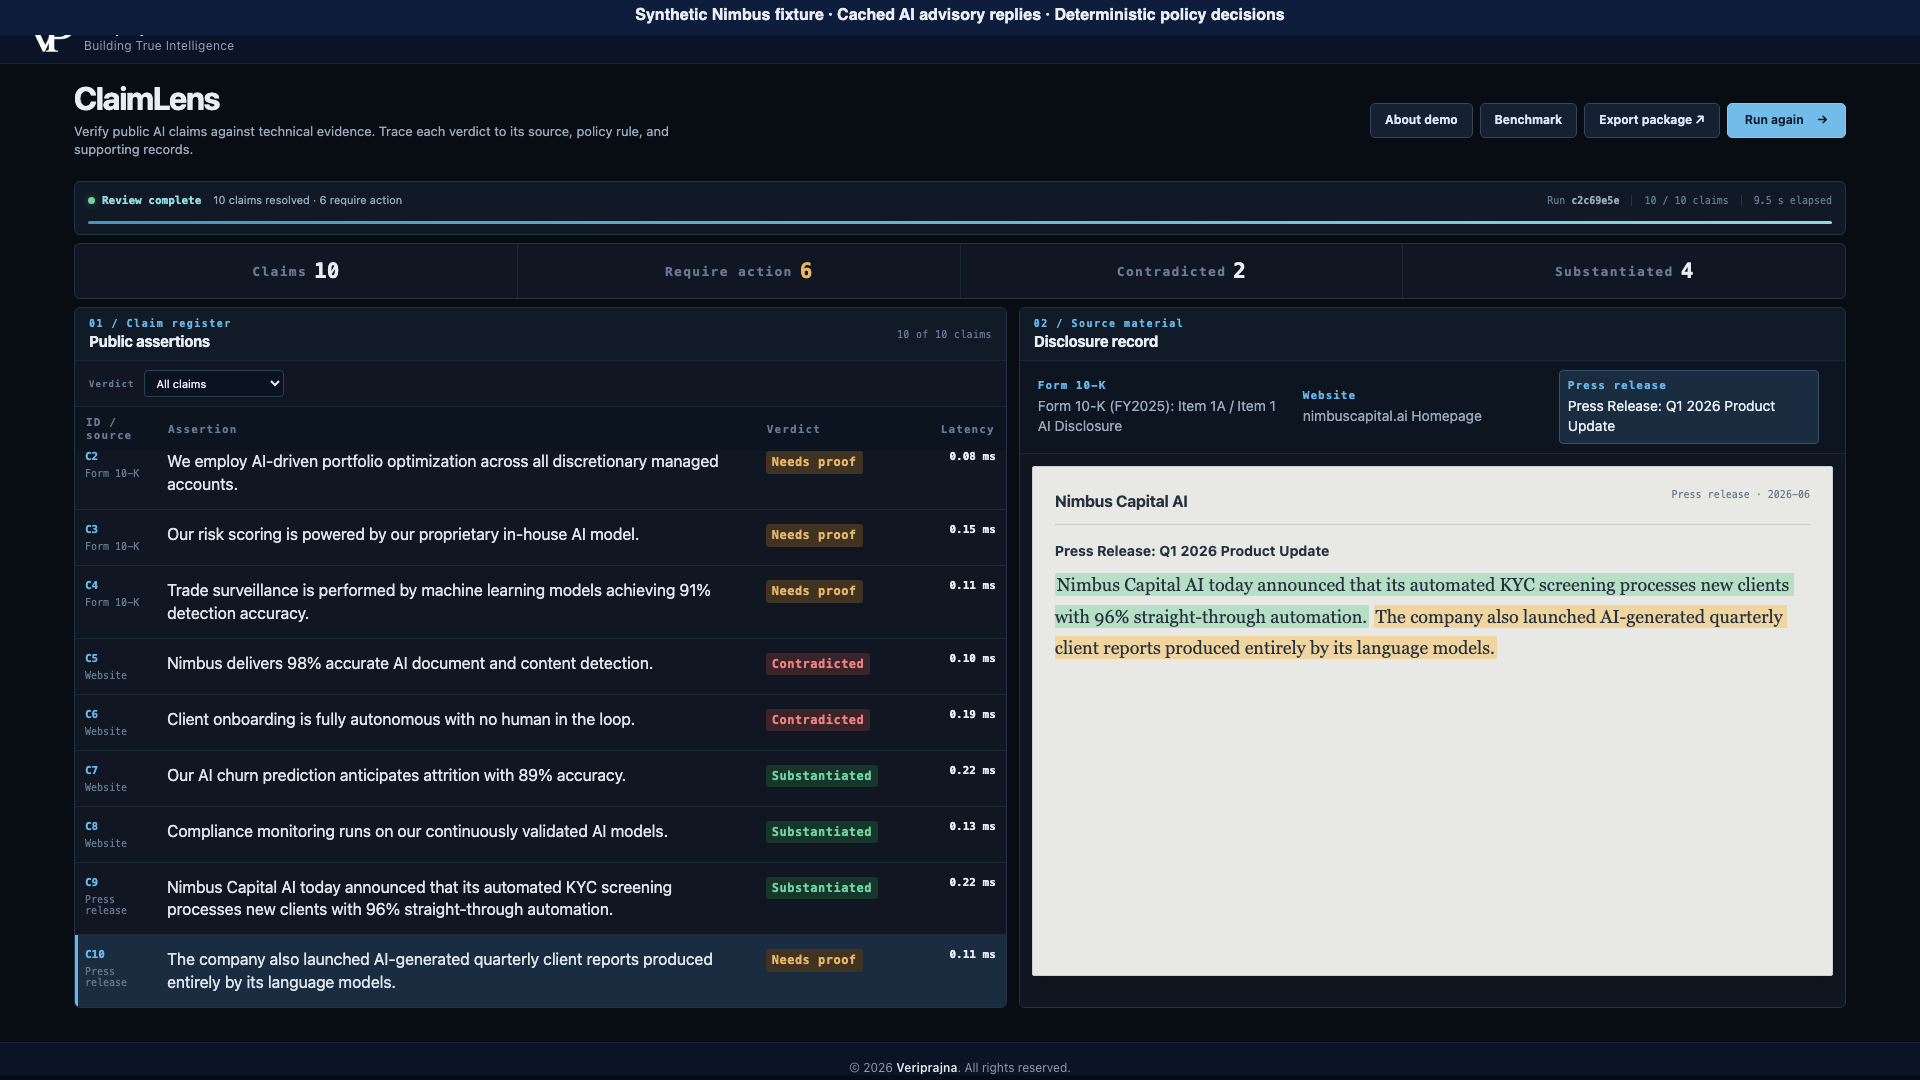
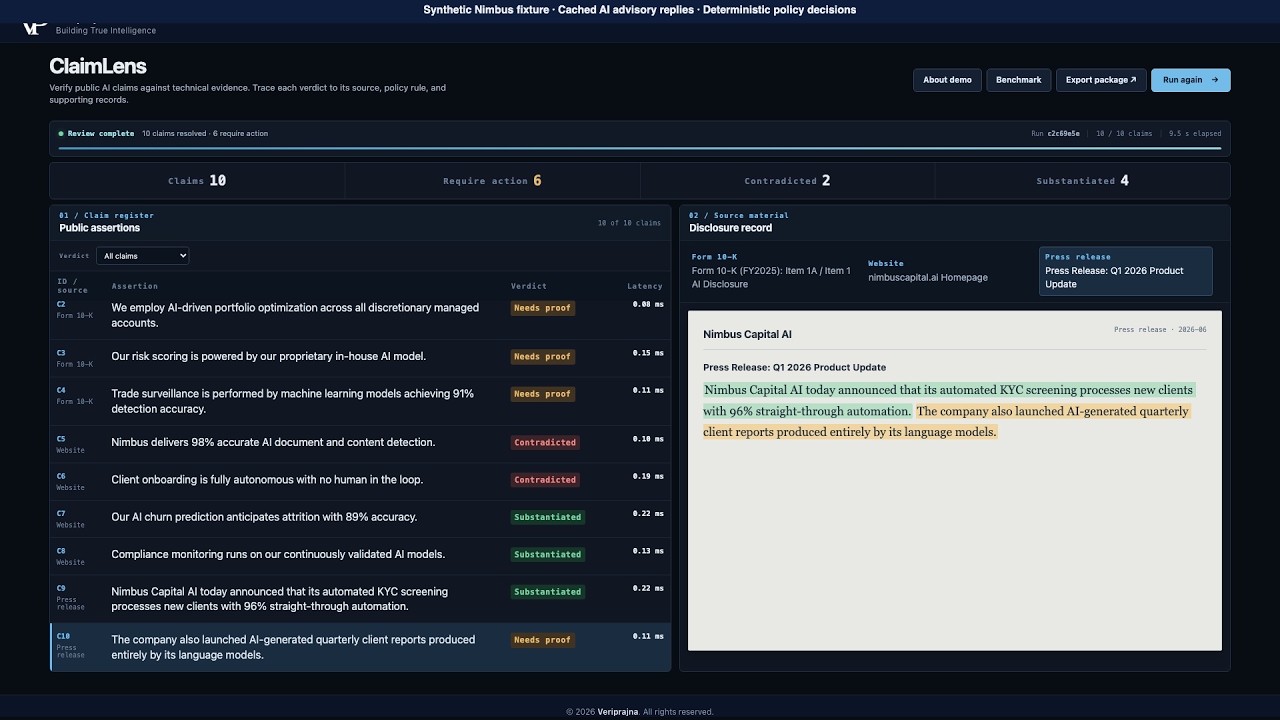
ClaimLens 登记册展示十项合成声称,其中六项需跟进、两项矛盾且四项已实证。
登记册将有支持的声称与未解决的声称并列呈现。在配置的规则下,四项声称已实证,两项矛盾,四项需要证实。六项需要跟进;这并非既定违规行为的统计数量。 查看全尺寸视图

合成欺诈检测声称以其披露的 94% 精确率以及支持性测试与运行记录保持实证状态。测试装置中的受支持结果仍然只是针对所提供记录的断言。审查人员在采信实际措辞之前,必须核实真实测量数据及其相关性。
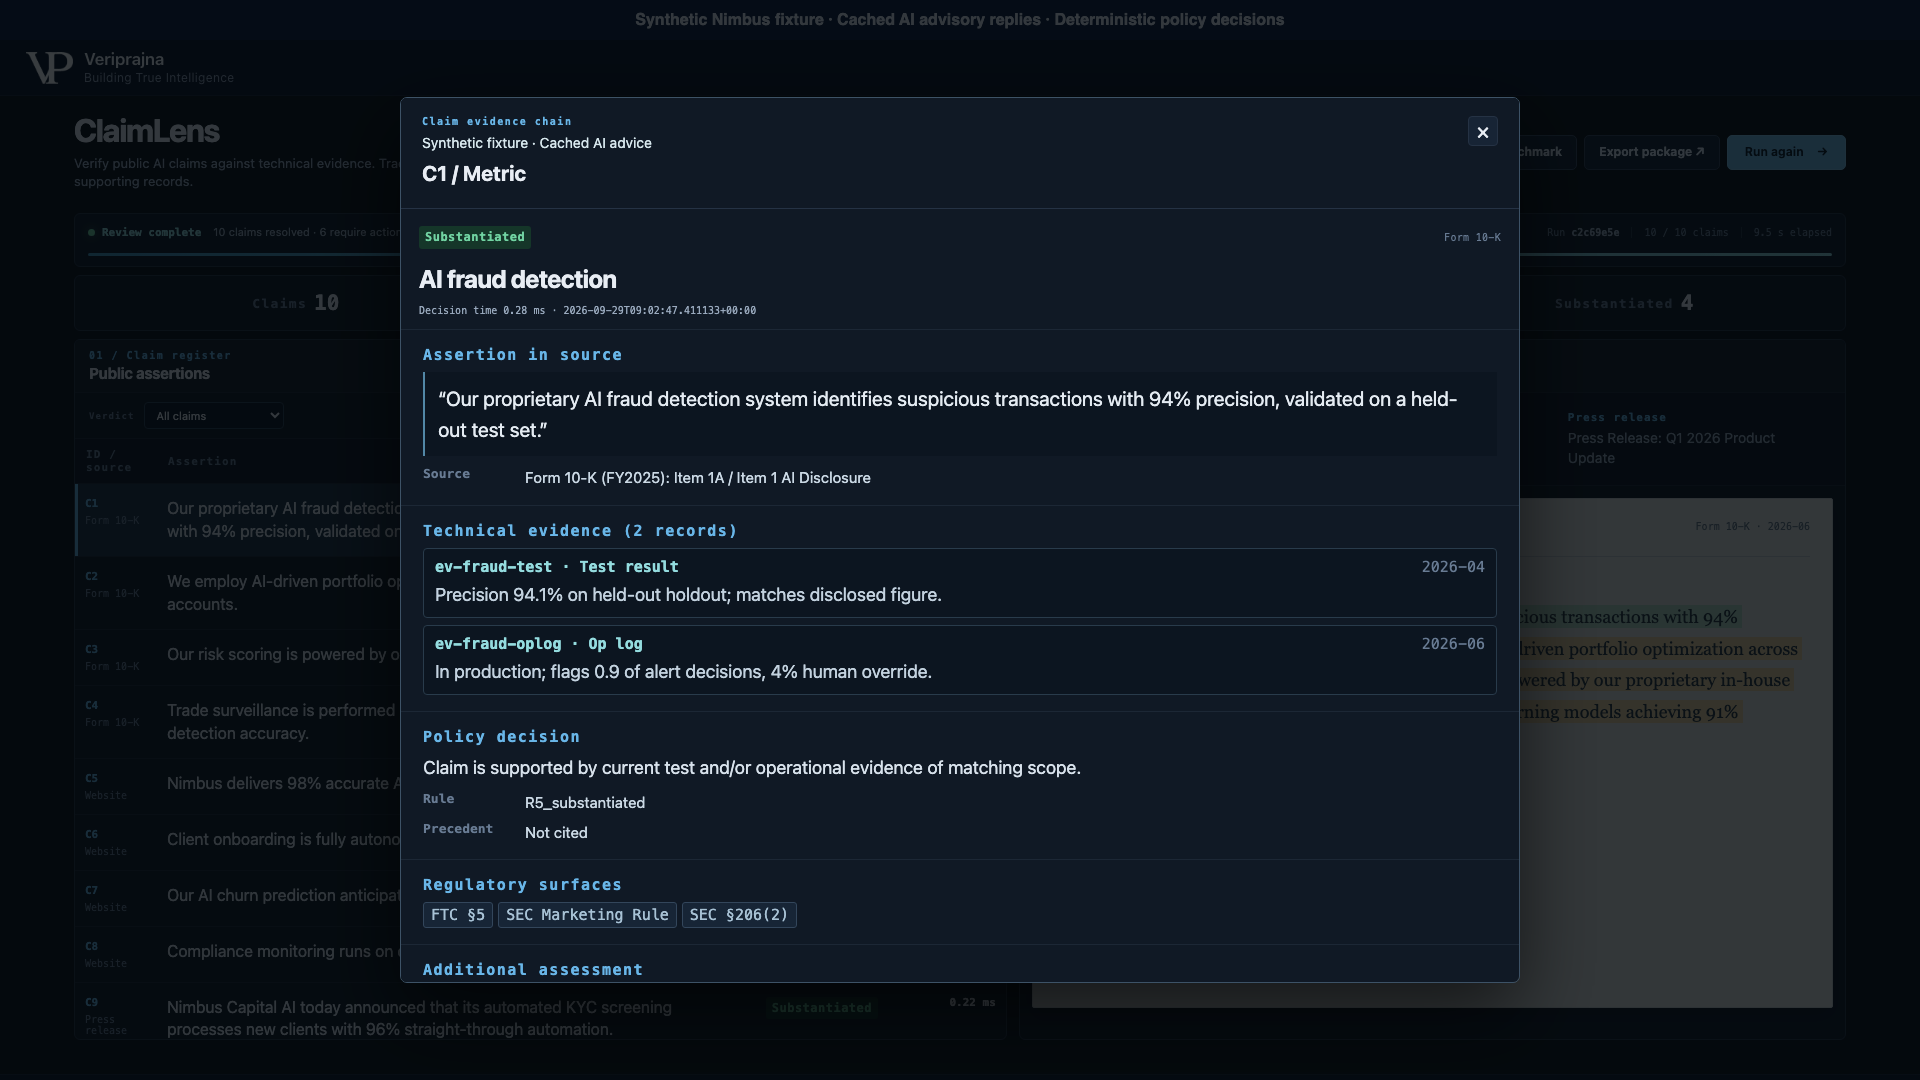
ClaimLens 合成欺诈检测声称,附带披露的 94% 精确率、测试与运行记录以及 SUBSTANTIATED 判定。
受支持的欺诈检测示例同时保留了测试与运行引用。其测试装置正文记为 94.1%,而存储的数值字段为 94.0;披露的声称为 94%。这是配置规则下的支持,而非经过独立验证的性能表现。 查看全尺寸视图

该工作流的适用定位

ClaimLens 演示了声称与记录的比对审查。下表将录制工作流支持检视的内容与实际审查仍需开展的工作明确区分开来。

审查任务本演示所提供的能力本演示未涵盖的范畴
定位承诺表述与所提供来源关联的原句通用文档接入与完整的声称发现
比对支持依据基于主体的记录关联与配置检查证据真实性鉴别与独立测试评估
理解判定结果判定结果、裁决规则与理论依据法律意见或监管审批
移交审查成果附带证据标识符的 JSON 数据包完整的证据归档库或防篡改存证保管

本演示不具备的功能

这是一项使用捆绑合成数据的本地演示。它不包含在线网站或监管文件爬虫、任意文档上传、生产环境 AIBOM 或 CI/CD 集成、语义检索、自主法律评估或 HTML 合订本导出。其设定的阈值不确立统计置信度或法律充分性。本页面旨在阐述录制的工作流,并不提供对本地应用程序的访问权限。

审查团队应探讨的核心问题

这能否告诉我们自己的 AI 声称在法律层面是否合规?

ClaimLens 使用配置的演示规则比对所提供的措辞与技术记录。实证结果不等于法律许可,界面中展示的监管标签仅为说明性的路由标签。人工复核与对底层记录的验证依然必不可少。

我们能否上传自己的文档或接入我们的网站?

本演示使用捆绑的合成 Nimbus 数据集。它不接受任意文档上传,亦不抓取网站、监管披露文件或内部系统。本页面展示录制的工作流及其证据视图。

审查实际核查了哪些证据?

演示通过结构化主体字段将提取出的句子与所提供的技术记录相连结。这些记录包含测试与运行日志。各项检查比对配置的数值和条件;它们并不鉴别记录的真伪,亦不对测试方法论进行独立评估。

最终决策是由 AI 做出的吗?

Substantiation Judge 提供建议但不会改动策略门禁决策。Adversarial Examiner 在返回反驳意见时可将门禁判为实证的声称降级,但它无法升级声称。在本次录制中,建议回复已被缓存,且所有 4 份审查员回复均维持了有支持的结果。

为什么即使模型客观存在,某项声称仍可能需要证实?

模型记录证明了某个组件是有文档记载的,但运营层面的声称还需要证明它实际做了什么。在合成投资组合示例中,提供的日志记录显示其仅对 1.5% 的配置决策产生影响。所配置的门禁返回 NEEDS_PROOF,将这一差距留存以供审查。

审查人员在导出的数据包中能获得什么?

浏览器中的导出按钮可保存已完成运行的 JSON 数据包,其中包含每项声称、来源、判定结果、裁决规则、理论依据及证据标识符。它还包含摘要、引擎版本和生成时间戳。它并不嵌入完整的证据记录、建议笔录或防篡改存证链。

技术研究

查阅相关研究,深入了解本演示的更广泛背景。

将声称与证据汇聚于同一审查流程

与 Veriprajna 共同探讨声称实证工作流。

在确定落地实施方案之前,我们可与您的团队探讨所需的记录、审查边界以及人工决策。

确定审查范围

  • ✓ 识别待审措辞
  • ✓ 映射所提供的证据
  • ✓ 明确未决问题
  • ✓ 商定人工复核职责

明确实施路径

  • ✓ 探讨来源与记录接入
  • ✓ 设定合理的规则边界
  • ✓ 规划面向审查人员的解释
  • ✓ 明确证据移交规范要求