合成内容与虚假评价检测

看似合理的评价仍可能属于协同操作活动。

Campaign Firewall 展示了当仅凭措辞无法发现异常模式时,关联证据如何支持人工审核路由。此处展示的所有评价与账号历史记录均为合成数据。

4 of 15

被本地仅基于文本的基准标记

模拟全人工操作活动,相同测试夹具

15 of 15

被集成模型路由至人工审核

合成记录,无平台操作

105 account pairs

通过共享商品历史关联

同一聚类内的关联证据

这些测试夹具观察结果阐明了一项设计抉择。两种方法均使用从语料库得出的文本百分位数,且集成审核阈值是在相同的标签上拟合的;这并不代表在未见数据上的性能表现。

看似合理的言辞仍未解决协同操作的疑问

品牌保护团队在决定升级处置之前,需要明确评价为何显得互相关联。仅凭流畅措辞无法确立账号是独立运作的,而仅凭负面意见也无法确立存在欺诈。

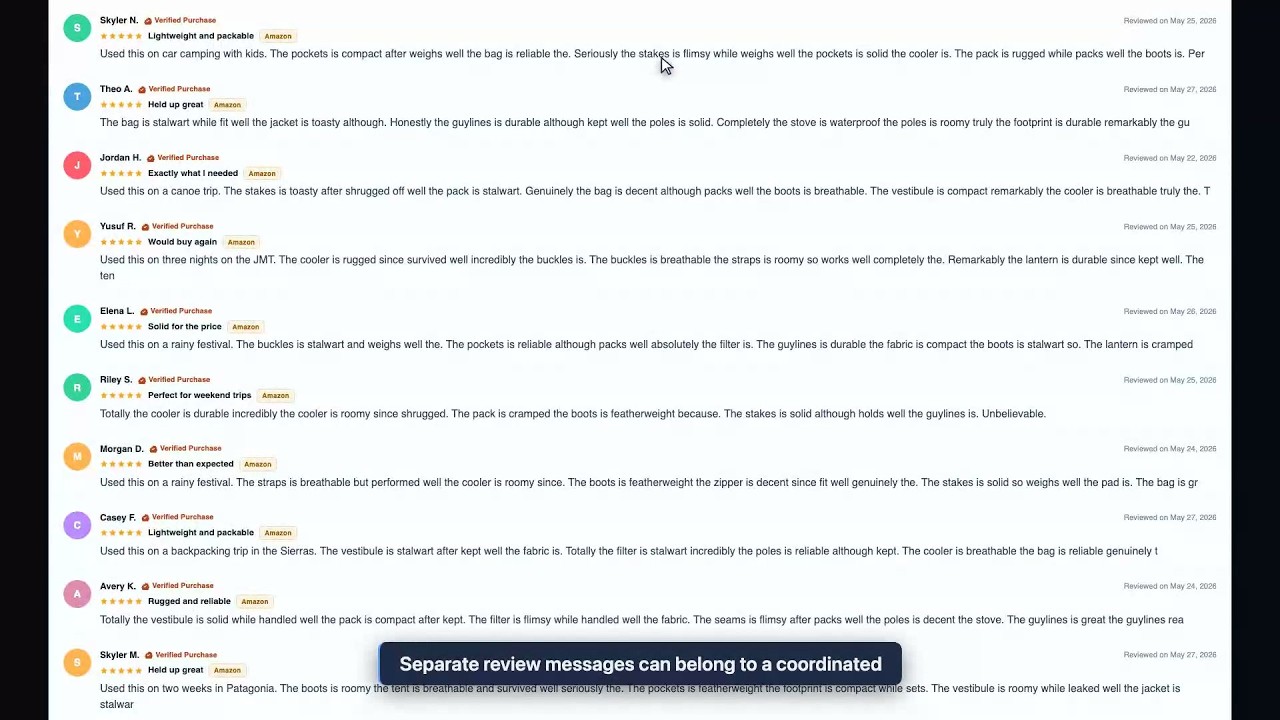
我们的合成示例模拟了针对竞品商品页面的 15-review 虚假活动。11 条记录几乎没有文体计量异常,但它们重叠的商品历史将各账号联系在一起。本地仅基于文本的基准标记了 15 条中的 4 条;集成模型则将全部 15 条路由至审核。

该路由保留了不确定性。模拟的全人工标签是测试夹具基准真值,并非证明这些评价是由真人撰写或有人收受了报酬的证据。

评估信号分值,随后解释发现

结合四大信号族

写作模式、账号行为、高峰时序及账号关联共同计入封顶的启发式评分。测试夹具模拟了 90 days 的历史记录;时序检测器则审查 72-hour 高峰时间窗口。该评分并非校准概率。

要求存在账号关联

共享设备或充分重叠的商品历史在图谱中生成边。商品重叠要求在同一商品页面内至少达到 0.5 Jaccard 相似度,且记录间隔不超过 72 hours。仅凭时序不会创建链接。

保持路由的可检查性

当规模与凝聚度符合配置规则时,连通分量即成为活动聚类。确定性评分在撰写描述性文字之前分配 CLEAR、REVIEW 或模拟的 AUTO 资格。REVIEW 始终是供人工研判的路由,而非已完成的调查。

保留文本背后的证据

记录的调查在评分后重放缓存的 Codex 响应。确定性过滤器检查数字、Token 重叠及结论逆转;它并不确立保留的每句话均为真实。JSON 保留活动归属、数值组件分值及未提交的申诉草稿。可打印 HTML 展示活动画像、单条评价信号名称及草稿;它不展示数值组件明细。

图谱采用可解释的连通分量聚类。本演示中未实现训练好的图神经网络或生产平台集成。

追踪评价活动:从信号到证据

在这些实际应用抓图中,所有评价、账号历史、设备及平台数据流均为合成数据。主示例追踪针对竞品的 15 条模拟评价,贯穿活动发现、人工审核路由直至导出的记录。

实操案例:15 条看似合理的评价,一种关联模式

测试夹具将本案例标记为全人工付费活动,但检测器既未确立作者身份,也未确立报酬给付。其 15 条评价中有 11 条的文体计量组件至多为 4:在此实现中几乎没有写作模式异常。它们的账号历史提供了将它们放在一起审查的依据。
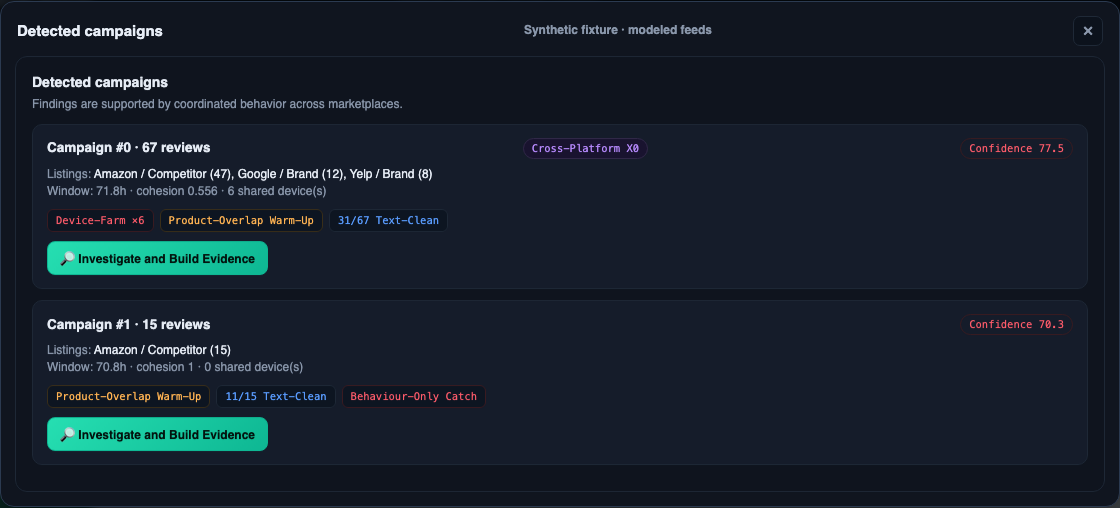
两个合成活动卡片:67-review 跨平台聚类与 15-review 商品历史聚类。
第二个卡片总结了跨越 70.8 hours 的 15-review 案例。其平均置信度标签为 70.3/100 的启发式分值,并非欺诈概率。打开图片可进行全尺寸检查。

1. 检查关联各账号的要素

这 15 条评价在配置的 72-hour 限制内,在同一商品页面上共享充分重叠的商品历史。这生成了 105 product-overlap pair edges,连接聚类中的每一对,凝聚度为 1.0。本案例中不存在共享设备边;此发现不依赖设备复用。仅凭时序不会生成边。
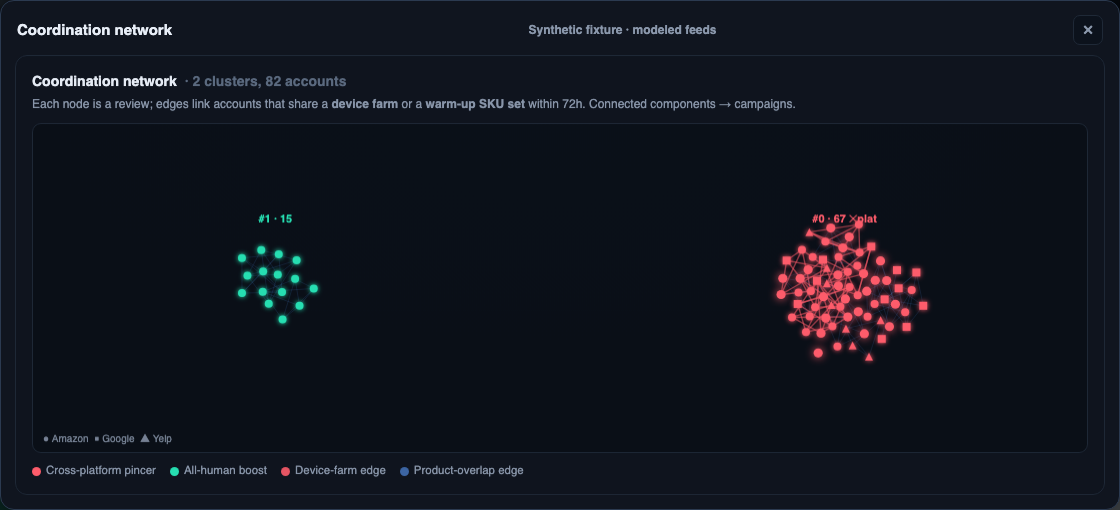
协同图谱展示独立的 15-review 和 67-review 合成聚类及平台形状。
该图谱展示两个聚类及其边的子集。每个节点代表一条评价;颜色区分聚类,而非 CLEAR 与 REVIEW 路由。绿色的 15-review 聚类仍被路由至 REVIEW。打开图片可进行全尺寸检查。

2. 对比文本信号与最终路由

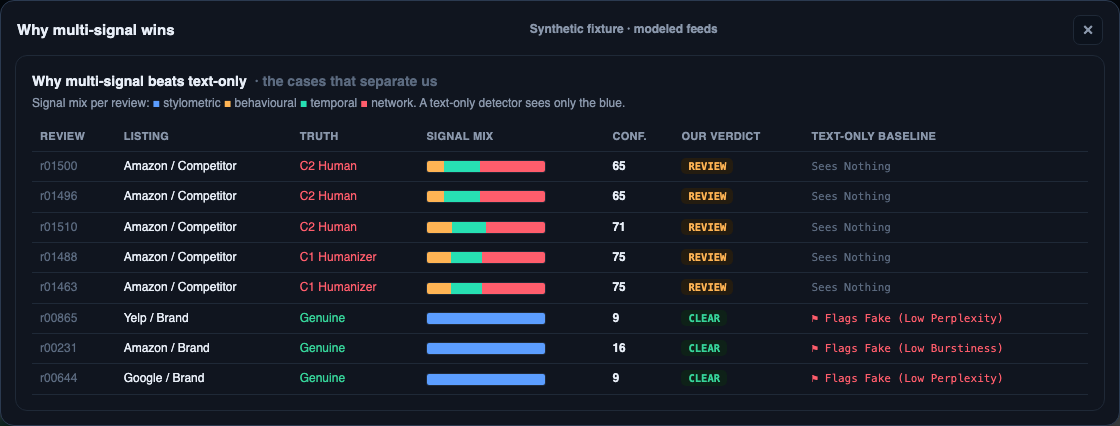
本地仅基于文本的基准标记了 15 条记录中的 4 条。因此,在该测试套件要求至少标记植入标签的 60% 的规则下,它未能实现活动级检测。集成模型结合写作、行为、时序与网络组件,将全部 15 条路由至 REVIEW,而非 AUTO。

完整合成 15-review 案例所确立的事实
证据或决策观察结果解读
写作模式信号11 of 15 的文体计量组件至多为 4低异常并非真人撰写凭证。
账号关联105 product-overlap pair edges;无共享设备边共享历史模式支持将这些账号一起审查。
本地仅基于文本的基准4 of 15 被标记此已实现的对照基准在 60% 规则下遗漏了该活动。
集成模型路由15 REVIEW;0 AUTO全部 15 条均路由至人工研判。未移除任何评价。
选取的 8 个合成评价行,对比组件信号、REVIEW 与 CLEAR 路由以及仅基于文本的基准决策。
此选取的 8 行对比展示了 REVIEW 与 CLEAR 两种结果;它并非完整的 15-review 聚类。琥珀色 REVIEW 表示供人工研判的路由。绿色 CLEAR 表示低于配置阈值,并非经过独立鉴真。打开图片可进行全尺寸检查。

3. 将描述性叙述与判定决策分离开来

在可选模型描述发现之前,确定性评分已设定层级。记录的调查重放来自真实 Codex 桥接的缓存响应。其事实性过滤器检查数字、Token 重叠及结论逆转;保留的文案仍需分析师审核,且无法更改分值或层级。
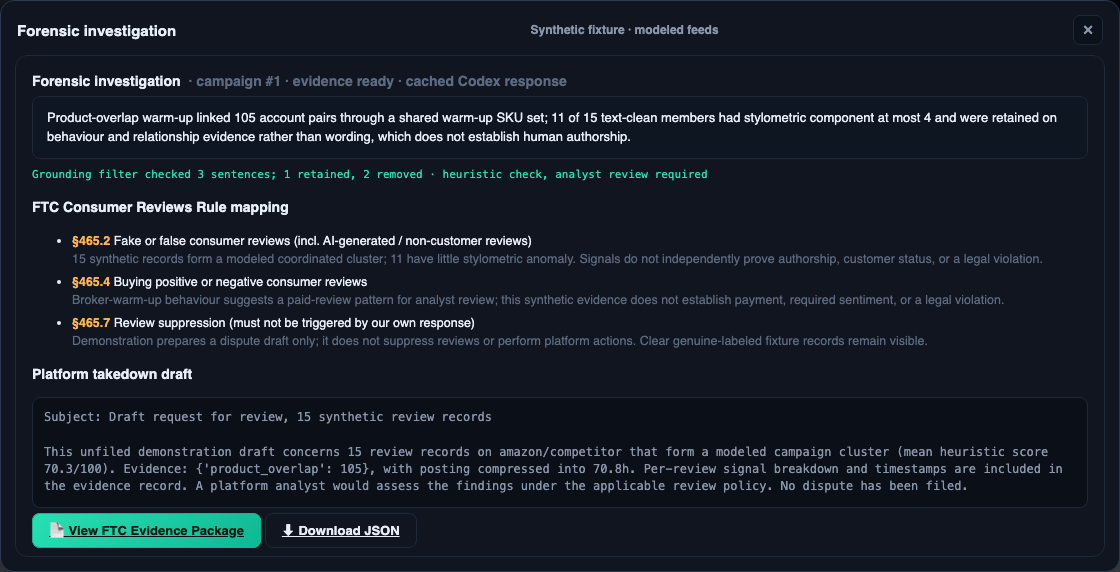
合成 15-review 调查展示缓存的 Codex 来源出处、启发式过滤器、指示性规则映射及未提交的草稿。
调查保留了商品重叠证据并识别了缓存叙述来源。规则映射仅具指示性。诸如“平台下架草稿”等界面措辞描述的是未提交的模板,而非已执行的平台操作。原生草稿称包含单条评价时间戳,但此导出仅包含记录生成时间戳,不包含单条评价时间戳。打开图片可进行全尺寸检查。

4. 在可检查的导出中保留调查发现

实际导出的 JSON 保留了活动归属、层级构成、贡献信号及每条记录的组件分值。可打印 HTML 呈现活动画像、缓存叙述、指示性规则映射、未提交的申诉草稿及全部 15 个被标记行。分析师可核查记录为何被路由,而无需仅依赖描述性叙述。原生申诉草稿夸大了时间戳覆盖范围:JSON 和可打印报告包含记录生成时间戳,但不含单条评价时间戳。在外部使用之前,需要补充并核实这些信息。
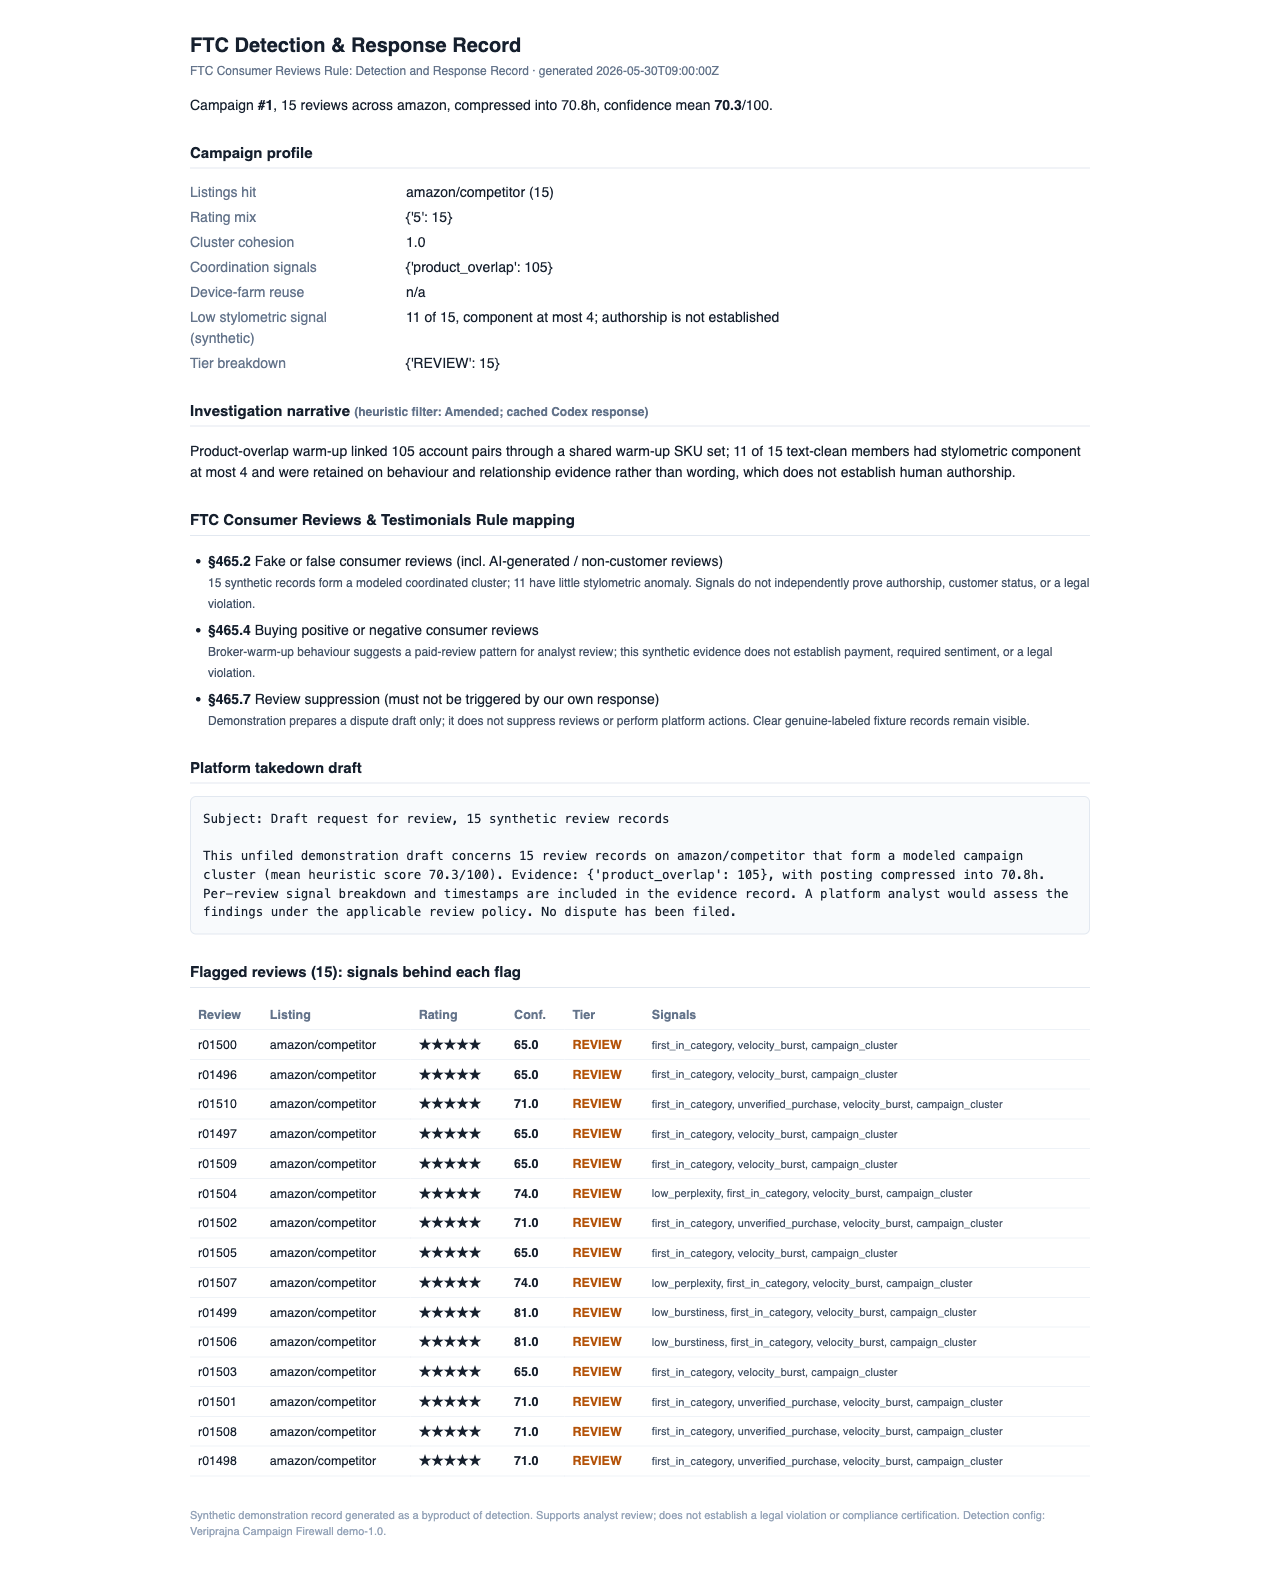
完整的可打印合成 15-review 证据报告,包含活动画像、叙述、草稿及全部 15 个 REVIEW 行。
这是根据实际下载的 JSON 渲染的应用原生可打印报告。全部 15 行均保持为 REVIEW。置信度数值为启发式分值;该记录属于描述性文档,并非违法违规证明、已提交申诉或具备独立证据链托管。原生草稿称包含单条评价时间戳,但此导出仅包含记录生成时间戳,不包含单条评价时间戳。打开图片可进行全尺寸检查。

跨平台对照:单一聚类中的正面与负面评价

另一个独立的合成聚类关联了 67 条记录:模拟 Amazon 竞品商品页面上的 47 条五星好评,加上针对模拟品牌的 12 条 Google 评价和 8 条 Yelp 评价。跨越 71.8 hours,该聚类拥有 90 shared-device pair edges 以及 1,175 product-overlap pair edges。它包含 24 AUTO 和 43 REVIEW 记录;AUTO 是模拟策略下的合格状态,并非自动移除。

此案例展示了为何审核人员可能需要跨模拟数据流的关联关系,而非仅仅统计负面言辞的数量。67 条记录中有 31 条几乎没有文体计量异常。即便存在连通模式,检测器也无法确立实际付款、顾客身份或过错归责。
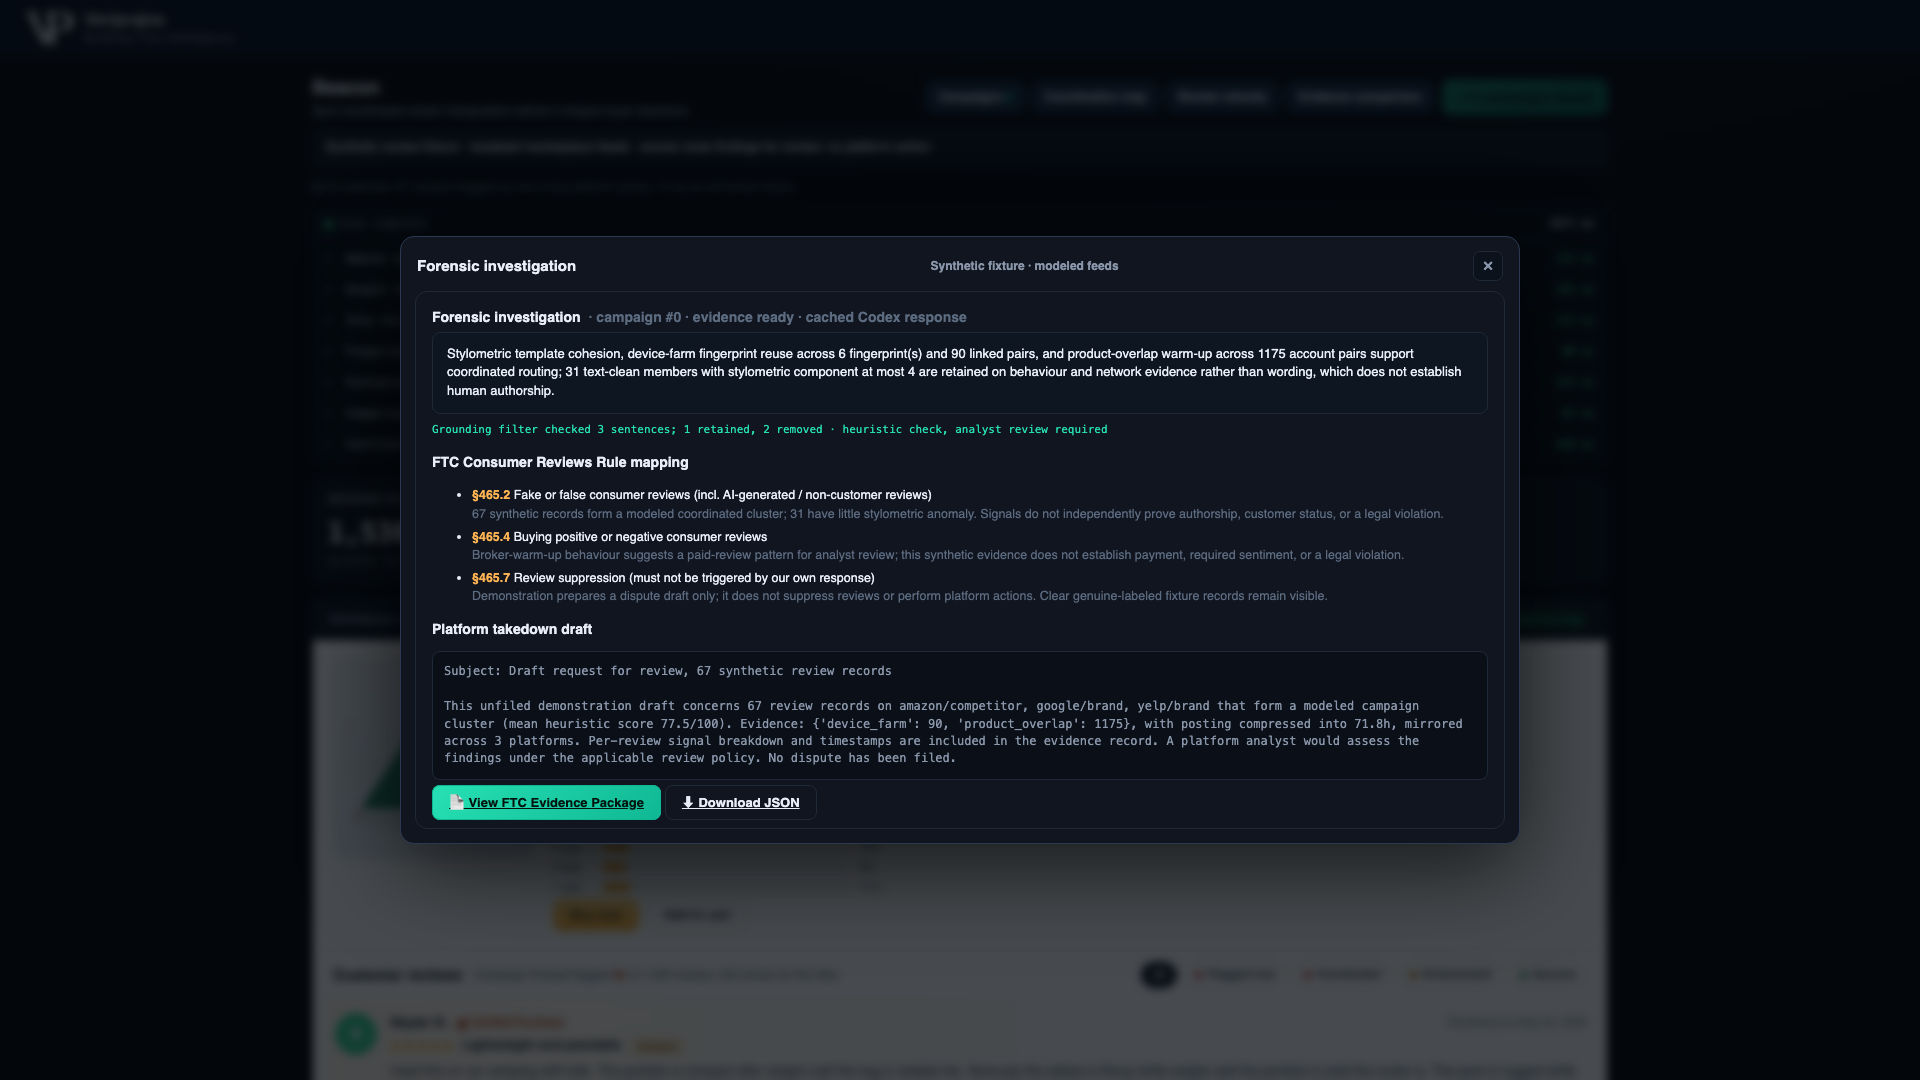
合成 67-review 调查展示共享设备与商品重叠证据、缓存叙述及未提交的申诉草稿。
第二个示例结合了跨越三个平台标签的模拟竞品刷好评与针对品牌的评价。原生调查识别了 67 条记录聚类并保留其关联证据。没有连接器抓取实时评价,也未提交任何申诉。原生草稿称包含单条评价时间戳,但此导出仅包含记录生成时间戳,不包含单条评价时间戳。打开图片可进行全尺寸检查。

时序突增属于上下文背景,而非活动成员总数

模拟的 Amazon 竞品商品页面在 72-hour 时间窗口内评价达到 69 条的高峰,而预期仅为 7.8 条,约为配置基准的 8.85 倍。该商品页面窗口计数并非 67 条记录的跨平台聚类规模。突增贡献了时序信号;账号关联则提供了图谱链接。
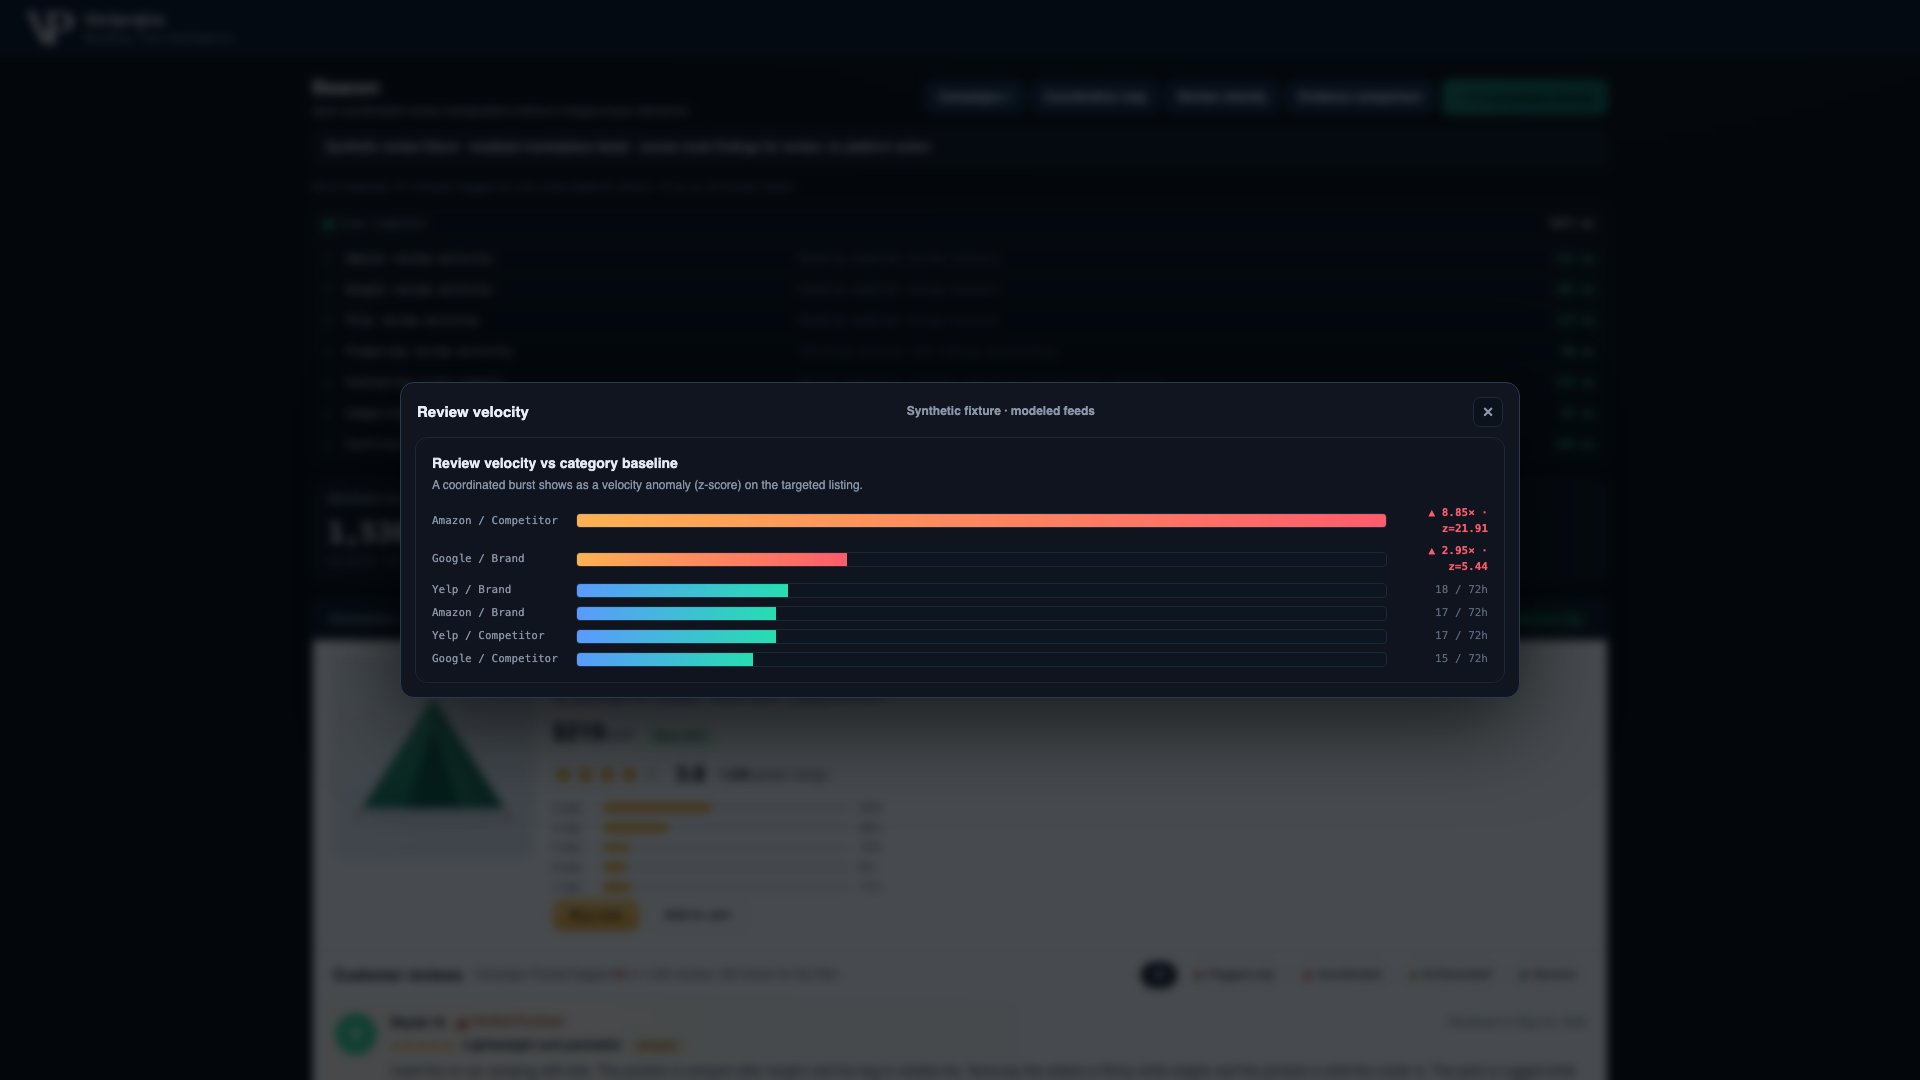
合成商品页面发布速率对比,显示 Amazon 竞品突增约为配置基准的 8.85 倍。
时序视图对比了商品页面级别的高峰窗口。其 Amazon 竞品突增提供了时间背景,但并非该窗口内每条评价均属于协同活动的证据。打开图片可进行全尺寸检查。

阅读附带限制说明的相同测试夹具对比

更广泛的测试夹具包含模拟 90 天历史中的 1,530 条合成记录。以下结果在相同的带标签语料库上复现了当前加载的阈值。两种方法均从中推导文本百分位数,且集成 REVIEW 阈值也是在其标签上拟合的。这些并非留出集或生产环境准确率结果。

当前样本内合成对比
度量指标Campaign Firewall 集成模型本地仅基于文本的基准
被标记的植入评价记录82 of 8240 of 82
被错误标记的带真实标签记录0 of 1,448306 of 1,448
检测到的植入活动标签3 of 30 of 3

标记包含 REVIEW 与 AUTO,并非实际移除。三个植入标签构成两个图谱聚类,因为刷好评与镜像标签连接到了同一个跨平台聚类中。假阳性对比仅适用于此已实现的基准和拟合测试夹具,不适用于商业检测器或新评价。
各层级能支持的功能

层级有用证据边界限制
本地仅基于文本的基准单条记录中的写作模式异常在模拟活动中标记 15 条中的 4 条;不作商业检测器主张
Campaign Firewall 集成模型写作、行为、时序与账号关联在此拟合的合成测试夹具中将全部 15 条路由至审核
调查文档记录成员归属、组件分值、叙述及申诉草稿支持检查;既未提交申诉,亦未证实违法违规

本演示不具备的功能

所有评价记录、账号历史、设备指纹及平台连接均为合成数据。数据流均为模拟生成,无实时连接器或抓取的评价。本演示不对真实作者进行鉴真,不移除评价,不完成人工调查,亦不提交申诉。

未衡量留出评估、生产假阳性率、分析师工时节省、ROI 或申诉成功率。相同测试夹具结果展示的是可复现的配置行为;它们并不确立泛化能力。

买方常见问题

它能否发现读起来像是真人撰写的虚假评价?

Campaign Firewall 将写作模式与账号行为、时序及关联证据相结合。在单个合成 15-review 活动中,本地仅基于文本的基准标记了 4 条记录,而集成模型将全部 15 条路由至人工审核。此模拟案例展示了协同操作检测;它并不确立真实人类作者身份或在全新评价上的表现。

什么证据将这些账号与虚假活动关联起来?

在模拟数据中,共享设备指纹与重叠商品历史构建了账号关联。商品历史链接需要共享商品页面、至少 0.5 Jaccard 相似度且时间戳相隔不超过 72 hours;仅凭时序不会生成边。活动成员归属、组件分值及贡献信号在证据导出中完整保留。

它是否直接从 Amazon、Google 和 Yelp 提取评价?

本演示使用标有 Amazon、Google 和 Yelp 标签的合成记录与模拟历史。它没有实时平台连接器、抓取的评价,亦无法访问真实账号、设备或购买历史。生产数据访问权限、许可及集成需要单独实施与验证。

它会替我们移除评价或提交申诉吗?

Campaign Firewall 导出包含未提交申诉草稿的描述性 JSON 及可打印 HTML 证据。REVIEW 代表人工审核路由,而 AUTO 代表模拟策略下的合格状态。两种状态均不会移除评价、提交申诉或完成调查。

我如何知道它不会标记真实顾客?

当前集成模型在此测试夹具中排除了全部 1,448 条带有真实标签的合成记录。其审核阈值是在相同的标签上拟合的,且两种方法均从该语料库中得出文本百分位数,因此该结果无法确立未见数据的假阳性率。在将这些路由投入实际业务运行前,仍需在独立数据上进行评估。

被标记的活动能否证明违反了 FTC 规定?

协同信号并不确立付款、指定情绪要求、顾客身份或法律违规。FTC 将虚假或不实评价与以正面或负面情绪为条件的奖励以及评价压制区分开来。本演示提供指示性规则映射及未提交的草稿以供实质性审查;它不对合规性作出认证。

法律背景: Federal Trade Commission, Consumer Reviews and Testimonials Rule Q&A (已核对 2026 年)。该映射属于描述性内容,在外部使用前需经过实质性法律审查。

技术研究

探索相关研究,了解本演示更广泛的背景。

在采取行动前使评价调查结果可供检查

与 Veriprajna 讨论您的证据与升级处置需求。

我们可以界定针对您的用例所需的数据访问、独立评估与审核工作流范围。本演示为该讨论提供了具体基础。

评估与考核

  • ✓ 梳理证据需求
  • ✓ 定义独立测试数据
  • ✓ 评估假阳性成本
  • ✓ 审查升级处置边界

实施规划

  • ✓ 明确获准的数据访问范围
  • ✓ 设计可检查评分机制
  • ✓ 规划分析师审核路由
  • ✓ 明确证据导出规范