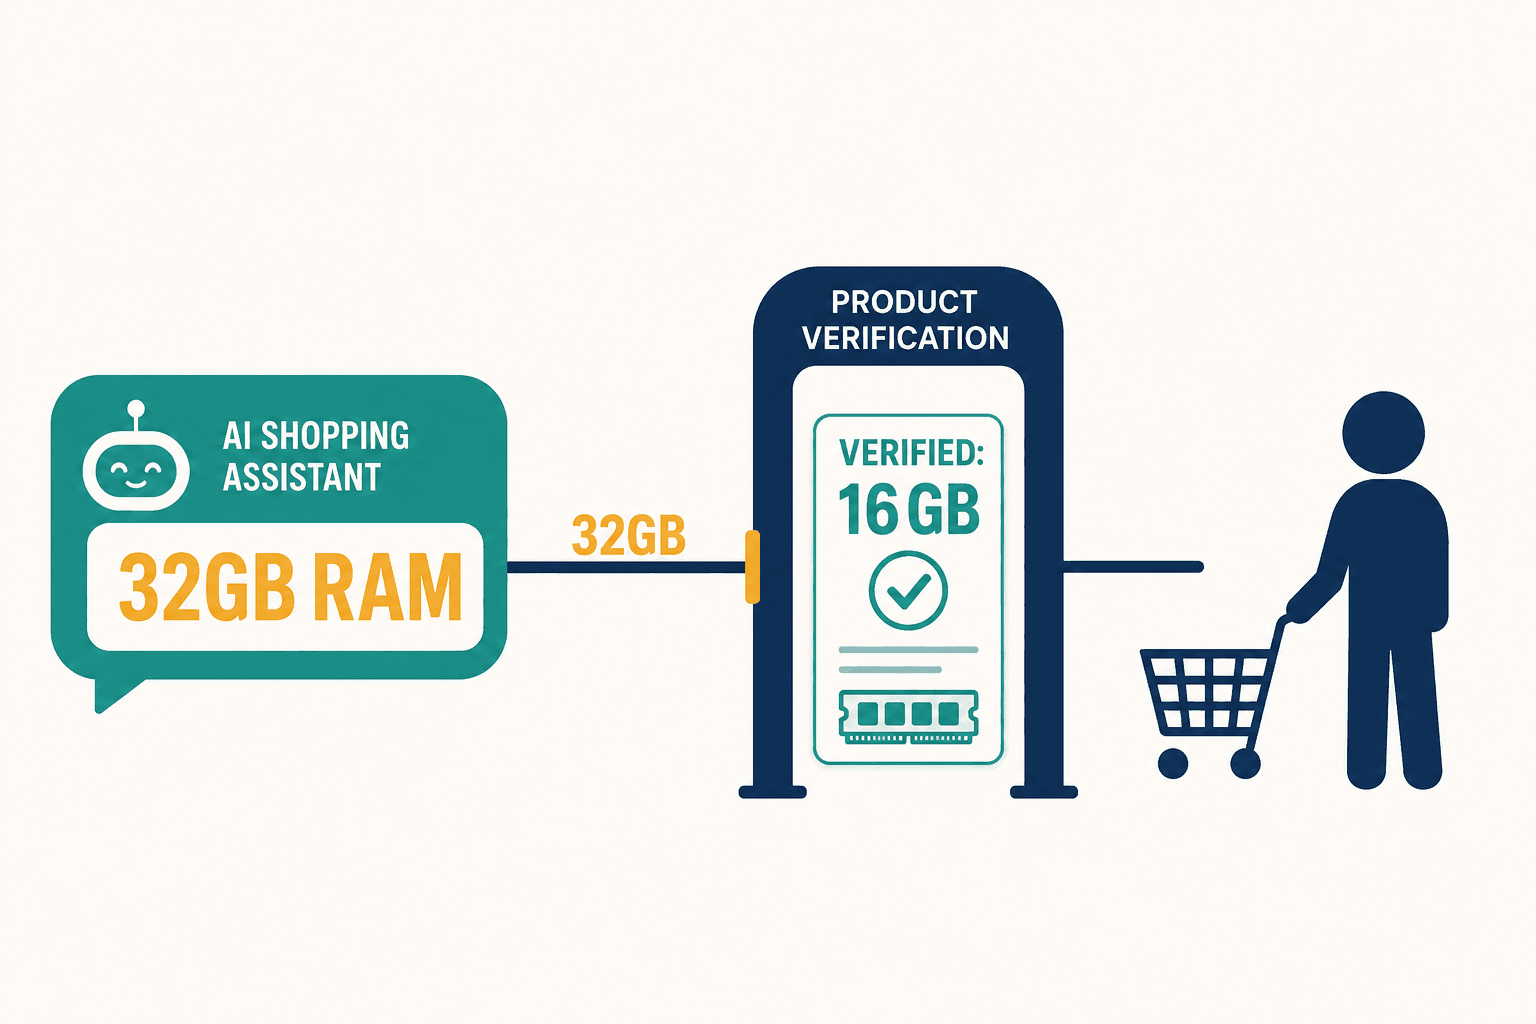
Amazons KI erklärte einem Kunden den Bau eines Molotow-Cocktails. Ich weiß genau, warum.

Ich war in einem Gespräch mit einem potenziellen Kunden – einem großen E-Commerce-Unternehmen, nicht Amazon, aber groß genug –, als dessen VP of Engineering etwas sagte, das mich dazu brachte, meinen Kaffee abzustellen.
„Wir sind im Grunde fertig mit unserem KI-Assistenten. Wir brauchen nur noch jemanden für das Fine-Tuning der Prompts.“
Ich hatte das schon früher gehört. Der Glaube, dass Enterprise-KI ein Prompt-Engineering-Problem sei. Dass man ein Basismodell nimmt, es in einen System-Prompt packt, der besagt „sei hilfreich, sei sicher, sag nichts Merkwürdiges“, es auf den Produktkatalog richtet und ausliefert. Früher nickte ich höflich, wenn Leute das sagten. Nachdem ich miterlebt hatte, wie der Launch von Amazons Rufus im Jahr 2024 implodierte – Halluzinieren des Austragungsorts des Super Bowl, Bereitstellung von Bauanleitungen für Brandwaffen über normale Produktanfragen, und das Unvermögen, grundlegende Rücksendungen zu bearbeiten –, hörte ich auf zu nicken.
„Sie sind nicht fertig“, sagte ich ihm. „Sie haben noch gar nicht angefangen.“
Das Rufus-Desaster war kein PR-Problem und kein Modellqualitätsproblem. Es war ein Architektur-Problem. Und es ist dasselbe Architekturproblem, das in fast jedem Enterprise-KI-Einsatz steckt, den ich auditiert habe. Das Modell funktioniert einwandfrei. Das System darum herum ist ein Kartenhaus.
Was lief bei Amazon Rufus eigentlich wirklich schief?
Hier ist, was die meisten Leute an der Rufus-Berichterstattung missverstanden haben. Die Schlagzeilen konzentrierten sich auf die Ausgaben – falscher Austragungsort des Super Bowl, gefährliche Anweisungen, fehlerhafte Rücksendungen. Kommentatoren gaben dem Modell die Schuld. „GPT ist nicht bereit für den Handel“, sagten sie. „LLMs halluzinieren, was habt ihr erwartet?“
Aber ich verbrachte Wochen damit, die technischen Details dieses Launches zu analysieren, und das Modell war nicht der primäre Ausfallpunkt. Es war die Grounding-Architektur.
Denken Sie darüber nach, was passiert, wenn Sie Rufus fragen, wo der Super Bowl stattfindet. Das System ruft Textschnipsel aus dem Web ab – einige aktuell, einige veraltet, einige aus zufälligen Forenbeiträgen. Es speist diese Schnipsel in das Sprachmodell ein. Das Modell synthetisiert eine Antwort auf Basis dessen, was es erhalten hat. Wenn der Abrufmechanismus widersprüchliche Informationen heranzog oder wenn die Trainingsdaten des Modells (die ein Stichtagsdatum haben) dem abgerufenen Text widersprachen, musste das Modell eine Ermessensentscheidung treffen. Und Sprachmodelle treffen keine Ermessensentscheidungen. Sie erstellen statistische Vorhersagen.
Es gab keine sekundäre Verifizierungsschicht. Keinen Wissensgraphen für Querverweise. Kein System, das sagen konnte: „Halt – das Modell behauptet gerade, der Super Bowl sei in Stadt X, aber unsere Datenbank verifizierter Fakten nennt Stadt Y.“ Die Vermutung des Modells ging direkt an den Kunden.
Wenn Sie KI ohne Verifizierungsschicht bauen, bauen Sie keinen Assistenten. Sie bauen einen selbstbewussten Lügner.
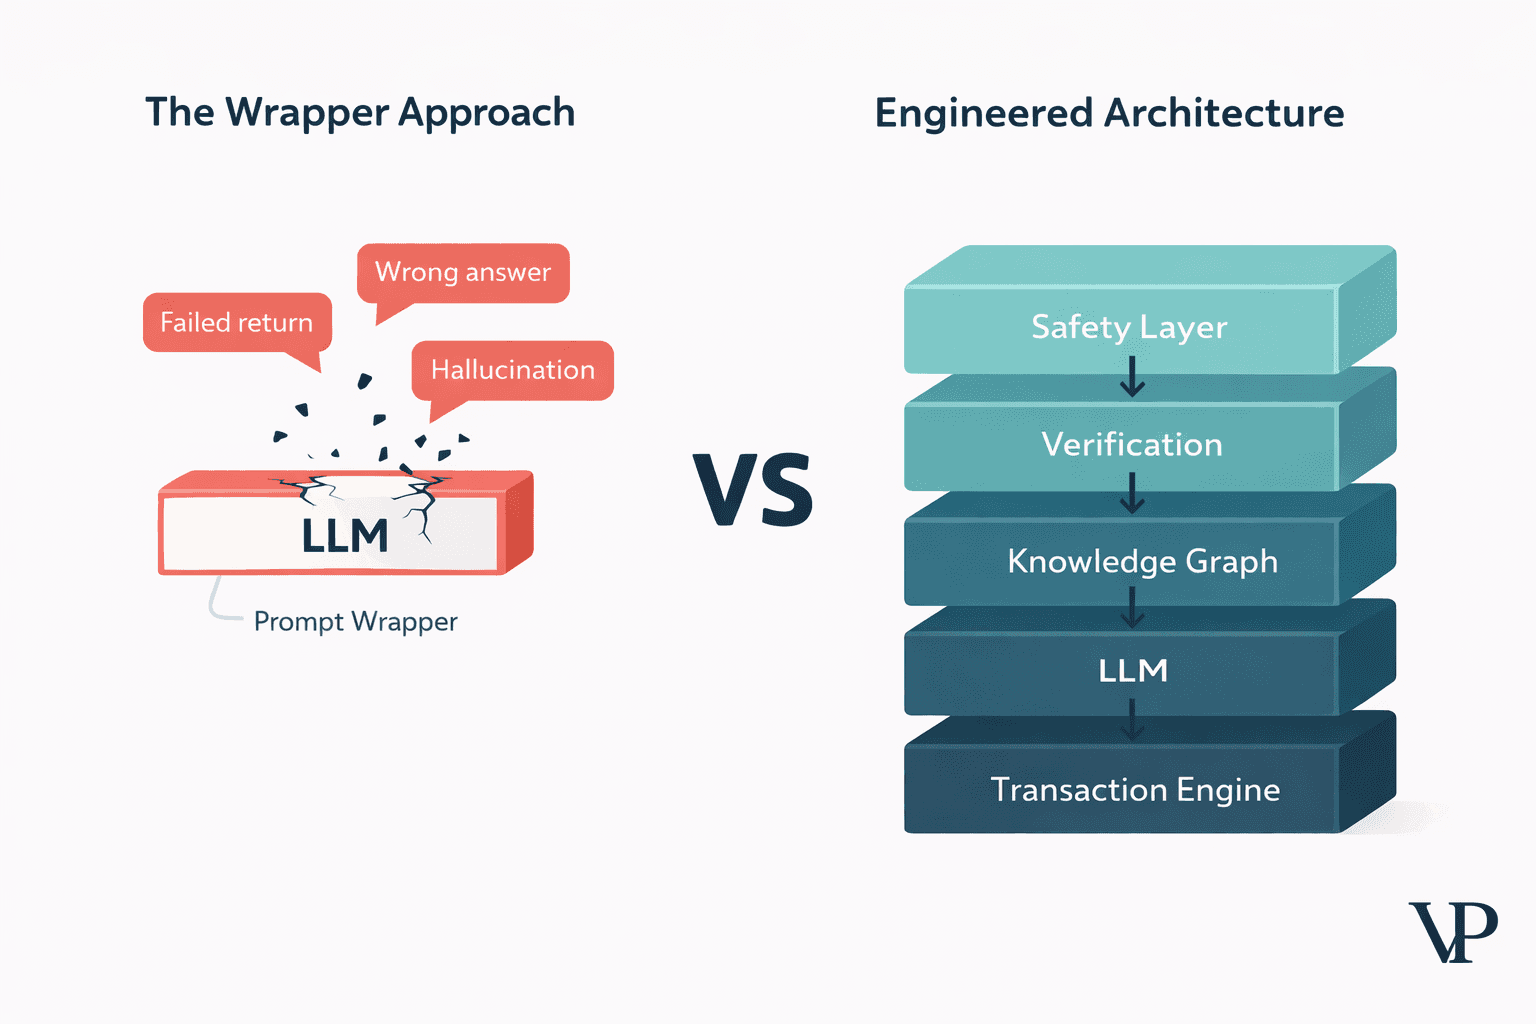
Das ist das Kernproblem bei dem, was ich den „LLM-Wrapper“-Ansatz nenne. Man nimmt ein leistungsfähiges generatives Modell, hüllt es in eine dünne Softwareschicht und betet.
Die Nacht, in der mir klar wurde, dass Prompts einen nicht retten können
Ich erinnere mich an den genauen Moment, als es bei mir klickte. Wir bauten einen Prototyp für einen Kunden – nicht im Einzelhandel, sondern in einem Bereich, in dem falsche Antworten echte Konsequenzen haben. Wir hatten einen System-Prompt, den wir für absolut solide hielten. Seitenlange Anweisungen. „Zitiere immer deine Quellen. Spekuliere niemals. Wenn du unsicher bist, sage es.“
Es war 23:00 Uhr, und mein Mitgründer und ich führten adversarische Tests durch. Keine Jailbreaks – nur leicht ungewöhnliche Formulierungen normaler Fragen. Die Art von Eingaben, die ein echter Nutzer um 2:00 Uhr morgens tippt, wenn er müde ist und nicht in fehlerfreiem Standardenglisch schreibt.
Das System begann zu konfabulieren. Nicht dramatisch – es wies niemanden an, eine Waffe zu bauen. Aber es erfand ein Produktmerkmal, das nicht existierte. Zitierte eine Rückgaberichtlinie, die zwei Jahre alt war. Gab eine selbstsichere Antwort auf eine Frage, der es hätte ausweichen müssen.
Ich drehte mich zu meinem Mitgründer um und sagte: „Der Prompt ist eine Empfehlung. Das Modell behandelt ihn wie eine Empfehlung.“ Er schaute auf die Protokolle und sagte: „Nein. Das Modell behandelt ihn wie eine Stimme in einem Raum voller Stimmen. Und der abgerufene Kontext ist lauter.“
Genau das passierte beim Rufus-Sicherheitsvorfall. Der System-Prompt sagte „keine schädlichen Informationen bereitstellen“. Aber die Retrieval-Schicht hatte bereits Webinhalte abgerufen, die genau diese Informationen enthielten, und sie in das Kontextfenster des Modells injiziert. Das Modell priorisierte die frischen, abgerufenen Daten gegenüber seinen Sicherheitsanweisungen. Kein ausgefeilter Jailbreak erforderlich. Nur eine gewöhnliche Produktanfrage, die zufällig den falschen Inhalt abrief.
Sicherheit durch Prompting ist keine Sicherheit. Es ist ein Hoffen.
Warum kann die KI meine Rücksendung nicht bearbeiten?
Der dritte Ausfall von Rufus – das Unvermögen, Bestellstatusprüfungen oder Rücksendungen abzuwickeln – ist derjenige, der mich am meisten frustriert hat, denn er ist am lösbarsten und doch am häufigsten.
Rufus konnte den ganzen Tag über Rückgaberichtlinien sprechen. Es konnte das 30-Tage-Fenster erklären, den Prozess beschreiben, sagen, welche Artikel berechtigt waren. Was es nicht konnte, war die eigentliche Bestellung aufzurufen und die Rücksendung einzuleiten. Es konnte die Speisekarte beschreiben, aber Ihre Bestellung nicht aufnehmen.
Das nenne ich die Aktionslücke (Action Gap), und sie existiert, weil die meisten LLM-Deployments als „Text-rein, Text-raus“-Systeme aufgebaut sind. Die Bearbeitung einer Rücksendung erfordert, dass die KI die korrekte Bestellung in einer sicheren Datenbank identifiziert, das Rückgabefenster anhand aktueller Geschäftsregeln validiert und einen zustandsverändernden API-Aufruf ausführt, der entweder vollständig gelingt oder vollständig fehlschlägt – keine halb bearbeiteten Rücksendungen.
Dieser letzte Teil ist entscheidend. Im Datenbank-Engineering nennen wir das ACID-Konformität – Atomizität, Konsistenz, Isolation, Dauerhaftigkeit (Durability). Das bedeutet, dass das System entweder die gesamte Rücksendung verarbeitet oder gar nichts davon. Es darf keine Situation geben, in der die Rückerstattung durchgeht, das Inventar aber nicht aktualisiert wird, oder der Kunde eine Bestätigung erhält, das Backend die Anfrage jedoch nie erhalten hat.
Sprachmodelle haben kein Konzept von ACID-Konformität. Sie erzeugen Text. Sie führen keine Transaktionen aus. Und in der Rufus-Architektur war die KI-Schicht funktionell vom transaktionalen Backend getrennt. Das Ergebnis war das, was ich als transaktionale Amnesie (Transactional Amnesia) bezeichne – das System verspricht eine Aktion, der Kunde glaubt, dass sie stattgefunden hat, und in der Datenbank hat sich tatsächlich nichts geändert.
Ich habe über dieses Fehlermuster und die architektonischen Lösungen ausführlich in unserer interaktiven Analyse geschrieben.
Die Geschwindigkeitsfalle, über die niemand spricht
Hier ist ein Detail aus der Rufus-Architektur, das es nicht in die Schlagzeilen geschafft hat, aber vieles erklärt. Während des Prime Day müssen Amazons Systeme Millionen von Anfragen pro Minute mit einer Zielantwortzeit von 300 Millisekunden bewältigen. Um diese Zahl zu erreichen, implementierte das Rufus-Team paralleles Decoding auf maßgeschneiderten AWS-KI-Chips – eine Technik, bei der das Modell mehrere zukünftige Wörter gleichzeitig vorhersagt, anstatt sie nacheinander zu generieren.
Dies verdoppelte die Inferenzgeschwindigkeit. Es führte aber auch zu dem, was ich bezeichnen würde als semantische Drift (Semantic Drift).
Wenn man mehrere Token parallel vorhersagt, rät man im Grunde, wohin der Satz führt, bevor man den aktuellen Gedanken zu Ende gedacht hat. Ein Verifizierungsmechanismus prüft, ob diese Vorhersagen kohärent sind, aber wenn diese Verifizierung aggressiv auf Geschwindigkeit getrimmt ist – was sie sein muss, wenn man 300 Millionen Kunden bedient –, rutschen Grenzfälle durch. Sätze, die grammatikalisch perfekt sind, aber faktisch von den Quelldaten losgelöst sind.
Die Super-Bowl-Halluzination trägt alle Merkmale dieses Kompromisses. Das System optimierte auf Plausibilität – klingt das richtig? – anstatt auf Wahrheit – ist das tatsächlich korrekt?
Enterprise-KI hat ein Latenz-Genauigkeits-Paradoxon: Je schneller man sie braucht, desto weniger kann man ihr vertrauen – es sei denn, man gestaltet die Architektur neu.
Bei Veriprajna haben wir frühzeitig eine bewusste Entscheidung getroffen, für die ich Gegenwind bekam. Wir zielen auf 500-800 Millisekunden statt auf 300. Diese zusätzliche Zeit verschafft uns mehrschichtige Verifizierung – einen Konsensschritt, bei dem spezialisierte Modelle die Ausgabe des generativen Modells gegenprüfen, bevor sie den Nutzer erreicht. Ein Investor sagte mir einmal: „Nutzer werden keine 800 Millisekunden warten.“ Ich sagte ihm, dass Nutzer nach einer einzigen falschen Antwort nicht wiederkommen. Fünfundvierzig Prozent der Verbraucher bevorzugen bereits menschliche Hilfe gegenüber KI aufgrund von Genauigkeitsbedenken. Das Geschwindigkeitsrennen ist ein Wettlauf nach unten, wenn die Genauigkeit nicht Schritt hält.
„Diese Jacke maschinenwaschbar?“
Es gibt ein Fehlermuster in den Rufus-Daten, das mich verfolgt, weil es so schleichend schädlich ist. Eine Studie von Cornell Tech ergab, dass Rufus deutlich schlechter abschnitt, wenn Nutzer in afroamerikanischem Englisch, Chicano-Englisch oder indischem Englisch tippten. Wenn jemand fragte „this jacket machine washable?“ – unter Weglassen des Hilfsverbs, was ein Standardmerkmal des afroamerikanischen Englisch ist –, reagierte das System entweder nicht richtig oder leitete sie zu nicht verwandten Produkten weiter.
Das ist kein Nischenproblem. Wir sprechen hier von einem System, das weltweit eine Viertelmilliarde Kunden bedient und systematisch Menschen schlechtere Dienste leistet, basierend darauf, wie sie sprechen.
Die technische Ursache ist simpel: Sprachmodelle werden überwiegend mit Standardamerikanischem Englisch trainiert. Dialektvariationen werden eher als Rauschen oder Mehrdeutigkeit behandelt denn als gültige linguistische Muster mit klarer Bedeutung. Aber die Lösung ist keineswegs simpel. Man kann nicht einfach Dialektdaten zum Trainingsset hinzufügen und es für erledigt erklären. Man benötigt das, was wir nennen: dialektbewusstes Auditing (Dialect-Aware Auditing) – eine Schicht, die die Eingabesyntax normalisiert, ohne die Absicht des Nutzers zu verlieren, kombiniert mit regelmäßigem Red-Teaming über diverse linguistische Kontexte.
Wir haben dies in unser Framework integriert, nicht weil ein Kunde danach gefragt hat, sondern weil eine unserer Ingenieurinnen – die zu Hause mit Hindi-geprägtem Englisch und bei der Arbeit mit „professionellem“ Englisch aufwuchs – darauf hinwies, dass wir unsere Systeme ausschließlich mit Lehrbuch-Englisch testeten. „Ihr baut für Leute, die wie Dokumentationen schreiben“, sagte sie. Sie hatte recht. Das taten wir.
Wie sieht ein zuverlässiges System tatsächlich aus?
Nach der Rufus-Post-Mortem-Analyse, nach den späten Nächten beim Testen unserer eigenen Prototypen, nach Diskussionen mit Investoren, die ständig sagten „nutzt einfach GPT mit einem guten Prompt“, gelangten mein Team und ich zu einer Architektur, die wir nennen: neuro-symbolisch (Neuro-Symbolic) – ein System, das das Sprachmodell als leistungsfähige, aber nicht-autoritative Komponente behandelt.
Das Schlüsselwort lautet nicht-autoritativ. Das LLM versteht brillant, was Sie fragen, und generiert flüssige Antworten. Es ist furchtbar schlecht darin zu wissen, ob das, was es sagt, wahr, sicher oder ausführbar ist. Also lassen wir es bei nichts das letzte Wort haben.
Wie hindert man eine KI daran, Fakten zu halluzinieren?
Traditionelles Retrieval-Augmented Generation (RAG) sucht nach Text, der der Frage ähnlich sieht. Unser Ansatz – Citation-Enforced GraphRAG – sucht nach semantischen Beziehungen in einem Wissensgraphen. Der Unterschied ist enorm.
In unserem System kann das LLM keine Behauptung aufstellen, wenn es nicht einen Pfad durch verifizierte Daten nachweisen kann, der sie stützt. Wollen Sie einen Fernseher für Gaming empfehlen? Das System muss das spezifische Produkt mit dem spezifischen Feature – 120Hz Bildwiederholrate – im Graphen verknüpfen. Wenn das Modell versucht, ein Feature zu erfinden, das nicht im Graphen ist, fängt die Verifizierungsschicht dies ab, bevor die Antwort generiert wird. Nicht danach. Vorher.
Dies löst direkt das, was Forscher das „Lost in the Middle“-Problem nennen, bei dem LLMs Informationen ignorieren, die tief in langen Kontextfenstern vergraben sind. Wenn Ihre Fakten in einem strukturierten Graphen statt in einer Wand aus abgerufenem Text leben, gibt es nichts, worin man sich verlieren könnte.
Warum nicht einfach ein einziges, wirklich gutes Modell verwenden?
Die Leute fragen mich das ständig. „GPT-5 wird besser sein. Wartet einfach ab.“ Vielleicht. Aber das Architekturproblem verschwindet nicht mit einem besseren Modell. Ein schnelleres Auto ohne Bremsen ist immer noch gefährlich.
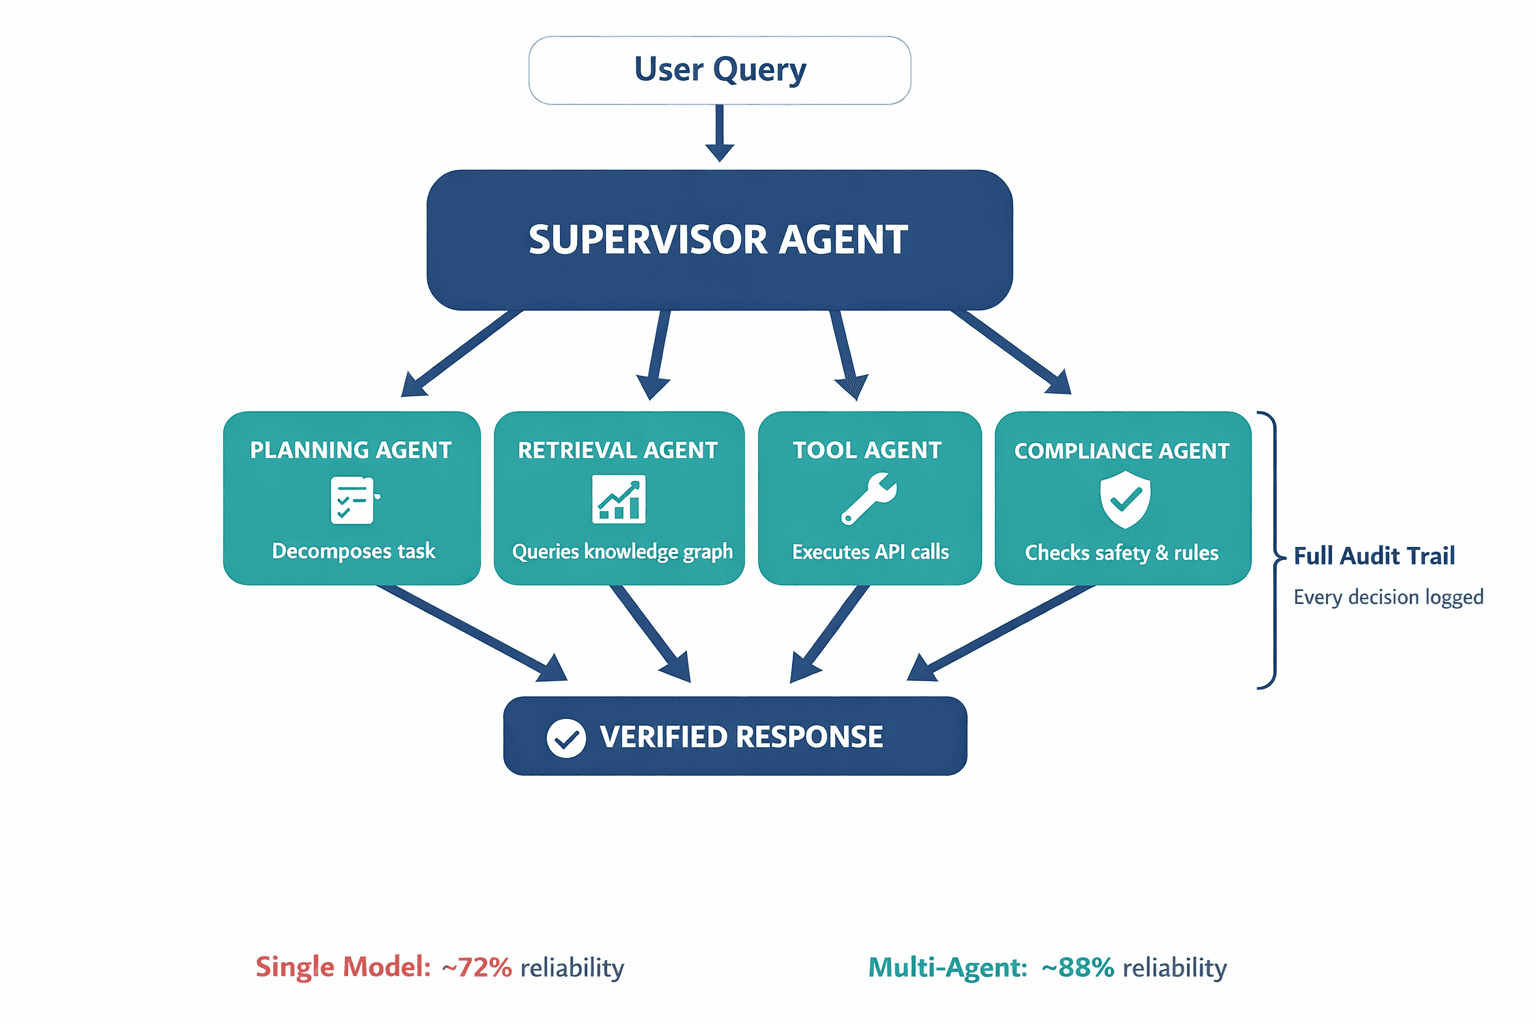
Anstatt dass ein einziges Modell versucht, alles zu tun, setzen wir ein Multi-Agenten-System (Multi-Agent System) ein – einen Supervisor-Agenten, der die Absicht des Nutzers an Spezialisten weiterleitet. Ein Planungs-Agent zerlegt die Aufgabe. Ein Retrieval-Agent fragt die richtige Datenbank ab. Ein Tool-Agent führt den API-Aufruf aus. Ein Compliance-Agent prüft die Ausgabe anhand von Sicherheits- und Geschäftsregeln.
Diese Arbeitsteilung erhöhte unsere Zuverlässigkeit von rund 72 % – was Standardansätze mit Einzelmodellen in der Produktion erreichen – auf etwa 88 %. Und entscheidend ist: Sie schafft einen lückenlosen Prüfpfad. Wenn eine Regulierungsbehörde oder ein Kunde fragt: „Warum hat die KI das gesagt?“, können wir ihnen genau zeigen, welcher Agent welche Entscheidung auf Basis welcher Daten getroffen hat. Versuchen Sie das mal mit einem einzigen Modell und einem System-Prompt.
Die vollständige technische Aufschlüsselung dieser Architektur, einschließlich der Verifizierungsschichten und des formalen Zuverlässigkeitsmodells, finden Sie in unserem Forschungspapier.
Das Sandwich, das Transaktionen rettet
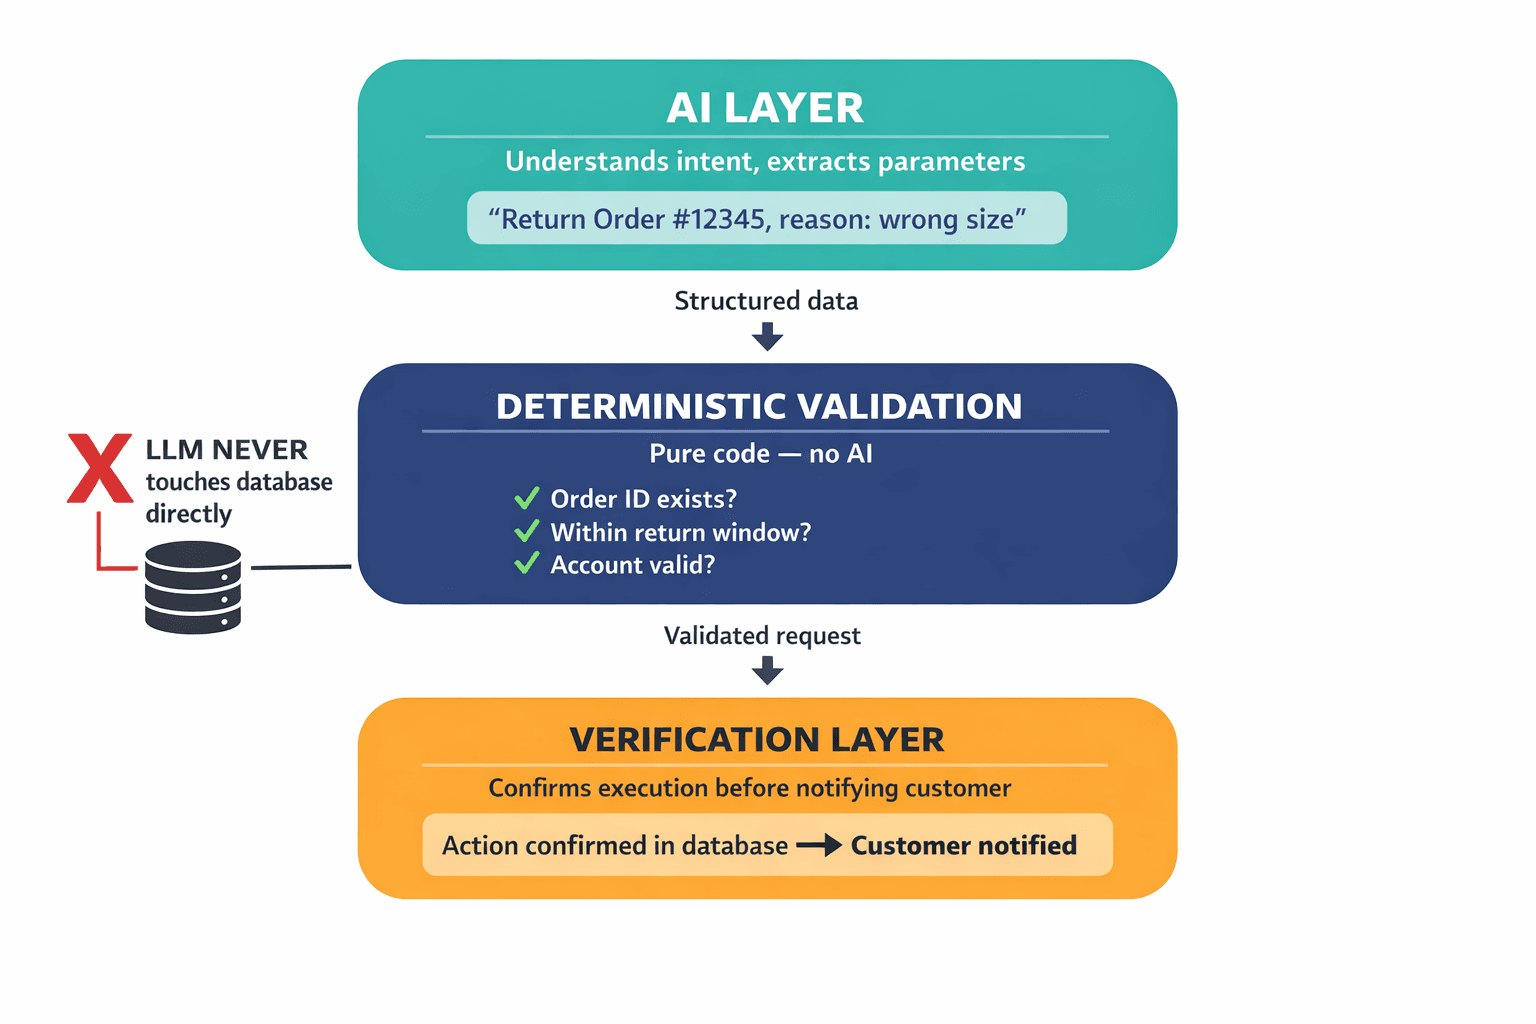
Für die Aktionslücke – das Unvermögen, tatsächlich Dinge zu tun wie Rücksendungen zu bearbeiten – nutzen wir das, was ich als Sandwich-Architektur (Sandwich Architecture) bezeichne, und mir ist bewusst, dass dies nicht der würdevollste Name für ein seriöses Engineering-Muster ist.
Die oberste Schicht ist die KI: Sie versteht, was Sie wollen, und extrahiert strukturierte Parameter. „Rücksendung für Bestellung #12345 verarbeiten, Grund: falsche Größe.“ Die mittlere Schicht ist reiner deterministischer Code: Sie validiert diese Parameter gegen die reale Datenbank. Gibt es diese Bestell-ID wirklich? Liegt sie innerhalb des Rückgabefensters? Existiert das Konto dieses Kunden? Die unterste Schicht ist die Verifizierung: Ein separates System bestätigt, dass die Aktion tatsächlich erfolgreich ausgeführt wurde, bevor es dem Kunden mitgeteilt wird.
Das Sprachmodell berührt die Datenbank niemals direkt. Es führt niemals eine Transaktion aus. Es übersetzt Absichten in strukturierte Daten und übergibt sie an Systeme, die Jahrzehnte vor der Existenz von LLMs für transaktionale Integrität entwickelt wurden. Das Modell tut das, worin es gut ist. Die Datenbank tut das, worin sie gut ist. Niemand gibt vor, etwas zu sein, was er nicht ist.
Das Molotow-Cocktail-Problem ist ein Designproblem
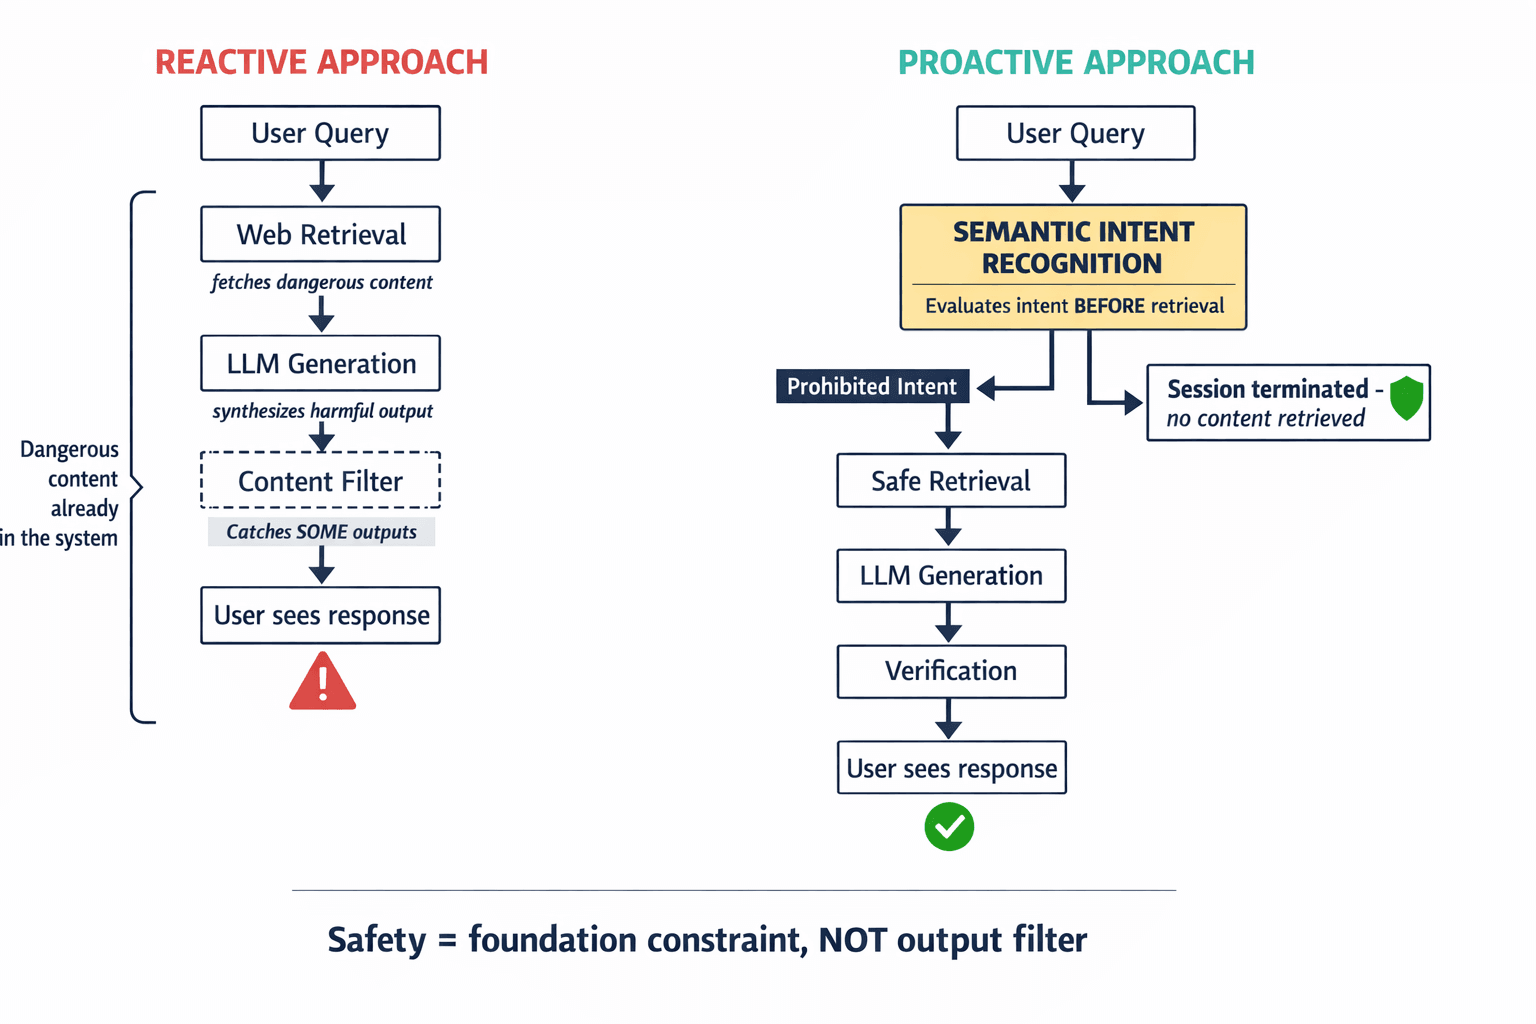
Ich möchte auf das Sicherheitsversagen zurückkommen, weil ich denke, dass es etwas Wichtiges darüber offenbart, wie die Branche über KI-Risiken nachdenkt.
Nach dem Vorfall konzentrierte sich die Diskussion auf bessere Content-Filter. Stärkere Keyword-Blockaden. Aggressiveres Sicherheits-Fine-Tuning. All dies sind reaktive Maßnahmen – sie versuchen, gefährliche Ausgaben abzufangen, nachdem das Modell sie bereits generiert hat.
Unser Ansatz ist anders. Wir implementieren das, was ich als semantische Absichtserkennung (Semantic Intent Recognition) bezeichne, auf der Eingabestufe. Bevor die Retrieval-Schicht überhaupt das Web durchsucht, bewertet ein Sicherheitsagent die semantische Absicht der Abfrage. Wenn die Absicht einer verbotenen Kategorie zugeordnet wird – Waffensynthese, Selbstverletzung, illegale Aktivitäten –, wird die Sitzung beendet, bevor irgendwelche Inhalte abgerufen werden.
Das ist von Bedeutung, weil der Rufus-Vorfall keinen Jailbreak erforderte. Der Nutzer stellte eine normal klingende Produktfrage. Das Retrieval-System, das pflichtbewusst das offene Web durchsuchte, rief Inhalte ab, die zufällig gefährliche Anweisungen enthielten. Das Modell, das pflichtbewusst abgerufene Inhalte synthetisierte, präsentierte diese Anweisungen dem Nutzer. Jede Komponente tat genau das, wofür sie konzipiert war. Das Design war das Problem.
Sicherheit ist kein Filter, den man am Ende hinzufügt. Sie ist eine Randbedingung, die man im Fundament verankert. Wenn Ihre KI gefährliche Inhalte abrufen kann, wird sie irgendwann auch gefährliche Inhalte ausliefern.
Die unbequeme Rechnung
Amazons CEO prognostizierte 10 Milliarden Dollar an zusätzlichem Umsatz durch Rufus. Diese Zahl hängt vollständig von dem ab, was ich Konversionsvertrauen (Conversion Confidence) nenne – die Wahrscheinlichkeit, dass ein Kunde den Empfehlungen der KI so weit vertraut, dass er auf „Kaufen“ klickt. Jede Halluzination, jede fehlgeschlagene Rücksendung, jede dialektbedingte Nicht-Antwort untergräbt dieses Vertrauen.
Der Wrapper-Ansatz ist im Vorfeld billiger. Ich will nichts vormachen. Einen LLM-Wrapper kann man in wenigen Wochen ausliefern. Unsere Architektur braucht Monate. Phase eins ist ein Daten-Audit – das Bereinigen interner Datensätze, das Schaffen von Ground Truth für Produkte und Richtlinien. Phase zwei ist die Bereitstellung der Multi-Agenten-Infrastruktur und des Wissensgraphen. Phase drei ist das Feedback-Schwungrad, bei dem menschlicher Input aus Kundenserviceteams die Genauigkeit der Agenten kontinuierlich verbessert.
Aber hier ist die Rechnung, auf die es ankommt: Für einen großen Einzelhändler übersteigen die Reputationskosten einer einzigen Schlagzeile wie „KI wies Kunden an, eine Waffe zu bauen“ das gesamte Budget eines ordnungsgemäß entwickelten Systems. Die 45 % der Verbraucher, die KI-Assistenten bereits misstrauen, lassen sich nicht durch schnellere Antwortzeiten zurückgewinnen. Sie lassen sich durch Systeme zurückgewinnen, die korrekt sind.
Die Ära des Wrappers ist vorbei
Ich habe die letzten zwei Jahre damit verbracht, Unternehmen dabei zuzusehen, wie sie denselben Fehler im Schnelldurchlauf wiederholten. Sie sehen die Demo, sind von der Sprachgewandtheit geblendet, liefern den Wrapper aus und verbringen das nächste Jahr damit, sich für die Ausgaben zu entschuldigen. Das Basismodell – ob GPT-4, Gemini, Claude oder was auch immer als Nächstes kommt – war nie das Differenzierungsmerkmal. Die umgebende Architektur war es schon immer.
Ein Sprachmodell ist eine Dampfmaschine. Immens leistungsfähig, in der Lage, Branchen zu transformieren. Aber eine Dampfmaschine ohne Kolben, Ventile und Regler ist nur eine Explosion, die darauf wartet zu passieren. Das Engineering, das diese Kraft kanalisiert und zähmt – die Verifizierungsschichten, die Wissensgraphen, die Agenten-Orchestrierung, die transaktionale Integrität –, genau das unterscheidet eine Demo von einem Produkt.
Die Unternehmen, die das verstehen, werden den Wert schöpfen. Die Unternehmen, die Modelle weiterhin in Prompts hüllen und beten, werden weiterhin für Schlagzeilen sorgen. Ich weiß, auf welcher Seite dieser Kluft ich baue.