Eine automatisierte Kamera verfolgte ein ganzes Fußballspiel lang einen kahlen Kopf. Ich baute das Physik-Gate, das Nein sagt.

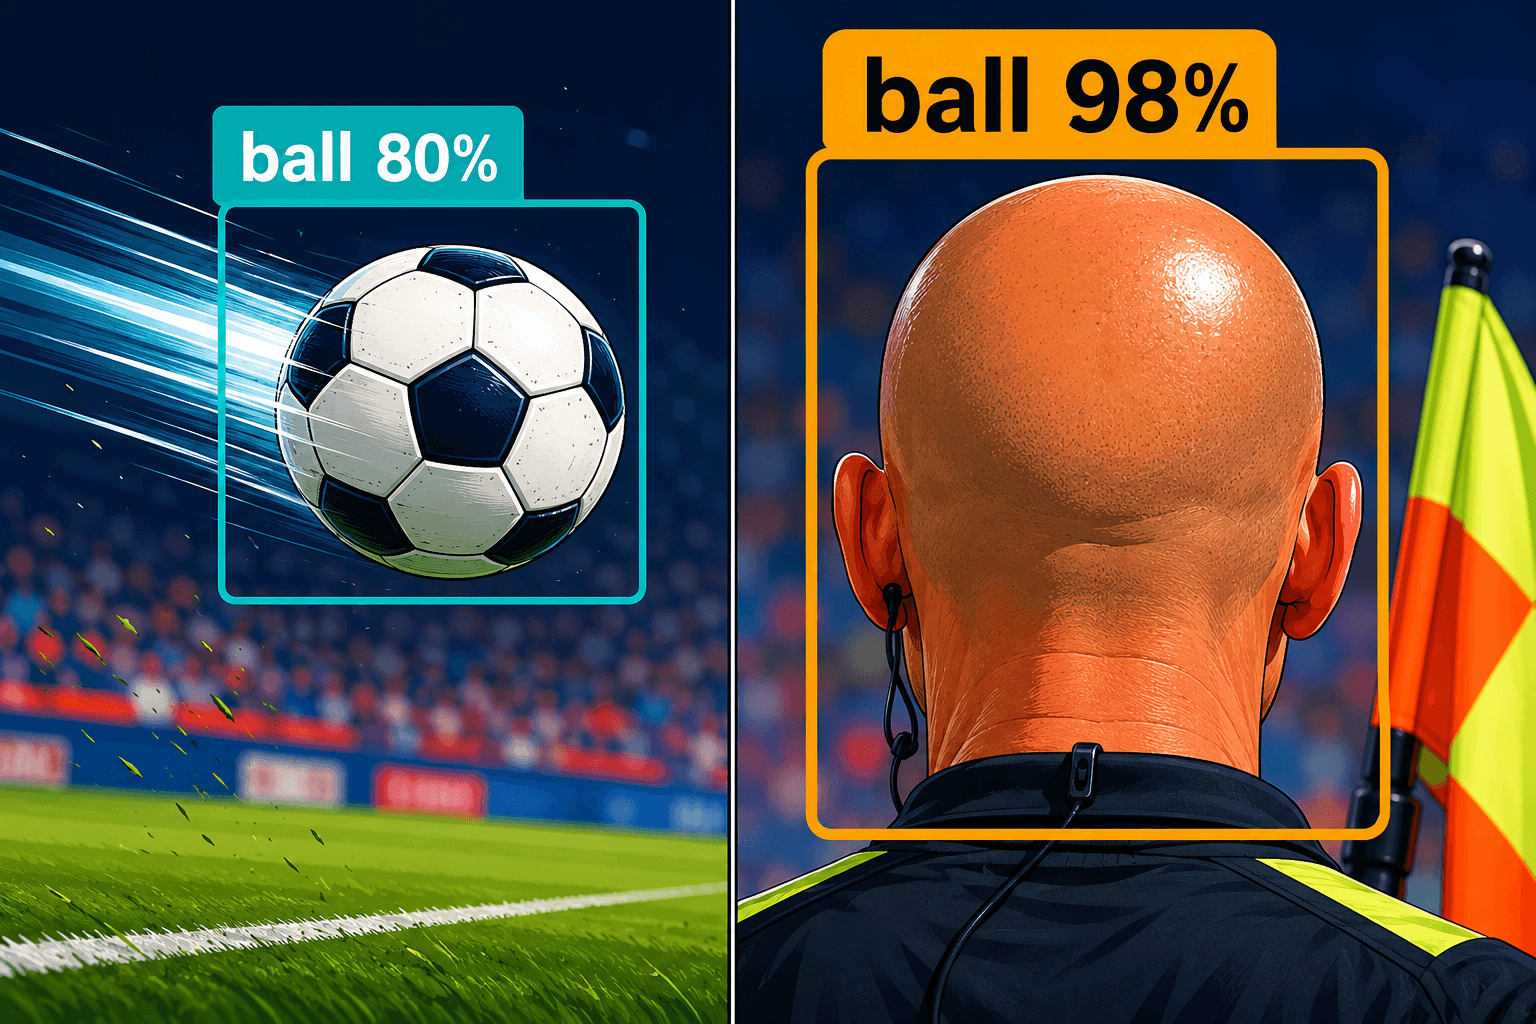
Im Oktober 2020 verbrachte eine automatisierte Kamera bei Inverness Caledonian Thistle einen Großteil eines Fußballspiels damit, den kahlen Kopf eines Linienrichters statt des Balls zu verfolgen. Unter dem Flutlicht glänzte der Kopf wie ein Ball, die Pixellot-Kamera folgte der Erkennung mit der höchsten ihr übergebenen Konfidenz, und die Zuschauer zu Hause bekamen eine lange, ausdauernde Nahaufnahme eines Mannes mit Glatze zu sehen, der an der Seitenlinie joggte, während das Spiel außerhalb des Bildausschnitts stattfand (dokumentiert auf unserer WP43-Lösungsseite).
Diese Geschichte begleitete mich während dieser gesamten Entwicklung, denn sie ist das klarste Bild, das ich von einem Fehler kenne, den jeder in der Computer Vision schon erlebt hat und den fast niemand korrekt benennt. Der Detektor war nicht kaputt. Er tat genau das, was ein Detektor tut. Er bewertete einen Bereich von Pixeln, der Glanz auf dem Kopf erzielte eine hohe Punktzahl, und jedes nachgelagerte System vertraute diesem Score. Plumbline, die von mir entwickelte Demo, ist zu finden unter https://veriprajna.com/demos/physics-constrained-computer-vision, und alles daran ist ein einziges Argument: Die Lösung liegt nicht im Detektor.
Der Moment, in dem ich aufhörte, dem Modell die Schuld zu geben
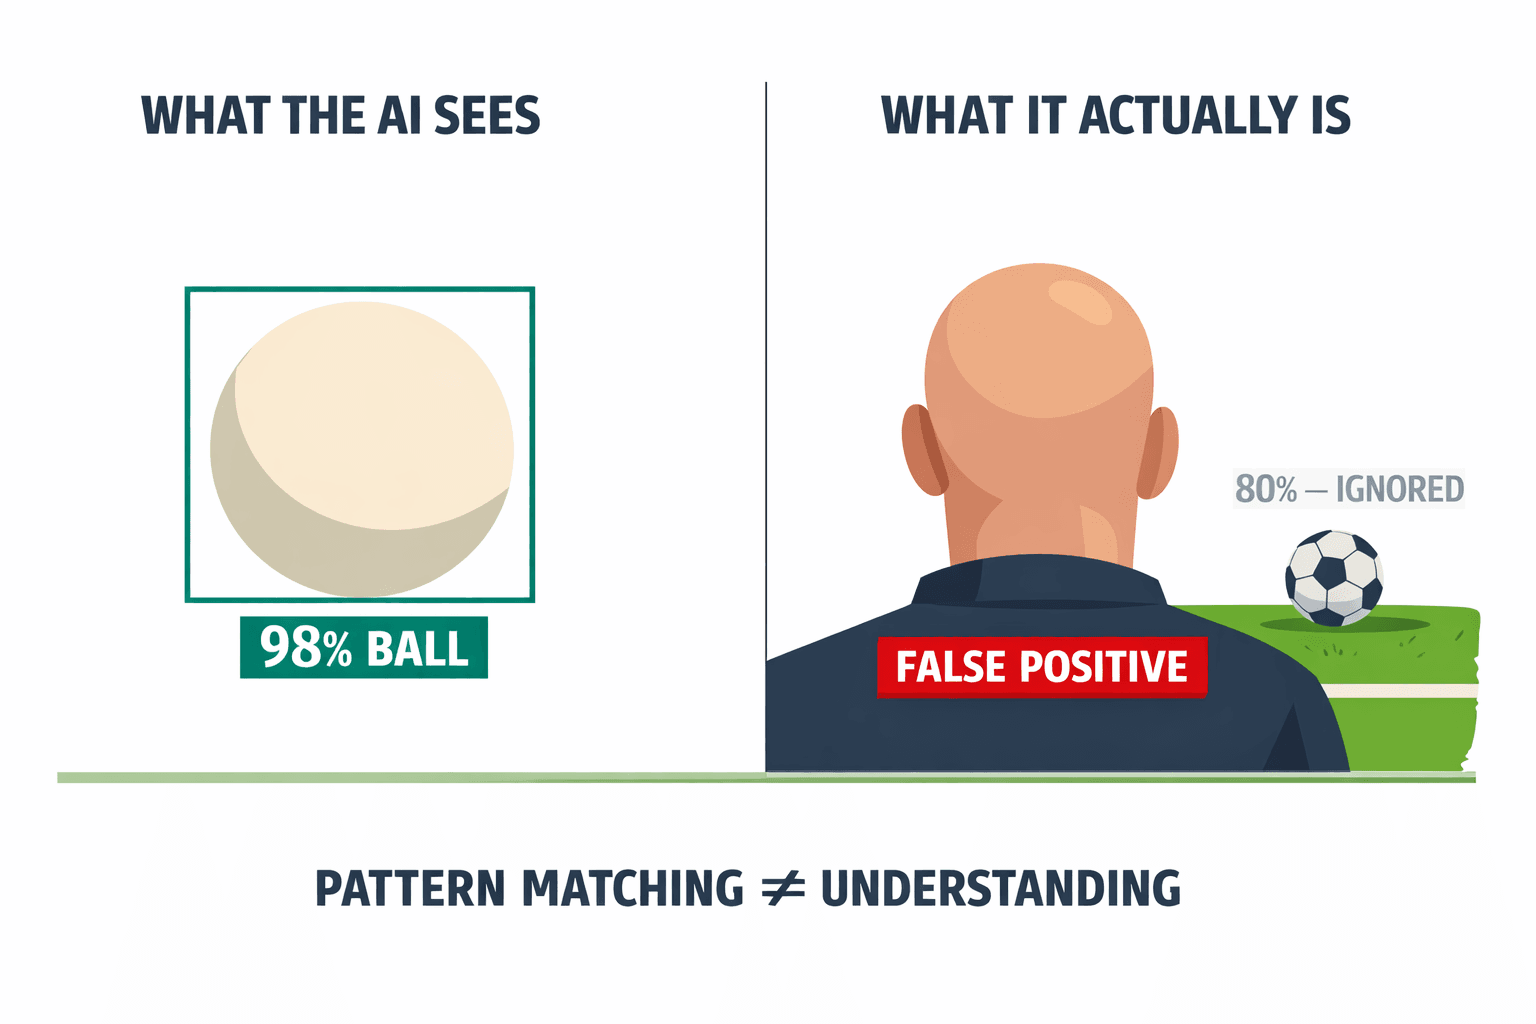
Ich verbrachte den ersten Tag damit, mir einen besseren Detektor vorzustellen, und konnte das Problem einfach nicht beseitigen. Ein Objektdetektor arbeitet bildunabhängig. Er bewertet jedes Bild nach Textur und Form, ohne jede Erinnerung daran, wo sich ein reales Objekt vor einem Moment befand oder wo es sich als Nächstes physikalisch befinden kann. Unter Flutlicht ist ein kahler Kopf also lokal ein exzellenter Ball. Man kann ein schärferes Modell trainieren, und es wird einem in dem Einzelbild, in dem der Glanz seinen Höhepunkt erreicht, immer noch einen Ball mit 98 % Konfidenz auf dem Kopf eines Mannes präsentieren. Die Konfidenz lügt nicht über die Pixel. Sie beantwortet eine Frage, die überhaupt nichts damit zu tun hat, ob dort ein Ball sein kann.
In diesem Moment änderte sich für mich der Blickwinkel grundlegend.
Ihr Vision-System hat kein Konfidenzproblem. Es hat ein Physikproblem.
Ein echter Ball unterliegt physikalischen Bedingungen, die für einen kahlen Kopf nicht gelten, und keine dieser Bedingungen steckt im Score des Detektors. Dieses eine Umdenken entschied über die gesamte Architektur. Ich hörte auf zu versuchen, den Detektor klüger zu machen, und begann, eine Schicht zu bauen, die hinter ihm ansetzt und die Physik durchsetzt, von der der Detektor nie etwas wusste.
Wie „physikalisch unmöglich“ im Code aussieht
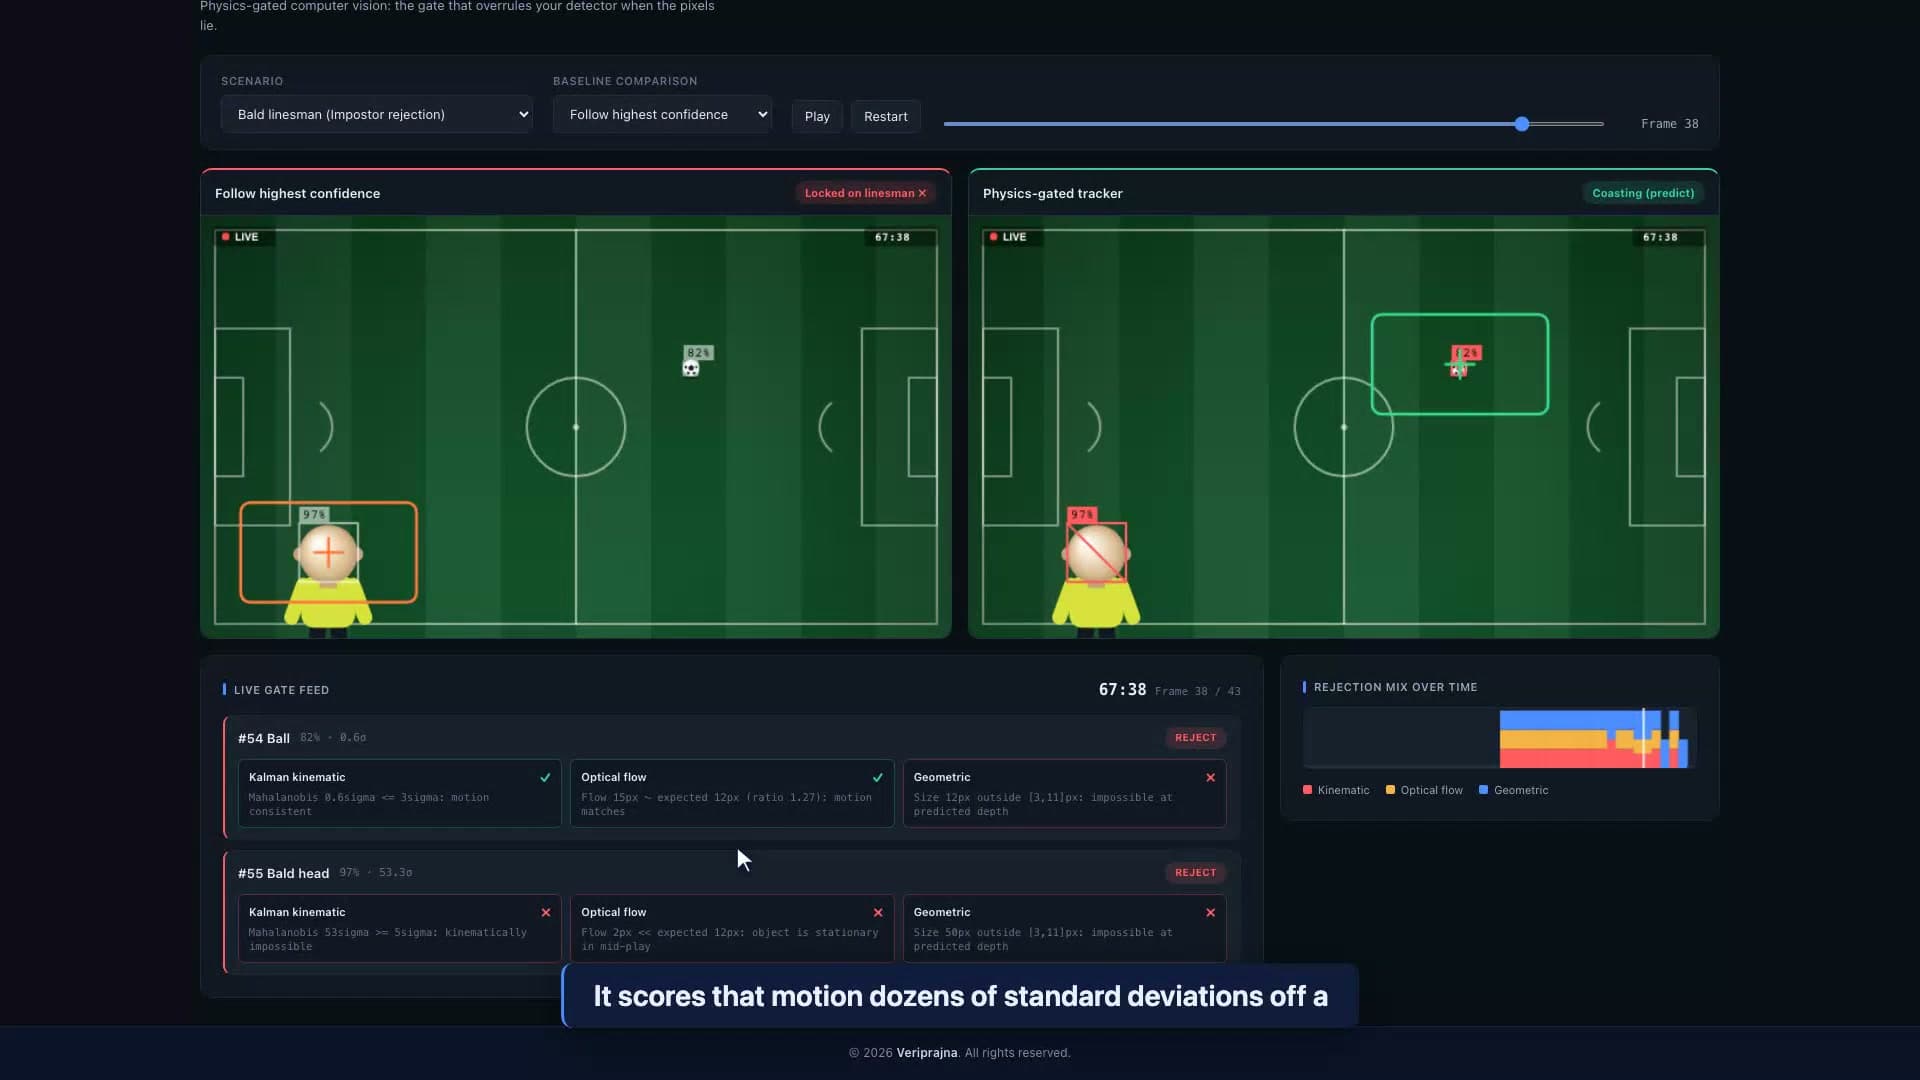
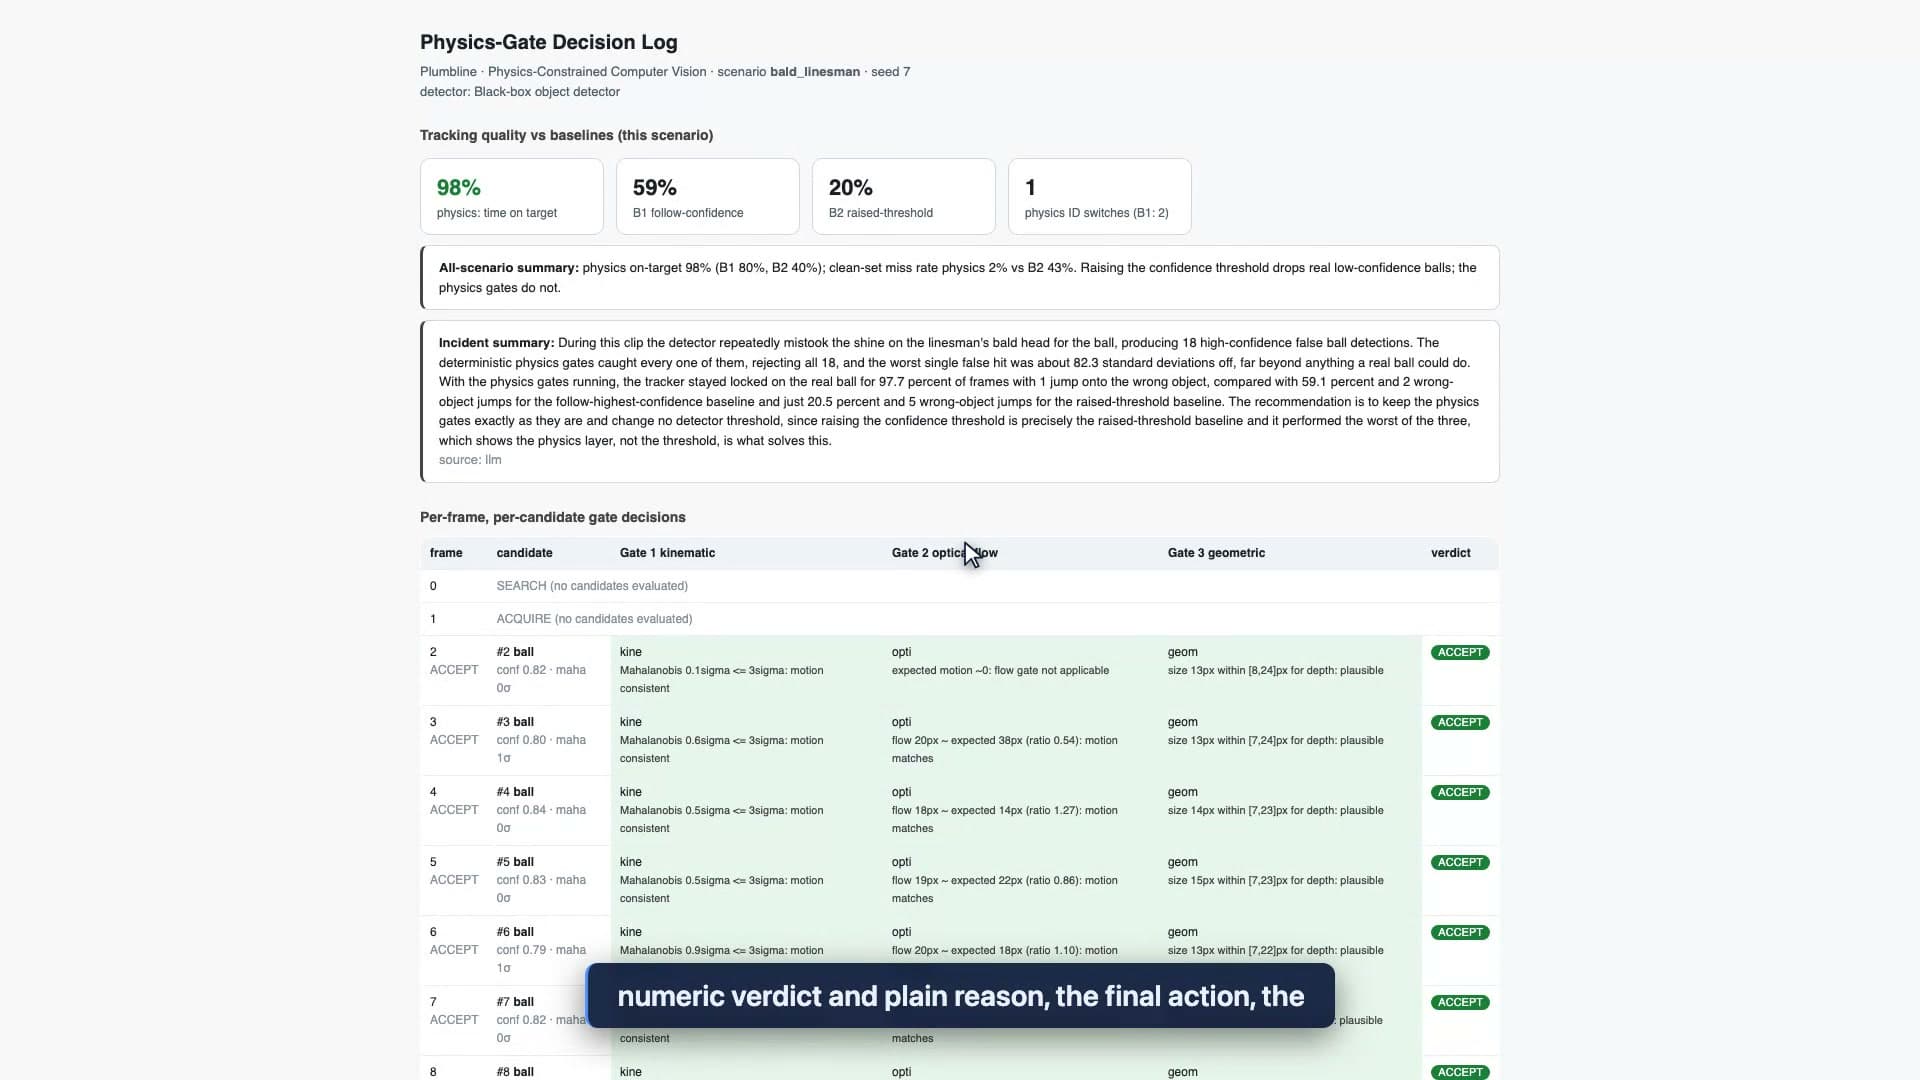
Ich wollte miterleben, wie eine Erkennung aus einem Grund abgewiesen wird, den ich in klarer Sprache lesen kann; also baute ich genau das zuerst. Plumbline sitzt jedem Detektor nachgelagert und wendet drei deterministische Gates auf jeden Kandidaten an, bevor irgendein System darauf reagiert. Das kinematische Gate nutzt ein Kalman-Filter – auf dem synthetischen Pfad ein Unscented Kalman Filter mit einem Modell für ballistische Flugbahnen –, um vorherzusagen, wo sich ein echter Ball als Nächstes befinden kann, und misst dann als Mahalanobis-Distanz, wie weit jeder Kandidat von dieser Vorhersage abweicht: Akzeptanz unter 3 Sigma, Ablehnung ab 5 Sigma, Markierung des Bereichs von 3 bis 5 Sigma zur Überprüfung. Das Optical-Flow-Gate vergleicht die lokale Pixelbewegung eines Kandidaten mit der erwarteten Geschwindigkeit der Trajektorie und weist einen „Ball“ ab, dessen Fluss in die falsche Richtung zeigt oder sich im offenen Spiel kaum bewegt. Das geometrische Gate nutzt ein Lochkameramodell, um zu ermitteln, wie viele Pixel ein 22-cm-Ball bei der implizierten Tiefe des Kandidaten einnehmen kann, und sortiert Größen aus, die nicht real sein können.
Nichts davon ist ein Modell. Es ist einfaches numpy und scipy, das man Zeile für Zeile lesen kann und das außerhalb jedes Netzes liegt – genau das ist der Grund, warum ich ihnen vertraue. Vertrauen hängt hier nicht davon ab, dass eine Blackbox sich nachträglich rechtfertigt.
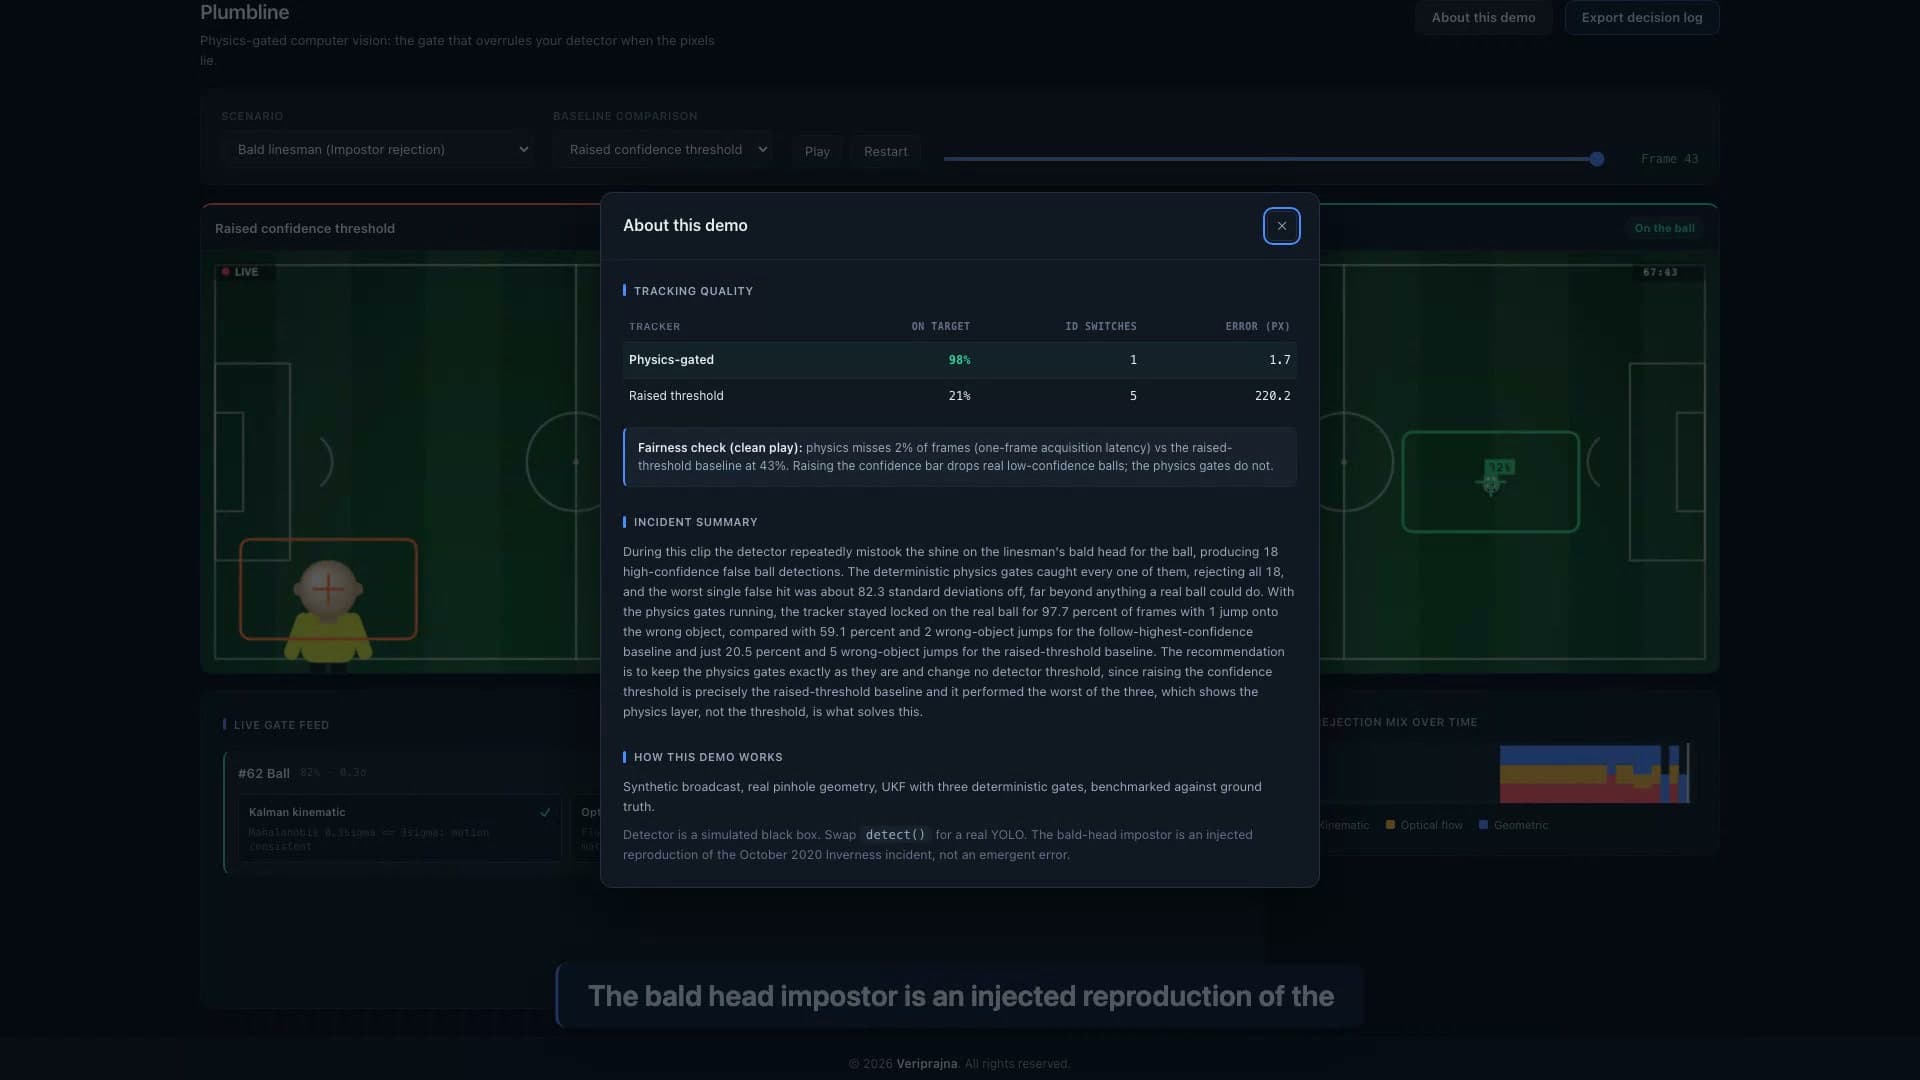
Der kahle Kopf scheitert an allen drei Gates gleichzeitig. Ich habe diesen Störfaktor ganz bewusst injiziert – als Nachbildung des Vorfalls von Inverness aus dem Jahr 2020 und nicht als zufälligen organischen Fehler –, denn der Fall, an dem eine Kamera scheitert, ist genau jener, der niemals im Testdatensatz eines Detektors auftaucht. Im schlechtesten Einzelbild des synthetischen Clips weicht der Kopf um 82.3 Sigma von der vorhergesagten Bewegung des Balls ab; das ist keine knappe Entscheidung, sondern kinematisch absurd. Der echte Ball, der bei einer Konfidenz von 0.87 und 0.4 Sigma liegt, passiert das Gate problemlos, und die Kamera bleibt auf ihm.
Jede Ablehnung hinterlässt eine dokumentierte Begründung
Ich wollte nicht, dass man hier irgendetwas auf Treu und Glauben hinnehmen muss, daher schreibt jede Entscheidung einen Datensatz, den man öffnen kann. Das exportierte Entscheidungsprotokoll enthält oben den Seed, das Szenario, die Detektor-ID und die Gate-Schwellenwerte, gefolgt von einer Zeile pro Einzelbild und Kandidat: die vom Detektor ausgegebene Klasse und Konfidenz, das numerische Urteil jedes Gates und seine klar verständliche Begründung („Mahalanobis 82 sigma >= 5 sigma: kinematically impossible“) sowie die finale Aktion. Im Szenario mit dem Linienrichter mit Glatze weisen die Gates alle 18 hochkonfidenten Fehlerkennungen des Täuschers ab, und der Physik-Tracker hält den Ball 97.7 % der Zeit, verglichen mit 59.1 % beim Verfolgen der höchsten Konfidenz und 20.5 % bei einem erhöhten Schwellenwert (synthetische Szene, Seed 7).
Für jeden, der die Haftung für eine automatisierte visuelle Entscheidung trägt, ist dieser Datensatz der Unterschied zwischen einem Vorfallsbericht und einem Achselzucken. Er ist als ablegbarer Nachweis dafür konzipiert, warum eine Kamera tat, was sie tat – kein Compliance-Zertifikat, sondern einfach die physikalische Begründung, protokolliert, Einzelbild für Einzelbild.
Den Konfidenz-Schwellenwert anzuheben, ist der falsche Hebel
Wenn ich Ingenieuren die Abweisung des kahlen Kopfes zeige, ist der erste Instinkt fast immer derselbe: Heben Sie einfach den Konfidenz-Schwellenwert an, bis der falsche Ball herausfällt. Ich habe die Demo gebaut, um diesem Instinkt mit Zahlen zu begegnen, weil er sich richtig anfühlt, aber falsch ist. In der sauberen synthetischen Szene ganz ohne Täuschungselement verwirft das Anheben des Schwellenwerts 43.2 % der echten Bälle mit niedriger Konfidenz, während die Physik-Gates ihre Fehlerrate im sauberen Datensatz bei 2.3 % halten – was lediglich einer Erfassungslatenz von einem einzelnen Einzelbild entspricht statt eines verlorenen Balls. Der Schwellenwert tauscht ein False Positive gegen einen Haufen False Negatives ein.
Die Physik-Gates arbeiten auf einer völlig anderen Achse. Sie können die unmögliche Erkennung abweisen, ohne die schwache echte Erkennung zu verwerfen, denn was sie prüfen (kann sich ein Ball hier befinden, sich so bewegen, bei dieser Größe?), hat nichts damit zu tun, wie laut der Detektor votiert hat. Diese Orthogonalität wollte ich mit dem Test an der sauberen Szene unbestreitbar machen.
Es gibt eine kleinere Feinheit, die mir beim Testen besonders ans Herz gewachsen ist: der Fall einer Verdeckung. Ein Spieler kreuzt für ein Dutzend Einzelbilder vor dem Ball, jeder Kandidat wird abgewiesen, und statt sich an den Spieler zu hängen, überbrückt der Physik-Tracker die Lücke anhand seiner eigenen Vorhersage und erfasst den Ball erneut, sobald er wieder auftaucht. Zu beobachten, wie er lieber eine leere Spur hält, als eine falsche vorzutäuschen, war der Moment, in dem sich diese Schicht zum ersten Mal weniger wie ein Filter und mehr wie Urteilsvermögen anfühlte.
Die Zahl, die ich fast nicht gezeigt hätte
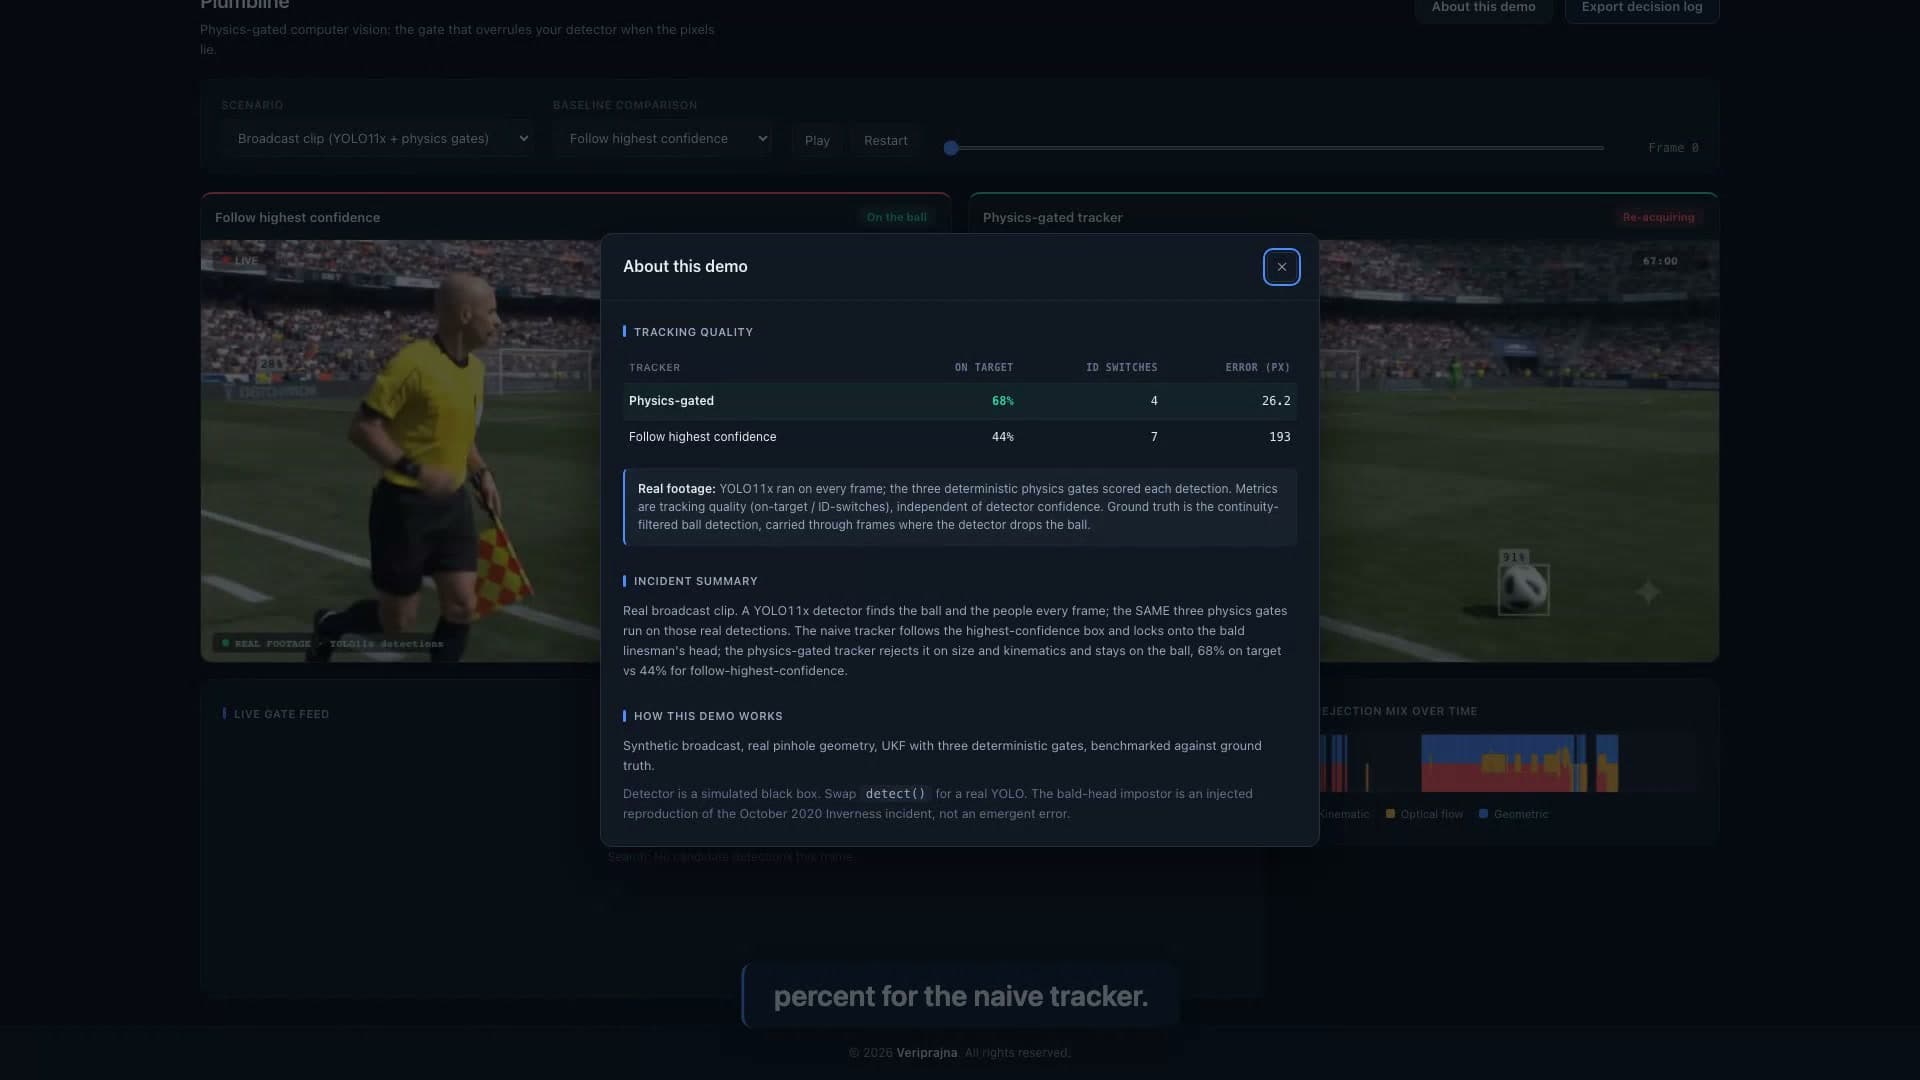
Ich hätte den Durchlauf mit echtem Videomaterial fast gestrichen, und ihn beizubehalten, ist die Entscheidung, auf die ich bei dieser gesamten Entwicklung am stolzesten bin. Alles oben Genannte läuft auf einer synthetischen Szene mit bekannter Ground Truth ab, was einen sauberen Benchmark erst ermöglicht – doch einem synthetischen Sieg misstraut man leicht. Also nahm ich einen echten Broadcast-Clip, ließ echte YOLO11x-Erkennungen Bild für Bild darüberlaufen, injizierte den Kopf des Linienrichters aus der tatsächlichen Personenerkennung als falschen Ball und führte dieselben drei Gates unverändert aus. Zwei ehrliche Kompromisse folgten: Ein einzelner, unkalibrierter Broadcast-Clip besitzt keine metrische Tiefe, daher läuft das kinematische Gate dort in der Bildebene als 2D-Kalman-Filter statt im dreidimensionalen Weltraum – und ein 3D-Filter wäre eine Täuschung gewesen. Und der Wert sank. Auf dem echten Clip halten die Physik-Gates den Ball 68.3 % der Zeit, gegenüber 43.8 % beim Verfolgen der höchsten Konfidenz und 30.0 % beim erhöhten Schwellenwert.
Ich haderte eine Weile mit den 68.3 %, denn 97.7 % ist die Zahl, die sich verkauft, und 68.3 % ist die Zahl, die bei schwierigem Videomaterial der Wahrheit entspricht. Ich behielt die ehrliche Zahl auf der Anzeigetafel, direkt in der App, wo jeder sie einsehen kann. Eine Verifikationsschicht, die sich selbst überverkauft, hat bereits bei der einen Aufgabe versagt, die sie erfüllen soll. Was den Ausschlag gibt, ist die Richtung: Derselbe Gate-Code, vollkommen unverändert, schlägt beide Baselines sowohl bei realen als auch bei simulierten Erkennungen – und er benennt seine eigenen Grenzen offen.
Wofür dies in Wahrheit das Fundament bildet
Ich hatte nicht vor, ein Fußballprodukt zu bauen, und ich möchte genau differenzieren, was diese Demo ist und was nicht. Es ist kein Anspruch darauf, dass wir jedes kommerzielle Kamerasystem beim Tracking übertreffen, da die spätere Firmware von Pixellot den Fall mit dem Glatzkopf bereits beherrscht – und der Detektor ist nicht das Produkt. Das Produkt ist die schlanke, überprüfbare Schicht zwischen einem Detektor und dem System, das auf dessen Ausgabe reagiert. Diese Metriken messen die Tracking-Qualität, nicht die Fehlerrate des Detektors; deshalb bleibt der Mehrwert bestehen, ganz gleich, wie gut der zugrunde liegende Detektor wird.
Diese Schicht ist heute wichtiger als zu Beginn meiner Arbeit. Computer Vision wird agentisch – mit Systemen, die ein Bild nicht mehr nur klassifizieren, sondern darauf basierend handeln –, und die unbeantwortete Governance-Frage hinter all diesen Systemen lautet, wie man einen autonomen Agenten daran hindert, auf der Grundlage einer physikalisch unmöglichen Erkennung zu agieren. SoccerNet bezeichnet Multi-Objekt-Tracking nach wie vor als „bei Weitem ungelöst“, und bisher ist keine physikbewusste Methode in dessen Benchmarks integriert. Der kahle Kopf war für mich nie der interessante Teil. Das Spannende ist vielmehr, dass die Bedingung, die ihn entlarvt – dass ein reales Objekt den Gesetzen der Physik gehorchen muss –, auch gegenüber einem perfekten Detektor der Zukunft Bestand hat. Denn ein Ball, der auf konstanter Höhe schwebt und sich mit drei Meilen pro Stunde bewegt, ist bei jeder Konfidenz falsch. Wenn Sie sehen möchten, wie eine Erkennung verworfen wird, und die exakte Begründung dafür lesen wollen: Die Demo befindet sich unter https://veriprajna.com/demos/physics-constrained-computer-vision, wo der reale Clip und die synthetischen Szenen nebeneinander laufen.
Und falls Sie es lieber sehen möchten, statt sich auf mein Wort zu verlassen: Hier läuft das Ganze durchgängig von Anfang bis Ende – der reale Clip und die synthetischen Szenen Seite an Seite.
Die Kamera folgte einem kahlen Kopf, weil ihr niemand gesagt hatte, was ein Ball tun kann. Alles, was ich gebaut habe, ist genau diese Anweisung – niedergeschrieben dort, wo Sie sie überprüfen können.