Eine geringere Risikoschätzung für Firmware ist keine Freigabeerlaubnis

Ein Firmware-Hotfix kann eine Risikoschätzung dramatisch verbessern und ein Release dennoch nach der deklarierten Richtlinie inakzeptabel lassen. Für ein Entwicklungsteam, das entscheidet, ob eine Zählerflotte aktualisiert werden soll, sind dies unterschiedliche Beurteilungen. Die Verbesserung sagt etwas über den Kandidaten aus. Die Erlaubnis hängt vom verbleibenden Risiko, der bewerteten Population und den Belegen hinter der Schätzung ab.
Ich habe MeterGuard so konzipiert, dass diese Urteile sichtbar bleiben. Es handelt sich um eine Pre-Flight-Demo für Firmware-Rollouts mit synthetischen Zählerpopulationen und synthetischen Firmware-Manifesten. Sie schätzt das Verhalten anhand eines Changelogs, modelliert dieses Verhalten im Abgleich mit dem Zustand der Flotte und gibt eine lokale Empfehlung ab. Sie sendet keine Firmware an Zähler und blockiert kein tatsächliches Update. Die relevante Frage ist, was dieser Trennungsansatz einem Release-Verantwortlichen zu prüfen erlaubt und was er weiterhin nicht nachweisen kann.
Verbesserung und Akzeptanz beantworten unterschiedliche Fragen
Betrachten wir die synthetische Population mit der Bezeichnung Plano Water. Ein anfänglicher Kandidat erzeugt eine modellierte mittlere Ausfallrate von 74.22% der bewerteten Endpunkte. Ein Hotfix erzeugt 2.85%. Beide Ergebnisse nutzen zwischengespeicherte, modellgestützte Verhaltensprofile statt gemessenen Verhaltens aus Firmware-Binärdateien. Innerhalb dieser Annahmen ist der Hotfix eine erhebliche Verbesserung. Dieser Vergleich verdient es, festgehalten zu werden, selbst wenn die finale Empfehlung NO-GO bleibt.
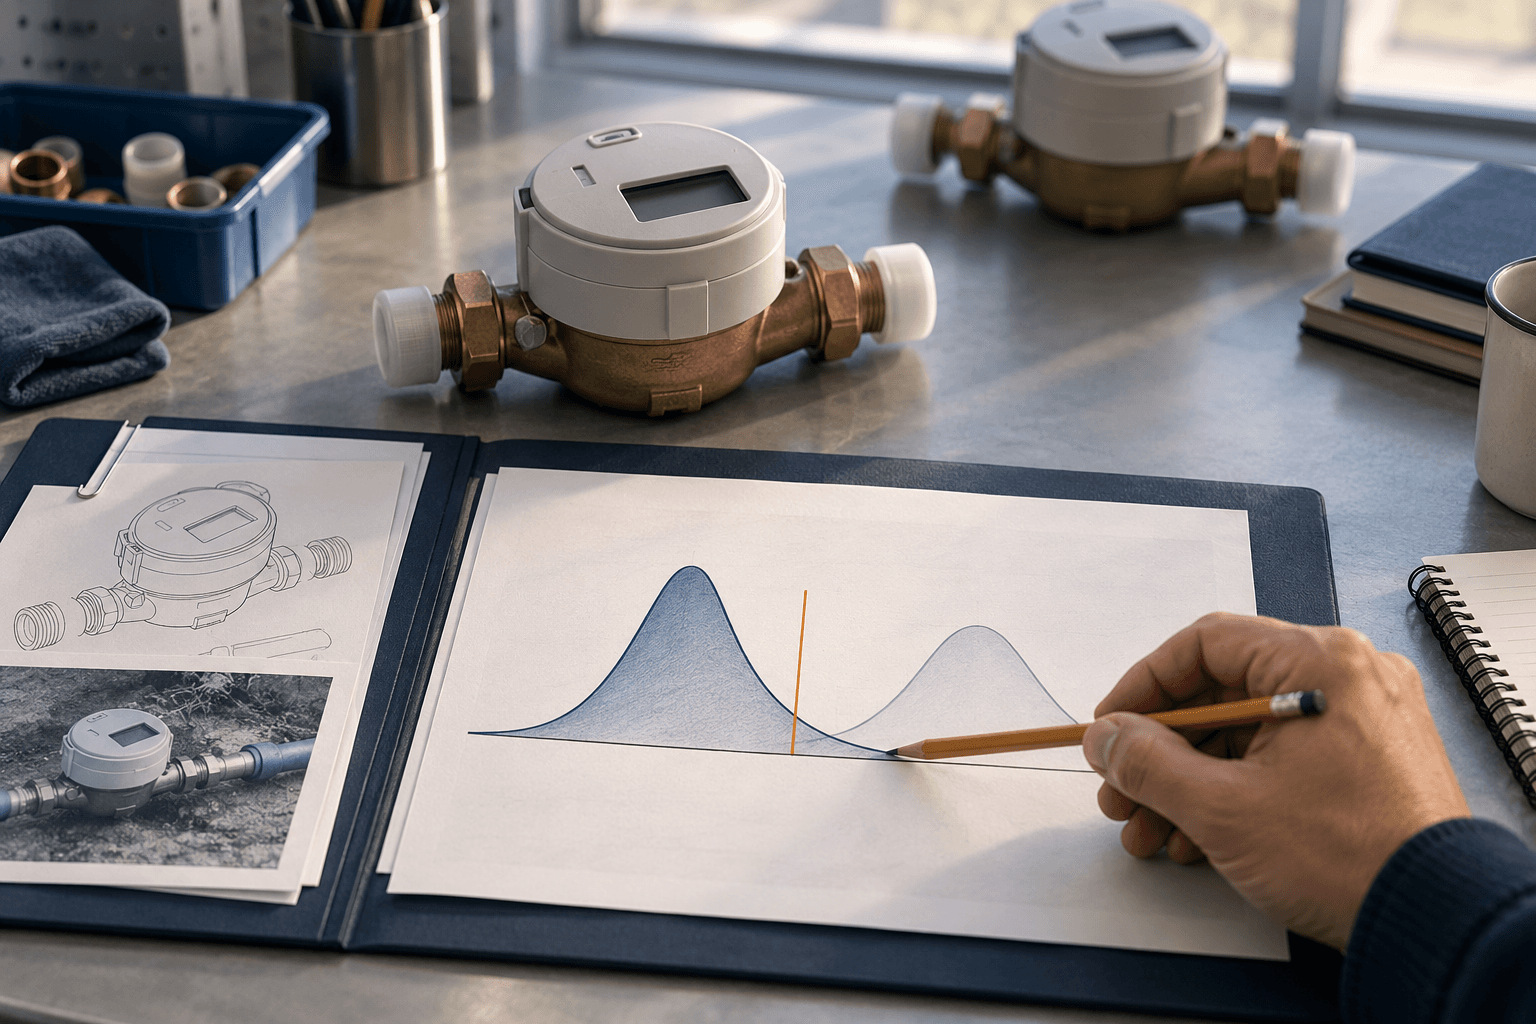
Das Release-Gate prüft zuerst das obere Ende des modellierten 90%-Intervalls. Ab 3.0% der bewerteten Endpunkte gibt es NO-GO zurück. Für den Hotfix liegt der Mittelwert bei 2,449 modellierten Ausfällen unter 86,078 bewerteten Endpunkten, mit einem Intervall von 1,536 bis 3,531. Die obere Rate liegt bei 4.10%, sodass die Hard-Block-Regel greift. Weiteren 1,922 Endpunkten fehlt ausreichende Telemetrie; sie sind von dieser Vorhersage ausgeschlossen, wobei eine manuelle Prüfung empfohlen wird.
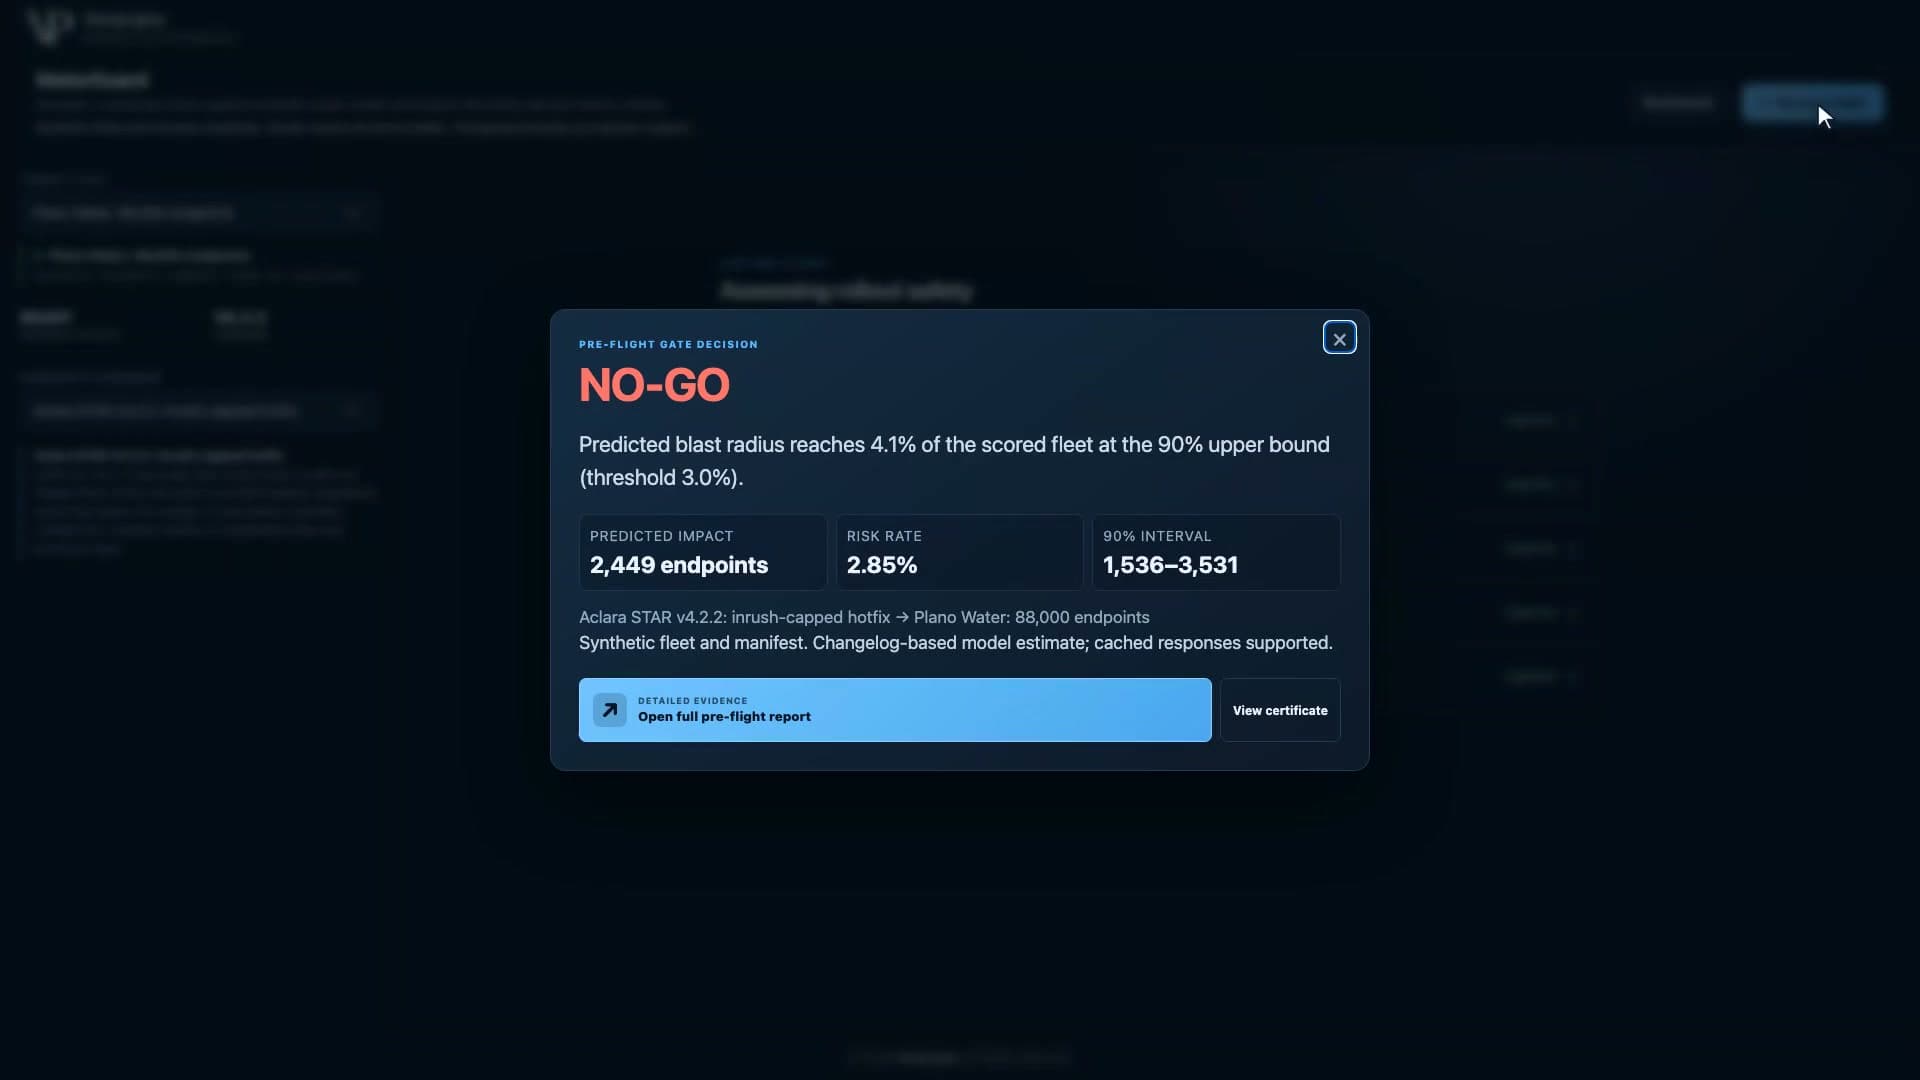
Eine reine Betrachtung des Mittelwerts würde übersehen, warum dies eine harte Blockade ist. Sie würde den Kandidaten auch nach dem Rest der Richtlinie nicht für GO qualifizieren: GO verlangt einen Mittelwert von höchstens 0.5%, nachdem die Obergrenzen- und Konfidenzprüfungen bestanden wurden. Ein mittleres numerisches Risiko führt zu STAGED-CANARY. Diese Unterscheidung ist wichtig, weil „besser“, „geeignet für einen begrenzten Schritt zur Beweiserhebung“ und „innerhalb der GO-Regel“ nicht zu einem einzigen beruhigenden Etikett verschmelzen sollten.
Ich ziehe es vor, die Verbesserung sichtbar zu halten, ohne zuzulassen, dass sie die Grenze neu verhandelt. Reagiert ein Team auf eine enttäuschende Empfehlung mit einer Lockerung des Schwellenwerts, hat es seine Akzeptanzrichtlinie geändert. Das mag in einem bestimmten Kontext eine vertretbare Entscheidung sein, aber es ist eine separate Entscheidung, die eigene Gründe erfordert. Der Nachweis, dass ein Kandidat besser ist als ein anderer, liefert diese Gründe nicht von selbst.
Diese Haltung hat ihren Preis. Eine konservative Grenze kann einen Kandidaten verzögern, der erfolgreich gewesen wäre. Das obere Ende eines modellierten Intervalls ist kein beobachtetes Praxisergebnis, und die Bezeichnung des Intervalls als „90%“ belegt nicht seine Abdeckung in einer Versorgerflotte. Diese Demo kann nicht bestimmen, welchen Schwellenwert ein echtes Versorgungsunternehmen wählen sollte. Was sie zeigen kann, ist, ob eine Empfehlung dem deklarierten Schwellenwert folgt, anstatt einem Schwellenwert, der stillschweigend angepasst wurde, um zum Ergebnis zu passen.
Die Erlaubnis gehört zu einem Kandidaten und einer Population
Dieselbe Verhaltensschätzung für den Hotfix liefert bei der generierten Population mit der Bezeichnung Hill Country Electric Co-op ein völlig anderes Ergebnis. Ihre modellierte mittlere Ausfallrate beträgt 0.02%, mit einer oberen Intervallrate von 0.03%, und das Gate gibt GO für 118,222 bewertete Endpunkte zurück. Die Population weist eine gesündere Batterielaufzeitverteilung und weniger schwache Funksignale auf als die synthetische Plano-Population. Ihre 1,778 ausgeschlossenen Endpunkte bleiben außerhalb dieser Empfehlung.
Dies ist ein Vergleich des geschätzten Schreibverhaltens über generierte Zustandsverteilungen hinweg. Er sagt nichts darüber aus, das Image eines Herstellers auf der Hardware eines anderen Herstellers zu installieren. Kompatibilität und aus Binärdateien abgeleitete Validierung sind separate Aufgaben, die die Demo nicht durchführt.
Der Vergleich verändert die Art und Weise, wie eine Release-Empfehlung formuliert sein sollte. „Diese Firmware ist risikoarm“ lässt den Geltungsbereich ungenannt. „Dieses geschätzte Verhalten erfüllt diese Richtlinie für diese bewertete Population“ wahrt die Bedingungen, unter denen das Ergebnis gilt. Batteriezustand und Funkwiederherstellung sind Eingaben für das modellierte Ergebnis, sodass ein günstiges Resultat nicht von ihnen gelöst und auf eine andere Flotte übertragen werden kann.
Für einen Release-Verantwortlichen eröffnet dies zwei unterschiedliche Wege, auf eine ungünstige Empfehlung zu reagieren. Der eine besteht darin, das Verhalten des Kandidaten oder die zu seiner Schätzung herangezogenen Belege zu verbessern. Der andere darin, eine engere Population in Betracht zu ziehen, deren Bedingungen eine andere Bewertung stützen. Sie adressieren unterschiedliche Probleme. Eine engere Bewertung kann die modellierte Exposition verringern, lässt jedoch den Rest der Population ungelöst. Bessere Belege über den Kandidaten können die Schätzung verbessern, fehlende Telemetriedaten der Flotte jedoch nicht herbeizaubern.
Diese Alternativen sind vorausschauende ingenieurtechnische Entscheidungen, keine Operationen, die diese Demo ausführt. Ihr Wert liegt darin, dass sie die Arbeit auf den Ursprung der Unsicherheit lenken. Das Urteil allein kann einem Team nicht sagen, ob es einen besseren Kandidaten, ein besseres Profil oder bessere Informationen über die Zielendpunkte benötigt. Die Eingaben und Ausschlüsse daneben können es.
Ein Code-Gate kann nicht validieren, was das Modell glaubt
MeterGuard hält die Richtlinie in einfachem Code fest. Das modellgestützte Governance-Memo folgt nach dem Urteil und besitzt keine direkte Befugnis, dieses zu überstimmen. Ich bestehe auf dieser Trennung, weil eine gewandte Erklärung nicht stillschweigend zu einer neuen Freigaberegel werden darf.
Das Modell übt früher im Workflow weiterhin erheblichen Einfluss aus. Sein Firmware-Profil schätzt Stromaufnahme, Wiederherstellung nach einem Reset und Flash-Schreibverhalten aus synthetischem Changelog-Text. Diese Schätzungen speisen den Simulator. Ein anderes Profil kann die modellierten Ausfälle verändern und somit das Urteil kippen, selbst wenn der Gate-Code unverändert bleibt. Eine überprüfbare Richtlinie legt fest, wie Eingaben beurteilt wurden; sie belegt nicht, dass die Eingaben korrekt waren.
Der Fall eines knappen Changelogs macht diese Unterscheidung sichtbar. Gegenüber derselben generierten Co-op-Population beträgt sein modellierter Mittelwert nur 0.05% und seine obere Rate 0.06%. Diese Zahlen unterschreiten die numerischen Grenzen. Das Profil weist dennoch eine geringe Konfidenz auf, sodass das Gate STAGED-CANARY statt GO empfiehlt. Spärliche Firmware-Belege werden als eigenständiger Grund behandelt, die umfassendere Empfehlung zurückzuhalten.
Das ist eine nützliche Schutzvorkehrung mit eigener Grenze. Das Konfidenzlabel eines Modells ist keine kalibrierte empirische Gewissheit. Die Anforderung eines nicht niedrigen Labels kann verhindern, dass eine erkannte Evidenzlücke ignoriert wird; sie kann ein „hohes“ Label jedoch nicht als zutreffend zertifizieren. Für den Produktiveinsatz müsste das Profil anhand tatsächlichen Firmware-Verhaltens und realer Ergebnisse validiert werden. Dies bleibt Arbeit außerhalb der synthetischen Demonstration.
Die sicherste Stichprobe hinterlässt eine schwierigere Frage
Die vorgeschlagene gestufte Route verwendet 500 Endpunkte aus der Kohorte mit dem geringsten modellierten Risiko, mit einer 72-stündigen Haltezeit und einer Neubewertung anhand beobachteter Telemetrie vor einer Ausweitung. Die Demo empfiehlt diesen Plan; sie hat keinen Canary-Rollout ausgeführt oder dessen Beobachtungen gesammelt. Das konfigurierte Kriterium für die Ausweitung ist eine beobachtete Ausfallrate von unter 0.1%.
Ich sehe einen echten Kompromiss darin, zuerst die sicherste Kohorte auszuwählen. Dies reduziert die für den ersten Schritt vorgeschlagene Exposition. Doch dieselbe Logik, die den Flottenzustand entscheidend machte, begrenzt auch, was dieser Schritt über Endpunkte in schlechterem Zustand aussagen kann. In einer hypothetischen Kampagne würde die Beobachtung eines erfolgreichen Updates bei gesunden Batterien und guten Funkverbindungen eine Aussage über diese getestete Stichprobe stützen. Sie würde offenlassen, wie sich der Kandidat bei gealterten Batterien oder schwachen Funkverbindungen verhält.
Es gibt mindestens zwei vertretbare Reaktionen auf diese Lücke. Ein Team könnte die Ausweitung auf Populationen beschränken, die der beobachteten Stichprobe hinreichend ähnlich sind, wodurch es eine langsamere Abdeckung in Kauf nimmt und degradierte Endpunkte ausstehend lässt. Oder es könnte Belege suchen, die gezielt auf die beeinträchtigten Bedingungen ausgerichtet sind, etwa eine kontrollierte Validierung des relevanten Batterie- und Wiederherstellungsverhaltens, bevor diese Endpunkte berücksichtigt werden. Der zweite Weg erfordert mehr Arbeit; der erste akzeptiert eine engere Schlussfolgerung. Keiner von beiden macht eine sichere Stichprobe per Deklaration repräsentativ.
Aus diesem Grund behandle ich STAGED-CANARY als Anforderung für spezifizierte Belege, nicht als weicheres Synonym für GO. Ein gestufter Plan muss darlegen, was seine Beobachtungen rechtfertigen und wo sie enden. Ohne diesen Geltungsbereich kann ein vorsichtig wirkender Prozess dennoch eine übermäßig weitreichende Schlussfolgerung ziehen.
Hier ist die Founder-Vorführung dieser Smart-Meter-Release-Entscheidungen in MeterGuard.
Das MeterGuard-Erklärvideo zeigt den Pre-Flight-Workflow und dessen Entscheidungsprotokolle. Meine Entwurfshaltung besteht darin, das geschätzte Verhalten, die bewertete Population, die Ausschlüsse und die deklarierte Regel neben der Empfehlung zu halten. Für einen Release-Verantwortlichen besteht der Test darin, ob der nächste vorgeschlagene Schritt die Unsicherheit auflöst, die den Stopp verursacht hat. Wenn er nur die einfachsten Bedingungen beobachtet, während die Entscheidung schwierigere betrifft, wartet die Grenze weiterhin auf Belege.