Was die bloße Existenz eines KI-Modells unbewiesen lässt

Ein Team kann eine Model Card erstellen und den entsprechenden Marketinganspruch dennoch unbeantwortet lassen. Die Dokumentation belegt unter Umständen, dass ein Modell existiert. Ein Satz, der das Unternehmen als „KI-gestützt“ beschreibt, geht eine weitergehende Verpflichtung hinsichtlich der Rolle des Modells im Arbeitsablauf ein. Ich möchte, dass die Prüfung dieses Satzes die operativen Aufzeichnungen einbezieht, bevor jemand die bloße Existenz der Technologie als ausreichenden Beleg wertet.
Offenlegung: Dieser Artikel wurde mithilfe generativer KI verfasst.
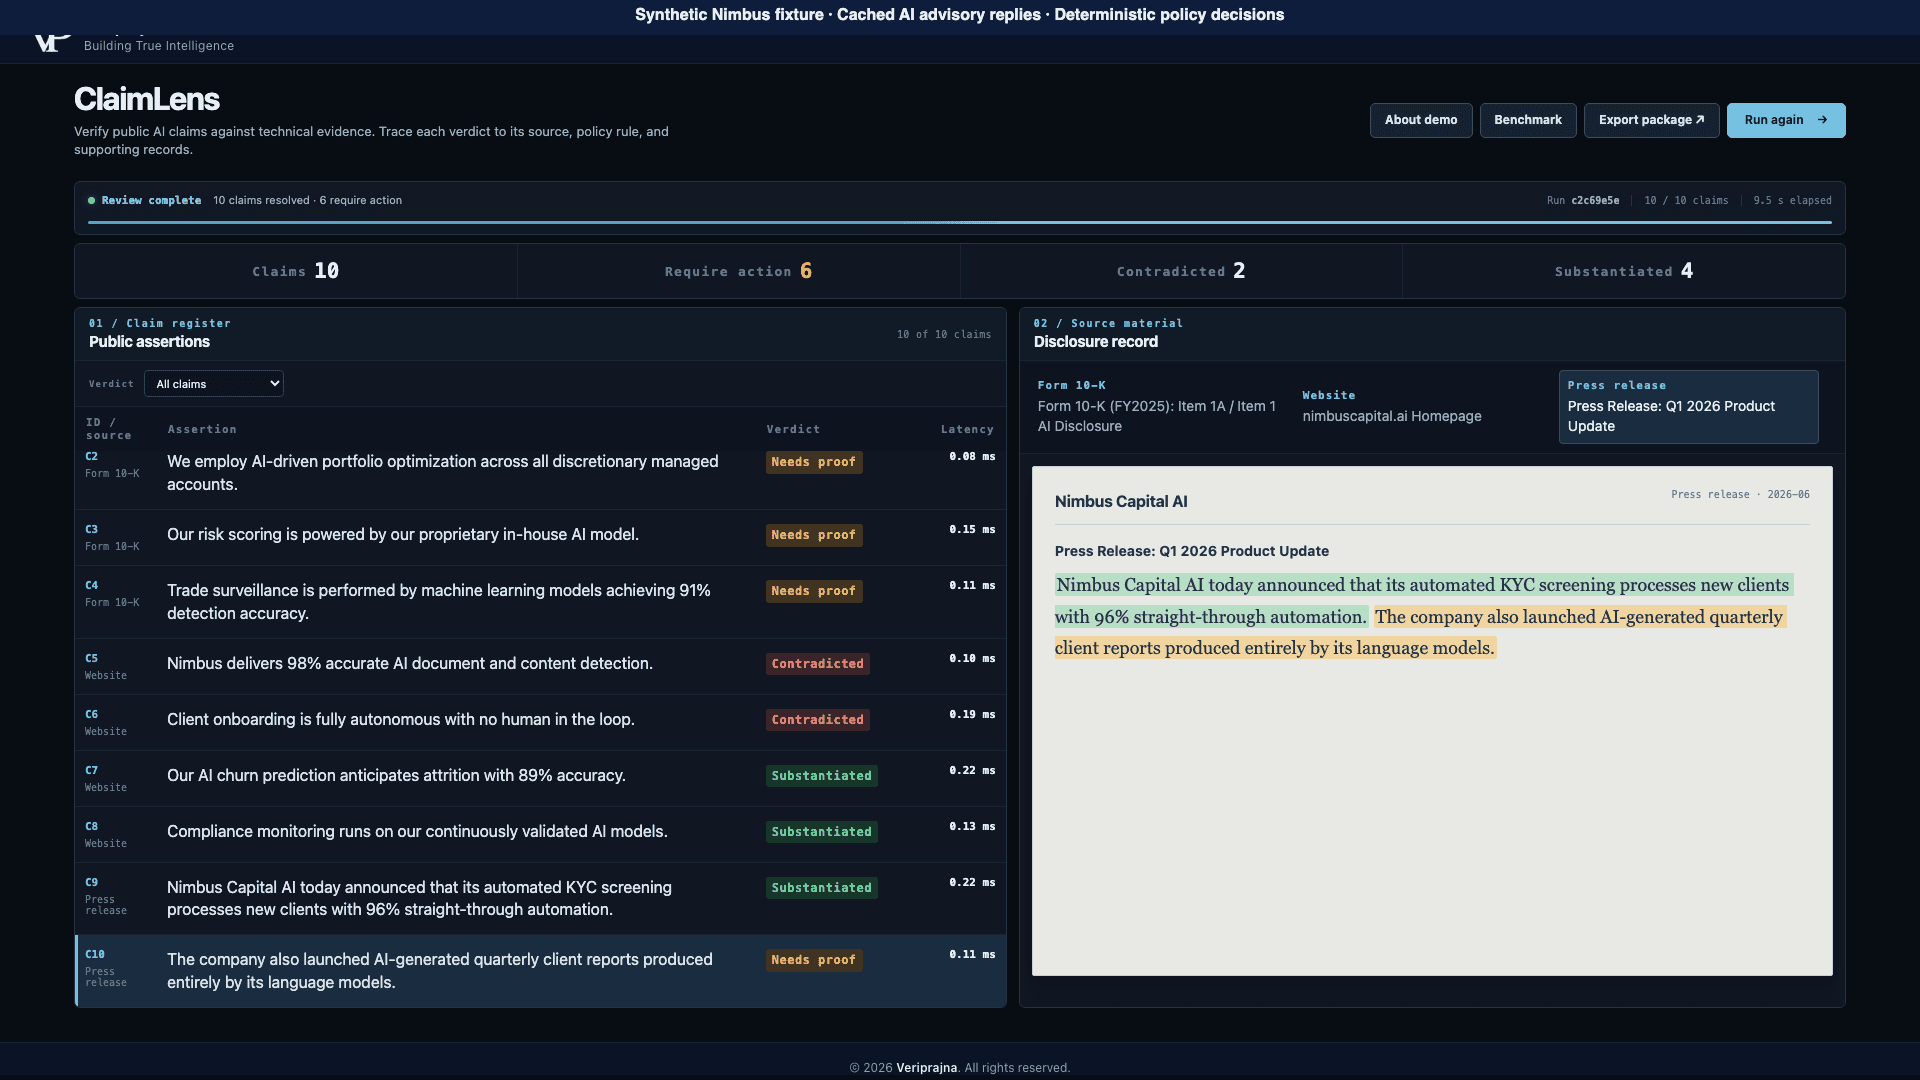
Diese gestalterische Haltung steht hinter ClaimLens, unserer lokalen Demonstration zur Verknüpfung von KI-Aussagen mit bereitgestellten technischen Aufzeichnungen. Das Beispiel hier ist Nimbus Capital AI, ein synthetisches Unternehmen mit synthetischen Offenlegungen und Protokollen. Es veranschaulicht ein Prüfproblem; es legt nicht dar, wie ein tatsächliches Investmentunternehmen arbeitet oder ob eine Offenlegung den gesetzlichen Vorgaben entspricht.
Der Abstand zwischen Bereitstellung und Steuerung
Nimbus erklärt: „Wir setzen in allen diskretionär verwalteten Konten auf KI-gestützte Portfoliooptimierung.“ Die bereitgestellte Modelldokumentation besagt, dass ein Optimierungsmodell bereitgestellt ist. Das Betriebsprotokoll besagt, dass die Modellausgabe 1.5% der Allokationsentscheidungen beeinflusst hat. ClaimLens ordnet diesem Anspruch gemäß seiner konfigurierten Regel für geringen operativen Einfluss das Urteil „Needs proof“ zu.
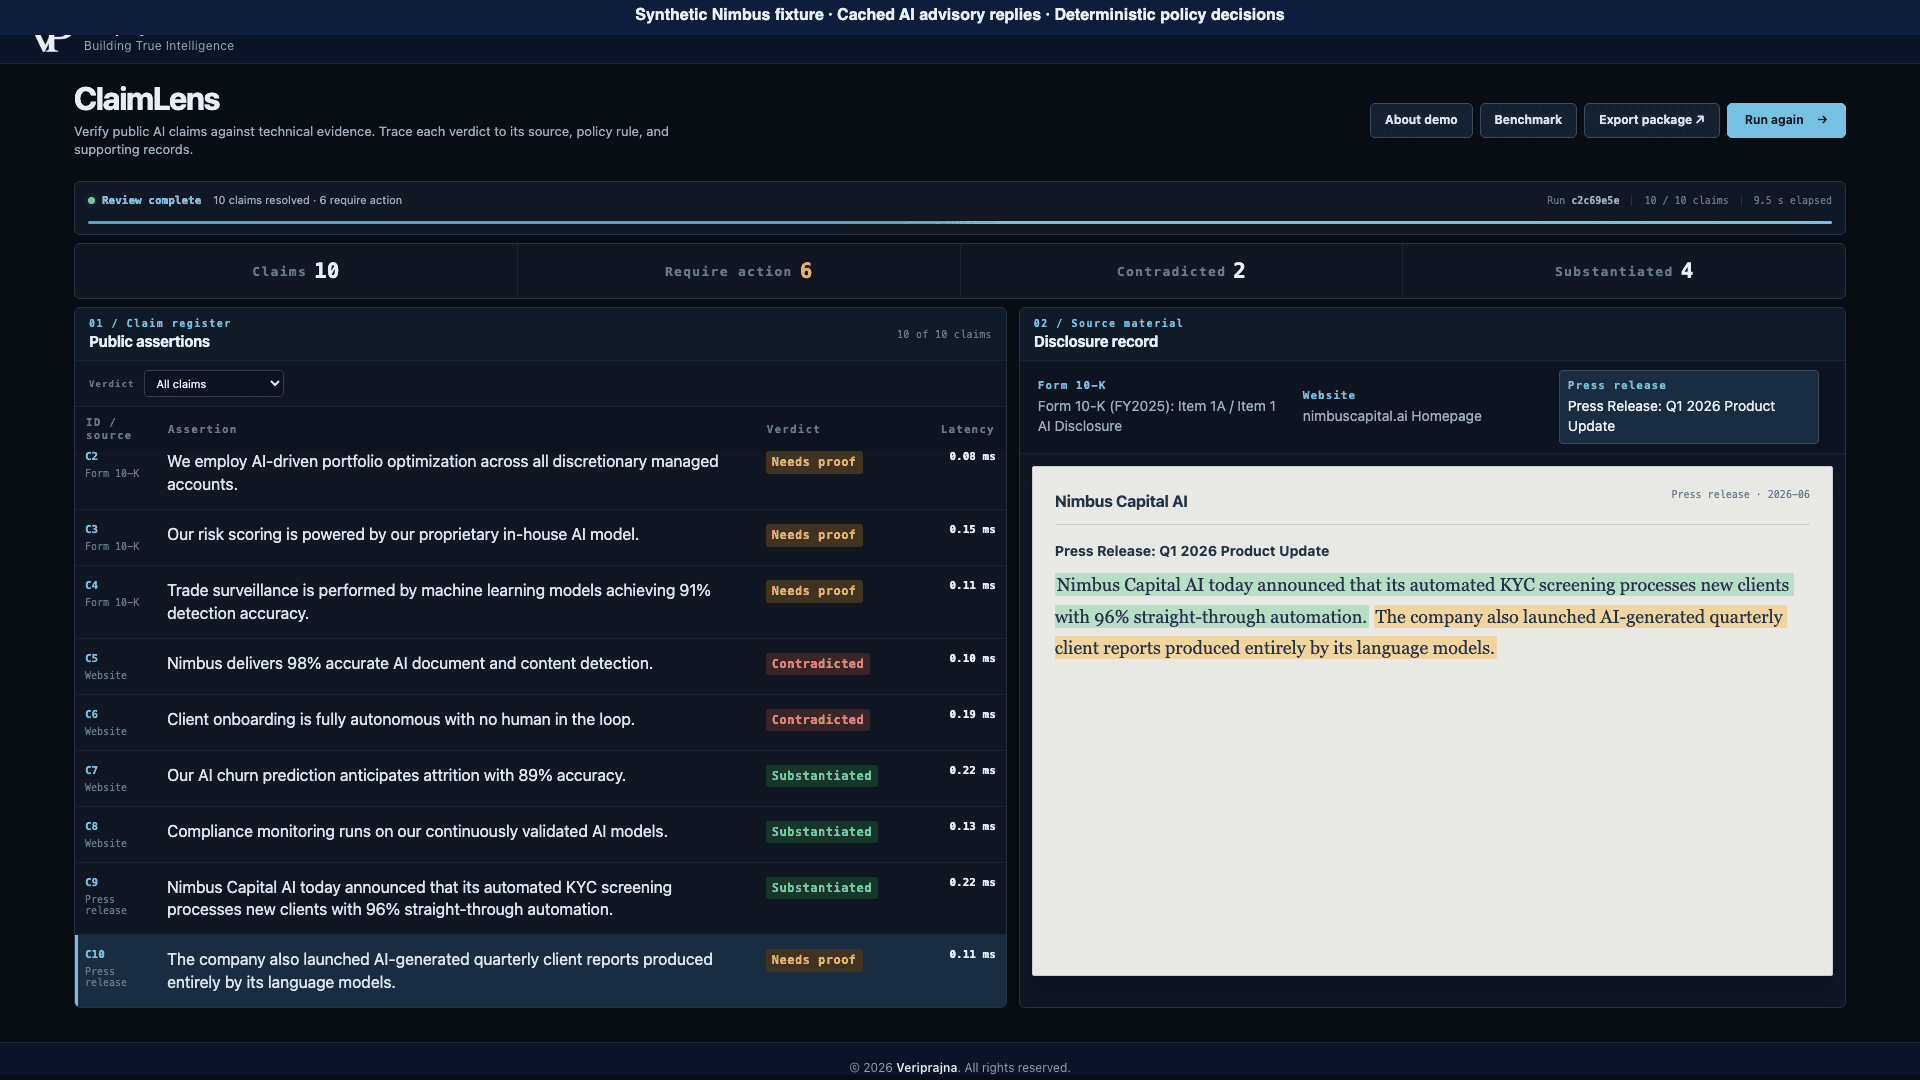
Der Existenznachweis beantwortet eine nützliche Frage. Es gibt ein Modell, das untersucht werden kann. Das Protokoll beantwortet eine andere: wie oft dessen Ausgabe die erfassten Allokationsentscheidungen beeinflusst hat. Keine der beiden Tatsachen sollte ignoriert werden, nur weil die andere unbequem ist.
Der Satz reicht weiter als diese Aufzeichnungen. „KI-gestützt“ suggeriert eine maßgebliche Rolle bei der Bestimmung der Arbeit. „In allen Konten“ führt eine breite Abdeckung ein. Ein bereitgestelltes Modell allein erklärt keines dieser beiden Versprechen. Der Wert von 1.5% gibt einem Prüfer einen konkreten Anlass zu fragen, wie das Modell am Prozess beteiligt ist und wie sich diese Beteiligung auf die Konten verteilt.
Ich bevorzuge eine Prüfung, die diese Lücke explizit offenlegt. Die pauschale Formulierung nur deshalb zu genehmigen, weil das Modell vorhanden ist, würde einem schmalen Belegstück ein weitaus größeres Versprechen aufbürden. Zu erklären, dass überhaupt keine KI verwendet wird, würde den Nachweis verwerfen, dass das Modell existiert und Entscheidungen mitunter beeinflusst. „Needs proof“ hält die Frage aufrecht, die die bereitgestellten Unterlagen offengelassen haben.
Ein niedriger Prozentsatz bedarf weiterhin der Interpretation
Der schwierigere Teil besteht darin zu entscheiden, was als Nächstes verlangt werden soll. Ein geringer Anteil an Entscheidungen erklärt für sich genommen noch nicht die Tragweite dieser Entscheidungen.
Betrachten wir einen hypothetischen Arbeitsablauf, in dem ein Modell eine kleine Zahl ungewöhnlich folgenreicher Allokationen steuert. Eine reine Zählung von Entscheidungen könnte seine wirtschaftliche Rolle unterschätzen. In einem anderen hypothetischen Ablauf erzeugt das Modell Empfehlungen für jedes Konto, die Menschen lehnen diese jedoch meist ab. Ein Protokoll, das nur angenommene Empfehlungen zählt, würde eine andere Aktivität abbilden als ein Protokoll, das alle geprüften Empfehlungen erfasst. Keine der beiden Möglichkeiten ist für Nimbus belegt. Sie verdeutlichen, warum die Bedeutung von „beeinflusst“ geklärt sein muss, bevor man diesen Prozentsatz nutzt, um die Formulierung festzulegen.
Ein Prüfer kann fragen, welches Ereignis das Protokoll dazu veranlasst, eine Entscheidung zu zählen, welche Konten und welchen Zeitraum es abdeckt und ob sich die beanspruchte Rolle auf Empfehlungen, angenommene Änderungen oder finale Entscheidungsgewalt bezieht. Fehlen diese Definitionen, wird auch das Einholen einer weiteren Model Card die Lücke nicht schließen. Der fehlende Nachweis betrifft den operativen Einsatz.
Hier setze ich der Entscheidung der Demo eine klare Grenze. ClaimLens wendet ausgewählte Regeln auf vorgelegte Datensätze an. Es authentifiziert diese Datensätze nicht und stellt auch nicht fest, ob die Protokollierungsmethode genau die Rolle erfasst, die ein Leser aus dem Satz ableiten würde. Ein konfiguriertes „Needs proof“-Ergebnis kann die Untersuchung strukturieren. Die zugrunde liegende Messung bedarf dennoch einer genauen Prüfung.
Dieselbe Vorsicht gilt, wenn eine Regel ein bestätigtes Ergebnis liefert. Eine Übereinstimmung zwischen einem Satz und einem vorgelegten Datensatz ist ein Grund zu prüfen, wie gut beide zusammenpassen. Sie belegt nicht, dass der Datensatz vollständig, repräsentativ oder unabhängig verifiziert ist. Ein Überprüfungssystem sollte diese Unterscheidung deutlich erkennbar halten, wenn seine Ergebnisse in eine Publikationsentscheidung einfließen.
Drei Reaktionen auf die Lücke
Für ein Team, das vor einer vergleichbaren Lücke steht, können sich sowohl der Wortlaut als auch die Belege ändern. Die Wahl hängt davon ab, welchen Teil des Anspruchs das Team verteidigen kann.
Eine Reaktion besteht darin, den Satz auf die bereits dokumentierte Aktivität einzugrenzen. Die Aussage, dass ein Modell bereitgestellt ist, ist eine geringere Verpflichtung als die Behauptung, dass es die Portfoliooptimierung über alle Konten hinweg steuert. Dies kann eine nützliche Korrektur sein, wenn die Bereitstellung die Tatsache ist, die kommuniziert werden soll. Es gibt jedoch den größeren Anspruch an die operative Rolle des Modells auf. Den Begriff „KI-gestützt“ durch ein anderes vages Adjektiv zu ersetzen, würde die ursprüngliche Frage ungelöst lassen.
Eine zweite Reaktion besteht darin, die operative Rolle präziser nachzuweisen. Dies könnte Aufzeichnungen erfordern, die zwischen generierten Empfehlungen, geprüften Empfehlungen und geänderten Entscheidungen samt Abdeckung und Definitionen unterscheiden. Dies erfordert mehr Arbeit als der bloße Nachweis, dass ein Modell existiert. Es ist jedoch gerechtfertigt, wenn die Rolle des Modells für das Verständnis der Leser zentral ist. Es kann auch offenlegen, dass der ursprüngliche Wortlaut selbst nach einer Verbesserung der Belege überarbeitet werden muss.
Eine dritte Reaktion besteht darin, den weitergehenden Anspruch zurückzuhalten, solange die Frage offen ist. Damit verzichtet das Team auf eine Botschaft, die es möglicherweise gerne nutzen möchte. Ich halte diese Kosten für angemessen, wenn das zentrale Versprechen des Satzes von einer operativen Rolle abhängt, die noch niemand mit ausreichenden Belegen beschreiben kann. Eine ungeklärte Kennzeichnung ist intern nur nützlich, wenn jemand die Nachverfolgung übernimmt; sie ersetzt keine Entscheidung über die öffentliche Formulierung.
Dies sind redaktionelle und prüftechnische Entscheidungen, keine Formulierungen, die ClaimLens automatisch empfiehlt oder rechtlich absegnet. Ihr Wert liegt darin, dass sie die ungelösten Nachweise mit einer konkreten nächsten Handlung verbinden. Das Team kann das Versprechen anpassen, die Belege verbessern oder die Aussage zurückstellen.
Widersprüche festhalten, ohne die Entscheidung zu verlieren
Das Portfoliobeispiel enthält zudem eine Meinungsverschiedenheit. In der aufgezeichneten Demo stuft der gecachte KI-Beurteiler den Anspruch als widerlegt ein, während das konfigurierte Prüfgate bei „Needs proof“ bleibt. Der Ratschlag ist ein vorgefertigter Replay, keine neue Modellbewertung. Der Beurteiler ändert die Entscheidung des Gates nicht.
Ich möchte, dass einem Prüfer beide Ergebnisse zur Verfügung stehen, da die Meinungsverschiedenheit ein Ermessen offenlegt: Wie weit tragen uns diese operativen Aufzeichnungen? Den Anspruch als widerlegt zu bezeichnen, drückt ein schärferes Urteil aus als die Feststellung, dass die Belege unzureichend sind. Die Person, die den Satz prüft, muss diesen Unterschied sehen und die Gründe dafür analysieren. Die beratende Ansicht auszublenden, würde einen bedenkenswerten Einwand beseitigen. Die protokollierte Entscheidung durch die am stärksten klingende Meinung zu ersetzen, würde verschleiern, wie das Ergebnis zustande kam.
Das ClaimLens-Erklärstück zeigt diesen Workflow vom Anspruch bis zum Nachweis. Seine nützliche Einheit ist der Satz zusammen mit seinem bereitgestellten Beleg, der protokollierten Entscheidung und der Begründung. Diese Kombination gibt Marketing, Technik und dem Prüfer ein gemeinsames Objekt zur Diskussion.
Hier ist der Walkthrough des Gründers zur synthetischen ClaimLens-Prüfung.
Mein Maßstab für die Diskussion ist eindeutig: Identifizieren Sie die operative Tatsache, die den Wortlaut vertretbar machen würde. Wenn das Team nur nachweisen kann, dass ein Modell existiert, dann ist das der Umfang des Anspruchs, der belegt wurde. Ein größeres Versprechen verdient seinen Platz erst, wenn die Belege die größere Rolle erklären.