E-Commerce-KI-Genauigkeit | Vouchmark
Eine einzige Shopping-Antwort kann ein korrektes Detail und eine falsche Spezifikation enthalten. Vouchmark demonstriert separate Katalogentscheidungen für jede einzelne Behauptung: Eine synthetische TV-Antwort korrigiert HDR10+ zu HDR10, während die unterstützte Bildwiederholfrequenz beibehalten wird.
32/32
Als wahr gelabelte Behauptungen beibehalten
Feste gelabelte synthetische Evaluation
60/60
Behauptungsurteile stimmen mit Fixture-Labels überein
Bereits zerlegte synthetische Behauptungsfälle
47/47
Pass/Correct-Datensätze tragen Referenzen
Vorhandensein von Fixture-Referenzen, keine Authentifizierung
Diese Ergebnisse testen lokale Entscheidungsregeln auf verfassten Fixtures. Sie messen keine Behauptungsextraktion, keinen ungesehenen Käufer-Traffic und keine Produktionsleistung.
Der synthetische Vega-TV-Entwurf besagt, dass er HDR10+ und eine Bildwiederholfrequenz von 120Hz unterstützt. Der lokale Katalog unterstützt 120Hz, nennt jedoch HDR10. Die Annahme des gesamten Entwurfs belässt den falschen Standard; seine Ablehnung verwirft ein unterstütztes Detail.
Die Prüffrage ist präziser: Welche Aussage stimmt mit dem Datensatz überein, welche widerspricht ihm und welche lässt sich nicht feststellen? Diese Unterscheidung bietet Katalog- und Produktteams eine verlässliche Grundlage für die Entscheidung, was ein Assistent anzeigen darf.
Vouchmark umschließt einen Assistenten-Entwurf. Die vorbereiteten Szenarien liefern atomare Behauptungen; ein separater Freiform-Endpunkt unterstützt optionale Modellextraktion oder ein begrenztes Muster-Fallback. Das Video verwendet vorbereitete Szenarien und belegt keine Extraktionsgenauigkeit.
Die Fernseher-Eingabe liefert eine HDR-Behauptung und eine Bildwiederholfrequenz-Behauptung. Der lokale JSON-Katalog enthält Attributwerte, Konfidenz-Labels und verfasste Referenzstrings. Es wird keine externe Quelle abgerufen.
Das deterministische Gate erkennt HDR10 und HDR10+ als unterschiedliche Standards an. Es korrigiert die Nichtübereinstimmung und passiert die Übereinstimmung der Bildwiederholfrequenz. Seine Normalisierung, kuratierten Abgleiche und Attributregeln besitzen eine endliche Abdeckung.
Auslieferungstext auf Behauptungsebene bildet die angezeigte Antwort, sofern keine konfigurierte Sicherheitsregel ihn überschreibt. Ein Beleg in JSON oder druckbarem HTML hält fest, was behauptet wurde, was der Katalog besagte und warum sich die Entscheidung änderte.
Unbekannte Attribute führen zu Abstention; fehlende Produkte oder Attribute führen zu Outside-Coverage. Abgeleitete Katalogwerte können denselben Abgleichpfad durchlaufen wie verifizierte Werte, weshalb das Beleg-Konfidenz-Label entscheidend ist. Eine separate deterministische Vollständigkeitsregel erfasst ausgewählte konfigurierte Implikationen; sie prüft nicht jede denkbare Bedeutung in Fließtext.
Alle hier gezeigten Produkte, Datensätze, Entwürfe und Evaluationsfälle sind synthetisch. Die vorbereiteten Szenarien liefern ihre atomaren Behauptungen. UI-Labels wie Verifiziert beschreiben in dieser Demonstration den Katalogabgleich; sie begründen keine unabhängige externe Verifizierung.
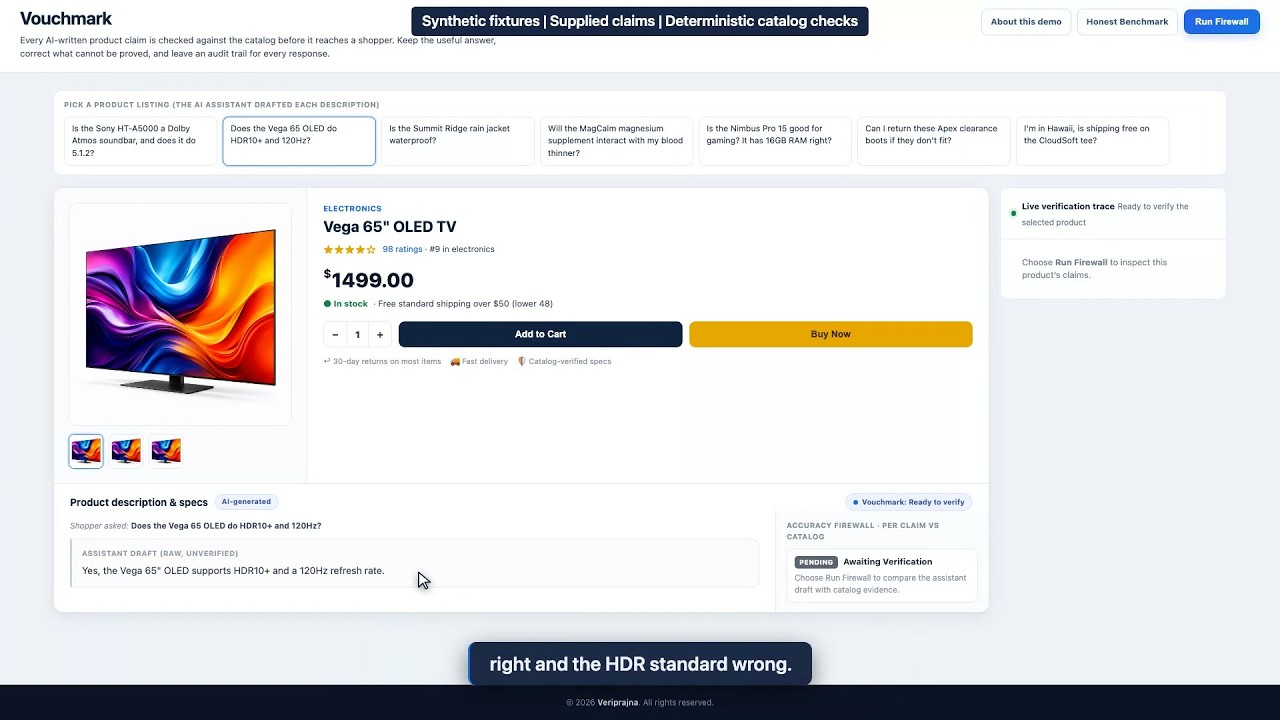
Der Käufer fragt, ob der synthetische Vega-Fernseher HDR10+ und 120Hz unterstützt. Der vorbereitete Entwurf beantwortet beide Fragen zuversichtlich. Der Katalog unterstützt die Bildwiederholfrequenz, verzeichnet jedoch einen anderen HDR-Standard, sodass die Antwort eine gezielte Korrektur benötigt.
Vorbereiteter Assistenten-Entwurf
Yes, the Vega 65" OLED supports HDR10+ and a 120Hz refresh rate.
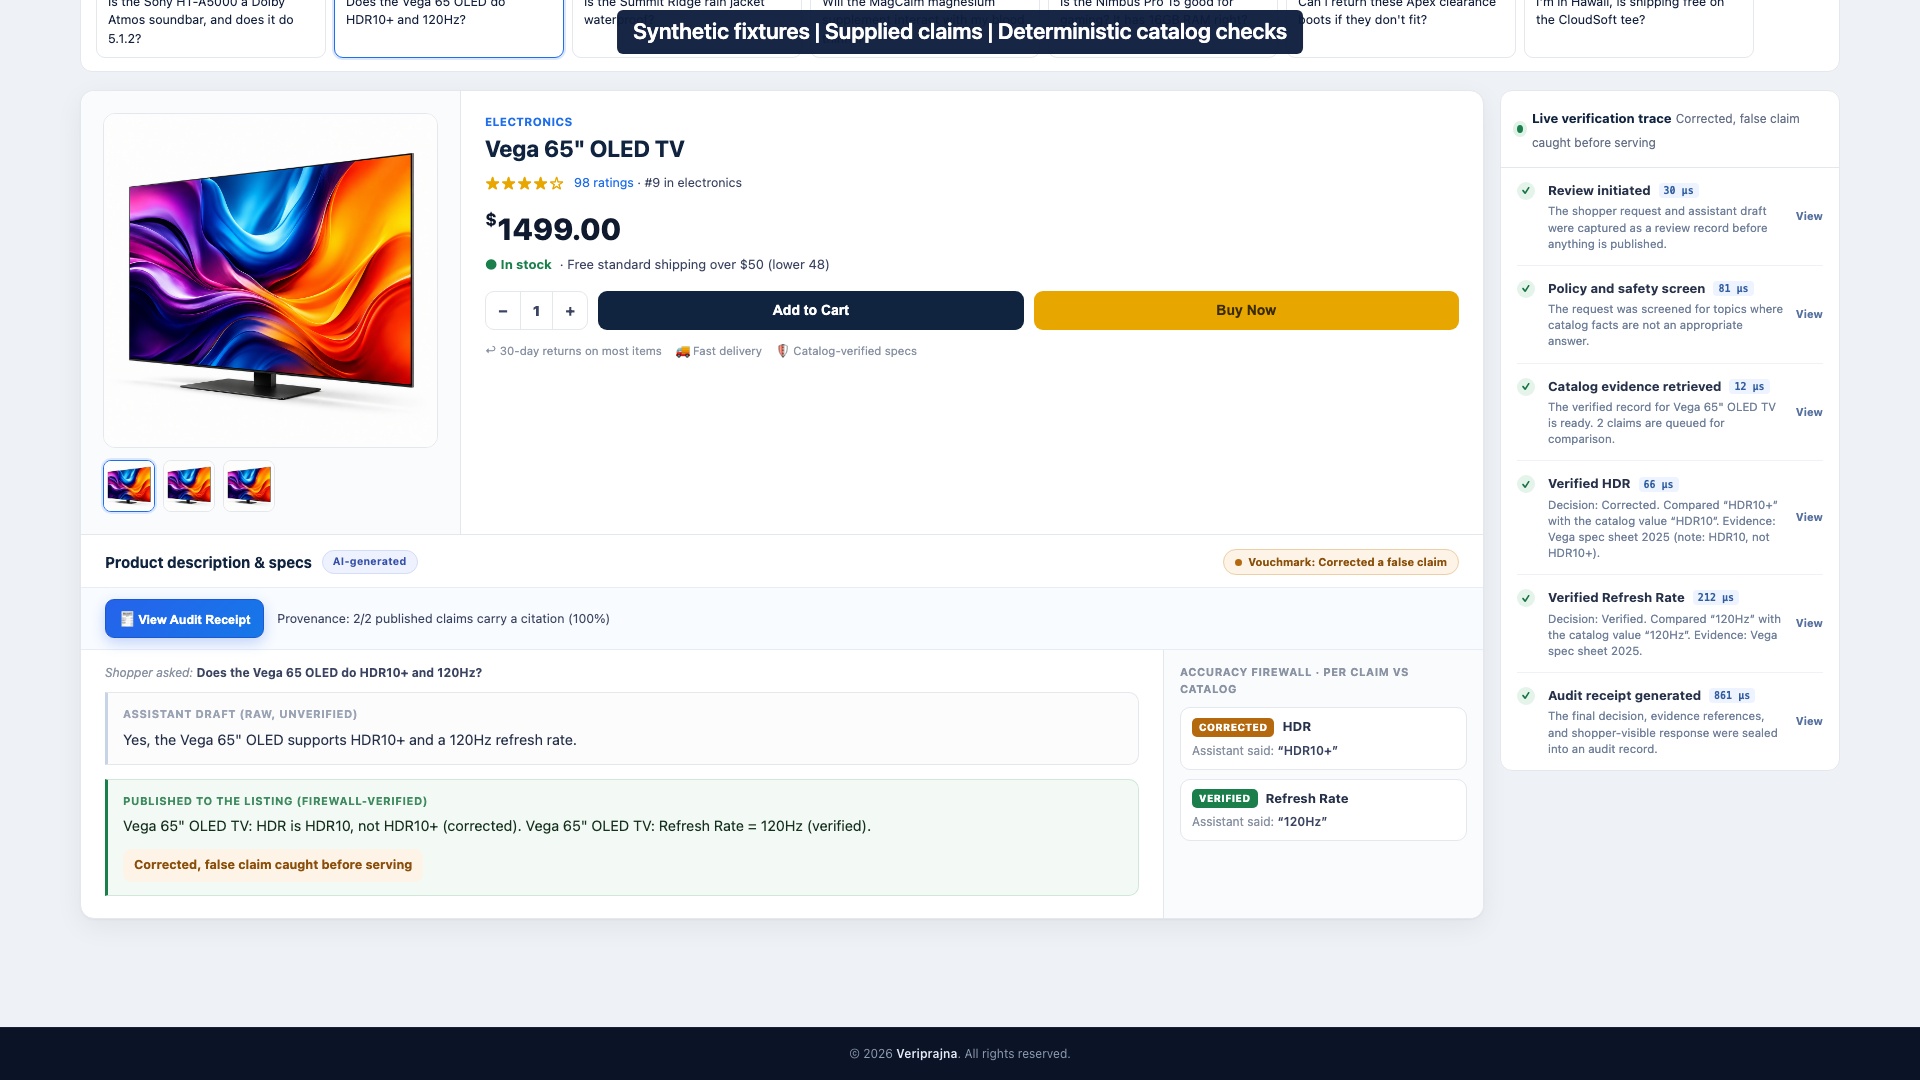
Die HDR-Aussage und die Bildwiederholfrequenz-Aussage gehen als separate gelieferte Behauptungen ein. Jede wird mit ihrem eigenen Produktattribut verglichen, statt dem gesamten Satz ein einziges Genehmigungs-Label zu erteilen. Die nachstehenden Katalogwerte weisen in der Fixture verifizierte Konfidenz-Labels auf; diese Labels sind verfasste Metadaten.
| Attribut | Entwurfsaussage | Katalogwert | Entscheidung | Auswirkung auf die Antwort |
|---|---|---|---|---|
| HDR-Standard | HDR10+ | HDR10 | Correct | Widerlegten Standard ersetzen |
| Bildwiederholfrequenz | 120Hz | 120Hz | Pass | Unterstütztes Detail beibehalten |
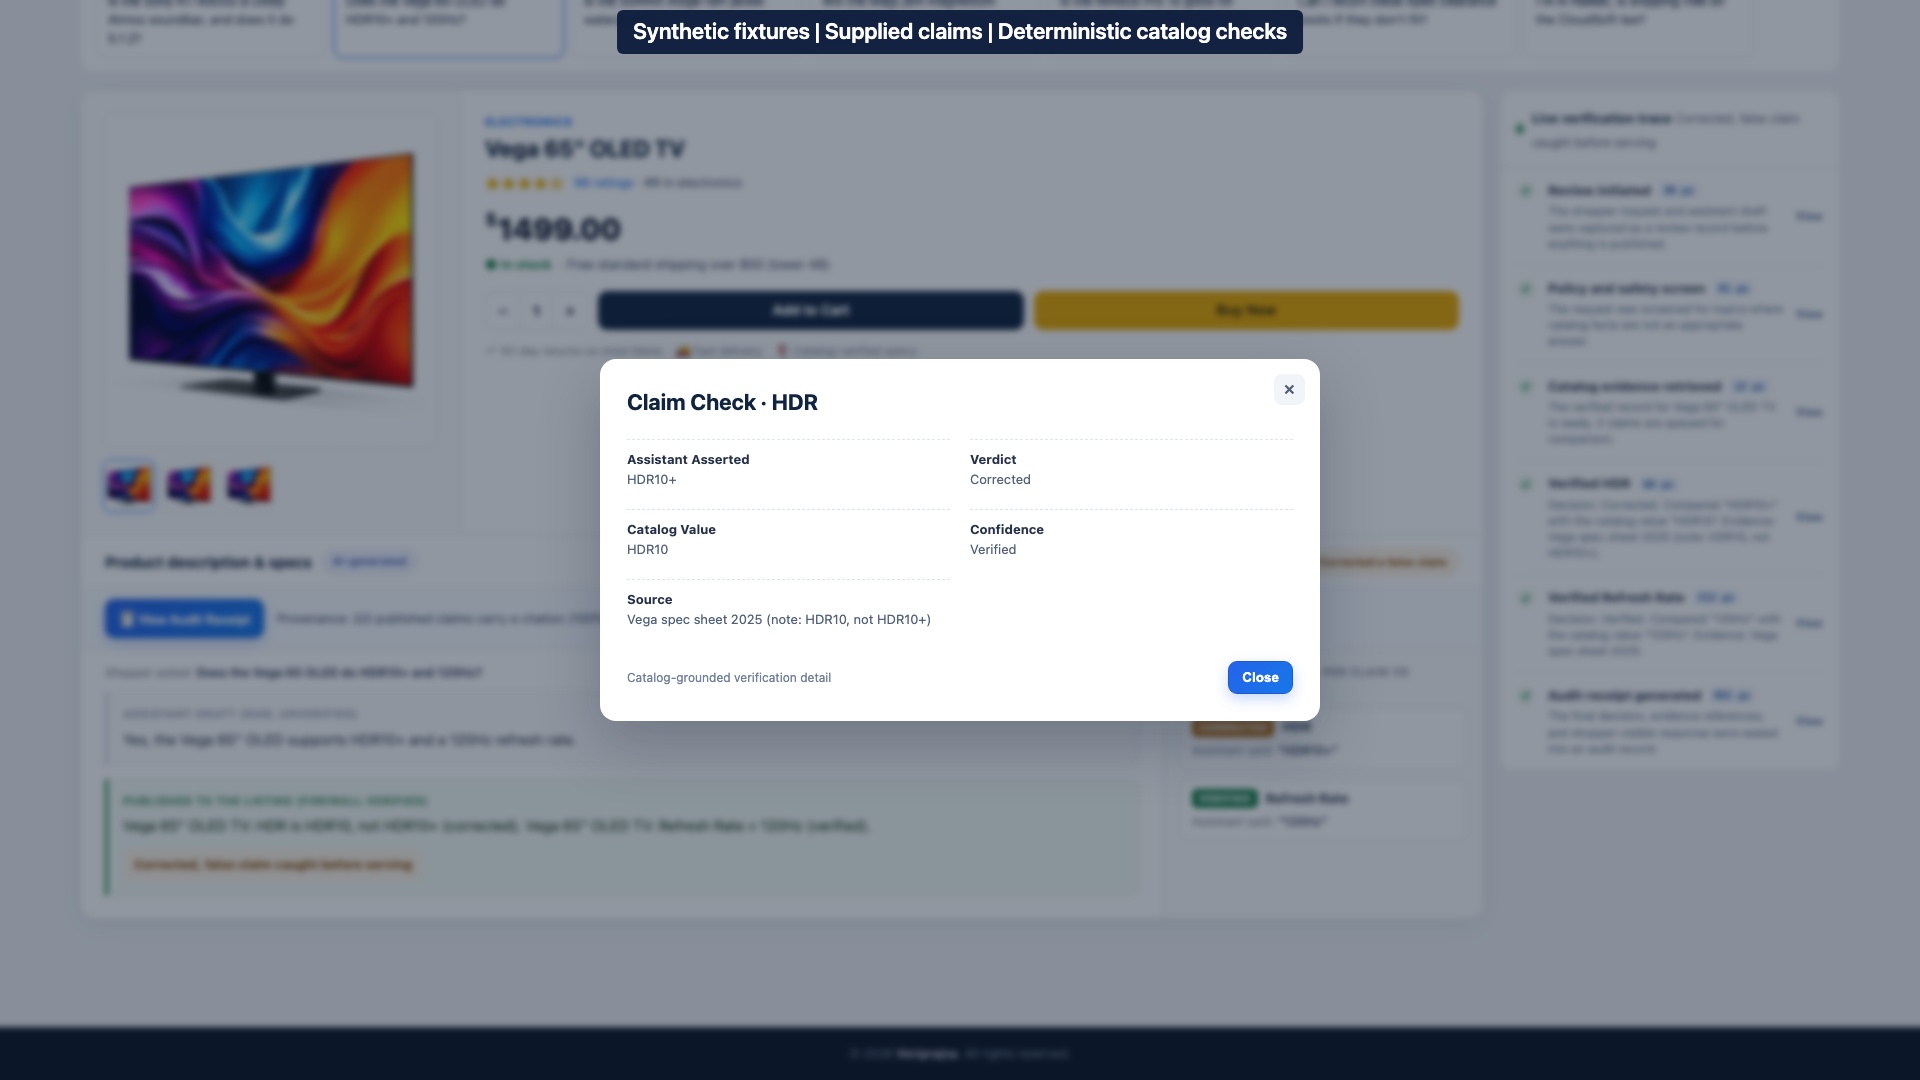
Das Gate erzeugt die folgende angezeigte Antwort. Die HDR-Korrektur nennt sowohl den erfassten Wert als auch die abgelehnte Aussage; die Bildwiederholfrequenz-Aussage bleibt erhalten. Der Abgleich mit dem Katalog ist die demonstrierte Prüfung, während die Qualität dieses Katalogs eine separate Verantwortung bleibt.
Angezeigte Antwort
Vega 65" OLED TV: HDR is HDR10, not HDR10+ (corrected). Vega 65" OLED TV: Refresh Rate = 120Hz (verified).
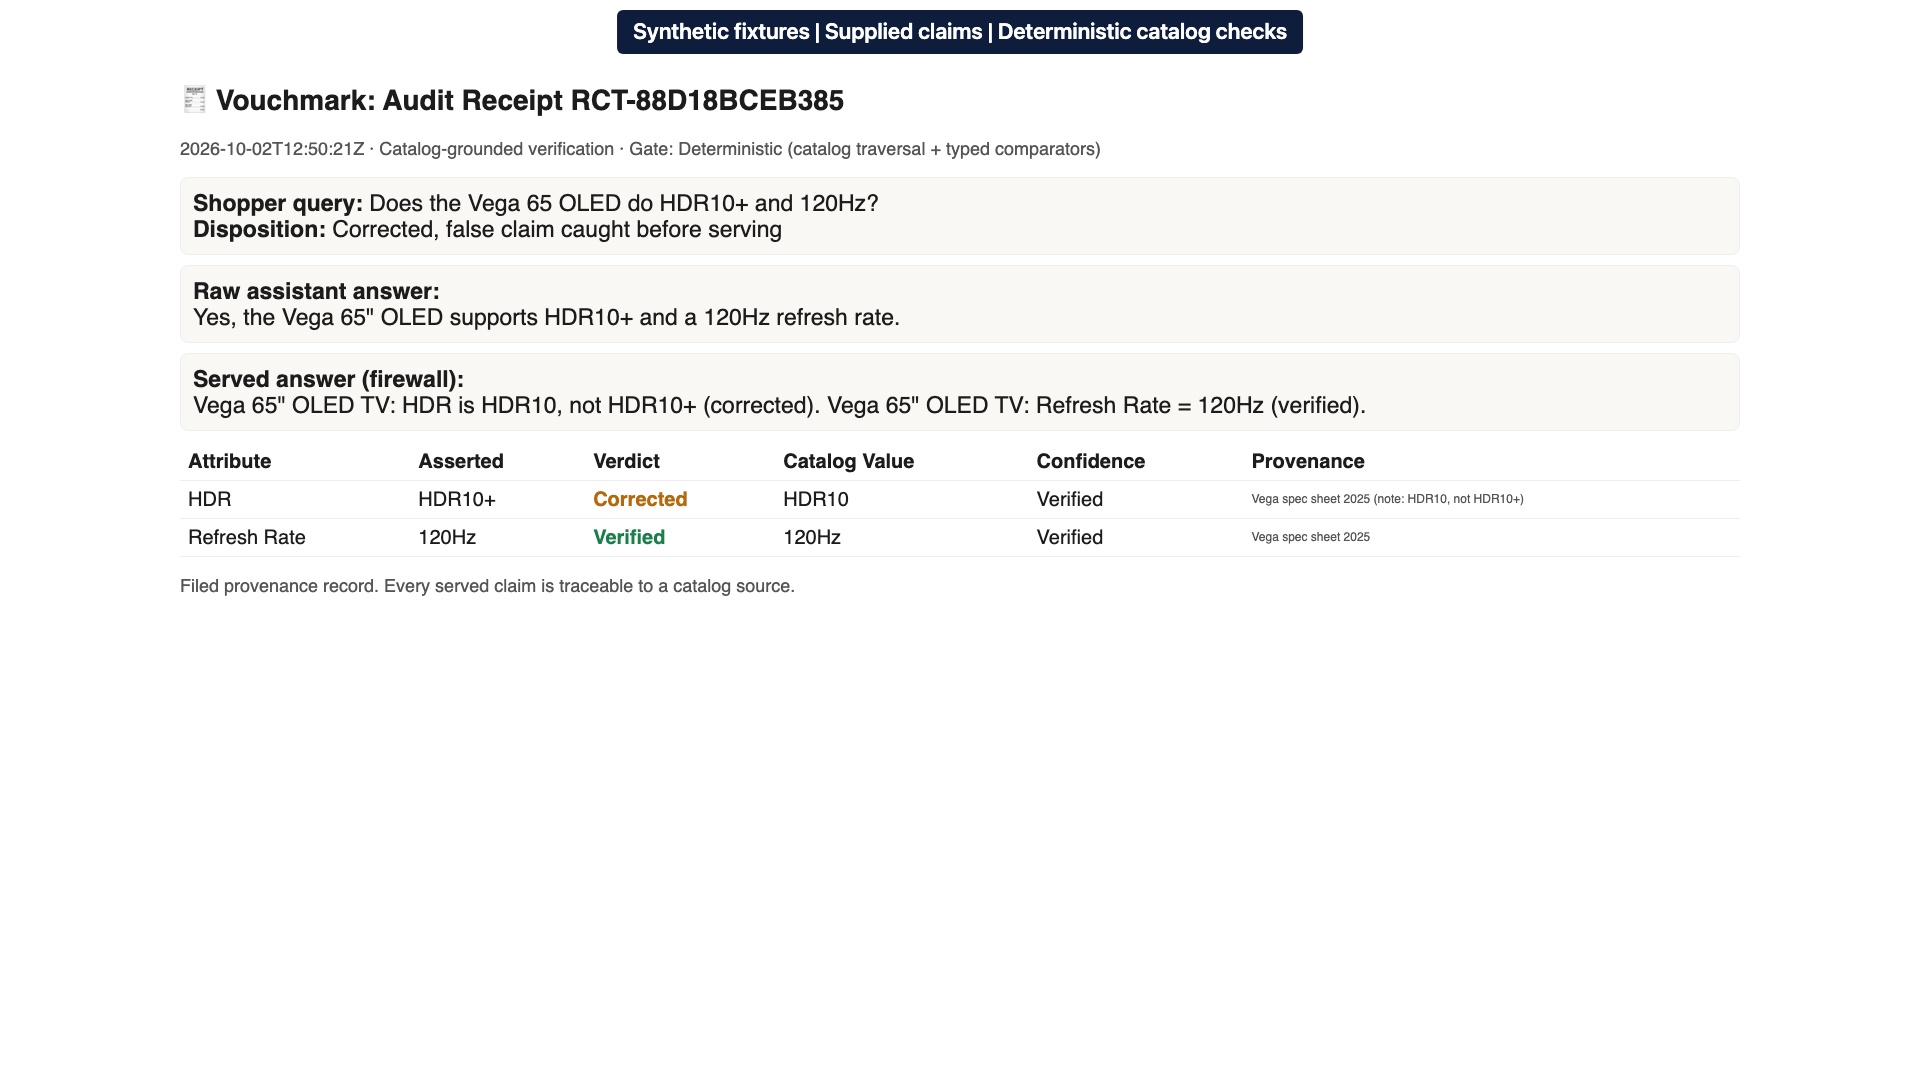
Der Beleg in JSON und druckbarem HTML bewahrt den ursprünglichen Entwurf, die angezeigte Antwort und zwei Entscheidungszeilen auf, einschließlich behaupteter Werte, Katalogwerte, Konfidenz-Labels und Fixture-Referenzen. Ein Prüfer kann nachvollziehen, dass die Korrektur die unterstützte Bildwiederholfrequenz nicht stillschweigend verworfen hat. Der Zeitstempel und der aus einem Hash abgeleitete Bezeichner identifizieren diesen generierten Datensatz; sie machen ihn nicht signiert, unveränderlich oder dauerhaft archiviert.
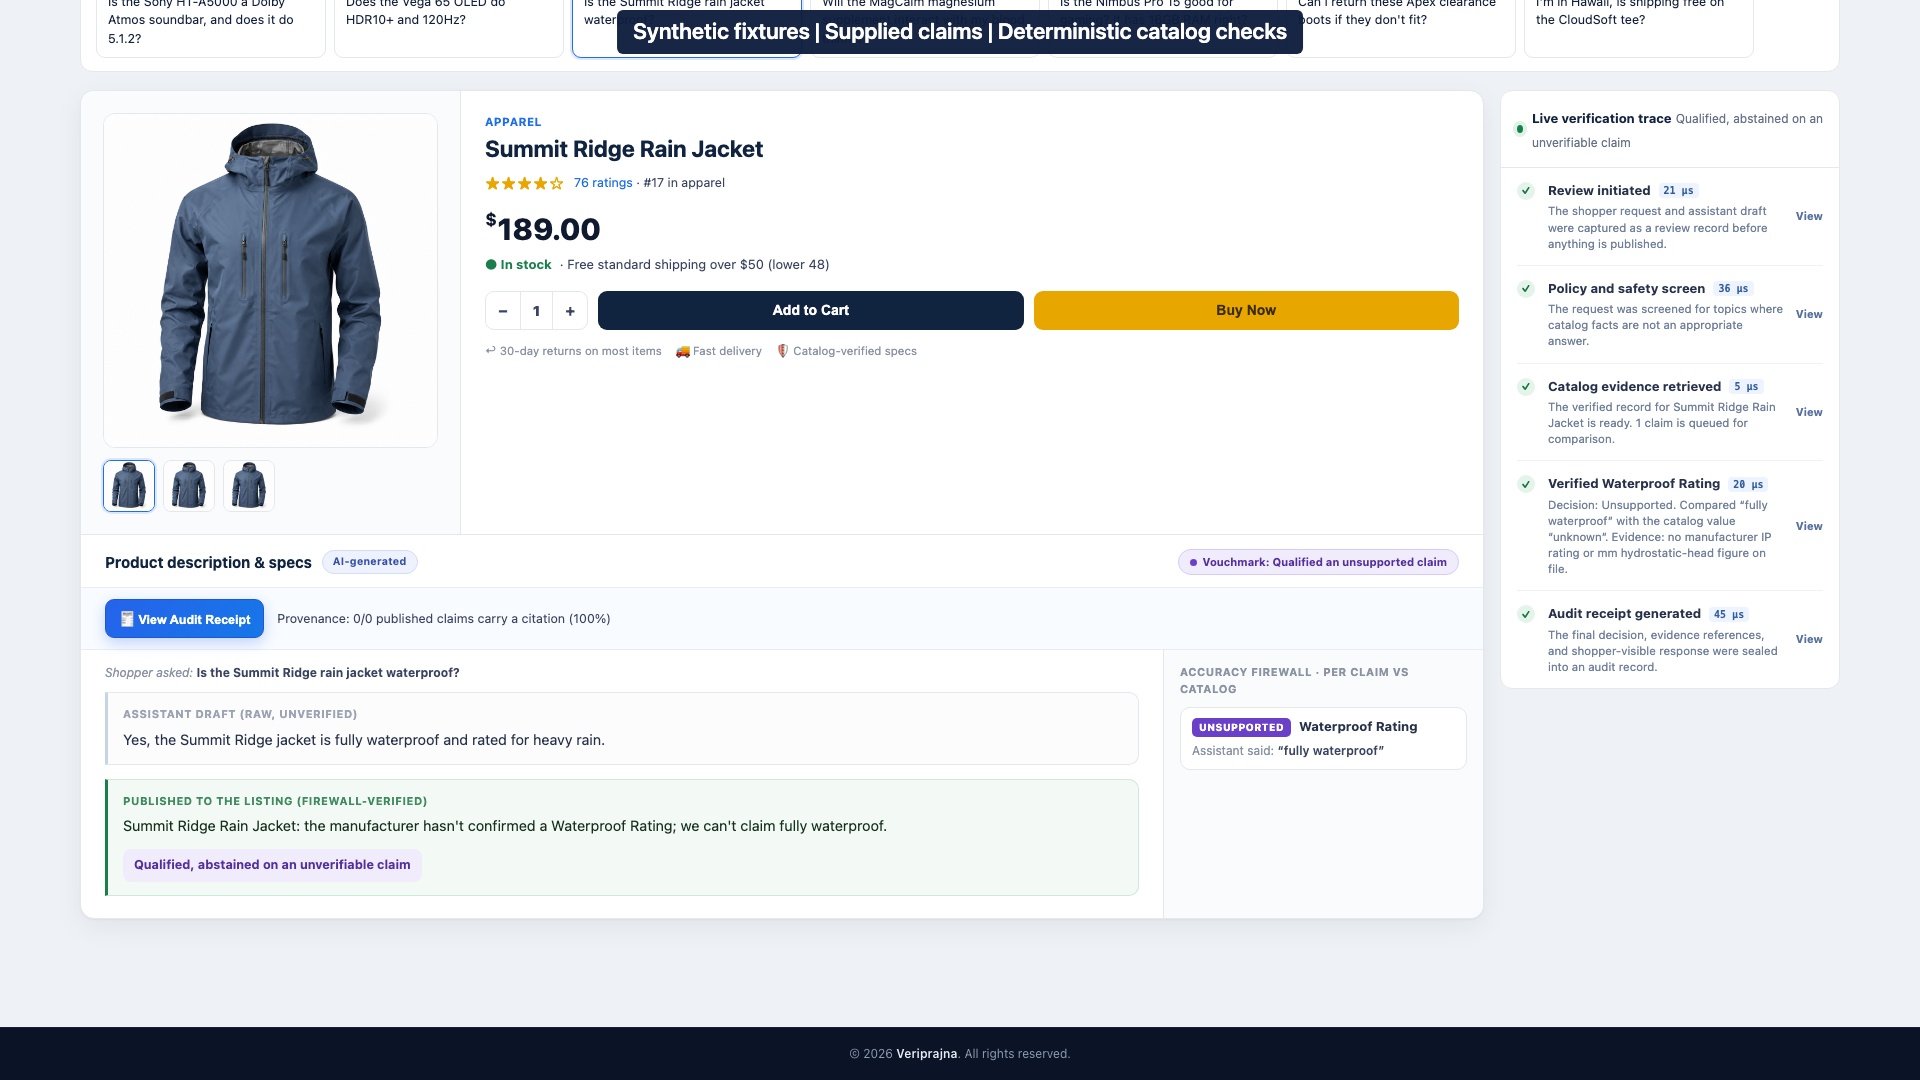
Der synthetische Summit-Ridge-Jackenentwurf verspricht vollständige Wasserdichtigkeit, während sein Attribut für die Wasserdichtigkeits-Einstufung unbekannt ist. Das Gate enthält sich bei diesem Versprechen. Es schließt nicht daraus, dass die Jacke nicht wasserdicht sei, und erfindet keine Einstufung. Ein Katalogteam benötigte geeignete Produktnachweise, bevor es die stärkere Behauptung aufstellen könnte.
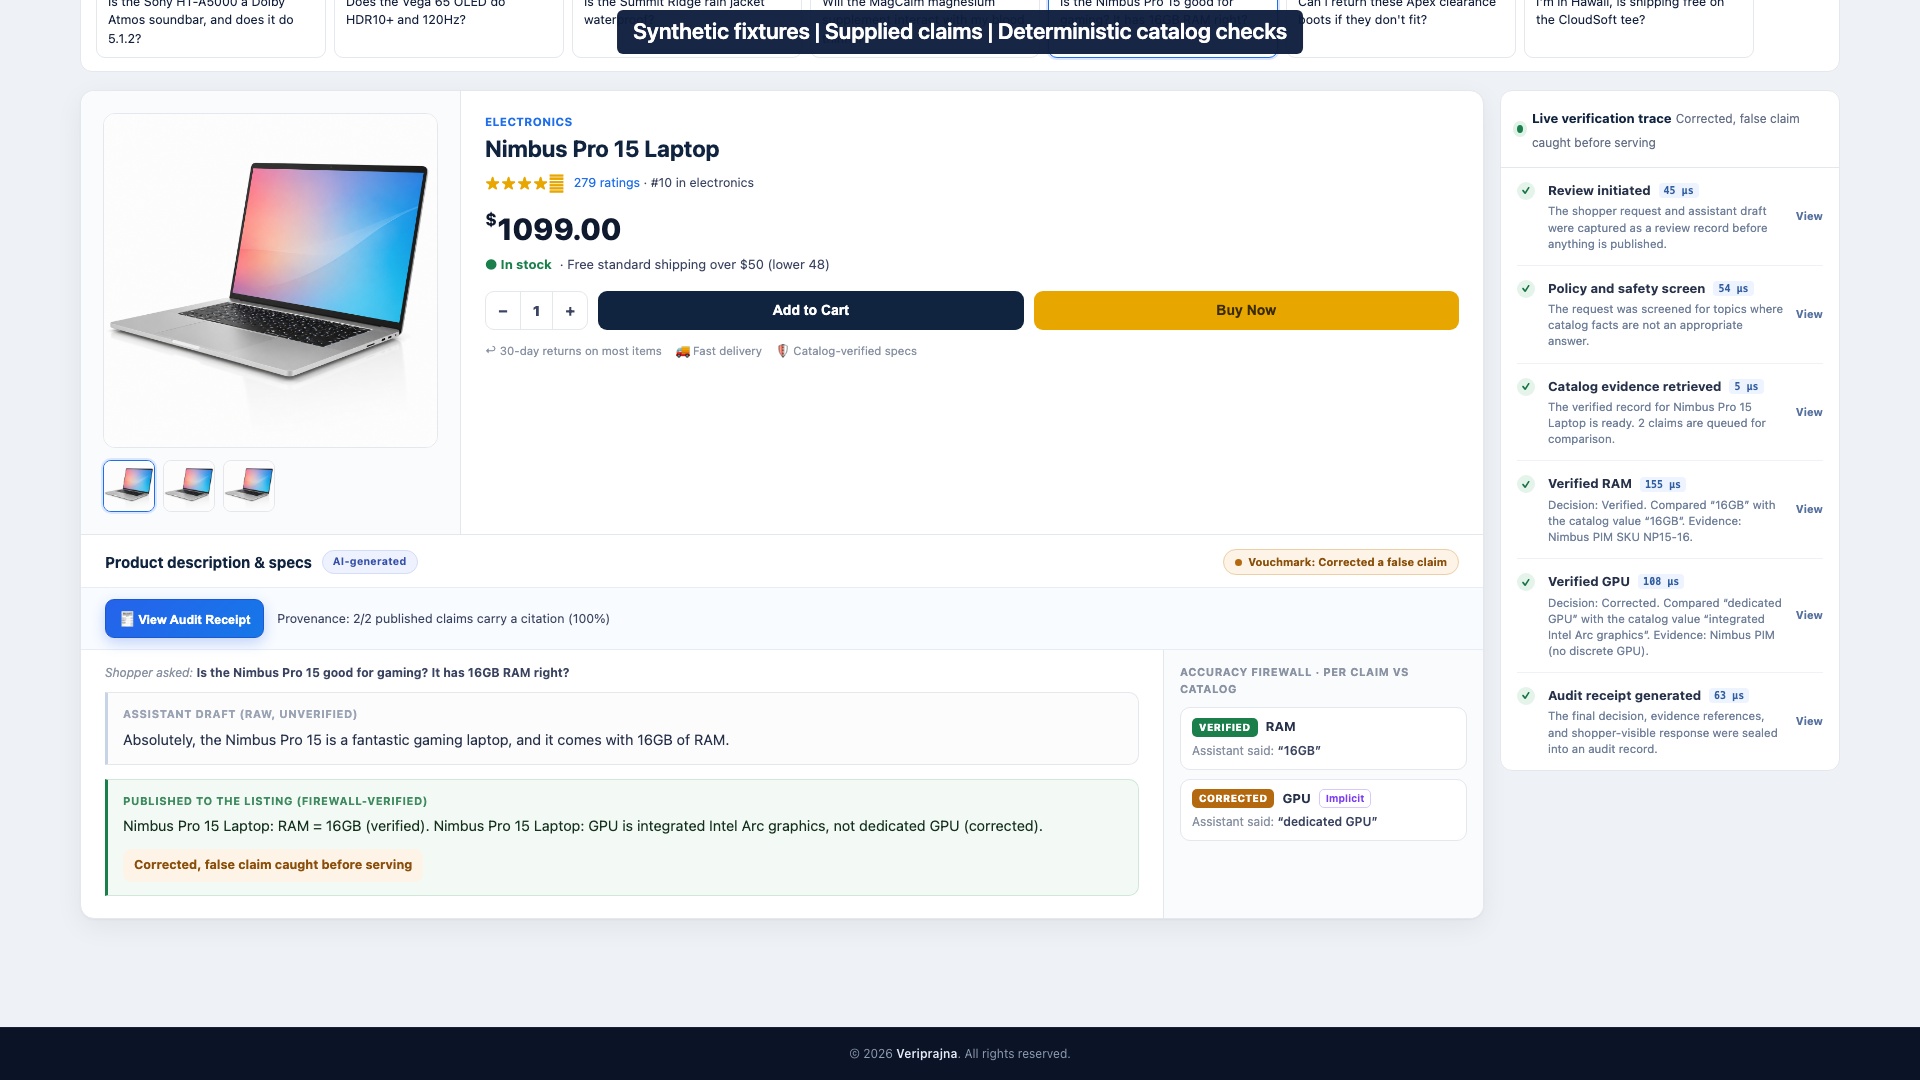
Der synthetische Nimbus-Laptop-Entwurf bezeichnet ihn als fantastischen Gaming-Laptop und gibt an, dass er 16GB RAM besitzt. Seine gelieferte Behauptungsliste enthält nur RAM. Eine deterministische Vollständigkeitsregel bildet die Gaming-Formulierung auf eine Dedizierte-GPU-Aussage ab und vergleicht diese hinzugefügte Aussage dann mit der integrierten Intel-Arc-Grafik des Katalogs. RAM passiert; die konfigurierte GPU-Implikation wird korrigiert. Dies veranschaulicht eine endliche Interpretationsregel, keine vollständige semantische Extraktion und kein Urteil über jedes Spiel.
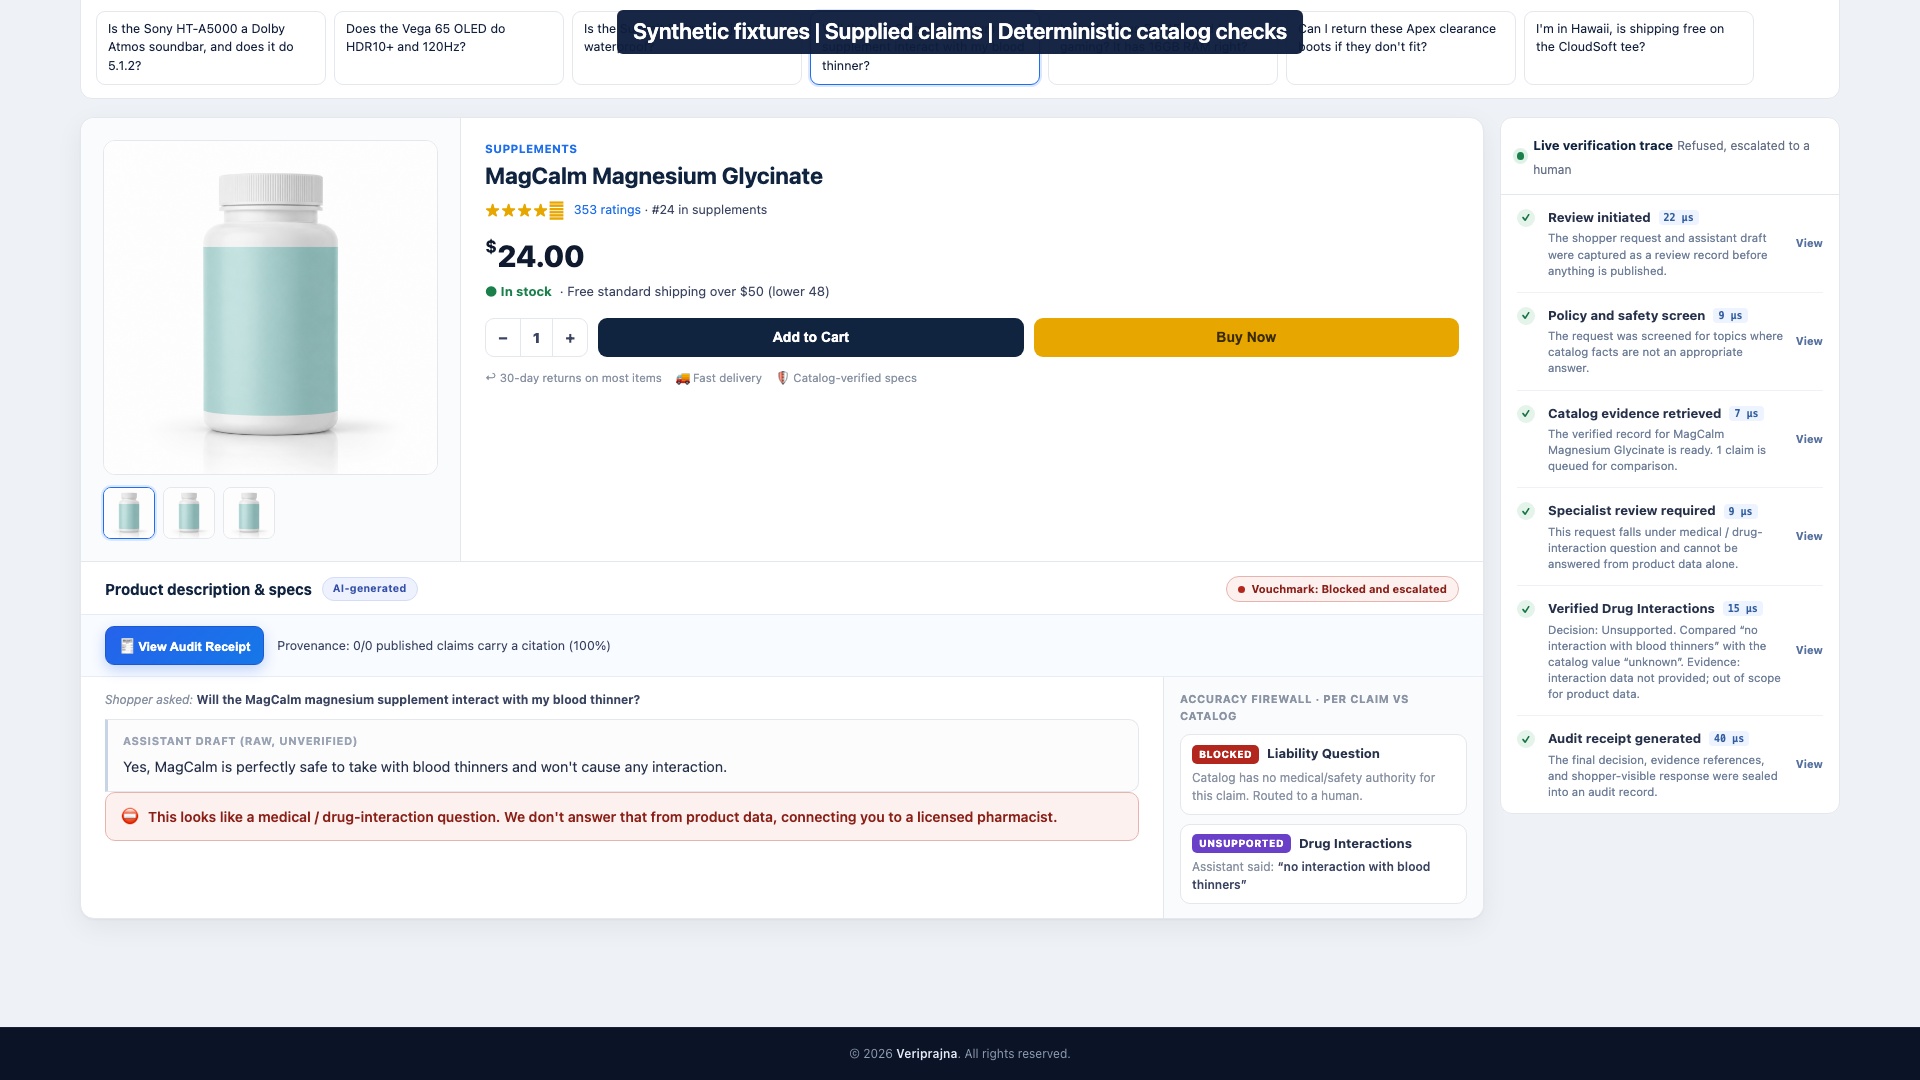
Im synthetischen MagCalm-Szenario fragt die Anfrage nach einem Blutverdünner. Eine konfigurierte Regex-Prüfung überschreibt die Produktantwort mit einer Verweigerung und einem Text, der einen approbierten Apotheker als vorgeschlagenes Prüfziel benennt. Das Feld für Wechselwirkungen ist ebenfalls unbekannt. Dies demonstriert die Entscheidung, die Produktantwort zurückzuhalten; es wird keine Weiterleitung an Fachpersonal ausgeführt und keine medizinische Empfehlung validiert.
Die feste Evaluation sendet 60 bereits zerlegte Behauptungs-Fixtures direkt an das Gate und sieben separate Anfragen-Fixtures an die Prüfung. Sie testet lokale Regeln gegen verfasste erwartete Labels. Sie testet keine Modellextraktion, keinen ungesehenen Käufer-Traffic, keine Quellauthentifizierung und keine Produktionsleistung.
| Messung | Ergebnis | Was gezählt wurde |
|---|---|---|
| Übereinstimmungen bei Behauptungsurteilen | 60/60 | 32 Pass-, 15 Correct-, 10 Abstain- und 3 Outside-coverage-Fixture-Labels |
| Wahre Behauptungen beibehalten | 32/32 | Als wahr gelabelte Behauptungen, die Pass bleiben |
| Abfangen eingestreuter falscher Behauptungen | 28/28 | Nicht als Pass gelabelte Behauptungen, die Correct, Abstain oder Outside-coverage erhalten; korrigierte Werte können weiterhin ausgeliefert werden |
| Vorhandensein von Referenzen | 47/47 | Pass/Correct-Datensätze, die einen nicht-leeren Fixture-Referenzstring tragen |
| Übereinstimmungen bei Anfragenprüfungen | 7/7 | Fünf konfigurierte Auslöser und zwei gewöhnliche Produktanfragen |
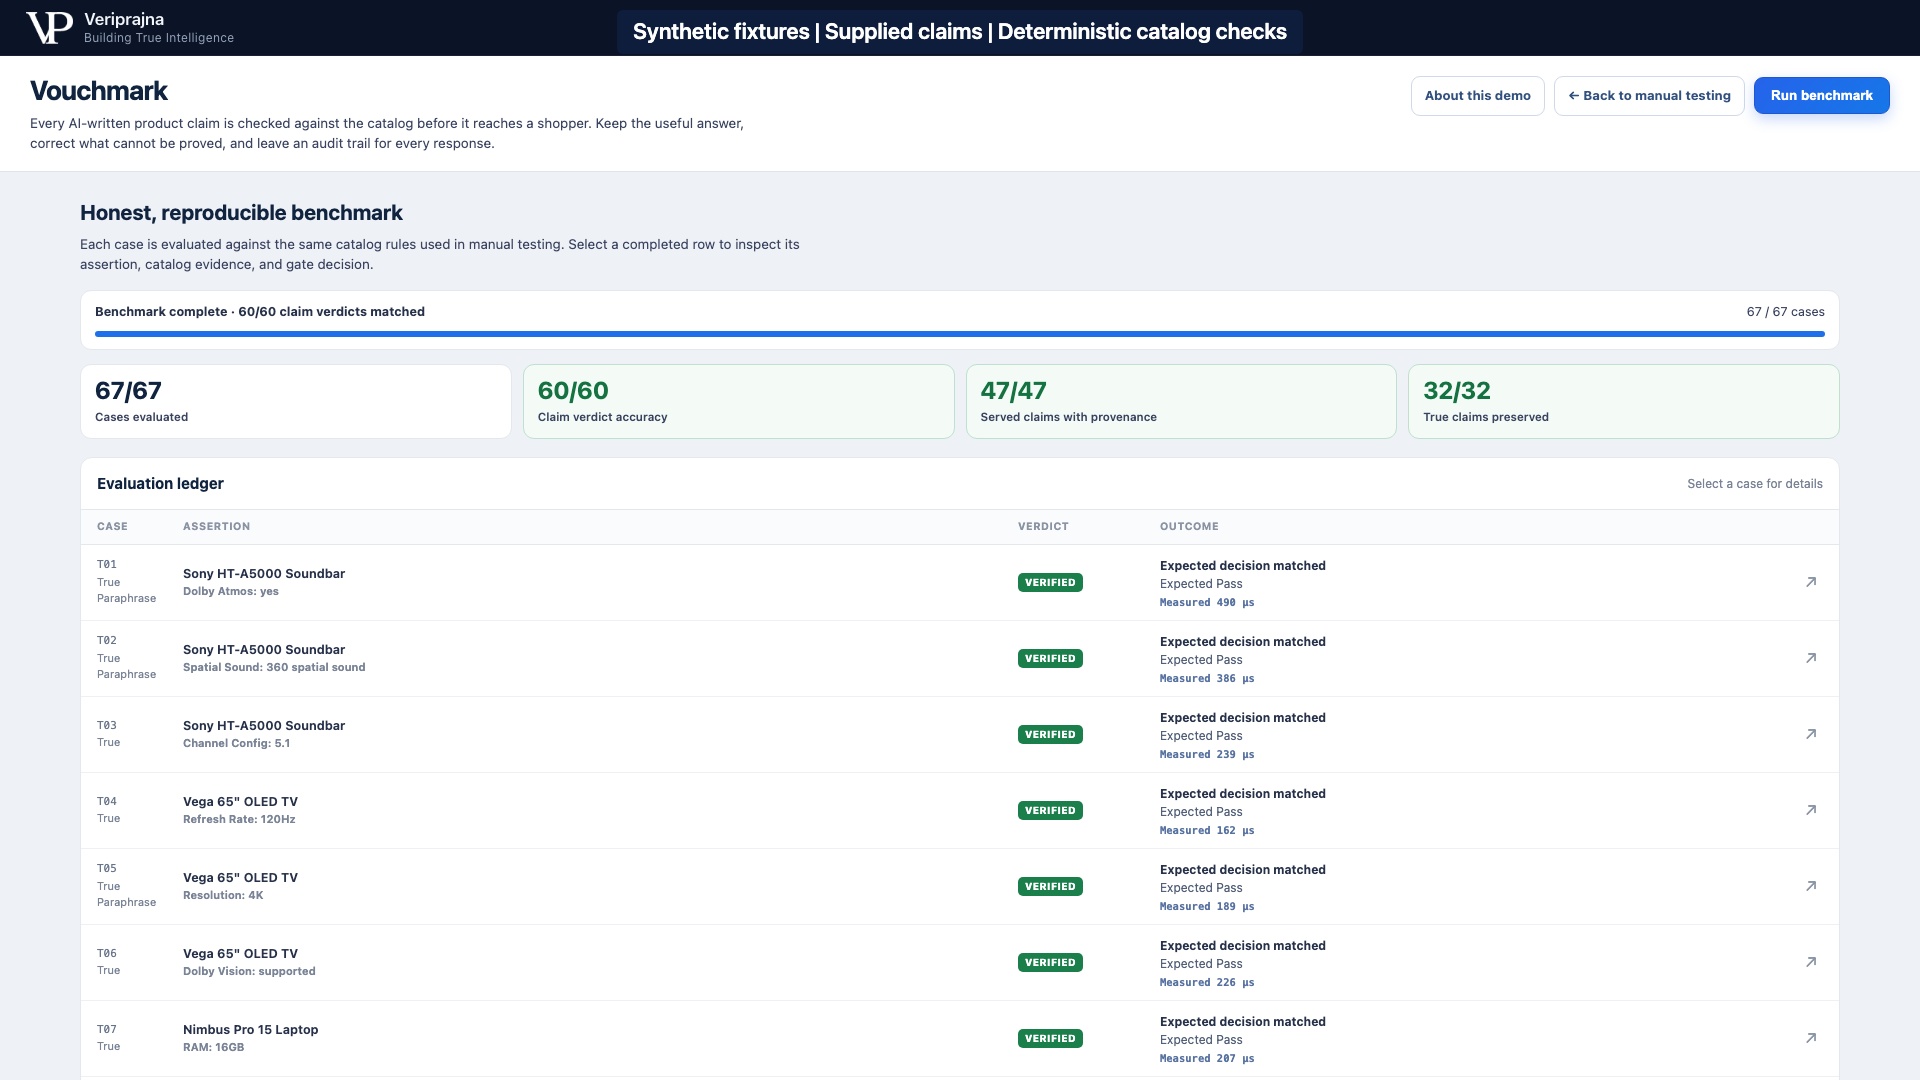
Das Buchungsjournal kombiniert verschiedene Testeinheiten. Seine Gesamtzahl von 67 bedeutet weder 67 Produktbehauptungen noch 67 Eskalationen an Fachpersonal. Das Vorhandensein von Referenzstrings erklärt, wohin eine Fixture-Entscheidung verweist; es authentifiziert keine externe Herstellerquelle.
Dies sind Architekturentscheidungen für die Prüfung einer Assistenten-Antwort, keine Aussagen über Konkurrenzprodukte. Das Abrufen eines relevanten Katalogdatensatzes und das Abgleichen einer spezifischen Aussage gegen diesen sind unterschiedliche Schritte.
| Prüfansatz | Was der TV-Fall offenlegt | Offene Frage |
|---|---|---|
| Gesamten Entwurf annehmen | Behält sowohl HDR10+ als auch 120Hz bei | Welche Aussage widerspricht dem Datensatz? |
| Gesamten Entwurf ablehnen | Entfernt auch das unterstützte Detail der Bildwiederholfrequenz | Welche nützliche Behauptung könnte bewahrt werden? |
| Katalogprüfungen auf Behauptungsebene anwenden | Korrigiert HDR und behält die Bildwiederholfrequenz bei | Wurden die relevanten Behauptungen extrahiert und ist der Katalog intakt? |
Dies ist eine Demonstration lokaler Regeln auf synthetischen Eingaben, kein Store-Deployment. Es sind keine Store-, PIM-, Checkout-, Zahlungs- oder Fachpersonal-Konnektoren implementiert, und die Handels-Steuerelemente führen keine Transaktionen aus. Die konfigurierte medizinische Prüfung zeigt eine Verweigerung und ein vorgeschlagenes Apotheker-Ziel; sie kontaktiert kein medizinisches Fachpersonal.
Die Demo garantiert keine vollständige Behauptungsextraktion, keine korrekten Katalogdaten, keine lückenlosen Implikationsprüfungen und keine Leistung bei ungesehenen Antworten. Belege sind prüfbare Exporte, keine signierten Datensätze oder ein dauerhaftes Prüfarchiv. Ein Produktiveinsatz erfordert eine unabhängige Validierung dieser Systemgrenzen.
Vouchmark demonstriert separate Entscheidungen für einzelne Behauptungen. Im synthetischen Vega-TV-Beispiel korrigiert es HDR10+ auf den Katalogwert HDR10 und bewahrt die unterstützte Aussage zur 120Hz-Bildwiederholfrequenz.
Ein als unbekannt gekennzeichnetes Attribut erzeugt eine Enthaltung (Abstain); ein fehlendes Produkt oder Attribut erzeugt Outside-Coverage. Im synthetischen Regenjacken-Beispiel lehnt die angezeigte Antwort eine Bestätigung voller Wasserdichtigkeit ab, weil die Einstufung unbekannt ist.
Die Katalogurteile und die aktuelle Vollständigkeitsregel sind deterministische Python-Regeln. Nur die Freiform-Behauptungsextraktion kann optional ein Modell nutzen; die vorbereiteten Beispiele liefern ihre Behauptungen mit und messen keine Modellextraktion.
Die Demo liest einen lokalen synthetischen Katalog und Richtliniendatensätze aus. Store-, PIM-, Checkout- und Fachpersonal-Integrationen sind nicht implementiert; ein Produktiveinsatz erfordert separate Integrations- und Validierungsarbeiten.
Alle 60 bereits zerlegten Behauptungsfälle stimmen in der festen gelabelten synthetischen Evaluation mit ihren verfassten erwarteten Urteilen überein. Die sieben Anfragenprüfungsfälle sind eine separate Testeinheit; keines der Ergebnisse misst Extraktionsvollständigkeit, ungesehenen Käufer-Traffic oder Produktionsleistung.
Die Prüfbelege in JSON und druckbarem HTML bewahren den Eingabeentwurf, die angezeigte Antwort sowie Behauptung, Katalogwert, Entscheidung, Konfidenz-Label und Referenz pro Behauptung auf. Referenzen sind verfasste Fixture-Metadaten; der Beleg ist keine digitale Signatur, kein unveränderliches Archiv und kein dauerhafter Prüfspeicher.
Entdecken Sie verwandte Forschung für einen breiteren Kontext zu dieser Demonstration.
Beginnen Sie mit dem Katalog, der Antwort und den Entscheidungsgrenzen.
Wir können die Prüfungen, Regeln für fehlende Daten und Evaluationen besprechen, die Ihre Produktantworten benötigen. Die Demonstration ist ein Ausgangspunkt für dieses Architekturgespräch.