La línea base ingenua de mi detector de caídas por radar logró el mismo 1.0 de recall. También disparó siete falsas alarmas en una noche.

En el turno de noche sintético que construí para Vigil, la línea base comercial activa nueve alertas entre las 02:00 y las 06:00, y siete de ellas son erróneas. Un ventilador de techo, captado a una velocidad máxima de 5.0 m/s. Un perro de terapia, con una sección transversal de radar de 0.27. Un residente sentándose bruscamente en un asiento a 2.92 m/s. Dos de esas nueve alertas son caídas reales, y una de ellas ocurre en un baño: una trayectoria del centroide que va desde 1.53 m de pie, bajando por 1.07, 0.84, 0.625 y 0.344 antes de estabilizarse en 0.119 m, nivel del suelo, respiración presente, sin recuperación.
Cada evento de ese turno es sintético, etiquetado y con base física, generado a partir de una semilla fija, y yo escribí ambos detectores. Por eso puedo decir la parte incómoda con total franqueza: la línea base también captó esa caída en el baño.
Vigil es la capa de inteligencia que construí para situarse entre un flujo de características de radar y un sistema de llamada a enfermería en residencias de mayores. Devuelve ALERT, SUPPRESS o ROUTE TO HUMAN, con un motivo adjunto a cada decisión que el centro puede archivar. La ruta de la demo es https://veriprajna.com/demos/smart-facility-fall-detection. Comencé el desarrollo asumiendo que la parte difícil era ver la caída. El benchmark discrepó conmigo en la primera ejecución.
El recall era la métrica con la que quería abrir
Ejecuté el benchmark esperando que la sensibilidad ante caídas fuera el titular, y es una buena cifra: 1.0 de recall para la cascada sobre un conjunto fijo de 360 eventos sintéticos ruidosos y etiquetados. La columna de al lado es lo que cambió el artículo que creía estar escribiendo. La línea base ingenua consta de dos cláusulas aritméticas: cualquier movimiento rápido o bajo es una caída (peak_v > 2.0 OR min_cz < 0.45), y sobre el mismo conjunto también obtiene 1.0 de recall. La sensibilidad es donde vive el marketing de detección de caídas, y ambos detectores están anclados en lo más alto.
La separación radica por completo en la fila que nadie pone en una diapositiva. La especificidad frente a factores de confusión es de 1.0 para la cascada y de 0.167 para la línea base, una tasa de falsas alarmas de 0.833 por evento benigno. Proyéctese eso a los 30 disparadores de movimiento benigno por habitación al día que asume el benchmark, y la línea base llega a 25.0 falsas alarmas por habitación y día. El rango publicado para los sensores comerciales tradicionales es de 5 a 15 falsas alarmas por habitación al día, y la fatiga por alarmas, más que la sensibilidad del sensor, está documentada como la causa principal por la que estos despliegues fracasan.
Debo decir esto antes de que un lector técnico lo diga por mí. Los pesos de fusión en data/fall_model.json fueron ajustados por tools/fit_fall_classifier.py a partir de los propios generadores de escenarios de la demo, los mismos generadores que producen el conjunto de 360 eventos. Esa es la objeción más sólida que cualquiera puede plantear contra mis dos 1.0, y es también la razón por la que me importa más el 0.167 que cualquiera de ellos. El fallo de la línea base no es un artefacto de mi configuración de entrenamiento. Es lo que hace un umbral cuando el mundo contiene ventiladores de techo.
Las siete falsas alarmas deciden si alguien sigue escuchando cuando llega la real.
Los factores de confusión se diseñaron para derrotar a una sola característica
Mi primer instinto fue mejorar el clasificador, y fue el instinto equivocado. Pasé la primera parte del desarrollo tratando esto como un problema de discriminación: encontrar la característica que separa una caída de una no caída, ponderarla con fuerza y seguir adelante. Los generadores de escenarios que ya había escrito hicieron que eso fuera imposible a propósito.
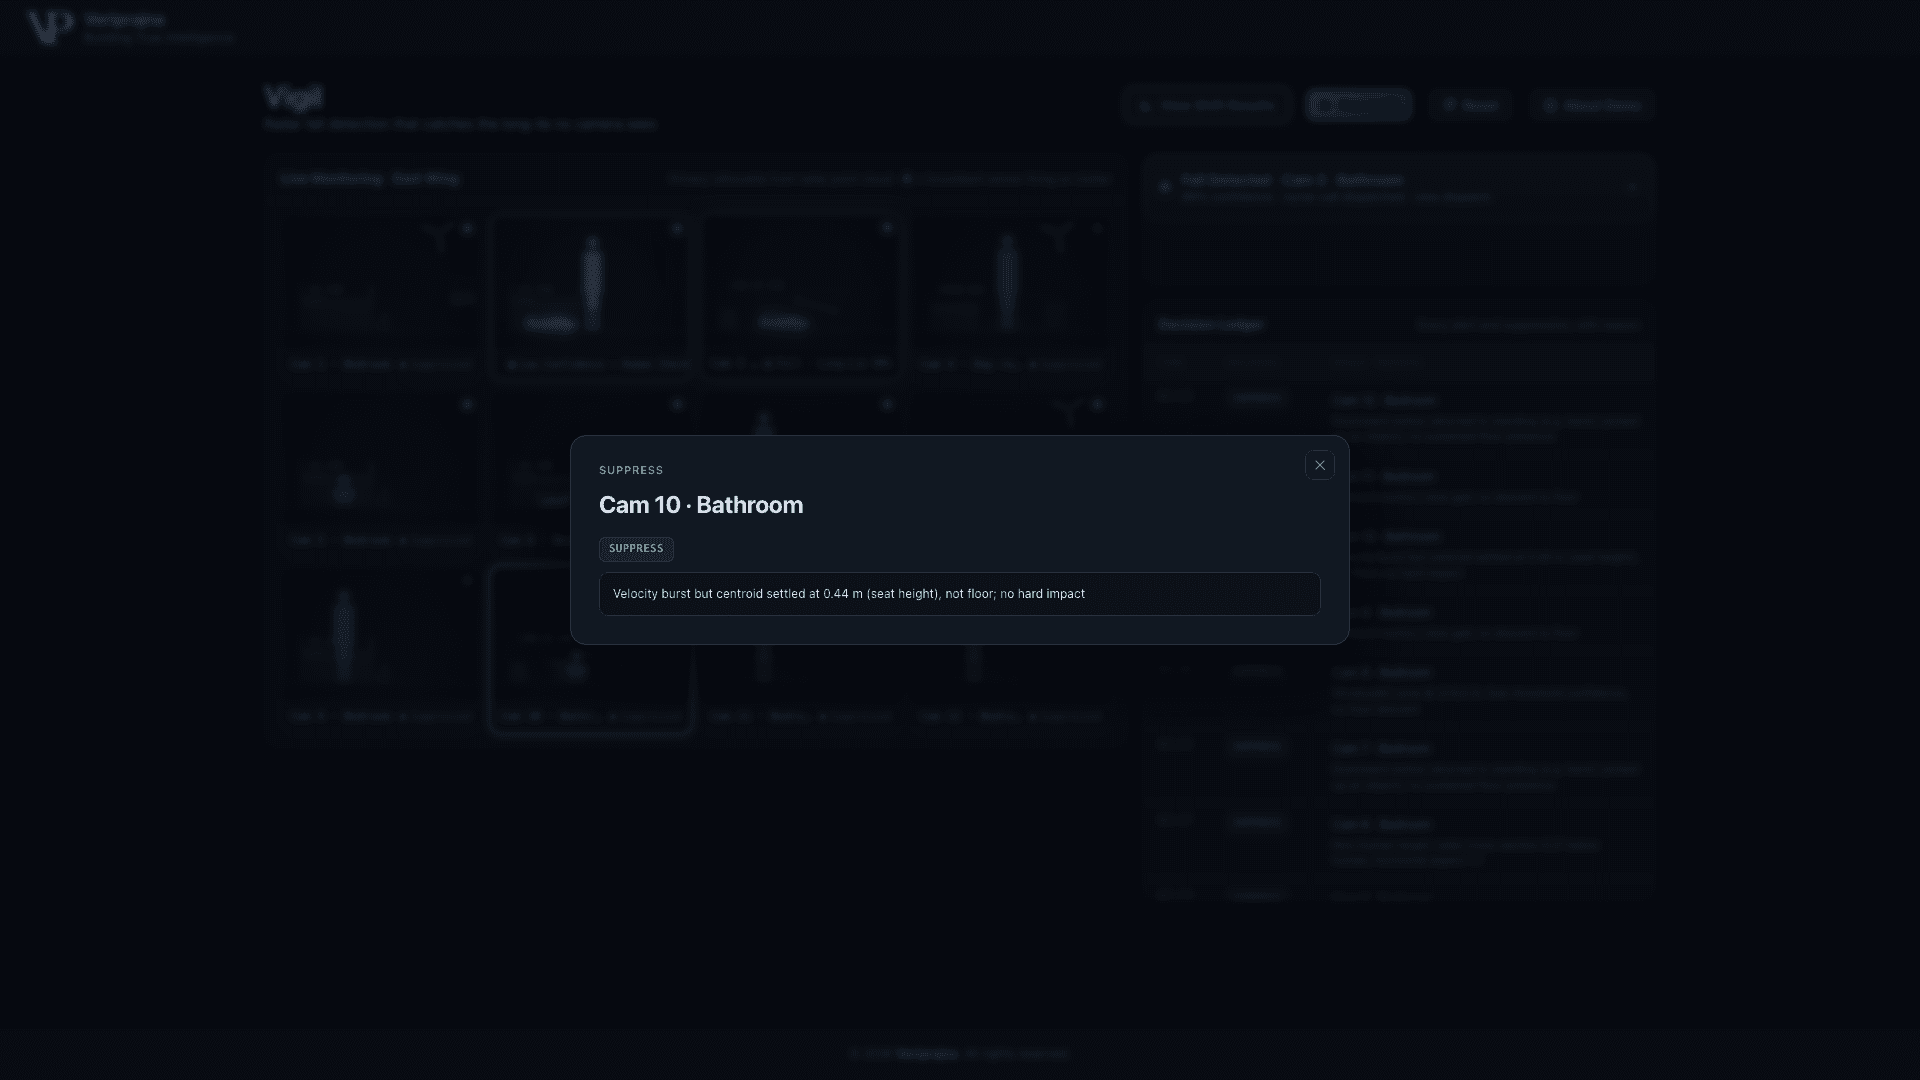
Cada factor de confusión se genera para solaparse con una caída real en alguna característica individual. La sentada brusca en Cam 5 conlleva un pico de velocidad de 2.92 m/s, la magnitud de una caída, y se estabiliza en 0.46 m. Su prima del baño en Cam 10 alcanza un pico de 3.31 m/s y se estabiliza en 0.44 m. Tanto el perro de terapia como el agacharse a recoger una toalla bajan el centroide, que es la otra mitad de la regla de la línea base. Cualquier prueba individual que pudiera escribir quedaba superada por diseño, razón por la cual la línea base es genuinamente engañada con un 0.167 en lugar de ser engañada por un hombre de paja creado para perder.
La velocidad era la característica de la que estaba más seguro, y es la que no sobrevivió en el clasificador. Lo que sobrevivió es un modelo logístico sobre cuatro características: proximidad al suelo, energía del impacto, caída de descenso y una aproximación a la sección transversal de radar, fusionadas en una P(fall) calibrada. Ningún término de velocidad llega a P(fall) en absoluto. Todavía queda una línea obsoleta en el docstring del módulo de cuando pensaba que sí lo haría. Es puro numpy, lo bastante pequeño como para que alguien pueda abrir classifier.py y retenerlo todo en la cabeza, lo cual, en una ruta crítica para la seguridad vital, vale más para mí que otro punto de AUC.
Pongo la supresión de Cam 10 ante la gente en primer lugar, porque el panel expone toda la discrepancia en una sola línea.
Cuatro condiciones, una ventana de 8 segundos
Escribí el verificador narrativo temporal como la pieza que a mí me gustaría leer como observador externo. temporal.py requiere cuatro condiciones dentro de la misma ventana de 8 segundos, con la bipedestación establecida en su quinto inicial: una mediana del centroide por encima de 1.2 m, un descenso superior a 0.6 m junto con una velocidad máxima por encima de 1.8 m/s en algún punto de la ventana, un impacto sostenido de banda ancha cuya media móvil de 3 fotogramas supera 0.50, y el centroide situándose efectivamente por debajo de 0.30 m. La prueba de impacto sostenido existe porque un pico de un solo fotograma cuesta poco y un cuerpo golpeando el suelo no.
La cadena de motivo que emite la aplicación dice "standing → descent → impact → floor", que es como el personal de enfermería interpreta un incidente, pero la implementación combina esas condiciones con un operador AND a lo largo de la ventana en lugar de imponer un orden. No es una máquina de estados, y prefiero escribirlo yo mismo antes de que un ingeniero lo descubra en el código fuente y se pregunte qué más se redondeó en el texto descriptivo.
Solo entonces la compuerta añade la confirmación de respiración por encima de 0.20 y una confianza de caída de al menos 0.70. Esos tres valores —nivel del suelo en 0.30 m, respiración en 0.20 y el umbral mínimo de confianza de 0.70— residen en código puro fuera de cualquier modelo. La dirección es lo que importa: las condiciones deterministas deben cumplirse antes de consultar siquiera la puntuación del modelo, por lo que un valor de confianza nunca puede fabricar una alerta por sí solo. Un P(fall) más bajo aún puede convertir una ALERT en un SUPPRESS, que es la asimetría adecuada para una capa a la que se le permite permanecer en silencio y no se le permite inventar. Otro umbral determinante se sitúa fuera de ese bloque documentado, un valor fijo p_fall >= 0.40 en gate.py que puede enviar un evento de ocupación múltiple a revisión humana basándose únicamente en la puntuación del modelo. Lo menciono porque, de lo contrario, "tres umbrales documentados" estaría presumiendo de más de lo que merece.
Las supresiones son el registro que una inspección estatal realmente solicita
Construí el Decision Ledger antes de construir nada que se pareciera a un producto, porque la pregunta que no podía responder nunca fue "¿la detectaste?". Era "¿por qué no se activó ninguna alerta en la habitación 203 a las 2:13?", y la respuesta ya debe constar en un registro escrito para cuando cualquiera pregunte. Diez de los doce eventos del turno son supresiones, y cada uno lleva registrado el valor de la característica correspondiente: el objetivo no humano de Cam 6 con una sección transversal de radar de 0.27 frente al mínimo humano de 0.55; las inclinaciones de Cam 7 y Cam 12 donde el centroide se detiene en 0.60 m y 0.59 m con una energía de impacto de 0.07 frente a un umbral de 0.50.
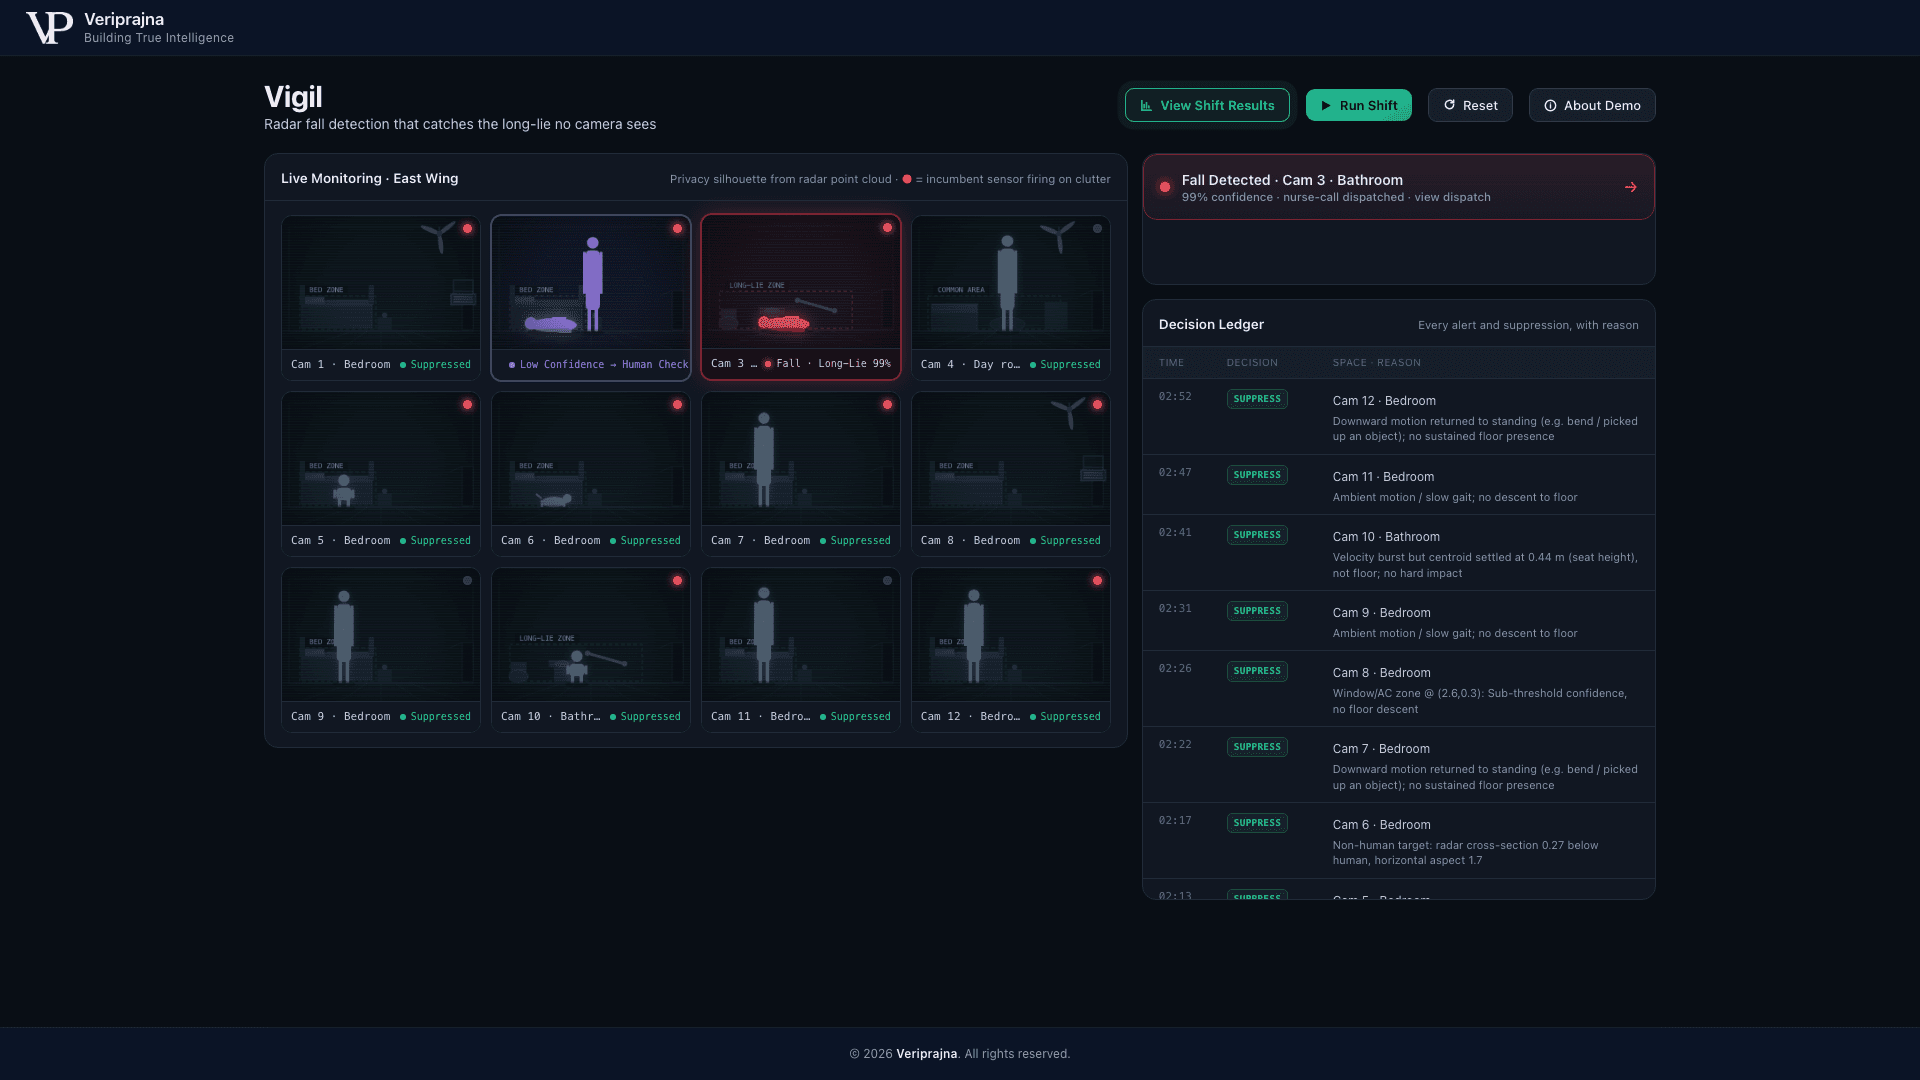
Esas diez filas suprimidas son sobre las que pregunta un inspector, porque son los eventos en los que no ocurrió nada y alguien aún tiene que explicar por qué.
Solo una parte de la calibración por habitación está realmente conectada a una decisión. El ventilador de techo de Cam 1 se suprime porque el mapa de clutter de la habitación 214 contiene una entrada Doppler de ubicación fija en (1.5, 1.5, 2.45 m) y check_clutter lo enmascara en ese vóxel. Esa ruta es real. Las alturas de asientos y camas por habitación en rooms.json, 0.42 m en el baño de la habitación 118 y 0.45 m en la habitación 203, junto con las entradas de barras de apoyo contiguas, son datos de calibración que ninguna ruta de código de la V1 lee; la franja de asiento que utilizo para etiquetar una sentada brusca es una prueba global de 0.38 a 0.60 m. Incluso figura long_lie_sec: 180.0 como clave en ese archivo que nada consume. La calibración por habitación es el trabajo de integración por el que paga un despliegue real, y en esta versión solo las máscaras Doppler están conectadas a una decisión.
La exportación es un JSON de auditoría del turno que cubre cada alerta, derivación y supresión con sus valores de características determinantes y el motivo de política, que es lo que exige una carpeta de CMS F689 o QAPI. La nota clínica del incidente se redacta por separado a partir de esa evidencia estructurada y se muestra en el panel de incidentes, no dentro del JSON.
La alerta que le permití emitir y la caída que no le permití afirmar
Situé el punto culminante del turno en un baño deliberadamente. Es la estancia de mayor riesgo y el único lugar donde una cámara no es una opción viable: diecinueve estados de EE. UU. han promulgado leyes que regulan las cámaras en las habitaciones de residencias de ancianos, permitiéndolas generalmente en la habitación del residente con su consentimiento, mientras que los baños quedan excluidos en la práctica por motivos de privacidad. Las características de radar no transportan imágenes, y esa es precisamente la razón por la que pueden llegar donde una cámara no puede.
Cam 3 es ese evento, y Vigil devuelve ALERT, categoría long_lie, confianza 0.99, tiempo en el suelo 4.8 s, con la escala de derivación escalonada armada en auxiliar de enfermería (CNA) de inmediato, enfermero encargado (Charge Nurse) a los 90 s y director de enfermería (DON) a los 180 s. El texto del distintivo de llamada a enfermería indica "Room 118B Bathroom: Fall Detected, 99% confidence. Resident on floor 5s. Breathing confirmed.". El despacho emite tanto una señal heredada de contacto seco de Rauland como una carga útil MQTT/REST de Ascom/Austco, y ambas pasan a través de un stub de adaptador registrado. Ningún hardware de llamada a enfermería está conectado a nada de esto. La razón por la que vale la pena construirlo de todos modos es la permanencia prolongada en el suelo: la mitad de los adultos mayores que yacen en el suelo durante más de una hora mueren en un plazo de seis meses.
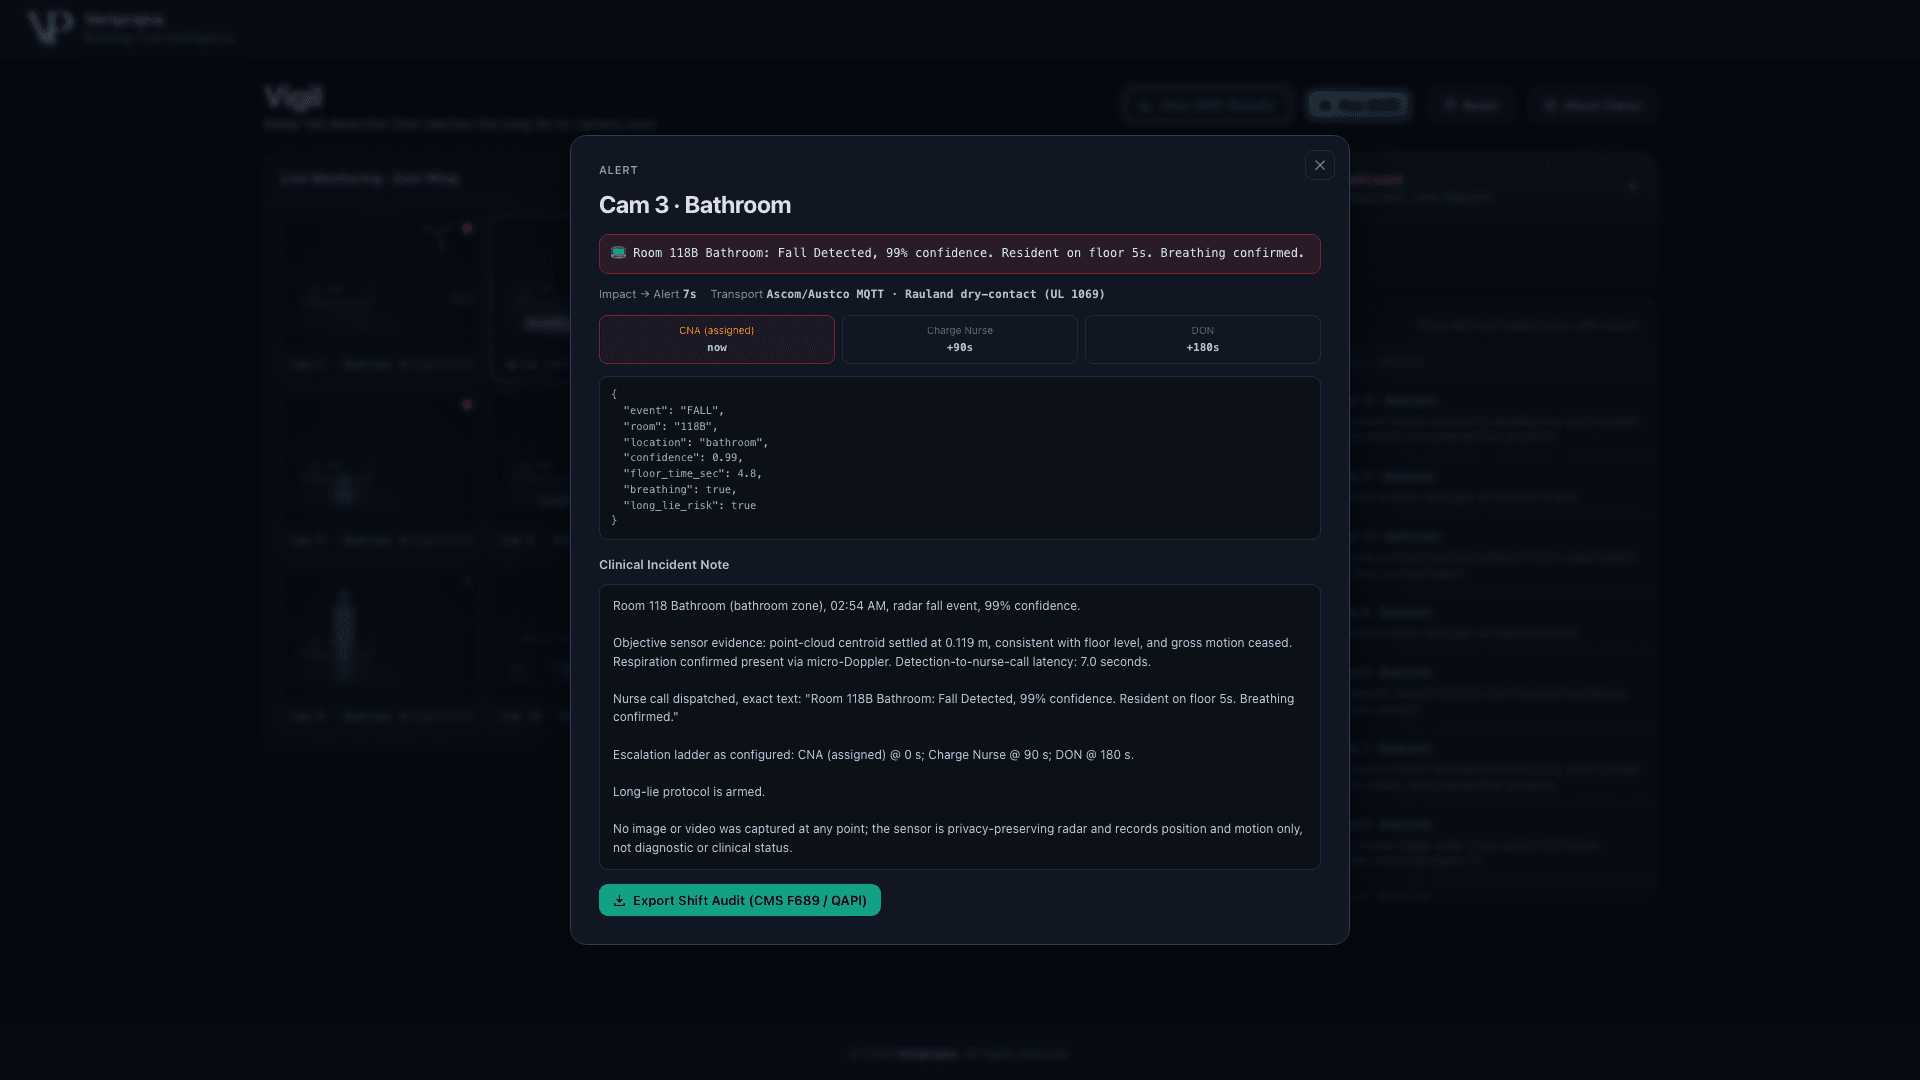
Hay un número en ese panel que me niego a vender. Los 7.0 segundos desde el impacto hasta la alerta se calculan en gate.py como el temporizador de retención más tres segundos, una constante. La aplicación lo muestra, y citaré lo que muestra en pantalla, pero es aritmética y no una velocidad del sistema medida en la práctica, y llamarlo latencia de referencia en benchmark sería la clase de pequeña falsedad que te cuesta las grandes verdades que tiene al lado.
El evento del que estoy más orgulloso es aquel que Vigil declina. Cam 2 es una caída real según el ground truth y P(fall) alcanza 0.99, y aun así Vigil no la afirma: la habitación contiene dos objetivos, el seguimiento de una sola persona queda fuera de la cobertura de la V1 y la compuerta devuelve ROUTE TO HUMAN con baja confianza. La línea base ingenua se dispara automáticamente y se atribuye el mérito de una detección que no se ganó. En ese turno ocurrieron dos caídas reales. Vigil alertó sobre una y envió la otra a comprobación por parte del personal, y no voy a describir eso como capturar todas las caídas, porque no es así. A lo largo del benchmark, 40 de 40 caídas con ocupación múltiple se derivan a un humano, sin alertas excesivas y sin omitir ninguna.
Lo que el marcador tiene permitido afirmar
La línea de salvedad debajo del modal Shift Results es la primera parte de ese panel que redacté. El modal informa 0 falsas alarmas para el motor frente a 7 del sistema tradicional en este turno, 1 de 2 caídas reales detectadas, 1 derivada a un humano, 100% de especificidad frente a factores de confusión sobre 360 eventos etiquetados, y 0.0 frente a 25 falsas alarmas proyectadas por habitación y día.
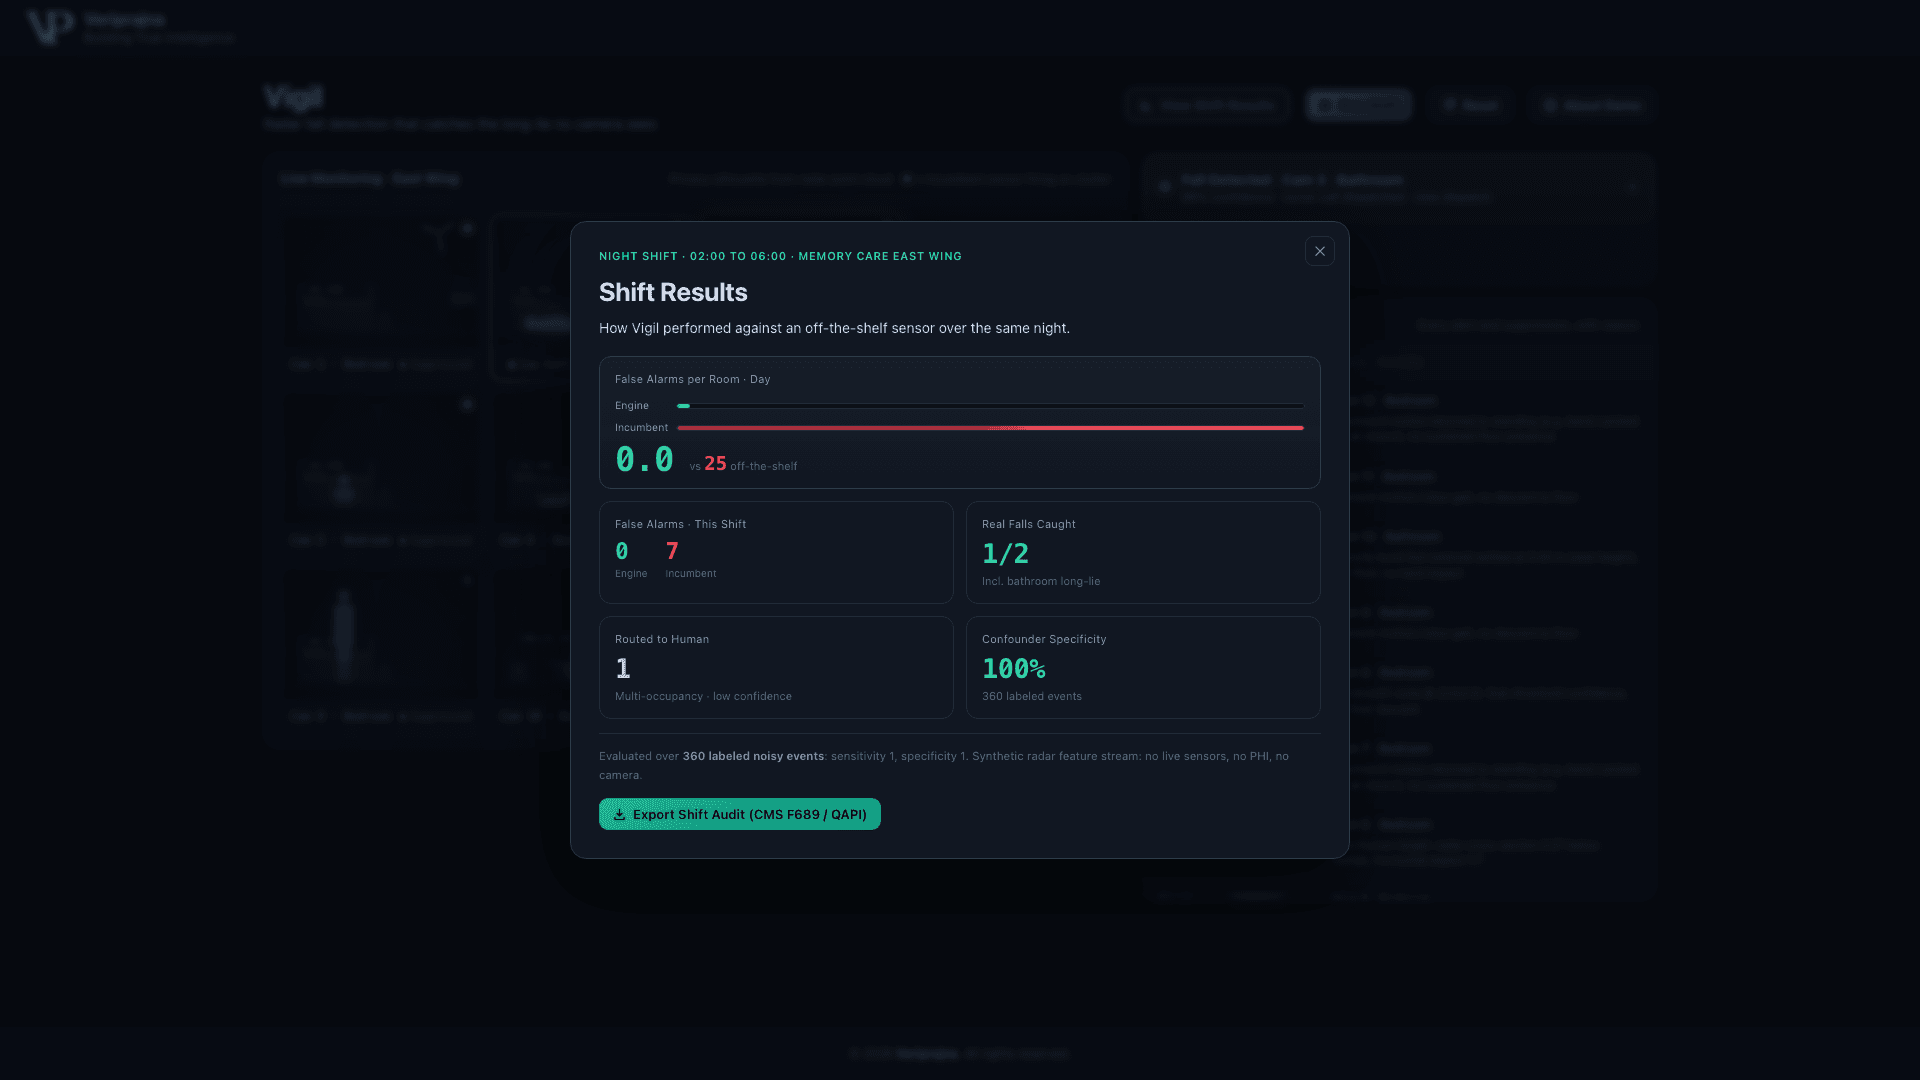
Esas cifras describen un conjunto dorado sintético fijo y nada más. No representan precisión en producción, ni un resultado clínico, ni una afirmación médica validada, y jamás una garantía para un centro residencial. Un piloto real tiene como objetivo menos de 2 falsas alarmas por habitación al día tras la calibración en modo sombra, y esa es la cifra que pondría delante de un director de enfermería, porque es aquella de la que podría responsabilizarme. El 0.0 es prueba de que el mecanismo separa las caídas de los factores de confusión en un conjunto que puedo entregarte; no es una promesa sobre un edificio por el que nunca he caminado.
El estándar que ahora exijo a una alerta para la seguridad vital
Salí de este desarrollo con una definición mucho más estricta de aquello en lo que la detección de caídas debe ser buena. La detección es un umbral, y un umbral ya obtiene 1.0 de recall en mi propio conjunto de prueba. El trabajo que se gana la atención de una enfermera es la negativa: el mapa de clutter que sabe qué vóxel ocupa el ventilador, la prueba de impacto que no acepta un solo fotograma, la condición de alcance del suelo que distingue una sentada brusca de una caída, y una compuerta programada de modo que un inspector estatal, y no un modelo, pueda entender por qué el sistema hizo lo que hizo.
El recorrido completo se encuentra en https://veriprajna.com/demos/smart-facility-fall-detection, y las diez filas suprimidas en el registro son donde realmente se decide el turno.
Y si prefieres ver el turno en lugar de leerme describirlo, aquí tienes toda la noche ejecutándose de principio a fin.
Un sistema que activa alarmas por el ventilador de techo termina silenciado en menos de una semana, y un sistema silenciado no detecta absolutamente nada. El comportamiento más sofisticado que pude otorgar a esta capa fue la capacidad de declinar, de forma registrada, con la cifra determinante adjunta. En Cam 2 ese número era 0.99, y la decisión correcta seguía siendo transferir el evento a una persona.