סיכון רגולטורי ומוכנות לליטיגציה במערכות AI
אנו מכינים מערכות AI לבחינה משפטית יריבית: תיעוד ברמת ליטיגציה, שימור ראיות, מוכנות לגילוי מוקדם והגנה רב-שיפוטית.
האם מערכת ה-AI שלכם ניתנת להגנה תחת בחינה יריבית?
הגישה שלנו היא לבנות את התשתית הטכנית המתוכננת להפוך מערכות AI לניתנות להגנה תחת בחינה משפטית — לא ציות במובן של סימון תיבות, אלא ניתנות להגנה במובן שעורך דין ליטיגציה יכול להוליך חבר מושבעים דרך האופן שבו התקבלה החלטה, שנציג תאגידי לפי כלל 30(b)(6) יכול להעיד על התנהגות המערכת ללא היסוס, ושעד מומחה יכול לעמוד בהצלחה בפני אתגר Daubert בנוגע ליכולת הפירוש של המודל.
זוהי עבודת הנדסה, לא ניסוח מדיניות. התקשרות מוגדרת כך שתפיק ארכיטקטורות לשימור ראיות, תיעוד ברמת ליטיגציה, וחפצי מידע מוכנים לגילוי מוקדם הקיימים עוד לפני שמישהו מגיש תביעה.
אלה אינם סיכונים היפותטיים — אלה תיקים פעילים עם נזקים אמיתיים, צווי גילוי מוקדם אמיתיים ודרישות תיקון אמיתיות. השאלה עבור ארגונים הפורסים AI אינה האם הם חשופים לסיכון משפטי. השאלה היא האם המערכות שלהם יכולות לשרוד את מה שקורה בהמשך: גילוי מוקדם יריבי, חקירות של המהנדסים שבנו את המודלים, עדות מומחה על מקור נתוני האימון, ובחינות רגולטוריות שבהן "השתמשנו בכלי של ספק" אינה הגנה — עמדה שאותה אנו מחליפים בתשתית בבעלות עצמית, כפי שמוצג ב הדגמה פעילה של פריסת LLM ריבוני ופרטי.
כיצד נראה גילוי מוקדם בתיקי AI (ומדוע רוב החברות נכשלות בו)
בספטמבר 2025, המחוז הדרומי של ניו יורק קבע תקני גילוי מוקדם ל-AI בליטיגציית זכויות היוצרים של OpenAI. בתי המשפט כופים כעת הפקה של מערך בסיסי של חפצי מידע, ועורכי הדין של התובעים בתיקי אפליה אלגוריתמית הולכים רחוק בהרבה.
מערך הבסיס שבתי המשפט כופים כעת
- הנחיות משתמש
- פלטי מודל וטיוטות שנוצרו על ידי AI
- מטא-נתונים עם חותמות זמן ומזהי מודל
- יומני גישה
- הגדרות תצורה
מה שתובעי אפליה דורשים בנוסף
- קוד מקור
- הרכב נתוני האימון
- דוחות אימות מודל
- תוצאות בדיקות A/B
- הודעות Slack פנימיות על הטיה ידועה
- נתוני ניטור לאחר הפריסה
- כל גרסה של המודל שרצה בייצור במהלך התקופה הרלוונטית
רוב החברות נכשלות בגילוי מוקדם באחת משתי דרכים. או שהראיות אינן קיימות משום שאיש לא בנה את התשתית ללכידתן — מה שמוביל לסנקציות על השמדת ראיות ולהוראות מסקנה שלילית. או שהראיות קיימות אך נראות מזיקות, משום שתקשורת פנימית חושפת שמהנדסים סימנו חששות להטיה שמעולם לא טופלו, או ששינויי מודל נפרסו ללא בדיקה מתועדת.
הגישה שלנו מתמודדת עם שני אופני הכשל. עבור הראשון, אנו מתכננים מערכות לשימור ראיות שילכדו הקשר החלטה באופן אוטומטי בזמן ההסקה: תמצית גרסת המודל, מאפייני הקלט, מצב העיבוד המקדים, ציוני הביטחון ומדיניות הממשל הפעילה. עבור השני, אנו מתכננים תהליכי ניהול שינויי מודל מובנים שבהם כל שינוי מתועד עם נימוק, תוצאות בדיקה ושרשראות אישור — כך שרשומת הגילוי המוקדם מספרת סיפור קוהרנטי של פיתוח אחראי במקום איטרציה מבולגנת.
לוח האכיפה הרגולטורי אינו ממתין
שלושה מועדי אכיפה מרכזיים מתכנסים באמצע 2026.
- Colorado SB 205 נכנס לתוקף 30 ביוני 2026, עם קנסות עד $20,000 לכל הפרה והגנה חיובית הזמינה רק לארגונים המדגימים ציות ל-NIST AI RMF.
- חובות הסיכון הגבוה של חוק ה-AI של האיחוד האירופי מתחילות באכיפה 2 באוגוסט 2026, עם קנסות המגיעים ל-EUR 35 מיליון או 7% מהמחזור הגלובלי. סעיף 73 מחייב הודעה על תקרית חמורה תוך יומיים במקרי מוות או שיבושים בתשתיות קריטיות, ותוך 15 ימים עבור תקריות אחרות.
- אכיפה קיימת של תובעים כלליים במדינות כבר פעילה: מסצ'וסטס הגיעה להסדר בעניין אפליה במתן הלוואות באמצעות AI ביולי 2025, ו-36 תובעים כלליים במדינות התנגדו רשמית לתפיסת סמכות פדרלית כדי לשמר את סמכות האכיפה שלהם.
נוף האכיפה סותר את עצמו באופן פנימי. ה-CFPB הציע לסיים את אכיפת ההשפעה הבלתי-שוויונית תחת ECOA בנובמבר 2025, בעוד תובעים כלליים במדינות הגישו תביעות אפליה של AI תחת חוקי UDAP עם קנסות לכל הפרה. ה-FTC הפך את צו ההסכמה שלו בעניין Rytr בפברואר 2026, ואז הוציא מסגרת אכיפה מקיפה לסוכני AI במרץ 2026.
ארגונים שבנו תוכניות ציות לאות רגולטורי יחיד חשופים כאשר אותו אות משתנה. הגישה שלנו היא לתכנן ארכיטקטורות הגנה הממופות לחובות עצמן, ולא לעמדתו הנוכחית של רגולטור יחיד כלשהו (מבוסס על המחקר שלנו על אחריותיות אלגוריתמית).
תיעוד ברמת ליטיגציה לעומת תיעוד ציות
יש הבדל משמעותי בין תיעוד המספק ביקורת ציות לבין תיעוד השורד בחינה משפטית יריבית.
| תיעוד ציות | תיעוד ברמת ליטיגציה |
|---|---|
| עונה על "האם עקבתם אחר התהליך?" | עונה על "הוכיחו שההחלטה הספציפית הזו לא הייתה מפלה — עם ראיות שמומחה מנגד אינו יכול לפרק בחקירה נגדית." |
| כרטיסי מודל המיועדים למתרגלי ML | תיעוד מודל שהוכן לשימוע Daubert |
הקהל, הביקורת היריבית ותקן הראיות שונים באופן מהותי.
התקשרות מוגדרת כך שתפיק תיעוד בתקן ברמת ליטיגציה: כל החלטת AI מהותית ניתנת לשחזור מתוך הרשומה שלה — גרסת המודל המדויקת, נתוני הקלט, ערכי המאפיינים, מצב צינור העיבוד המקדים והלוגיקה של ההחלטה ניתנים לאחזור חודשים או שנים לאחר מעשה.
הגנות ספציפיות לתחום שאנו מתעדים
- AI תעסוקתי: הגנת הרלוונטיות לתפקיד וההכרח העסקי (מסגרת העברת הנטל של Griggs/Wards Cove תחת Title VII), מתועדת ברמת עיצוב המערכת ולא כרציונליזציה לאחר מעשה.
- AI במתן הלוואות וביטוח: מתודולוגיית בדיקת השפעה בלתי-שוויונית מתועדת בקפדנות מספקת כך שמומחה סטטיסטי של תובע אינו יכול לתקוף את הבדיקה כבלתי מספקת.
- AI בתחום הדיור: שרשרת הראיות המראה שהיחס לבעלי שוברים לא נעשה בעקיפין דרך היסטוריית אשראי או גורמי חוב — וקטור התקיפה המדויק בליטיגציה מסוג SafeRent, שבה האלגוריתם דירג מועמדים באמצעות גורמים שהפלו באופן לא פרופורציונלי שוכרים שחורים והיספנים (מפורט ב המחקר שלנו על מנדט השלמות האלגוריתמית של SafeRent).
גילוי מוקדם מדומה: מציאת החולשות שלכם לפני שהצד שכנגד עושה זאת
התקשרות יכולה לכלול תרגילים יריביים שבהם המהנדסים שלנו נוטלים את תפקידו של מומחה טכני של תובע, ובוחנים את מערכות ה-AI שלכם לאיתור החולשות שליטיגציה תנצל:
- שינויי מודל לא מתועדים
- מאפייני הוגנות לא נבדקים בקבוצות מוגנות
- הערכות השפעה חסרות
- פערים במסלול הביקורת
- תקשורת פנימית הסותרת מדיניות שפורסמה
- פערים במקור הנתונים המערערים על טענות שלמות נתוני האימון
התרגיל מתוכנן להפיק הערכה חסויה — תחת חיסיון עורך דין-לקוח כאשר משולב עם ייעוץ משפטי חיצוני — החושפת חולשות לפני שהן הופכות למוצגים בבית המשפט.
זהו אינו תרגיל שולחני. אנו מנסחים את השאלונים ובקשות המסמכים שהצד שכנגד היה מגיש, מזהים את שומרי המסמכים שקבצֿיהם היו נסרקים, בודקים האם מערכות השימור לוכדות את מה שבתי המשפט דורשים (לפי תקני הגילוי המוקדם של AI של SDNY משנת 2025), ומעריכים האם נציג ה-30(b)(6) שלכם יכול להעיד מבלי ליצור יותר חשיפה משהוא פותר. התפוקה המיועדת היא מפת דרכים לתיקון המאורגנת לפי חומרת סיכון הליטיגציה, עם מפרטים הנדסיים לסגירת כל פער.
הגנה רב-שיפוטית ללא תוכניות מקבילות
חברה עם לקוחות באיחוד האירופי, עובדים בקולורדו, מועמדים לעבודה באילינוי ופעילות ביטוחית באחת מ-23 המדינות שאימצו את בולטין מודל ה-AI של NAIC ניצבת מול לפחות חמישה משטרים רגולטוריים חופפים עבור מערכת AI יחידה. בניית תוכניות ציות נפרדות לכל תחום שיפוט אינה מתרחבת, והיא יוצרת חוסר עקביות שעורכי הדין של התובעים מנצלים:
"אמרתם לרגולטורים בקולורדו שמתודולוגיית בדיקת ההטיה שלכם היא X, אך הערכת ההתאמה שלכם באיחוד האירופי מתארת אותה כ-Y. מה נכון מבין השניים?"
הגישה שלנו היא לבנות מסגרת הגנה מאוחדת שבה התקן המחמיר ביותר החל קובע את קו הבסיס.
- פרוטוקול בדיקת השפעה בלתי-שוויונית העונה על תקן האפליה האלגוריתמית של Colorado SB 205 מפיק בו-זמנית ראיות לדרישות ממשל הנתונים של סעיף 10 בחוק ה-AI של האיחוד האירופי ולהגנת ההכרח העסקי של Title VII.
- נוהל תגובה לתקריות העונה על לוח הזמנים של הודעה תוך יומיים לפי סעיף 73 עונה אוטומטית על חלון 72 השעות של חוק ה-RAISE של ניו יורק ועל ציפיות ההודעה של תובעים כלליים במדינות.
שכבות תיעוד ספציפיות לתחום שיפוט מייצרות את חפצי המידע הנכונים עבור כל רגולטור או בית משפט מבלי לתחזק תוכניות מקבילות. כאשר חוק חדש של מדינה עובר או שמשרד ה-AI של האיחוד האירופי מוציא הנחיות אכיפה, שכבת הכיסוי מתעדכנת. בקרות הבסיס משתנות לעתים רחוקות, משום שהן כבר בנויות לרף הגבוה ביותר.
אחריות ברמת הדירקטוריון ושאלת חובת הנאמנות
כשלים בממשל AI יוצרים סיכון לאחריות אישית עבור דירקטורים תחת תקן Caremark של דלאוור. דירקטוריונים שאינם מיישמים מערכות דיווח לסיכון AI ניצבים בפני תביעות נגזרות של בעלי מניות. ה-SEC כלל את ה-AI בין עדיפויות הבחינה המובילות שלו לשנים 2025-2026, ומצופה מדירקטוריונים לתעד מסגרות פיקוח על AI בהצהרות ייפוי כוח עד עונת ייפוי הכוח של 2026.
התקשרות מוגדרת כך שתפיק את התוצרים הפונים לדירקטוריון המתוכננים לסגור פער זה:
- חומרי תדרוך למנהלים המתרגמים סיכון AI טכני לשפת ממשל
- מרשמי סיכונים הממופים לחובות נאמנות
- מערכות ניטור המספקות לדירקטורים ראיות מתועדות לפיקוח פעיל
לא מצגת שקופיות רבעונית — מערכת מידע מובנית המספקת את הבסיס להדגמת פיקוח בתום לב על סיכון AI, התקן הספציפי שדורש Caremark.
עיקרי הדברים
- ניתנות להגנה היא הנדסה, לא מדיניות: ארכיטקטורות לשימור ראיות, תיעוד ברמת ליטיגציה וחפצי מידע מוכנים לגילוי מוקדם חייבים להתקיים לפני הגשת התביעה.
- גילוי מוקדם של AI כופה כעת הנחיות, פלטים, מטא-נתונים, קוד מקור, נתוני אימון וכל גרסת מודל בייצור — לכדו הקשר החלטה בזמן ההסקה או הסתכנו בסנקציות על השמדת ראיות.
- שלושה מועדים בשנת 2026 מתכנסים: Colorado SB 205 (30 ביוני), חובות הסיכון הגבוה של חוק ה-AI של האיחוד האירופי (2 באוגוסט), והודעה על תקרית חמורה לפי סעיף 73.
- כלי ספק אינם מעבירים אחריות; מסגרת מאוחדת מבוססת-התקן-המחמיר עם שכבות כיסוי ספציפיות לתחום שיפוט עדיפה על תוכניות מקבילות לכל רגולטור.
- פיקוח הדירקטוריון על סיכון AI הוא כעת שאלת חובת זהירות לפי Caremark, הנתמכת בעדיפויות הבחינה של ה-SEC.
סיכון רגולטורי ומוכנות לליטיגציה במערכות AI
 צפייה
בינה מלאכותית אתית לשימור מנויים | Veriprajna
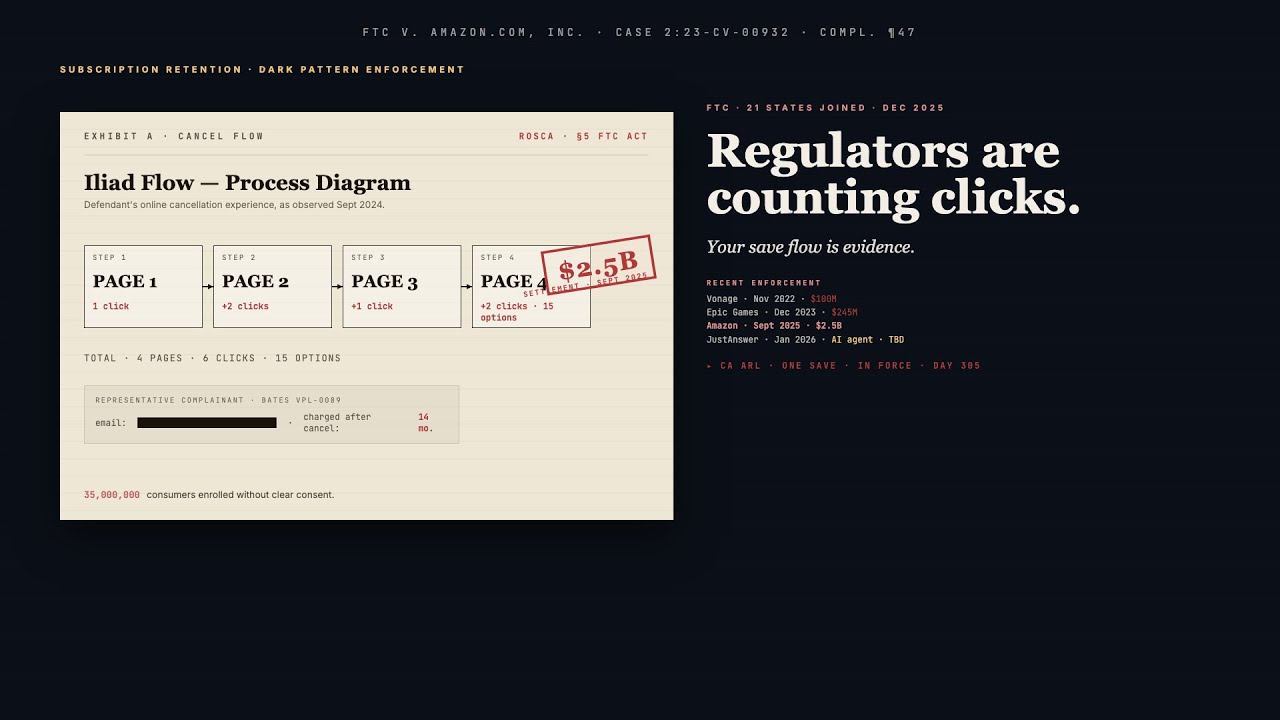
אמזון שילמה 2.5 מיליארד דולר עבור תהליך ביטול שדרש 6 קליקים. אובר ניצבת מול 21 תובעים כלליים של מדינות בגין 23 מסכים לביטול.
 צפייה
ציות AI בתחום הדיור: הוגנות בסינון דיירים ותמחור אלגוריתמי | Veriprajna
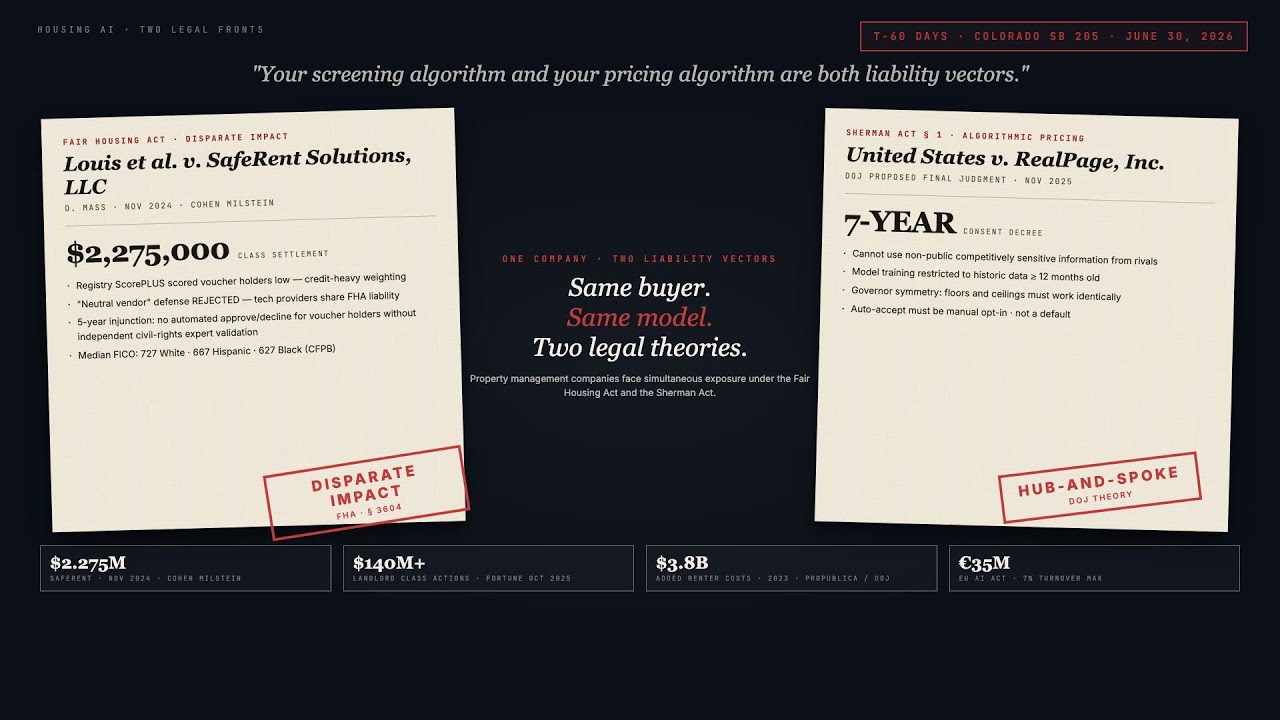
חברות לניהול נכסים ניצבות בפני חשיפה משפטית סימולטנית בשתי חזיתות: סינון דיירים המפלה תחת חוק הדיור ההוגן (Fair Housing Act), וניהול הכנסות המתאם תמחור תחת חוק שרמן (Sherman Act). אנו מבקרים את שניהם, מהנדסים ארכיטקטורות תואמות ציות, וממפים את המערכות שלכם מול כל תחום שיפוט שמשמעותי.
 צפייה
Sovereign AI ופריסת LLM פרטי | Veriprajna
אחד מכל חמישה ארגונים כבר ספג פריצה כתוצאה משימוש בכלי AI לא מורשים. איסור על AI לא עובד. בניית חלופות מאובטחות וריבוניות כן עובדת.
שאלות נפוצות
מה בדיוק דורש גילוי מוקדם בליטיגציית AI וכיצד אנו מתכוננים אליו?
בעקבות תקני הגילוי המוקדם של AI של SDNY מספטמבר 2025, בתי המשפט כופים כעת הפקה של הנחיות משתמש, פלטי מודל, טיוטות שנוצרו על ידי AI, מטא-נתונים עם חותמות זמן ומזהי מודל, יומני גישה והגדרות תצורה. עורכי הדין של התובעים בתיקי אפליה הולכים רחוק יותר: קוד מקור, הרכב נתוני אימון, דוחות אימות מודל, תוצאות בדיקות A/B, תקשורת פנימית על הטיה ידועה, וכל גרסת מודל בייצור במהלך התקופה הרלוונטית. ההכנה משמעה בניית תשתית לשימור ראיות הלוכדת הקשר החלטה באופן אוטומטי בזמן ההסקה, ולא הרכבתה בדיעבד לאחר שנוחת זימון. אנו מתכננים מערכות המאחסנות את תמצית גרסת המודל, מאפייני הקלט, מצב העיבוד המקדים, ציוני הביטחון ומדיניות הממשל הפעילה עבור כל החלטה מהותית, הניתנות לתשאול לפי מזהה החלטה, טווח זמן או מחלקת תוצאה.
כיצד תיעוד AI ברמת ליטיגציה שונה מכרטיסי מודל סטנדרטיים או מתיעוד ציות?
תיעוד ציות עונה על "האם עקבתם אחר התהליך?" תיעוד ברמת ליטיגציה עונה על "הוכיחו שההחלטה הספציפית הזו לא הייתה מפלה, עם ראיות שמומחה מנגד אינו יכול לפרק בחקירה נגדית." כרטיסי מודל המיועדים למתרגלי ML חסרים את תקן הביקורת היריבית, את שרשרת המשמורת הראייתית, ואת מיפוי המסגרת המשפטית הספציפית (Daubert לעדות מומחה, Griggs/Wards Cove להעברת נטל בהשפעה בלתי-שוויונית, FCRA לגילויי דוח צרכן) שליטיגציה דורשת. אנו מפיקים תיעוד שבו כל החלטה מהותית ניתנת לשחזור מתוך הרשומה שלה: גרסת המודל המדויקת, נתוני הקלט, ערכי המאפיינים, מצב צינור העיבוד המקדים והלוגיקה של ההחלטה, הניתנים לאחזור חודשים או שנים לאחר מעשה עם שלמות עמידה בזיוף.
מהם מדדי הקנס לאי-ציות רגולטורי של AI בשנת 2026?
נוף הקנסות כולל מספרים קונקרטיים. Colorado SB 205 (בתוקף מ-30 ביוני 2026): עד $20,000 לכל הפרה תחת חוק הגנת הצרכן, עם הגנה חיובית רק לארגונים המדגימים ציות ל-NIST AI RMF. חוק ה-AI של האיחוד האירופי (אכיפת סיכון גבוה מ-2 באוגוסט 2026): עד EUR 35 מיליון או 7% מהמחזור השנתי הגלובלי בגין נהלים אסורים, EUR 15 מיליון או 3% בגין אי-ציות בסיכון גבוה. Illinois AIVFA: עד $5,000 לכל הפרה בתוספת תביעות פרטיות, עם 37 תיקים שהוגשו בחודש הראשון של האכיפה. פיצויים סטטוטוריים של FCRA: $100-$1,000 לכל הפרה מכוונת, המתעצמים באופן דרמטי בתובענות ייצוגיות כמו תביעת Eightfold AI המכסה נתונים על מעל מיליארד עובדים. חוקי UDAP במדינות מאפשרים קנסות לכל הפרה ללא הוכחת נזק אישי.
האם אנו אחראים לאפליית AI כאשר אנו משתמשים בכלי של ספק, ולא במודל שלנו?
כן. מעסיקים נותרים אחראים באופן מלא לתוצאות מפלות מכלי AI של ספק תחת Title VII, FCRA וחוקי תעסוקה במדינות. בתיק Mobley v. Workday (מאי 2025), בית המשפט קבע כי "תפקידה של Workday בתהליך הגיוס אינו פחות משמעותי משום שהוא כביכול מתרחש דרך בינה מלאכותית ולא דרך בן אנוש חי." תובענת ה-FCRA הייצוגית נגד Eightfold AI מפרטת בשמם את המעסיקים שהשתמשו בכלי הדירוג. Colorado SB 205 מטיל חובות נפרדות על פורסים ללא קשר לשאלה האם הם בנו את מערכת ה-AI. אינכם יכולים למסור החוצה אחריות משפטית על ידי מסירת הטכנולוגיה החוצה. אנו מסייעים לארגונים לבנות את התיעוד, הבדיקות ותשתית הפיקוח המדגימים כי הפעלתם בדיקת נאותות על כלי AI של ספק, וזו ההגנה שבאמת חשובה כאשר כתב תביעה של תובע נוחת.
כיצד אנו מטפלים בציות AI כאשר רגולטורים פדרליים ומדינתיים נעים בכיוונים מנוגדים?
הסביבה הנוכחית סותרת את עצמה באופן פנימי. ה-CFPB הציע לסיים את אכיפת ההשפעה הבלתי-שוויונית תחת ECOA בנובמבר 2025, בעוד תובעים כלליים במדינות הגישו בו-זמנית תביעות אפליה של AI תחת חוקי UDAP מדינתיים. ה-FTC הפך את צו ההסכמה שלו בעניין Rytr בפברואר 2026, ואז הוציא מסגרת אכיפה מקיפה לסוכני AI במרץ 2026. צו ביצוע מדצמבר 2025 הציע תפיסת סמכות פדרלית של חוקי AI מדינתיים, אך 36 תובעים כלליים במדינות התנגדו לו רשמית ועד שבתי המשפט יפסקו, החוקים המדינתיים נותרים ניתנים לאכיפה. אנו בונים ארכיטקטורות הגנה הממופות לחובות הסטטוטוריות עצמן, ולא לעמדתו הנוכחית של רגולטור יחיד כלשהו. מסגרת בקרה מאוחדת עם שכבות תיעוד ספציפיות לתחום שיפוט משמעה שכאשר עדיפויות האכיפה משתנות, שכבת הכיסוי מתעדכנת בעוד בקרות הבסיס מחזיקות מעמד.
מהו תרגיל גילוי מוקדם מדומה ומה הוא בעצם מפיק?
תרגיל גילוי מוקדם מדומה הוא סימולציה יריבית שבה המהנדסים שלנו משחקים תפקיד של מומחים טכניים של תובע הבוחנים את מערכות ה-AI שלכם לאיתור פגיעויות ליטיגציה. אנו מנסחים את השאלונים ובקשות המסמכים האמיתיים שהצד שכנגד היה מגיש, מזהים את שומרי המסמכים שקבצֿיהם היו נסרקים, בודקים האם מערכות השימור שלכם לוכדות את מה שבתי המשפט דורשים כעת תחת תקני הגילוי המוקדם של AI של SDNY משנת 2025, ומעריכים האם נציג ה-30(b)(6) התאגידי שלכם יכול להעיד על המערכת מבלי ליצור חשיפה נוספת. התפוקה היא מפת דרכים חסויה לתיקון (המבוצעת תחת חיסיון עורך דין-לקוח כאשר משולבת עם ייעוץ משפטי חיצוני) המאורגנת לפי חומרת סיכון הליטיגציה, עם מפרטים הנדסיים לסגירת כל פער. זה שונה מביקורת ציות משום שאנו בודקים במפורש חולשות יריביות, ולא מוודאים מול מסגרת ציות.
האם חברי הדירקטוריון שלנו ניצבים בפני אחריות אישית בגין כשלים בממשל AI?
תחת תקן Caremark של דלאוור, דירקטורים מפרים את חובת הזהירות שלהם כאשר הם אינם מיישמים מערכות מידע ודיווח או אינם מנטרים כראוי את ההנהלה. ממשל AI נמצא כעת באופן מובהק בתוך מסגרת זו. ה-SEC כלל את ה-AI בין עדיפויות הבחינה המובילות שלו לשנים 2025-2026, ומצופה מדירקטוריונים לתעד מסגרות פיקוח על AI בהצהרות ייפוי כוח עד עונת ייפוי הכוח של 2026. הכשל מסכן בתביעות נגזרות של בעלי מניות בסגנון Caremark, בהמלצות עיכוב ובנזק תדמיתי. אנו בונים את מערכות המידע המובנות המספקות לדירקטורים ראיות מתועדות לפיקוח פעיל על AI: מרשמי סיכונים הממופים לחובות נאמנות, לוחות מחוונים לניטור המראים סטטוס ממשל, וחומרי תדרוך המתרגמים סיכון AI טכני לשפת הממשל שדירקטורים זקוקים לה כדי להדגים פיקוח בתום לב.
כיצד אנו בונים בדיקת השפעה בלתי-שוויונית שתעמוד בפני מומחה סטטיסטי של תובע?
מסגרות העברת הנטל שונות לפי הסטטוט. Title VII (Griggs/Wards Cove) מחייב את המעסיק להדגים רלוונטיות לתפקיד והכרח עסקי אם תובע מבסס השפעה בלתי-שוויונית. ל-ECOA ול-FHA יש תקנים משלהם. מומחה סטטיסטי של תובע יתקוף גדלי מדגם, מתודולוגיית בדיקה, הגדרות קבוצה מוגנת, והאם אוכלוסיית ההשוואה נבנתה כראוי. אנו מתכננים פרוטוקולי בדיקה ברמת עיצוב המערכת, ולא כניתוח לאחר מעשה: הגדרת פילוח קבוצות מוגנות, בחירת מבחנים סטטיסטיים מתאימים (כלל ארבע-חמישיות, מבוסס-רגרסיה, בייסיאני), ביסוס אוכלוסיות השוואה בסיסיות, ותיעוד הצדקת ההכרח העסקי עבור כל מאפיין המפיק תוצאות בלתי-שוויוניות. התיעוד מובנה כך שכאשר מומחה של תובע תוקף את המתודולוגיה, התגובה כבר נמצאת ברשומה עם נימוק הבדיקה, ולא מאולתרת במהלך החקירה.
כיצד נראות בדרך כלל דרישות תיקון טכני של צו הסכמה בתחום AI?
צווי הסכמה בפעולות אכיפה של AI עוקבים אחר דפוס מתהווה: השבת רווח אלגוריתמית (השמדת נתונים שנאספו שלא כראוי ומודלים שאומנו עליהם), תקופות איסור על שימושי AI ספציפיים (Rite Aid קיבלה איסור בן 5 שנים על זיהוי פנים), מחיקה חובה של נתוני צרכן ששימשו במערכת ה-AI, ביקורות עצמאיות של צד שלישי (בדרך כלל דו-שנתיות), תוכניות כתובות לניהול סיכונים וממשל, מנגנוני הודעה וביטול הסכמה של צרכנים, ודיווח ציות מתמשך לרגולטור. צו ההסכמה של ה-FTC בעניין Rite Aid הוא התבנית הנוכחית. אנו מהנדסים לאחור את הדרישות הללו לתשתית פרואקטיבית: מעקב מקור נתונים שיכול להוכיח איסוף חוקי, תיעוד שושלת מודל שיכול להדגים נתוני אימון נקיים, ותוכניות ממשל שכבר עונות על דרישות התיקון של צו ההסכמה הטיפוסי. בניית זאת לפני האכיפה זולה בסדרי גודל מהתאמה בדיעבד תחת פיקוח בית משפט.
בנו את ה-AI שלכם בביטחון.
שותפו עם צוות בעל ניסיון עמוק בבניית הדור הבא של AI ארגוני. אנו נסייע לכם לתכנן, לבנות ולהטמיע אסטרטגיית AI שתוכלו לסמוך עליה.
Veriprajna ייעוץ דיפ-טק מתמחה בבניית מערכות AI קריטיות לבטיחות עבור תחומי הבריאות, הפיננסים והרגולציה. הארכיטקטורות שלנו מאומתות מול פרוטוקולים מבוססים ומלוות בתיעוד ציות מקיף.