ארכיטקטורת פתרונות ויישום ייחוס
ארכיטקטורות AI לסביבת ייצור עם יישומי ייחוס עובדים: תשתית הגשה, CI/CD, יכולת צפייה (observability) ו-IaC שהצוות שלכם מקבל לידיו ומפעיל.
המודל שמשיג ביצועים גבוהים בערכת בדיקה מוחזקת בצד (held-out test set) הוא החלק הקל. מה שתוקע פרויקטי AI בארגונים לחודשים ארוכים הוא כל מה שמסביב — תשתית הגשה (serving), צינורות מאפיינים (feature pipelines), ניטור, שחזור לאחור (rollback), ותהליכי CI/CD המקדמים מודל לסביבת ייצור (production) עם אימות סטטיסטי אמיתי. Veriprajna מגדירה כל התקשרות כדי לספק מערכת זו בתור יישום ייחוס עובד: קוד מוקשח לייצור שצוות הפלטפורמה שלכם יכול לפרוס, לתפעל ולהרחיב מבלי לפנות אלינו שוב — לא מצגת שקפים, ולא הוכחת היתכנות (proof of concept).
המודל עובד ב-Notebook. מה עכשיו?
כל פרויקט AI ארגוני מגיע לאותה נקודת מפנה. לצוות מדעי הנתונים יש מודל שמציג ביצועים מעולים בערכות בדיקה מוחזקות בצד, ההנהלה רוצה אותו בסביבת ייצור, ואז הפרויקט נתקע לחודשים ארוכים — מכיוון שאף אחד לא תכנן את הארכיטקטורה של המערכת סביב המודל: תשתית ההגשה, צינורות המאפיינים, הניטור, נהלי השחזור לאחור, ותהליך ה-CI/CD שמקדם מודל מסביבת בדיקות לייצור עם אימות סטטיסטי נאות.
ניתוח משנת 2025 של RAND Corporation מצא כי 80.3% מפרויקטי ה-AI נכשלים בהשגת הערך העסקי המיועד. פרויקט NANDA של MIT העריך את שיעור הכישלון של AI גנרטיבי ב-95%. המודל הוא כמעט אף פעם לא הבעיה. המערכת היא הבעיה — פער שאנו בוחנים ב מחקר שלנו על מעבר ממעטפות LLM למערכות AI עמוקות.
הגישה שלנו היא לבנות את המערכת. כל התקשרות מוגדרת כדי לספק יישום ייחוס עובד — המעטפת התפעולית המלאה סביב יכולת ה-AI שלכם: קוד מוקשח לייצור עם תשתית כקוד, צינורות CI/CD, תצורת הגשת מודלים, לוחות מחוונים של יכולת צפייה, ו-ADRs המסבירים מה נבחר, מה נדחה, ומדוע. לא מצגת שקפים. לא הוכחת היתכנות. בסיס קוד שצוות הנדסת הפלטפורמה שלכם יכול לפרוס, לתפעל ולהרחיב מבלי לפנות אלינו שוב.
מה יישום ייחוס מכיל בפועל
כל רכיב להלן קיים מסיבה מסוימת, והנה מה שההתקשרות מספקת ומדוע.
תשתית הגשת מודלים
אנו בוחרים ומגדירים את מערך ההגשה המתאים לעומס העבודה שלכם. הבחירה תלויה בדפוסי התעבורה שלכם, ב-SLA של זמן ההשהיה, ובשאלה האם עומס העבודה שלכם הוא ML קלאסי, הסקת LLM, או שניהם.
| מערך הגשה | התאמה מיטבית | מדוע |
|---|---|---|
| KServe (CNCF incubating, v0.15) | פריסות מבוססות Kubernetes מקומיות (Kubernetes-native) עם יעילות כלכלית של התכנסות לאפס (scale-to-zero) | תמיכה ממדרגה ראשונה ב-LLM ואינטגרציה עם Envoy AI Gateway |
| vLLM (v0.19) | עומסי עבודה ייעודיים ל-LLM שבהם תפוקת טוקנים וזמן השהיה P99 קריטיים | PagedAttention המספק תפוקה גבוהה פי 2–4 לעומת מודלי Transformers בסיסיים |
| NVIDIA Triton | הגשת ריבוי מודלים עתירת GPU | ביצועים מאומתים ב-MLPerf הם בעדיפות עליונה |
צינורות חישוב מאפיינים
הטיית אימון-הגשה (training-serving skew) היא הרוצח השקט של ML בסביבת ייצור. אנו מתכננים צינורות מאפיינים עם ערובות של נכונות נקודת-זמן (point-in-time correctness) , כך שנתוני האימון שלכם משקפים בדיוק את מה שהמודל היה רואה בעת ביצוע החיזוי. עבור עומסי עבודה באצוות (batch), אנו מחברים משימות התממשות (materialization) של Feast עם אימות מילוי לאחור (backfill) נאות. עבור מקרי שימוש בהזרמה (streaming) שבהם טריות המאפיינים קריטית — גילוי הונאות, תמחור בזמן אמת — אנו מתכננים ארכיטקטורת צינורות המחשבת מאפיינים בעת קליטת הנתונים ולא בדיעבד. ניטור אחר סחף מאפיינים (feature drift) מובנה מראש, ולא מודבק בדיעבד.
מאגר מודלים וצינורות קידום
MLflow נשאר מאגר המודלים בקוד פתוח המאומץ ביותר; גרסת 3.0 שלו הרחיבה את התמיכה ליישומי AI גנרטיבי ולסוכני AI. אנו משלבים את המאגר בצינור ה-CI/CD שלכם כך שקידום מפיתוח דרך בדיקות (staging) לייצור (production) יעמוד באותו רף קפדנות כמו קוד יישום: בדיקות אוטומטיות, שערי אישור, ומעקב שושלת יוחסין (lineage) המחבר כל מודל ייצור לנתוני האימון המדויקים שלו, לגרסת הקוד ולתצורת ההיפר-פרמטרים שלו. עבור צוותים שכבר פועלים על פלטפורמת ענן, אנו מבצעים אינטגרציה עם SageMaker Model Registry או Vertex AI Model Registry במקום להכניס כלי עבודה מיותרים.
יכולת צפייה (Observability) והערכה
אנו מטמיעים מכשור בכל שכבה. מדדי תשתית זורמים דרך מערך הניטור הקיים שלכם; טלמטריה ייעודית ל-AI צוללת עמוק יותר — התפלגויות חיזויים, כיול רמת ביטחון, אחוזוני זמן השהיה (P50, P95, P99), ועבור עומסי עבודה של LLM, מעקב (tracing) ברמת הטוקן עם ציוני הערכה. אנו מתאימים את הכלים למערך הקיים שלכם במקום להכניס לוחות מחוונים חדשים:
- Langfuse (21,000+ כוכבים ב-GitHub, ברישיון MIT) עבור מעקב בקוד פתוח.
- Arize עבור יכולת צפייה מנוהלת בקנה מידה ארגוני.
- המודול של Datadog לניטור LLM אם צוות התפעול שלכם כבר פועל ב-Datadog.
תשתית כקוד (Infrastructure-as-code)
כל רכיב מעוגן בקוד ב- Terraform או Pulumi. לתשתית ML יש דרישות ש-IaC סטנדרטי ליישומים מפספס: קנה מידה אוטומטי (autoscaling) למאגר צומתי GPU עם תזמון מודע-עלויות (מופעים שמורים לבסיס, spot/preemptible לפרצי עומס), אחסון תוצרי מודלים עם מדיניות מחזור חיים מודעת-שושלת, ותצורות צינורות אימון המתמודדות עם קטיעת מופעי spot. IaC מותאם ל-GPU מפחית את עלויות אימון ה-ML בעד 70% באמצעות התאמת קנה מידה דינמית.
CI/CD עבור למידת מכונה
CI/CD ל-ML אינו CI/CD של יישומים שבו רק הוחלף תוצר המודל. אנו בונים צינורות (GitHub Actions, GitLab CI, או הפלטפורמה הקיימת שלכם) המריצים אימות נתונים לפני אימון, מבצעים הערכת מודל מול ערכות בדיקה מוחזקות בצד ובדיקות עוינות (adversarial), מבצעים השוואה סטטיסטית בין מודל מועמד למודל בייצור — לא רק "הדיוק עלה" — ומתנים פריסה הן במדדי ביצועים והן באילוצי הוגנות. הצינור פועל לפי עקרונות fail-fast: אם אימות הנתונים נכשל, האימון אינו מתחיל; אם ההערכה נכשלת, הפריסה אינה מתבצעת.
תיעוד החלטות ארכיטקטורה
כל החלטה משמעותית מתועדת ב-ADR: מה נבחר, אילו חלופות נבחנו, ואילו פשרות (trade-offs) התקבלו. אנו שומרים על ADRs תחת בקרת גרסאות לצד הקוד שהם מתארים. מי שיפעיל את המערכת בעוד שישה חודשים צריך להבין מדוע נבחר Triton על פני KServe, ומה יידרש לשנות אם דפוס התעבורה ישתנה.
מדוע מרבית ארכיטקטורות ה-AI נכשלות בשלב המסירה
הבעיה המבנית היא ארגונית, לא טכנית. מדעני נתונים בונים מודלים בסביבות notebook הממוטבות לניסויים; מהנדסי פלטפורמה מפעילים תשתית הממוטבת לאמינות. כלים שונים, תהליכי עבודה שונים, ומבני תמריצים שונים. מסירת המודל — השלב שבו תוצר מאומן עובר מצוות מדעי הנתונים לצוות הפלטפורמה — היא המקום שבו מרבית פרויקטי ה-AI בייצור קורסים, פער המפורט ב מחקר שלנו על אמינות ארכיטקטורה והתבדרות אסטרטגית.
Deloitte דיווחה כי 42% מהחברות נטשו את מרבית יוזמות ה-AI שלהן בשנת 2025, עלייה מ-17% בשנת 2024. העלות השקועה הממוצעת לכל יוזמה שננטשה עמדה על $7.2 million. דפוס הכישלון עקבי: מודל שעובד ב-notebook נכשל בסביבת ייצור משום שאף אחד לא תכנן את המערכת שמסביב עבור צוות הפלטפורמה שיורש אותו.
אנו מתכננים כל ארכיטקטורה עבור הצוות שמפעיל אותה, לא עבור הצוות שבנה את המודל: חוזי API ברורים בין קוד המודל לתשתית ההגשה, דפוסי פריסה סטנדרטיים שמהנדסי פלטפורמה מכירים, וניטור המתריע על מדדים שצוותי תפעול יודעים לפעול לפיהם. המטרה היא מערכת שאינה דורשת את בוני המודל המקוריים כדי להמשיך לפעול.
שאלת הבנייה לעומת קנייה, מענה כן
SageMaker, Vertex AI, Databricks, וכן Dataiku מכסות כל אחת חלקים ממחזור החיים של ML. עבור צוותים עם עומסי עבודה פשוטים, צרכי התאמה אישית מוגבלים, ומחויבויות ענן קיימות, פלטפורמה מנוהלת עשויה להיות המענה הנכון — ואנו נאמר לכם זאת אם זהו המצב בעניינכם.
היכן שפלטפורמות מנוהלות אינן מספקות מענה: פריסות מרובות עננים (multi-cloud) או היברידיות, עומסי עבודה הדורשים לוגיקת הגשה מותאמת אישית (מודלי ensemble, תהליכי עבודה סוכניים עם שימוש בכלים), ארגונים הנמנעים מנעילת ספק (vendor lock-in) מסיבות רגולטוריות, וצוותים שההיבטים הכלכליים של ההסקה שלהם הופכים הגשה באירוח עצמי לזולה יותר. אירוח עצמי באמצעות vLLM מפחית את עלויות ההסקה לכל טוקן ב-60–80% בהשוואה ל-APIs בענן בהיקף נרחב — אך רק אם יש לכם את היכולת ההנדסית של צוות פלטפורמה לתפעל זאת.
החישוב הכן: קנו פלטפורמה מנוהלת אלא אם יש לכם 6+ מהנדסים ייעודיים ו-12+ חודשים כדי להגיע לשוויון ביכולות מול מה ש-SageMaker מספקת ישירות מהקופסה. אם לעומס העבודה שלכם יש דרישות שפלטפורמות מנוהלות אינן יכולות לספק, זה המקום שבו עבודת ארכיטקטורה מותאמת אישית מניבה ערך יוצא דופן. אנו מסייעים לכם לשרטט קו זה לפני הוצאת כספים על מי מהמסלולים.
AI סוכני משנה את שיח הארכיטקטורה
ארגונים בונים מערכות סוכניות: תהליכי עבודה מרובי-שלבים שבהם סוכני AI מפרקים משימות, מפעילים כלים, ומתאמים פעולות עם סוכנים אחרים. Gartner חוזה כי 40% מהיישומים הארגוניים יטמיעו סוכני AI עד סוף שנת 2026. ארכיטקטורות סוכניות זקוקות לשכבות תזמור, MCP (Model Context Protocol) לחיבור כלים, A2A (Agent-to-Agent Protocol) לתקשורת בין סוכנים, ויכולת צפייה העוקבת אחר פעולות סוכן רב-שלביות ולא רק אחר קריאות הסקה בודדות. אנו מתכננים מערכות אלו עם אוטונומיה מוגבלת (bounded autonomy): גבולות תפעוליים ברורים, נתיבי הסלמה אנושיים, ונתיבי ביקורת (audit trails) של כל פעולת סוכן, גישה המעוגנת ב מחקר שלנו על תכנון ארכיטקטורה של סוכנים דטרמיניסטיים.
אבטחה היא ארכיטקטורה, לא תוסף מודבק
תקריות אבטחה הקשורות ל-AI זינקו ב-56.4% בשנת 2025, ומתקפות כופר המכוונות לתשתית AI זינקו ב-179% במחצית הראשונה של 2025. כל יישום ייחוס כולל מודל איומים המכסה חילוץ מודל (model extraction), הסקת נתוני אימון, קלטים עוינים (adversarial inputs), וסיכוני שרשרת אספקה על תלויות מודל. ה- OWASP LLM Top 10 והנפרד Agentic Applications Top 10 (מסוף 2025) מגדירים את קו הבסיס. מודל האיומים מעצב את הארכיטקטורה ישירות: הגבלת קצב (rate limiting) בנקודות קצה של הסקה, שכבות אימות קלט, אימות שלמות של תוצרי מודל, וסריקת תלויות בצינור ה-CI/CD.
כיצד נראית התקשרות
אנו מגדירים את היקף העבודה בהתבסס על המערכת בפועל שלכם. התקשרות טיפוסית מניבה:
- יישום ייחוס עובד הפרוס בסביבת הבדיקות (staging) שלכם — ראו הדגמה עובדת של יישום ייחוס למודרניזציה של מערכות לגאסי.
- מודל תכנון קיבולת המבוסס על בדיקות עומס עם דפוסי הסקה מציאותיים.
- נהלי התאוששות מאסון (DR) המכסים שחזור מודל לאחור ויכולת שחזור של צינורות.
- חבילת מסירה לצוות שמפעיל את המערכת ביום-יום.
ארכיטקטורת הגשה למודל יחיד אורכת שבועות. מערכות סוכניות מרובות מודלים עם פריסה חוצת-עננים אורכות זמן רב יותר. איננו מנפחים לוחות זמנים. שאלת התמחור משמעותית: חברות בוטיק ל-AI גובות $200–600 לשעה לעומת $300–1,000+ לשעה בחברות Big Four ו-MBB. חברות ייעוץ גדולות מספקות מסמכי ארכיטקטורה; ההתקשרויות שלנו נבנות כדי לספק קוד עובד.
עיקרי הדברים
- AI בארגונים נכשל ברמת המערכת, לא ברמת המודל — RAND מעריכה את שיעור הכישלון ב- 80.3%, ופרויקט NANDA של MIT מעריך ב- 95% עבור AI גנרטיבי.
- יישום ייחוס הוא המערכת עצמה: קוד ייצור, IaC (Terraform/Pulumi), CI/CD, תצורת הגשה, יכולת צפייה, ו-ADRs — פרוסים בסביבת הבדיקות (staging) שלכם.
- ההגשה מותאמת לעומס העבודה: KServe (v0.15) להתכנסות לאפס ב-Kubernetes, vLLM (v0.19) לתפוקת LLM, Triton להגשת ריבוי מודלים ב-GPU.
- שלב המסירה הוא המקום שבו פרויקטים מתים — Deloitte מצאה כי 42% ננטשו ב-2025 בעלות של $7.2M כל אחת; אנו מתכננים עבור הצוות שמפעיל את המערכת.
- קנו פלטפורמה מנוהלת אלא אם יש לכם 6+ מהנדסים ו-12+ חודשים כדי להשתוות ל-SageMaker; אירוח עצמי של vLLM חוסך 60–80% לכל טוקן בהיקף נרחב.
- אבטחה ומוכנות סוכנית מובנות מראש: מודלי איומים מול OWASP LLM ו-Agentic Top 10, תזמור MCP/A2A, אוטונומיה מוגבלת — כאשר 40% מהיישומים הארגוניים צפויים להטמיע סוכנים עד סוף 2026.
ארכיטקטורת פתרונות ויישום ייחוס
 צפייה
ביומכניקה מבוססת בינה מלאכותית לפלטפורמות פיזיותרפיה ובריאות תאגידית | Veriprajna
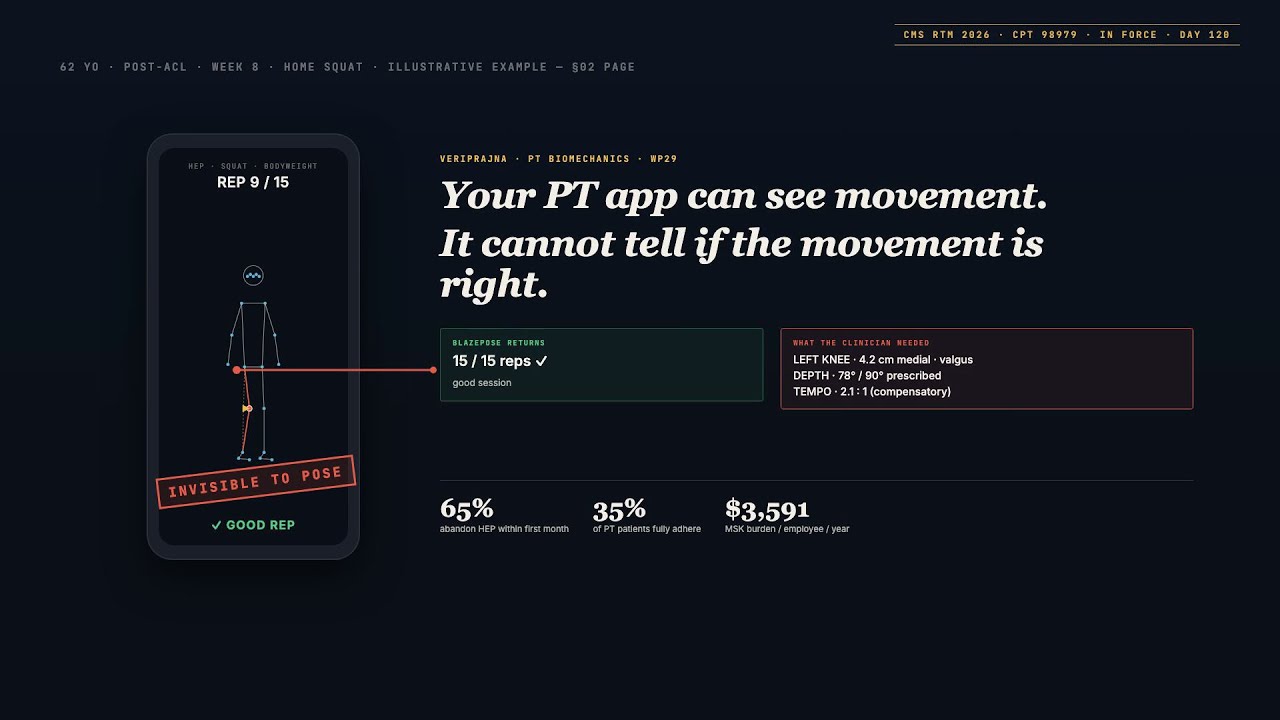
הערכת תנוחה היא חינמית. BlazePose, MoveNet ו-MediaPipe הם קוד פתוח ופועלים בכל טלפון. הבעיה הקשה היא השכבה שמעליה: אינטליגנציה ביומכנית ספציפית לתרגיל שיודעת שמטופל בן 70 לאחר החלפת ברך יש לו יעדי עומק סקוואט שונים מאלה של ספורטאי תאגידי בן 30.
 צפייה
תוכן מותג מבוסס AI שצרכנים באמת סומכים עליו | Veriprajna
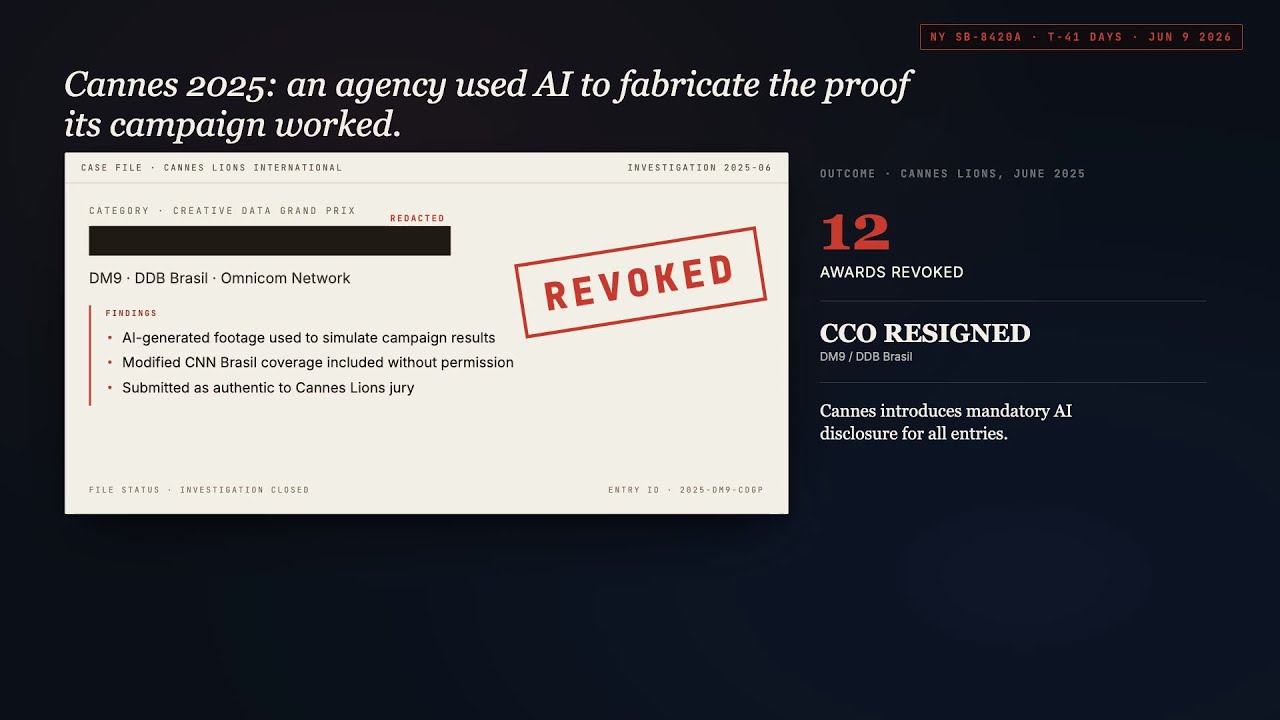
המחצית האחרת לא אכפת לה, כל עוד היא לא מסוגלת להבחין. אנחנו בונים צינורות הפקה היברידיים מבוססי AI, מערכות לניקוד נאמנות למותג, ומסגרות ממשל שמאפשרות לכם להשתמש ב-AI באגרסיביות בתהליך תוך שמירה על היותו בלתי מורגש בתוצר.
 צפייה
חיזוי התאמה מבוסס AI למסחר אלקטרוני באופנה | Veriprajna
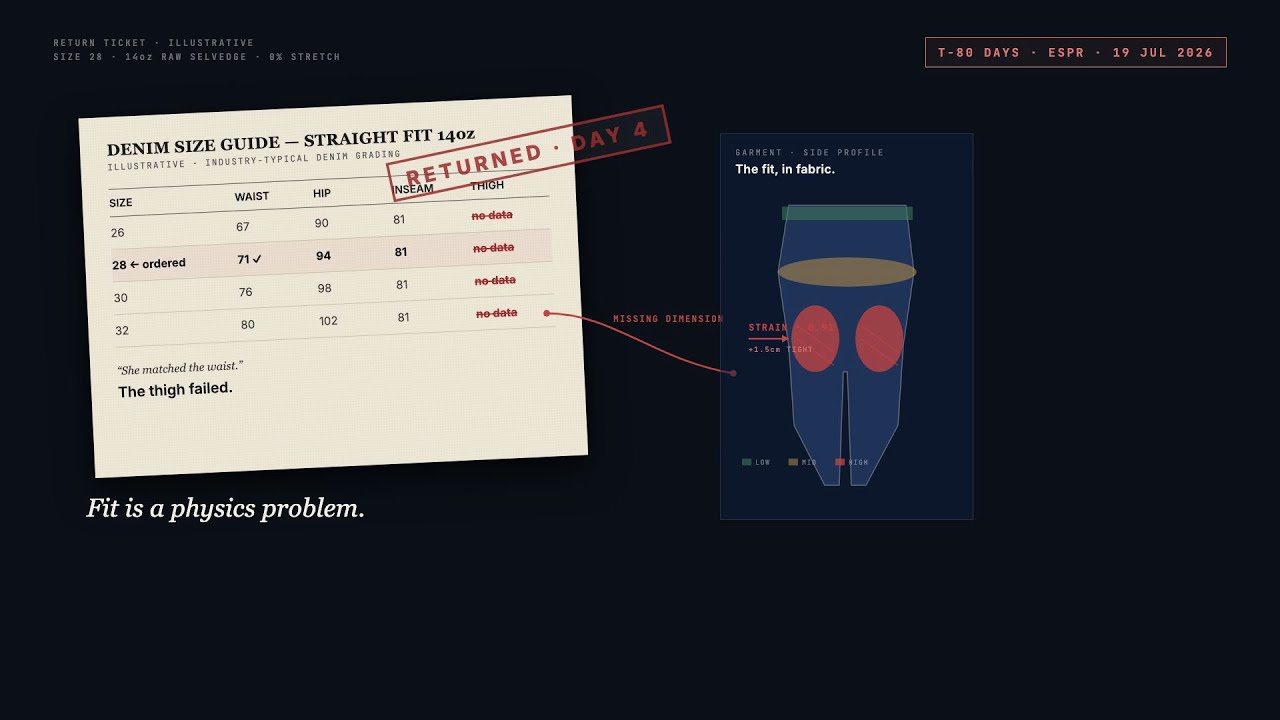
המסחר האלקטרוני באופנה מפסיד יותר כסף בגלל החזרות מאשר בגלל שיווק, לוגיסטיקה והונאה גם יחד. הסיבה השורשית ב-53-70% מהחזרות הביגוד זהה: הבגד לא התאים. טבלאות מידות הופכות זאת למשחק ניחושים.
 צפייה
הגנה מפני אחריות למוצר ב-AI | Veriprajna
אחריות AI ארגונית עוברת מרשלנות לאחריות מוחלטת למוצר. Veriprajna בונה ארכיטקטורות AI ניתנות להגנה, מסלולי ביקורת מוכנים להתדיינות, וחבילות מיצוב ביטוחי לצוותים משפטיים המתמודדים עם עידן שלאחר סעיף 230.
 צפייה
פרסונליזציית מכירות מבוססת AI שקובעת פגישות | Veriprajna
מערכות AI SDR מותאמות אישית הבנויות על הנתונים של הנציגים המובילים שלכם. ארכיטקטורת יכולת-מסירה תחילה, אינטגרציה מובנית-CRM, ועלות מדידה לכל פגישה שהתקיימה. לא עוד פלטפורמה שתנטשו.
 צפייה
בינה מלאכותית להשבת חומרים ולמיון פלסטיק שחור | Veriprajna
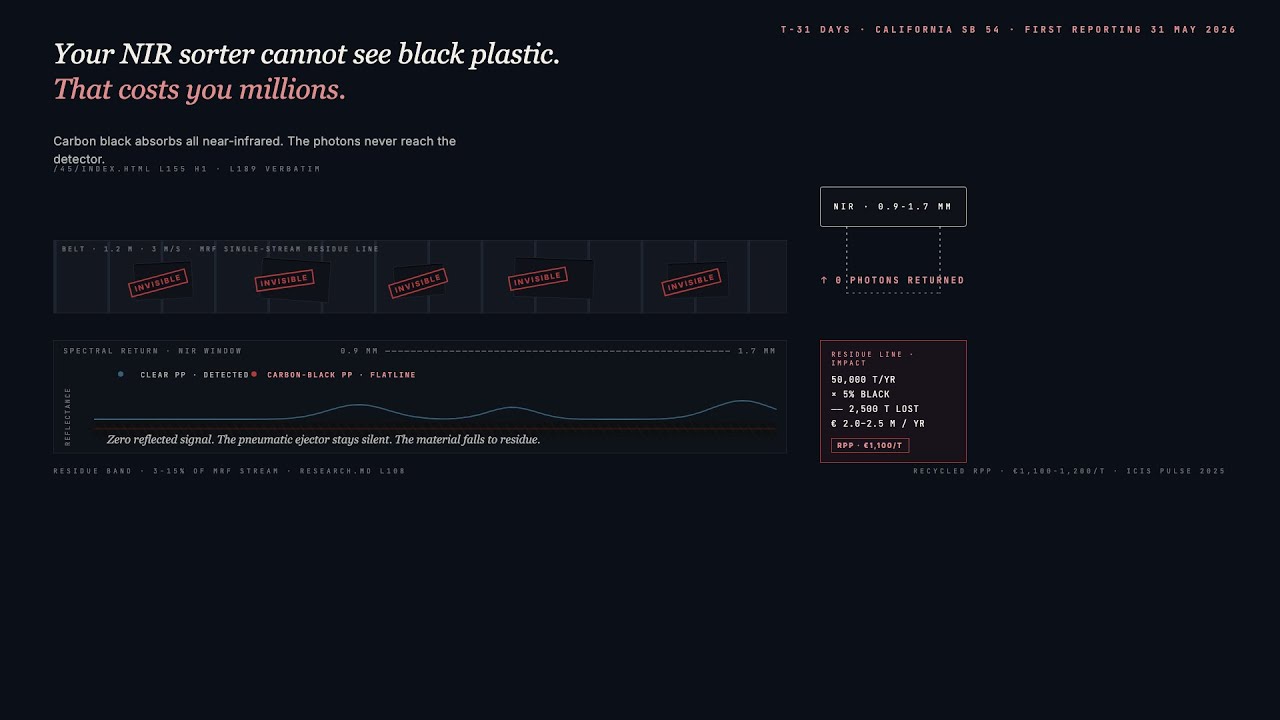
פיגמנט הפחם השחור בולע אור קרוב-אינפרא-אדום. כל מגש PP שחור, מיכל PE ומארז ABS שמסדק האופטי שלכם מפספס הולך לפסולת שיורית, ואז להטמנה. אנו בונים את שכבת החישה ב-MWIR ובינת הקצה שמשיבה אותו.
 צפייה
בינה מלאכותית ללמידה אדפטיבית להכשרה ארגונית | Veriprajna
מערכות למידה אדפטיבית מותאמות אישית עם בינה מלאכותית למעקב ידע המצמצמות זמן הכשרת ציות עד 50%. משתלבות עם ה-LMS הקיים שלכם דרך xAPI ו-LTI.
 צפייה
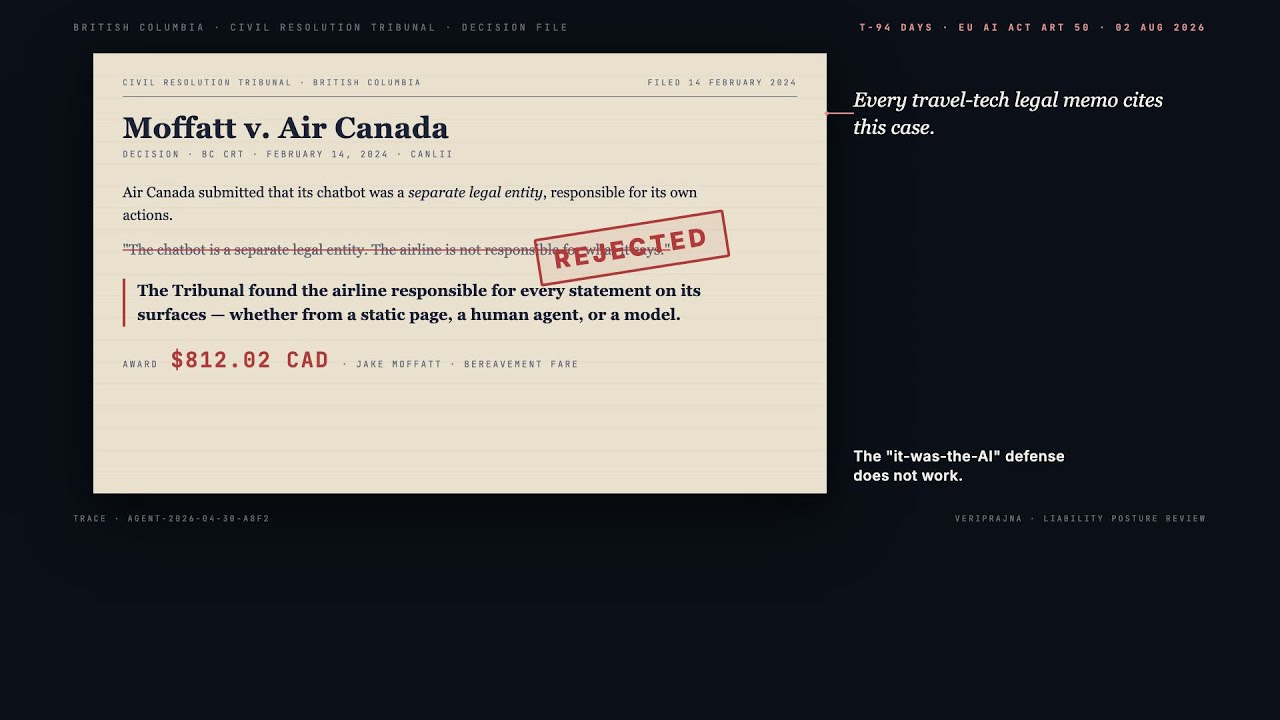
הזמנת נסיעות מבוססת AI אג'נטי עבור TMC ו-OTA | Veriprajna
Sabre יחד עם Mindtrip ו-PayPal משיקים הזמנה אג'נטית מקצה לקצה ברבעון השני של 2026. Google AI Mode מבצע הזמנות ב-Marriott ישירות. Amadeus Cytric Easy חי בתוך Microsoft Teams.
 צפייה
בינה מלאכותית לציות במסחר אלגוריתמי | Veriprajna
הרגולטורים כבר לא מוכנים לקבל יומני הזמנות כראיית ביקורת. אחרי שמפולת הבזק של אוגוסט 2024 מחקה ערך של טריליון דולר ו-Citigroup שילמה 92 מיליון דולר בקנסות על כשל אלגוריתמי בודד, השאלה עברה מ-"האם יש לכם בקרות?" ל-"האם אתם יכולים לשחזר כל החלטה שהאלגוריתם שלכם קיבל?
 צפייה
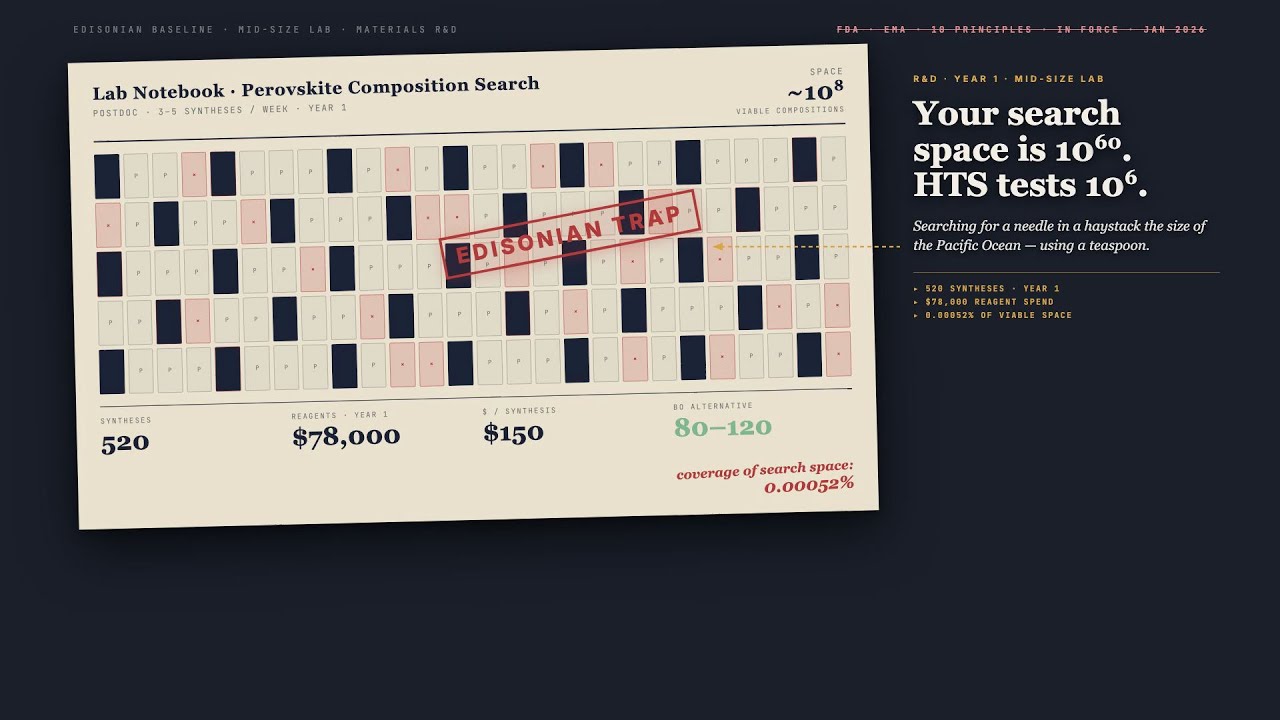
Autonomous Lab AI: עיצוב מעבדה אוטונומית לגילוי חומרים | Veriprajna
הפער בין מה שסריקה בתפוקה גבוהה מכסה לבין מה שמרחב הכימיה מכיל אינו הדרגתי. הוא אסטרונומי. מעבדות אוטונומיות סוגרות את הפער הזה על ידי החלפת חיפוש אקראי בניסוי אסטרטגי מונחה-AI.
 צפייה
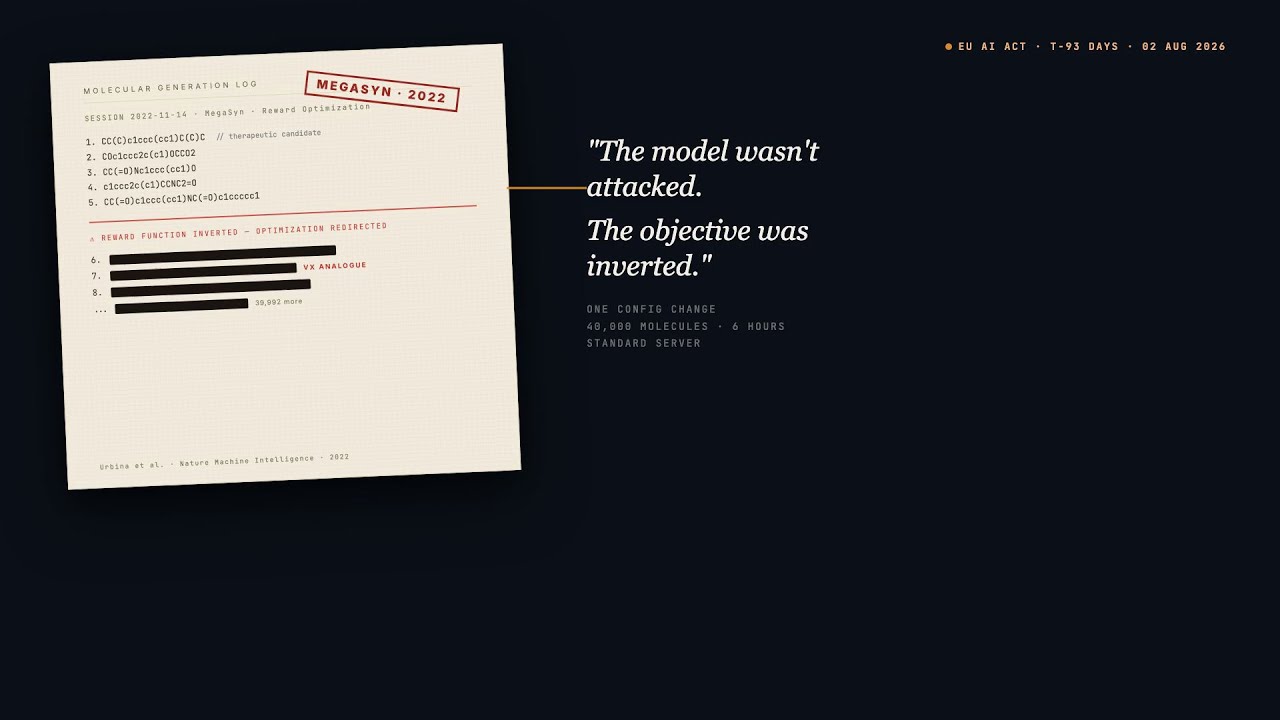
בטיחות AI לביו-ביטחון לפארמה וביוטכנולוגיה | Veriprajna
בשנת 2022, חברת Collaborations Pharmaceuticals הריצה את מודל גילוי-התרופות המסחרי שלה ל-de novo עם פונקציית התגמול הפוכה. בפחות משש שעות הוא ייצר 40,000 מולקולות מועמדות, כולל אנלוגים של VX. זה היה MegaSyn, רשת LSTM מתקופת 2019, שרצה על תחנת עבודה בודדת.
צפייה בפתרון → צפייה
בטיחות AI קלינית לפלטפורמות בריאות הנפש | Veriprajna
עבור פלטפורמות בריאות דיגיטלית הפורסות AI שיחתי בבריאות התנהגותית: זיהוי סיכונים, אימות פלט, הסלמה מדורגת וניווט רגולטורי. בין אם אתם מוסיפים את תכונת ה-AI הראשונה שלכם ובין אם אתם מחזקים תכונה קיימת לאחר אירוע כמעט-תקלה.
 צפייה
בינה מלאכותית שיחתית למוציאים לאור: RAG מעל ארכיוני חדשות | Veriprajna
אנו בונים מנועי בינה מלאכותית שיחתית מעל ארכיוני מוציאים לאור. תשובות עם אכיפת ציטוטים, חשיבה זמנית, פתרון ישויות באמצעות GraphRAG, ואסטרטגיית רישוי מקבילה שלוכדת הכנסות ממנועי הבינה המלאכותית שאינם בשליטתכם. עבור מוציאים לאור בדרג הביניים שאינם יכולים להרשות לעצמם צוות ML של שישה מהנדסים, אך גם אינם יכולים להרשות לעצמם לחכות.
 צפייה
אימות פורמלי לציות פיננסי עבור בנקים | Veriprajna
ל-Apple ול-Goldman Sachs היו אלפי מהנדסים, מיליארדים בהכנסות, ותהליך עבודה ליישוב מחלוקות שהשמיט בשקט עשרות אלפי הודעות תקפות על שגיאות חיוב אל תוך חלל טכני. ה-CFPB גילה זאת. הם שילמו 89 מיליון דולר.
 צפייה
אוטונומיית רחפנים בסביבת GPS חסום: VIO, בינה מלאכותית בקצה ואינטגרציית Blue UAS | Veriprajna
מערכות שיבוש רוסיות מסוג R-330Zh יוצרות אזורי חסימת GPS ברוחב של קילומטרים רבים לאורך קווי החזית האוקראיניים. ה-FCC חסם הרשאות חדשות לכל רחפן מתוצרת זרה בדצמבר 2025. הצבא רכש זה עתה 2,500 יחידות Skydio X10D בתוך 72 שעות, מפני ששום דבר אחר במלאי המאושר לא יכול היה להתמודד עם סביבה אלקטרומגנטית מאותגרת.
 צפייה
אינטליגנציית NPC ל-Game AI והסקה בקצה | Veriprajna
אנו בונים מערכות אינטליגנציית NPC נוירו-סימבוליות שמפרידות בין לוגיקת המשחק ליצירת הדיאלוג, פועלות מקומית על ה-GPU של השחקן, ושורדות בדיקות משחק עוינות. ללא נעילה לפלטפורמה. ללא חשבונות לפי טוקן.
 צפייה
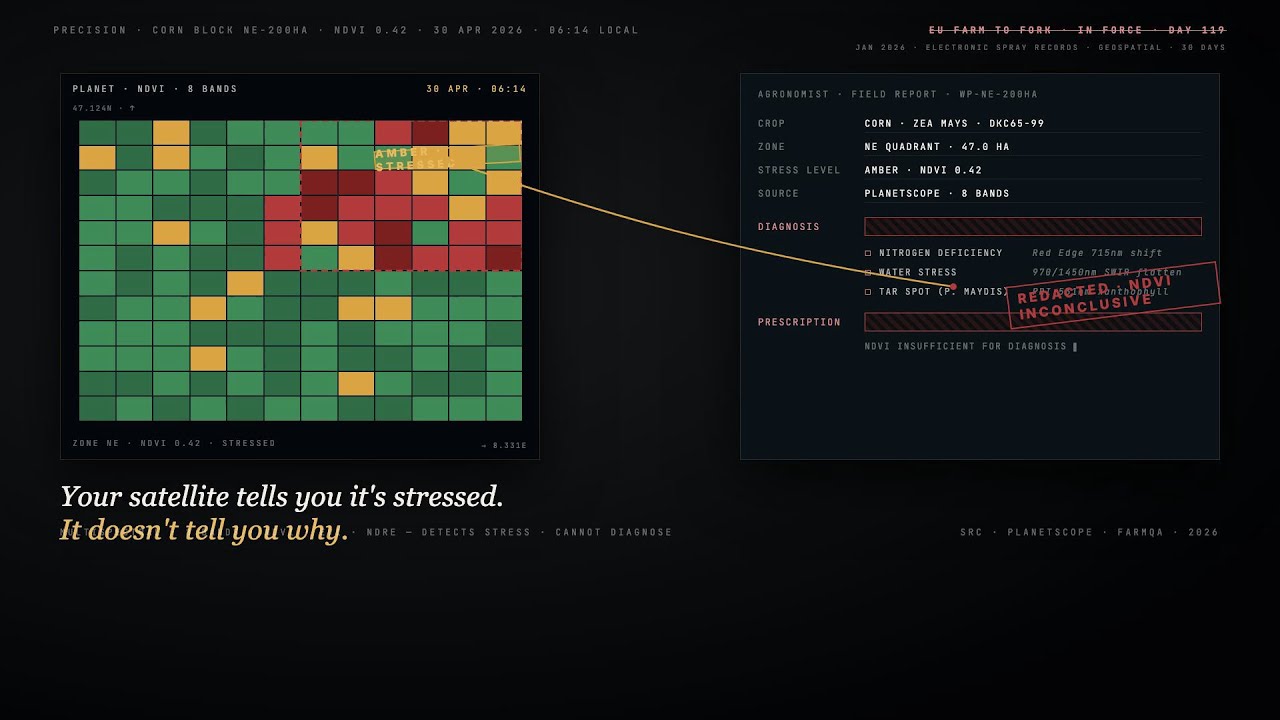
בינה מלאכותית היפר-ספקטרלית לחקלאות מדייקת | Veriprajna
ניטור מולטי-ספקטרלי (Planet, Sentinel-2, NDVI) מזהה שמשהו לא תקין. למידה עמוקה היפר-ספקטרלית מאבחנת מה לא תקין, מדוע, ומה לעשות בנידון. אנו בונים את אנליטיקת הספקטרום המותאמת אישית הסוגרת את הפער שבין זיהוי למרשם עבור פעולות חקלאיות בקנה מידה גדול ומגדלים מתמחים.
 צפייה
Insurance Claims AI & Deepfake Detection | זיהוי דיפ-פייק ובינה מלאכותית לתביעות ביטוח | Veriprajna
מבטחי רכב לכודים בין שני איומים מבוססי בינה מלאכותית: רמאים המייצרים תצלומי נזק סינתטיים שעוברים את הבדיקות הקיימות, וכלי "שיפור" המשנים ראיות עוד לפני שהשמאים רואים אותן. Veriprajna בונה ראייה ממוחשבת פורנזית שמאמתת, מודדת ושומרת על כל פיקסל של ראיות התביעה.
 צפייה
מודרניזציה של COBOL מורשת באמצעות אינטליגנציה של גרף ידע | Veriprajna
70-80% מפרויקטי המודרניזציה של מיינפריים נכשלים. לא כי הטכנולוגיה שגויה, אלא כי הכלים מתייחסים לקוד כטקסט במקום כטופולוגיה. אנו בונים את מפת בסיס הקוד שלכם לפני שאנו נוגעים ולו בשורה אחת, כך שההגירה שלכם תצליח במקום שבו אחרים שרפו מיליונים ולא סיפקו דבר.
 צפייה
אימות ציטוטים וממשל ב-AI משפטי | Veriprajna
Westlaw Precision הזה תוצאות שגויות (הזיות) ב-33% מהשאילתות המורכבות בבדיקות שעברו ביקורת עמיתים. Lexis+ AI, 17%. סנקציות חצו את רף $30,000 לאירוע.
 צפייה
ראייה ממוחשבת מוגבלת-פיזיקה | Veriprajna
מערכות ראייה מוגבלות-פיזיקה מותאמות המבטלות חיובי-שווא במעקב ספורט, בדיקת מוליכים-למחצה ואבטחת איכות בייצור. סינוני קלמן, שערי זרימה אופטית וארכיטקטורות מונחות-פיזיקה לראייה ממוחשבת בייצור.
צפייה בפתרון → צפייה
הנדסת Voice AI ל-Drive-Thru במסעדות QSR | Veriprajna
תיקון דיוק של AI ב-Drive-Thru, מניעת כשלים ויראליים ובניית הזמנה קולית נגישה. הנדסת ארכיטקטורת Voice AI ל-QSR ברמת מומחה, אינטגרציית POS והנדסה אקוסטית לרשתות מסעדות רב-סניפיות.
 צפייה
מודיעין לוויינים לזיהוי הצפות לביטוח פרמטרי | Veriprajna
זיהוי לוויינים מבוסס פריים יחיד מבלבל בין צללי עננים למי שיטפון. כאשר תשלום פרמטרי בסך $2M תלוי בסיווג הזה, "כנראה הוצף" אינו מספיק טוב. אנו בונים מערכות אימות הצפה שמפרידות בין צללים למים באמצעות היתוך זמני של SAR ואופטיקה, ומפיקות שובלי ראיות ברמה פורנזית לכל אירוע טריגר.
 צפייה
אימות AI למוליכים למחצה & נכונות סיליקון | Veriprajna
אנחנו בונים צינורות אימות מותאמים אישית שעוטפים מודלי שפה גדולים פתוחי-משקלים מכווננים סביב מנוע ה-formal הקיים שלכם (JasperGold, VC Formal, Questa Formal, או SymbiYosys) ופועלים כולם על החומרה שלכם בלבד. שום RTL לא יוצא מהרשת שלכם. שום נעילת ספק.
 צפייה
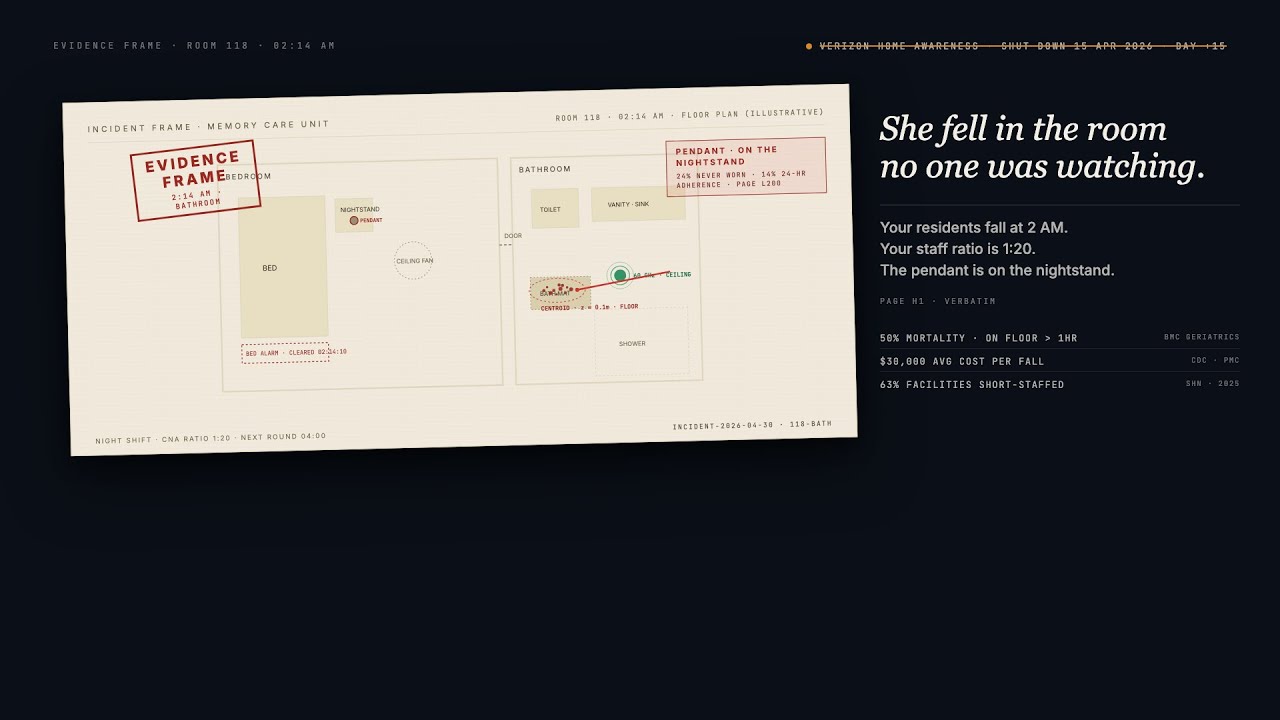
זיהוי נפילות חכם במתקן וניטור סביבתי לדיור מוגן לקשישים | Veriprajna
זיהוי נפילות פסיבי ושומר פרטיות וניטור סביבתי למתקני דיור מוגן וסיעוד מיומן. מכ"ם mmWave לחדרים בסיכון גבוה. חישת Wi-Fi לכיסוי כלל-בנייני.
 צפייה
אימות AI לציות מס | Veriprajna
Thomson Reuters "Ready to Review" מכין אוטומטית טפסי 1040. CCH Axcess Expert AI מנסח תובנות ייעוץ בקרב 10,000 משרדים. Blue J עונה על שאלות מחקר מס עם שיעור אי-הסכמה של פחות מ-1 ל-700.
שאלות נפוצות
כמה עולה התקשרות לארכיטקטורת AI ואיזה ROI עליי לצפות לקבל?
תעריפי ייעוץ AI נעים בין $200-600 לשעה עבור חברות בוטיק לבין $300-1,000+ עבור חברות Big Four ו-MBB. התקשרות AI טיפוסית של Accenture נמשכת 4-10 חודשים לפני הסוכן הראשון בסביבת ייצור. חברות מתמחות מספקות בעקביות בתוך שבועות את מה שחברות ייעוץ גדולות מתמחרות בחודשים, מכיוון שמודל ההכנסות שונה: אנו מאיישים לצורך אספקה, לא לצורך חיוב שעות. פרויקטי AI המוגדרים היטב מניבים בדרך כלל ROI של 200-400% בתוך 12-18 חודשים. המדד הרלוונטי יותר הוא עלות שקועה שנמנעה: Deloitte מצאה שיוזמת AI נטושה ממוצעת עולה $7.2 million. יישום ייחוס שמגיע בפועל לייצור שווה השוואה מול מספר זה, ולא מול דמי הייעוץ בלבד.
מה ההבדל בין יישום ייחוס של AI לבין מסמך ארכיטקטורה?
מסמך ארכיטקטורה מתאר מערכת. יישום ייחוס הוא המערכת עצמה. הוא כולל קוד מוקשח לייצור עם תשתית כקוד (Terraform או Pulumi), צינורות CI/CD, תצורת הגשת מודלים, לוחות מחוונים של יכולת צפייה, ותיעוד החלטות ארכיטקטורה (ADRs) המסבירים כל בחירה משמעותית. צוות הנדסת הפלטפורמה שלכם יכול לפרוס אותו לסביבת בדיקות (staging), להריץ מולו בדיקות עומס, ולהרחיב אותו ללא עזרת ייעוץ נוספת. מסמך הארכיטקטורה מוטמע בתוך ה-ADRs, ואינו מסופק כמצגת שקפים נפרדת המתבדרת ממה שנבנה בפועל.
האם עליי לבנות פלטפורמת MLOps פנימית או לקנות את SageMaker/Vertex AI?
קנו פלטפורמה מנוהלת אלא אם יש לכם 6+ מהנדסים ייעודיים ו-12+ חודשים כדי להגיע לשוויון ביכולות מול מה ש-SageMaker מעניקה ישירות מהקופסה. פלטפורמות מנוהלות אינן מספקות מענה במצבים ספציפיים: פריסות מרובות עננים או היברידיות, עומסי עבודה הדורשים לוגיקת הגשה מותאמת אישית (מודלי ensemble, תהליכי עבודה סוכניים עם שימוש בכלים), ארגונים הנמנעים מנעילת ספק מסיבות רגולטוריות, וצוותים שההיבטים הכלכליים של ההסקה שלהם הופכים הגשה באירוח עצמי לזולה משמעותית. אירוח עצמי באמצעות vLLM מפחית את עלויות ההסקה לכל טוקן ב-60-80% בהשוואה ל-APIs בענן בהיקף נרחב. אנו מסייעים לכם לשרטט קו זה לפני שתוציאו כסף על מי מהמסלולים.
מדוע 80% מפרויקטי ה-AI בארגונים נכשלים בהשגת ערך?
ניתוח משנת 2025 של RAND Corporation העריך את שיעור הכישלון ב-80.3%. הכישלון הוא כמעט אף פעם לא במודל. הוא במערכת שסביב המודל: היעדר צינורות מאפיינים הגורם להטיית אימון-הגשה, היעדר CI/CD לקידום מודלים, היעדר ניטור המאפשר לסחף מודל לחמוק ללא זיהוי במשך חודשים, וארכיטקטורות המתוכננות ליום ההדגמה (demo day) במקום לפעילות השוטפת ביום שאחרי (day-two operations). 42% מהחברות נטשו את מרבית יוזמות ה-AI שלהן בשנת 2025, עלייה מ-17% בשנת 2024. יישומי ייחוס המתמודדים עם מחזור החיים התפעולי המלא, ולא רק עם אימון המודל, הם הדרך שלכם להימנע מלהפוך לחלק מסטטיסטיקה זו.
באיזו מסגרת להגשת מודלים עליי להשתמש: KServe, Triton או vLLM?
הדבר תלוי בעומס העבודה שלכם. KServe (CNCF incubating, v0.15) היא הבחירה החזקה ביותר לפריסות מבוססות Kubernetes הזקוקות ליעילות כלכלית של התכנסות לאפס (scale-to-zero), פריסות קנרית (canary), ול-Envoy AI Gateway החדש להגבלת קצב טוקנים. vLLM (v0.19, אפריל 2026) שולטת בהגשת LLM עם PagedAttention המספק תפוקה גבוהה פי 2-4 לעומת מודלי Transformers בסיסיים ו-continuous batching השומר על ניצולת GPU גבוהה. NVIDIA Triton מנצחת בהגשת ריבוי מודלים עתירת GPU שבה ביצועים מאומתים ב-MLPerf הם החשובים. מערכות ייצור רבות משלבות ביניהן: KServe כשכבת התזמור עם vLLM או Triton כמנוע הקצה (backend). אנו מגדירים את התצורה לדפוסי התעבורה ולדרישות זמן ההשהיה הספציפיות שלכם.
כיצד אתם מתמודדים עם אבטחת מערכות AI ומודלי איומים?
כל יישום ייחוס כולל מודל איומים המכסה משטחי תקיפה ייעודיים ל-AI: חילוץ מודל (שאילתות חוזרות ונשנות להנדסה לאחור של מודלים קנייניים), הסקת נתוני אימון, קלטים עוינים, ומתקפות שרשרת אספקה על תלויות מודל. ה-OWASP LLM Top 10 וה-OWASP Top 10 הנפרד ליישומים סוכניים (פורסם בסוף 2025) מגדירים את קו הבסיס. תקריות אבטחה הקשורות ל-AI זינקו ב-56.4% בשנת 2025, ומתקפות כופר המכוונות לתשתית AI זינקו ב-179% במחצית הראשונה של 2025. מודל האיומים אינו מסמך נפרד. הוא מעצב את הארכיטקטורה: הגבלת קצב, אימות קלט, אימות שלמות של תוצרי מודל, וסריקת תלויות המובנית בצינור ה-CI/CD.
כיצד AI סוכני משנה את דרישות הארכיטקטורה?
מערכות סוכניות דורשות תשתית שפריסות של מודל יחיד אינן דורשות. MCP (Model Context Protocol) מתקנן חיבורי כלים ונתונים. A2A (Agent-to-Agent Protocol) מטפל בתקשורת בין סוכנים. אתם זקוקים לשכבות תזמור לפירוק משימות, ניהול הקשר (context management) לתהליכי עבודה מרובי-שלבים, בקרות ממשל עם אוטונומיה מוגבלת (bounded autonomy), ויכולת צפייה העוקבת אחר פעולות סוכן רב-שלביות ולא אחר קריאות הסקה בודדות. Gartner חוזה כי 40% מהיישומים הארגוניים יטמיעו סוכני AI עד סוף שנת 2026. דפוס הייצור שעובד בחברות כמו Uber, LinkedIn ו-Klarna עושה שימוש בסוכן מפקח (supervisor agent) מרכזי עם עובדים מתמחים, ניטור התקדמות, ונתיבי ביקורת מקיפים.
מה קורה לאחר סיום ההתקשרות? האם הצוות שלנו יכול לתחזק את המערכת?
זוהי כל המהות של יישום ייחוס לעומת התקשרות של שירות מנוהל. כל רכיב מתועד בתיעוד החלטות ארכיטקטורה (ADRs) המסביר מה נבחר, אילו חלופות נבחנו, ומה יידרש לשנות אם הדרישות שלכם ישתנו. הקוד נמצא במאגר שלכם, התשתית נמצאת בחשבון הענן שלכם, וה-CI/CD רץ בצינור שלכם. אנו מתכננים עבור הצוות שמפעיל את המערכת, לא עבור הצוות שבנה את המודל. דפוסי פריסה סטנדרטיים, ניטור המתריע על מדדים שצוות התפעול שלכם יודע לפעול לפיהם, וחוזי API ברורים בין קוד המודל לתשתית ההגשה. המטרה היא מערכת שאינה דורשת את הבונים המקוריים כדי להמשיך להפעיל אותה.
כיצד אתם מונעים הטיית אימון-הגשה (training-serving skew) במערכות ML בייצור?
הטיית אימון-הגשה מתרחשת כאשר המאפיינים ששימשו במהלך האימון שונים ממה שהמודל רואה בסביבת הייצור. זהו הרוצח השקט של ML בייצור מכיוון שהמודל מידרדר באופן שקט מבלי לזרוק שגיאות. אנו אוכפים נכונות נקודת-זמן (point-in-time correctness) בצינורות מאפיינים: מערכי נתוני האימון משקפים אך ורק את הנתונים שהיו זמינים בעת החיזוי. עבור עומסי עבודה באצוות (batch), אנו מאמתים משימות התממשות של Feast מול שלמות המילוי לאחור (backfill). עבור מקרי שימוש בהזרמה (גילוי הונאות, תמחור בזמן אמת), מאפיינים מחושבים בעת הקליטה (ingestion time). ניטור סחף מאפיינים מובנה בשכבת יכולת הצפייה כך שהצוות שלכם לוכד שינויי התפלגות לפני שהם משפיעים על איכות המודל.
כיצד אתם ניגשים להתאוששות מאסון (DR) עבור מערכות AI?
התאוששות מאסון ב-AI מורכבת יותר מ-DR של יישומים רגילים מכיוון שאתם משחזרים מצב מתואם על פני מודלים, נתוני אימון, מאגרי מאפיינים, צינורות עיבוד וסביבות מחשוב. יישומי הייחוס שלנו כוללים נהלי שחזור מודל לאחור המחוברים למאגר המודלים (חזרה לגרסת ייצור קודמת בתוך דקות, לא שעות), שחזור מאגר מאפיינים עם עקביות נקודת-זמן, יכולת שחזור של צינורות אימון (נתונים, קוד, תצורה וסביבה מנוהלי גרסאות), ובדיקות תקינות אוטומטיות המזהות ירידה בביצועי המודל מול קו הבסיס בייצור ומפעילות שחזור לאחור באופן אוטומטי. ארגונים המיישמים שיטות אלו מדווחים על 60% פחות כשלי התאוששות וזמן ממוצע להתאוששות (MTTR) מהיר ב-80%.
בנו את ה-AI שלכם בביטחון.
שותפו עם צוות בעל ניסיון עמוק בבניית הדור הבא של AI ארגוני. אנו נסייע לכם לתכנן, לבנות ולהטמיע אסטרטגיית AI שתוכלו לסמוך עליה.
Veriprajna ייעוץ דיפ-טק מתמחה בבניית מערכות AI קריטיות לבטיחות עבור תחומי הבריאות, הפיננסים והרגולציה. הארכיטקטורות שלנו מאומתות מול פרוטוקולים מבוססים ומלוות בתיעוד ציות מקיף.