L'Audit di IA per la Selezione Inquilini Segnalava Rosso. La Mia Soluzione Era Ancora Incompleta.

Il risultato rosso che non ha risposto abbastanza
Non potevo ignorare il $2.275 million settlement in Louis et al. v. SafeRent Solutions quando ho cominciato a lavorare sulla questione ingegneristica alla base degli audit sull'IA nel settore abitativo. Un tribunale federale ha concesso l'approvazione definitiva all'accordo nel novembre 2024, senza alcuna ammissione di colpa. Il caso ha reso leggibile un rischio, ma il processo di sviluppo mi ha spinto verso una domanda operativa più complessa: una volta che un audit di modello mostra una disparità, cosa dovrebbe fare esattamente il team?
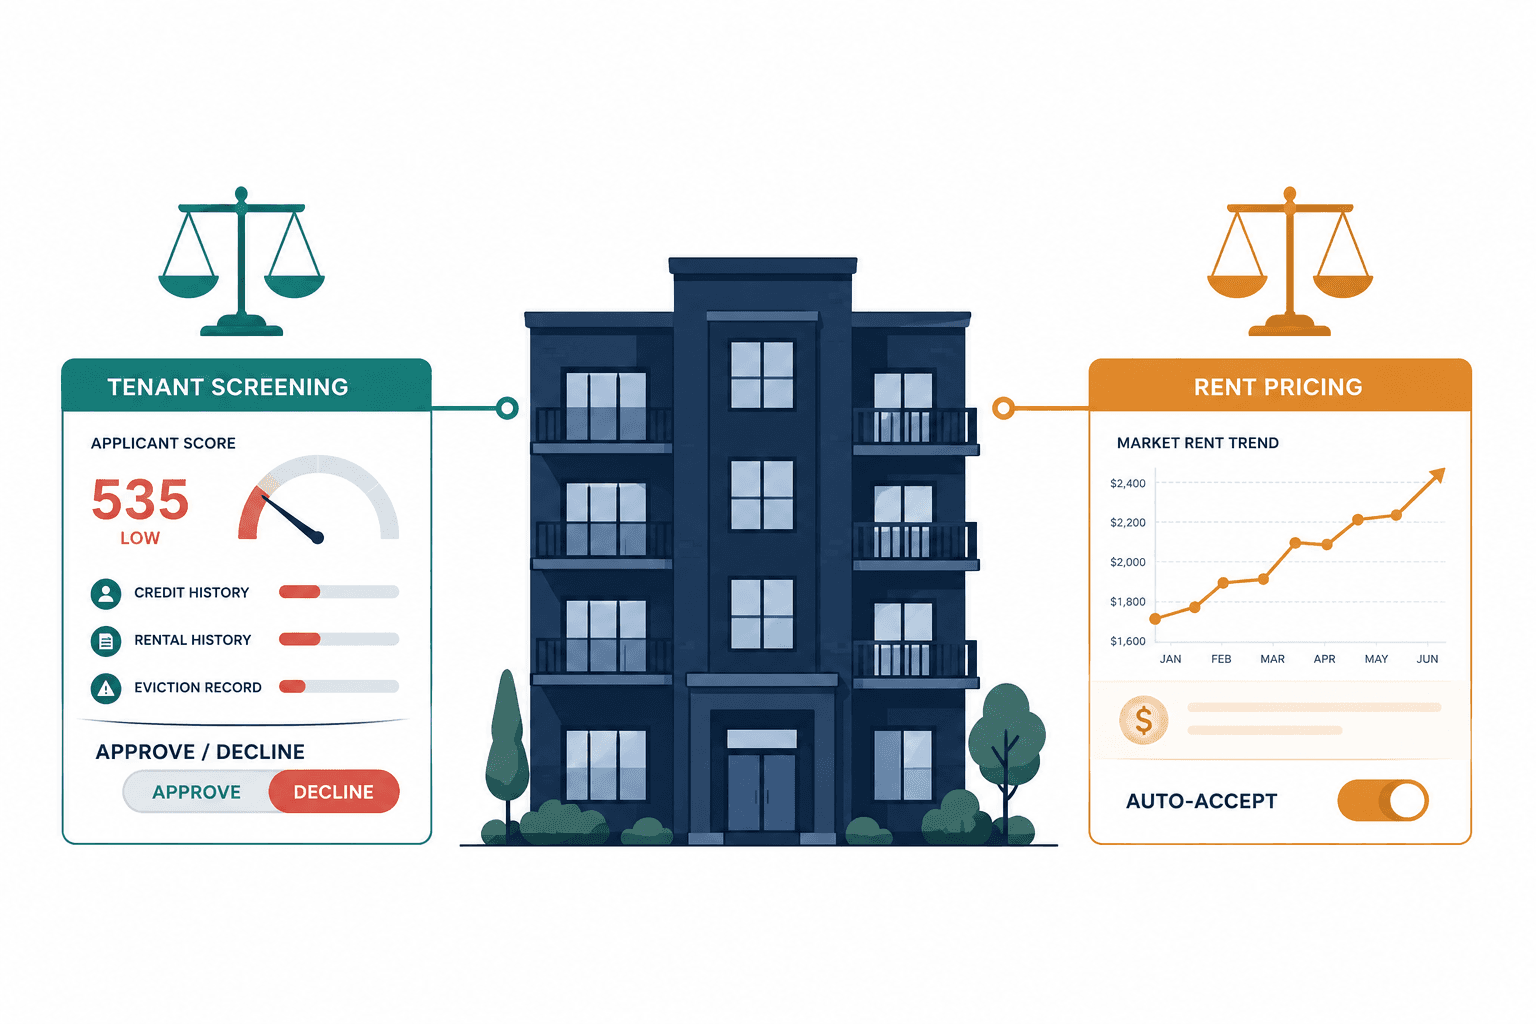
Ho eseguito Equora su un pool sintetico fisso di 9.000 candidati per la selezione degli inquilini. ScreenScore v3, il modello di riferimento orientato al credito nella dimostrazione, ha prodotto un AUC di 0,7823. Il rapporto di impatto disparato minimo, o DIR, si è attestato a 0,694 per i candidati neri. Il gate configurato a quattro quinti nella demo è 0,80. Quella soglia è una scelta progettuale per la dimostrazione, non una conclusione legale e non un test automatico del Fair Housing Act.
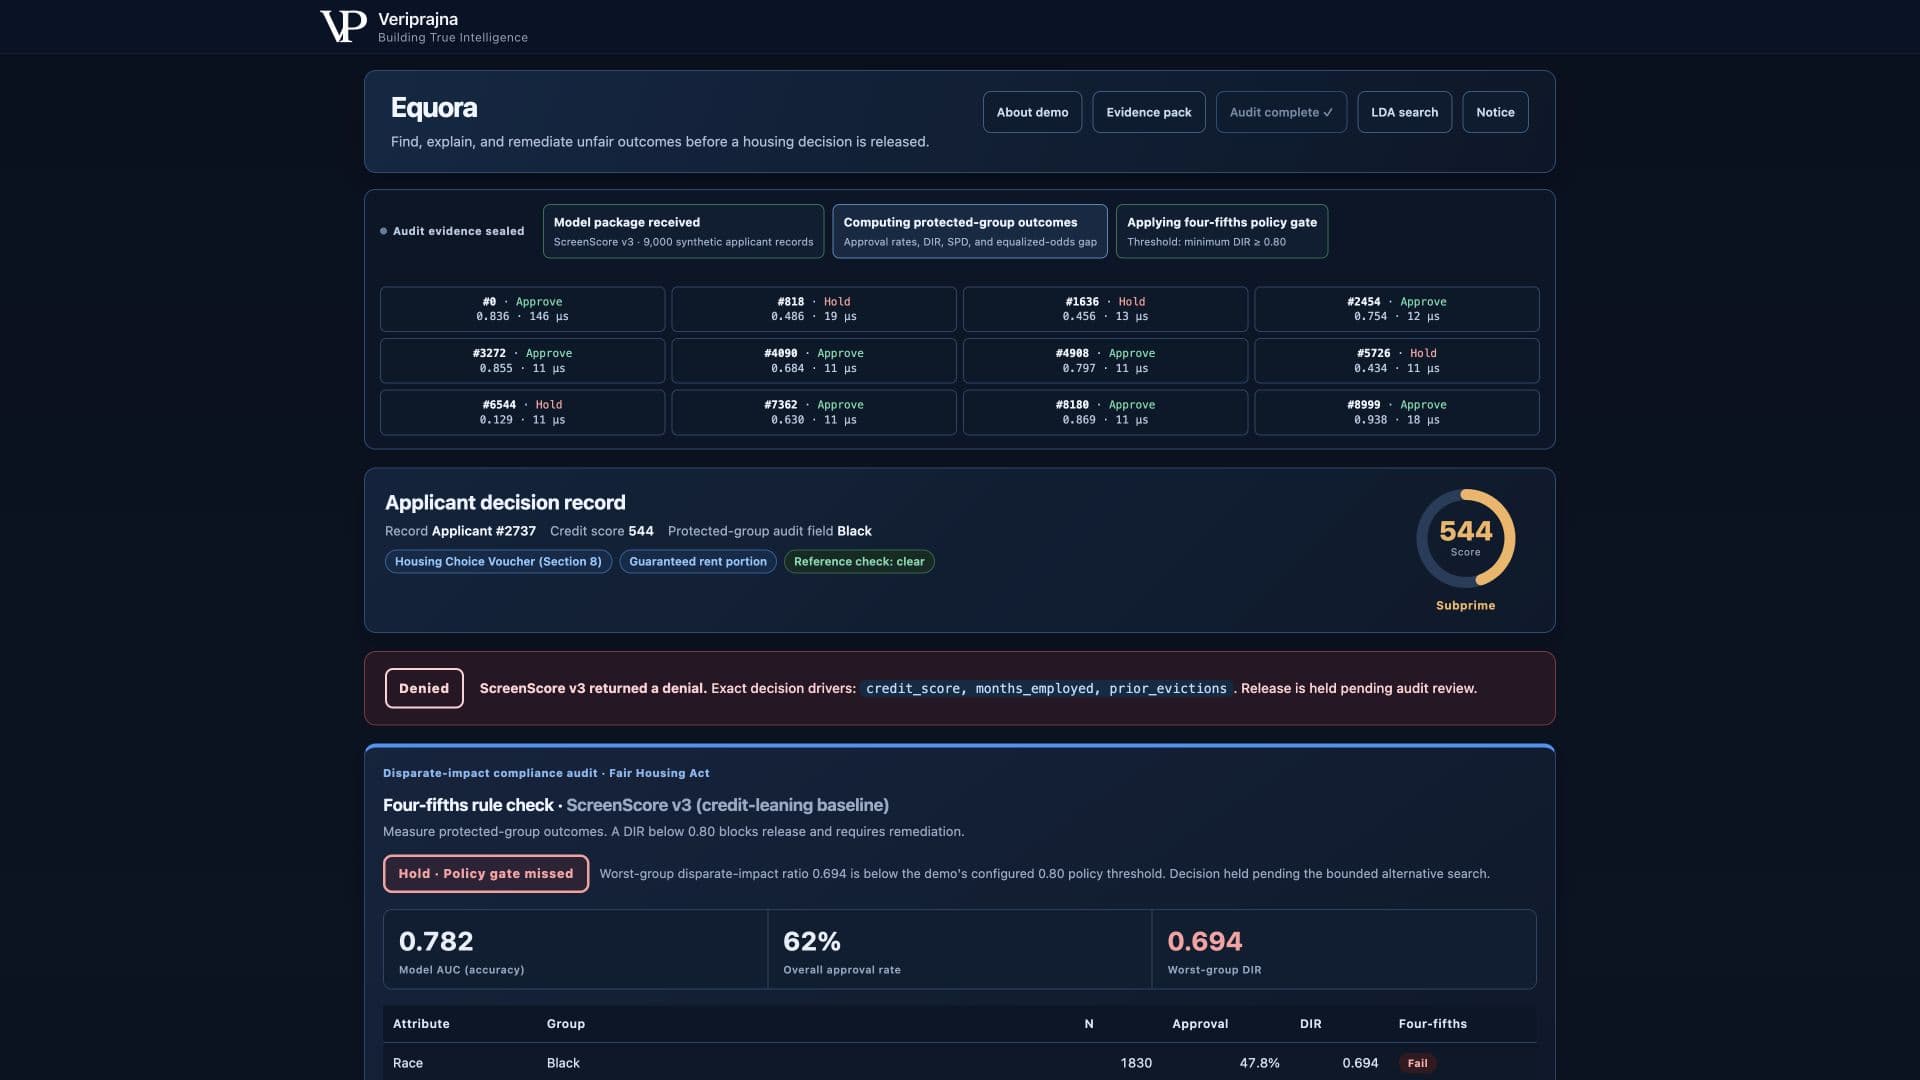
La mia prima versione avrebbe potuto fermarsi lì. Avrebbe potuto rendere il risultato rosso, generare un report e sembrare completa in una riunione di revisione. Invece, mi sono reso conto di aver costruito un allarme migliore senza un piano di risposta. La metrica poteva mostrare al team dove il modello di riferimento non aveva superato il gate configurato. Non poteva mostrare se esistesse un'alternativa con minore disparità, quale utilità tale alternativa avrebbe sacrificato, o come chiunque avrebbe potuto riprodurre la scelta in seguito.
Il walkthrough iniziale è ancora utile in the Equora housing AI compliance breakdown, ma il processo di sviluppo è diventato interessante solo quando l'audit rosso è diventato il punto di partenza.
Cosa la metrica ha lasciato senza risposta
Continuavo a tornare allo stesso spazio vuoto sotto la tabella di audit: quale cambiamento avrei difeso, e su quali prove? Ci sono modi semplici per far muovere un numero di equità. Cambiare la soglia di approvazione. Rimuovere una caratteristica. Aggiungere una caratteristica. Modificare la regolarizzazione. Il punteggio si sposta, ma uno spostamento senza uno spazio di ricerca definito e una regola di selezione stabile è difficile da governare.
Ho provato ad affrontare il problema come una singola modifica al modello. Quella strada si è rivelata subito impercorribile. Se avessi limitato l'influenza del punteggio di credito e il risultato fosse migliorato, non avrei avuto alcun motivo per credere che quel limite fosse preferibile a un altro. Se avessi valorizzato il reddito da voucher garantito, avrei comunque dovuto verificarne il costo in termini di utilità con lo stesso tasso di selezione. Ogni modifica isolata generava un'ulteriore domanda sulle alternative che non avevo valutato.
Ho trascritto quelle domande accanto al risultato e ho capito che il mio prototipo non aveva una risposta stabile a nessuna di esse. Una seconda esecuzione avrebbe potuto riflettere un'intuizione diversa. Una terza avrebbe potuto cambiare l'insieme di confronto senza documentare la modifica. Anche se ogni scelta era sensata in isolamento, la sequenza sarebbe stata difficile da ricostruire. Questo era l'esperimento fallito: avevo trattato la remediation come una serie di scelte di ottimizzazione del modello quando invece doveva essere una procedura di ricerca dichiarata. La distinzione sembra sottile finché qualcuno non chiede perché un candidato accettabile sia stato selezionato rispetto a un altro.
La soluzione era rendere la ricerca stessa un artefatto. Equora valuta 480 configurazioni esplicite, neutrali in apparenza, a parità di selettività. La griglia varia sottoinsiemi di quattro caratteristiche facoltative ad alto rischio, limiti al punteggio di credito senza cap, 720, 680 o 640, se il reddito da voucher garantito viene valorizzato, e sei valori L2 da 0,1 a 30,0. Il rapporto debito/reddito, i mesi di impiego e il reddito dichiarato rimangono inclusi.
Quel confine è importante perché posso descriverlo. Posso rieseguirlo. Posso anche dire cosa non copre. La ricerca non afferma di abbracciare ogni possibile modello, politica o trasformazione delle caratteristiche. È una dimostrazione ingegneristica delimitata con una griglia nota e un budget di accuratezza dichiarato.
Una metrica rossa registra il problema. Una ricerca governata registra la risposta disponibile.
Dovevo rendere la ricerca ispezionabile
Ricordo di aver raggiunto la fase in cui la ricerca funzionava correttamente ma sembrava ancora opaca. Alla fine appariva una raccomandazione, ma il percorso per arrivarci era per lo più nascosto nel codice. Quell'output era matematicamente difendibile e operativamente debole. L'ufficio legale o un revisore del rischio del modello non avrebbe dovuto fidarsi della mia memoria su quali combinazioni fossero state testate.
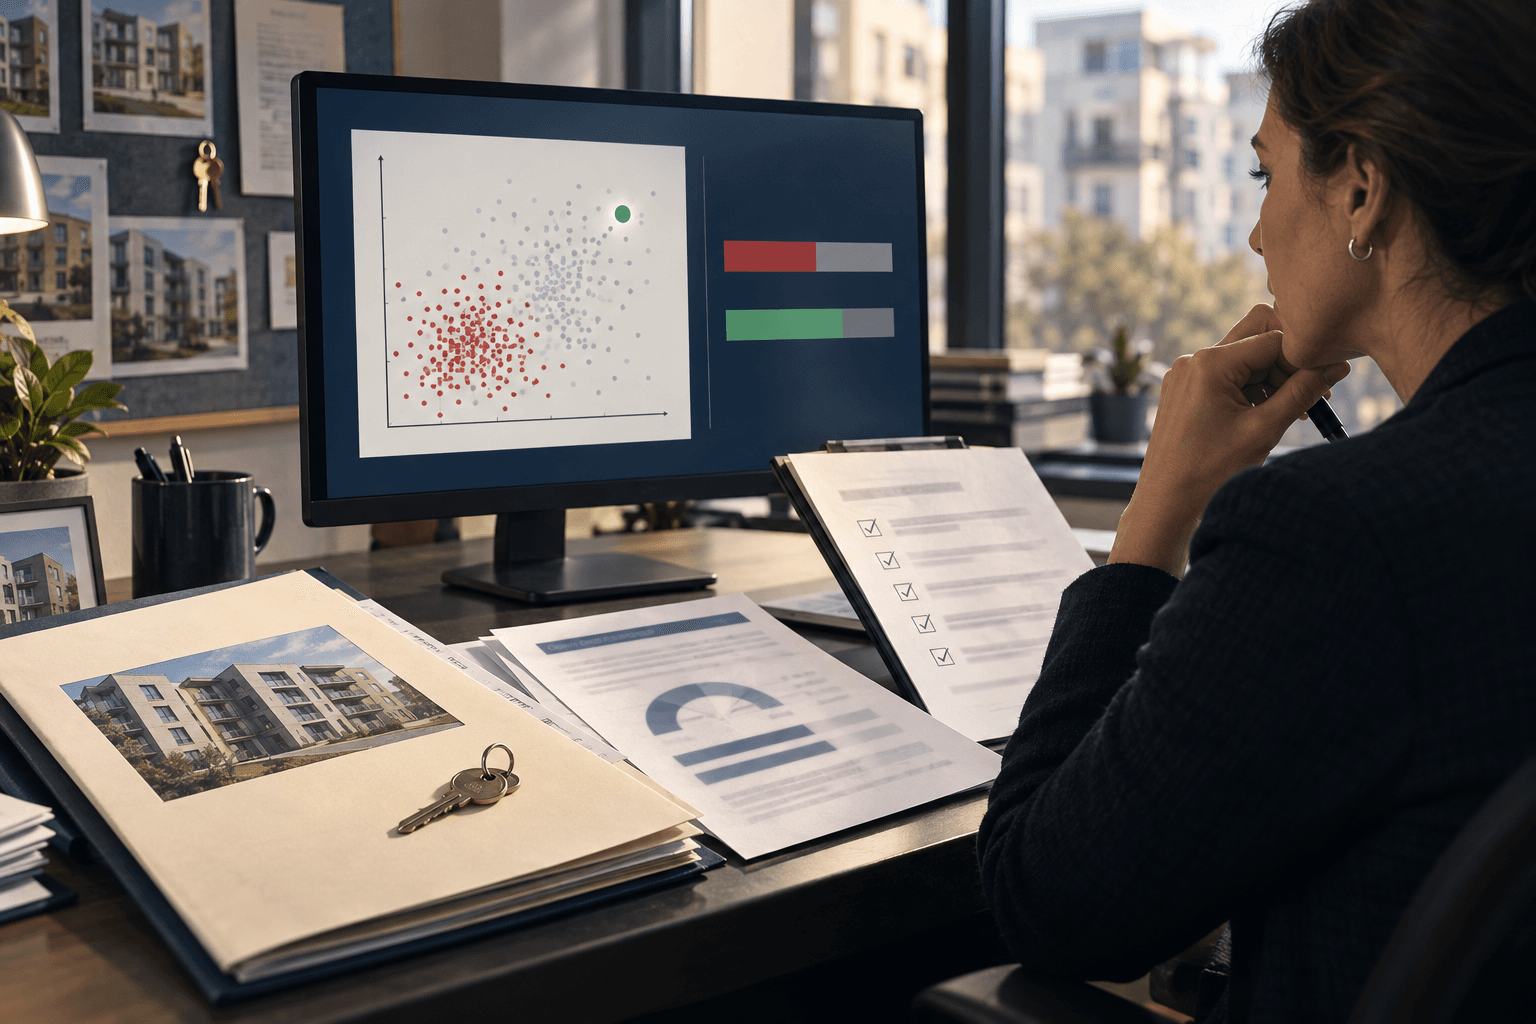
Ho spostato lo spazio di ricerca nell'interfaccia e reso il progresso visibile. Il sistema testa ogni configurazione rispetto allo stesso campione sintetico fisso e alla stessa selettività. Registra l'AUC del candidato e il DIR minimo, quindi traccia la frontiera di Pareto accuratezza/equità. Se nessun candidato supera il gate configurato entro il budget AUC di 0,03, il motore non restituisce nessuna alternativa sicura invece di produrre una raccomandazione artificiale.
Volevo che un revisore potesse porre domande concrete. I limiti al credito erano stati valutati? Il reddito garantito era stato valorizzato? Ogni candidato manteneva la selettività costante? Quanti candidati si erano qualificati secondo la regola configurata? Queste sono domande a cui si può rispondere dal registro. La procedura decisionale rimane al di fuori del modello linguistico: un codice deterministico calcola le metriche, applica il gate e seleziona il candidato qualificato con la minore perdita di AUC misurata.
Dovevo anche resistere alla tentazione di eliminare i candidati non selezionati. Una schermata di prodotto vuole naturalmente mettere in primo piano una sola risposta, ma gli altri punti testati forniscono il contesto alla raccomandazione. La frontiera consente a un revisore di confrontare AUC e DIR minimo tra le configurazioni valutate invece di vedere solo la coordinata selezionata. I candidati esclusi sono parte delle prove, perché mostrano cosa ha confrontato la regola di selezione prima di stabilirsi sul risultato qualificante.
Questo è stato il momento in cui la mia stessa impostazione è cambiata. Avevo iniziato con in mente una dashboard di equità. Quello che stavo effettivamente costruendo era un processo decisionale riproducibile. Il grafico era utile perché ogni punto rappresentava una configurazione testata, non perché una frontiera sia visivamente convincente.
Il compromesso che ho finalmente potuto vedere
Ho osservato l'esecuzione completata valutare tutte le 480 configurazioni e restituire 240 che avevano superato il gate 0,80 della demo entro il budget di accuratezza configurato. La configurazione raccomandata manteneva le caratteristiche di riferimento, aggiungeva il credito di reddito garantito, limitava l'influenza del punteggio di credito a 640 e utilizzava una regolarizzazione L2 di 10,0.
Potevo quindi leggere il risultato come un compromesso anziché come una pretesa di perfezione. Su questo campione sintetico fisso, il DIR minimo è salito da 0,694 a 0,875. L'AUC è passato da 0,7823 a 0,7788, una perdita misurata di 0,0036 che l'interfaccia mostra come 0,36%. Per l'intersezione tra inquilini neri con voucher nel campione, il DIR è passato da 0,701 a 1,029.
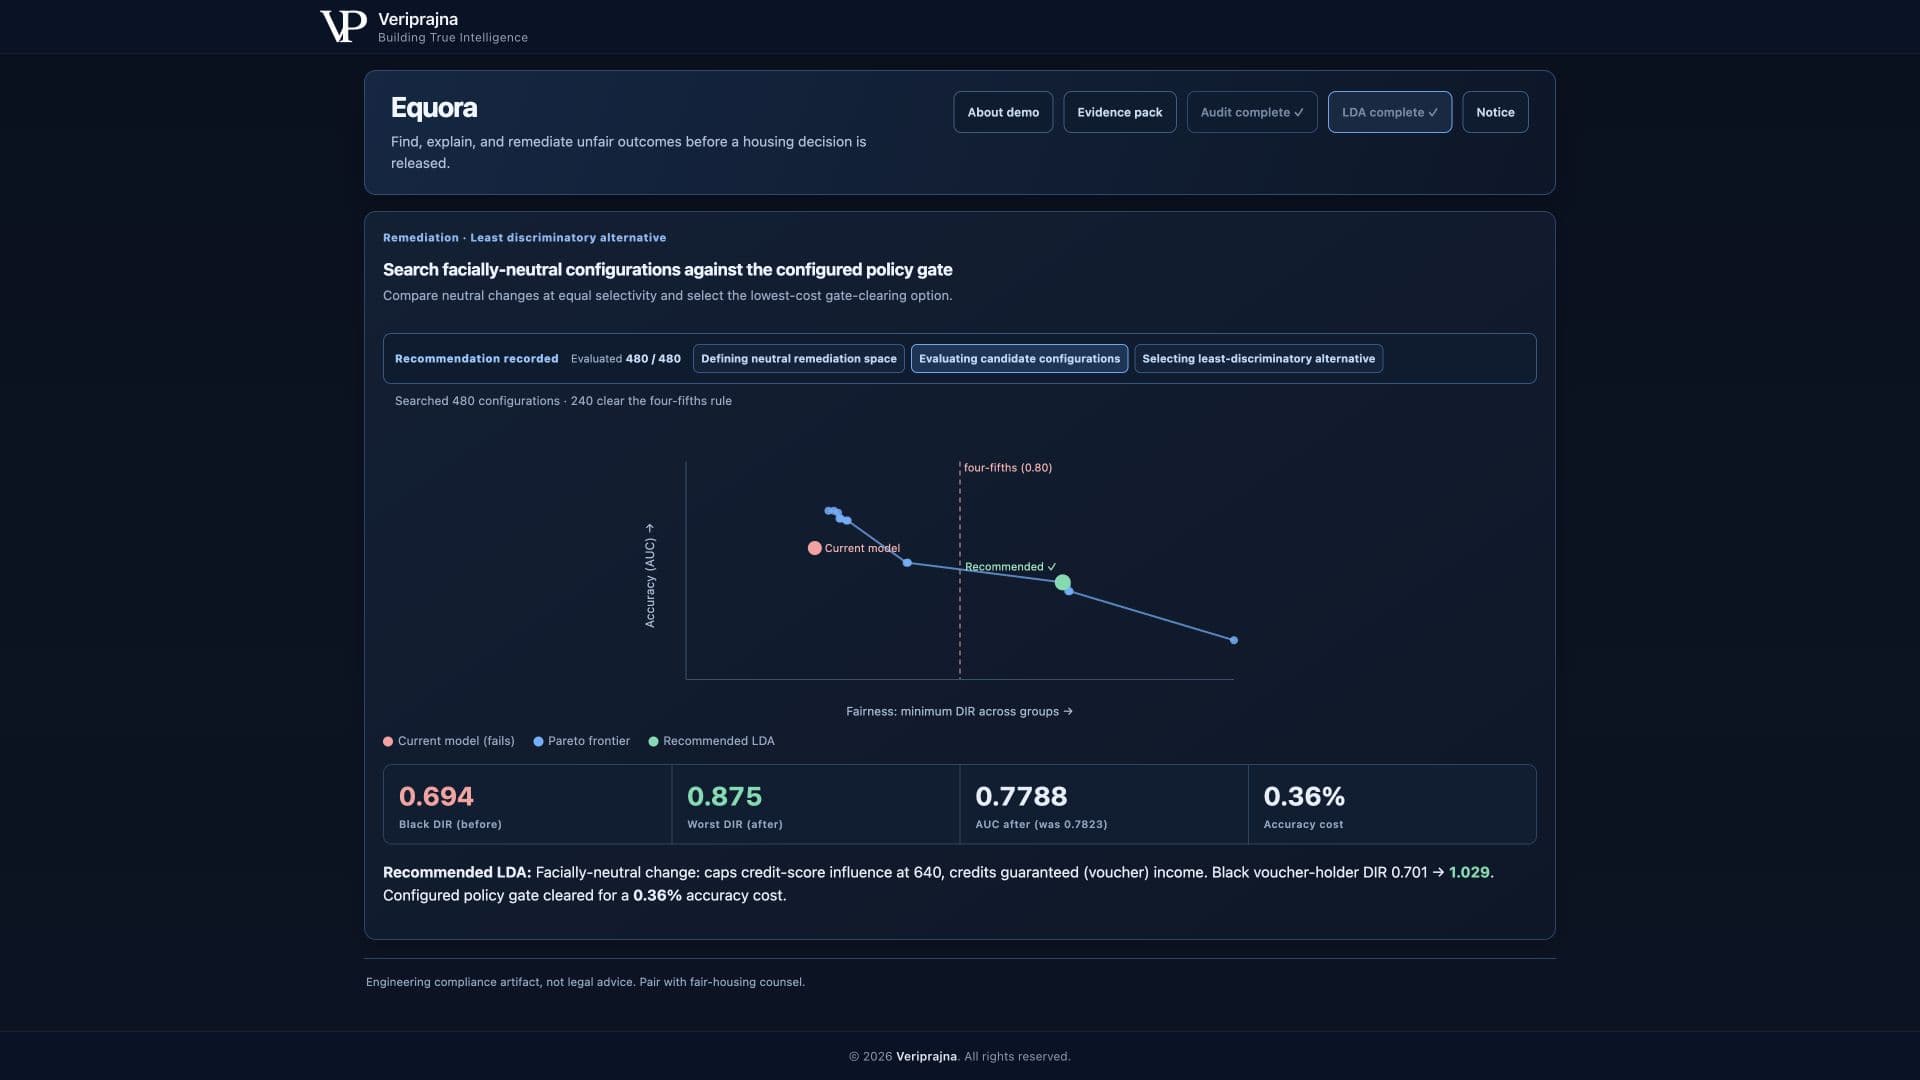
Sono cauto con la parola raccomandato. Questo candidato è l'opzione con il minor costo di AUC misurato che si qualifica all'interno di questa griglia specifica. Non è un ottimo universale, una certificazione legale o una prova di un modello privo di bias. I numeri descrivono un modello di riferimento adattato e una ricerca delimitata su dati sintetici. Non descrivono un proprietario reale, un fornitore di screening, un pool di candidati o un mercato immobiliare.
Ho trovato quella frase più difficile da scrivere rispetto al numero di miglioramento. Il linguaggio di prodotto premia la certezza, mentre il lavoro di governance dipende dalla preservazione del perimetro. L'affermazione delimitata è più forte proprio perché un altro revisore può vedere dove si ferma. Se l'organizzazione espande la griglia, modifica il budget o adotta un gate di policy diverso, dovrà aspettarsi un registro diverso e forse una raccomandazione diversa. Il metodo rimane riproducibile anche quando le ipotesi cambiano.
Tale limitazione non indebolisce la dimostrazione. Rende esplicito il confine della revisione. Un revisore può contestare il budget di 0,03, il gate della policy dei quattro quinti, le caratteristiche disponibili, il vincolo di selettività o la griglia stessa. Questi disaccordi diventano input per un processo che può essere rieseguito, piuttosto che commenti allegati a un punteggio rosso statico.
Perché ho mantenuto le prove al di fuori del testo
Ero tentato di lasciare che il testo generato portasse più spiegazioni perché la prosa rende un'interfaccia più rifinita. Mi sono ritirato da quella posizione. Un paragrafo fluente non può stabilire quali configurazioni siano state testate, calcolare il DIR, o decidere se un candidato superi una soglia. Queste sono affermazioni computazionali, e volevo che il registro sopravvivesse anche se ogni frase generata fosse stata rimossa.
Ho separato i ruoli. Un codice deterministico calcola l'audit, ricerca le alternative, applica il gate configurato e preserva il risultato. Un modello linguistico, quando abilitato, è limitato alla redazione del testo. La modalità offline utilizza un template deterministico. Le prove non dipendono dalla formulazione.
Ho applicato lo stesso confine a una motivazione rivolta al candidato. Per un record sintetico negato, un'attribuzione esatta delle caratteristiche del modello lineare identifica i tre principali fattori negativi. L'avviso deve citare quelle caratteristiche. Un avviso di riserva ben fondato supera quel controllo ristretto, mentre un codice di motivazione generico che non nomina alcuna caratteristica fallisce e viene instradato alla revisione umana. Il critico verifica solo la fondatezza delle caratteristiche. Non stabilisce la piena conformità all'FCRA o la sufficienza legale.
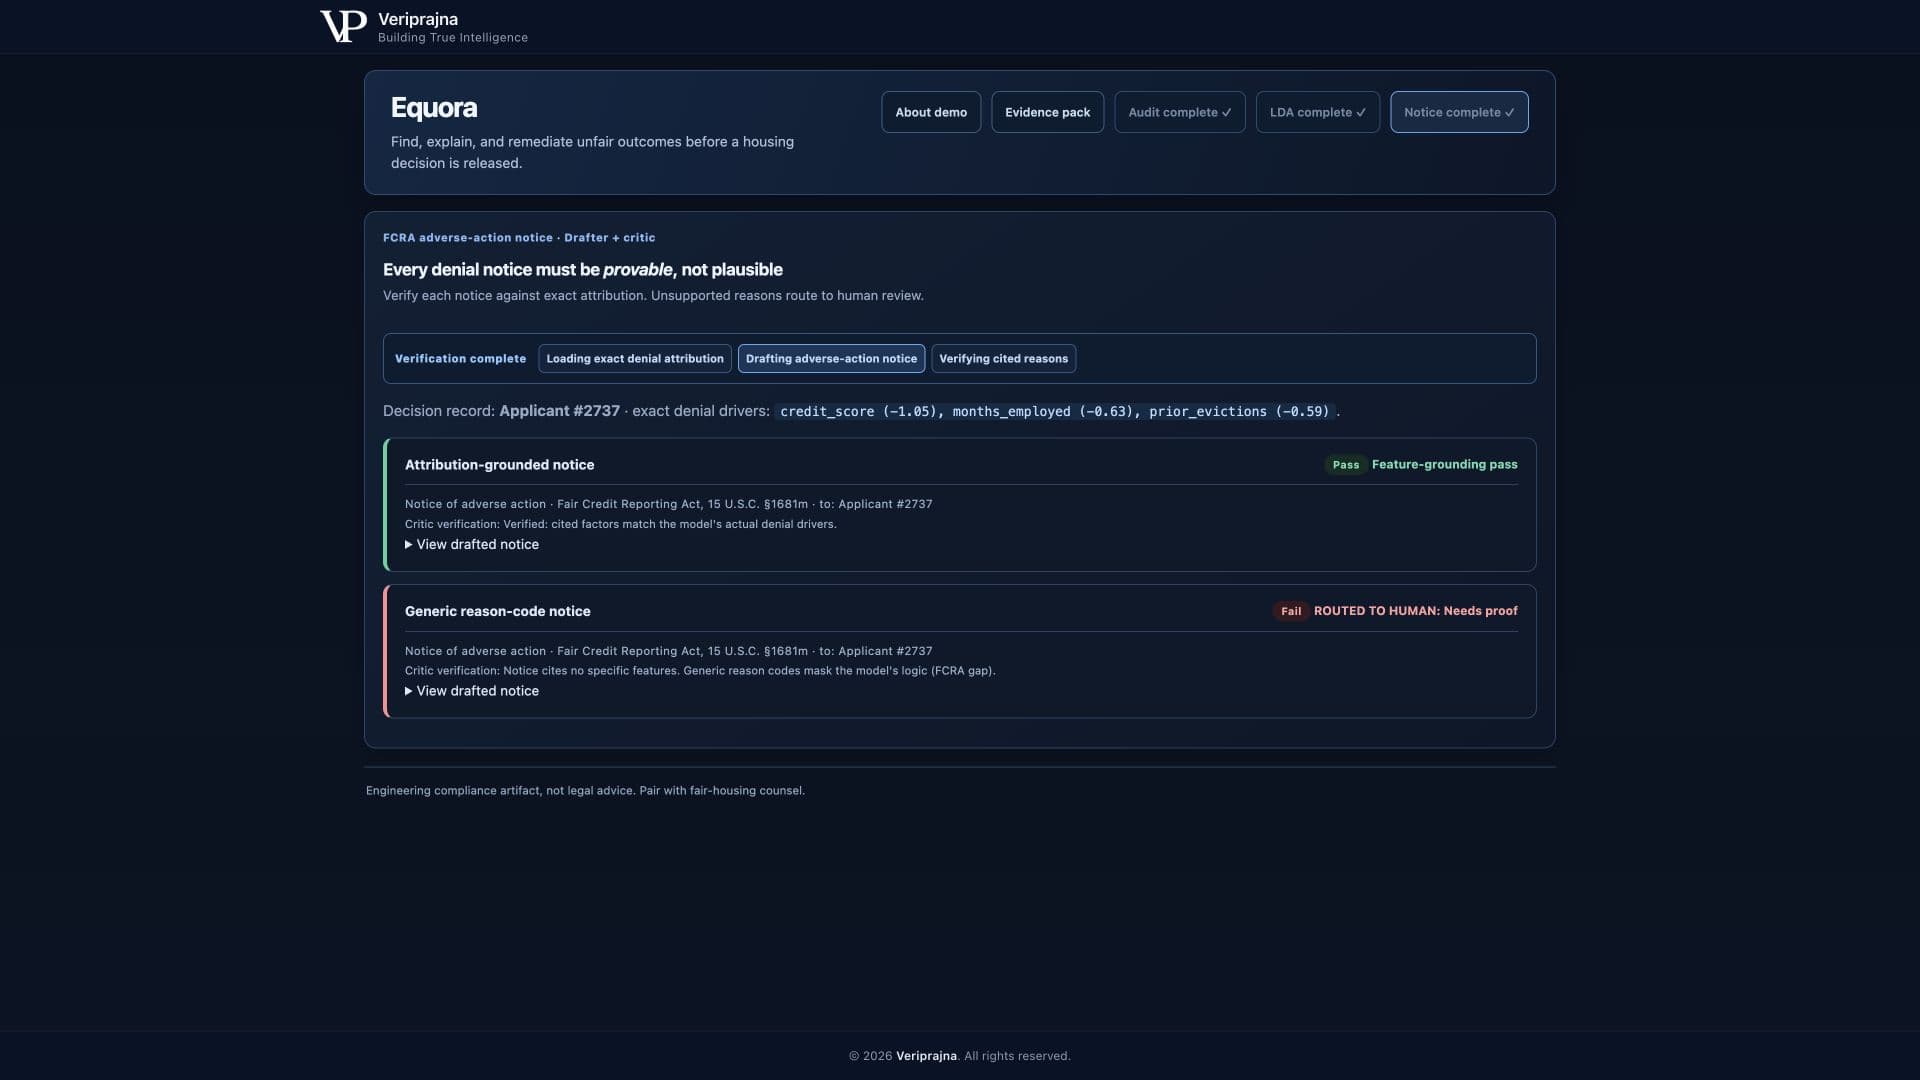
Questo è adiacente alla ricerca piuttosto che una seconda tesi. Una volta che un team sceglie un'alternativa, le prove devono comunque confluire nel registro decisionale e in qualsiasi spiegazione rilasciata da esso. Una ricerca riproducibile perde il suo valore di governance se l'ultimo miglio può inventare una motivazione.
L'artefatto che vorrei avere in sala
Ora immagino la riunione di revisione in modo diverso. Non immagino qualcuno che presenta un punteggio rosso e chiede alla sala di accettare una vaga promessa di migliorare il modello. Immagino un revisore che apre la griglia delimitata, vede ogni candidato con pari selettività, controlla la frontiera di Pareto e risale il risultato selezionato fino alla regola configurata.
Vorrei che il registro mostrasse sia il guadagno che il costo. Qui, ciò significa DIR minimo a 0,875 e AUC a 0,7788 dopo la ricerca, con i valori di riferimento accanto a essi. Vorrei anche che il sistema mantenesse le alternative che ha scartato e restituisse nessuna alternativa sicura quando nessuna si qualifica. Una raccomandazione forzata cancellerebbe l'esito più importante possibile.
Il walkthrough completo è disponibile in the Equora housing AI compliance breakdown. Mostra l'audit, la ricerca dell'Alternativa Meno Discriminatoria delimitata, la vista del compromesso e il passaggio delle prove. Rimane una dimostrazione ingegneristica costruita su dati sintetici, non un sistema decisionale di produzione o un consiglio legale.
E se preferisci vedere il flusso di lavoro invece di leggere la mia descrizione, ecco il walkthrough del fondatore che si esegue dall'inizio alla fine.
Ho iniziato con una metrica rossa perché era la cosa più ovvia da visualizzare. Ho concluso convinto che l'artefatto più prezioso è il percorso riproducibile dal risultato rosso a una scelta delimitata, inclusa la possibilità che il percorso si concluda senza alcuna scelta qualificante. Un audit può dire a un team di fermarsi. Un registro di ricerca può mostrare cosa hanno esaminato prima di decidere come procedere.