A Triagem de Inquilinos Ficou Vermelha. Minha Construção Ainda Estava Incompleta.

O resultado vermelho que não respondeu o suficiente
Eu não pude ignorar o $2.275 million settlement in Louis et al. v. SafeRent Solutions quando comecei a trabalhar a questão de engenharia por trás das auditorias de IA habitacional. Um tribunal federal deu aprovação final ao acordo em novembro de 2024, sem admissão de culpa. O caso tornou um risco legível, mas o projeto me forçou a uma questão operacional mais difícil: quando uma auditoria de modelo revela uma disparidade, o que exatamente a equipe deve fazer a seguir?
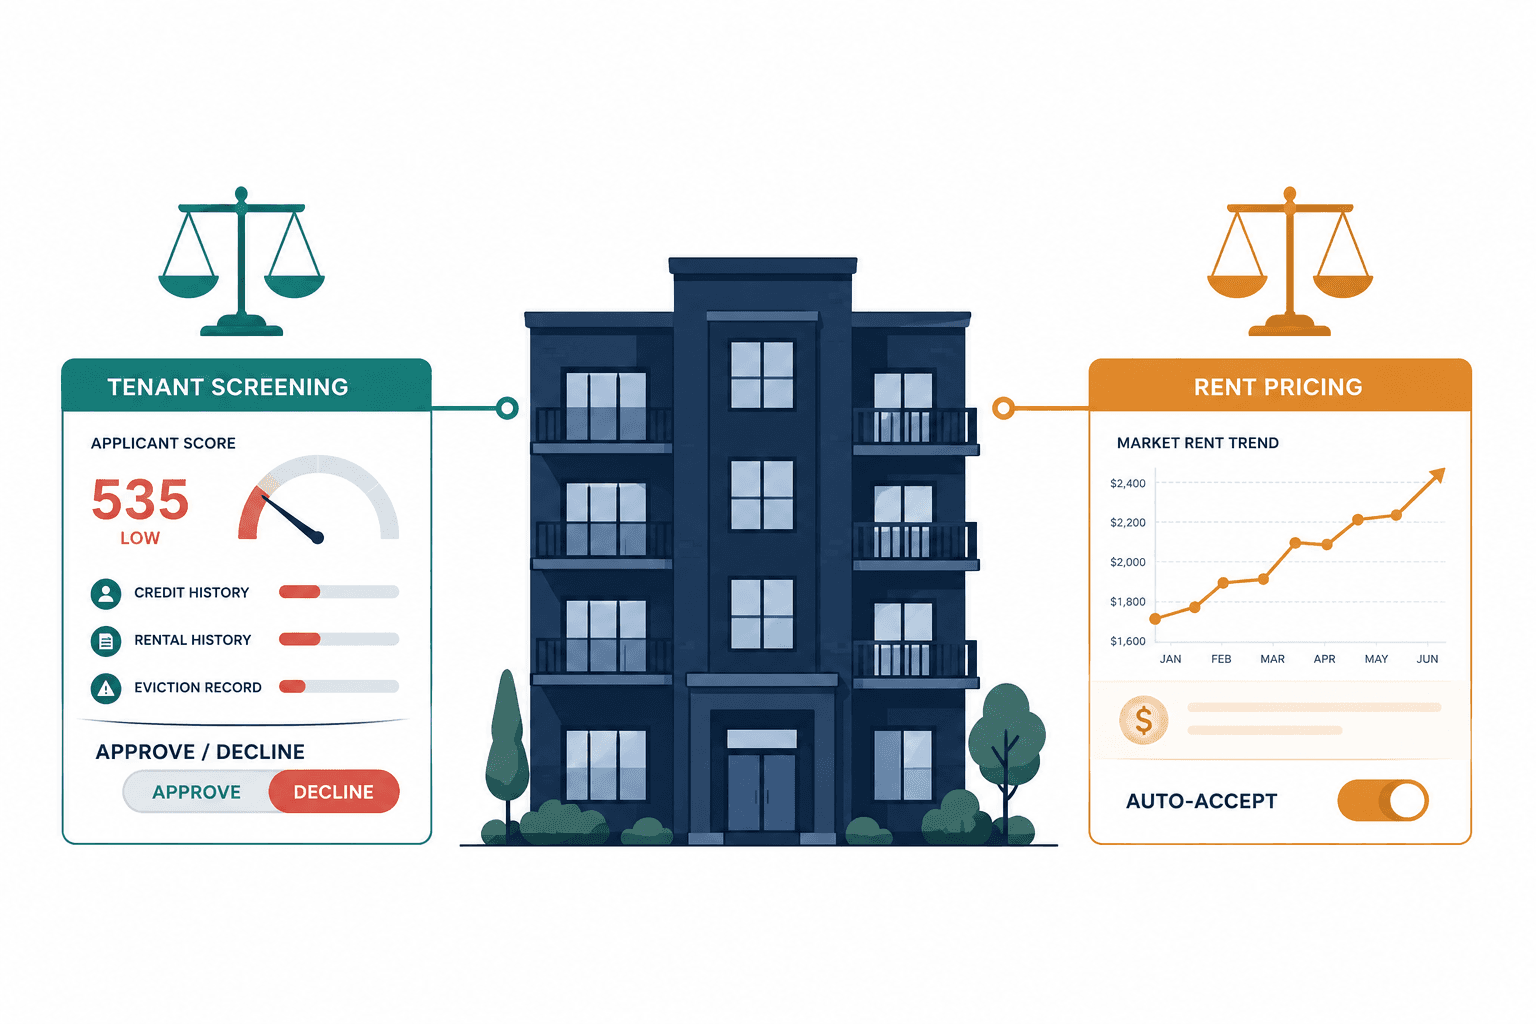
Executei o Equora contra um conjunto sintético de triagem de inquilinos com 9.000 registros. O ScreenScore v3, a linha de base de crédito na demonstração, produziu um AUC de 0,7823. A razão de impacto díspare mínima, ou DIR, ficou em 0,694 para candidatos negros. O gate de política dos quatro quintos configurado na demonstração é 0,80. Esse limiar é uma escolha de design para a demonstração, não uma conclusão legal nem um teste automático da Lei de Habitação Justa.
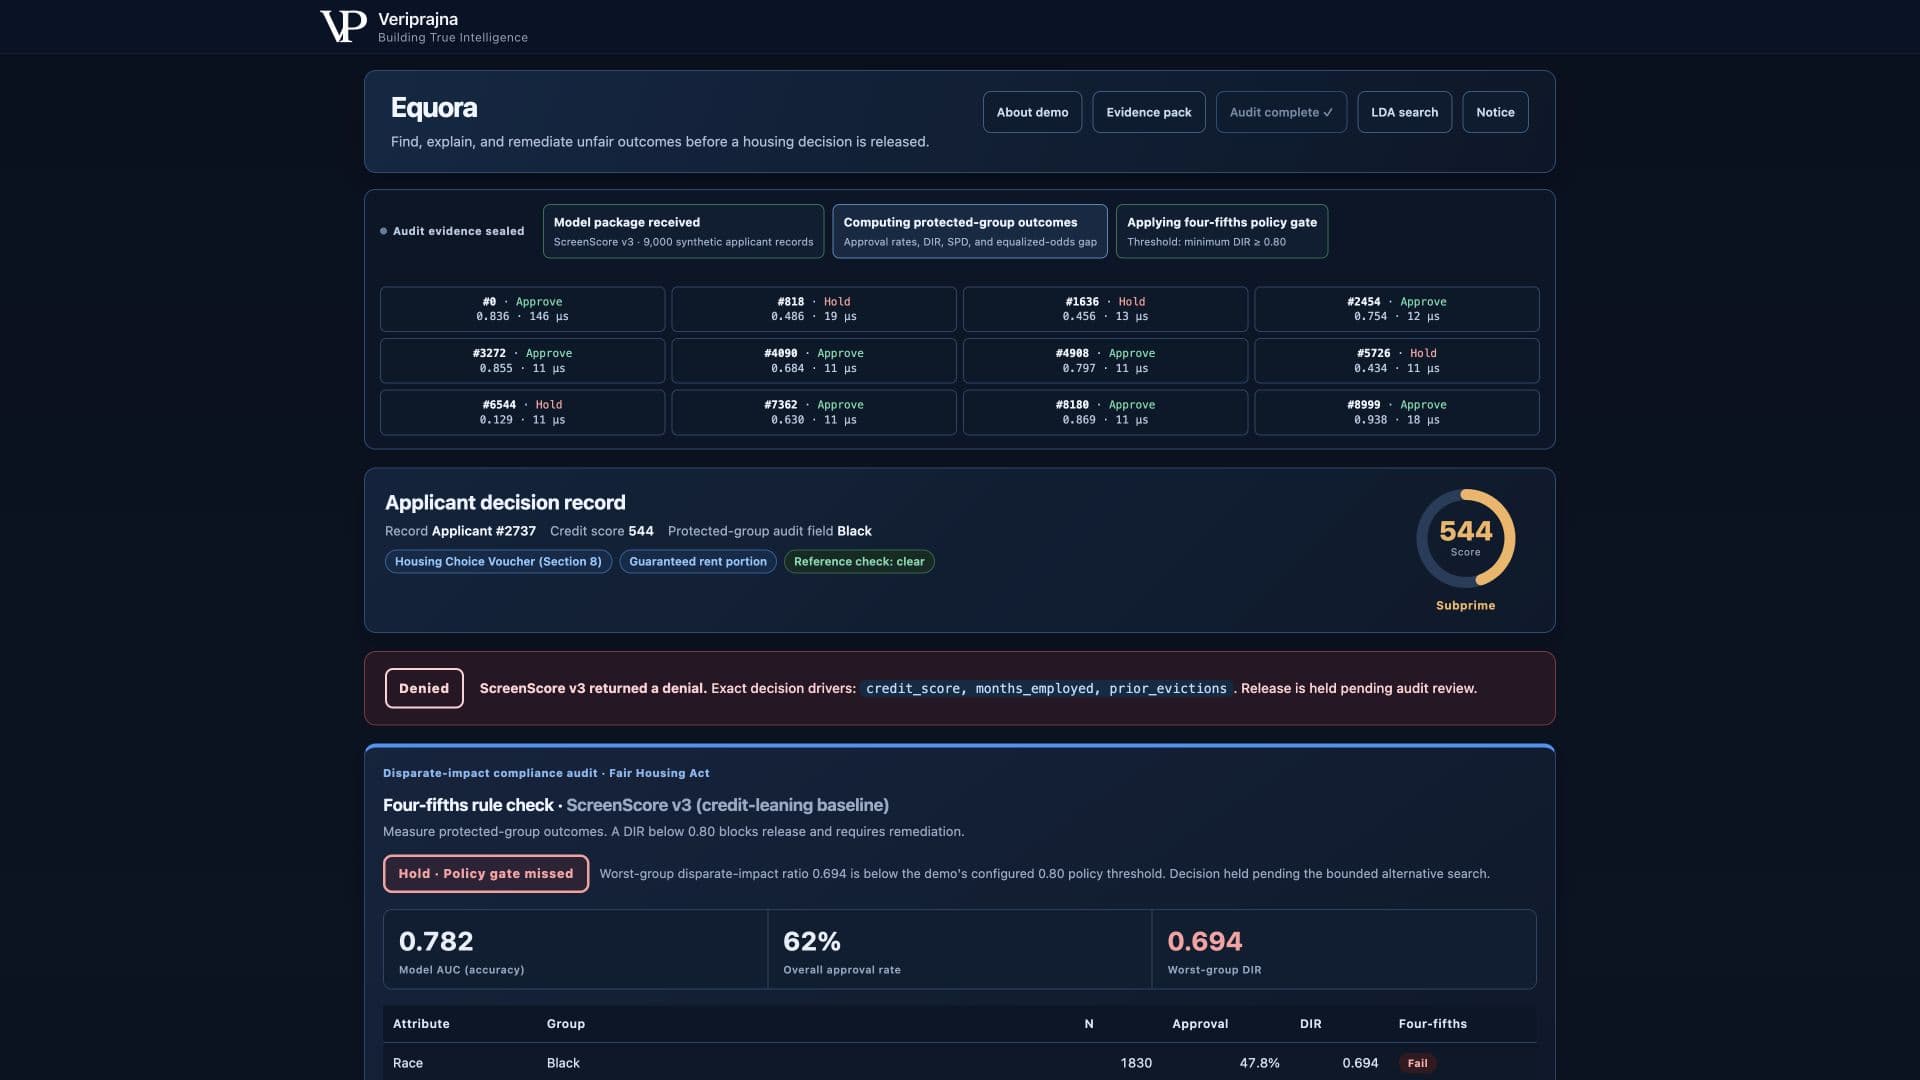
Minha primeira versão poderia ter parado aí. Poderia ter deixado o resultado vermelho, gerado um relatório e parecido completa em uma reunião de revisão. Em vez disso, senti que havia construído um alarme melhor sem um plano de resposta. A métrica podia mostrar à equipe onde a linha de base falhou em seu gate configurado. Ela não podia mostrar se existia uma alternativa de menor disparidade, qual utilidade essa alternativa sacrificaria ou como alguém poderia replicar a escolha mais tarde.
A apresentação inicial ainda é útil em a análise de conformidade de IA habitacional do Equora, mas o projeto só ficou interessante quando a auditoria vermelha se tornou o ponto de partida.
O que a métrica deixou sem resposta
Eu continuava voltando ao mesmo espaço em branco abaixo da tabela de auditoria: qual mudança eu defenderia, e com base em quais evidências? Existem maneiras fáceis de fazer um número de equidade se mover. Alterar o limiar de aprovação. Remover uma variável. Adicionar uma variável. Modificar a regularização. O escore se move, mas um movimento sem um espaço de busca definido e uma regra de seleção estável é difícil de governar.
Tentei pensar no problema como uma única edição de modelo. Isso falhou rapidamente. Se eu limitasse a influência do escore de crédito e o resultado melhorasse, ainda assim não teria razão para acreditar que esse limite era preferível a outro. Se eu creditasse a renda garantida por voucher, ainda precisaria ver seu custo de utilidade à mesma taxa de seleção. Cada mudança isolada criava outra pergunta sobre as alternativas que eu não havia avaliado.
Escrevi essas perguntas ao lado do resultado e percebi que meu protótipo não tinha uma resposta estável para nenhuma delas. Uma segunda execução poderia refletir um palpite diferente. Uma terceira poderia alterar o conjunto de comparação sem documentar a mudança. Mesmo que cada escolha fosse sensata de forma isolada, a sequência seria difícil de reconstruir. Esse foi o experimento fracassado: Eu havia tratado a remediação como uma série de escolhas de ajuste de modelo, quando ela precisava ser um procedimento de busca declarado. A distinção parece sutil até que alguém pergunte por que um candidato aceitável foi selecionado em detrimento de outro.
A solução foi tornar a própria busca um artefato. O Equora avalia 480 configurações explícitas e neutras em aparência com igual seletividade. A grade varia subconjuntos de quatro variáveis opcionais de alto risco, limites de escore de crédito de sem limite, 720, 680 ou 640, se a renda garantida por voucher é creditada, e seis valores de L2 de 0,1 a 30,0. A relação dívida-renda, os meses de emprego e a renda declarada permanecem incluídos.
Esse limite importa porque posso descrevê-lo. Posso reexecutá-lo. Também posso dizer o que ele não cobre. A busca não afirma abranger todos os modelos, políticas ou transformações de variáveis possíveis. É uma demonstração de engenharia delimitada com uma grade conhecida e um orçamento de precisão declarado.
Uma métrica vermelha registra o problema. Uma busca governada registra a resposta disponível.
Eu precisava tornar a busca inspecionável
Lembro de ter chegado ao estágio em que a busca funcionava corretamente, mas ainda parecia opaca. Uma recomendação aparecia no final, mas o caminho até ela estava em grande parte oculto no código. Esse resultado era matematicamente defensável e operacionalmente fraco. Um advogado ou revisor de risco de modelo não deveria ter que confiar na minha memória sobre quais combinações foram testadas.
Movi o espaço de busca para a interface e tornei o progresso visível. O sistema testa cada configuração contra o mesmo conjunto sintético fixo e a mesma restrição de seletividade. Ele registra o AUC e o DIR mínimo do candidato e, em seguida, traça a fronteira de Pareto de precisão/equidade. Se nenhum candidato ultrapassa o gate configurado dentro do orçamento de AUC de 0,03, o motor não retorna nenhuma alternativa segura em vez de fabricar uma recomendação.
Eu queria que um revisor pudesse fazer perguntas concretas. Os limites de crédito foram avaliados? A renda garantida foi creditada? Todos os candidatos mantiveram a seletividade constante? Quantos candidatos se qualificaram sob a regra configurada? Essas perguntas têm resposta no registro. O procedimento de decisão permanece fora do modelo de linguagem: o código determinístico calcula as métricas, aplica o gate e seleciona o candidato qualificado com a menor perda de AUC medida.
Também precisei resistir a eliminar os candidatos malsucedidos. Uma tela de produto naturalmente quer destacar uma única resposta, mas os outros pontos testados fornecem contexto para a recomendação. A fronteira permite que um revisor compare o AUC e o DIR mínimo entre as configurações avaliadas, em vez de ver apenas a coordenada selecionada. Os candidatos perdedores fazem parte das evidências, porque mostram o que a regra de seleção comparou antes de se decidir pelo resultado qualificado.
Foi o momento em que meu próprio enquadramento mudou. Eu havia começado com um painel de equidade em mente. O que eu estava construindo de fato era um processo de decisão replicável. O gráfico era útil porque cada ponto representava uma configuração testada, não porque uma fronteira é visualmente persuasiva.
O equilíbrio que finalmente pude ver
Observei a execução completa avaliar todas as 480 configurações e retornar 240 que superaram o gate de 0,80 da demonstração dentro do orçamento de precisão configurado. A configuração recomendada manteve as variáveis da linha de base, adicionou crédito de renda garantida, limitou a influência do escore de crédito a 640 e usou regularização L2 de 10,0.
Eu podia então ler o resultado como um equilíbrio, e não como uma afirmação de perfeição. Neste conjunto sintético fixo, o DIR mínimo subiu de 0,694 para 0,875. O AUC passou de 0,7823 para 0,7788, uma perda medida de 0,0036 que a interface mostra como 0,36%. Para a interseção de titulares de voucher negros no conjunto de dados, o DIR passou de 0,701 para 1,029.
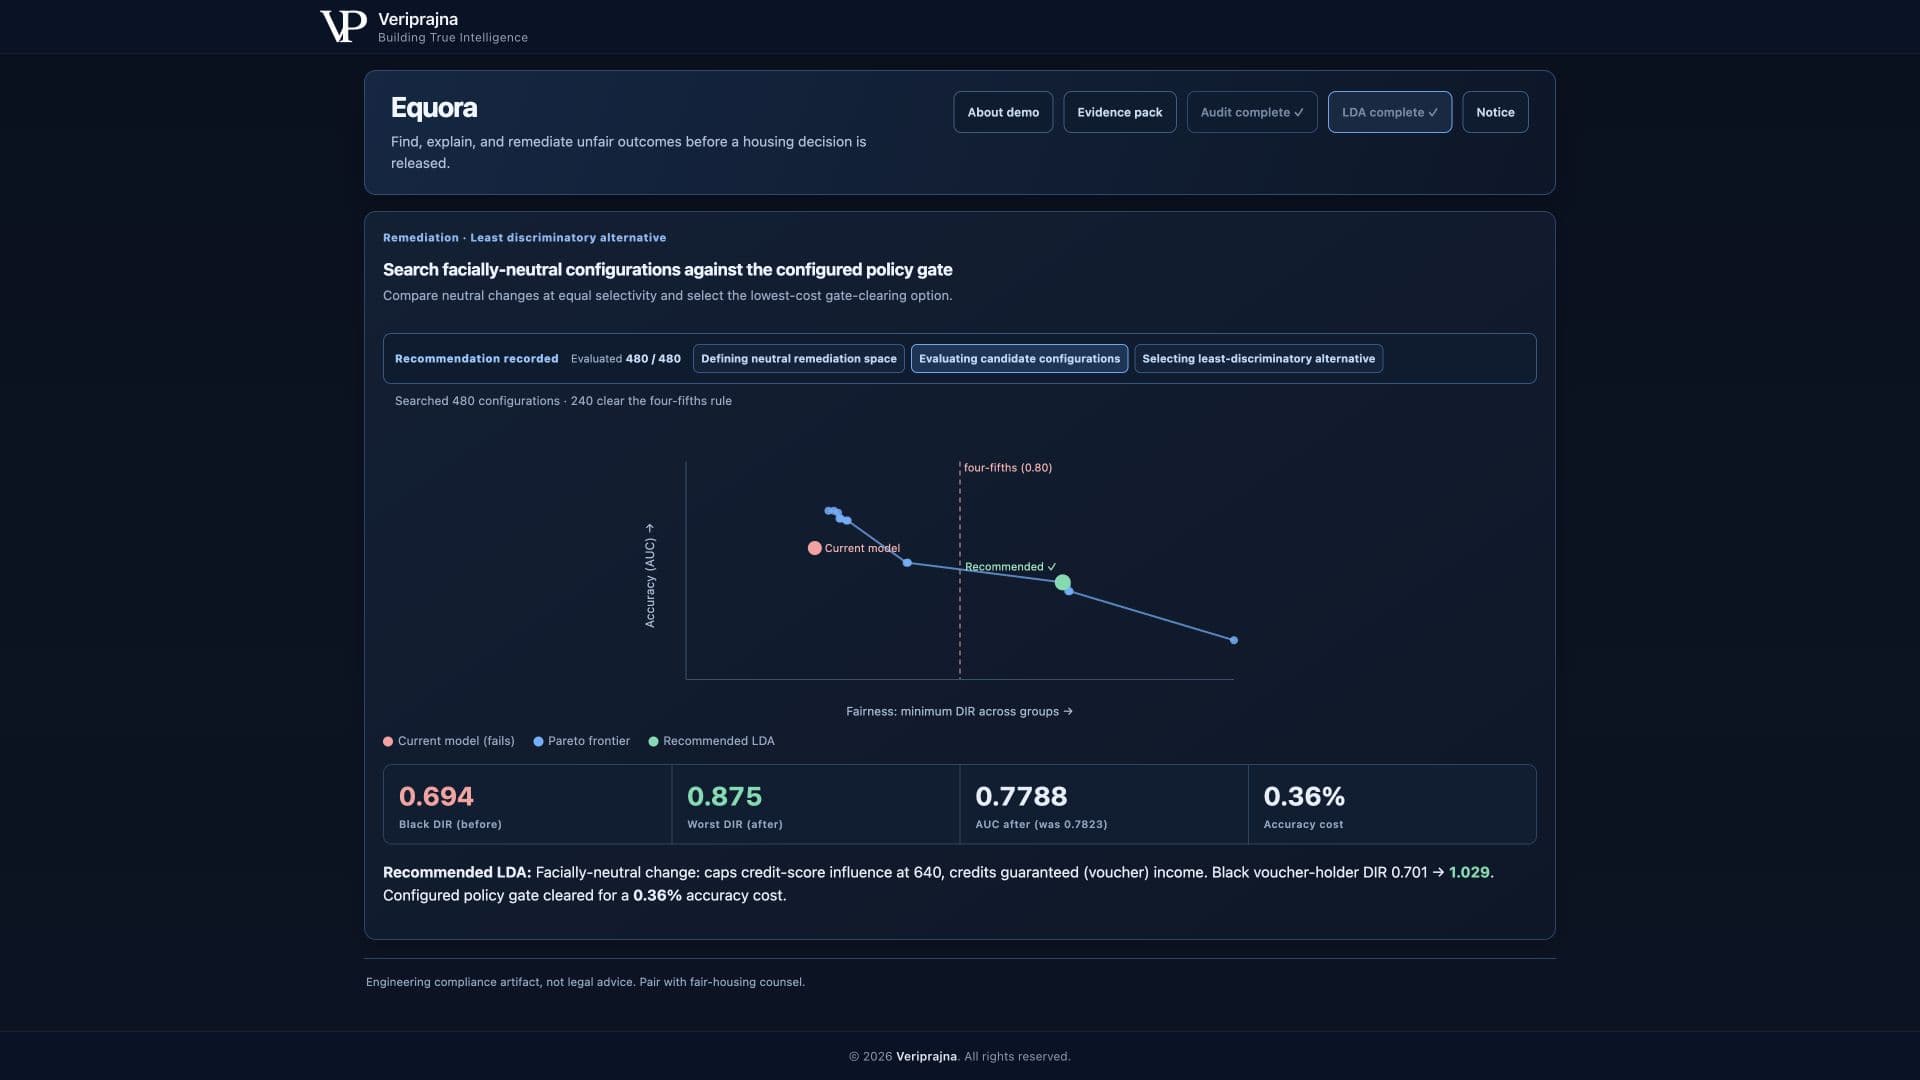
Sou cuidadoso com a palavra recomendado. Este candidato é a opção de menor custo de AUC medido que se qualifica dentro desta grade específica. Ele não é um ótimo universal, uma certificação legal ou prova de um modelo livre de viés. Os números descrevem uma linha de base ajustada e uma busca delimitada em dados sintéticos. Eles não descrevem um proprietário real, fornecedor de triagem, conjunto de candidatos ou mercado imobiliário.
Achei essa frase mais difícil de escrever do que o número de melhoria. A linguagem de produto recompensa a certeza, enquanto o trabalho de governança depende da preservação do escopo. A afirmação delimitada é mais forte precisamente porque outro revisor pode ver onde ela para. Se a organização expandir a grade, alterar o orçamento ou adotar um gate de política diferente, ela deve esperar um registro diferente e talvez uma recomendação diferente. O método permanece replicável mesmo quando as premissas mudam.
Essa limitação não enfraquece a demonstração. Ela torna o limite de revisão explícito. Um revisor pode questionar o orçamento de 0,03, o gate de política dos quatro quintos, as variáveis disponíveis, a restrição de seletividade ou a própria grade. Essas discordâncias se tornam entradas para um processo que pode ser reexecutado, em vez de comentários anexados a um escore vermelho estático.
Por que mantive as evidências fora do texto
Fui tentado a deixar o texto gerado carregar mais da explicação porque a prosa faz uma interface parecer completa. Recuei disso. Um parágrafo fluente não pode estabelecer quais configurações foram testadas, calcular o DIR ou decidir se um candidato passa em um limiar. Essas são afirmações computacionais, e eu queria que o registro sobrevivesse mesmo que todas as frases geradas fossem removidas.
Separei os papéis. O código determinístico computa a auditoria, busca as alternativas, aplica o gate configurado e preserva o resultado. Um modelo de linguagem, quando habilitado, está limitado a redigir texto. O modo offline usa um modelo determinístico. As evidências não dependem da redação.
Apliquei o mesmo limite a uma razão voltada ao candidato. Para um registro sintético negado, a atribuição exata de variáveis de modelo linear identifica os três principais contribuidores negativos. O redigidor do aviso deve citar essas variáveis. Um aviso de fallback fundamentado passa por essa verificação restrita, enquanto um código de motivo genérico que não nomeia nenhuma variável falha e é encaminhado para revisão humana. O crítico verifica apenas a fundamentação nas variáveis. Ele não estabelece conformidade plena com a FCRA nem suficiência legal.
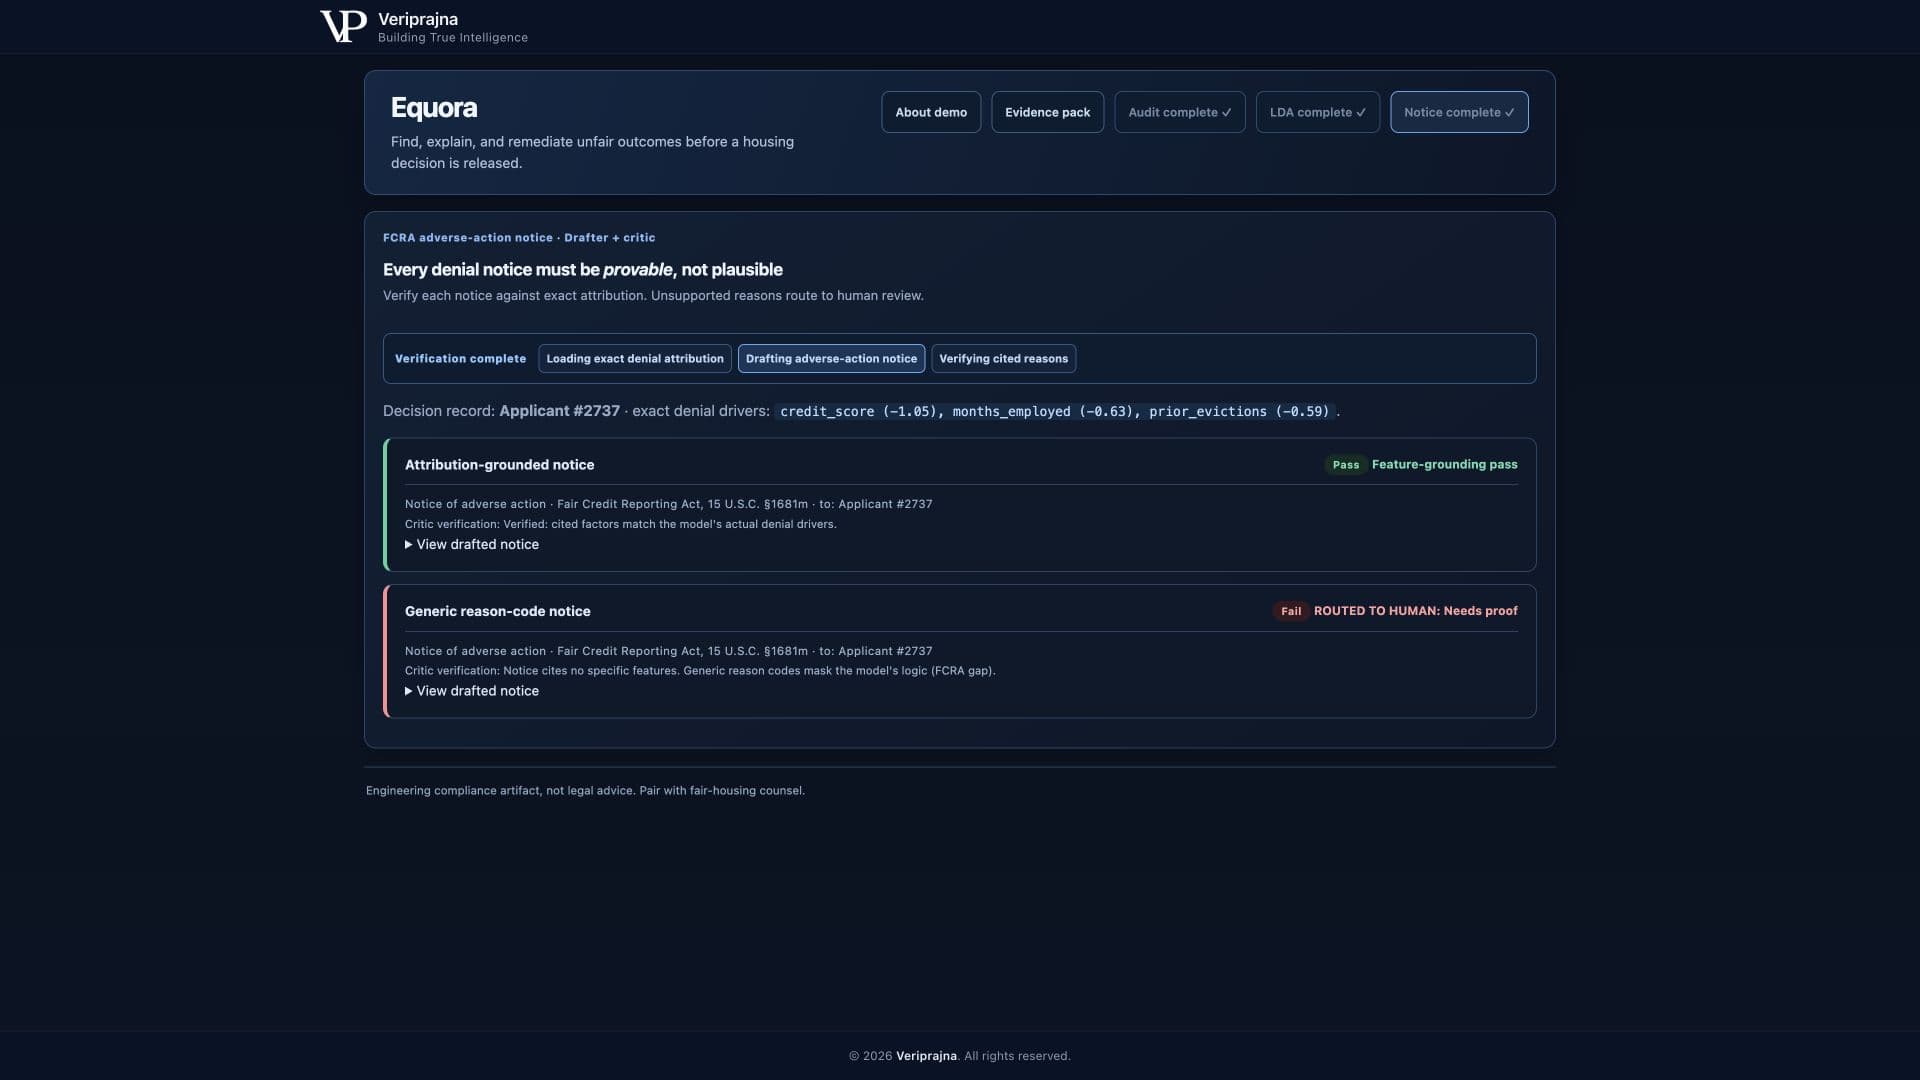
Isso é adjacente à busca, e não uma segunda tese. Uma vez que uma equipe escolhe uma alternativa, as evidências ainda precisam chegar ao registro de decisão e a qualquer explicação divulgada a partir dele. Uma busca reprodutível perde seu valor de governança se o último trecho puder inventar um motivo.
O artefato que eu gostaria de ter na sala
Agora imagino a reunião de revisão de forma diferente. Não imagino alguém apresentando um escore vermelho e pedindo para a sala aceitar uma promessa ampla de melhorar o modelo. Imagino um revisor abrindo a grade delimitada, vendo cada candidato com igual seletividade, verificando a fronteira de Pareto e rastreando o resultado selecionado de volta à regra configurada.
Eu queria que o registro mostrasse tanto o ganho quanto o custo. Aqui, isso significa DIR mínimo em 0,875 e AUC em 0,7788 após a busca, com os valores de linha de base ao lado. Eu também queria que o sistema retivesse as alternativas que rejeitou e retornasse nenhuma alternativa segura quando nenhuma se qualifica. Uma recomendação forçada apagaria o resultado possível mais importante.
O guia completo está disponível em a análise de conformidade de IA habitacional do Equora. Ele mostra a auditoria, a busca delimitada da Alternativa Menos Discriminatória, a visualização do equilíbrio e a entrega das evidências. Permanece uma demonstração de engenharia construída sobre dados sintéticos, não um sistema de decisão em produção ou assessoria jurídica.
E se você preferir ver o fluxo de trabalho a me ouvir descrevê-lo, aqui está o guia do fundador rodando do início ao fim.
Comecei com uma métrica vermelha porque era a coisa óbvia a exibir. Terminei convencido de que o artefato mais valioso é o caminho replicável do resultado vermelho até uma escolha delimitada, incluindo a possibilidade de que o caminho termine sem nenhuma escolha qualificada. Uma auditoria pode dizer a uma equipe para parar. Um registro de busca pode mostrar o que eles examinaram antes de decidir como prosseguir.