Der Mieter-Bonitätsprüfungs-Audit wurde rot. Mein System war noch unfertig.

Das rote Ergebnis, das nicht ausreichend Antworten gab
Ich konnte $2.275 million settlement in Louis et al. v. SafeRent Solutions nicht ignorieren, als ich begann, die technische Fragestellung hinter KI-Audits für den Wohnungsmarkt zu durcharbeiten. Ein Bundesgericht genehmigte den Vergleich im November 2024 endgültig, ohne ein Schuldeingeständnis. Der Fall machte ein Risiko erkennbar, aber der Entwicklungsprozess drängte mich zu einer schwierigeren operativen Frage: Was genau soll das Team tun, sobald ein Modellaudit eine Disparität aufzeigt?
Ich habe Equora gegen ein festes synthetisches Bewerberfeld für die Mieter-Bonitätsprüfung mit 9.000 Datensätzen getestet. ScreenScore v3, das kreditlastige Ausgangsmodell in der Demonstration, erzielte einen AUC-Wert von 0,7823. Das minimale Disparate-Impact-Verhältnis, kurz DIR, betrug 0,694 für schwarze Bewerber. Die konfigurierte Vierfünftel-Richtlinien-Schwelle der Demo beträgt 0,80. Dieser Schwellenwert ist eine Designentscheidung für die Demonstration, keine rechtliche Schlussfolgerung und kein automatischer Test nach dem Fair Housing Act.
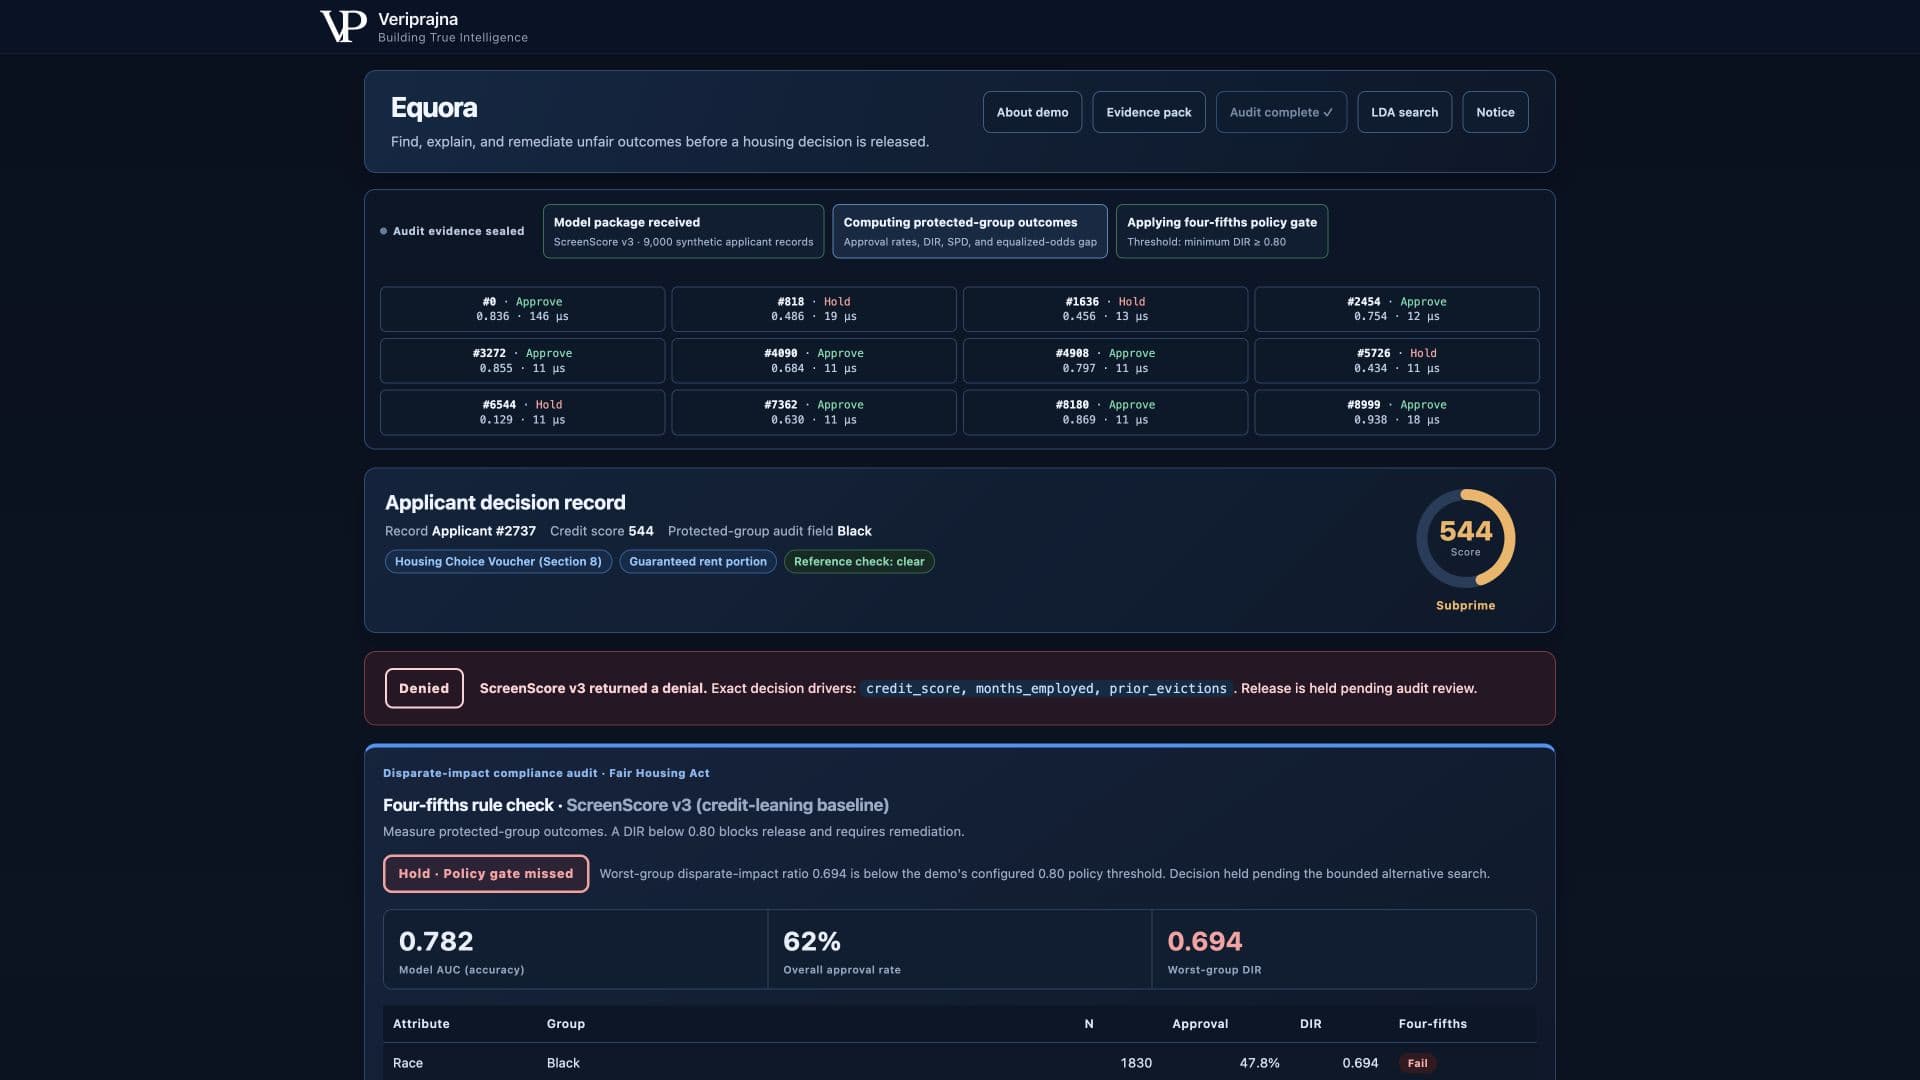
Meine erste Version hätte dort stoppen können. Sie hätte das Ergebnis rot färben, einen Bericht erstellen und in einem Review-Meeting vollständig wirken können. Stattdessen hatte ich das Gefühl, einen besseren Alarm ohne Reaktionsplan gebaut zu haben. Die Kennzahl konnte dem Team zeigen, wo das Ausgangsmodell seine konfigurierte Schwelle verfehlt hatte. Sie konnte nicht zeigen, ob eine Alternative mit geringerer Disparität existierte, welchen Nutzen diese Alternative opfern würde, oder wie die Entscheidung später nachvollzogen werden könnte.
Die frühe Schritt-für-Schritt-Anleitung ist nach wie vor nützlich unter der Equora-Aufschlüsselung zur KI-Compliance im Wohnungsmarkt, aber der Entwicklungsprozess wurde erst interessant, als der rote Audit zur Startlinie wurde.
Was die Kennzahl offenließ
Ich kehrte immer wieder zu derselben leeren Stelle unterhalb der Audit-Tabelle zurück: welche Änderung ich verteidigen würde, und auf welcher Grundlage? Es gibt einfache Möglichkeiten, einen Fairness-Wert zu verschieben. Den Genehmigungsschwellenwert ändern. Ein Merkmal entfernen. Ein Merkmal hinzufügen. Die Regularisierung anpassen. Der Wert bewegt sich, aber eine Bewegung ohne definierten Suchraum und eine stabile Auswahlregel ist schwer zu steuern.
Ich versuchte, das Problem als einzelne Modelländerung zu betrachten. Das scheiterte schnell. Wenn ich den Einfluss des Kredit-Scores begrenzte und sich das Ergebnis verbesserte, hatte ich dennoch keinen Grund zu glauben, dass diese Begrenzung einer anderen vorzuziehen war. Wenn ich garantiertes Gutschein-Einkommen anrechnete, musste ich dennoch dessen Nutzungskosten bei gleicher Auswahlrate sehen. Jede isolierte Änderung warf eine weitere Frage über die von mir nicht bewerteten Alternativen auf.
Ich schrieb diese Fragen neben das Ergebnis und erkannte, dass mein Prototyp auf keine davon eine stabile Antwort hatte. Ein zweiter Durchlauf könnte eine andere Vermutung widerspiegeln. Ein dritter könnte den Vergleichssatz ändern, ohne die Änderung zu dokumentieren. Selbst wenn jede Entscheidung für sich genommen sinnvoll war, wäre die Abfolge schwer zu rekonstruieren. Das war das gescheiterte Experiment: Ich hatte die Behebung als eine Reihe von Modell-Tuning-Entscheidungen behandelt, als sie eine deklarierte Suchprozedur hätte sein müssen. Die Unterscheidung klingt subtil, bis jemand fragt, warum ein akzeptabler Kandidat einem anderen vorgezogen wurde.
Die Lösung bestand darin, die Suche selbst zu einem Artefakt zu machen. Equora bewertet 480 explizite, dem Anschein nach neutrale Konfigurationen bei gleicher Selektivität. Das Raster variiert Teilmengen von vier optionalen Hochrisiko-Merkmalen, Kredit-Score-Obergrenzen von keine Obergrenze, 720, 680 oder 640, ob garantiertes Gutschein-Einkommen angerechnet wird, und sechs L2-Werte von 0,1 bis 30,0. Das Verschuldungsquoten-Verhältnis, die Beschäftigungsmonate und das gemeldete Einkommen bleiben einbezogen.
Diese Grenze ist wichtig, weil ich sie beschreiben kann. Ich kann sie neu ausführen. Ich kann auch sagen, was sie nicht abdeckt. Die Suche erhebt keinen Anspruch darauf, jedes mögliche Modell, jede Richtlinie oder jede Merkmalsumformung zu umfassen. Es ist eine begrenzte technische Demonstration mit einem bekannten Raster und einem deklarierten Genauigkeitsbudget.
Eine rote Kennzahl dokumentiert das Problem. Eine geregelte Suche dokumentiert die verfügbare Reaktion.
Ich musste die Suche nachvollziehbar machen
Ich erinnere mich daran, den Punkt erreicht zu haben, an dem die Suche korrekt ablief, aber immer noch undurchsichtig wirkte. Am Ende erschien eine Empfehlung, doch der Weg dorthin war größtenteils im Code verborgen. Diese Ausgabe war mathematisch vertretbar und operativ schwach. Rechtsbeistand oder ein Modell-Risiko-Prüfer sollte nicht auf mein Gedächtnis vertrauen müssen, welche Kombinationen getestet wurden.
Ich habe den Suchraum in die Oberfläche verlagert und den Fortschritt sichtbar gemacht. Das System testet jede Konfiguration gegen dasselbe feste synthetische Datensatzset und dieselbe Selektivitätsbeschränkung. Es zeichnet den AUC und den minimalen DIR des Kandidaten auf und zeichnet die Genauigkeits-/Fairness-Pareto-Grenze. Wenn kein Kandidat die konfigurierte Schranke innerhalb des AUC-Budgets von 0,03 übersteigt, gibt die Engine keine sichere Alternative zurück, anstatt eine Empfehlung zu konstruieren.
Ich wollte, dass ein Prüfer konkrete Fragen stellen kann. Wurden die Kredit-Obergrenzen bewertet? Wurde garantiertes Einkommen angerechnet? Hat jeder Kandidat die Selektivität konstant gehalten? Wie viele Kandidaten qualifizierten sich gemäß der konfigurierten Regel? Diese sind aus dem Protokoll beantwortbar. Das Entscheidungsverfahren bleibt außerhalb des Sprachmodells: Deterministischer Code berechnet die Kennzahlen, wendet die Schranke an und wählt den qualifizierenden Kandidaten mit dem kleinsten gemessenen AUC-Verlust aus.
Ich musste auch dem Drang widerstehen, die nicht erfolgreichen Kandidaten wegzupolieren. Eine Produktoberfläche möchte naturgemäß eine Antwort in den Vordergrund stellen, aber die anderen getesteten Punkte geben der Empfehlung Kontext. Die Grenzlinie ermöglicht es einem Prüfer, AUC und minimalen DIR über die bewerteten Konfigurationen hinweg zu vergleichen, anstatt nur die ausgewählte Koordinate zu sehen. Die unterlegenen Kandidaten sind Teil des Nachweises, weil sie zeigen, was die Auswahlregel verglichen hat, bevor sie sich auf das qualifizierende Ergebnis festlegte.
Das war der Moment, in dem sich meine eigene Sichtweise änderte. Ich hatte mit einem Fairness-Dashboard im Sinn angefangen. Was ich tatsächlich aufbaute, war ein wiederholbarer Entscheidungsprozess. Das Diagramm war nützlich, weil jeder Punkt eine getestete Konfiguration repräsentierte, nicht weil eine Pareto-Grenze visuell überzeugend ist.
Der Kompromiss, den ich endlich sehen konnte
Ich beobachtete den abgeschlossenen Durchlauf bei der Bewertung aller 480 Konfigurationen und die Rückgabe von 240, die die 0,80-Schranke der Demo innerhalb des konfigurierten Genauigkeitsbudgets überstiegen. Die empfohlene Konfiguration behielt die Ausgangsmerkmale bei, fügte Gutschrift für garantiertes Einkommen hinzu, begrenzte den Kredit-Score-Einfluss auf 640 und verwendete L2-Regularisierung von 10,0.
Ich konnte das Ergebnis dann als Kompromiss lesen statt als Vollkommenheitsanspruch. Auf diesem festen synthetischen Datensatz stieg der minimale DIR von 0,694 auf 0,875. Der AUC bewegte sich von 0,7823 auf 0,7788, ein gemessener Verlust von 0,0036, den die Oberfläche als 0,36 % anzeigt. Für den Schnittpunkt der schwarzen Gutscheininhaber im Datensatz bewegte sich DIR von 0,701 auf 1,029.
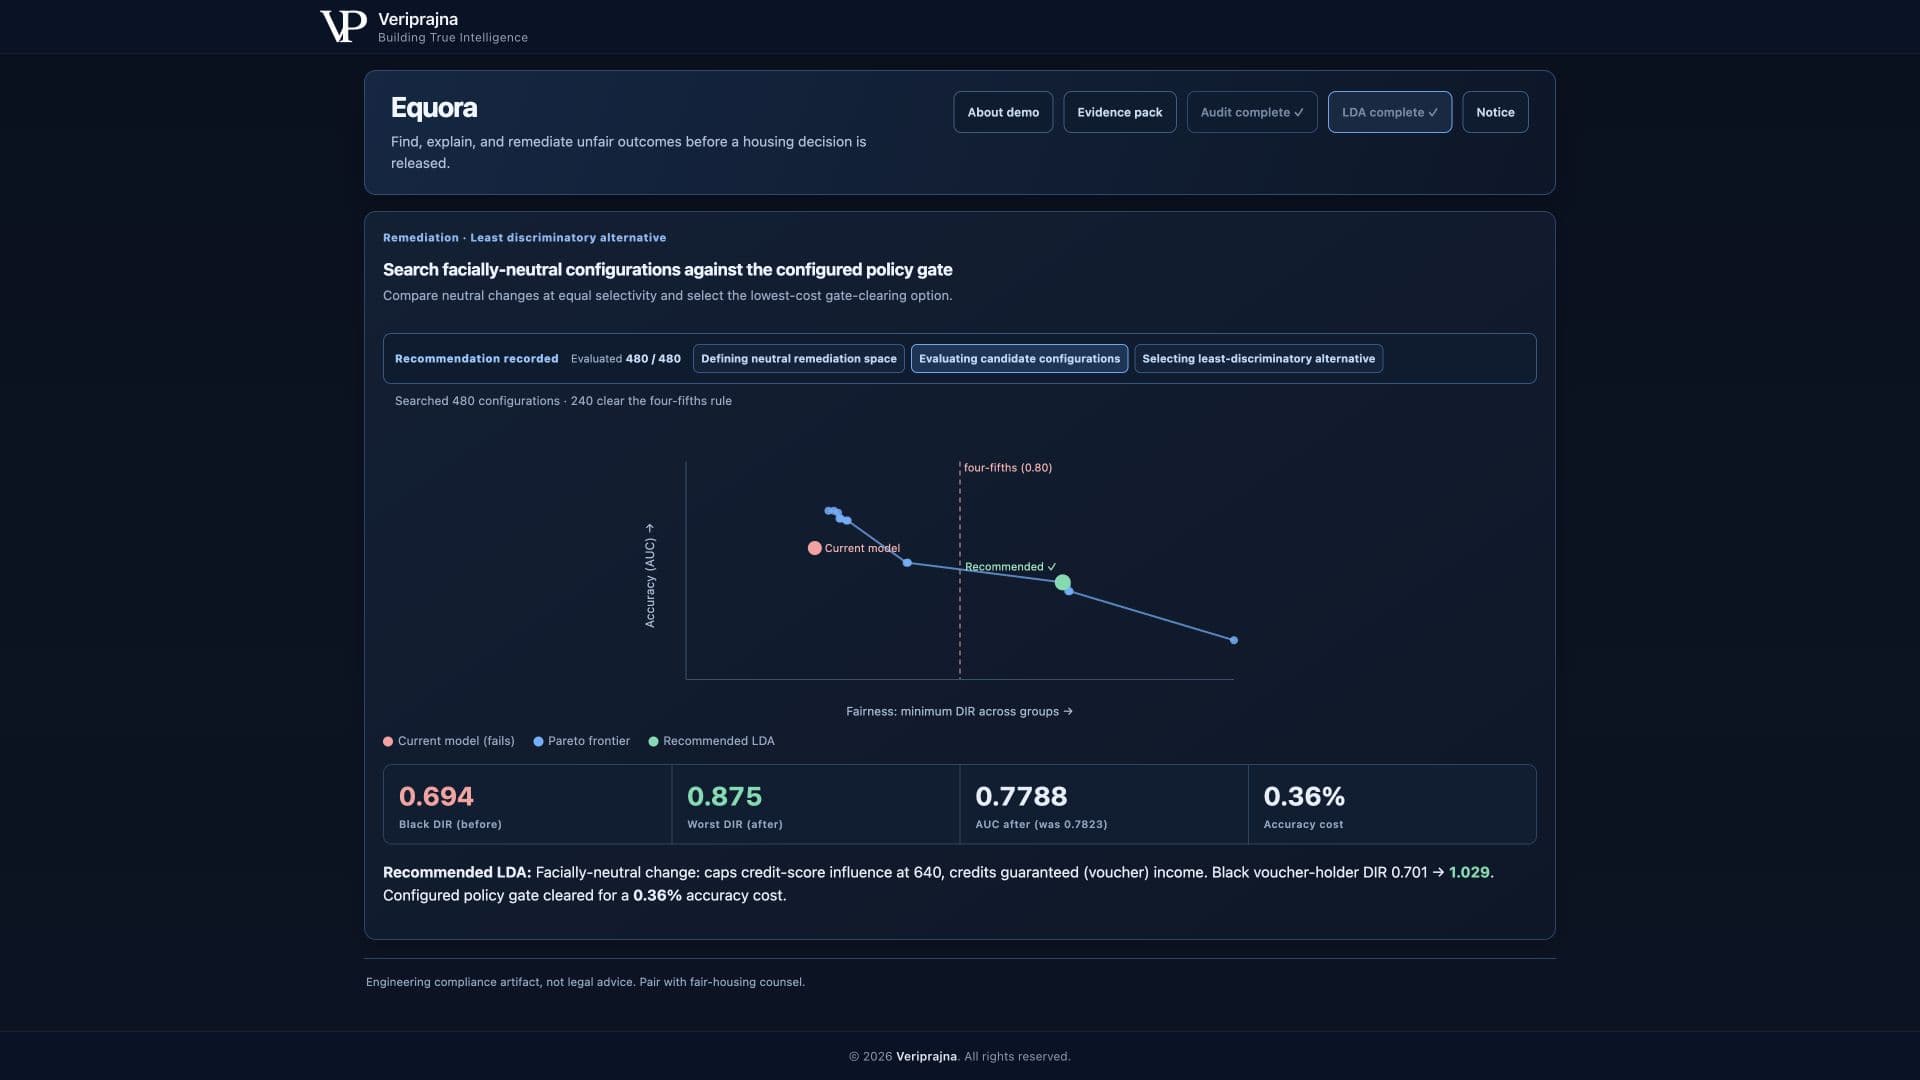
Ich verwende das Wort „empfohlen“ mit Bedacht. Dieser Kandidat ist die Option mit den niedrigsten gemessenen AUC-Kosten, die innerhalb dieses spezifischen Rasters qualifiziert. Es ist kein universelles Optimum, keine rechtliche Zertifizierung und kein Nachweis eines vorurteilsfreien Modells. Die Zahlen beschreiben ein angepasstes Ausgangsmodell und eine begrenzte Suche auf synthetischen Daten. Sie beschreiben keinen realen Vermieter, Prüfanbieter, Bewerberpool oder Wohnungsmarkt.
Diesen Satz zu schreiben fiel mir schwerer als die Verbesserungszahl. Produktsprache belohnt Gewissheit, während Governance-Arbeit davon abhängt, den Geltungsbereich zu wahren. Der begrenzte Anspruch ist genau deshalb stärker, weil ein anderer Prüfer sehen kann, wo er endet. Wenn die Organisation das Raster erweitert, das Budget ändert oder eine andere Richtlinien-Schranke übernimmt, sollte sie ein anderes Protokoll und möglicherweise eine andere Empfehlung erwarten. Die Methode bleibt wiederholbar, auch wenn sich die Annahmen ändern.
Diese Einschränkung schwächt die Demonstration nicht. Sie macht die Prüfgrenze explizit. Ein Prüfer kann das 0,03-Budget, die Vierfünftel-Richtlinien-Schranke, die verfügbaren Merkmale, die Selektivitätsbeschränkung oder das Raster selbst anfechten. Diese Meinungsverschiedenheiten werden zu Eingaben für einen Prozess, der neu ausgeführt werden kann, anstatt als Kommentare an einem statischen roten Wert zu hängen.
Warum ich den Nachweis außerhalb des Fließtexts hielt
Ich war versucht, generierten Text mehr von der Erklärung tragen zu lassen, weil Fließtext eine Oberfläche vollständig wirken lässt. Ich rückte davon ab. Ein flüssiger Absatz kann nicht feststellen, welche Konfigurationen getestet wurden, DIR berechnen oder entscheiden, ob ein Kandidat eine Schwelle überschreitet. Das sind rechnerische Behauptungen, und ich wollte, dass das Protokoll auch dann bestehen bleibt, wenn jeder generierte Satz entfernt würde.
Ich trennte die Rollen. Deterministischer Code berechnet den Audit, sucht nach Alternativen, wendet die konfigurierte Schranke an und bewahrt das Ergebnis. Ein Sprachmodell ist, wenn aktiviert, auf das Entwerfen von Text beschränkt. Der Offline-Modus verwendet eine deterministische Vorlage. Der Nachweis hängt nicht von der Formulierung ab.
Ich wendete dieselbe Grenze auf einen bewerberorientierten Grund an. Für einen abgelehnten synthetischen Datensatz identifiziert die genaue lineare Modell-Merkmalsattribution die drei wichtigsten negativen Beitragsfaktoren. Der Ersteller des Bescheids muss diese Merkmale zitieren. Ein fundierter Ersatzbescheid besteht diese enge Prüfung, während ein generischer Grundcode, der kein Merkmal nennt, scheitert und an die menschliche Überprüfung weitergeleitet wird. Der Kritiker überprüft nur die Merkmalsfundierung. Er begründet keine vollständige FCRA-Konformität oder rechtliche Hinlänglichkeit.
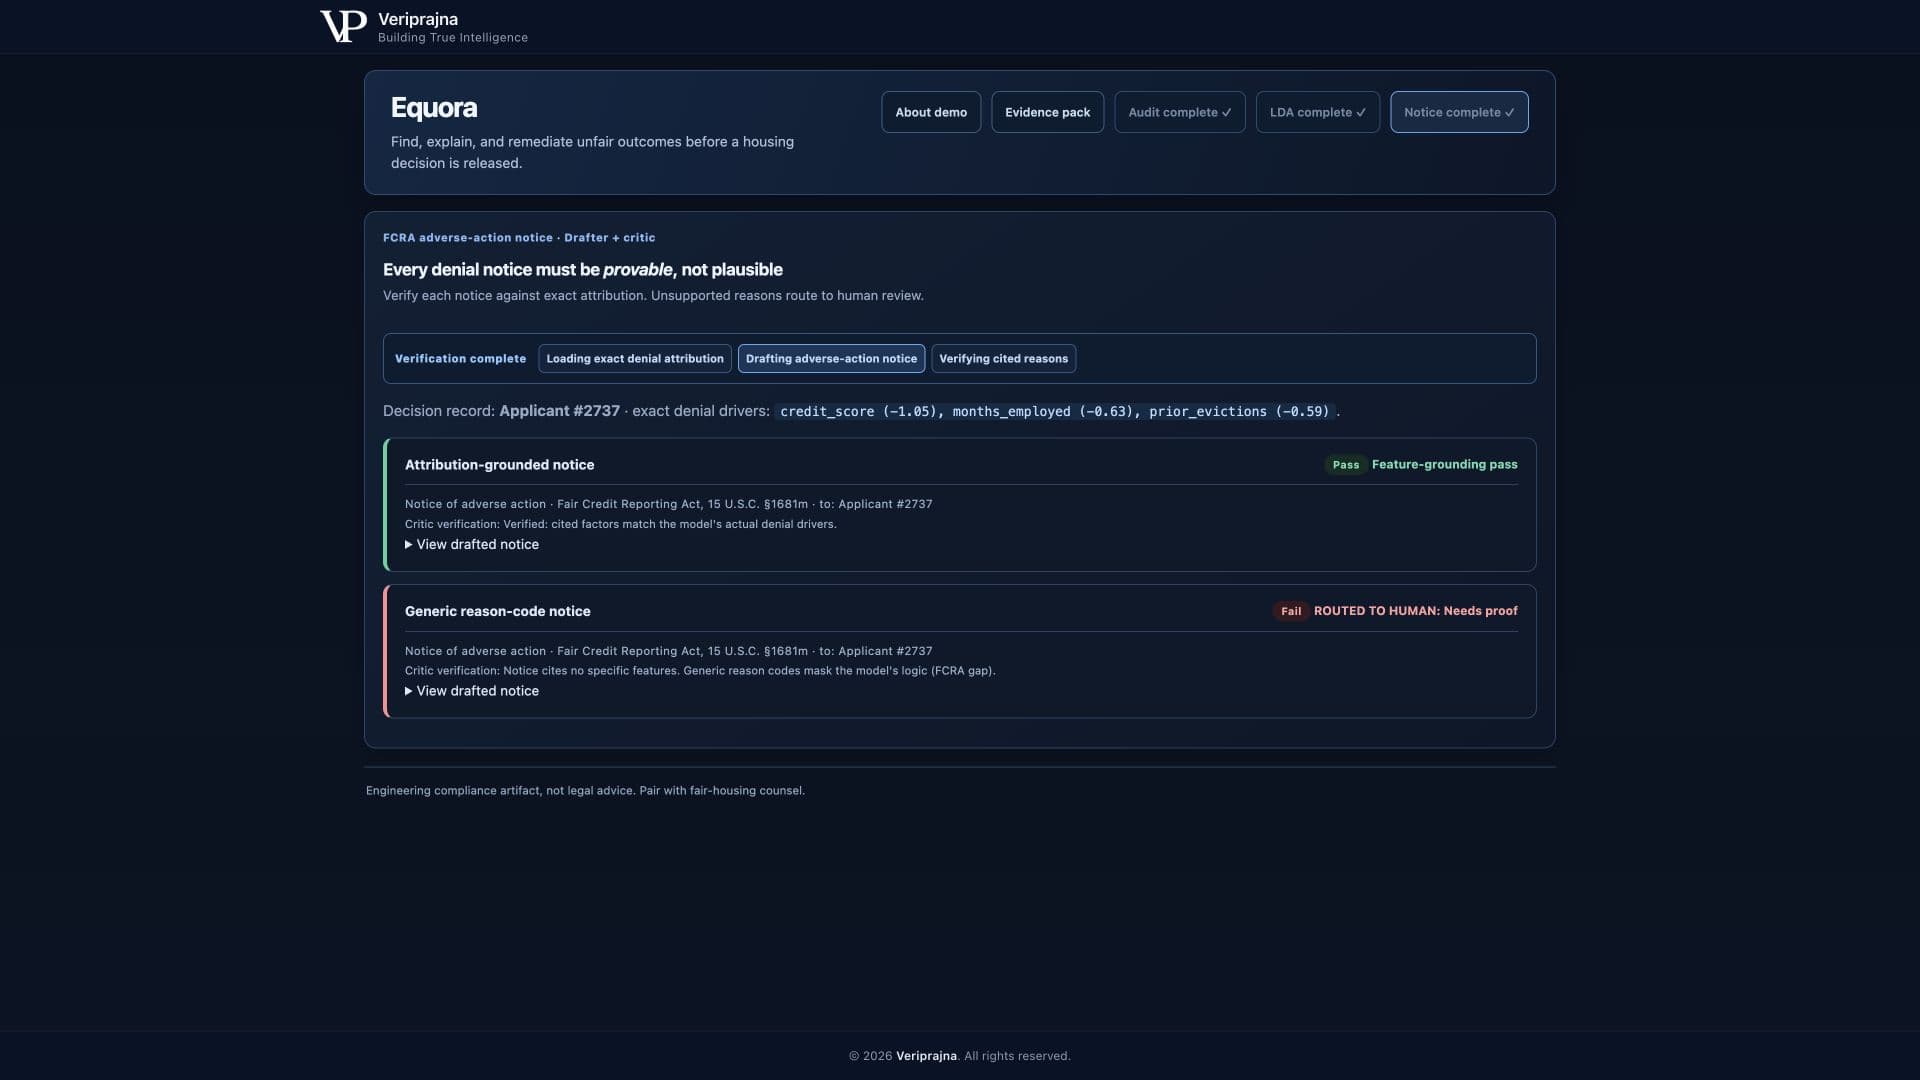
Dies grenzt an die Suche an, anstatt eine zweite These zu sein. Sobald ein Team eine Alternative wählt, muss der Nachweis noch in das Entscheidungsprotokoll und in jede daraus veröffentlichte Erklärung einfließen. Eine reproduzierbare Suche verliert ihren Governance-Wert, wenn die letzte Meile einen Grund erfinden kann.
Das Artefakt, das ich im Raum haben möchte
Ich stelle mir das Review-Meeting jetzt anders vor. Ich stelle mir nicht vor, dass jemand einen roten Wert präsentiert und den Raum bittet, ein breites Versprechen zur Modellverbesserung zu akzeptieren. Ich stelle mir vor, dass ein Prüfer das begrenzte Raster öffnet, jeden Kandidaten bei gleicher Selektivität sieht, die Pareto-Grenze überprüft und das ausgewählte Ergebnis bis zur konfigurierten Regel zurückverfolgt.
Ich möchte, dass das Protokoll sowohl den Gewinn als auch die Kosten zeigt. Hier bedeutet das einen minimalen DIR von 0,875 und einen AUC von 0,7788 nach der Suche, mit den Ausgangswerten daneben. Ich möchte auch, dass das System die abgelehnten Alternativen behält und keine sichere Alternative zurückgibt, wenn keine qualifiziert. Eine erzwungene Empfehlung würde das wichtigste mögliche Ergebnis auslöschen.
Die vollständige Schritt-für-Schritt-Anleitung ist verfügbar unter der Equora-Aufschlüsselung zur KI-Compliance im Wohnungsmarkt. Sie zeigt den Audit, die begrenzte Least-Discriminatory-Alternative-Suche, die Kompromissansicht und die Weitergabe des Nachweises. Es bleibt eine technische Demonstration auf Basis synthetischer Daten, kein produktiv eingesetztes Entscheidungssystem oder eine Rechtsberatung.
Und wenn Sie lieber den Workflow sehen möchten, als meine Beschreibung zu lesen, ist hier die Gründer-Schritt-für-Schritt-Anleitung, die von Anfang bis Ende läuft.
Ich begann mit einer roten Kennzahl, weil das die naheliegende Sache war, die angezeigt werden sollte. Ich schloss überzeugt ab, dass das wertvollere Artefakt der wiederholbare Weg vom roten Ergebnis zu einer begrenzten Wahl ist, einschließlich der Möglichkeit, dass der Weg ohne eine qualifizierende Wahl endet. Ein Audit kann einem Team sagen, dass es stoppen soll. Ein Suchprotokoll kann zeigen, was sie geprüft haben, bevor sie entschieden haben, wie sie vorgehen wollen.