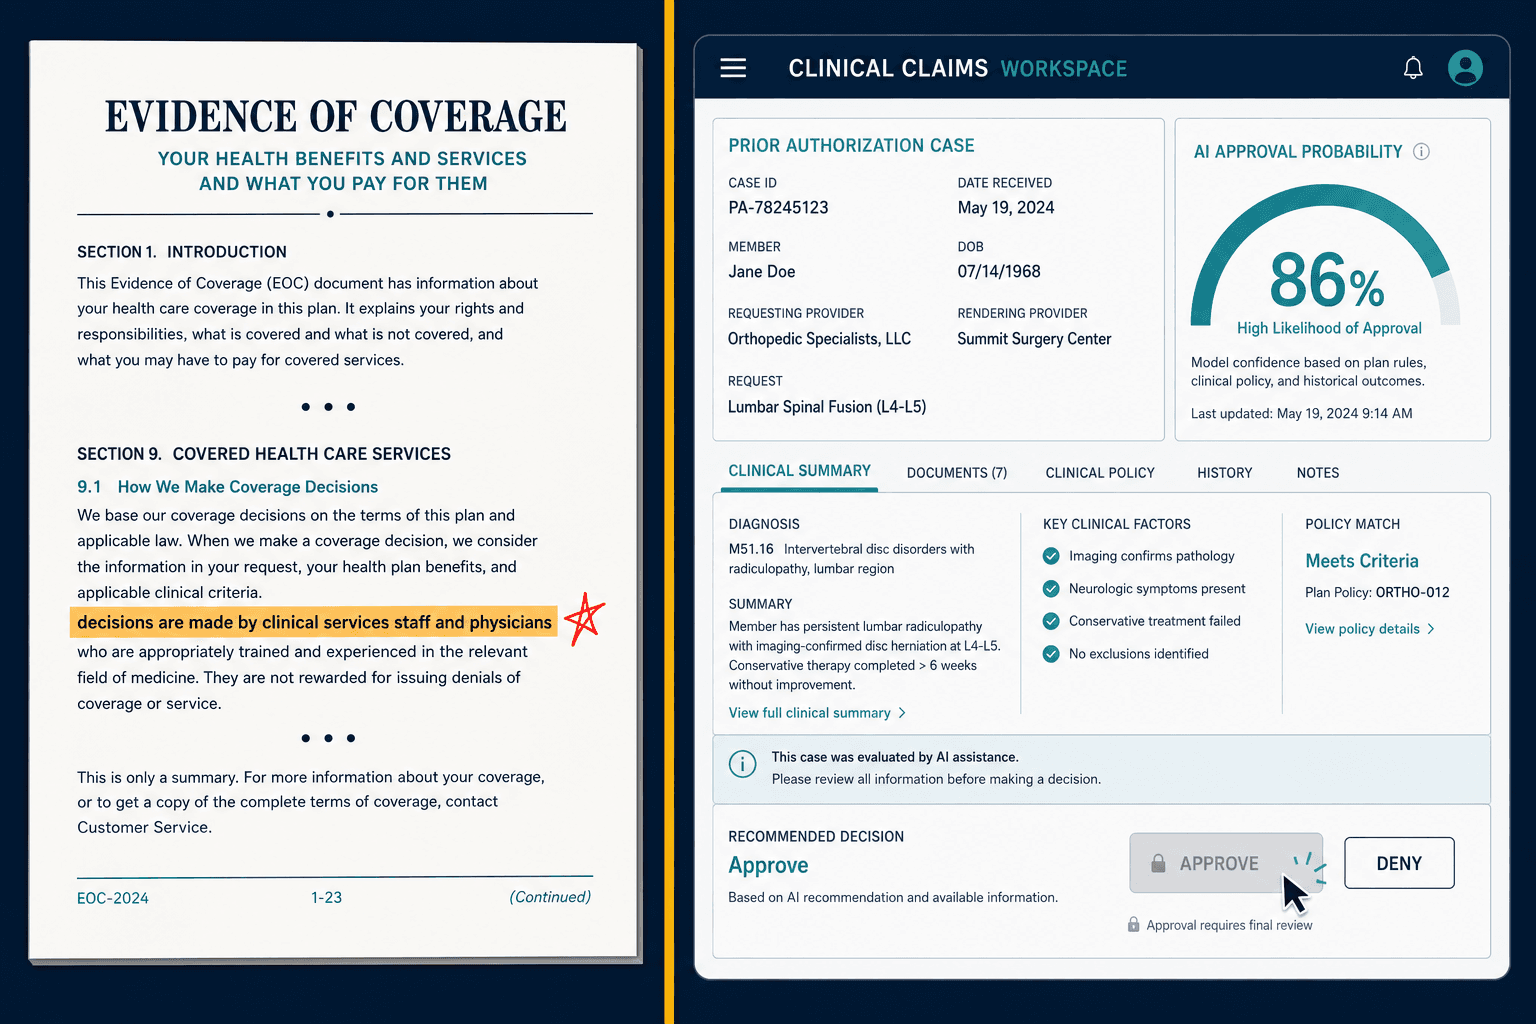
Ein Stand-in-Modell für Medicare Advantage ergab eine Ablehnung bei 0.985. Das Gate hielt sie zur Prüfung an.

Ich habe einen synthetischen Medicare Advantage-Vorabgenehmigungsfall in CertaRoute geöffnet und eine anfängliche Ablehnung bei 0.985 Modellkonfidenz vorgefunden. Die patientenspezifischen Indikatoren sind vorhanden, machen jedoch nur 22.06% der absoluten Attribution des Modells aus. Die Entscheidungsgovernance-Schicht hält den Fall zur ärztlichen Prüfung an, anstatt Konfidenz als Erlaubnis zur Finalisierung einer Ablehnung zu behandeln.
Das ist die Designentscheidung, die ich sichtbar machen wollte. Das Modell ist nicht allein deshalb mangelhaft, weil es einen hohen Score liefert. Die Frage ist vielmehr, ob der Score genügend Umstände dieser konkreten Person enthält, um die Entscheidung zu tragen. Der vollständige Walkthrough zeigt den Pfad, die Faktoren und den lokalen Datensatz der Anwendung. Es ist ein Erklärbericht mit Video und Screenshots, kein interaktives Kostenträgersystem.
Die Ablehnung schien entschieden, bis ich die Akte öffnete
Ich komme immer wieder auf A-4471 zurück, eine skriptbasierte Verlängerung für postakute qualifizierte Pflege in unserem synthetischen Seed-Datensatz. In der Arbeitsliste lautet die anfängliche Modellbewertung DENY. Das ist genau die Art von prägnanter Ausgabe, die ein überhasteter Prüfprozess mit einer abgeschlossenen Entscheidung verwechseln kann. In der Fallakte stehen individuelle klinische Faktoren neben populationsgewichteten Faktoren. Derselbe Bildschirm meldet ärztliche Prüfung ausstehend, und sein technischer Datensatzstatus lautet NEEDS_PROOF.
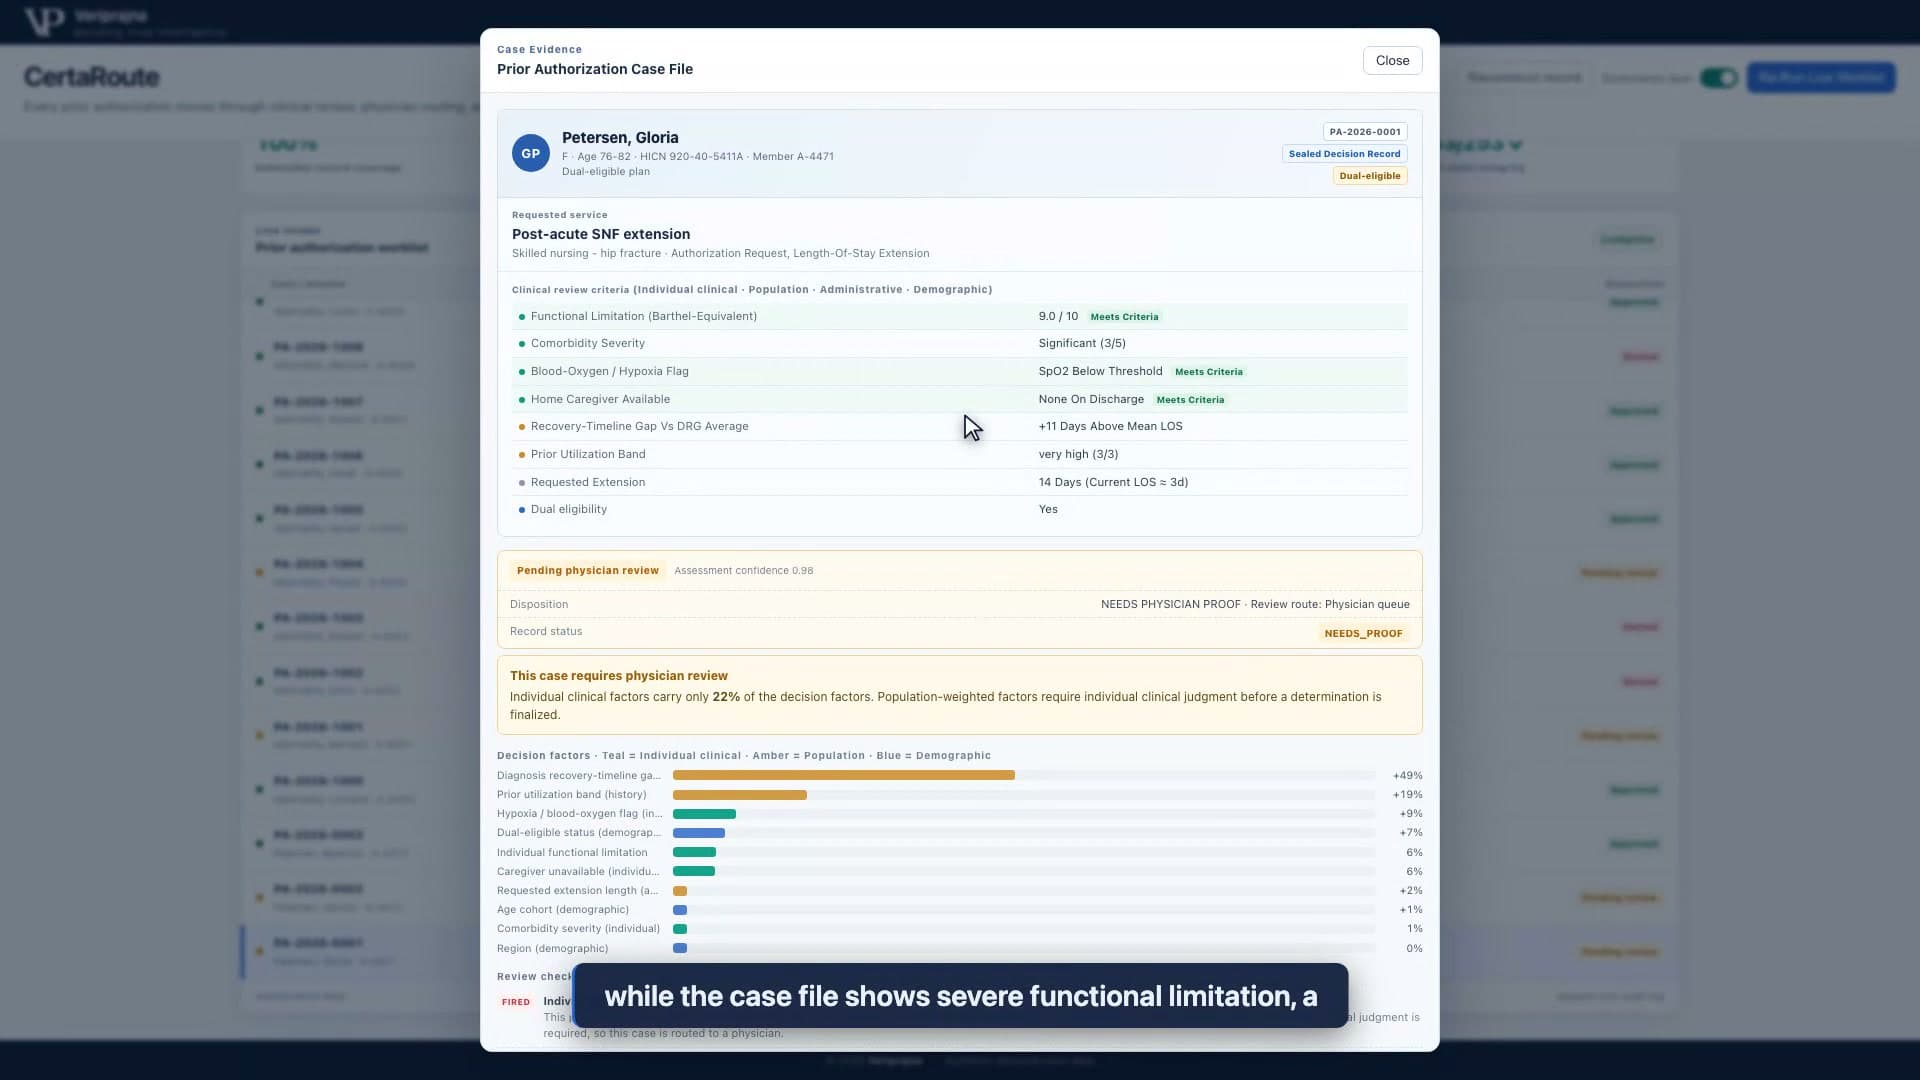
Ich möchte nicht, dass ein Leser diese klinischen Beobachtungen für die Akte eines echten Versicherten hält. Name, Versichertennummer und Fall sind frei erfunden. Das QNXT-Quelllabel dient lediglich als Platzhalter. Hinter dieser Ansicht stehen keine echte Leistungsabrechnung, keine Deckungsentscheidung und keine ärztliche Warteschlange. Ich habe einen synthetischen Fall verwendet, damit die Mechanismen untersucht werden können, ohne Glaubwürdigkeit von einer realen Patientengeschichte zu borgen, die wir nicht haben.
Das erste Spannungsfeld ist eindeutig: Die Fallakte enthält individualisierte Fakten, doch eine mit hoher Konfidenz versehene Ablehnung kann dennoch hauptsächlich durch aggregierte Historien geprägt sein. Ein Patientenfeld in der Eingabe zu sehen, ist nicht dasselbe, wie zu sehen, dass es im Ergebnis eine Rolle spielt. Diese Unterscheidung geht leicht verloren, wenn die Benutzeroberfläche die Ausgabe eines Modells zu einem einzelnen grünen oder roten Abzeichen verdichtet. Ich wollte das Gegenteil: eine Fallansicht, in der die ursprüngliche Antwort und die herangezogene Evidenz gemeinsam gelesen werden können.
Die CMS stellte die zugrundeliegende Verantwortung in ihren FAQ zu Abdeckungskriterien und Nutzungsmanagement vom Februar 2024 klar. Deckungsentscheidungen bei Medicare Advantage müssen die Umstände des einzelnen Patienten berücksichtigen; ein auf größeren Datensätzen trainierter Algorithmus kann diese Prüfung nicht ersetzen. Ich betrachte dies als Designvorgabe, nicht als Behauptung, dass diese Demonstration Medicare Advantage-Anforderungen bereits erfüllt. Tatsächliche Deckungskriterien, klinisches Urteilsvermögen und Planabläufe müssten in einer realen Implementierung evaluiert werden.
Die 22.06% hinter einer 0.985-Ablehnung
Ich möchte 0.985 anfangs gern als Beruhigung verstehen. Dann blicke ich auf die Attributionsbalken. Bei A-4471 trägt die Lücke im Genesungszeitplan etwa 49% zur absoluten Attribution bei und die bisherige Inanspruchnahme etwa 19%. Individuelle klinische Faktoren steuern zusammen lediglich 22.06% bei. Die Fallakte räumt diesen Faktoren Platz auf der Seite ein, aber das Modell gewichtet sie bei seiner Ablehnung weit geringer.
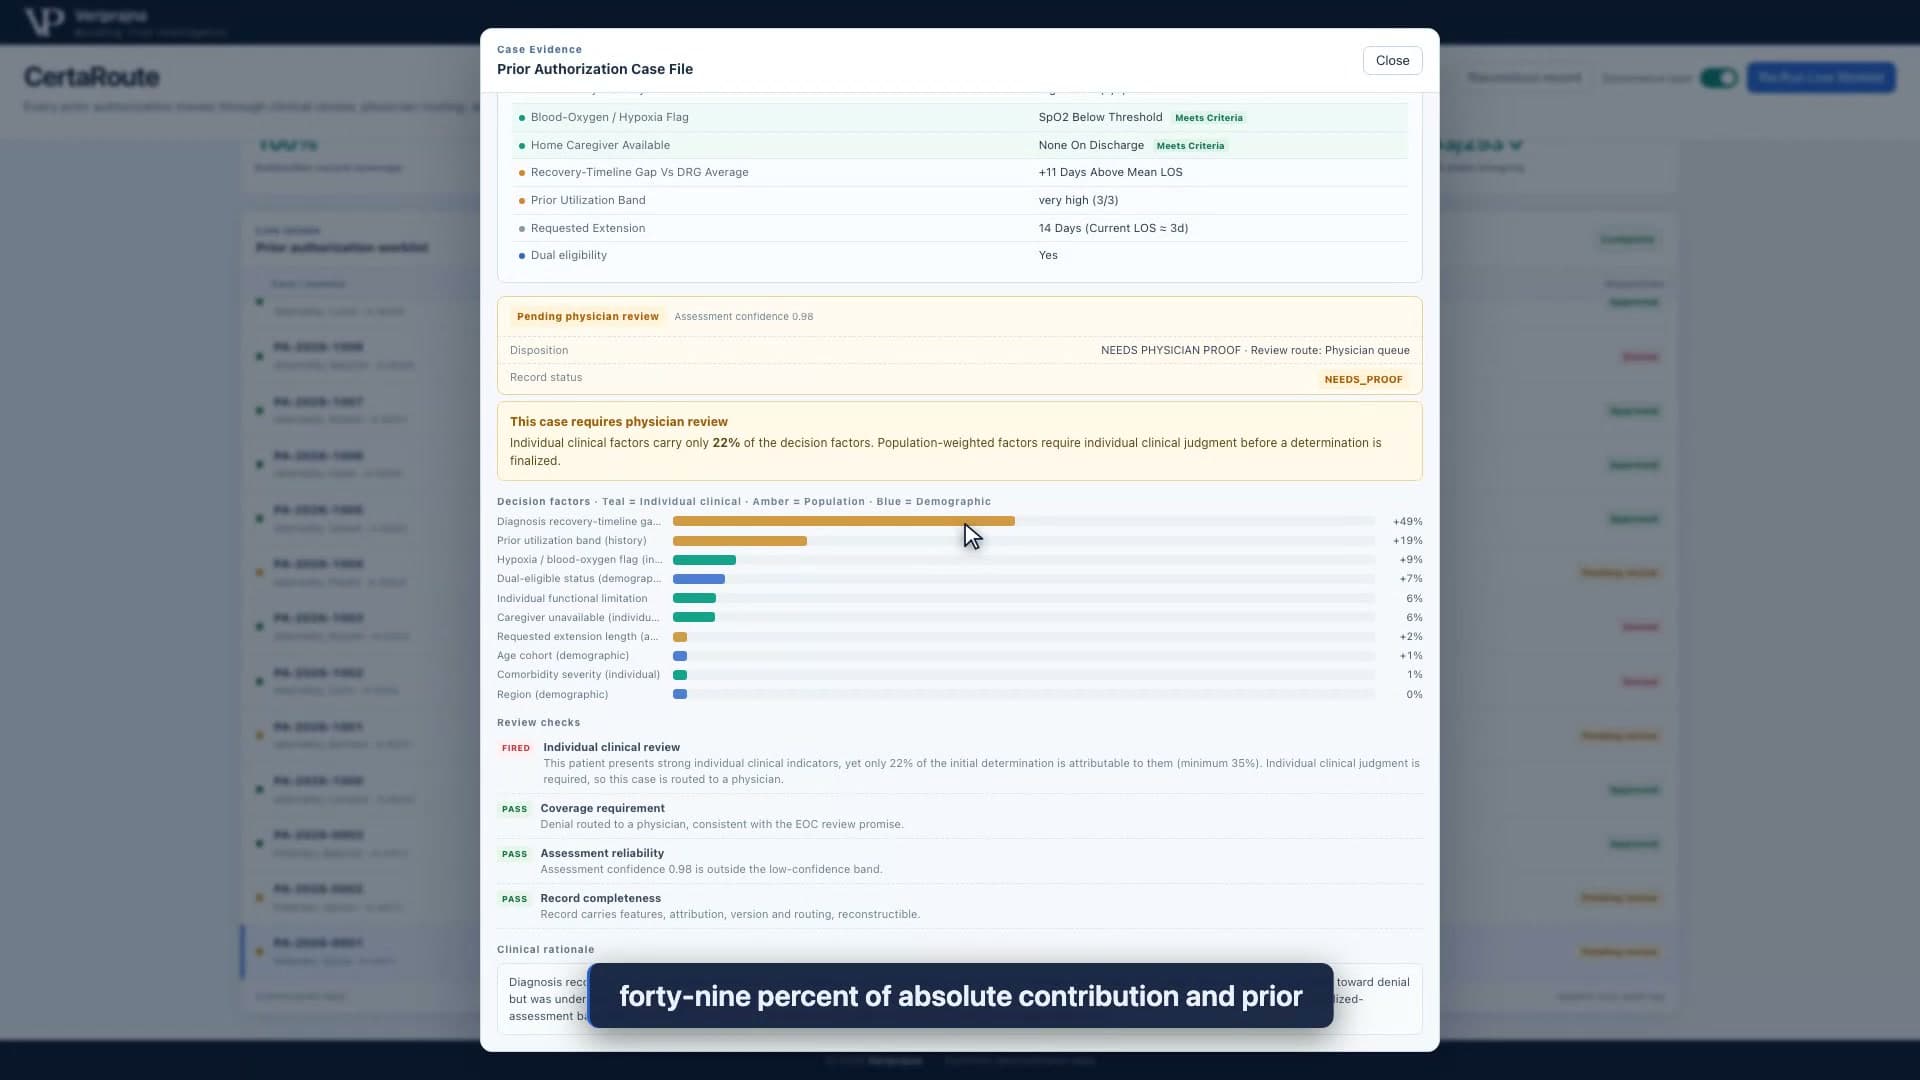
Ich musste einer allzu einfachen, trügerischen Lesart dieses Diagramms widerstehen. Die Shapley-Attribution erklärt, wie dieses trainierte Stand-in-Modell die Beiträge auf seine zehn Merkmale verteilt hat. Sie beweist nicht, dass ein individueller Faktor medizinisch ausschlaggebend ist oder dass das richtige Deckungsergebnis eine Genehmigung wäre. Ein Patient könnte wichtige klinische Fakten aufweisen, die das Modell nur unzureichend abbildet; ein Diagramm allein kann darüber nicht entscheiden. Die nützliche Schlussfolgerung ist präziser und gewichtiger: die Modellkonfidenz verriet mir nicht, ob individuelle Evidenz ausreichend Gewicht trug.
Deshalb ist der Schwellenwert in dieser Demo eine Weiterleitungsschwelle und keine Schwelle für medizinische Notwendigkeit. Bei einem konfigurierbaren Anteil von 35% wird eine signifikante Ablehnung mit zu geringer Einzelfaktor-Attribution angehalten. Sie wird auf eine ärztliche Prüfroute geleitet, die als NEEDS_PHYSICIAN_PROOF gekennzeichnet ist. Es gibt keine automatische Umkehrung. Es gibt auch keine stille Umwandlung der anfänglichen Modellablehnung in eine endgültige Planablehnung. Der Zweck der Prüfung besteht darin, zu verhindern, dass diese beiden Ereignisse als ein und dasselbe behandelt werden.
Ich finde diese Unterscheidung nützlicher als pauschale Behauptungen darüber, ob KI ins Nutzungsmanagement gehört. Ein Modell kann helfen, Informationen zu strukturieren und zu bewerten. Wenn das operative System einem Prüfer jedoch nicht sagen kann, warum eine bestimmte Ablehnung von einer Modellausgabe zu einer autorisierten Entscheidung überging, hat eine hohe Konfidenzzahl mehr Autorität erhalten, als ihr zusteht. Bei A-4471 besagt das Modell das eine, und die Governance-Route besagt im Grunde, dass die Evidenz weiterhin einen Arzt benötigt.
Der Auslöser muss im Rahmen seines Geltungsbereichs gelesen werden. Dieselbe Demo enthält eine Genehmigung, deren Einzelfaktor-Attribution unter dem konfigurierten Schwellenwert liegt. Sie wird von dieser Prüfung nicht umgeleitet, da der Schwellenwert nur für signifikante Ablehnungen gilt. Diese Asymmetrie ist im Quellcode beabsichtigt. Den Schwellenwert als universellen klinischen Qualitätstest darzustellen, wäre falsch und würde die spezifische operative Frage verschleiern, die dieses Beispiel tatsächlich aufwirft.
Ich habe die Autorität aus der Erklärung herausgelöst
Ich kann einen beratenden Absatz überzeugend klingen lassen. Ich kann Prosa jedoch nicht zu einer sicheren Weiterleitungsinstanz machen, bloß indem ich ein Sprachmodell bitte, sie zu verfassen. In CertaRoute berechnet ein deterministisches Governance-Gate die Route aus den Fall- und Modellausgaben. Der erklärende Text folgt danach. Im standardmäßigen Pfad ohne API-Schlüssel ist es eine deterministische Vorlage; eine optionale Schnittstelle kann modellgenerierte Formulierungen liefern. Keine der Versionen darf die Disposition autorisieren.
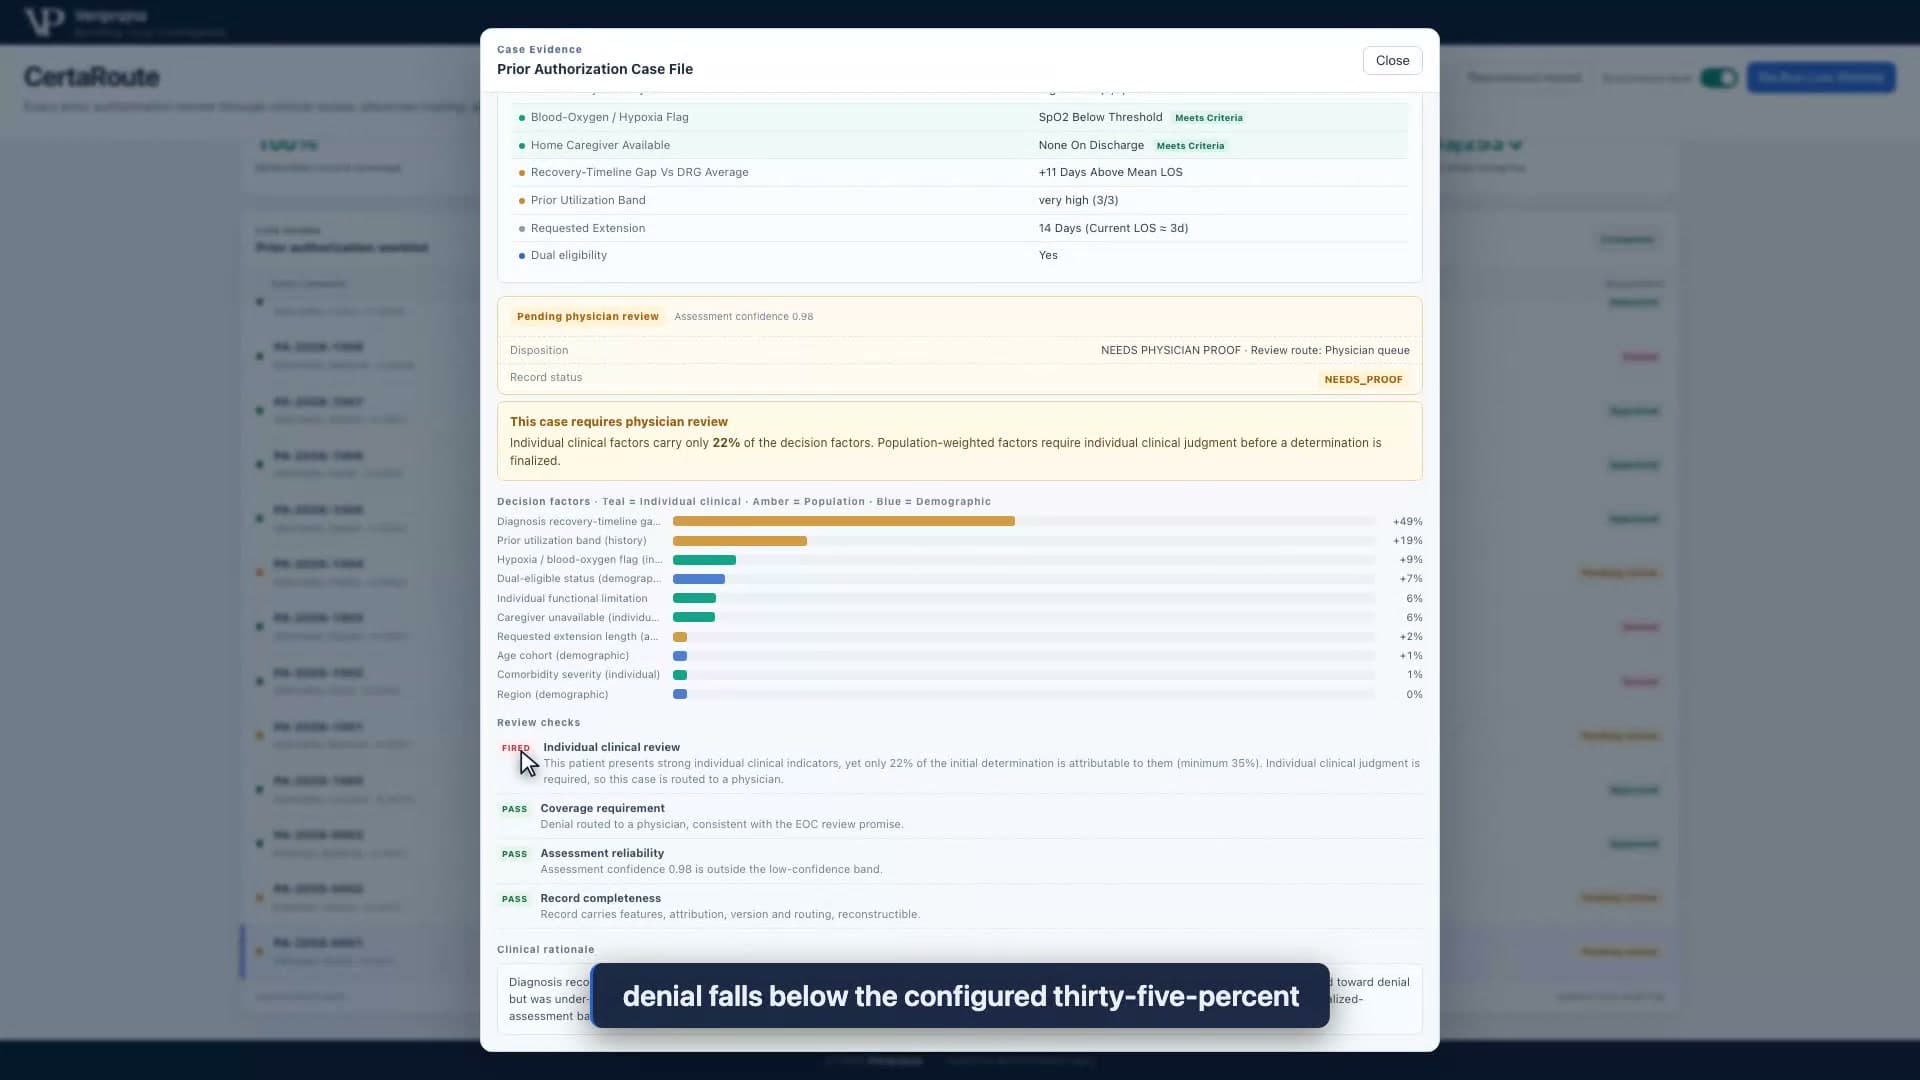
Ich betrachte dies als den Moment, in dem die Oberfläche aufhört, eine gewöhnliche Modelldemo zu sein. Die schriftliche Begründung kann das Ergebnis lesbar machen, aber die Regel bleibt separat überprüfbar. Ich kann auf Eingabe, Attribution, konfigurierte Schwelle und Route verweisen, ohne dass jemand dem Stil eines generierten Textes vertrauen muss. Sollte eine zukünftige Erklärung übertreiben, was die Evidenz hergibt, führt das Gate weiterhin zum selben Ergebnis. Diese Trennung stellt Prüfern eine bessere Frage: Hat der Code diesen Fall aus dem richtigen Grund, unter der richtigen Richtlinie und unter Wahrung des korrekten klinischen Kontexts weitergeleitet?
Die Antwort in dieser Demo ist begrenzt. Ihre Prüfung der Abdeckungsanforderungen ist eine Bestätigung auf Basis von Routing-Entscheidungen; sie vergleicht den Fall nicht mit einem tatsächlichen Evidence-of-Coverage-Dokument. Die Vollständigkeitsprüfung verfügt über ein Feldanwesenheits-Flag, aber diese Pipeline übergibt dieses Flag derzeit als True, anstatt jedes Feld unabhängig zu untersuchen. Ich möchte nicht, dass das freundliche PASS-Label einer solchen Prüfung im Marketing als Beweis für lückenlose Akten oder Plan-Compliance dargestellt wird. Eine sichtbare Prüfung ist nur dann nützlich, wenn ihr Umfang ebenso sichtbar ist.
Der Niedrigkonfidenzbereich und eine programmierte Kombination seltener Komorbiditäten bieten im festen Testlauf weitere Prüfungswege, sind aber nicht der Grund, warum A-4471 mir wichtig ist. Dieser Fall erprobt die schwierigere Versuchung: Ein Modell kann sich sehr sicher sein und dennoch wesentliche Umstände einer konkreten Person an den Rand drängen. Die Designfrage lautet, wer an dieser Grenze die Autorität besitzt. In dieser Demonstration hält der Code die Ablehnung an, und ein Arzt müsste in einem echten Arbeitsablauf weiterhin eine individuelle Bewertung vornehmen. Die angezeigte Warteschlange selbst ist reiner Demostatus.
Ich habe den Begriff "Human in the Loop" für viele verschiedene Konstrukte gehört. Er kann bedeuten, dass ein Arzt den vollständigen Kontext vor einer Entscheidung sieht. Er kann aber auch lediglich ein Warteschlangen-Label bedeuten, das angehängt wird, nachdem eine Entscheidung faktisch bereits gefallen ist. In unserer Anwendung ist das Warteschlangen-Label das sichtbare Ende der Simulation. Die anspruchsvollere Arbeit außerhalb umfasst Zuständigkeiten im Arbeitsablauf, Qualifikationen, Zugriffskontrollen, reale Plankriterien und Nachweise über tatsächliche Prüfungen. Ich möchte diese Grenze lieber klar benennen, als zu suggerieren, ein Label beweise das Stattfinden dieser Schritte.
Der Datensatz machte es schwerer, meine Grenzen zu ignorieren
Als Nächstes untersuche ich die Fallrekonstruktion. Die Anwendung schreibt einen lokalen SQLite-Datensatz, dessen Hash den Hash des vorherigen Datensatzes einschließt, und berechnet die Kette bei der Verifizierung neu. Im festen synthetischen Durchlauf wurden 253 von 253 Datensätzen vor einer Manipulation verifiziert. Ein Demo-Bedienelement verändert einen gespeicherten Datensatz, ohne seinen Hash neu zu berechnen; der Verifizierer meldet daraufhin eine unterbrochene Kette. Der Datensatz für A-4471 kann rekonstruiert und als HTML ausgegeben werden.
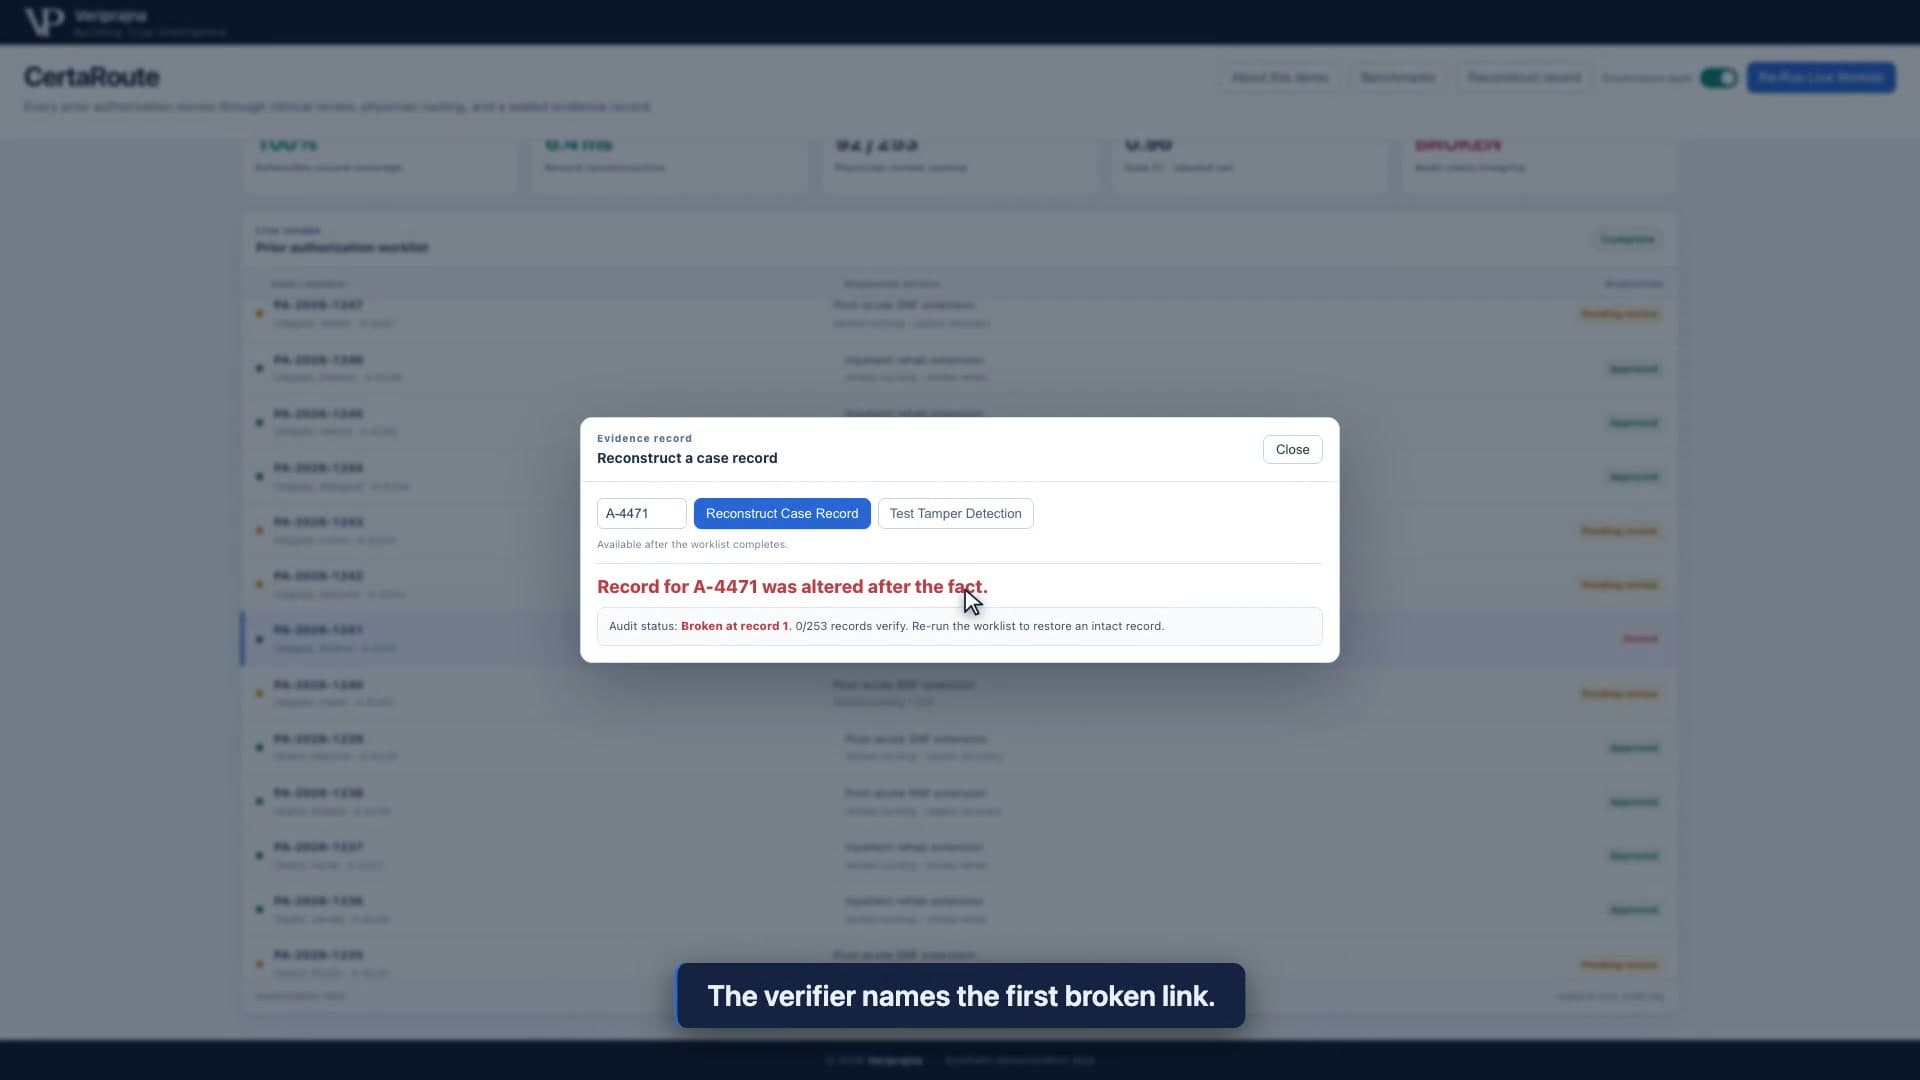
Mir gefällt, dass der Datensatz etwas Konkreteres liefert als das bloße Versprechen, "Beweise aufzubewahren". Er enthält die Falleingaben, die Attribution und den Routing-Status, die es einer anderen Person ermöglichen würden zu fragen, was das System getan hat. Doch wenn ich die rekonstruierte Ausgabe lese, sehe ich auch, was sie nicht liefern kann: die abgeschlossene Beurteilung eines qualifizierten Arztes, einen validierten klinischen Kontext und eine unabhängig kontrollierte Aufbewahrungskette. Eine technisch intakte Kette bescheinigt keines dieser fehlenden Elemente. Sie kann eine Änderung dieses lokalen Datensatzes aufdecken; sie kann für sich genommen weder beweisen, dass die zugrundeliegenden Daten korrekt waren, noch dass die schlussendliche Deckungsentscheidung rechtmäßig war.
Die Anwendung bezeichnet einige Datensätze als DEFENSIBLE. Ich behandle das als Demo-Status-Label, nicht als juristische Schlussfolgerung. Im festen Durchlauf nahmen 92 von 253 Fällen den Weg der ärztlichen Prüfung und erhielten NEEDS_PROOF; dies sind ausstehende und keine abgeschlossenen, rechtssicheren Ablehnungen. Die verbleibenden 161 werden von der Demo-Logik als DEFENSIBLE eingestuft, die Feldinhalte nicht unabhängig validiert. Selbst die 100%ige Datensatzabdeckung bedeutet im festen Durchlauf lediglich rekonstruierbare technische Datensätze. Sie beschreibt weder einen realen Krankenversicherungsplan noch begründet sie Rechtsverteidigungsfähigkeit.
Das ist eine anspruchsvollere Art, über Prüfprotokolle zu sprechen. Ich kann einen Mechanismus zur Erfassung und Überprüfung technischer Fakten aufzeigen und gleichzeitig die klinischen und operativen Fakten benennen, die er nicht enthält. Wenn eine manipulierte lokale Zeile erkannt werden kann, ist das wertvoll. Wenn das Fehlen eines ärztlichen Urteils im selben Atemzug benannt wird, wird der Datensatz weniger wahrscheinlich zu einer Requisite, die falsche Sicherheit erzeugt.
Was ein Prüfer sehen können sollte
Ich kehre zur anfänglichen Ablehnung zurück, weil man sie unter aggregierten Ergebnissen leicht aus den Augen verliert. Das Benchmark-Panel enthält eine eingebaute Ablehnungsratenlücke bei Dual-Eligibles in den Seed-Daten sowie einen synthetischen Routing-Score. Solche Ansichten können Fragen zu einer Population aufwerfen. Sie können mir jedoch nicht sagen, ob A-4471 eine individualisierte Beurteilung erhalten hat. Ein Kohortensignal und eine Route auf Fallebene dienen unterschiedlichen Zwecken; dieser Essay bleibt beim Einzelfall.
Ich möchte, dass eine Führungskraft für Compliance oder medizinisches Management bei dieser Demonstration einer klaren Abfolge folgen kann. Es gibt einen synthetischen Antrag auf Verlängerung postakuter Pflege. Das trainierte Stand-in-Modell lehnt ihn zunächst mit hoher Konfidenz ab. Die exakte Shapley-Attribution zeigt, welche Merkmale diese Bewertung bestimmt haben. Der individuelle klinische Anteil unterschreitet den konfigurierten Schwellenwert für eine signifikante Ablehnung. Ein Code-Gate hält den Fall zur ärztlichen Prüfung an. Ein lokaler Datensatz bewahrt die Aktionen der App, belässt die eigentliche Arbeit des Arztes und die reale Planintegration jedoch außerhalb der Demo.
Hier ist der Gründer-Walkthrough durch den synthetischen Fall und das Prüf-Gate.
Diese Abfolge wird sichtbar in der vollständigen CertaRoute-Aufschlüsselung. Sie stellt keinen Anspruch auf klinische Validierung, eine reale Kostenträgeranbindung oder eine Compliance-Zertifizierung dar. Für mich liegt ihr praktischer Nutzen in der unbequemen Pause zwischen einer selbstsicheren Modellausgabe und der Befugnis, danach zu handeln. Wenn die Umstände eines Patienten diese Route nicht sichtbar verändern, hat der Konfidenzwert die falsche Frage beantwortet.