Wenn eine KI-Shopping-Antwort nur teilweise zutrifft

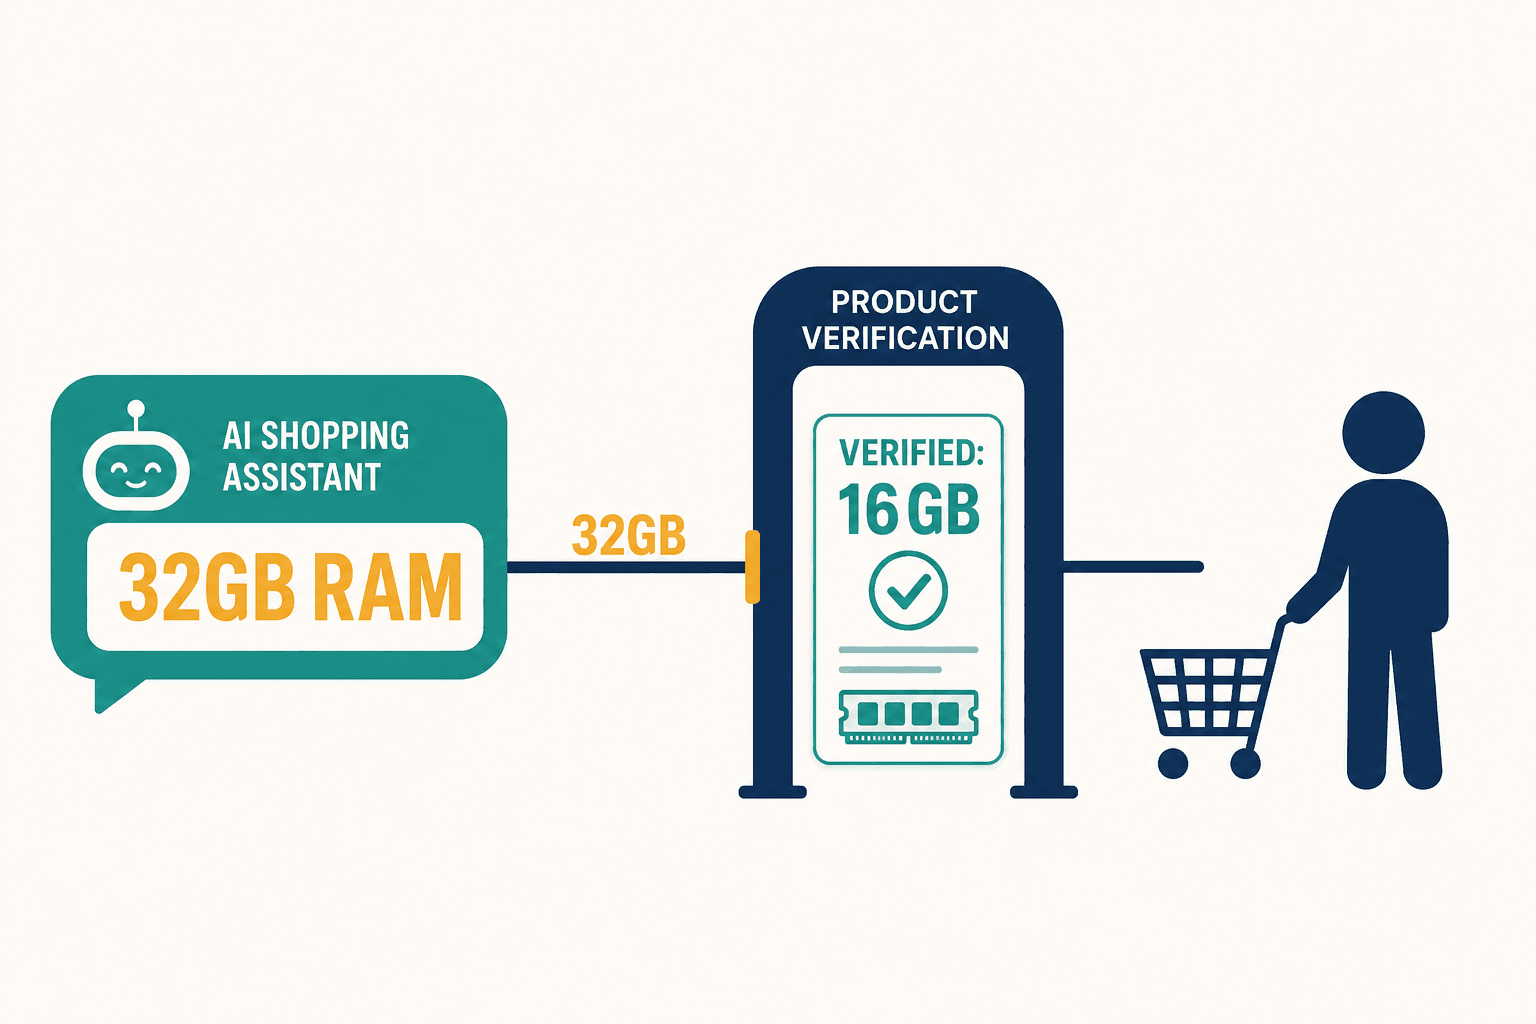
Eine KI-Shopping-Antwort kann die Bildwiederholrate eines Produkts korrekt angeben, während sie gleichzeitig einen Standard verspricht, den das Produkt gar nicht unterstützt. Die gesamte Antwort zu akzeptieren, bewahrt den Fehler. Sie komplett zu verwerfen, wirft das nützliche Detail weg. Ich bevorzuge eine Verifikationsgrenze, die diese Entscheidungen separat treffen und jede einzelne begründen kann.
Diese Präferenz hat praktische Konsequenzen für Commerce-Teams: Eine Antwort sollte Vertrauen auf der Ebene ihrer überprüfbaren Behauptungen gewinnen. Ein flüssiger Satz ist ein bequemer Kommunikationsweg, aber er bündelt Behauptungen, die ganz unterschiedliche Beziehungen zum Produktkatalog aufweisen können. Die Prüfungsaufgabe besteht darin, diese Beziehungen zu entflechten, bevor die Antwort zusammengestellt wird, die ein Kunde letztlich sieht.
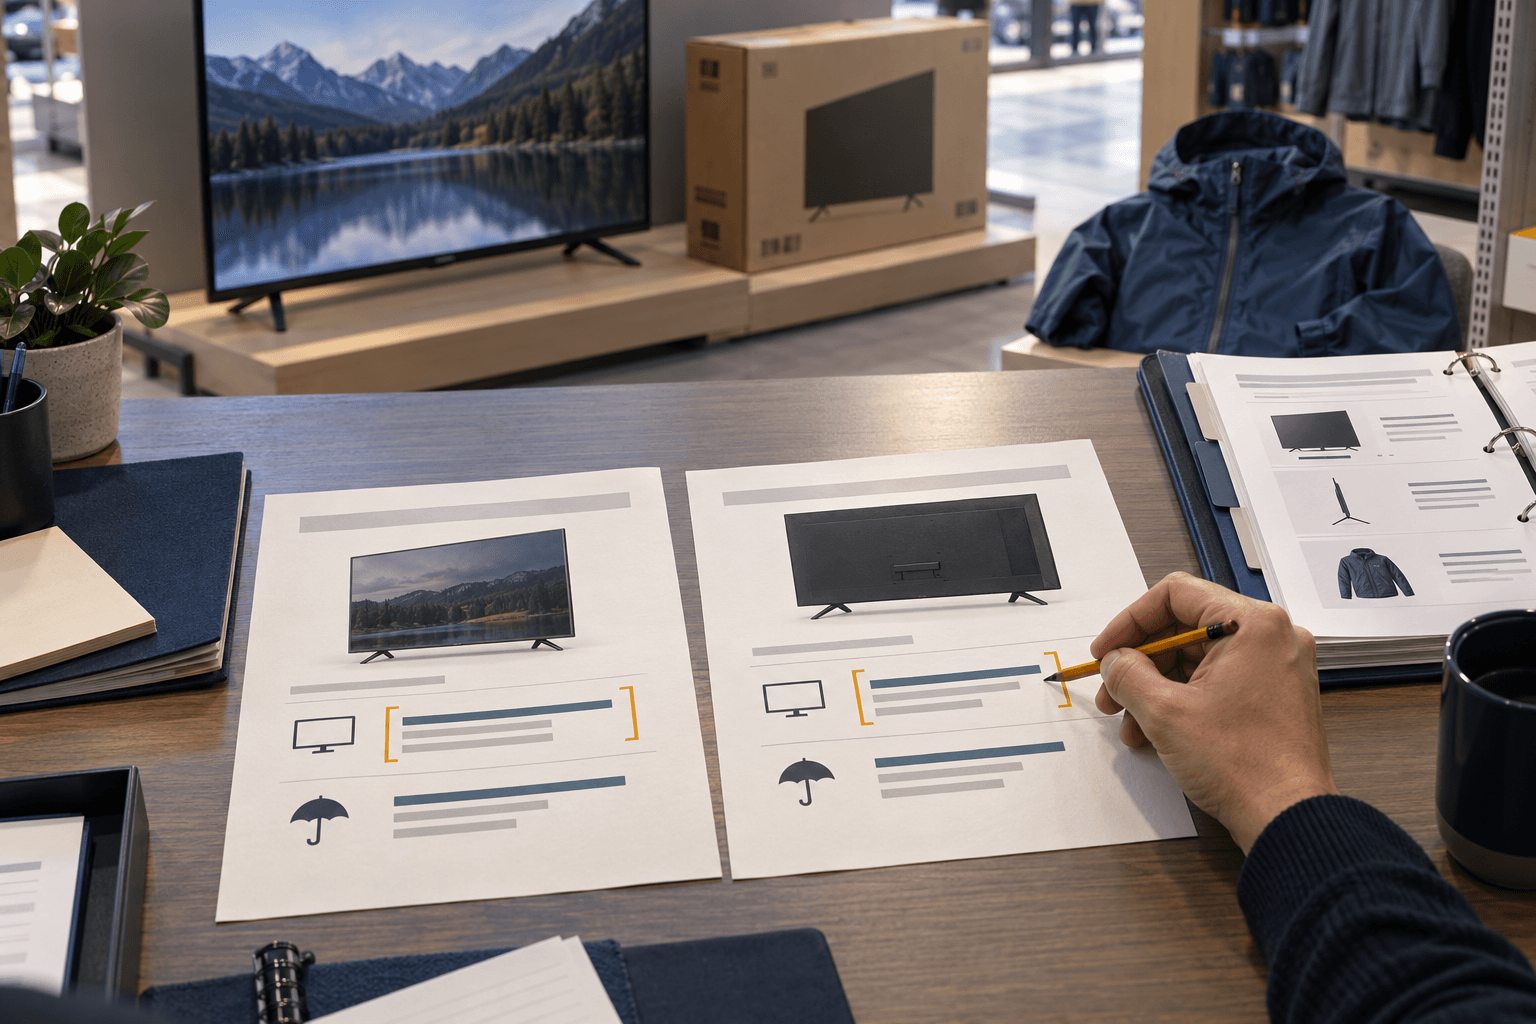
Unsere Vouchmark-Demo macht diese Grenze anhand synthetischer Produkte, vorbereiteter Antworten und lokaler Katalogdatensätze überprüfbar. Sie kapselt vorgegebene Entwürfe ein, anstatt selbst als Einkaufsassistent oder Shop zu fungieren. Ihr nützlichstes Beispiel ist eine Fernseher-Antwort, die eine kleine Korrektur benötigt, gefolgt von einer Jacken-Antwort, bei der eine Korrektur ungerechtfertigt wäre.
Bewahren, was der Katalog stützt
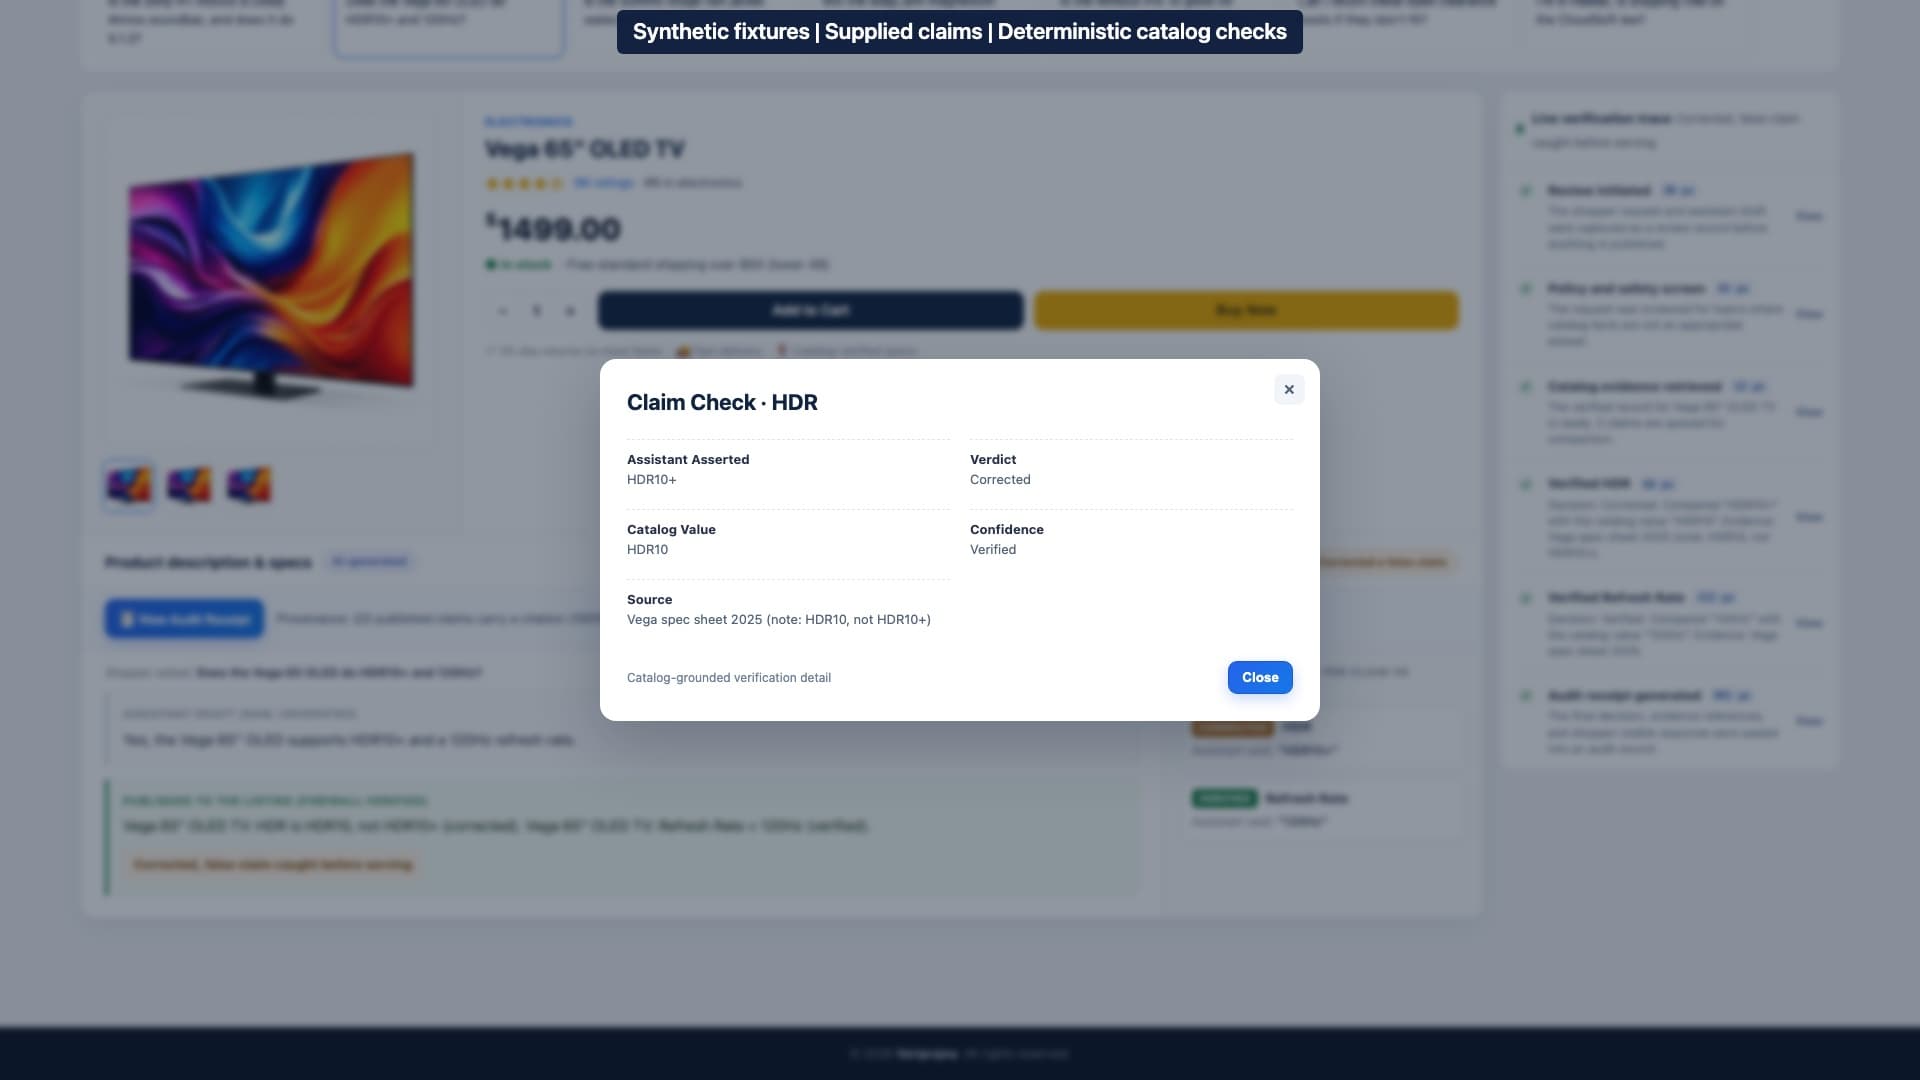
Im Fall des synthetischen Fernsehers besagt ein Entwurf, dass der Vega OLED HDR10+ und eine Bildwiederholfrequenz von 120Hz unterstützt. Das sind zwei unterschiedliche Spezifikationen. HDR10 und HDR10+ sind verschiedene Standards, sodass das zusätzliche Zeichen in diesem Vergleich nicht als harmlose Formulierungsvariante behandelt werden kann.
Der Fixture-Katalog enthält HDR10 und 120Hz. Das Python-Gate korrigiert die erste Behauptung und lässt die zweite passieren. Die angezeigte Antwort behält daher die Bildwiederholrate bei, während sie die Standardkorrektur explizit macht.
Das ist ein nützlicheres Ergebnis, als den Entwurf durch eine pauschale Verweigerung zu ersetzen. Der Katalog kann die Frage beantworten; er kann lediglich nicht beide Teile der vorgeschlagenen Antwort stützen. Es ist zudem rechenschaftspflichtiger, als ein Modell um eine besser klingende Umformulierung zu bitten, ohne festzuhalten, welche Behauptung gescheitert ist. Die Korrektur hat eine konkrete Grundlage: Der behauptete Standard weicht vom Katalogwert ab.
Für ein Team, das ein solches Design bewertet, verdient die Bewahrung von Informationen einen eigenen Test. Ein System, das jede Antwort unterdrückt, könnte vermeiden, viele unbelegte Details auszuliefern, während es kaum Produktinformationen beisteuert. Die entscheidende Frage ist, ob es eine unbegründete Behauptung entfernen kann, ohne benachbarte Angaben zu verwerfen, die der verfügbare Datensatz stützt.
Die vorbereiteten Szenarien von Vouchmark liefern die einzelnen Behauptungen bereits mit. Sie demonstrieren nicht, dass ein Modell jede Behauptung im ursprünglichen Fliesstext selbst gefunden hat. Das Fernsehbeispiel verdeutlicht das Verhalten dieser Katalogentscheidung bei bereits vorgegebener Dekomposition.
Ein unbekanntes Attribut kann keine Korrektur liefern
Die synthetische Summit Ridge-Jacke verdeutlicht ein anderes Problem. Ihr Entwurf verspricht, dass die Jacke vollständig wasserdicht sei. Das Feld für die Wasserdichtigkeitsklasse im Katalog ist unbekannt, und im Fixture ist keine Herstellerbewertung hinterlegt.
Das Gate enthält sich. Es stellt fest, dass der verfügbare Datensatz die Wasserdichtigkeitsbehauptung nicht stützen kann. Es ersetzt den Entwurf nicht durch die Behauptung, die Jacke sei nicht wasserdicht.
Diese Unterscheidung ist wesentlich, weil der Katalog zur strittigen Eigenschaft schweigt. Eine fehlende Bewertung kann weder die eine noch die andere Seite der Behauptung rechtfertigen. Wenn das System jede unbestätigte Behauptung in ihr Gegenteil verkehrt, erzeugt es eine neue Antwort unter dem Anschein einer Korrektur.
Es gibt eine verlockende Alternative: ein naheliegendes Attribut nutzen, um die Antwort hilfreich zu halten. Der Jacken-Datensatz enthält eine abgeleitete Wasserabweisungsbeschreibung, die mit einer Beschichtung verknüpft ist. Aber Wasserabweisung und eine bestätigte Wasserdichtigkeitsklasse sind unterschiedliche Behauptungen. Dieses vorbereitete Szenario liefert die abgeleitete Beschreibung nicht als Ersatz für die fehlende Bewertung aus.
Ich möchte, dass diese Trennung dem Druck standhält, eine allzu glatte Antwort zu liefern. Unter diesen Bedingungen ist eine qualifizierte Aussage vorzuziehen, weil sie die ungeklärte Eigenschaft benennt, ohne die Frage des Kunden stillschweigend zu verändern. Der Preis ist real: Dem Kunden fehlt weiterhin die erfragte Bewertung. In einem Produktionsdesign würde das Schließen dieser Lücke eine geeignete Quelle oder einen separaten Prüfprozess erfordern; die Demo leistet beides nicht.
Eine nützliche Katalogprüfung unterscheidet daher zwei Reparaturaufgaben. Ein Widerspruch fordert das Team auf, konkurrierende Werte abzugleichen. Ein unbekannter Wert fordert das Team auf, eine fehlende Tatsache zu ermitteln. Beides in eine Warteschlange mit der Aufschrift „falsche Antwort“ zu leiten, verschleiert, welche Arbeit noch aussteht und was der Assistent in der Zwischenzeit sicher sagen kann.
Ein Katalogabgleich besitzt eine Autoritätsgrenze
Entscheidungen auf Behauptungsebene machen die Antwort leichter überprüfbar. Sie machen den Katalog nicht unfehlbar.
Die im Fernseherdialog sichtbare Quellenbezeichnung identifiziert eine verfasste Fixture-Referenz. Sie ist nützlich, um die gezeigte Entscheidung nachzuvollziehen, aber sie ist kein Beleg dafür, dass Vouchmark ein Herstellerdokument abgerufen und authentifiziert hat. Die Demo erlaubt es zudem, dass als abgeleitet markierte Attribute denselben Vergleichspfad durchlaufen wie als verifiziert markierte. Ihr Ausgabetext kann einen solchen Treffer als „verifiziert“ bezeichnen, während der Beleg die Kennzeichnung „abgeleitet“ behält.
Dies legt eine Richtlinienentscheidung offen, die ein Commerce-Team explizit treffen muss. Wenn abgeleitete Attribute für eine bestimmte Antwort akzeptabel sind, sollte die angezeigte Einschränkung diesen Status wahren. Wenn das Unternehmen eine direkte Bestätigung für diese Eigenschaft verlangt, sollte das Abgleichen eines abgeleiteten Katalogwerts nicht ausreichen, um ihn als bestätigt auszugeben. Vouchmark demonstriert die Vergleichsmechanik; es legt diese produktive Evidenzrichtlinie nicht fest.
Ich befürworte es, den Evidenzstatus an der Stelle sichtbar zu halten, an der die Behauptung verwendet wird. Andernfalls kann eine Ableitung scheinbare Autorität erlangen, nur weil sie eine andere Komponente durchlaufen hat. Ein korrekter Vergleich und eine vertrauenswürdige Quelle sind verwandte Anforderungen, aber das eine kann das andere nicht ersetzen.
Dieselbe Überlegung begrenzt, was ein Prüfbeleg leisten kann. Das lesbare Protokoll von Vouchmark hält Entwurf, angezeigte Antwort, Behauptungsentscheidungen und Referenzen zusammen. Das unterstützt die Nachprüfung, warum sich die Antwort geändert hat. Der Zeitstempel und der hashbasierte Bezeichner schaffen jedoch keinen signierten, unveränderlichen oder unabhängig verwahrten Datensatz. Ein Produktionsteam, das diese Eigenschaften benötigt, muss über den Export der Erklärung hinaus weitere Schritte unternehmen.
Das Gate und die Abdeckung separat prüfen
Die feste, annotierte synthetische Evaluation der Demo liefert das erwartete Ergebnis für alle 60 bereits dekomponierten Behauptungsfälle. Dieses Resultat ist eine Überprüfung der endlichen Regeln anhand ihrer bereitgestellten Labels. Es misst weder, wie vollständig die Freitextantwort eines Einkaufsassistenten dekomponiert werden kann, noch begründet es die Leistung bei realem Kundenverkehr.
Ein gewöhnliches hypothetisches Beispiel macht den Unterschied deutlich. Angenommen, ein Entwurf besagt, ein Laptop verfüge über den angegebenen Speicher und sei ideal, um den ganzen Tag Videos zu bearbeiten. Ein Verifizierer könnte die Speicherbehauptung erhalten und sie korrekt bestätigen. Das Eignungs- und Ausdauerversprechen könnte außerhalb des extrahierten Sets bleiben. Perfekte Entscheidungen über die vorgelegte Behauptung würden die folgenreichen Teile der Antwort ungeprüft lassen.
Vouchmark verfügt über eine enge, deterministische Vollständigkeitsregel, die einen Weg aufzeigt, eine Auslassung sichtbar zu machen. Im synthetischen Gaming-Laptop-Szenario enthalten die gelieferten Behauptungen nur den Speicher. Eine konfigurierte Regel fügt eine Behauptung über dedizierte Grafik hinzu, der der Katalog dann widerspricht. Diese Zuordnung ist eine gewählte Demo-Interpretation der Formulierung, keine universelle Definition für Gaming-Tauglichkeit oder eine lückenlose Erkennung impliziter Versprechen.
Die Auswirkung auf die Evaluierung ist spezifisch. Ein Team benötigt Belege für die Entscheidungen über bereitgestellte Behauptungen und separate Belege dafür, welche Behauptungen diese Entscheidungsschicht überhaupt erreichen. Den vollständigen Entwurf gegen ein unabhängig erstelltes Behauptungsset zu testen, würde helfen, Letzteres zu untersuchen. Es würde auch aufdecken, ob scheinbar hilfreiche Formulierungen Versprechen hinzufügen, die die Vergleichsregeln nicht abbilden können.
Hier besteht ein Zielkonflikt. Den ausgegebenen Text auf katalogbasierte Vorlagen zu beschränken, kann den Prüfumfang des Systems verringern, geht jedoch auf Kosten der Ausdruckskraft. Reichhaltigere Prosa zuzulassen, kann die Erklärung verbessern, vergrößert aber die Menge expliziter und impliziter Versprechen, die abgedeckt werden müssen. Ein sauberer Gate-Benchmark kann diese Designentscheidung nicht allein treffen.
Der Vouchmark-Erklärbericht zeigt die synthetischen Beispiele und das Entscheidungsprotokoll. Für ein Handelsteam ist das wichtigere Prüfungsartefakt die Grenze um die vorgeschlagene Antwort: Welche Behauptungen wurden identifiziert, auf welche Evidenz stützte sich jede einzelne, und was blieb ungeklärt?
Hier ist der Gründer-Walkthrough zu diesen Katalogentscheidungen in Vouchmark.
Ich beurteile eine Verifikationsschicht danach, ob sie nützliche Details einer Antwort bewahren kann, während sie ungelöste Teile sichtbar macht. Die Freigabe einer vollständigen Antwort sollte einen Grund zu der Annahme erfordern, dass ihre wesentlichen Behauptungen das Gate erreicht haben, zusammen mit einer Richtlinie für die Qualität der dahinterstehenden Evidenz. Bis dahin ist ein akkurates Urteil nur ein Befund über eine vorgelegte Behauptung, und die restliche Antwort bedarf weiterhin einer Rechtfertigung.