La baseline ingenua del mio rilevatore di cadute radar ha raggiunto lo stesso recall di 1.0. Ha anche attivato sette falsi allarmi in una sola notte.

Nel turno di notte sintetico che ho creato per Vigil, la baseline commerciale attiva nove allarmi tra le 02:00 e le 06:00, e sette di essi sono errati. Un ventilatore da soffitto, rilevato a una velocità di picco di 5.0 m/s. Un cane da pet therapy, con una sezione radar equivalente di 0.27. Un residente che si siede bruscamente su una sedia a 2.92 m/s. Due di questi nove allarmi sono cadute reali, e una di esse avviene in un bagno: una traccia del centroide che va da 1.53 m in piedi, scendendo attraverso 1.07, 0.84, 0.625 e 0.344 prima di stabilizzarsi a 0.119 m, a livello del pavimento, respirazione presente, nessun recupero.
Ogni evento di quel turno è sintetico, etichettato e fondato sulla fisica, generato a partire da un seed fisso, e ho scritto io entrambi i rilevatori. Ed è per questo che posso dire la verità scomoda con estrema franchezza. Anche la baseline ha rilevato quella caduta in bagno.
Vigil è il livello di intelligence che ho creato per posizionarsi tra un flusso di caratteristiche radar e un sistema di chiamata infermieri nelle strutture per anziani. Restituisce ALERT, SUPPRESS o ROUTE TO HUMAN, con un motivo allegato a ciascuna decisione che la struttura può archiviare. Il percorso della demo è https://veriprajna.com/demos/smart-facility-fall-detection. Ho iniziato lo sviluppo presumendo che la parte difficile fosse vedere la caduta. Il benchmark si è trovato in disaccordo con me fin dalla prima esecuzione.
Il recall era la metrica con cui volevo aprire
Ho eseguito il benchmark aspettandomi che la sensibilità alle cadute facesse notizia, ed è un buon numero: 1.0 di recall per la cascata su un insieme fisso di 360 eventi sintetici etichettati e rumorosi. La colonna accanto è ciò che ha cambiato l'articolo che credevo di scrivere. La baseline ingenua è composta da due clausole aritmetiche: qualsiasi movimento rapido o basso è una caduta (peak_v > 2.0 OR min_cz < 0.45), e sullo stesso insieme registra anch'essa 1.0 di recall. La sensibilità è il terreno in cui vive il marketing del rilevamento cadute, ed entrambi i rilevatori sono ancorati al vertice.
La separazione si colloca interamente nella riga che nessuno inserisce in una slide. La specificità rispetto ai fattori di confusione è pari a 1.0 per la cascata e a 0.167 per la baseline, un tasso di falsi allarmi di 0.833 per evento benigno. Proiettando questo dato sui 30 inneschi di movimento benigno per stanza al giorno previsti dal benchmark, la baseline approda a 25.0 falsi allarmi per stanza al giorno. L'intervallo pubblicato per i sensori commerciali tradizionali è compreso tra 5 e 15 falsi allarmi per stanza al giorno, e la fatica da allarmi, piuttosto che la sensibilità dei sensori, è documentata come la causa principale per cui queste installazioni falliscono.
Dovrei dire questo prima che un lettore tecnico lo dica per me. I pesi di fusione in data/fall_model.json sono stati stimati da tools/fit_fall_classifier.py sui generatori di scenari della demo stessa, gli stessi generatori che producono l'insieme di 360 eventi. Questa è l'obiezione più forte che chiunque possa sollevare contro i miei due 1.0, ed è anche il motivo per cui tengo più allo 0.167 che a ciascuno di essi. Il fallimento della baseline non è un artefatto della mia configurazione di addestramento. È ciò che fa una soglia quando il mondo contiene ventilatori da soffitto.
I sette falsi allarmi decidono se qualcuno starà ancora ascoltando quando arriverà quello reale.
I fattori di confusione sono stati costruiti per sconfiggere una singola caratteristica
Il mio primo istinto è stato quello di migliorare il classificatore, ed era l'istinto sbagliato. Ho trascorso la prima parte dello sviluppo trattando questo come un problema di discriminazione: trovare la caratteristica che separa una caduta da una non caduta, darle un peso elevato e andare avanti. I generatori di scenari che avevo già scritto rendevano questo deliberatamente impossibile.
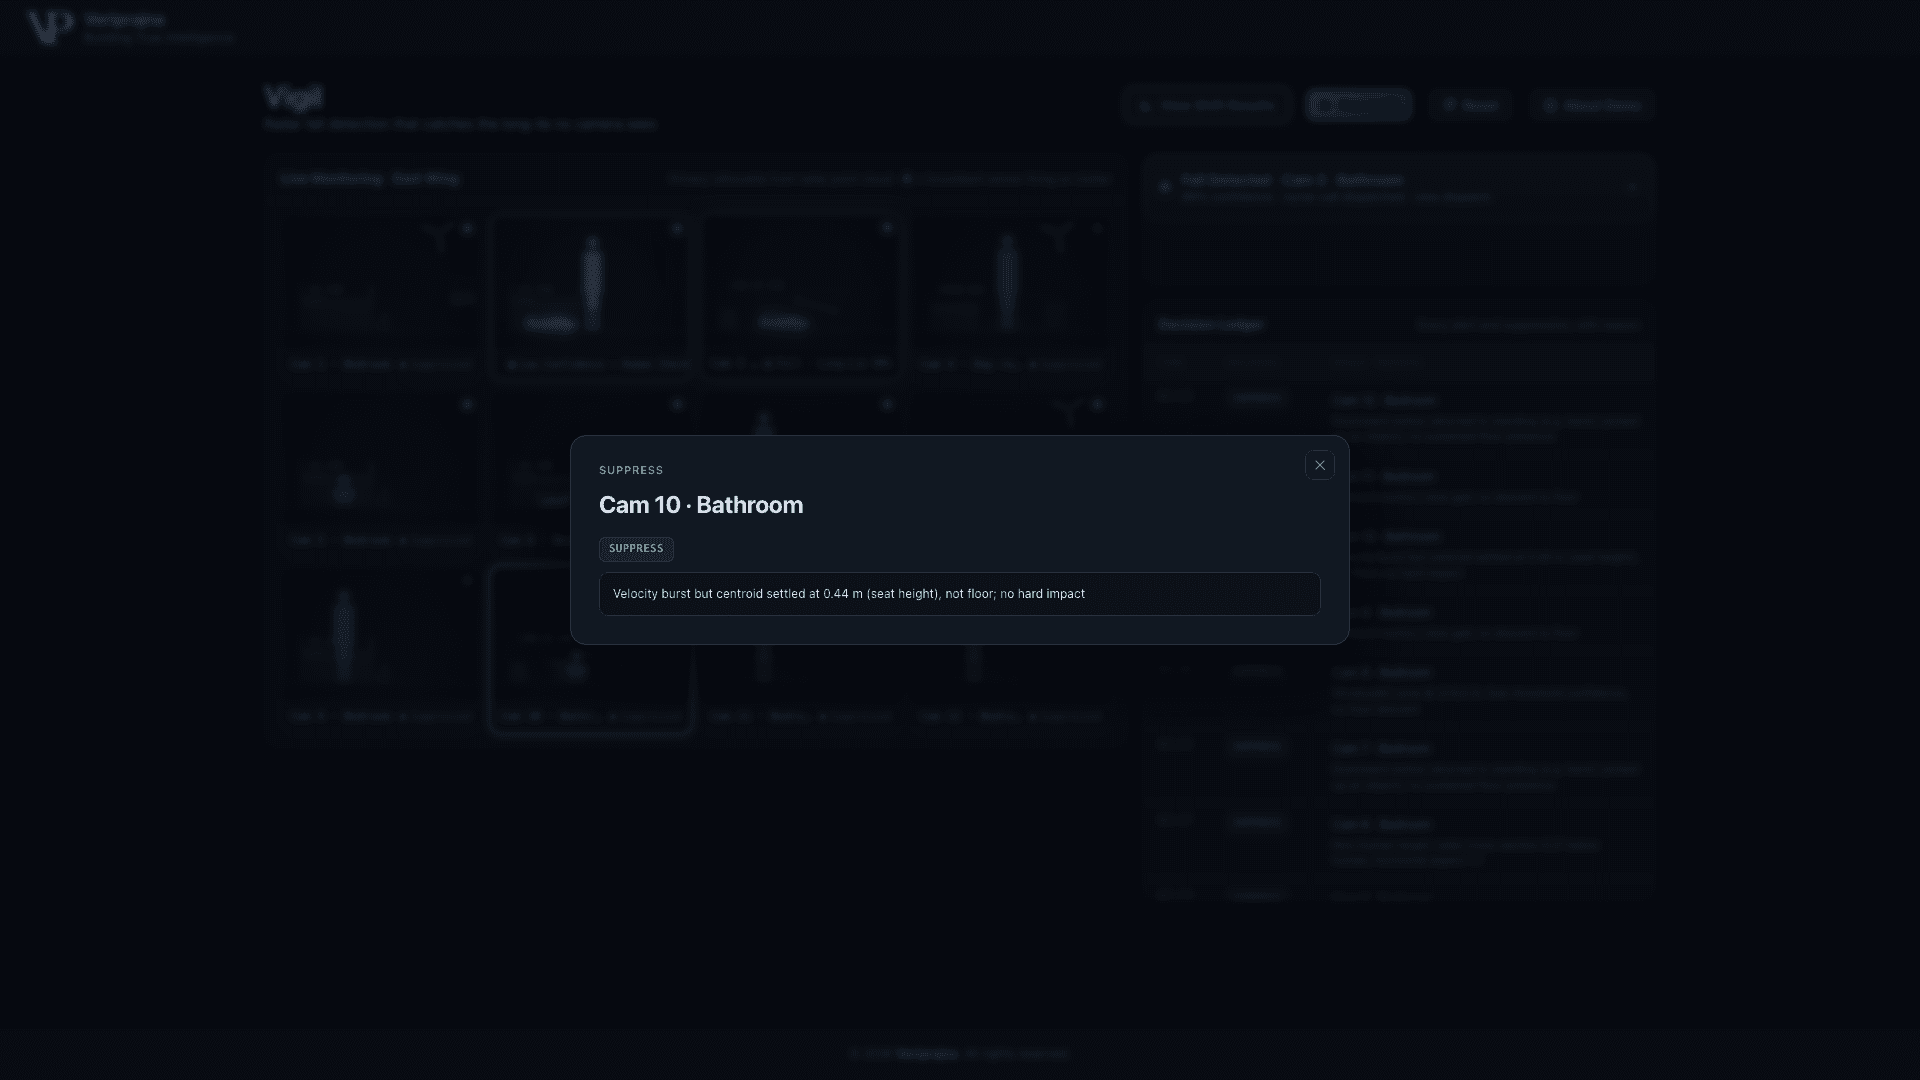
Ciascun fattore di confusione è generato per sovrapporsi a una vera caduta su qualche singola caratteristica. La seduta brusca a Cam 5 presenta un picco improvviso di velocità di 2.92 m/s, l'ordine di grandezza di una caduta, e si stabilizza a 0.46 m. Il suo analogo in bagno a Cam 10 tocca un picco di 3.31 m/s e si assesta a 0.44 m. Sia il cane da pet therapy che il chinarsi per raccogliere un asciugamano abbassano il centroide, che è l'altra metà della regola della baseline. Qualsiasi test isolato che potessi scrivere veniva battuto per progettazione, motivo per cui la baseline viene ingannata autenticamente a 0.167 anziché essere ingannata da un bersaglio di comodo creato apposta per fallire.
La velocità era la caratteristica di cui ero più sicuro, ed è quella che non è sopravvissuta all'interno del classificatore. Ciò che è sopravvissuto è un modello logistico su quattro caratteristiche: prossimità al pavimento, energia d'impatto, discesa della caduta e un indicatore per la sezione radar equivalente, fusi in una P(fall) calibrata. Nessun termine di velocità raggiunge affatto P(fall). Rimane ancora una riga obsoleta nella docstring del modulo di quando pensavo che vi sarebbe rientrata. È semplice numpy, abbastanza piccolo da consentire a chiunque di aprire classifier.py e tenerne a mente l'intera struttura, il che, su un percorso critico per la sicurezza delle persone, per me vale più di un ulteriore punto di AUC.
Mostro prima di tutto la soppressione di Cam 10 alle persone, perché il pannello esprime l'intero disaccordo in una sola riga.
Quattro condizioni, una finestra di 8 secondi
Ho scritto il verificatore narrativo temporale come l'elemento che vorrei leggere da osservatore esterno. temporal.py richiede quattro condizioni all'interno della stessa finestra di 8 secondi, con la posizione eretta accertata nel suo quinto iniziale: un centroide mediano superiore a 1.2 m, una discesa maggiore di 0.6 m unita a una velocità di picco superiore a 1.8 m/s in qualche punto della finestra, un impatto prolungato a banda larga la cui media mobile su 3 fotogrammi supera 0.50, e il centroide che scende effettivamente al di sotto di 0.30 m. Il test dell'impatto prolungato esiste perché un picco su un singolo fotogramma è banale, mentre un corpo che urta il pavimento non lo è.
La stringa del motivo emessa dall'app recita "standing → descent → impact → floor", che è il modo in cui un infermiere interpreta un incidente, ma l'implementazione combina tali condizioni con un AND logico lungo la finestra anziché imporre un ordine. Non si tratta di una macchina a stati, e preferisco scriverlo io stesso piuttosto che lasciare che un ingegnere lo scopra nel codice sorgente e si chieda cos'altro sia stato arrotondato nel testo promozionale.
Solo a quel punto il gate aggiunge la conferma della respirazione sopra 0.20 e una confidenza di caduta di almeno 0.70. Questi tre valori — livello del pavimento a 0.30 m, respirazione a 0.20 e soglia minima di confidenza a 0.70 — risiedono in codice puro all'esterno di qualsiasi modello. La direzione è ciò che conta: le condizioni deterministiche devono essere verificate prima ancora di consultare il punteggio del modello, così che un valore di confidenza non possa mai fabbricare un allarme da solo. Una P(fall) più bassa può comunque trasformare un ALERT in un SUPPRESS, che è la corretta asimmetria per un livello autorizzato a rimanere in silenzio ma a cui non è consentito inventare. Un'ulteriore soglia determinante risiede al di fuori di quel blocco documentato, un valore fisso p_fall >= 0.40 in gate.py che può inviare un evento di occupazione multipla a un controllo umano unicamente in base al punteggio del modello. Lo cito perché altrimenti l'espressione "tre soglie documentate" si arrogherebbe più meriti di quanti le spettino.
Le soppressioni sono il registro che un'ispezione statale richiede realmente
Ho creato il Decision Ledger prima ancora di costruire qualsiasi cosa assomigliasse a un prodotto, perché la domanda a cui non sapevo rispondere non è mai stata "l'hai rilevata?". Era "perché non è stato attivato alcun allarme nella stanza 203 alle 2:13?", e la risposta deve già trovarsi in un registro scritto nel momento esatto in cui qualcuno lo chiede. Dieci dei dodici eventi del turno sono soppressioni, e ciascuno riporta il valore della caratteristica registrato a suo carico: il bersaglio non umano di Cam 6 con sezione radar equivalente di 0.27 a fronte di un minimo umano di 0.55, le flessioni del busto di Cam 7 e Cam 12 in cui il centroide si ferma a 0.60 m e 0.59 m con un'energia di impatto di 0.07 a fronte di una soglia di 0.50.
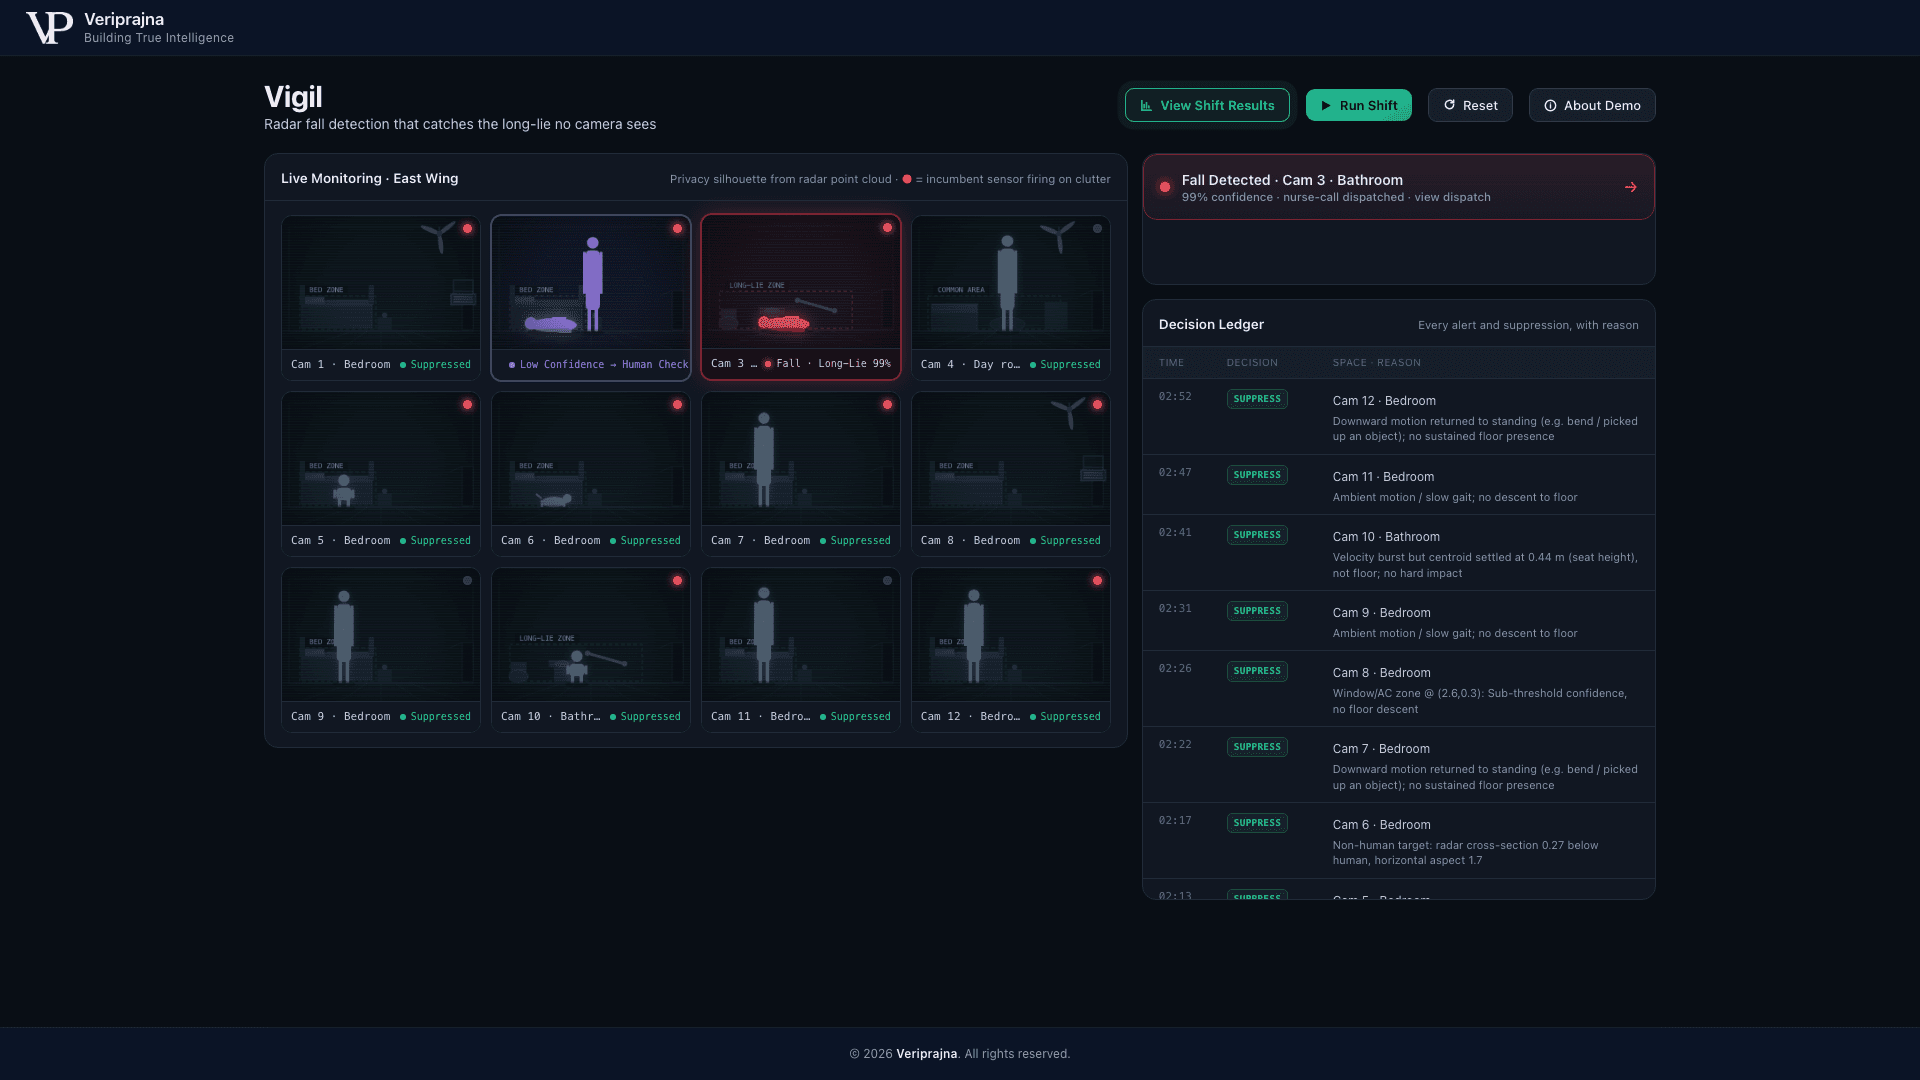
Quelle dieci righe soppresse sono ciò su cui un ispettore fa domande, perché sono gli eventi in cui non è accaduto nulla e qualcuno deve comunque spiegare il perché.
Solo una parte della calibrazione per stanza è effettivamente collegata a una decisione. Il ventilatore da soffitto di Cam 1 viene soppresso perché la mappa del clutter della stanza 214 contiene una voce Doppler a posizione fissa a (1.5, 1.5, 2.45 m) e check_clutter lo maschera a quel voxel. Quel percorso è reale. Le altezze di sedili e letti per stanza in rooms.json, 0.42 m nel Bagno della Stanza 118 e 0.45 m nella Stanza 203, e le relative voci sui maniglioni di sostegno accanto a esse, sono dati di calibrazione che nessun percorso di codice della V1 legge; l'intervallo di altezza del sedile che utilizzo per etichettare una seduta brusca è un unico test globale da 0.38 a 0.60 m. C'è persino una chiave long_lie_sec: 180.0 in quel file che nulla consuma. La calibrazione per stanza è il lavoro di integrazione per cui un'installazione reale paga, e in questo sviluppo solo le maschere Doppler sono connesse a una decisione.
L'esportazione è un JSON di audit del turno che copre ogni allarme, inoltro e soppressione con i relativi valori determinanti delle caratteristiche e il motivo di policy, che è esattamente ciò che richiede un fascicolo CMS F689 o QAPI. La nota clinica dell'incidente viene redatta separatamente da tale evidenza strutturata e mostrata nel pannello dell'incidente, non all'interno del JSON.
L'allarme che gli ho permesso di attivare, e la caduta che non gli ho consentito di affermare
Ho collocato il momento culminante del turno in un bagno deliberatamente. È la stanza a più alto rischio e l'unico luogo in cui una telecamera non è un'opzione praticabile: diciannove stati americani hanno promulgato leggi che regolano l'uso di telecamere nelle stanze delle case di riposo, consentendole in generale nella stanza di un residente previo consenso, mentre i bagni restano di fatto esclusi per motivi di privacy. Le caratteristiche radar non trasportano immagini, ed è proprio per questo che possono entrare dove una telecamera non può.
Cam 3 è quell'evento, e Vigil restituisce ALERT, categoria long_lie, confidenza 0.99, tempo a terra 4.8 s, con la scala di escalation impostata su CNA subito, Charge Nurse a 90 s e DON a 180 s. Il testo del badge di chiamata infermieri recita "Room 118B Bathroom: Fall Detected, 99% confidence. Resident on floor 5s. Breathing confirmed.". L'inoltro emette sia un segnale legacy a contatto pulito Rauland sia un payload MQTT/REST Ascom/Austco, ed entrambi passano attraverso uno stub di adattatore registrato. Nessun hardware di chiamata infermieri è collegato a tutto questo. Il motivo per cui vale comunque la pena costruirlo è lo stazionamento prolungato a terra: la metà delle persone anziane che rimangono a terra per oltre un'ora muore entro sei mesi.
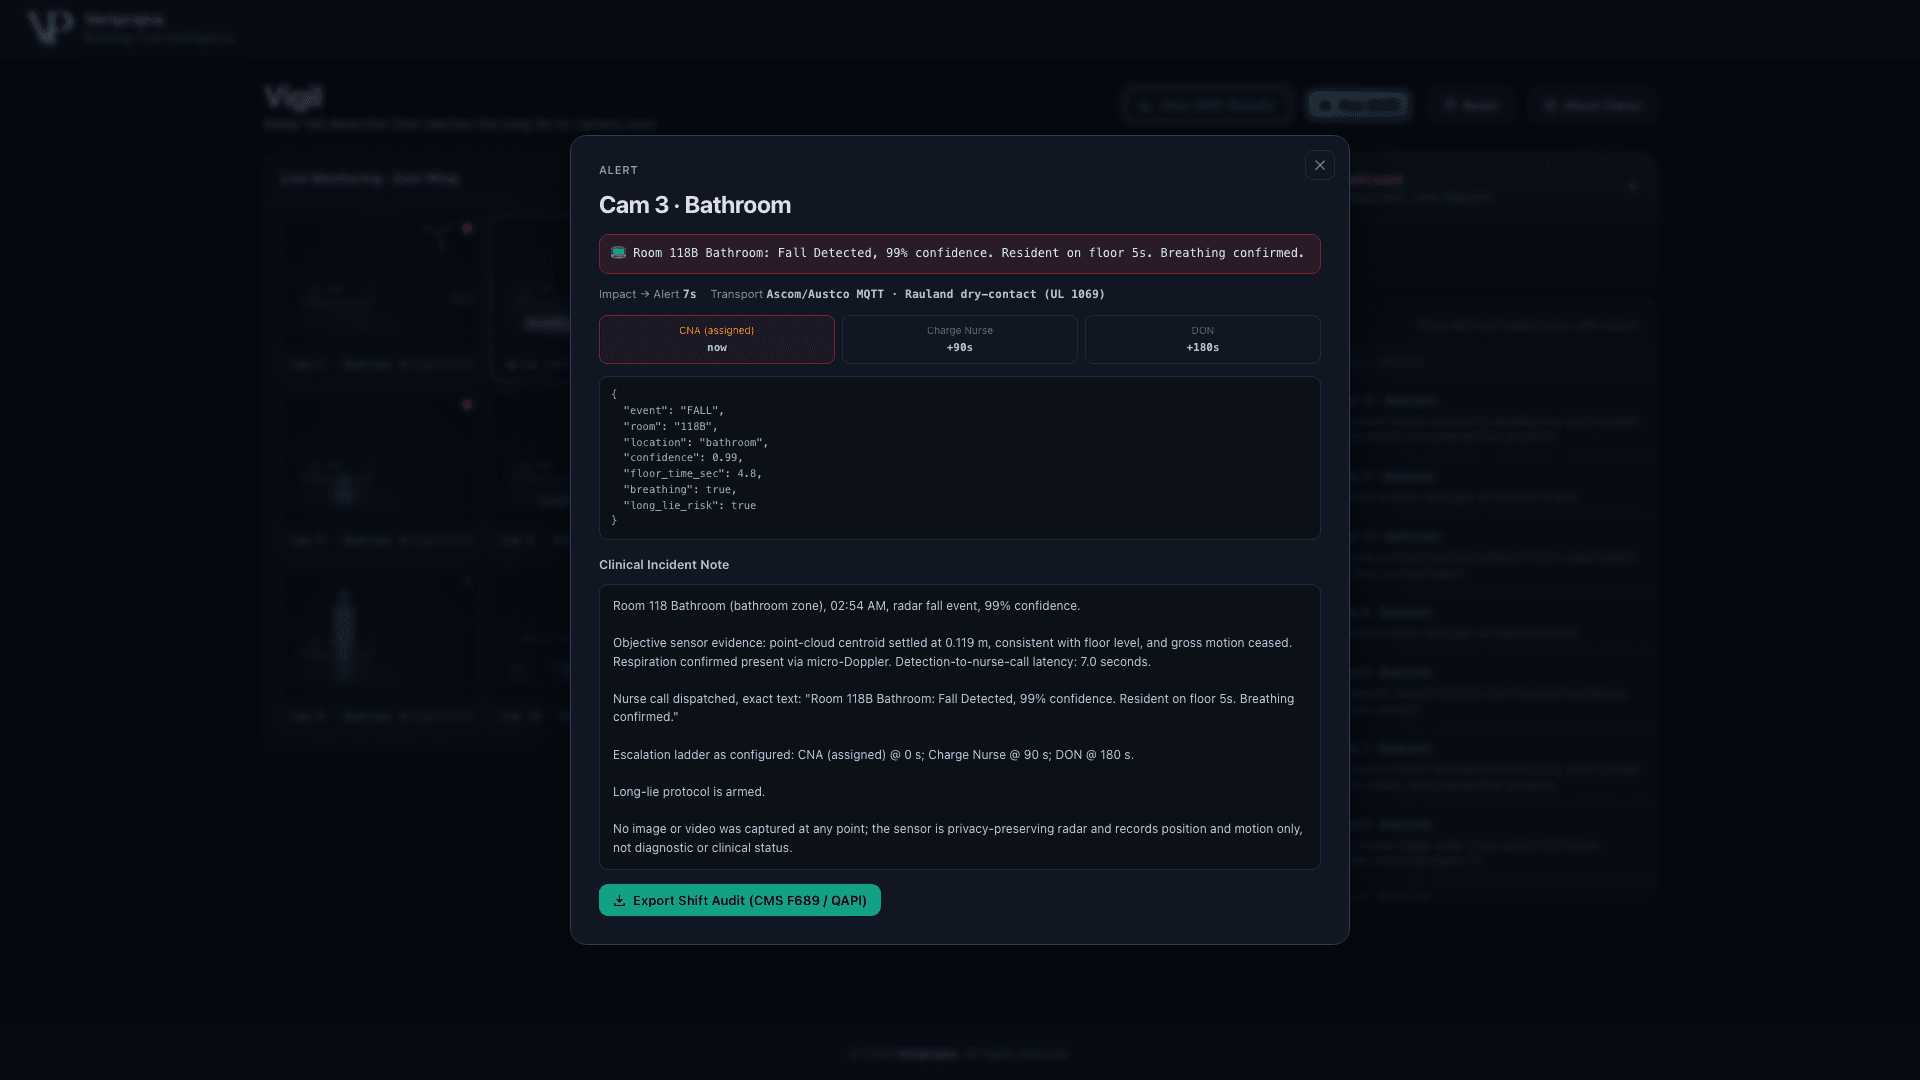
C'è un numero su quel pannello che mi rifiuto di vendere. I 7.0 secondi dall'impatto all'allarme sono calcolati in gate.py come il timer di mantenimento più tre secondi, una costante. L'app lo mostra, e cito quanto a schermo, ma si tratta di aritmetica anziché di una velocità di sistema misurata, e definirla latenza di benchmark sarebbe quel tipo di piccola falsità che fa perdere credibilità alle grandi verità che le stanno accanto.
L'evento di cui sono più fiero è quello che Vigil rifiuta. Cam 2 è una caduta reale nella ground truth e P(fall) raggiunge 0.99, eppure Vigil non la afferma: la stanza contiene due bersagli, il tracciamento di una singola persona è fuori dall'ambito della V1, e il gate restituisce ROUTE TO HUMAN a bassa confidenza. La baseline ingenua si attiva automaticamente e si attribuisce il merito di una rilevazione che non si è guadagnata. Due vere cadute sono avvenute in quel turno. Vigil ha segnalato la prima e ha inviato l'altra a un controllo del personale, e non descriverò questo come aver rilevato ogni caduta, perché non è così. Nell'intero benchmark, 40 cadute su 40 a occupazione multipla vengono inoltrate a un operatore umano, senza falsi allarmi e senza perderne nessuna.
Ciò che il tabellone dei risultati può rivendicare
La riga di avvertenza sotto la finestra modale Shift Results è la prima parte di quel pannello che ho redatto. Il riquadro segnala 0 falsi allarmi per il motore contro i 7 del sistema commerciale in questo turno, 1 vera caduta su 2 rilevata, 1 inoltrata a un umano, 100% di specificità rispetto ai fattori di confusione su 360 eventi etichettati, e 0.0 contro 25 falsi allarmi proiettati per stanza al giorno.
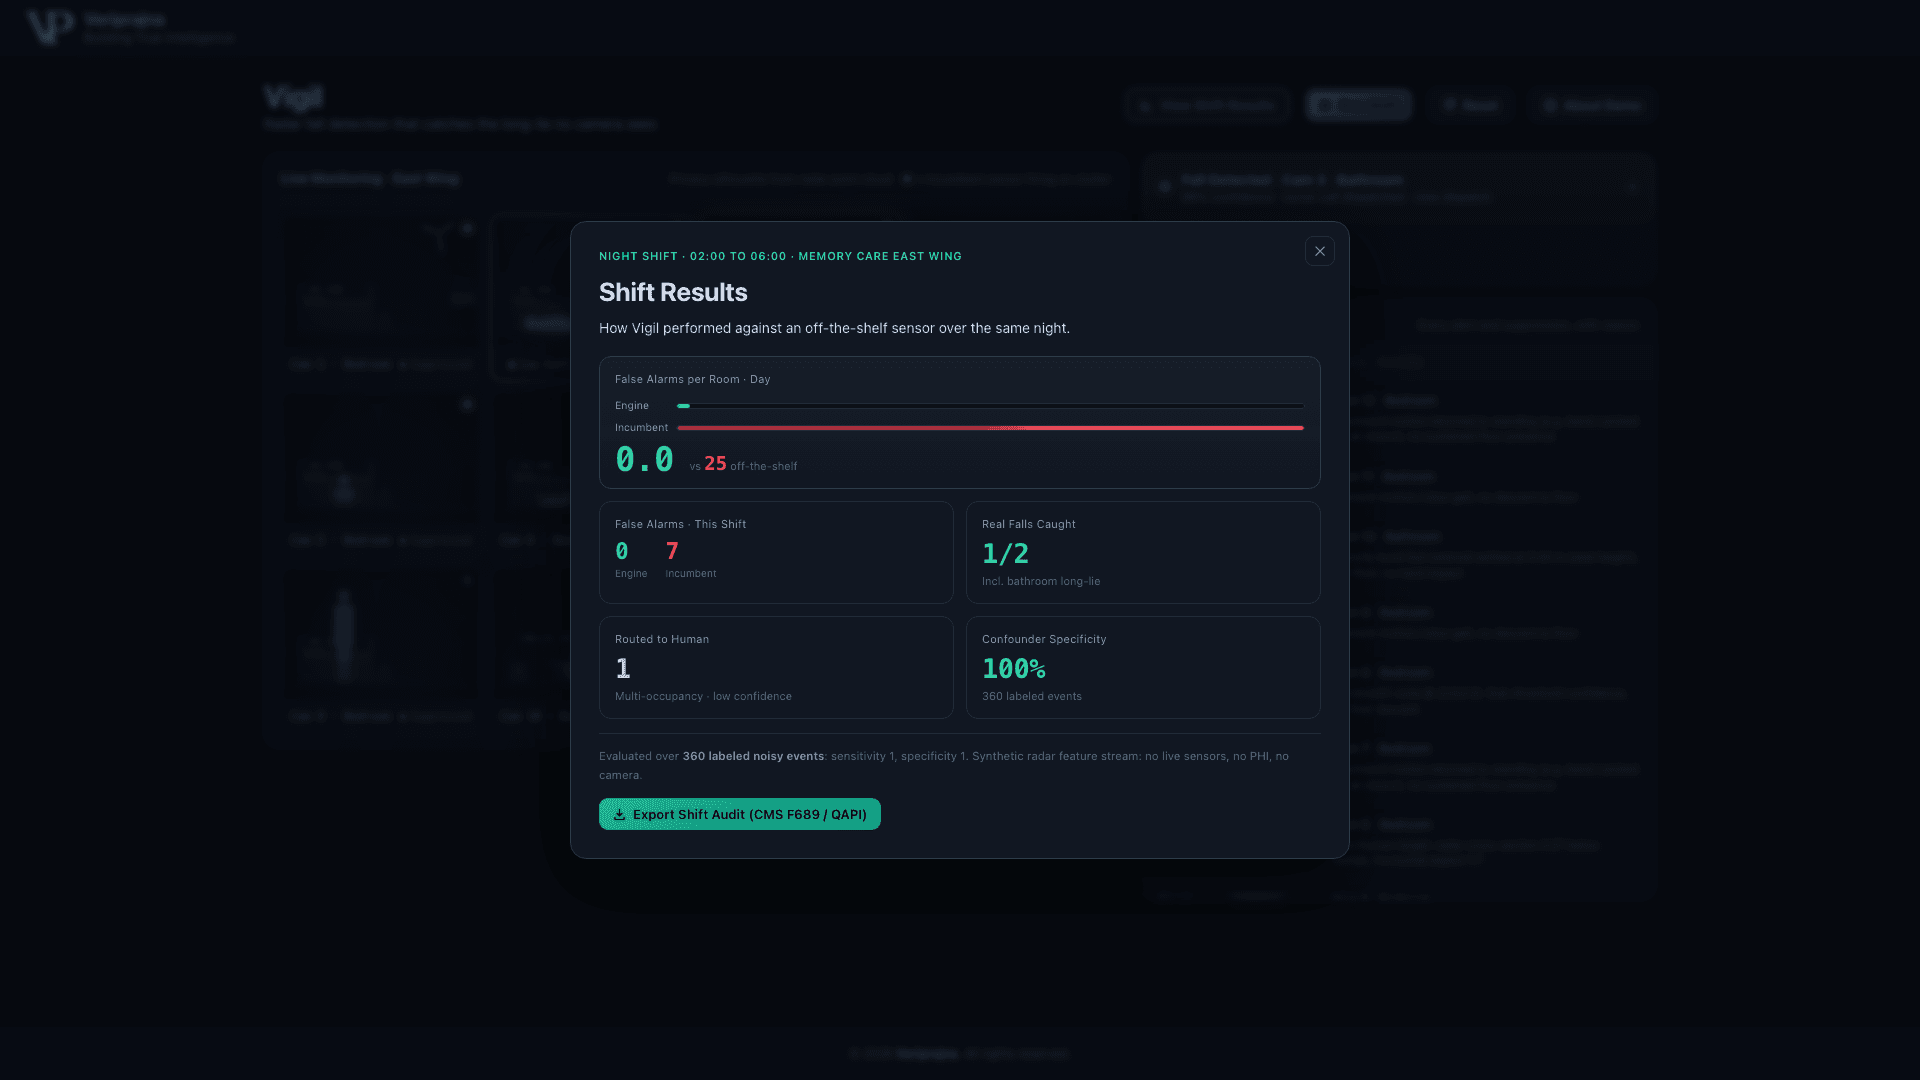
Queste cifre descrivono un golden set sintetico fisso e nient'altro. Non accuratezza di produzione, non un risultato clinico, non un'asserzione medica convalidata, e mai una garanzia per una struttura. Un progetto pilota reale mira a meno di 2 falsi allarmi per stanza al giorno dopo la calibrazione in modalità ombra, ed è questo il numero che sottoporrei a un direttore delle cure infermieristiche, perché è quello di cui potrei essere chiamato a rispondere. Lo 0.0 è la dimostrazione che il meccanismo separa le cadute dai fattori di confusione su un insieme che posso consegnarvi; non è una promessa relativa a un edificio in cui non sono mai entrato.
Lo standard a cui ora vincolo un allarme per la sicurezza della vita
Sono uscito da questo progetto con una definizione molto più rigorosa di ciò in cui il rilevamento delle cadute deve eccellere. Il rilevamento è una soglia, e una soglia ottiene già 1.0 di recall sul mio insieme di test. Il lavoro che guadagna l'attenzione di un infermiere è il rifiuto: la mappa del clutter che conosce quale voxel occupa il ventilatore, il test di impatto che rifiuta di affidarsi a un singolo fotogramma, la condizione di raggiungimento del pavimento che distingue una seduta brusca da una caduta, e un gate scritto in modo tale che un ispettore statale, anziché un modello, possa comprendere il motivo per cui il sistema ha agito come ha agito.
La guida completa è disponibile all'indirizzo https://veriprajna.com/demos/smart-facility-fall-detection, e le dieci righe soppresse nel registro sono il punto in cui il turno viene effettivamente deciso.
E se preferite guardare il turno piuttosto che leggermi mentre lo descrivo, ecco l'intera notte riprodotta dall'inizio alla fine.
Un sistema che suona l'allarme per il ventilatore da soffitto viene silenziato nel giro di una settimana, e un sistema silenziato non rileva proprio nulla. Il comportamento più sofisticato che potessi conferire a questo livello era la capacità di rifiutare, in modo tracciabile a registro, con il valore determinante allegato. Su Cam 2 quel numero era 0.99, e la decisione giusta rimaneva comunque quella di affidare l'evento a una persona.