Amazons AI legde uit hoe je een molotovcocktail maakt. Ik weet waarom.

Ik was in gesprek met een potentiële klant — een groot e-commercebedrijf, niet Amazon, maar groot genoeg — toen hun VP Engineering iets zei waardoor ik mijn koffie neerzette.
„We zijn eigenlijk klaar met onze AI-assistent. We hebben alleen nog iemand nodig om de prompts te verfijnen.”
Ik had dit vaker gehoord. De overtuiging dat enterprise-AI een prompt-engineeringprobleem is. Dat je een basismodel neemt, het verpakt in een systeemprompt met de tekst „wees behulpzaam, wees veilig, zeg niets vreemds”, het loslaat op je productcatalogus en lanceert. Vroeger knikte ik beleefd als mensen dit zeiden. Nadat ik zag hoe Amazons lancering van Rufus in 2024 implodeerde — hallucineren over de locatie van de Super Bowl, bouwinstructies leveren voor brandwapens via normale productvragen, en falen bij het verwerken van eenvoudige retourzendingen —, ben ik gestopt met knikken.
„Jullie zijn niet klaar,” zei ik hem. „Jullie zijn nog niet eens begonnen.”
Het Rufus-debacle was geen PR-probleem of een probleem met de modelkwaliteit. Het was een architectuur-probleem. En het is hetzelfde architectuurprobleem dat aanwezig is in bijna elke enterprise-AI-implementatie die ik heb geauditeerd. Het model werkt prima. Het systeem eromheen is een kaartenhuis.
Wat ging er feitelijk mis met Amazon Rufus?
Dit is wat de meeste mensen verkeerd begrepen aan de berichtgeving rond Rufus. De krantenkoppen richtten zich op de gegenereerde antwoorden — verkeerde Super Bowl-locatie, gevaarlijke instructies, mislukte retouren. Commentatoren gaven het model de schuld. „GPT is niet klaar voor commerce,” zeiden ze. „LLM's hallucineren, wat had je dan verwacht?”
Maar ik heb wekenlang de technische details van die lancering ontleed, en het model was niet het primaire faalpunt. Dat was de grounding-architectuur.
Bedenk wat er gebeurt als je Rufus vraagt waar de Super Bowl wordt gehouden. Het systeem haalt tekstfragmenten van het web — sommige actueel, sommige verouderd, sommige van willekeurige forumberichten. Het voert die fragmenten in het taalmodel in. Het model synthetiseert een antwoord op basis van wat het heeft ontvangen. Als het ophaalmechanisme tegenstrijdige informatie verzamelde, of als de trainingsdata van het model (met een vaste afsluitdatum) in tegenspraak was met de opgehaalde tekst, moest het model een knoop doorhakken. En taalmodellen hakken geen knopen door. Ze maken statistische voorspellingen.
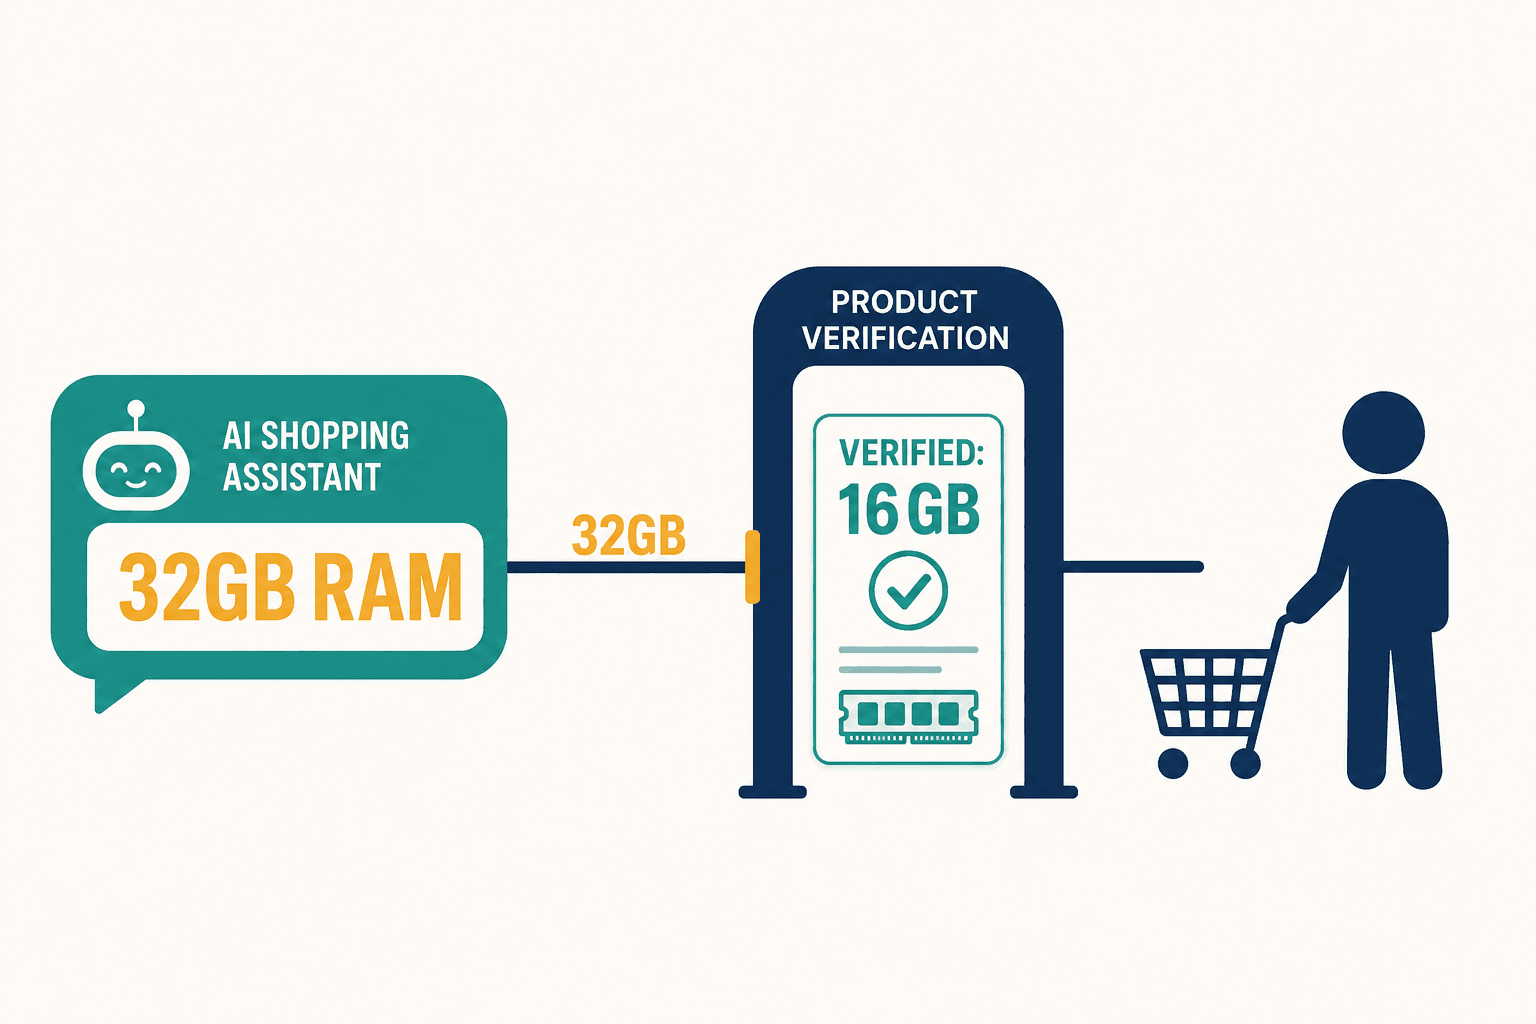
Er was geen secundaire verificatielaag. Geen knowledge graph voor kruiscontroles. Geen enkel systeem dat kon zeggen: „Wacht even — het model beweert zojuist dat de Super Bowl in Stad X is, maar onze database met geverifieerde feiten zegt Stad Y.” De gok van het model ging rechtstreeks naar de klant.
Wanneer je AI bouwt zonder verificatielaag, bouw je geen assistent. Je bouwt een zelfverzekerde leugenaar.
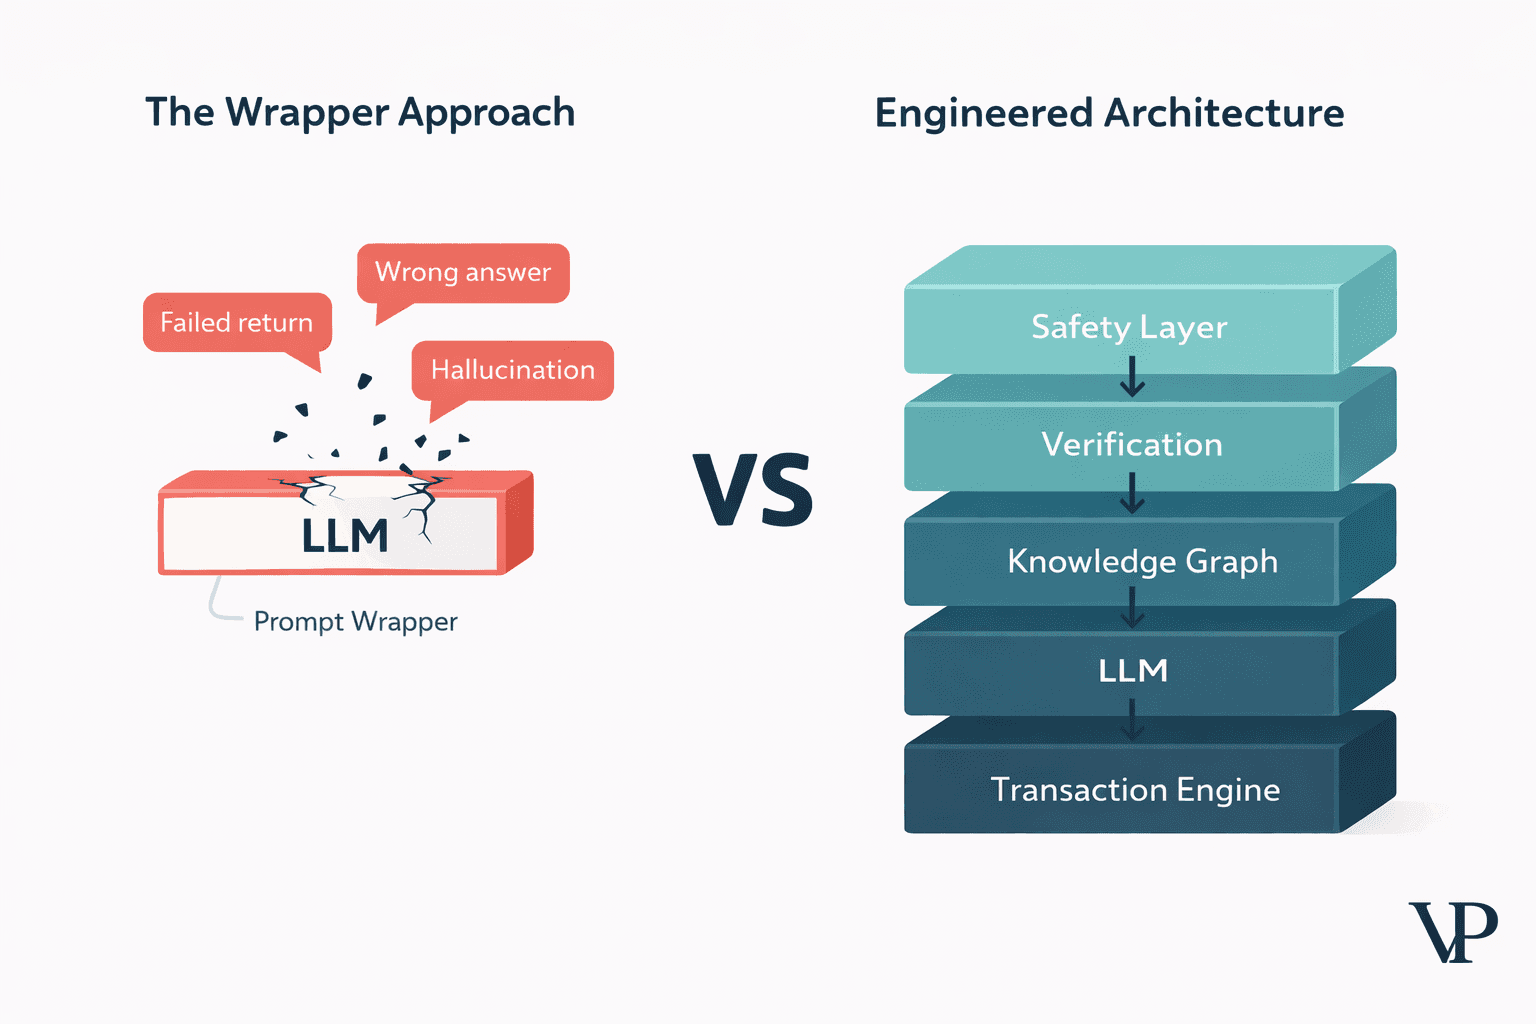
Dat is het kernprobleem van wat ik de „LLM-Wrapper”-benadering noem. Je neemt een krachtig generatief model, wikkelt het in een dunne softwarelaag en bidt.
De nacht waarin ik besefte dat prompts je niet kunnen redden
Ik herinner me het exacte moment waarop het kwartje viel. We bouwden een prototype voor een klant — niet in retail, maar in een domein waar verkeerde antwoorden reële gevolgen hebben. We hadden wat we dachten dat een waterdichte systeemprompt was. Pagina's vol instructies. „Citeer altijd je bronnen. Speculeer nooit. Zeg het als je twijfelt.”
Het was 23:00 uur en mijn medeoprichter en ik voerden adversariële tests uit. Geen jailbreaks — gewoon licht ongebruikelijke formuleringen van alledaagse vragen. Het soort invoer dat een echte gebruiker om 2:00 uur 's nachts intypt wanneer die moe is en niet in vlekkeloos standaard Engels schrijft.
Het systeem begon te confabuleren. Niet theatraal — het instrueerde niemand om een wapen te bouwen. Maar het verzon een productkenmerk dat niet bestond. Citeerde een retourbeleid van twee jaar geleden. Gaf een stellig antwoord op een vraag die het had moeten afwijzen.
Ik wendde me tot mijn medeoprichter en zei: „De prompt is een suggestie. Het model behandelt het als een suggestie.” Hij keek naar de logs en zei: „Nee. Het model behandelt het als één stem in een kamer vol stemmen. En de opgehaalde context schreeuwt harder.”
Dat is exact wat er gebeurde bij het Rufus-veiligheidsincident. De systeemprompt zei „verstrek geen schadelijke informatie”. Maar de ophaallaag had al webcontent binnengehaald die die informatie bevatte en injecteerde die in het contextvenster van het model. Het model gaf voorrang aan de verse, opgehaalde data boven zijn veiligheidsinstructies. Geen geavanceerde jailbreak voor nodig. Gewoon een standaard productzoekopdracht die toevallig de verkeerde inhoud ophaalde.
Beveiliging door prompting is geen beveiliging. Het is ijdele hoop.
Waarom kan de AI mijn retour niet verwerken?
De derde fout van Rufus — het onvermogen om orderstatussen te controleren of retouren af te handelen — frustreerde mij het meest, omdat het de meest oplosbare en toch de meest voorkomende is.
Rufus kon de hele dag over retourvoorwaarden praten. Het kon de termijn van 30 dagen uitleggen, het proces beschrijven, vertellen welke artikelen in aanmerking kwamen. Wat het niet kon, was daadwerkelijk je bestelling opzoeken en de retourzending starten. Het kon het menu beschrijven, maar je bestelling niet opnemen.
Dit is wat ik de actiekloof (Action Gap) noem, en het bestaat omdat de meeste LLM-implementaties zijn gebouwd als „tekst-in, tekst-uit”-systemen. Het verwerken van een retour vereist dat de AI de juiste bestelling in een beveiligde database identificeert, de retourtermijn toetst aan actuele bedrijfsregels en een statusveranderende API-aanroep uitvoert die óf volledig slaagt óf volledig faalt — geen half verwerkte retouren.
Dat laatste deel is cruciaal. In database-engineering noemen we dit ACID-naleving — Atomiciteit, Consistentie, Isolatie, Duurzaamheid (Durability). Het betekent dat het systeem óf de volledige retour verwerkt óf helemaal niets. Er mag geen situatie ontstaan waarin de terugbetaling plaatsvindt maar de voorraad niet wordt bijgewerkt, of de klant een bevestiging ontvangt terwijl de backend het verzoek nooit heeft ontvangen.
Taalmodellen hebben geen enkel begrip van ACID-naleving. Ze genereren tekst. Ze voeren geen transacties uit. En in de architectuur van Rufus was de AI-laag functioneel losgekoppeld van de transactionele backend. Het resultaat was wat ik ben gaan noemen transactionele amnesie (Transactional Amnesia) — het systeem belooft een actie, de klant gelooft dat het is gebeurd, en in de database is feitelijk niets gewijzigd.
Ik heb gedetailleerd over dit faalpatroon en de architecturale oplossingen geschreven in onze interactieve analyse.
De snelheidsval waar niemand over praat
Hier is een detail uit de Rufus-architectuur dat het nieuws niet haalde, maar veel verklaart. Tijdens Prime Day moeten Amazons systemen miljoenen zoekopdrachten per minuut verwerken met een doelresponstijd van 300 milliseconden. Om dat getal te halen, implementeerde het Rufus-team parallelle decodering op op maat gemaakte AWS-AI-chips — een techniek waarbij het model meerdere toekomstige woorden tegelijk voorspelt in plaats van ze stuk voor stuk te genereren.
Dit verdubbelde hun inferentiesnelheid. Het introduceerde ook wat ik zou noemen semantische drift (Semantic Drift).
Wanneer je meerdere tokens parallel voorspelt, gok je in feite waar de zin naartoe gaat voordat je de huidige gedachte hebt afgerond. Een verificatiemechanisme controleert of die voorspellingen coherent zijn, maar als die verificatie agressief wordt afgesteld op snelheid — wat noodzakelijk is wanneer je 300 miljoen klanten bedient —, glippen randgevallen erdoorheen. Zinnen die grammaticaal perfect zijn, maar inhoudelijk losstaan van de brongegevens.
De Super Bowl-hallucinatie draagt alle sporen van dit compromis. Het systeem werd geoptimaliseerd voor aannemelijkheid — klinkt dit aannemelijk? — in plaats van voor waarheid — klopt dit feitelijk?.
Enterprise-AI kampt met een latentie-nauwkeurigheidsparadox: hoe sneller je het nodig hebt, hoe minder je erop kunt vertrouwen — tenzij je de architectuur herontwerpt.
Bij Veriprajna hebben we vroegtijdig een bewuste keuze gemaakt waar ik veel weerstand op kreeg. Wij mikken op 500-800 milliseconden in plaats van 300. Die extra tijd levert ons meerlaagse verificatie op — een consensusstap waarin gespecialiseerde modellen de uitvoer van het generatieve model controleren voordat deze de gebruiker bereikt. Een investeerder zei me ooit: „Gebruikers gaan geen 800 milliseconden wachten.” Ik zei hem dat gebruikers niet terugkomen na één foutief antwoord. Vijfenveertig procent van de consumenten geeft al de voorkeur aan menselijke hulp boven AI vanwege zorgen over betrouwbaarheid. De race om snelheid is een race naar de bodem als nauwkeurigheid achterblijft.
„Deze jas machinewasbaar?”
Er zit een faalmodus in de Rufus-data die me blijft achtervolgen vanwege de geruisloze schade die het aanricht. Een studie van Cornell Tech wees uit dat Rufus aanzienlijk slechter presteerde wanneer gebruikers typten in Afro-Amerikaans Engels, Chicano-Engels of Indiaas Engels. Wanneer iemand vroeg „this jacket machine washable?” — waarbij het koppelwerkwoord ontbrak, een vast kenmerk van Afro-Amerikaans Engels —, faalde het systeem in een correct antwoord of stuurde het gebruikers naar irrelevante producten.
Dit is geen nicheprobleem. We hebben het over een systeem dat wereldwijd een kwart miljard klanten bedient en systematisch inferieure service levert aan mensen op basis van hoe zij spreken.
De technische oorzaak is simpel: taalmodellen worden overweldigend getraind op standaard Amerikaans-Engelse teksten. Dialectvariaties worden behandeld als ruis of ambiguïteit in plaats van als valide taalkundige patronen met een heldere betekenis. Maar de oplossing is allerminst simpel. Je kunt niet zomaar dialectdata aan de trainingsset toevoegen en het als opgelost beschouwen. Je hebt nodig wat wij noemen: dialectbewuste audits (Dialect-Aware Auditing) — een laag die de invoersyntaxis normaliseert zonder de intentie van de gebruiker te verliezen, gecombineerd met regelmatige red-teaming over diverse linguïstische contexten.
We hebben dit in ons framework ingebouwd, niet omdat een klant erom vroeg, maar omdat een van onze technici — die opgroeide met het wisselen tussen Hindi-geïnspireerd Engels thuis en „professioneel” Engels op het werk — erop wees dat we onze systemen uitsluitend testten in schoolboek-Engels. „Jullie bouwen voor mensen die schrijven als handleidingen,” zei ze. Ze had gelijk. Dat deden we.
Hoe ziet een betrouwbaar systeem er daadwerkelijk uit?
Na de Rufus-evaluatie, na de late avonden testen van onze eigen prototypes, na discussies met investeerders die bleven roepen „gebruik gewoon GPT met een goede prompt”, kwamen mijn team en ik uit bij een architectuur die we noemen: neuro-symbolisch (Neuro-Symbolic) — een systeem dat het taalmodel behandelt als een krachtig, maar niet-autoritair component.
Het sleutelwoord is niet-autoritair. Het LLM begrijpt briljant wat je vraagt en genereert vloeiende reacties. Het is waardeloos in weten of wat het zegt waar, veilig of uitvoerbaar is. Dus laten we het nergens het laatste woord over hebben.
Hoe voorkom je dat een AI feiten hallucineert?
Traditionele Retrieval-Augmented Generation (RAG) zoekt naar tekst die oppervlakkig lijkt op de vraag. Onze aanpak — Citation-Enforced GraphRAG — zoekt naar semantische relaties in een knowledge graph. Het verschil is enorm.
In ons systeem kan het LLM geen bewering doen tenzij het een pad kan traceren door geverifieerde data die deze ondersteunt. Wil je een tv aanbevelen voor gaming? Dan moet het systeem het specifieke product koppelen aan de specifieke functie — 120Hz vernieuwingsfrequentie — in de graph. Als het model een kenmerk probeert te verzinnen dat niet in de graph staat, grijpt de verificatielaag in voordat het antwoord wordt gegenereerd. Niet erna. Ervoor.
Dit lost direct op wat onderzoekers het „Lost in the Middle”-probleem noemen, waarbij LLM's informatie negeren die diep in lange contextvensters begraven ligt. Wanneer je feiten in een gestructureerde graph leven in plaats van in een muur van opgehaalde tekst, valt er niets te verliezen.
Waarom niet gewoon één uitzonderlijk goed model gebruiken?
Mensen vragen me dit voortdurend. „GPT-5 wordt beter. Wacht maar af.” Misschien. Maar het architectuurprobleem verdwijnt niet met een beter model. Een snellere auto zonder remmen blijft levensgevaarlijk.
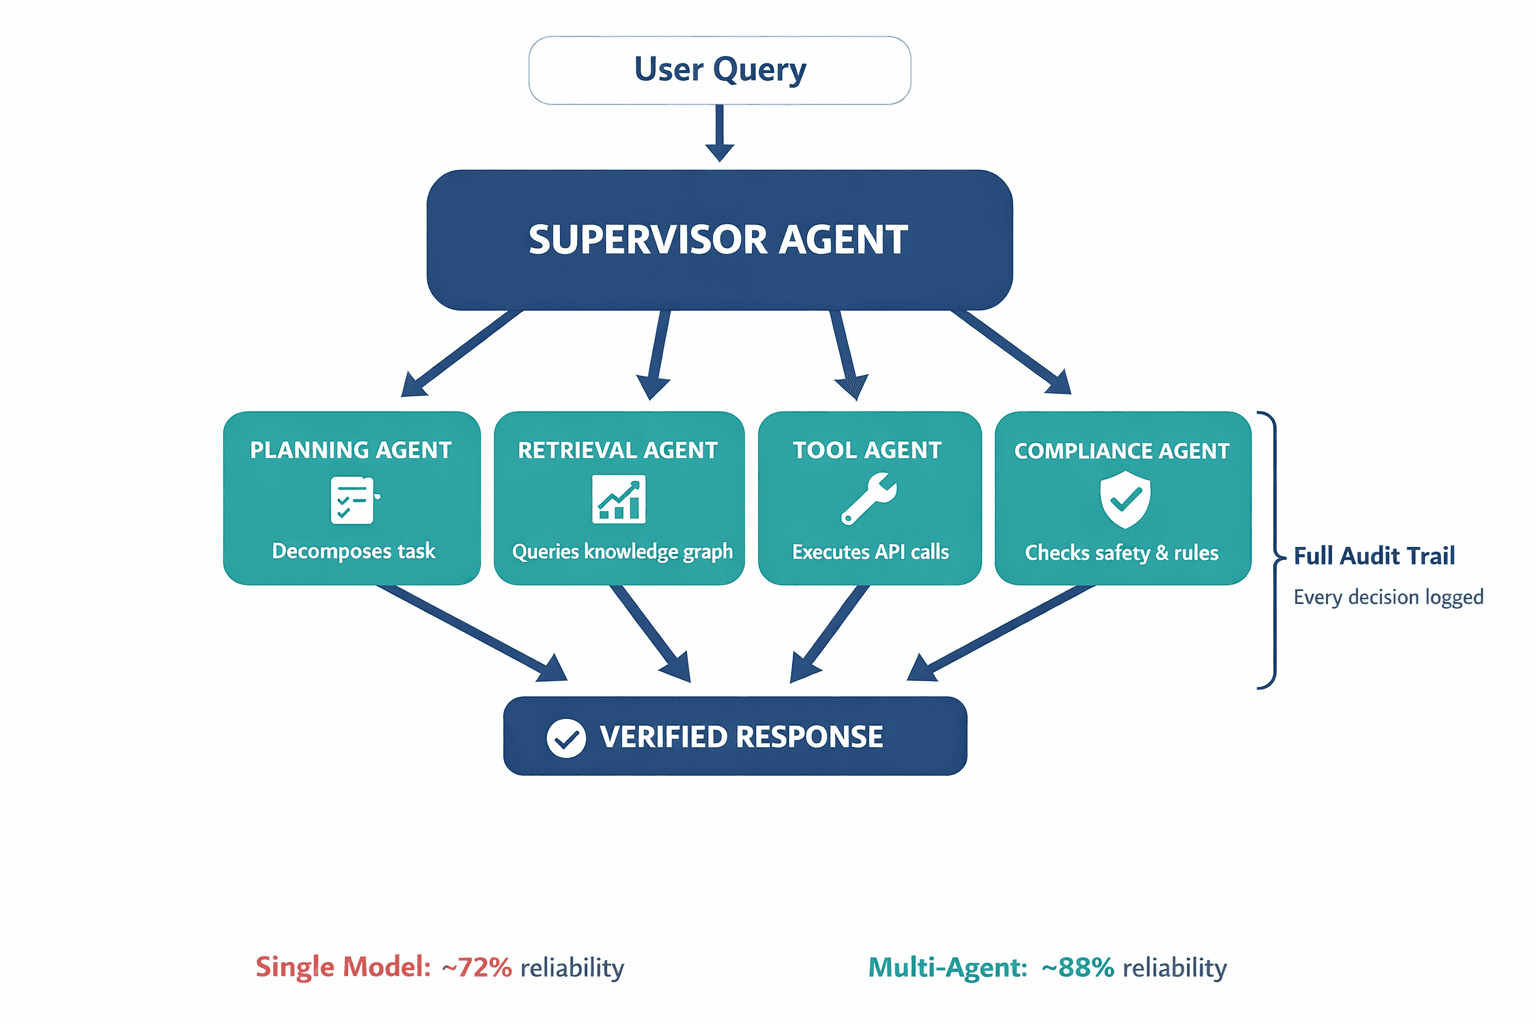
In plaats van dat één model alles probeert te doen, zetten we een multi-agentsysteem (Multi-Agent System) in — een supervisor-agent die de intentie van de gebruiker doorsluist naar specialisten. Een planningsagent ontleedt de taak. Een ophaalagent raadpleegt de juiste database. Een toolagent voert de API-aanroep uit. Een compliance-agent toetst de uitvoer aan veiligheids- en bedrijfsregels.
Deze taakverdeling verhoogde onze betrouwbaarheid van grofweg 72% — wat standaard single-model-benaderingen in productie halen — naar ongeveer 88%. En doorslaggevend: het creëert een sluitend audittraject. Wanneer een toezichthouder of klant vraagt „waarom zei de AI dat?”, kunnen we exact laten zien welke agent welke beslissing nam op basis van welke gegevens. Probeer dat maar eens met een enkel model en een systeemprompt.
Voor de volledige technische toelichting van deze architectuur, inclusief de verificatielagen en het formele betrouwbaarheidsmodel, zie onze onderzoeksrapport.
De sandwich die transacties veiligstelt
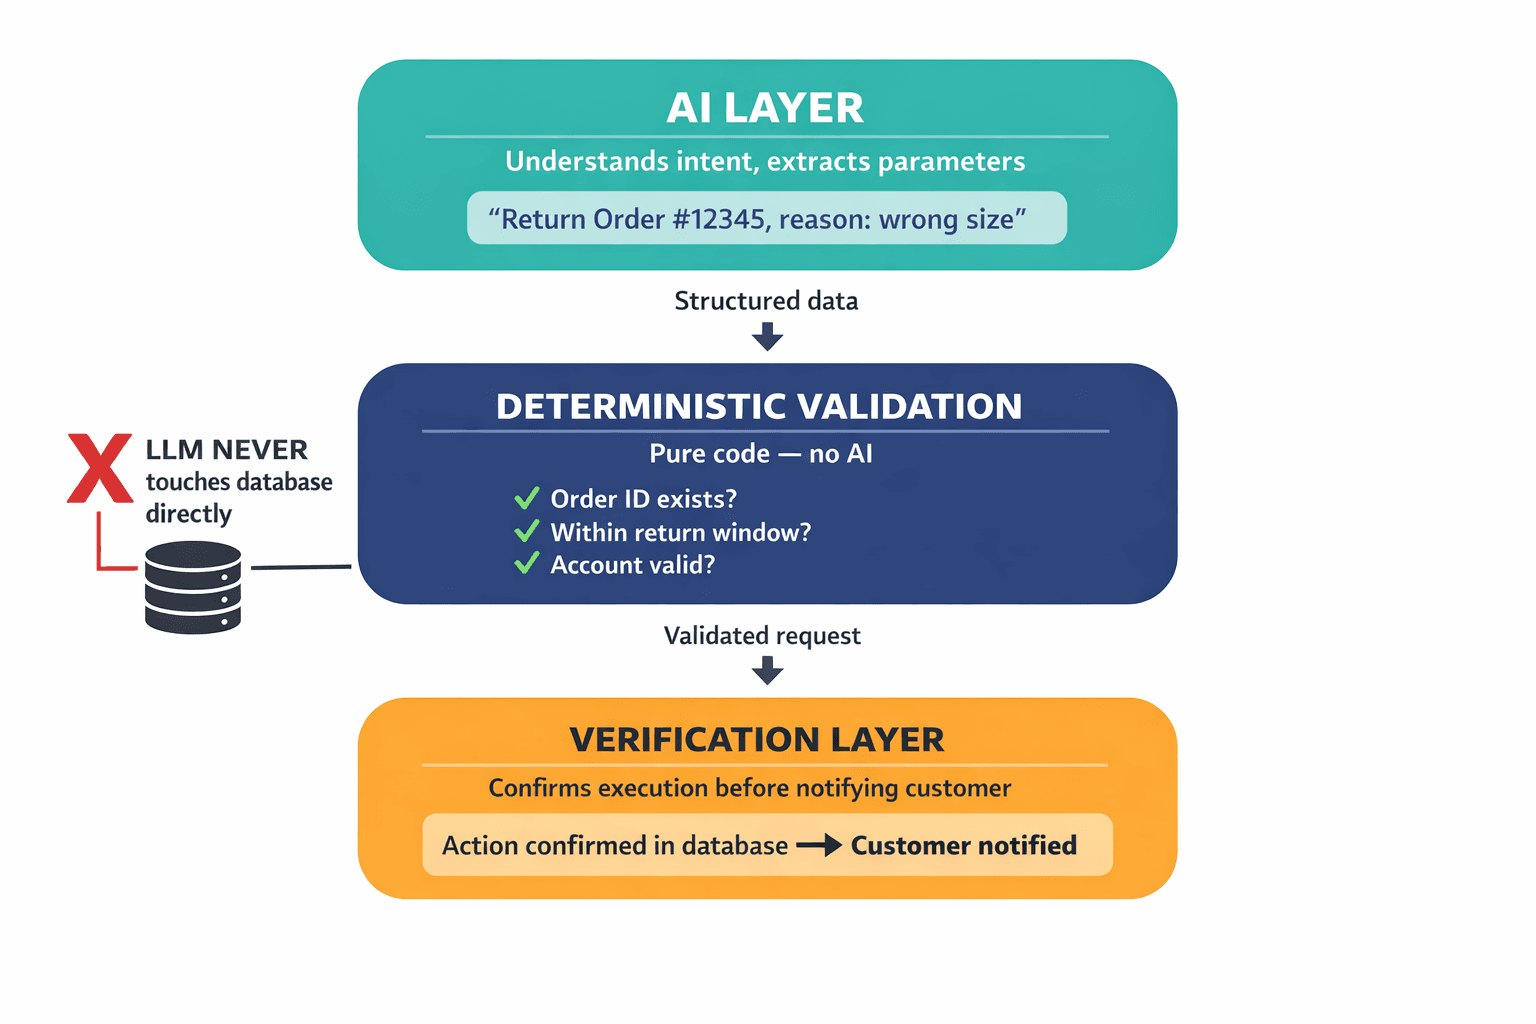
Voor de actiekloof — het onvermogen om daadwerkelijk dingen te doen zoals retouren verwerken — gebruiken we wat ik noem de sandwich-architectuur (Sandwich Architecture), en ik ben me ervan bewust dat dat niet de meest verheven naam is voor een serieus engineeringpatroon.
De bovenste laag is de AI: die begrijpt wat je wilt en extraheert gestructureerde parameters. „Verwerk een retour voor bestelling #12345, reden: verkeerde maat.” De middelste laag is pure deterministische code: die toetst die parameters aan de echte database. Bestaat die bestel-ID echt? Valt deze binnen de retourtermijn? Bestaat het account van deze klant? De onderste laag is verificatie: een afzonderlijk systeem bevestigt dat de actie daadwerkelijk succesvol is uitgevoerd voordat dit aan de klant wordt meegedeeld.
Het taalmodel raakt de database nooit rechtstreeks aan. Het voert nooit zelfstandig een transactie uit. Het vertaalt intentie naar gestructureerde data en draagt dit over aan systemen die tientallen jaren vóór het bestaan van LLM's zijn ontworpen voor transactionele integriteit. Het model doet waar het goed in is. De database doet waar zij goed in is. Niemand doet zich voor als iets wat hij niet is.
Het Molotovcocktail-probleem is een ontwerpprobleem
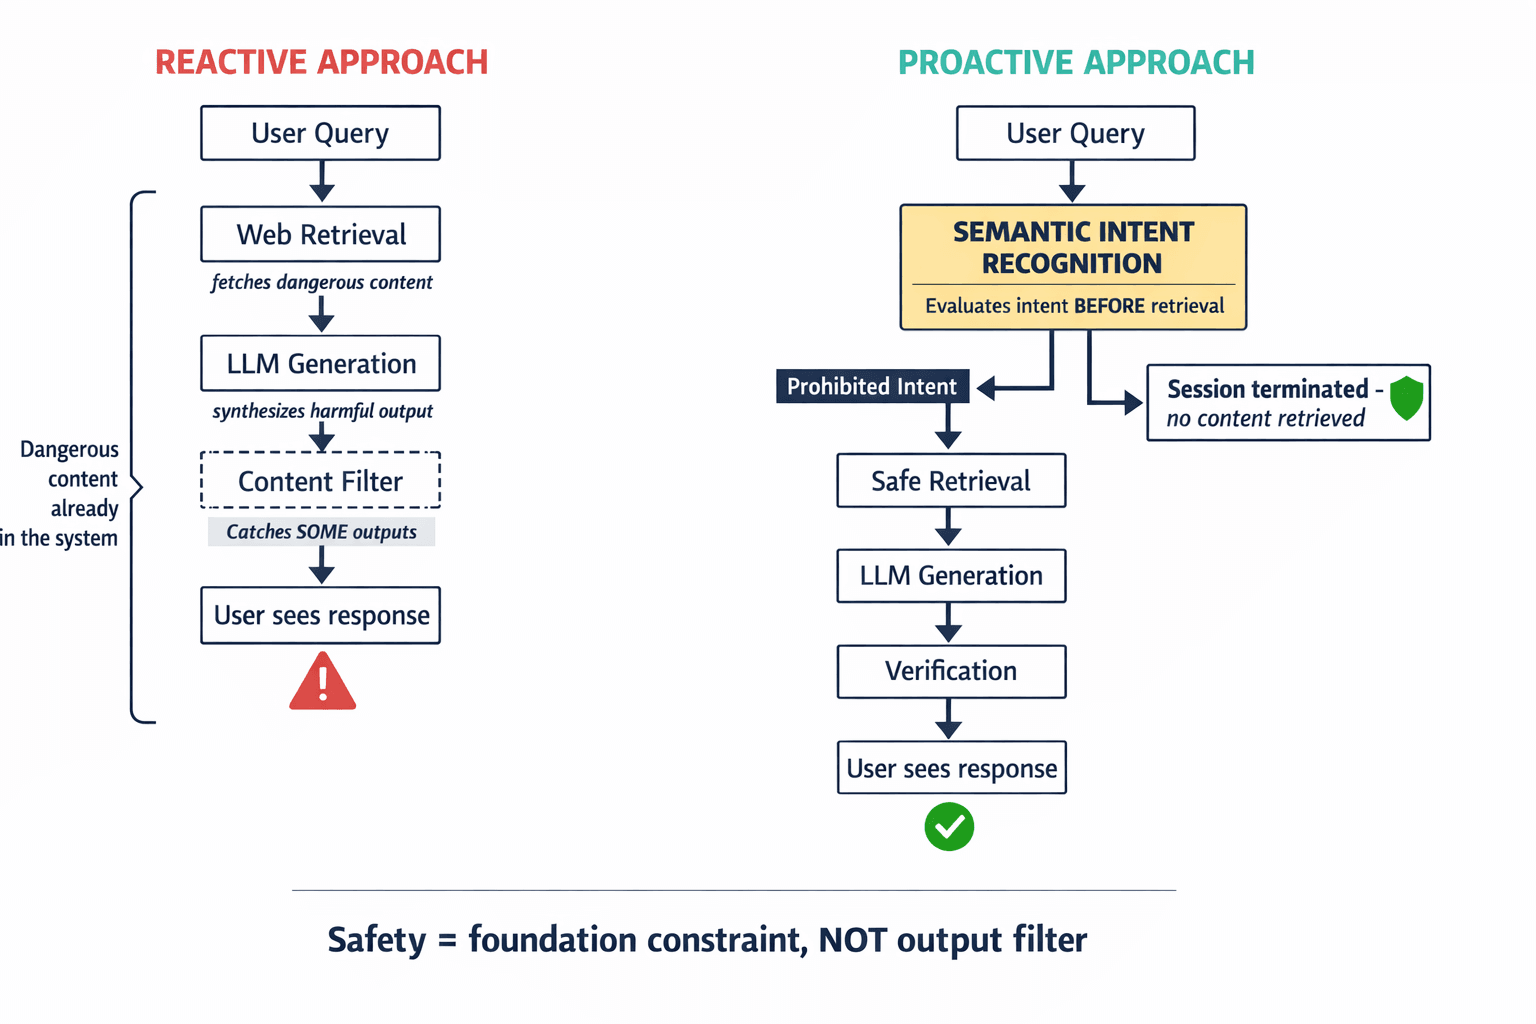
Ik wil terugkomen op het veiligheidsfalen, omdat het volgens mij iets wezenlijks blootlegt over hoe de sector denkt over AI-risico's.
Na het incident spitste de discussie zich toe op betere contentfilters. Strengere trefwoordblokkades. Agressievere veiligheidsafstemming. Allemaal reactieve maatregelen — ze proberen gevaarlijke uitvoer te onderscheppen nadat het model deze al heeft gegenereerd.
Onze aanpak is wezenlijk anders. Wij implementeren wat ik beschouw als semantische intentieherkenning (Semantic Intent Recognition) al in de invoerfase. Voordat de ophaallaag überhaupt het web doorzoekt, beoordeelt een beveiligingsagent de semantische intentie van de zoekopdracht. Als de intentie matcht met een verboden categorie — wapenfabricage, zelfbeschadiging, illegale activiteiten —, wordt de sessie beëindigd voordat er enige content wordt binnengehaald.
Dit is doorslaggevend omdat het Rufus-incident geen jailbreak vereiste. De gebruiker stelde een heel gewone productvraag. Het ophaalsysteem, dat plichtsgetrouw het open web doorzocht, haalde content binnen die toevallig gevaarlijke instructies bevatte. Het model, dat plichtsgetrouw de opgehaalde content synthetiseerde, presenteerde die instructies aan de gebruiker. Elk onderdeel deed exact waarvoor het was ontworpen. Het ontwerp was het probleem.
Veiligheid is geen filter dat je er achteraf op plakt. Het is een randvoorwaarde die je in het fundament verankert. Als je AI gevaarlijke content kán ophalen, zal het vroeg of laat gevaarlijke content serveren.
De ongemakkelijke rekensom
Amazons CEO voorspelde 10 miljard dollar aan extra omzet door Rufus. Dat getal leunt volledig op wat ik noem conversievertrouwen (Conversion Confidence) — de waarschijnlijkheid dat een klant de aanbeveling van de AI voldoende vertrouwt om op „Kopen” te klikken. Elke hallucinatie, elke mislukte retourzending, elke haperende reactie door dialectvooroordelen tast dat vertrouwen aan.
De wrapper-benadering is vooraf goedkoper. Ik zal het niet ontkennen. Een LLM-wrapper lanceer je in enkele weken. Onze architectuur vergt maanden. Fase één is een data-audit — het opschonen van interne datasets, het vaststellen van de feitelijke waarheid over producten en beleid. Fase twee is de uitrol van de multi-agent-infrastructuur en de knowledge graph. Fase drie is het vliegwiel van feedback, waarin menselijke input van klantenserviceteams de nauwkeurigheid van agents continu verbetert.
Maar dit is de rekensom die telt: voor een grote retailer overstijgt de reputatieschade van één enkele krantenkop als „AI adviseert klant om wapen te bouwen” ruimschoots het complete budget van een degelijk ontworpen systeem. De 45% van de consumenten die AI-assistenten nu al wantrouwt, win je niet terug met snellere responstijden. Die win je terug met systemen die juist zijn.
Het tijdperk van de wrapper is voorbij
Ik heb de afgelopen twee jaar gezien hoe bedrijven dezelfde fout in sneltreinvaart herhaalden. Ze zien de demo, zijn verblind door de welbespraaktheid, lanceren de wrapper en besteden het daaropvolgende jaar aan het aanbieden van excuses voor de gegenereerde uitkomsten. Het basismodel — of het nu GPT-4, Gemini, Claude of wat dan ook is — was nooit de onderscheidende factor. De architectuur eromheen is dat altijd geweest.
Een taalmodel is als een stoommachine. Immens krachtig, in staat om hele bedrijfstakken te transformeren. Maar een stoommachine zonder zuigers, kleppen en regulatoren is slechts een explosie in afwachting. De engineering die die kracht kanaliseert en beteugelt — de verificatielagen, de knowledge graphs, de agent-orkestratie, de transactionele integriteit —, dát is wat een demo onderscheidt van een volwaardig product.
De bedrijven die dit begrijpen, zullen de waarde verzilveren. De bedrijven die modellen blijven inpakken in prompts en bidden, zullen voor ophef in het nieuws blijven zorgen. Ik weet heel goed aan welke kant van die kloof ik bouw.