Een lagere firmware-risicoschatting is geen vrijgavepermissie

Een firmware-hotfix kan een risicoschatting aanzienlijk verbeteren en een release toch onaanvaardbaar laten onder het verklaarde beleid. Voor een engineeringteam dat beslist of een meterpark moet worden bijgewerkt, zijn dat verschillende beoordelingen. De verbetering vertelt iets over de kandidaat. Toestemming hangt af van het resterende risico, de beoordeelde populatie en het bewijs achter de schatting.
Ik heb MeterGuard gebouwd om die oordelen zichtbaar te houden. Het is een pre-flight-demo voor firmware-uitrol met behulp van synthetische meterpopulaties en synthetische firmware-manifesten. Het schat gedrag op basis van een changelog, modelleert dat gedrag tegen de gezondheid van het meterpark en geeft een lokale aanbeveling af. Het stuurt geen firmware naar meters en blokkeert geen daadwerkelijke update. De nuttige vraag is wat een release-eigenaar door deze scheiding kan inspecteren en wat het nog steeds niet kan vaststellen.
Verbetering en aanvaardbaarheid beantwoorden verschillende vragen
Beschouw de synthetische populatie met het label Plano Water. Een initiële kandidaat levert een gemodelleerd gemiddeld storingspercentage op van 74.22% van de beoordeelde eindpunten. Een hotfix levert 2.85% op. Beide resultaten maken gebruik van gecachte modelondersteunde gedragsprofielen, in plaats van gemeten gedrag uit firmware-binaries. Binnen die aannames is de hotfix een aanzienlijke verbetering. Die vergelijking is het bewaren waard, zelfs wanneer de uiteindelijke aanbeveling NO-GO blijft.
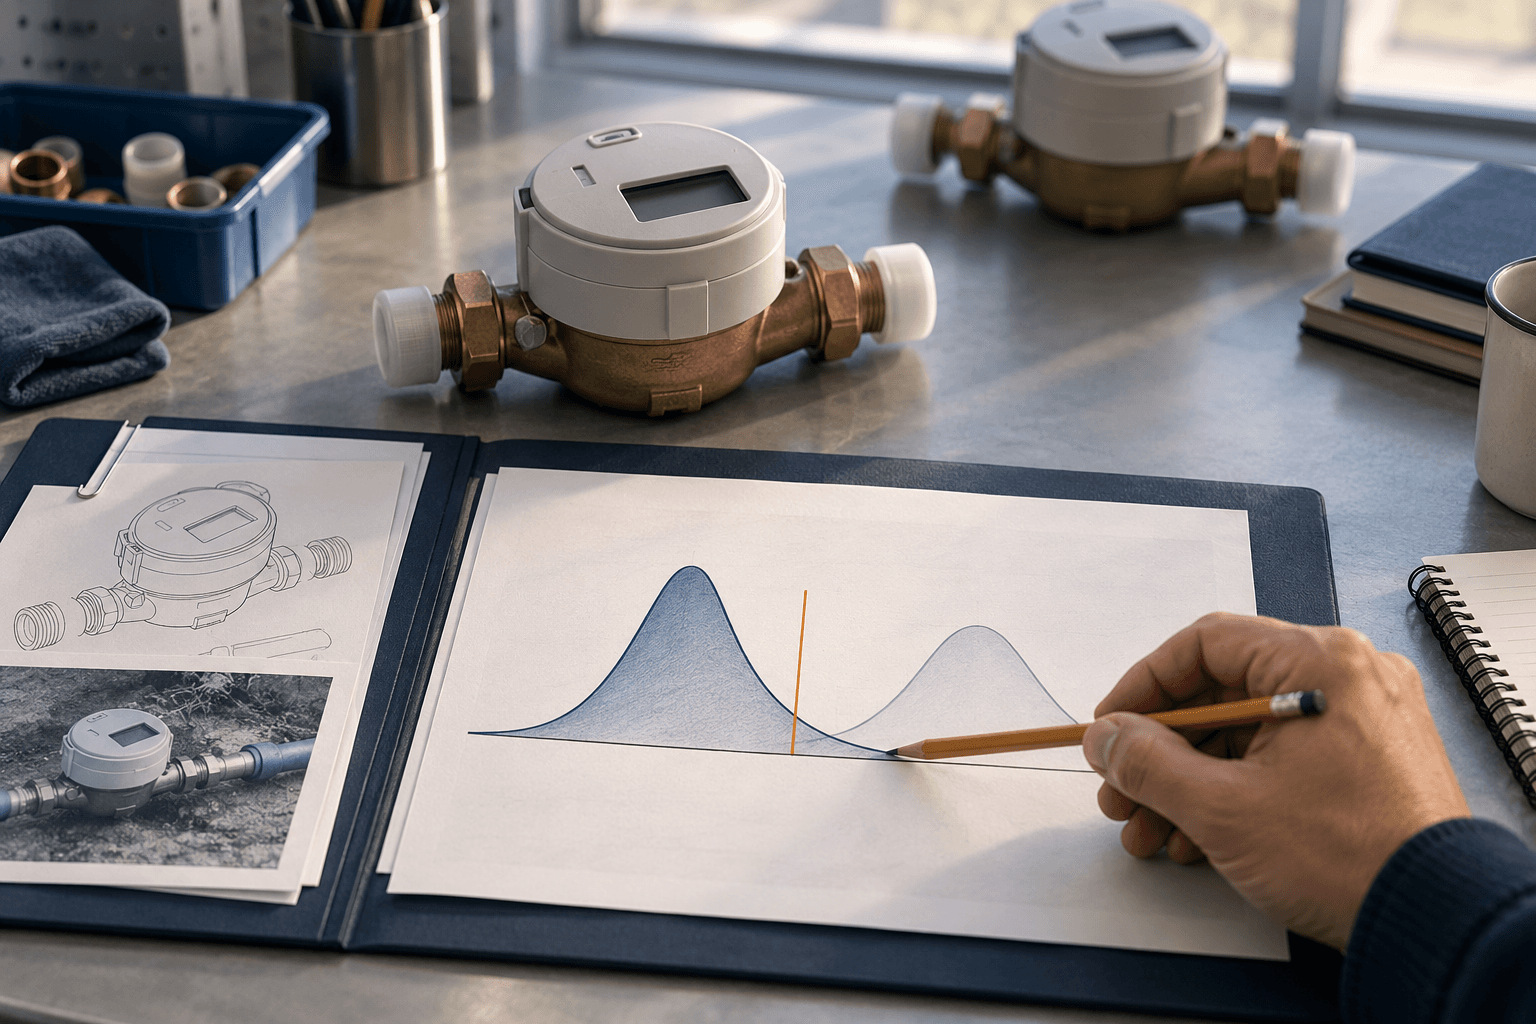
De release-gate controleert eerst de bovenkant van het gemodelleerde 90%-interval. Bij of boven 3.0% van de beoordeelde eindpunten retourneert het NO-GO. Voor de hotfix is het gemiddelde 2,449 gemodelleerde fouten onder 86,078 beoordeelde eindpunten, met een interval van 1,536 tot 3,531. Het bovenste percentage is 4.10%, waardoor de regel voor harde blokkering van toepassing is. Nog eens 1,922 eindpunten ontberen voldoende telemetrie en zijn uitgesloten van die voorspelling, waarbij handmatige beoordeling wordt aanbevolen.
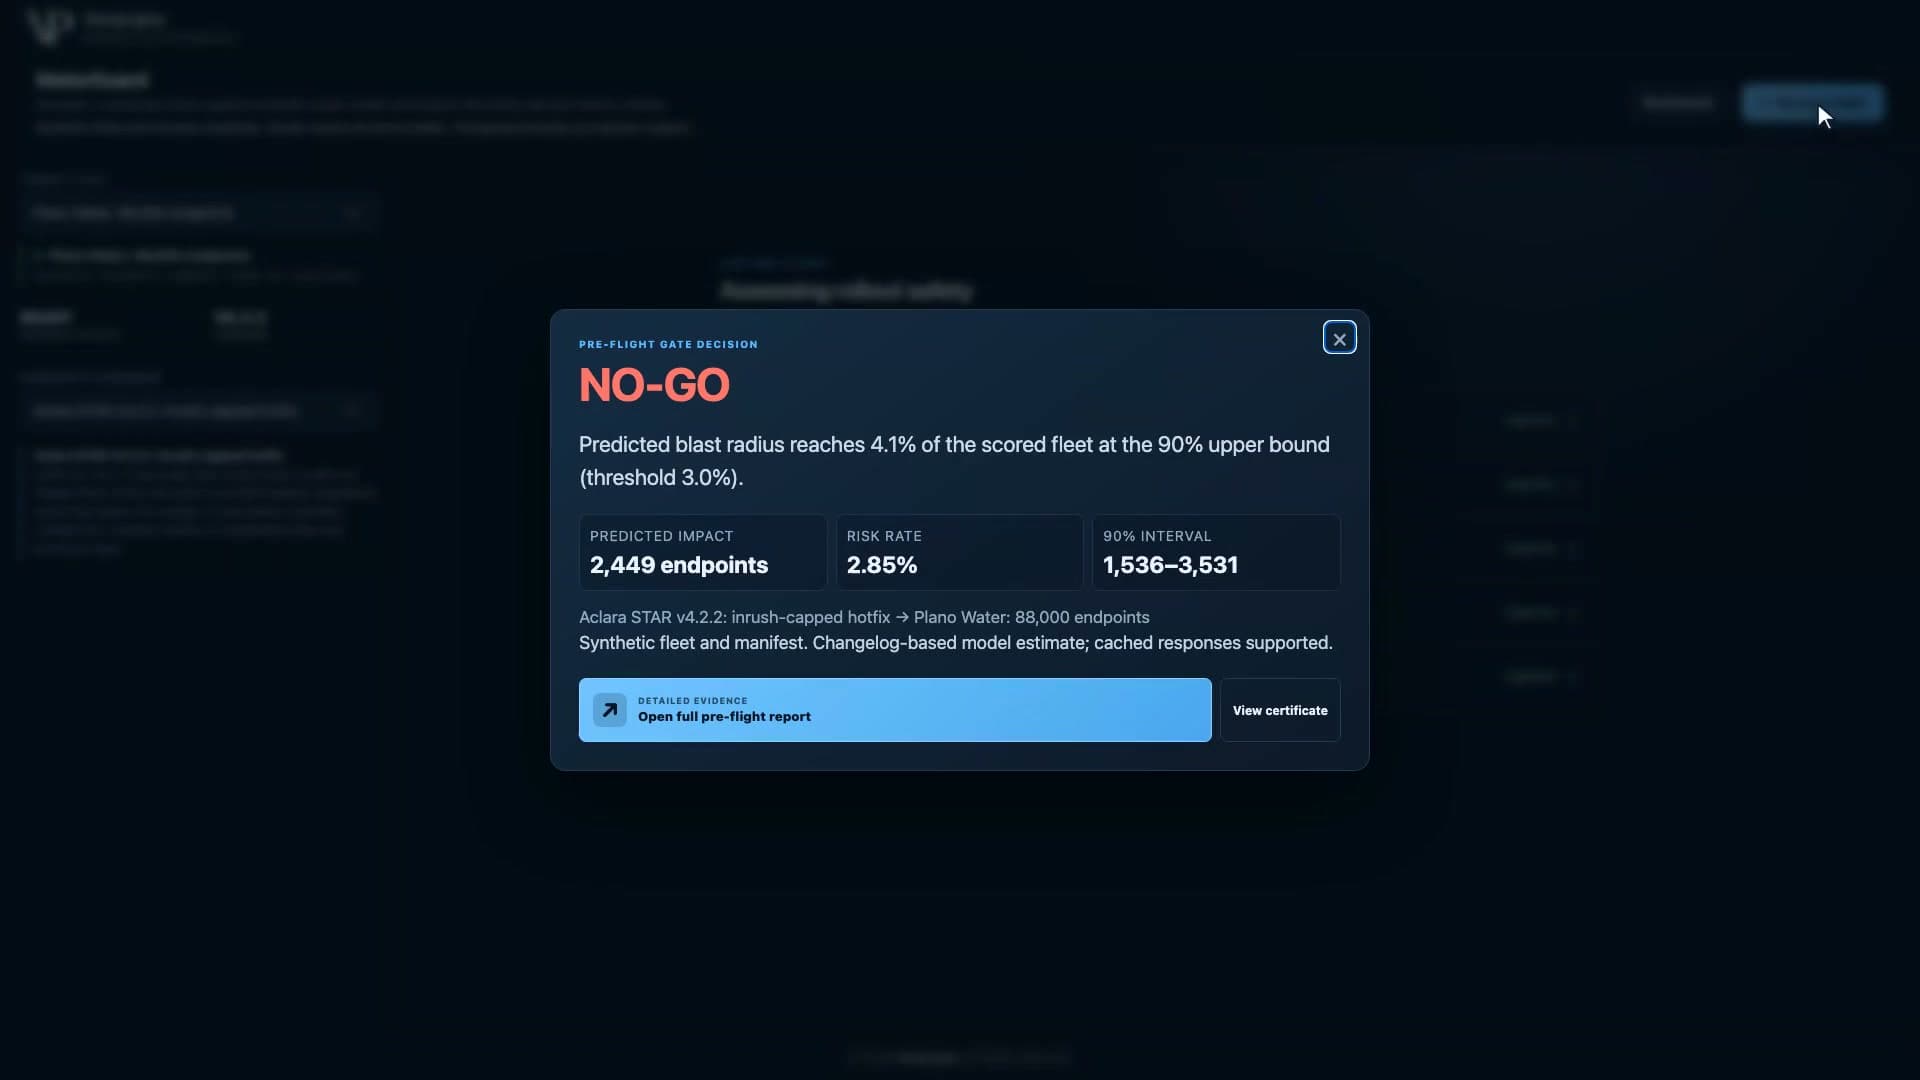
Een lezing op basis van uitsluitend het gemiddelde zou missen waarom dit een harde blokkade is. Het zou de kandidaat onder de rest van het beleid evenmin in aanmerking laten komen voor GO: GO vereist een gemiddelde op of onder 0.5%, na het doorstaan van de bovengrens- en betrouwbaarheidscontroles. Tussenliggend numeriek risico leidt tot STAGED-CANARY. Het onderscheid is belangrijk omdat 'beter', 'in aanmerking komend voor een beperkte stap voor bewijsgaring' en 'binnen de GO-regel' niet mogen samenvallen in één geruststellend label.
Ik houd de verbetering liever zichtbaar zonder toe te staan dat deze opnieuw over de grens onderhandelt. Als een team op een teleurstellende aanbeveling reageert door de drempel te versoepelen, heeft het zijn acceptatiebeleid gewijzigd. Dat kan in een specifieke context een verdedigbare beslissing zijn, maar het is een afzonderlijke beslissing die om eigen redenen vraagt. Het bewijs dat de ene kandidaat beter is dan de andere levert die redenen niet vanzelf.
Aan dit standpunt zijn kosten verbonden. Een conservatieve grens kan een kandidaat vertragen die geslaagd zou zijn. De bovenkant van een gemodelleerd interval is geen waargenomen veldresultaat, en het benoemen van het interval als '90%' bewijst niet de dekking ervan in een netwerkbedrijfsvloot. Deze demo kan niet bepalen welke drempel een echt nutsbedrijf moet hanteren. Wat het kan laten zien, is of een aanbeveling de drempel volgt die werd verklaard, in plaats van een drempel die stilletjes werd aangepast om bij het resultaat te passen.
Toestemming hoort bij een kandidaat en een populatie
Dezelfde gedragsschatting voor de hotfix levert een heel ander resultaat op voor de gegenereerde populatie met het label Hill Country Electric Co-op. Het gemodelleerde gemiddelde storingspercentage is 0.02%, met een bovenste intervalpercentage van 0.03%, en de gate retourneert GO voor 118,222 beoordeelde eindpunten. De populatie heeft een gezondere batterijverdeling en minder zwakke radiosignalen dan de synthetische Plano-populatie. De 1,778 uitgesloten eindpunten blijven buiten die aanbeveling.
Dit is een vergelijking van geschat schrijfgedrag over gegenereerde gezondheidsverdelingen. Het zegt niets over het installeren van de image van de ene fabrikant op de hardware van een andere fabrikant. Compatibiliteit en uit binaire bestanden afgeleide validatie zijn afzonderlijke werkzaamheden die de demo niet uitvoert.
De vergelijking verandert hoe ik wil dat een release-aanbeveling wordt uitgedrukt. 'Deze firmware heeft een laag risico' laat de reikwijdte onbenoemd. 'Dit geschatte gedrag voldoet aan dit beleid op deze beoordeelde populatie' behoudt de voorwaarden waaronder het resultaat standhoudt. Batterijconditie en radioherstel zijn invoergegevens voor de gemodelleerde uitkomst, dus een gunstig resultaat kan daar niet van worden losgekoppeld en naar een ander meterpark worden overgedragen.
Voor een release-eigenaar creëert dit twee verschillende manieren om te reageren op een ongunstige aanbeveling. De ene is het verbeteren van het gedrag van de kandidaat of het bewijsmateriaal dat is gebruikt om het te schatten. Een andere is het overwegen van een nauwere populatie waarvan de omstandigheden een andere beoordeling ondersteunen. Ze beantwoorden verschillende problemen. Een nauwere beoordeling kan de gemodelleerde blootstelling verminderen, maar laat de rest van de populatie onopgelost. Beter bewijs over de kandidaat kan de schatting verbeteren, maar kan ontbrekende vloot-telemetrie niet tevoorschijn toveren.
Die alternatieven zijn toekomstgerichte engineeringkeuzes, geen bewerkingen die deze demo uitvoert. Hun waarde is dat ze het werk richten op de bron van de onzekerheid. Het oordeel alleen kan een team niet vertellen of het een betere kandidaat, een beter profiel of betere informatie over de beoogde ontvangers nodig heeft. De invoergegevens en uitsluitingen daarnaast kunnen dat wel.
Een codegate kan niet valideren wat het model gelooft
MeterGuard houdt het beleid in duidelijke code. De modelondersteunde governancenotitie komt na het oordeel en heeft geen directe bevoegdheid om dit te overrulen. Ik wil die scheiding omdat een welbespraakte uitleg niet stilletjes een nieuwe release-regel mag worden.
Het model behoudt eerder in de workflow een aanzienlijke invloed. Het firmwareprofiel schat stroomverbruik, herstel na reset en flash-schrijfgedrag op basis van synthetische changelogtekst. Die schattingen voeden de simulator. Een ander profiel kan de gemodelleerde storingen veranderen en daardoor het eindoordeel wijzigen, zelfs als de gatecode nooit verandert. Inspecteerbaar beleid stelt vast hoe invoergegevens werden beoordeeld; het bewijst niet dat de invoer correct was.
Het geval met een beknopte changelog maakt het onderscheid zichtbaar. Tegenover dezelfde gegenereerde coöperatiepopulatie is het gemodelleerde gemiddelde slechts 0.05% en het bovenste percentage 0.06%. Die cijfers blijven binnen de numerieke grenzen. Het profiel heeft desalniettemin een lage betrouwbaarheid, waardoor de gate STAGED-CANARY aanbeveelt in plaats van GO. Schaarste aan firmwarebewijs wordt behandeld als een onafhankelijke reden om de bredere aanbeveling in te houden.
Dat is een nuttige beveiliging, met een eigen beperking. Het betrouwbaarheidslabel van een model is geen gekalibreerde empirische zekerheid. Het vereisen van een niet-laag label kan voorkomen dat een erkende bewijskloof wordt genegeerd; het kan een 'hoog' label niet certificeren als accuraat. Voor gebruik in productie zou het profiel validatie vereisen tegen daadwerkelijk firmwaregedrag en reële uitkomsten. Dit blijft werk buiten de synthetische demonstratie.
De veiligste steekproef laat een moeilijkere vraag achter
De voorgestelde gefaseerde route gebruikt 500 eindpunten uit het cohort met het laagste gemodelleerde risico, met een wachttijd van 72 uur en herevaluatie met behulp van waargenomen telemetrie alvorens uit te breiden. De demo beveelt dit plan aan; het heeft geen canary uitgevoerd of waarnemingen verzameld. Het geconfigureerde uitbreidingscriterium is een waargenomen uitvalpercentage onder 0.1%.
Ik zie een reële afweging in het eerst kiezen van het veiligste cohort. Het vermindert de blootstelling die voor de eerste stap wordt voorgesteld. Maar dezelfde logica die de toestand van het meterpark van belang maakte, beperkt ook wat die stap zou kunnen vaststellen over eindpunten in slechtere staat. In een hypothetische campagne zou het waarnemen van een succesvolle update op gezonde batterijen en goede radioverbindingen een claim over die geteste steekproef ondersteunen. Het zou openlaten hoe de kandidaat zich gedraagt op verouderde batterijen of zwakke radioverbindingen.
Er zijn ten minste twee verdedigbare reacties op die kloof. Een team zou de uitbreiding kunnen beperken tot populaties die voldoende vergelijkbaar zijn met de waargenomen steekproef, waarbij een tragere dekking wordt geaccepteerd en verslechterde eindpunten in afwachting blijven. Of het zou bewijs kunnen zoeken dat gericht is op de verslechterde omstandigheden, zoals gecontroleerde validatie van het relevante batterij- en herstelgedrag, alvorens die eindpunten in aanmerking te nemen. Het tweede pad vraagt meer werk; het eerste accepteert een beperktere conclusie. Geen van beide maakt een veilige steekproef per decreet representatief.
Daarom behandel ik STAGED-CANARY als een verzoek om gespecificeerd bewijs, niet als een zachter synoniem voor GO. Een gefaseerd plan moet vermelden wat zijn waarnemingen zullen rechtvaardigen en waar ze stoppen. Zonder die reikwijdte kan een voorzichtig ogend proces nog steeds een te brede conclusie opleveren.
Hier is de toelichting van de oprichter over deze slimme-meter-releasebeslissingen in MeterGuard.
De MeterGuard-uitleg toont de pre-flight-workflow en de bijbehorende besluitvormingsdossiers. Mijn ontwerpstandpunt is om het geschatte gedrag, de beoordeelde populatie, uitsluitingen en de verklaarde regel naast de aanbeveling te houden. Voor een release-eigenaar is de test of de volgende voorgestelde stap de onzekerheid wegneemt die de pauze veroorzaakte. Als het alleen de gemakkelijkste omstandigheden observeert terwijl de beslissing moeilijkere betreft, wacht de grens nog steeds op bewijs.