固件风险估计值的降低并不等同于发布准许

固件热修复可能使风险估计值显著改善,但在已声明的策略下,该发布版本可能依然不被接受。对于决定是否更新智能电表机群的工程团队而言,这是两种截然不同的判定。改善说明了候选版本本身的某些特性;而准许发布则取决于剩余风险、受评估的母体以及估计背后的证据。
我围绕保持这些判定的可见性构建了MeterGuard。这是一个使用合成电表母体和合成固件清单的固件发布预检演示。它根据变更日志估计行为,对照机群健康状况对该行为进行建模,并发布本地建议。它既不会向电表发送固件,也不会拦截实际更新。真正有价值的问题在于,这种分离能让发布负责人审查什么,以及它依然无法确立什么。
改善与可接受性回答的是不同的问题
以标有Plano Water的合成母体为例。初始候选版本在受评分端点中产生的建模平均故障率为74.22%。热修复版本则为2.85%。两项结果均使用缓存的模型辅助行为配置文件,而非从固件二进制文件中实测的行为。在这些假设前提下,该热修复是一项实质性的改进。即使最终的建议依然是NO-GO,这一对比也值得保留。
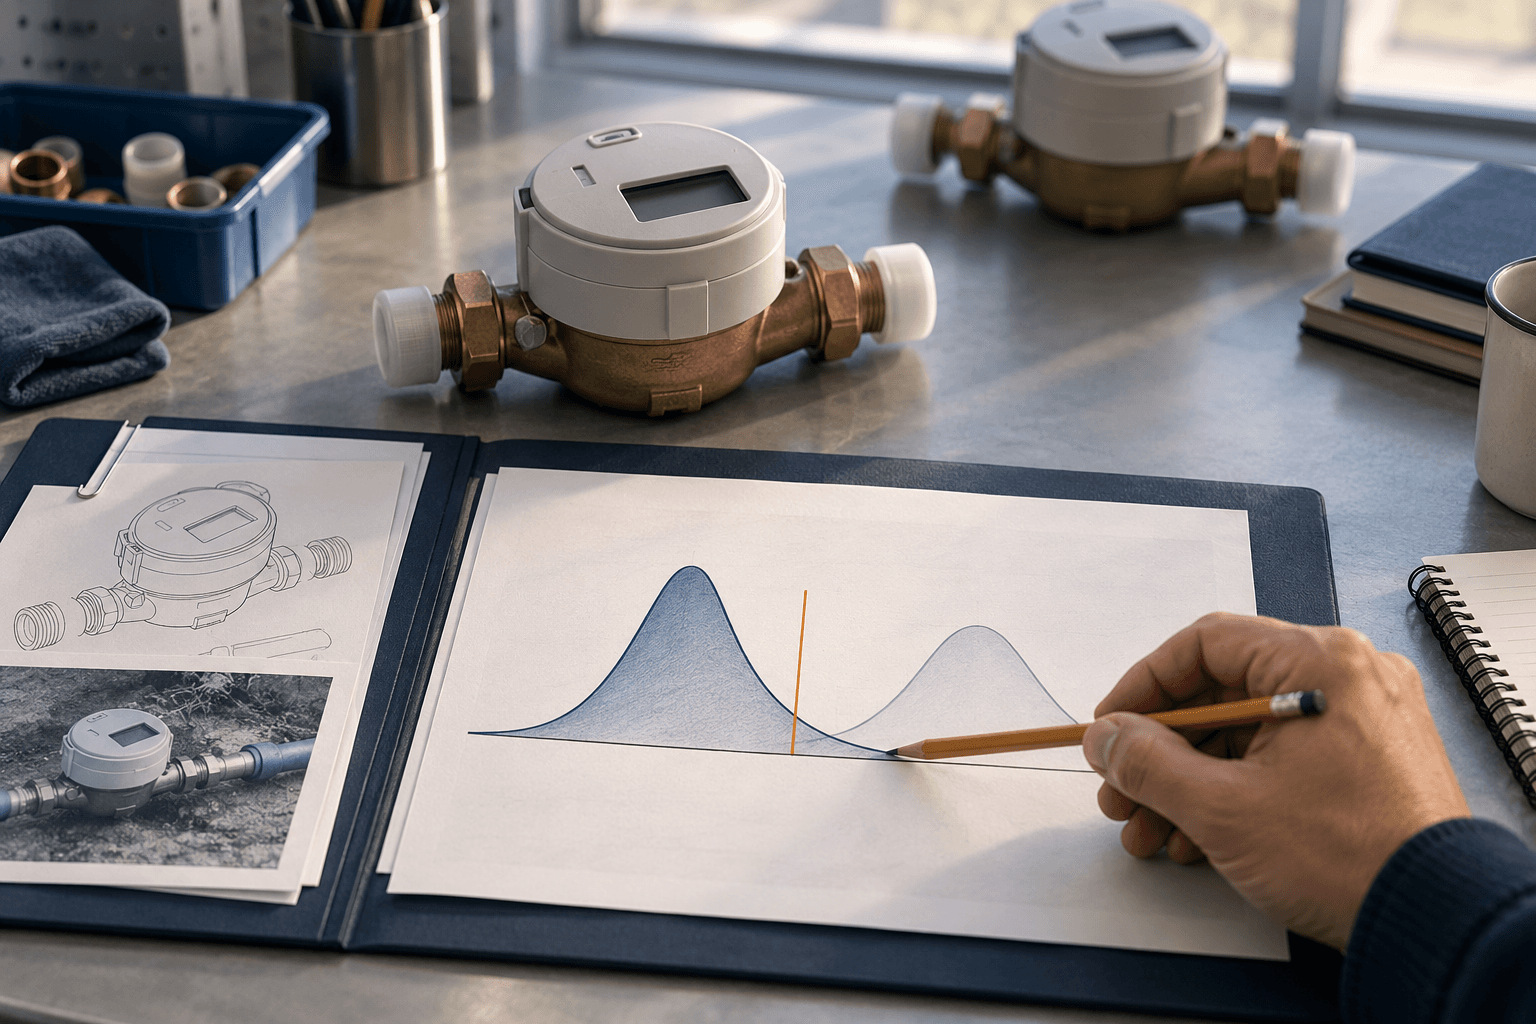
发布门首先检查90%建模区间的上限。若达到或超过受评分端点的3.0%,则返回NO-GO。对于该热修复版本,在86,078个受评分端点中,建模故障平均值为2,449个,区间范围为1,536至3,531个。上限比率为4.10%,因此适用硬性阻断规则。另有1,922个端点因缺乏足够的遥测数据而从该预测中排除,并建议进行人工复核。
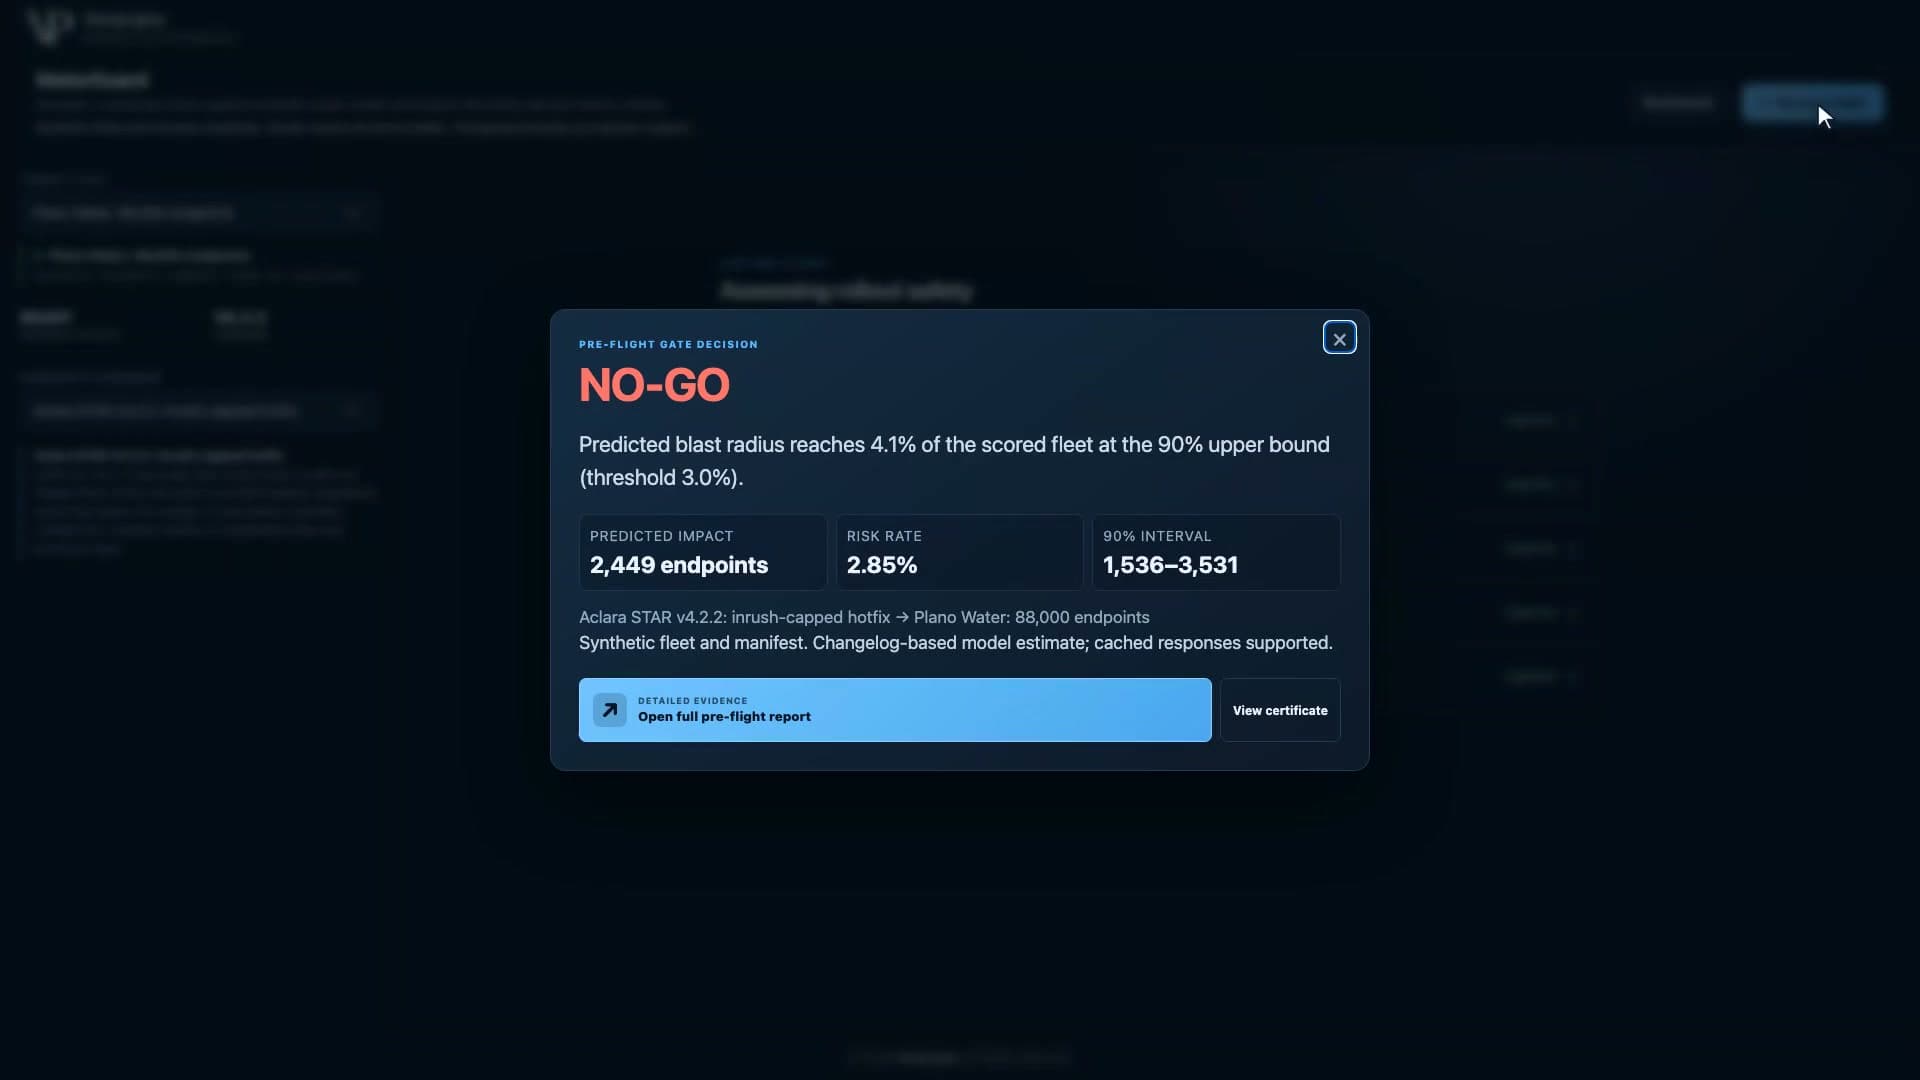
仅看平均值的解读会忽略为何这是一个硬性阻断。根据策略的其他部分,该候选版本同样不符合GO的条件:GO要求在通过上限和置信度检查后,平均值必须达到或低于0.5%。居中的数值风险则导向STAGED-CANARY。这种区分至关重要,因为“更好”、“符合有限证据收集步骤的资格”以及“处于GO规则之内”绝不应混为一谈并简化为一个令人安心的标签。
我倾向于保持改善情况的可见性,但不允许其重新协商既定边界。如果团队在面对令人失望的建议时通过放宽阈值来应对,那就意味着它已经改变了验收策略。在特定环境下,这或许是一个站得住脚的决定,但它是一个需要独立理由的独立决定。证明一个候选版本优于另一个候选版本的证据本身并不能提供这些理由。
这种立场是有代价的。保守的边界可能会推迟一个本可以成功的候选版本。建模区间的上限并不是实际观察到的现场结果,将区间称为“90%”并不能确立其在公用事业机群中的覆盖率。本演示无法确定真正的公用事业公司应当采用何种阈值。它所能展示的是,一项建议究竟是遵循了此前声明的阈值,还是遵循了为了迎合结果而悄然调整的阈值。
准许同时归属于候选版本与母体
同样的微调热修复行为估计值,在针对标有Hill Country Electric Co-op的生成母体时,得出了截然不同的结果。其建模平均故障率为0.02%,上限区间率为0.03%,校验门针对118,222个受评分端点返回了GO。与合成Plano母体相比,该母体拥有更健康的电池分布和更少的弱无线电信号。其1,778个被排除的端点依然处于该建议之外。
这是对跨生成健康度分布的估计写入行为的比对。它完全不涉及将一家制造商的固件镜像安装在另一家制造商的硬件上。兼容性以及基于二进制文件的验证是演示原型未执行的独立工作。
这种对比改变了我对发布建议表达方式的要求。“此固件风险较低”未指明适用范围。“该估计行为在此受评分母体上符合此项策略”则保留了该结果得以成立的前提条件。电池状况和无线电恢复是建模结果的输入参数,因此良好的结果不能脱离这些参数并直接套用到另一个机群中。
对于发布负责人而言,这催生了应对不利建议的两种不同方式。其一是改进候选版本的行为或用于评估该行为的证据;其二是考虑条件足以支撑不同评估结论的更狭窄母体。这两种方式解决的是不同的问题。更狭窄的评估范围可能会降低建模暴露面,但会导致其余母体悬而未决。关于候选版本的更充分证据或许能优化估计,但绝无法凭空变出缺失的机群遥测数据。
这些替代方案是前瞻性的工程抉择,而非本演示所执行的操作。它们的价值在于将工作指引至不确定性的根源。单凭判定结果无法告诉团队究竟是需要更好的候选版本、更好的行为画像,还是需要关于目标接收对象的更完善信息;但与之并列的输入数据与排除项却能做到这一点。
代码校验门无法核实模型所深信的内容
MeterGuard将策略保留在纯代码中。模型辅助的治理备忘录生成于判定之后,无权直接推翻该判定。我之所以坚持这种分离,是因为流畅的解释绝不能悄然演变为新的发布规则。
模型在工作流前端仍具有重大影响。其固件配置文件根据合成变更日志文本估计电流消耗、复位后恢复以及闪存写入行为。这些估计值随后被送入模拟器。即使校验门代码从未改变,不同的配置文件也会改变建模故障数,进而改变判定结果。可检查的策略确立了输入是如何被评判的;它并不能证明输入本身是正确的。
变更日志内容单薄的案例使这种区别显现出来。在面对相同的生成Co-op母体时,其建模平均值仅为0.05%,上限率为0.06%。这些数值完全通过了数字边界。然而该配置文件携带了低置信度标签,因此校验门推荐了STAGED-CANARY而非GO。稀疏的固件证据被作为暂不给出广泛推荐的独立理由。
这是一项有益的防线,但也存在自身的局限。模型的置信度标签并非经过校准的经验确定性。要求非“低”标签可以防止某个公认的证据空白被忽视;但它无法证实“高”标签就一定准确。若要在生产环境中作为依据,该配置文件需要针对实际的固件行为与结果进行验证。这依然是超越该合成演示范围的工作。
最安全的样本留下了更棘手的疑问
提议的阶段性路线采用了来自最低建模风险群组的500个端点,设置了72小时的观察保持期,并在扩大范围之前使用观测到的遥测数据进行重新评估。演示原型推荐了该计划;但它并未执行金丝雀发布或收集其实际观察数据。配置的扩大准则是观测故障率低于0.1%。
我认为首先选择最安全群组存在实际的权衡。它减少了第一步提议的风险暴露面。但使机群状况变得重要的同一逻辑,也限制了该步骤对于处于较差状况的端点所能证明的结论。在一个假设的行动中,观察到在健康电池和良好无线电连接下的成功更新,可以支撑针对该测试样本的主张;但这对于候选版本在老化电池或微弱无线电连接下的表现如何,依然悬而未决。
面对这一鸿沟,至少有两种合理的应对方式。团队可以将扩大范围持续限制在与观察样本充分相似的母体上,接受较慢的覆盖进度,并将退化端点保持待定状态;或者,在考虑这些端点之前,去寻求针对退化条件的专门证据,例如对相关电池和恢复行为进行受控验证。第二条路径需要更多工作;第一条路径则接受了更狭窄的结论。但这两种方式都不能仅凭一纸声明就让安全样本具备代表性。
这正是我将STAGED-CANARY视作对特定证据的请求、而非GO的温和同义词的原因。阶段性计划需要明确其观察数据将证明什么以及在何处止步。若缺乏该范围界定,一个看似谨慎的流程依然可能得出过度泛化的结论。
以下是创始人关于MeterGuard中这些智能电表发布决策的演练介绍。
这份MeterGuard解析指南展示了预检工作流及其决策记录。我的设计理念是将估计行为、评分母体、排除对象和既定规则与推荐结果并列展示。对于发布负责人而言,检验的关键在于提议的下一步举措能否解决导致暂停的不确定性。如果它仅在最顺畅的工况下进行观察,而决策所关切的却是更严苛的条件,那么准入边界便依然处于等待证据的状态。