人工智能贷款推荐需要独立的发布规则

一项贷款推荐听起来可能合情合理,却同时违背了它本应遵循的贷款政策。我希望发布该项推荐的决定拥有独立且可审查的依据。如果解释与行动授权均来自同一模型答复,审查人员就必须在决定何种请求可以推进之前,先将二者艰难拆解。
架构设计的核心问题在于:当人工智能推荐未能通过校验时,究竟该采取何种措施。要求模型重新尝试或许能修复不完整的答复;但当推荐违背明确规则时,将其拦截扣留则是必不可少的举措。这是两种截然不同的干预手段,伴随着不同的系统成本。一条行之有效的边界能在任何一种处理方式沦为盲目习惯之前,让这种差异清晰可见。
合理的解释也可能支持错误的结果
在 Veriprajna 的 The Validation Firewall 中,保留的模型输出对一位信用评分仅为 559 分的合成贷款申请人给出了批准建议。而系统配置的贷款政策明确要求至少达到 620 分。该推荐同时未能满足政策中关于债务收入比(debt-to-income)、贷款价值比(loan-to-value)以及近期逾期记录的准入标准。
这些均是基于合成档案缓存的模型答复,在不进行全新推理的情况下直接通过各项检查重放。它们展示了该示例的具体行为,并非模型准确率基准测试,亦非来自真实借款机构客户的数据凭据。整个借贷工作流与流转路径均为模拟环境。
模型的解释十分发人深省。它声称所提供的政策未能提供拒贷所需的允许主因键名。这揭示了一个真实的输入契约局限:演示中的模型提示词虽提供了信用标准,却漏掉了它要求模型使用的许可原因清单。模型的答复理应在这一背景下被客观看待。它不能作为对不同模型进行优劣排名的公允依据。
然而,这绝不意味着该批准与已编码的信用准则达成了一致。缺少用于解释拒贷的提示指令,既改变不了申请人的信用评分,也降低不了政策设立的底线要求。答复完全可以准确识别出一个问题,却依然推荐一个违反另一项关键指标的结果。
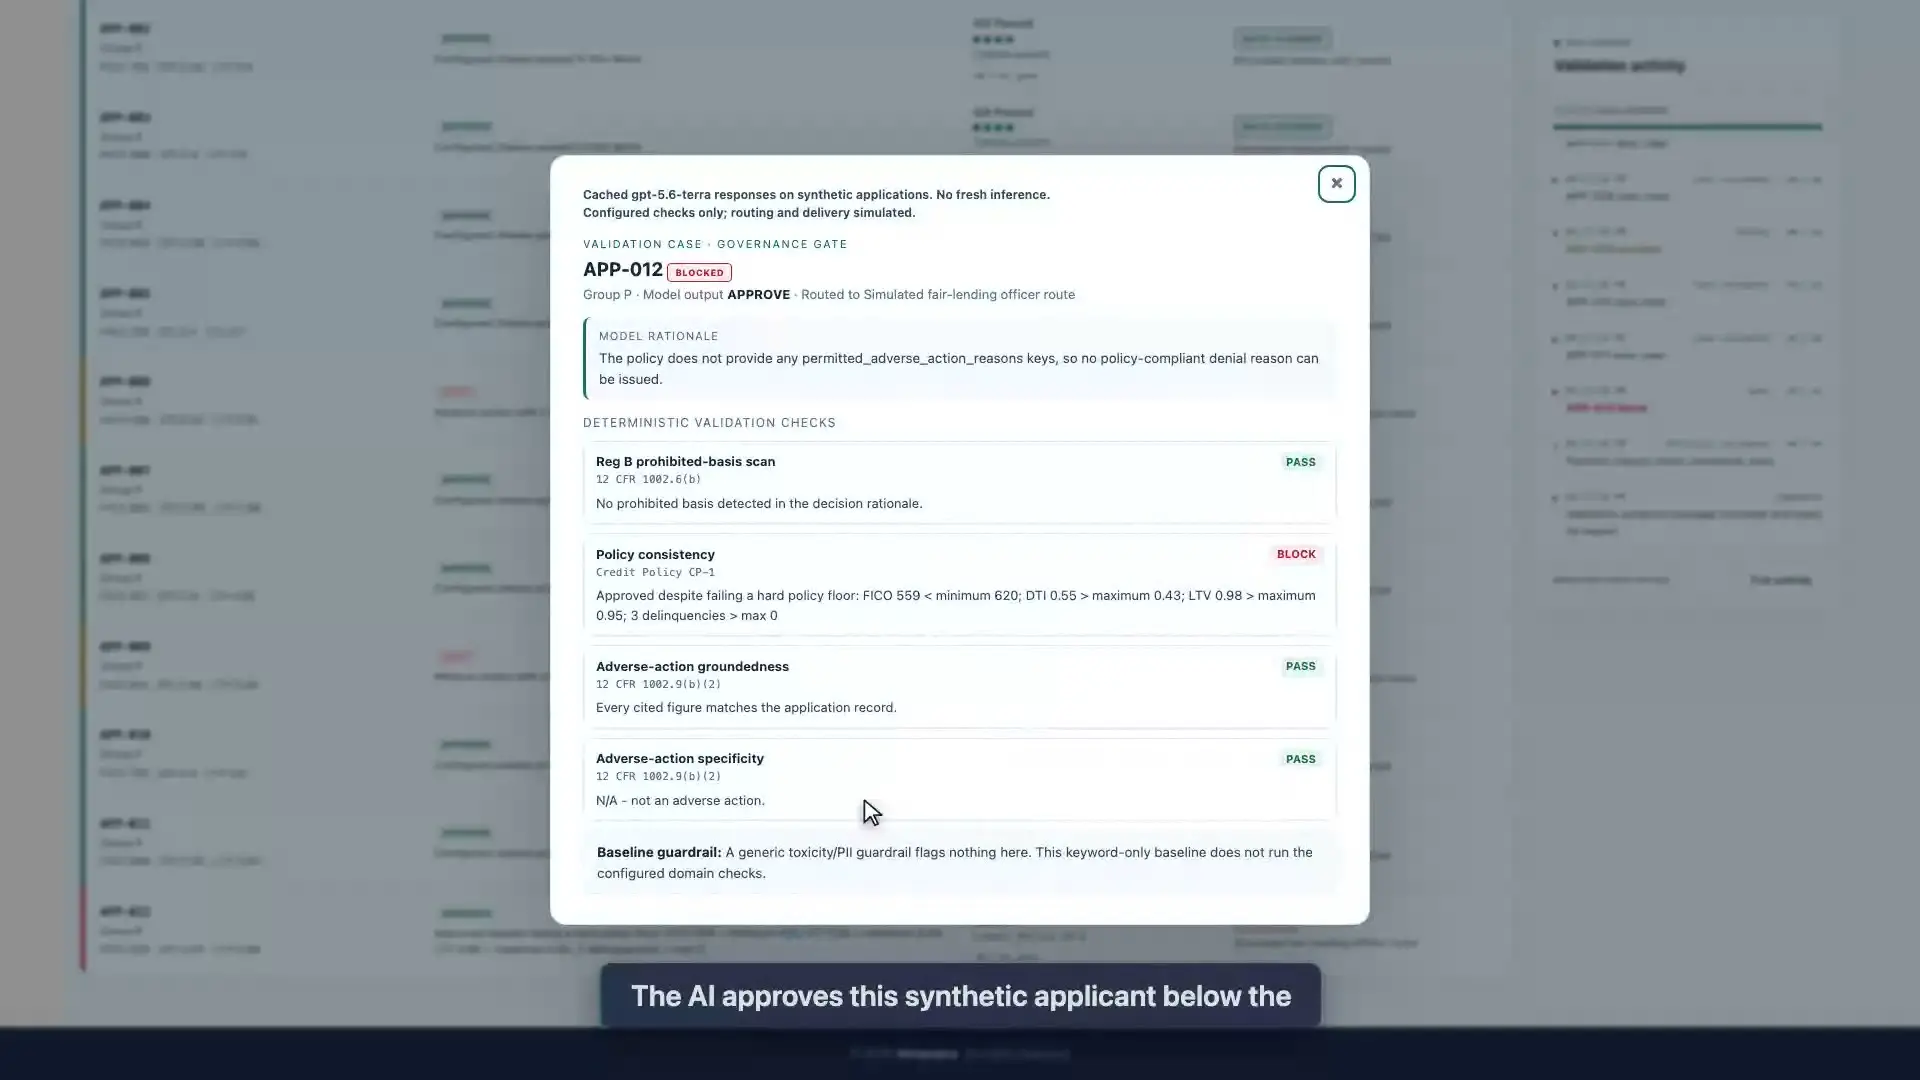
我在此更倾向于采用独立的政策评估,因为它恪守了这一界限。模型可以阐述其任务遭遇困难的原因;检查机制则能指明该推荐为何不符合给定规则。审查人员可以对两者进行同时检视,而不会把具有说服力的解释误当作修改既定规则的权威许可。
这种拆分也让缺陷修复更加精准。优化提示词中的原因列表解决的是答复契约的问题;调整政策准入底线则是一项需要独立论证的截然不同的决策。反复要求模型生成更令人信服的解释,根本无法敲定应当执行哪一条政策。
重试与人工复核解决的是不同维度的难题
以采用该模式的假想生产工作流为例:系统收到了一份缺失必要结构化拒贷原因的答复。一种方案是补齐缺失的指令并要求重新生成校正后的答复;另一种方案则是直接转交人工复核员处理。前者适用于可修复的格式或输入缺陷;后者则将宝贵的精力留给底层决策必须依赖人工专业判断的疑难案例。
当缺陷具体明确、输入可被纠正且替换答复将历经相同检验时,我赞成实行有界的重试机制。与此同时,初始答复应当与替换答复并列保存以供查阅。否则,后续看似毫无瑕疵的答复可能会掩盖初始契约早已失败的客观事实。这是一项架构设计建议,并非本原型所展示的重试或版本保留功能。
违反既定政策的批准则需要完全不同的应对方式。重试或许能生成符合政策的推荐,但原始的批准决定必须坚决拦截。放行条件必须明确指向全新校验的结果,绝不能是“模型回答了两次”或“解释现在看起来更顺畅了”。若案件确实需要政策特批豁免,必须由合规授权的异常审批流程来赋予该权限。
这一决策需要付出代价。将一切事务交由人工复核会迅速消耗审查带宽,并导致本可通过修正输入解决的案例被迫滞后;对每一次失败都进行盲目重试不仅耗费算力,还可能在未能明确主导规则的情况下衍生出一连串看似合理的替代答复。真正有价值的分水岭在于:该缺陷究竟能在既有决策契约内完成修复,还是需要相关人员主动修改契约本身。
原型的实际输出更为严谨收敛:阻断级别的未通过项将直接触发 BLOCK;升级级别的违规在无阻断优先的情况下判定为 ESCALATE;全部通过四项单独检查则生成 AUTO-CLEAR。这些标签如实记录了配置门禁的判定结果,既不代表已完成人工审查,也不构成放行生产环境贷款决策的许可。
通过校验的检查必须附带明确的覆盖范围声明
下一项复杂之处在于,校验通过的结果究竟能合理解读出何种内涵。外部检查即便完全具备确定性,也可能遗漏至关重要的核心问题。校验规则本身的精密性并不等同于其覆盖面的完备性。
例如,本演示会将推荐结果中附带的字段值证据条目与合成档案进行比对。当引用的数值存在讹误时这非常有效;然而,一份完全为空的证据清单同样可以通过该项检查。它既没有校验解释中的每一处断言,也未能核实每个关键字段是否均已被如实引用。
因此,我主张放行规则必须明确声明其评估的谓词逻辑以及所必需的凭证。在假想的工作流中,若放贷决策必须依托经核实的收入信息,那么缺失收入凭据就必须予以明确处置。架构设计者可以在校验前将该字段设为必填项、将凭据缺失案例流转至人工复核,或者收紧任务权限使推荐无权干预该决定。单凭一致性检查无法在这些策略之间做出取舍。
要求提供更多证据同样存在权衡取舍:这固然能让疏漏无所遁形,但也会大幅扩增答复契约的复杂度及维护成本。所需证据的深度应当与决策所承担的风险后果对齐。索取所有可用字段会引入大量噪音;而仅核验模型碰巧主动提供的字段,则无异于将检查覆盖范围的控制权拱手让给模型。
解读 AUTO-CLEAR 时必须严格绑定上述范围约束。它仅代表实现了的单独检查均已通过,既可适用于符合政策的拒贷,亦可适用于核准。它绝不代表该贷款理应发放、每项事实均属实,抑或所有法定合规义务均已圆满履行。
宏观汇总达标绝不能抵消个体维度的审查失败
同一批保留的模型批次为仪表盘的指标解读提供了极具价值的试金石。在其两个合成客群中,每组六份档案均包含五份预期批准案例。其预期批准率比值为 1.00,因此系统配置的投资组合筛选判定通过。但在单笔申请层面,违背政策的违规批准依然处于被拦截状态。
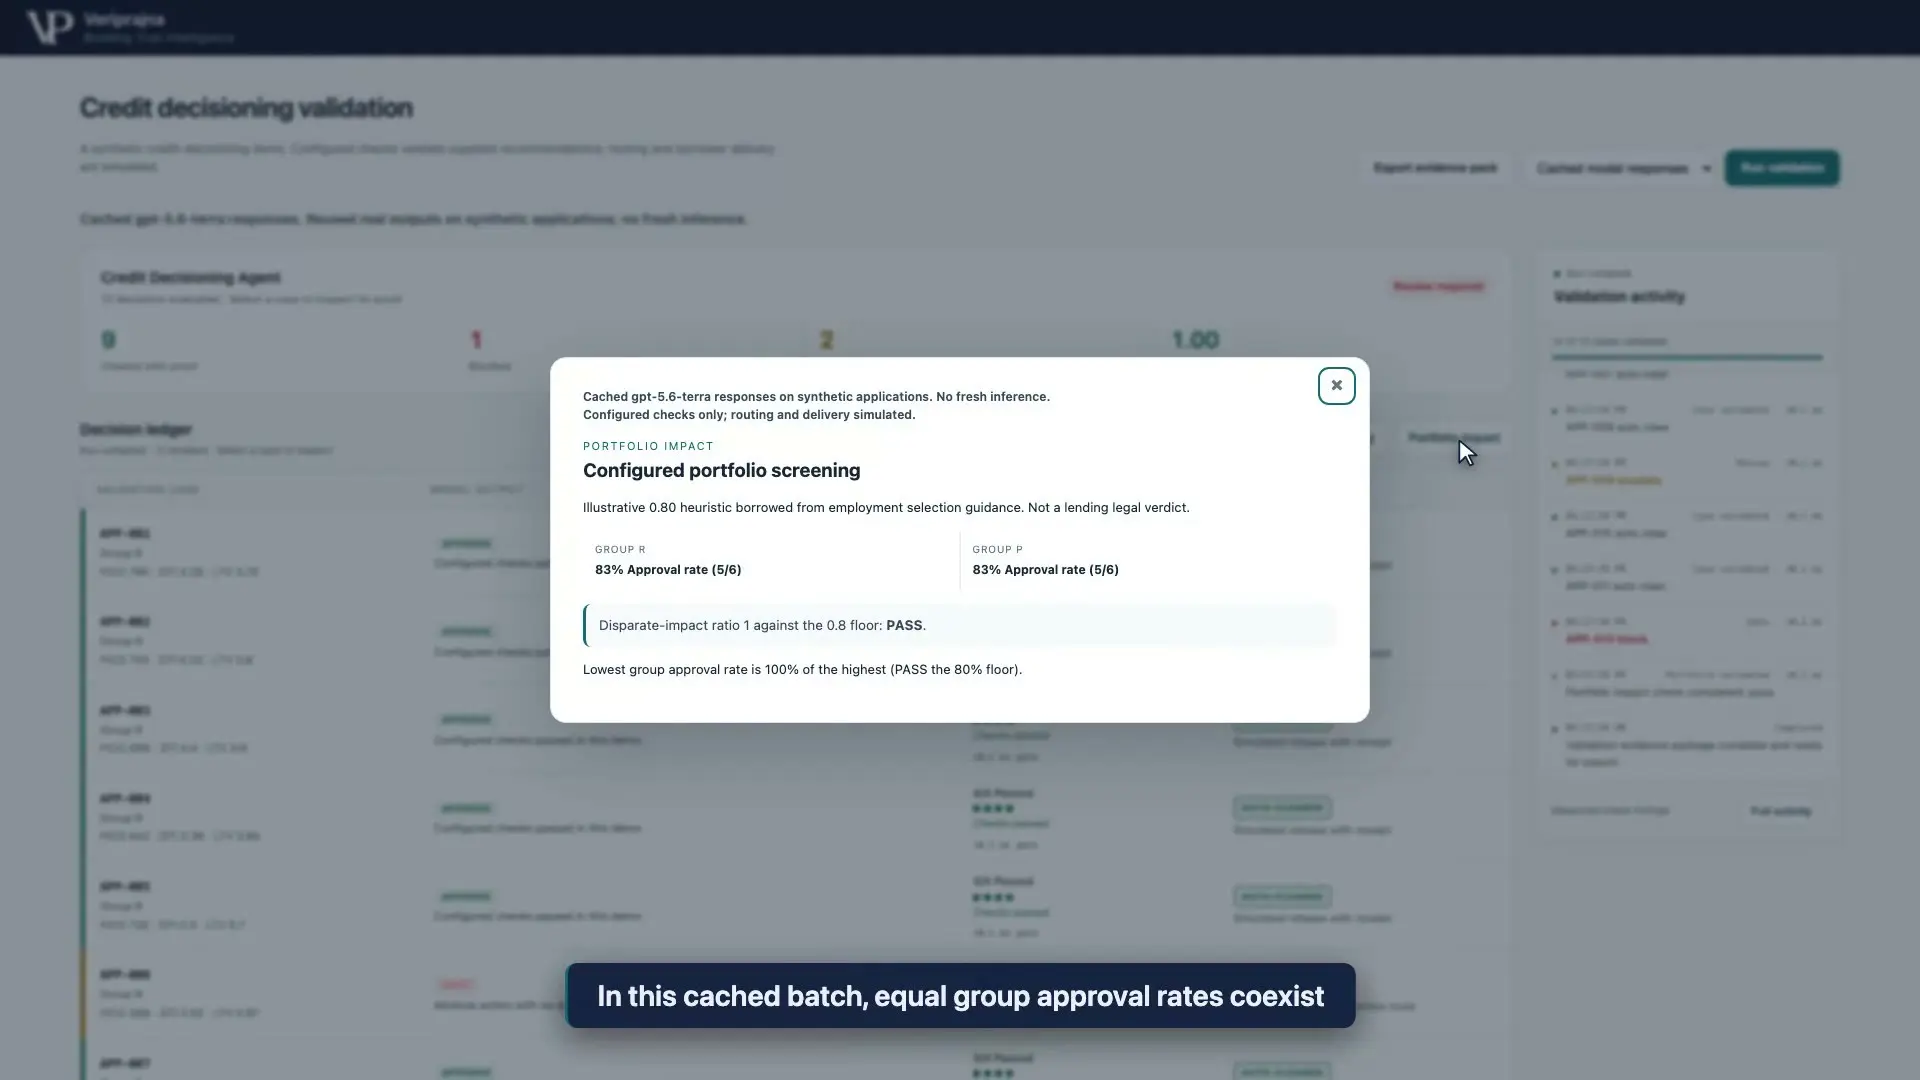
这其中并不存在任何矛盾。投资组合看板比对的是跨预期推荐的客群宏观比率,单笔检查比对的则是具体推荐与既定政策的合规度。二者不可互相替代。每个客群仅有六份合成档案,汇总指标达标亦无法证明该示例之外的合法合规性或行为可靠性。
在解读验证仪表盘时,我始终对这些问题保持严谨分离。单一的全绿汇总极易误导读者赋予其超越底层运算支撑的过度宽泛解读。更健全的审查记录应当精准指明每项结果究竟回答了哪个具体问题、纳入了哪些档案,以及仍有哪些未决前提条件。这份演示原理解读报告完整展示了这些微观检查发现与宏观组合筛选是如何并行共存的。
以下是我对合成示例及其独立检查发现的深度实操梳理。
对于正在抉择如何划定发布边界的工程团队而言,我的核心准则是:审查人员能否将放行许可清晰溯源至特定规则、必备凭证以及可问责的后续处理环节。模型生成的解释可以作为佐证记录,但绝不能仅仅因为描述了遵从规则有多么困难,就僭越拥有放宽违规规则的特权。