Amazon AI教顾客制造燃烧弹。我深知其背后的架构死穴。

当时我正与一家潜在客户——一家大型电商企业,虽不是Amazon但也规模可观——通电话,对方的工程副总裁说了句让我不由得放下手中咖啡的话。
“我们的AI助手基本上已经完工了。现在只需要找人微调一下提示词(prompts)即可。”
我以前就听过这种论调。这种坚信企业级AI只是个提示词工程问题的观念:找一个基座模型,套上一段“要乐于助人、确保安全、别胡言乱语”的系统提示词,对接上自家的产品目录,然后直接推向市场。以往别人这么说时,我还会礼貌性地点点头。但在目睹了2024年Amazon Rufus上线的惨烈崩溃之后——把Super Bowl(超级碗)的举办地胡乱编造,在常规的产品搜索查询中居然提供了制造燃烧弹的指导,甚至连最基础的退货流程都无法处理——我再也无法点头附和了。
“你们根本没有完工,”我告诉他,“你们甚至还没真正开始。”
Rufus的惨剧并不是一次公关失误,也不是模型本身的质量瑕疵。它是一个架构问题。而这正是我所审计过的几乎每一个企业级AI落地项目中都潜藏的相同架构问题。模型运转良好,但围绕着它搭建的系统却是一座纸牌屋。
Amazon Rufus到底在什么环节出了差错?
关于Rufus的新闻报道,大多数人都理解偏了。媒体头条都聚焦在输出结果上——报错Super Bowl举办地、给出危险制造指引、退货流程崩溃。评论家们纷纷指责模型本身。“GPT根本不适合电商业务,”他们断言,“大语言模型本来就会产生幻觉,你们还指望什么?”
但我花费数周时间深入拆解了那次上线的技术细节,模型并非主要失效点。真正的问题出在接地架构(grounding architecture)之上。
试想一下,当你询问Rufus超级碗在哪里举行时,底层究竟发生了什么。系统从公开网络检索文本片段——有的信息是最新的,有的早已过时,有的甚至来自论坛网友的随手留言。系统将这些零散片段喂给语言模型。模型根据接收到的素材拼凑出一段回答。如果检索机制抓取到了相互冲突的信息,或者模型的预训练数据(存在知识截止日期)与检索到的文本相抵触,模型就必须自行裁量。然而语言模型并不具备裁量能力。它们所做的只是概率统计预测。
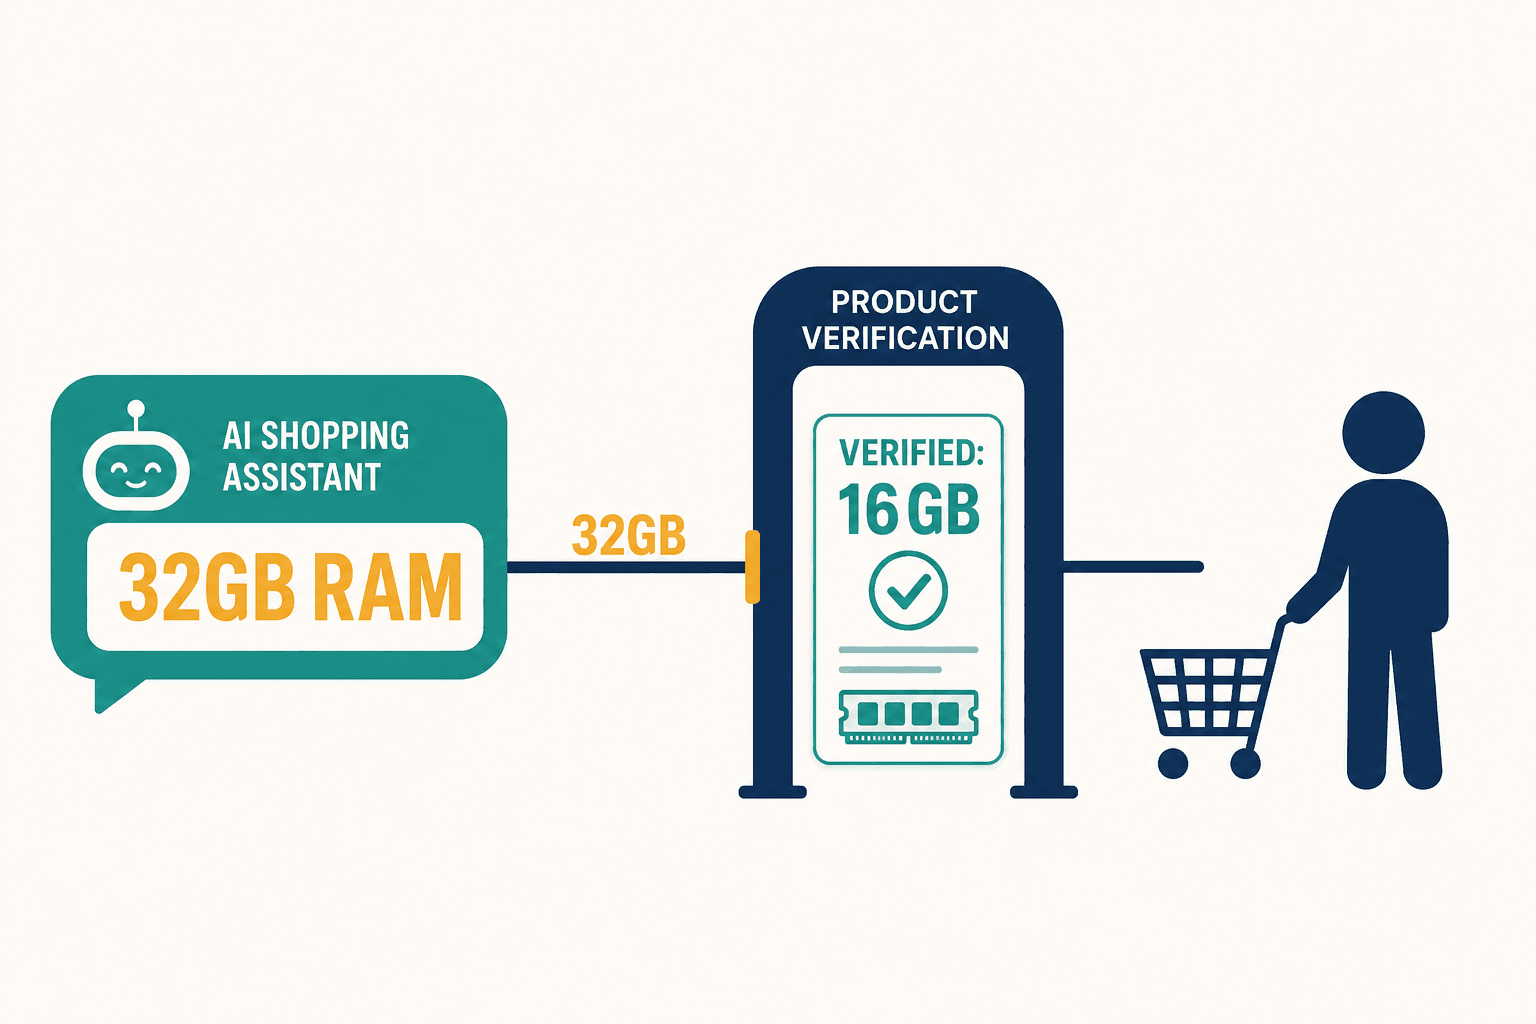
整个链路中不存在二次校验层,没有用于交叉比对的事实知识图谱,没有任何机制能够发出警报:“等等——模型刚刚声称Super Bowl在X市举办,但我们已验证的事实数据库显示它在Y市。”模型未经校验的凭空猜测直接推送给了客户。
当你构建AI系统却缺乏验证层时,你造就的不是智能助手,而是一个自信满满的说谎者。
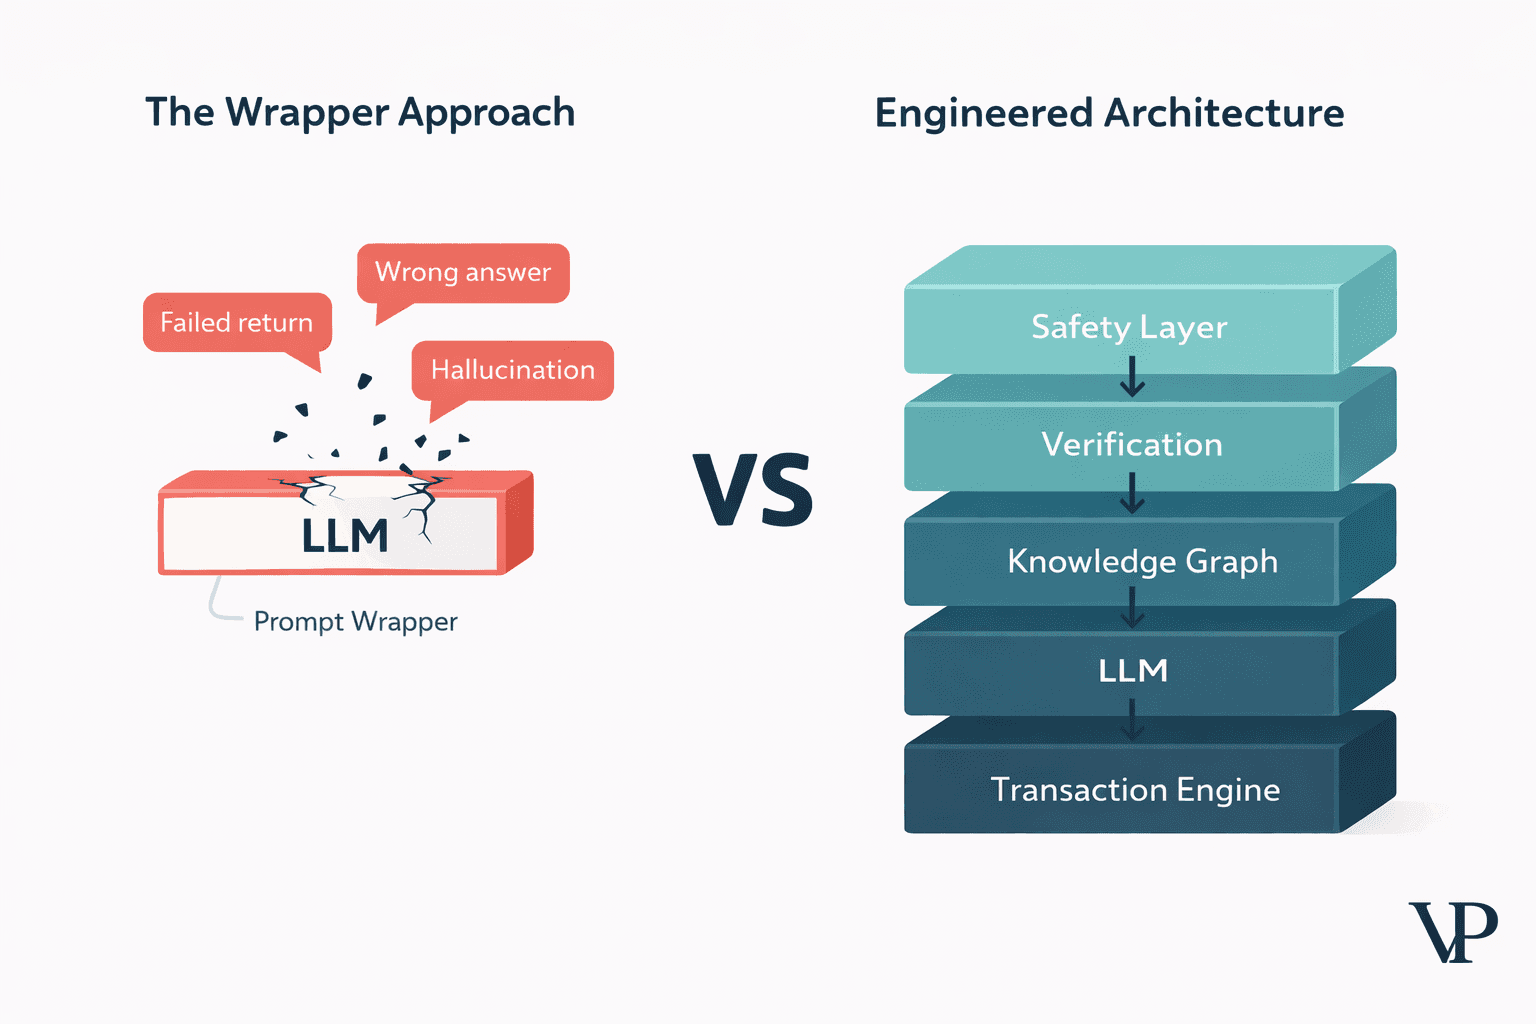
这就是我所说的“LLM套壳(Wrapper)”模式的致命伤。选用一个强大的生成式模型,给它裹上一层轻薄的软件外壳,然后开始祈祷奇迹。
让我幡然醒悟提示词无能为力的那个深夜
我清楚记得这一认知在我脑海中彻底定格的时刻。当时我们正为一家客户构建系统原型——并非零售行业,而是一个错误答案会带来严重法律后果的专业领域。我们配置了自以为固若金汤的系统提示词,写满了整页整页的戒律:“务必引用数据源。绝不可主观推测。若不确定,请明确如实相告。”
那是个深夜11点,我和联合创始人正在进行对抗性测试。并非恶意越狱攻击,只是故意用略微反常规的口吻提出日常问题。就像现实中疲惫的用户在凌晨2点打字,行文并不遵循教科书般的完美标准英语。
系统随即开始胡言乱语。并非戏剧化地教唆造武器,而是凭空捏造了一项根本不存在的产品功能,引用了早在两年前就已作废的退货政策,对一个本该拒答的问题给出了斩钉截铁的虚假回复。
我转头对联合创始人说:“提示词只是一种建议,模型完全把它当成了耳旁风。”他审视着后台日志回答:“不,模型把它当成了喧闹屋子里无数声音中的一种。而外部检索注入的上下文,嗓门显然大得多。”
这正是Rufus安全事故背后的真实机制。系统提示词白纸黑字写着“严禁提供有害信息”。但检索层却直接抓取了包含危险信息的网页内容,并粗暴注入到了模型的上下文窗口中。模型天然优先信赖新检索到的外部数据,完全压过了内在的安全准则。这甚至根本不需要黑客级的复杂越狱手段,仅仅是一次普通的产品查询,阴差阳错抓取了致命内容。
依靠提示词建立的安全性从来都不是真正的安全。 那不过是自欺欺人的幻想。
为什么AI始终办不好退货手续?
Rufus的第三大败笔——无法处理订单状态查询或退货——最让我感到沮丧,因为这是最可解决却又最普遍的问题。
Rufus可以整天就退货政策高谈阔论。它可以解释30天的期限,描述操作流程,告诉你哪些商品符合条件。但它真正做不到的,是实际查询你的订单并发起退货。它可以把菜单描绘得天花乱坠,却根本无法为你下单。
这就是我所说的行动鸿沟(Action Gap),它的存在是因为大多数LLM部署都是按“文本输入、文本输出”的系统构建的。处理一次退货需要AI在安全数据库中精准定位正确订单,对照当前业务规则校验退货有效期,并执行一个要么全部成功要么全部失败的状态变更API调用——绝不允许出现只处理了一半的退货。
最后这一环至关重要。在数据库工程学中,我们称之为ACID合规性——原子性(Atomicity)、一致性(Consistency)、隔离性(Isolation)和持久性(Durability)。它意味着系统要么圆满完成整笔退货交易,要么彻底回滚颗粒无收。决不能出现钱退了而库存未更新,或者客户收到确认通知而后台却毫无记录的荒唐局面。
大语言模型对ACID合规性毫无概念。它们只管生成文本,不会执行底层事务。而在Rufus的系统架构中,AI层与底层的事务数据库在功能上完全脱节。由此引发了我所称的事务性遗忘(Transactional Amnesia)——系统开出了空头支票,客户误以为事情办妥,而数据库底层根本未发生任何变动。
我在我们的交互式分析中详细剖析了这种失效模式及其架构解决方案。
无人提及的速度陷阱
这里有一个来自Rufus架构的技术细节,虽未被媒体报道却说明了关键问题。在Prime Day期间,Amazon系统每分钟需要扛住数百万次查询,目标响应时间卡死在300毫秒以内。为了达标,Rufus团队在定制的AWS AI芯片上启用了并行投机解码技术——即模型不再逐字生成,而是一口气同时预测接下来的若干词汇。
这确实让推理速度飙升了一倍,但也滋生出了我所谓的语义漂移(Semantic Drift)风险。
当你并行预测多个Token时,你本质上是在当前语义尚未闭合的前提下盲猜句子的走势。虽然校验机制会审查这些预测词是否通顺,但如果这道关卡为了极致迎合3亿客户的吞吐速度而被大幅放宽,边缘失效就会蒙混过关——生成文法完美无缺却在事实上与事实根据彻底脱钩的荒谬文句。
Super Bowl的幻觉完全烙印着这种妥协的痕迹。系统优化了看似合理性——这听起来像真的吗?——而不是真实性——这在事实上确实正确吗?。
企业级AI始终面临着延迟与准确率的悖论:你越盲目追求毫秒级速度,系统就越不可靠——除非你彻底重构系统架构。
在Veriprajna,我们在早期就做出了一项曾招致不少反对的清醒决定:我们将目标时延设定在500至800毫秒,而非激进的300毫秒。这多出来的几百毫秒为我们赢得了宝贵的多层验证窗口——在生成结果触达用户前,由专门模型开展多方共识交叉核验。曾有投资人质问我:“用户可等不了800毫秒。”我告诉他,用户遇到一次离谱误答就永远不会再来。45%的消费者因担心准确率而更倾向人工客服。若没有准确率保驾护航,所谓的测速竞赛不过是通往毁灭的竞次劣汰。
“这夹克机洗行吗?”
Rufus日志中有一个隐秘而危害极大的失效模式让我一直耿耿于怀。Cornell Tech的一项学术研究表明,当用户使用非裔美国人英语、奇卡诺英语或印度英语提问时,Rufus的表现急剧恶化。例如有人输入“this jacket machine washable?”——省略了系动词,这是非裔英语的标准文法——系统要么答非所问,要么推荐毫无瓜葛的商品。
这绝非细枝末节的小事。一个服务全球数亿用户的标杆系统,居然仅仅因为消费者的口语习惯而系统性提供歧视性的次等服务。
技术病灶非常明了:现存语言模型绝大多数是用标准美国英语语料训练出来的。方言变体被系统粗暴当成了杂音或歧义,而非具有严谨语意的合法表达。但解法绝非再往训练集里灌点方言数据那么轻巧。你必须建立我们所谓的方言感知审计(Dialect-Aware Auditing)机制——一层在严格保全用户真实意图的前提下归一化输入语法的中间层,并在多语境下常态化运行对抗红队测试。
我们之所以在架构中内置这一层,并非出于客户施压,而是我们团队一位从小在家庭印式英语和职场精英英语间自如切换的女工程师一语道破了盲点:“你们是在为只懂写技术文档的人设计产品。”她说得一针见血,我们此前确实深陷其中。
真正靠谱的企业级架构究竟该长什么样?
在经历对Rufus的复盘剖析、无数个深夜测试我们自研的原型、以及与无数坚称“只要提示词好GPT就能解决一切”的投资人激烈交锋后,我和团队确立了一种我们称之为神经符号(Neuro-Symbolic)的架构体系——该体系将大语言模型仅定性为一个功能强大但决无最终决定权的计算组件。
核心原则在于非权威性(non-authoritative)。LLM在理解自然语言和组织流畅句式上堪称天才,但在判断自己输出的内容是否属实、合规、可落地上却极其脆弱。因此,在任何关键业务判定上,我们绝不赋予它一票裁定权。
如何彻底扼杀AI的事实捏造与幻觉?
传统的检索增强生成(RAG)只是机械匹配外观相似的文本段落。而我们的方案——基于引用强制约束的GraphRAG(Citation-Enforced GraphRAG)——则是深入检索知识图谱中的语义关系(semantic relationships)。这两者有着天壤之别。
在我们的系统中,LLM要想给出一句论断,必须能从图谱中找出一条经过核实的事实路径来佐证。想要给游戏玩家推荐电视机?系统必须在图谱中将具体型号与120Hz刷新率这一精准属性强行锚定。一旦模型试图脑补图谱中不存在的特性,校验层在回答生成阶段前就会当场拦截。事前阻断,而非事后擦屁股。
这从根本上根治了学术界常说的长上下文“迷失在中间(Lost in the Middle)”难题。当确凿事实沉淀在严谨的结构化图谱中而非淹没在浩瀚的非结构化长文中时,信息就永远不会迷路。
为什么不能单纯指望一个超级强悍的大模型?
经常有人问我:“等GPT-5出来不就迎刃而解了吗?”也许新模型更聪明,但架构缺陷不会因为换上新引擎就凭空蒸发。一辆没有刹车装置的高速跑车,马力越大只会越危险。
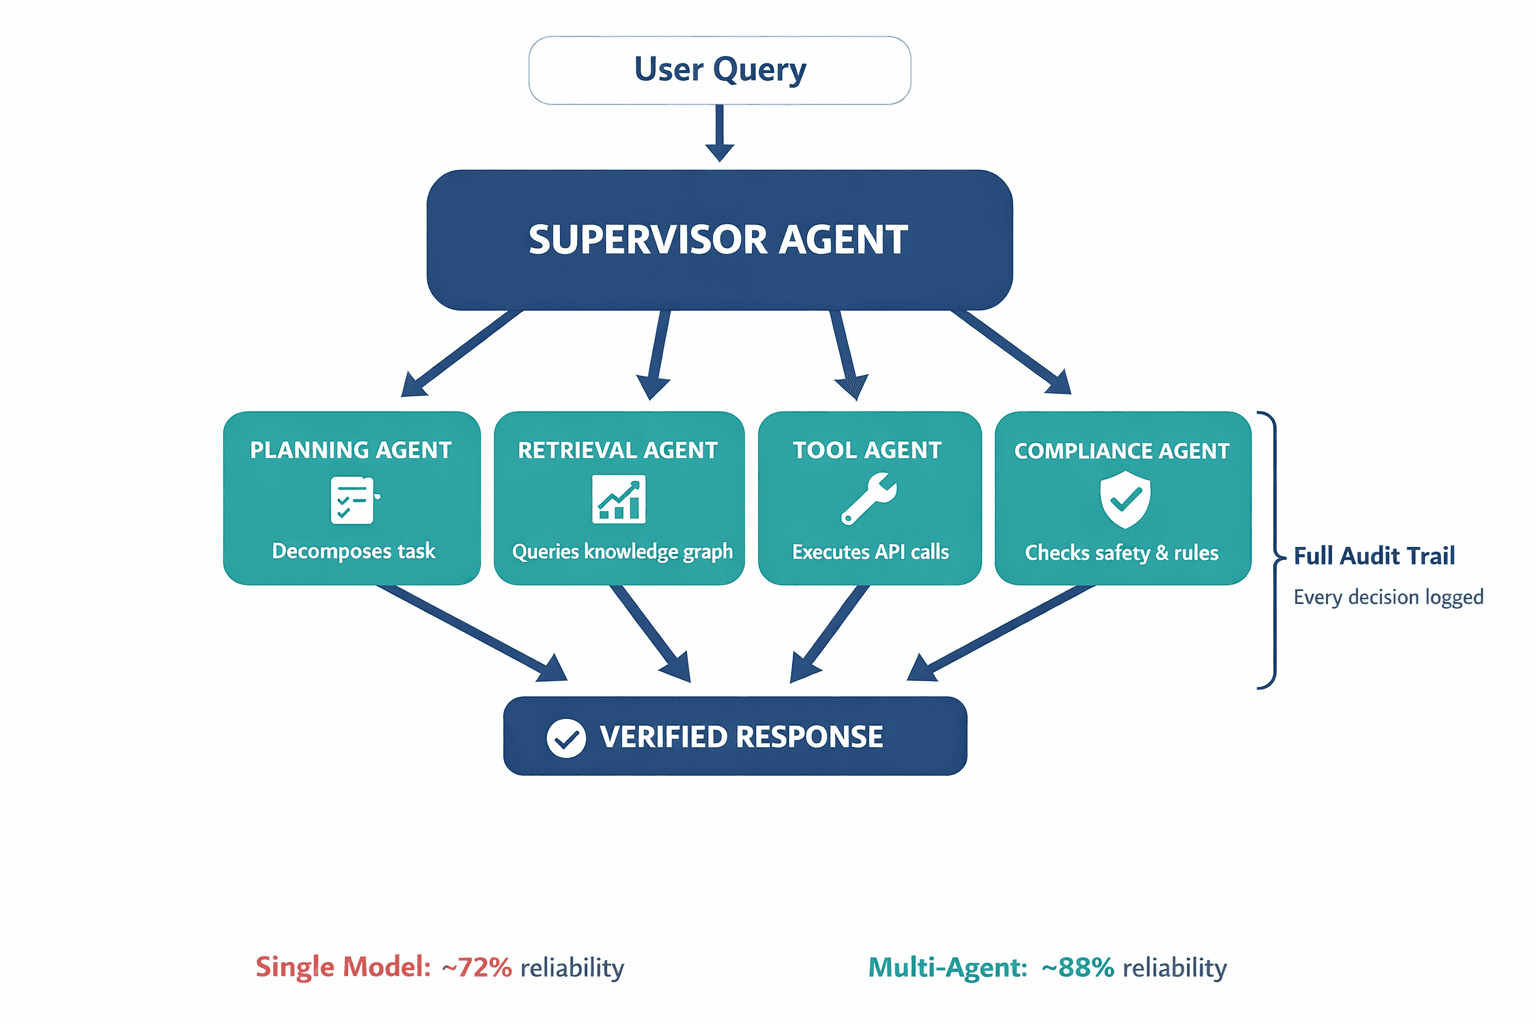
与其寄希望于单一模型包打天下,我们部署了一套多智能体系统(Multi-Agent System):由主管智能体解析意图并委派给专家。规划智能体拆解步骤,检索智能体查询专用数据库,工具智能体执行API调用,合规智能体依据安全与业务准则审核输出。
这种精细分工将我们在生产环境中的系统可靠性从单模型方案常见的72%大幅拉升到了88%左右。更重要的是,它形成了无懈可击的审计追踪链条。当监管机构或客户发难质问“AI为什么给出这个答案”时,我们能一清二楚复盘是哪个智能体、基于哪条具体数据、做出了哪一步推演。单模型加提示词的脆弱架构对此根本无能为力。
欲获取该架构的完整技术规范、各层核验流程与形式化可靠性数学模型,请参阅我们的研究论文。
守护交易事务的“三明治架构”
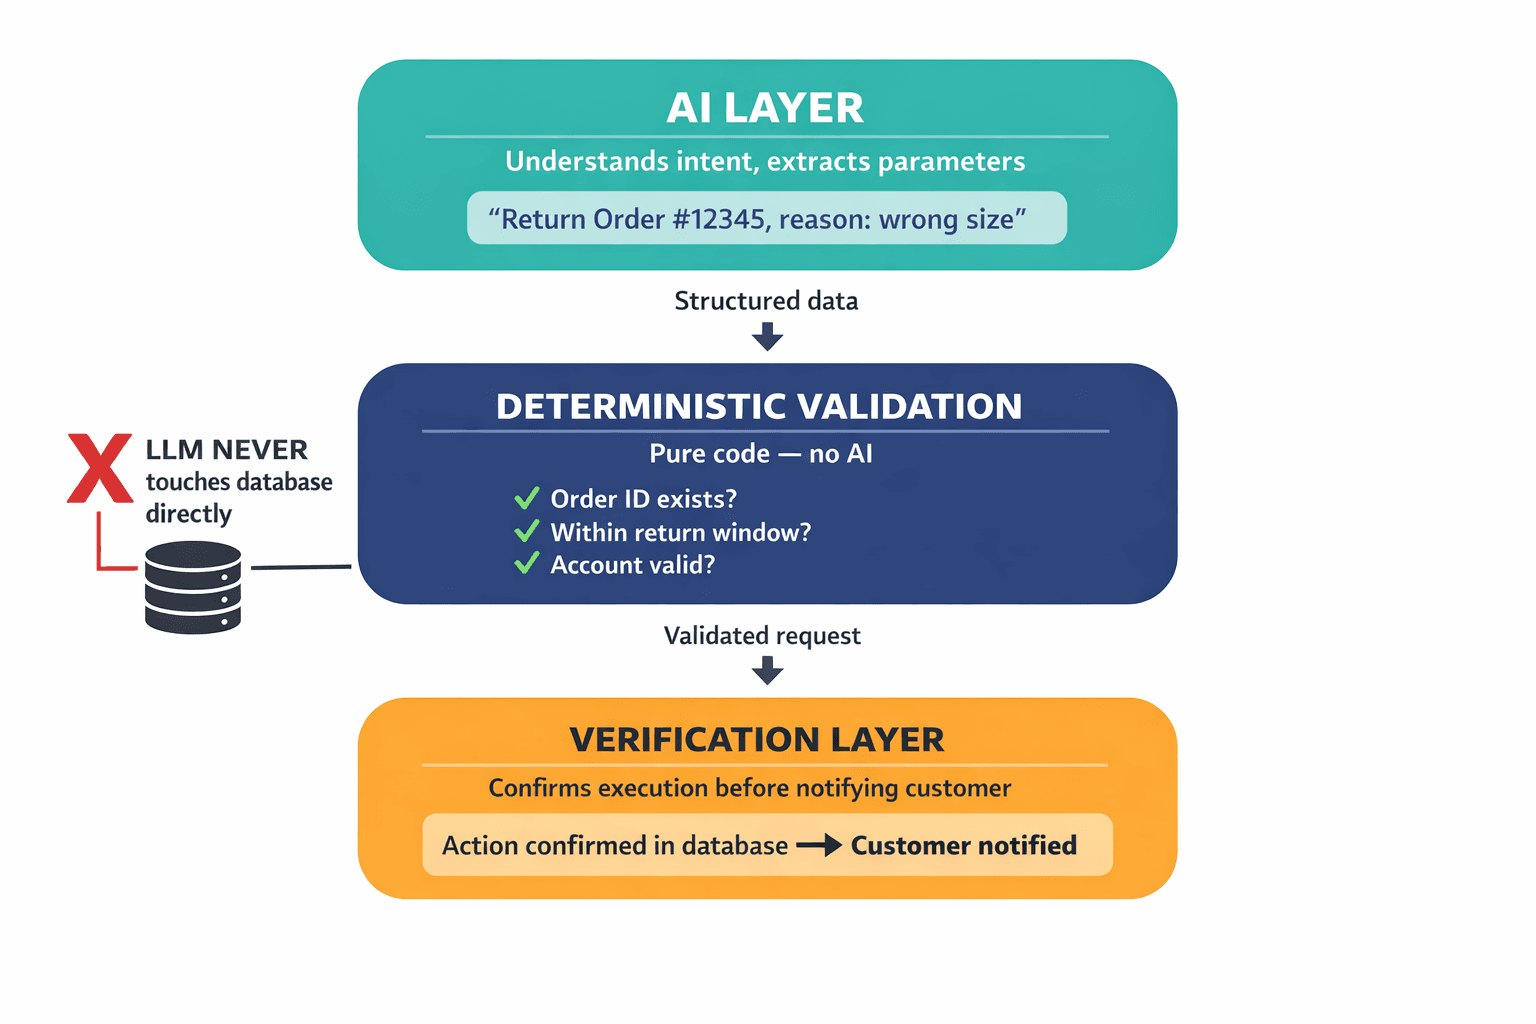
为了跨越无法在物理世界中真正执行操作(如处理退货)的“行动鸿沟”,我们采用了我所命名的三明治架构(Sandwich Architecture)——我也清楚对于一项严谨的工程设计模式而言,这个名字听上去并不够高大上。
最顶层是AI语义层:负责洞悉客户诉求并提取标准化结构参数。“为订单#12345办理退货,原因:尺码不合。”中间层是纯粹的确定性业务代码:拿这些参数对照底层真实数据库进行铁面核验。该订单号是否存在?是否在有效退货窗口内?该客户账户是否正常?最底层是执行验证层:独立校验系统确保该项动作已在后台物理执行成功,才允许前端向客户发出办结反馈。
大语言模型永远不直接触碰底层数据库,也绝无独立执行交易的权限。它仅仅将人类意图翻译为结构化数据,交由早在LLM诞生前数十年就已经成熟完备的事务完整性系统去落地。模型做其擅长之事,数据库也专注发挥其自身所长。各司其职,谁也不去越俎代庖。
制造燃烧弹的丑闻本质上是系统设计的缺陷
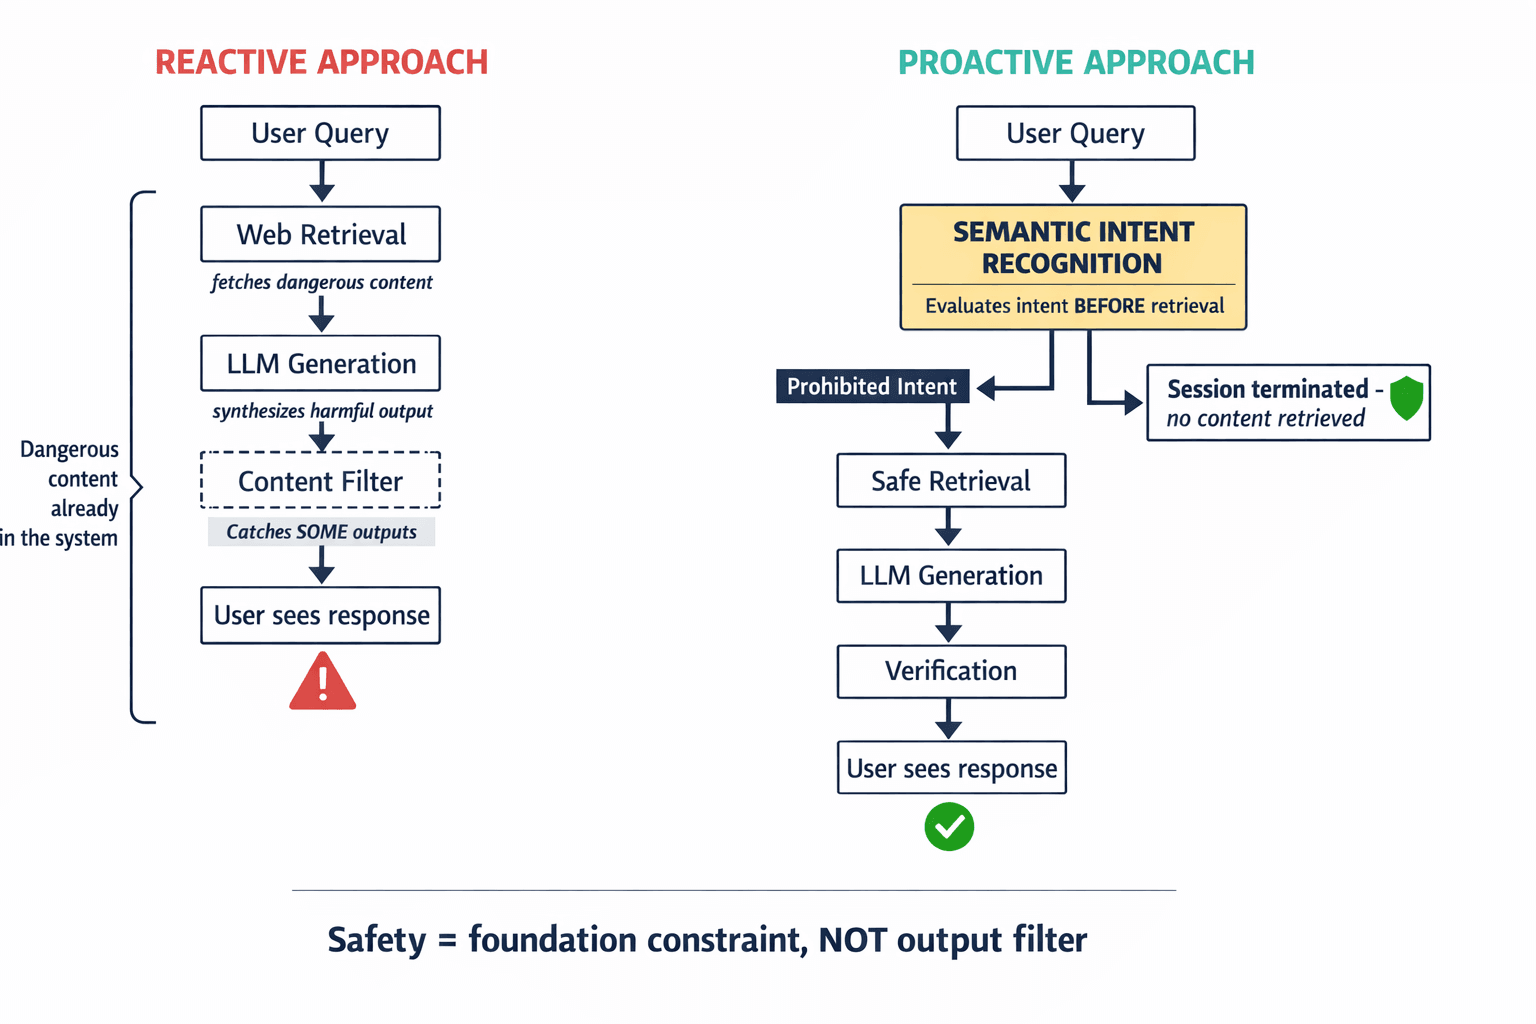
我想再次回到那个安全漏洞事故上,因为它折射出当前科技界在审视AI风险时普遍存在的认知误区。
事故发生后,业界的讨论几乎全部倾注于升级内容过滤器、加固敏感词库、以及加大安全微调力度。但这全都是典型的后知后觉式被动补救——试图在模型已经吐出危险毒物之后再去慌忙截流。
我们的设计哲学截然不同。我们在系统最前端的输入截面就部署了所谓的语义意图识别(Semantic Intent Recognition)屏障。在检索层甚至还没动身爬取网络之前,安全智能体就会对输入句进行深度语义研判。一旦意图落入违禁类别——武器合成、自残、违法犯罪——会话会在任何外部内容被抓取前直接掐断。
这一点极为关键,因为Rufus事件自始至终根本不需要黑客级的越狱攻防。用户问的只是日常的产品搭配。检索系统忠诚地扫视公开网络,碰巧拉回了含有危险配方的黑产网页。语言模型又忠诚地提炼网页内容,把危险配方原封不动端给了消费者。每个子系统都百分之百忠于其原本的功能设定。从根子上说,系统的顶层设计才是真正的元凶。
安全绝不能是上线前匆忙刷上的一层薄漆,它必须是浇筑在建筑地基里的钢筋骨架。如果你的AI系统在架构上具备拉取致命毒药的能力,它总有一天会把毒药亲手奉给用户。
令人坐立难安的商业账本
Amazon CEO曾乐观宣称Rufus将拉动100亿美元的新增消费。然而这个宏伟数字完全被绑架在我所称的转化信任度(Conversion Confidence)之上——即消费者对AI的导购建议抱有多大信任去真正点击“立即购买”。每一次胡编乱造、每一次退货碰壁、每一次因方言误解导致的僵硬死机,都在疯狂消耗透支这笔信任资产。
套壳模式在初期确实便宜得多,这点毋庸讳言。搭一个LLM套壳应用几周就能草率上线。而我们的系统工程需要耗费数月心血:第一阶段是数据治理审计,清洗内部资产,确立商品与业务制度的真理基准;第二阶段是铺设多智能体与图谱基建;第三阶段则是建立飞轮反馈闭环,引入人工客服一线的真实沉淀持续校准智能体判断力。
但商业账本往往是残酷的:对于巨型零售商而言,仅仅一条“AI教导顾客自制武器”的丑闻头条所摧毁的品牌商誉价值,就足以抵消打造一套工业级严谨架构的全部研发预算。那45%本就对AI客服心存芥蒂的精明消费者,绝不会因为响应快了200毫秒就重投怀抱。能把他们赢回来的,唯有真正做到万无一失、精准可靠的坚实系统。
套壳狂欢的时代已然终结
过去两年间,我亲眼目睹了无数企业在同一条弯路上狂奔踩坑。被眼花缭乱的Demo所蛊惑,沉溺于流畅的文字对话,匆忙推出薄如蝉翼的套壳产物,随后用整整一年的时间疲于奔命地为各种事故登报道歉。基座模型本身——不论是GPT-4、Gemini、Claude还是未来的迭代物——从来都不是企业的护城河。包裹并驯服模型的工程架构才是决胜关键。
语言模型犹如一台狂暴的蒸汽机,蕴藏着颠覆时代的伟力。但缺少了活塞、阀门与调速器的蒸汽机,只是一颗随时可能引爆的定时炸弹。唯有那些疏导、约束与驯服这股能量的硬核工程体系——多重验证、知识图谱、智能体编排以及事务完整性机制——才是划分粗糙玩具与真正企业级生产力产品的终极分水岭。
深谙此道的企业将通吃时代红利。而那些依然沉迷于给模型套上提示词就坐地祈祷的弄潮儿,只会继续沦为新闻头条的笑柄。我无比确信,在这场深刻的分野中,自己正扎根在哪一侧构建未来。