采购AI排除供应商之前,应先审查其底层假设

采购团队需要一个能够在采购业务层面站得住脚的理由来排除某个供应商。低于入围阈值的分数仅仅标明了一个结果。它尚未解释该供应商是在绩效上确实存在短板、证据基础是否薄弱,还是评分公式以采购团队预设的方式奖励了长期的交易历史。
声明:本文借助生成式AI起草。
我正是围绕这一关键区别构建了MeritLens。我的核心观点是:任何对交易历史和营收假设高度敏感的排除决定,在模拟自主授标推进之前,都应当具备可接受审查的合理解释。修改这些假设应当促使该决定进入复核流程,同时完整保留原始决定及其证据链。这种解释还必须为采购方留出充分空间,以判断风险关切是否切实合理。
更优的交付履约表现完全可以与排除决定并存
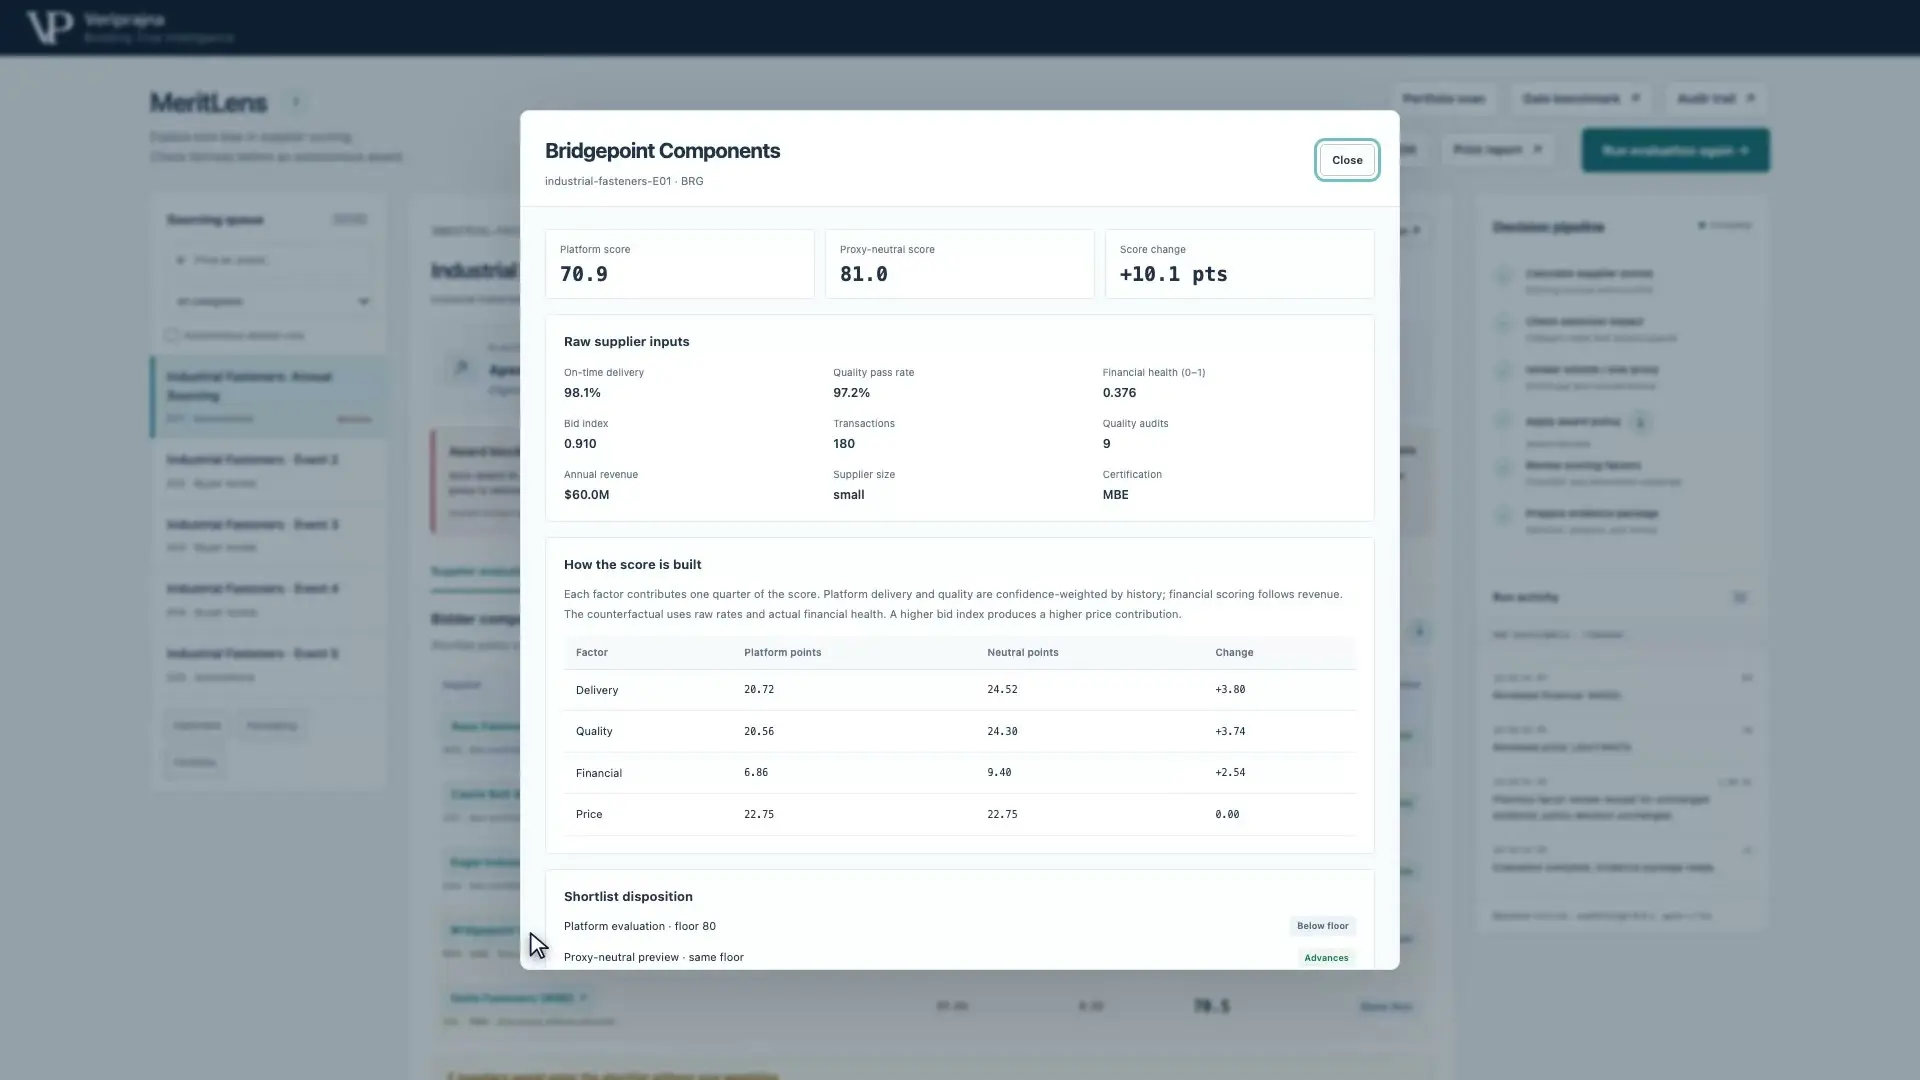
请看我们演示中展示的工业紧固件采购合成案例。Bridgepoint Components的准时交付率达到98.1%,而Apex Fastener Industries为97.2%。Bridgepoint的质量合格率也略胜一筹。然而,模拟平台对Bridgepoint的评分仅为70.9,而对Apex的评分高达91.9。由于入围名单门槛分数为80,Bridgepoint被直接排除。
评分公式对交付、质量、财务和价格四大要素赋予同等权重。其中交付与质量根据支持性历史数据的多少进行动态调整:交易笔数和审核次数决定了实测比率偏离80%先验基准值的幅度。财务要素则直接采用年营业收入。即便供应商多样性标识或规模标签未直接出现在计分公式中,这些依然是影响深远的权重选择。更为宏观的综合评估则使用多样性标签来对比不同群体并执行其采购政策。
Bridgepoint仅拥有180笔交易记录和9次审核,而Apex拥有4,200笔交易和140次审核。因此,前者更为优异的原始比率在初始得分中得到的加分权重相对较少。营业收入在小型供应商与大型供应商之间引入了另一层差距。这一排除决定实际上综合反映了实测绩效、证据规模以及所选财务代理指标的共同作用。
这是启动复核的有益起点。更高的交付率本身并不能直接锁定采购决策。但它有力地证明了,仅仅一句“供应商得分过低”绝非一个完整的合理解释。
替代公式让分歧变得具体清晰
MeritLens的代理指标中立预览使每家供应商都能就其交付和质量的原始比率获得全额认可,直接采用财务健康度代替营业收入,并保持价格和要素权重不变。这是一种明确的替代性计算方案,因此采购方能够清晰看到究竟哪些限制被放宽,哪些约束依然保留。
在该替代公式下,Bridgepoint得分跃升至81.0,成功进入预览入围名单。Apex得分88.0,依然保持领先地位。最初21.0分的分差缩小为7.0分。原始分差中大约有三分之二归因于所配置的历史数据与营收假设。这种归因取决于替代公式的计算规则;它并不是现实世界中存在歧视的因果证明。
我利用这种替代计算来精确定位分歧所在。一位接受原始比率但质疑将营业收入作为财务指标的采购方,其反对理由显然不同于一位怀疑9次审核能否提供充足质量凭据的采购方。若将两种关切笼统合并为一个总分,就会掩盖究竟哪一项假设真正需要提供辩护论据。
该预览还为简化的公平叙事保留了一个不容忽视的事实:Bridgepoint的财务健康状况确实偏低。在该要素中去除营业收入并不能抹除客观存在的财务差距,而更出色的交付表现也并不意味着Bridgepoint在每一项正当标准上都更为优秀。一个真正有价值的解释应当始终保持这类残存劣势清晰可见。
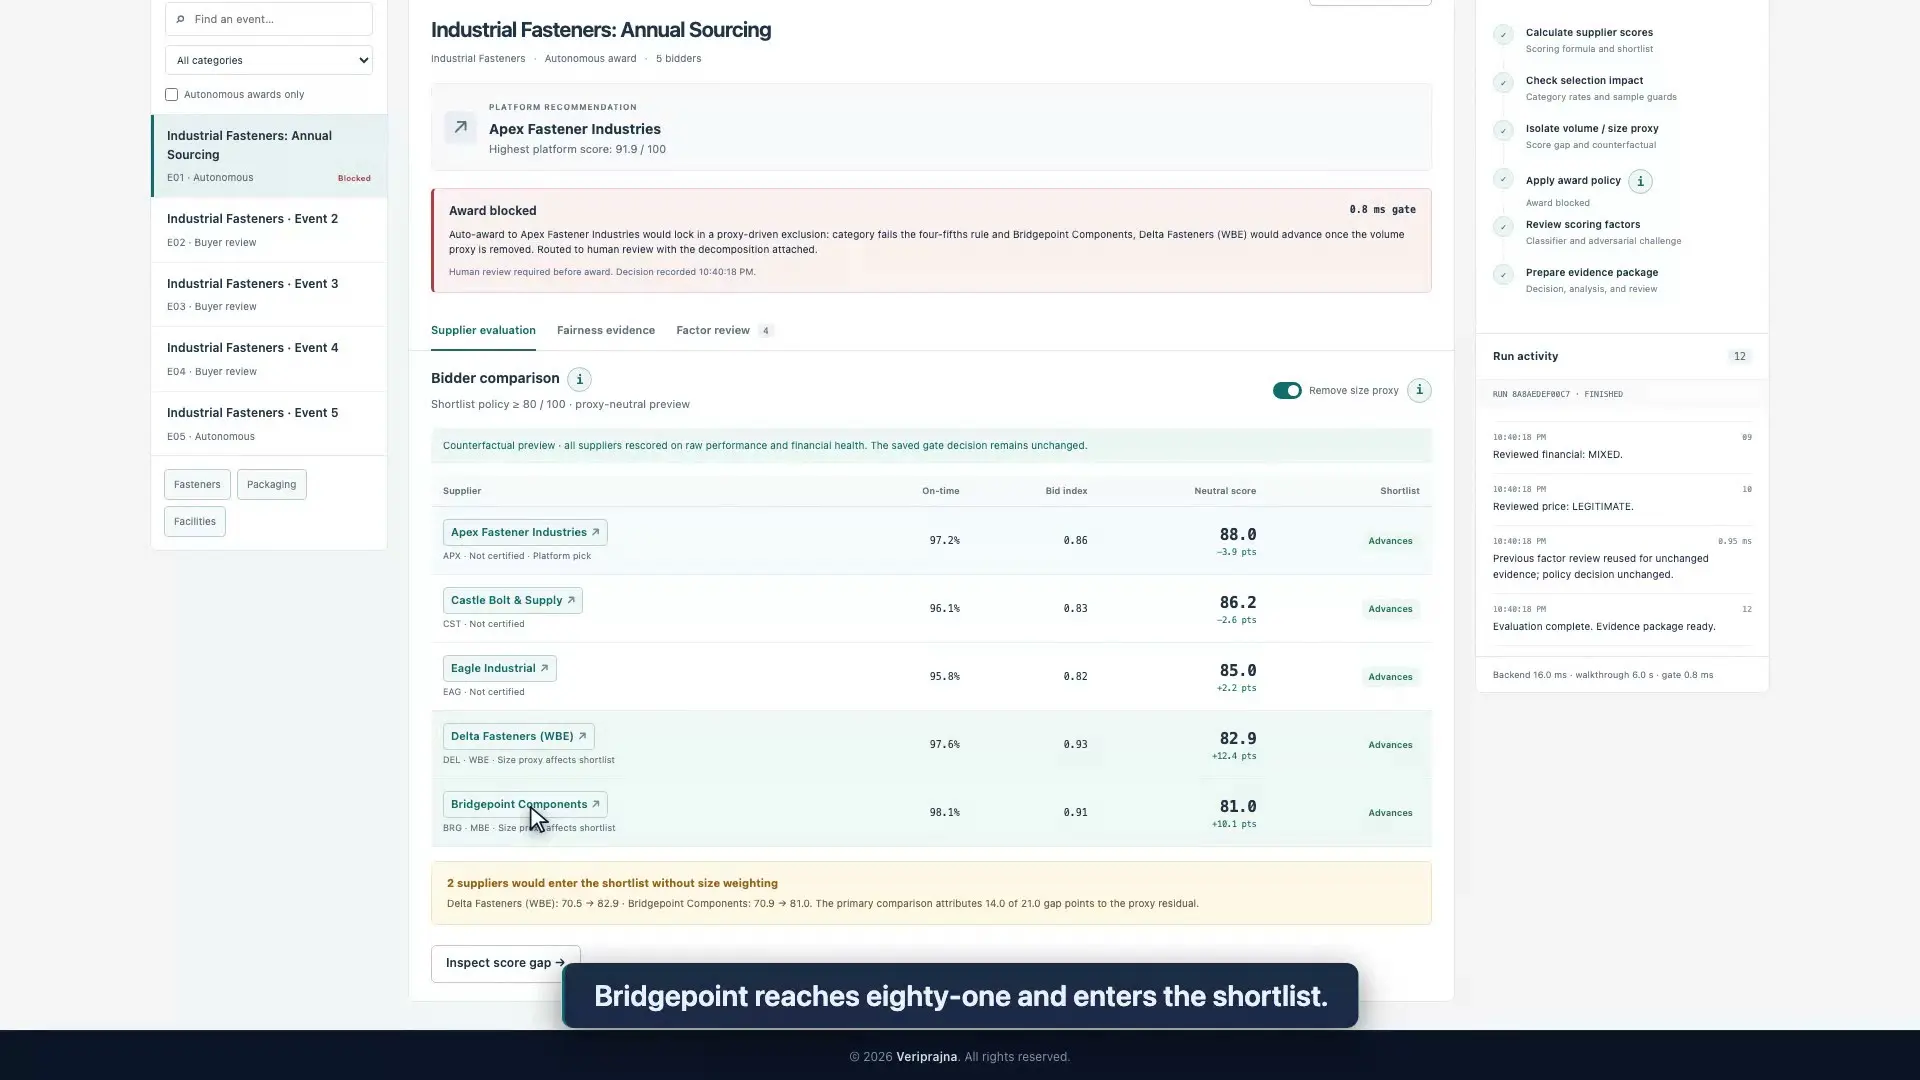
原始建议和保存的BLOCK判定保持不变。该预览不授予合同,不替代原始评分器,也不对记录的品类评估重新评分。这里的所有供应商和授标均为合成或模拟数据,本演示没有与采购平台的实时连接。有关更多计算方法和决策边界的详细信息,请参阅MeritLens说明文档。
取消惩罚必然伴随着相应代价
棘手的问题在于有限的历史是否应该降低准入资格。基于少数观察样本的原始比率所包含的信息量,显然低于有大量观察支持的相同比率。采购方对此类不确定性保持审慎完全合理。像预览所做的那样对每一项原始比率给予全额认可,虽然消除了对历史短板的惩罚,但同时也去除了公式针对证据规模所设定的校准机制。
我并没有把这种预览当作替代性采购政策来对待。它的价值在于揭示了准入决策在多大程度上依赖于该项校准。如果一个团队在缺乏其他评估薄弱证据手段的情况下贸然采用替代方案,它就是在承担未解决的潜在风险。如果它保持原公式不变,就等于默认接受了:由于历史交易较少,实测绩效更为优秀的供应商依然可能被拒之门外。
在一次假设的采购中,如果失误代价极为高昂,那么保留审慎保守的准入规则是完全站得住脚的。辩护理由应当明确说明该规则旨在应对何种不确定性,以及为何所要求的历史记录与该笔采购高度相关。而在另一次假设的采购中,如果团队能够在做出承诺前调查缺失的证据,那么将敏感的排除决定转入人工复核可能是更明智的选择。这种途径需要消耗关注度和时间,但它使团队能够将悬而未决的证据疑虑与真实的绩效缺陷明确区分开来。
这些都属于采购方的自主抉择,而非MeritLens所展示的附加功能。演示展示的是得分对比和拦截机制。它并不替真实机构规定应当承担哪些采购风险,也没有呈现完整的人工评估结果。
我的设计取向是在关键节点上明确保留分歧。复核流程应当有能力得出排除决定合理的结论;它也应当能够识别出需要修正的假设,而无需默许直接将合同授予挑战者。入围资格是一项决策;最终选定供应商则是另一项完全不同的决策。
政策结果必须附带其判定理由
在紧固件案例中,拦截动作具备特定的触发基础。配置的品类诊断标出了选拔差异,原始最高分获得者带有非多样性老牌供应商标签,而原先被排除的多样性挑战者在替代公式下达到了入围门槛。这些条件共同作用生成了BLOCK判定,并要求对模拟授标进行人工审查。仅仅单纯改变个别得分并不足以触发该规则。
对立面的决策边界同样至关重要。在另一个独立的合成包装材料案例中,即便有一家供应商在代理指标中立预览中获得了资格,品类诊断依然返回PASS,闸门依然裁定ALLOW。某些单一供应商类别样本过小,无法在既定防护机制下开展评估。ALLOW代表了该政策的执行结果;它并不证明每个类别都已经受过评估,也不能证明所有的排除决定都对代理指标免疫。这些诊断是预先配置的演示规则,而非采购法理层面的定论。
这一边界为采购方提供了一个实用的评估准则:在审查政策结果背后动因的同时,务必检视该规则未能覆盖的例外情形。在狭隘的政策下,绿色标签可能是合规的,但仍可能将关乎采购成败的核心疑问悬而不决。扩大规则以暂扣每一项敏感的排除决定能够覆盖更多案例,但同时也会将更多的决策推给人工审核。团队需要清醒而审慎地权衡这一工作负荷。
同样的权责划分原则适用于AI生成解释。MeritLens在开展咨询性要素审查之前,会先行保存确定性的闸门决策和审计日志。已生成的模型解释可以针对未变更的输入直接复用,而核心决策的运行并不依赖实时模型调用。咨询性文本可以解释或质疑要素的理解方式;但它绝不能篡改数值证据或已保存的结果。因此,具有说服力的措辞发挥着明确的作用,却绝不能演变成直接推进流程的通行证。
如果您希望亲眼目睹其实际运行,而不是听我在此描述,这里提供了整套系统从头到尾端到端运行的完整演示。
在评估采购AI系统时,我希望采购方能够完整复现一项排除决定的全过程:原始得分、支撑各要素的证据、改变资格的底层假设、依然残存的劣势,以及管辖下一步行动的确切规则。当替代得分让这种判断变得更加精确时,它才赢得了立足之地。最终的职责始终在于坚定地捍卫采购决策,包括团队经过深思熟虑后主动选择承担的那部分不确定性。