Die naive Baseline in meinem Radar-Sturzdetektor erreichte denselben Recall von 1,0. Sie löste aber auch sieben Fehlalarme in einer einzigen Nacht aus.

In der synthetischen Nachtschicht, die ich für Vigil aufgebaut habe, löst die Standard-Baseline zwischen 02:00 und 06:00 Uhr neun Alarme aus, und sieben davon sind falsch. Ein Deckenventilator, erfasst bei einer Spitzengeschwindigkeit von 5,0 m/s. Ein Therapiehund, Radarquerschnitt 0,27. Ein Bewohner, der sich mit 2,92 m/s hart auf einen Sitz setzt. Zwei dieser neun Alarme sind echte Stürze, und einer davon ereignet sich im Badezimmer: Eine Schwerpunktspur verläuft vom Stehen bei 1,53 m abwärts über 1,07, 0,84, 0,625 und 0,344, bevor sie sich bei 0,119 m einpendelt – Bodenniveau, Atmung vorhanden, keine Erholung.
Jedes Ereignis in dieser Schicht ist synthetisch, gelabelt und physikalisch fundiert, generiert aus einem festen Seed – und ich habe beide Detektoren geschrieben. Aus diesem Grund kann ich den unangenehmen Teil ganz offen aussprechen: Die Baseline hat diesen Sturz im Badezimmer ebenfalls erkannt.
Vigil ist die Intelligenzschicht, die ich entwickelt habe, um in Seniorenresidenzen zwischen einem Radar-Merkmalsstrom und einer Schwesternrufanlage zu vermitteln. Sie liefert ALERT, SUPPRESS oder ROUTE TO HUMAN, jeweils versehen mit einer Begründung, die eine Einrichtung revisionssicher ablegen kann. Die Demo-Route lautet https://veriprajna.com/demos/smart-facility-fall-detection. Ich begann die Entwicklung unter der Annahme, dass der schwierige Teil darin bestünde, den Sturz zu erkennen. Der Benchmark belehrte mich bereits beim ersten Durchlauf eines Besseren.
Der Recall war die Zahl, mit der ich eröffnen wollte
Ich führte den Benchmark in der Erwartung durch, dass die Sturz-Sensitivität die Schlagzeile sein würde, und es ist eine gute Zahl: 1,0 Recall für die Kaskade über ein festes Set von 360 gelabelten, verrauschten synthetischen Ereignissen. Die Spalte daneben war es, die den Artikel veränderte, den ich eigentlich schreiben wollte. Die naive Baseline besteht aus zwei arithmetischen Klauseln; jede schnelle oder bodennahe Bewegung gilt als Sturz (peak_v > 2.0 OR min_cz < 0.45), und auf demselben Set erreicht sie ebenfalls einen Recall von 1,0. Das Marketing für Sturzerkennung lebt von der Sensitivität, und beide Detektoren stehen ganz oben an der Spitze.
Die Differenzierung liegt vollständig in der Zeile, die niemand auf einer Folie zeigt. Die Störfaktor-Spezifität liegt bei 1,0 für die Kaskade und 0,167 für die Baseline, was einer Fehlalarmrate von 0,833 pro harmlosem Ereignis entspricht. Rechnet man das auf die 30 harmlosen Bewegungsauslöser pro Zimmer und Tag hoch, die der Benchmark annimmt, landet die Baseline bei 25,0 Fehlalarmen pro Zimmer und Tag. Die in der Fachliteratur publizierte Spanne für etablierte Standardsensoren liegt bei 5 bis 15 Fehlalarmen pro Zimmer und Tag, und Alarmmüdigkeit – nicht etwa die Sensorsensitivität – ist nachweislich der Hauptgrund für das Scheitern solcher Systeme.
Ich sollte dies erwähnen, bevor eine technisch versierte Leserschaft es für mich tut. Die Fusionsgewichte in data/fall_model.json wurden angepasst durch tools/fit_fall_classifier.py an den demoeigenen Szenariengeneratoren, denselben Generatoren, die das 360-Ereignisse-Set erzeugen. Das ist der stärkste Einwand, den man gegen meine beiden 1,0-Werte vorbringen kann, und genau deshalb bedeutet mir der Wert von 0,167 mehr als jeder der beiden. Das Scheitern der Baseline ist kein Artefakt meines Trainings-Setups. Es ist das, was ein Schwellenwert tut, wenn es auf der Welt Deckenventilatoren gibt.
Die sieben Fehlalarme entscheiden darüber, ob überhaupt noch jemand hinhört, wenn der echte Sturz eintrifft.
Die Störfaktoren wurden gezielt darauf ausgelegt, ein einzelnes Merkmal auszuhebeln
Mein erster Instinkt war, den Klassifikator zu verbessern, und es war der falsche Instinkt. In der Anfangsphase der Entwicklung behandelte ich dies als Diskriminierungsproblem: Finde das Merkmal, das einen Sturz von einem Nicht-Sturz trennt, gewichte es stark, und weiter geht's. Die Szenariengeneratoren, die ich bereits geschrieben hatte, machten genau das mit voller Absicht unmöglich.
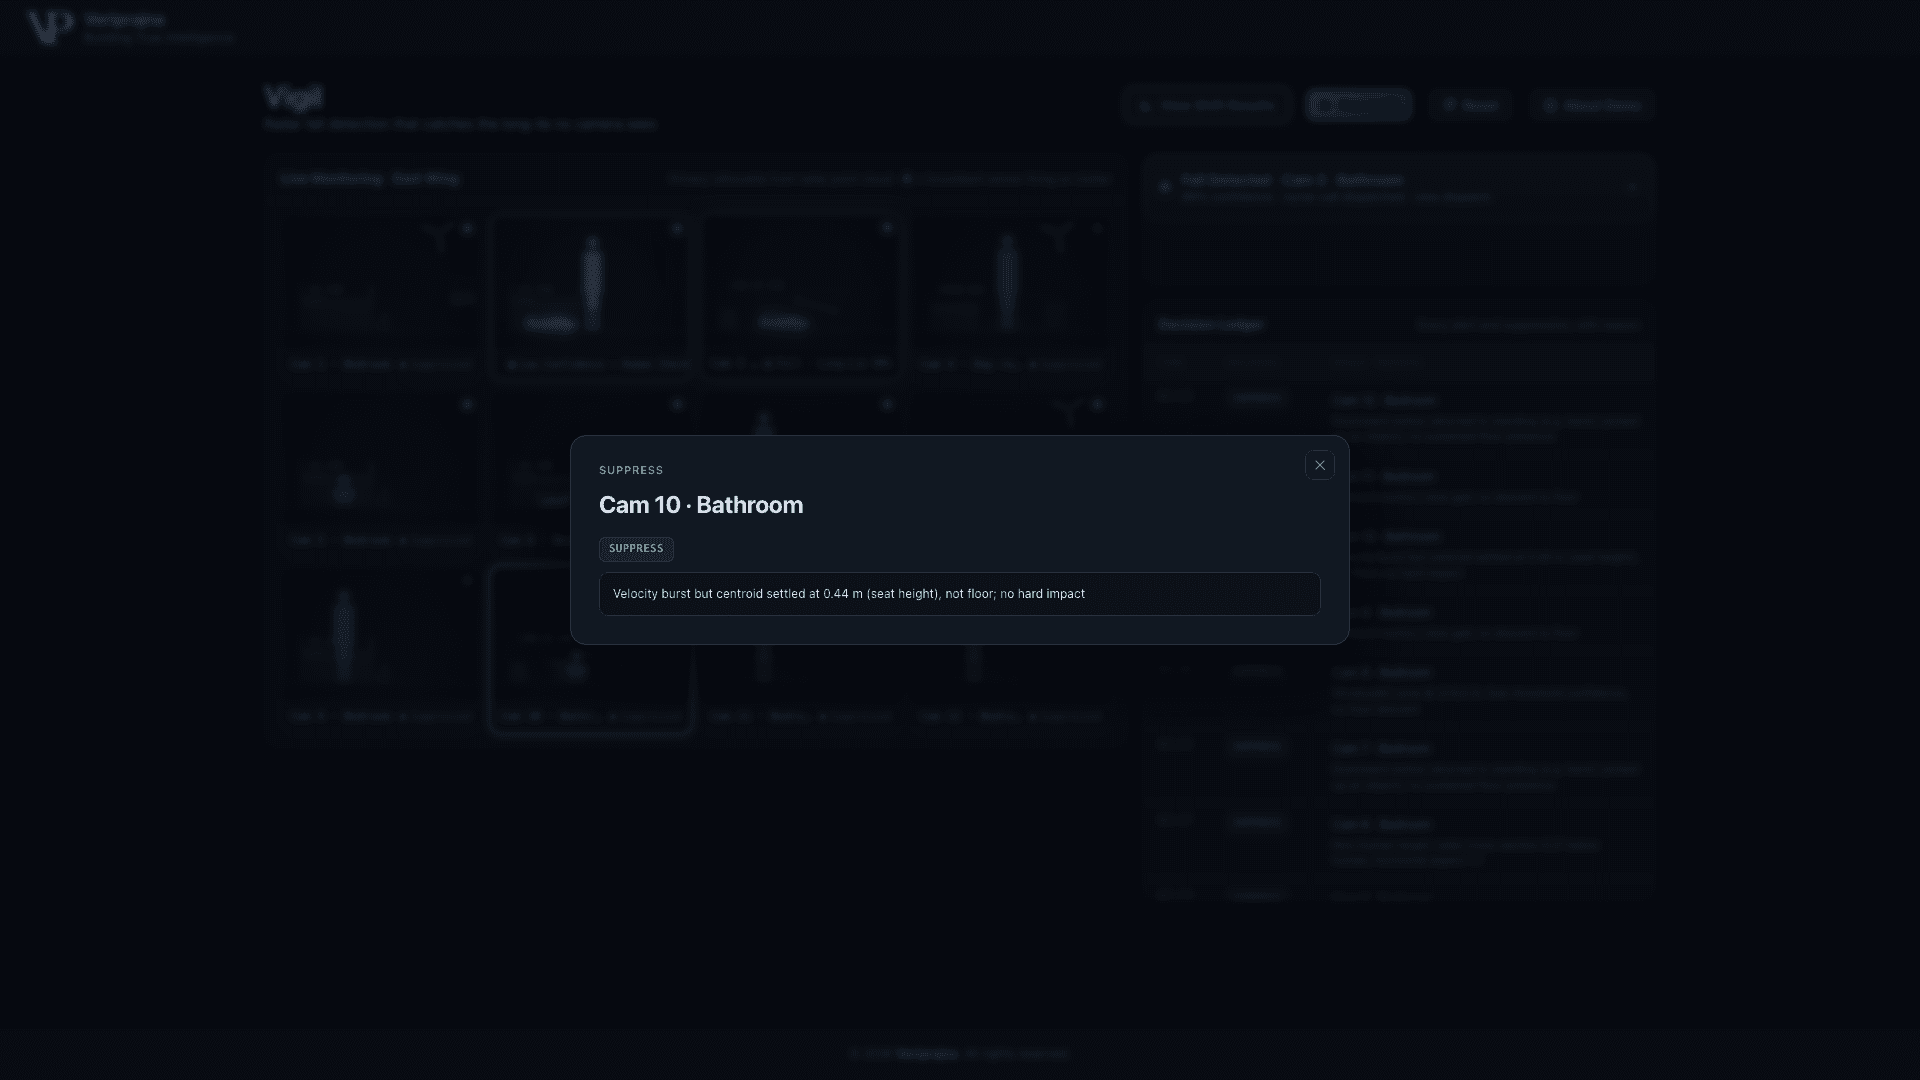
Jeder Störfaktor wird generiert, um sich bei einem einzelnen Merkmal mit einem echten Sturz zu überschneiden. Das harte Hinsetzen bei Cam 5 weist einen Geschwindigkeitsschub von 2,92 m/s auf – das Ausmaß eines Sturzes – und pendelt sich bei 0,46 m ein. Sein Pendant im Badezimmer bei Cam 10 erreicht in der Spitze 3,31 m/s und pendelt sich bei 0,44 m ein. Der Therapiehund und das Bücken nach einem Handtuch senken beide den Schwerpunkt ab, was der anderen Hälfte der Baseline-Regel entspricht. Jeder einzelne Test, den ich hätte schreiben können, wurde konstruktionsbedingt ausgehebelt; deshalb lässt sich die Baseline bei 0,167 wirklich täuschen und nicht etwa durch einen von mir konstruierten Strohmann.
Die Geschwindigkeit war das Merkmal, bei dem ich mir am sichersten war, und genau sie hat es nicht in den Klassifikator geschafft. Was überlebt hat, ist ein logistisches Modell über vier Merkmale – Bodennähe, Aufprallenergie, Fallhöhe und ein Proxy für den Radarquerschnitt –, fusioniert zu einem kalibrierten P(fall). Kein Geschwindigkeitsterm fließt in P(fall) ein. Im Docstring des Moduls gibt es noch eine veraltete Zeile aus der Zeit, als ich dachte, dass er es würde. Es ist reines NumPy, schlank genug, dass jemand classifier.py öffnen und das Ganze komplett im Kopf behalten kann – was mir auf einem lebenssicherheitskritischen Pfad mehr wert ist als ein weiterer Punkt AUC.
Ich zeige die Unterdrückung bei Cam 10 immer als Erstes, weil das Panel die gesamte Diskrepanz in einer einzigen Zeile auf den Punkt bringt.
Vier Bedingungen, ein einziges 8-Sekunden-Fenster
Ich habe den zeitlichen Narrativ-Verifizierer so konzipiert, wie ich ihn mir als Außenstehender wünschen würde. temporal.py erfordert vier Bedingungen innerhalb desselben 8-Sekunden-Fensters, wobei im ersten Fünftel ein Stehen nachgewiesen sein muss: ein medianer Schwerpunkt von über 1,2 m, ein Absinken um mehr als 0,6 m zusammen mit einer Spitzengeschwindigkeit von über 1,8 m/s an irgendeiner Stelle im Fenster, ein anhaltender breitbandiger Aufprall, dessen gleitender Mittelwert über 3 Frames 0,50 überschreitet, und das tatsächliche Absinken des Schwerpunkts unter 0,30 m. Der Test auf anhaltenden Aufprall existiert, weil eine Spitze in einem einzelnen Frame leicht auftritt, ein auf den Boden aufschlagender Körper jedoch nicht.
Der Begründungsstring, den die App ausgibt, lautet „standing → descent → impact → floor“ – so, wie eine Pflegekraft einen Vorfall liest. Die Implementierung verknüpft diese Bedingungen über das Fenster hinweg jedoch mit einem logischen UND, statt eine strikte Reihenfolge zu erzwingen. Es handelt sich nicht um eine State-Machine, und ich schreibe das lieber selbst offen auf, als dass ein Ingenieur es im Quellcode entdeckt und sich fragt, was der Text sonst noch geglättet hat.
Erst danach ergänzt das Gate eine Atembestätigung von über 0,20 sowie eine Sturzkonfidenz von mindestens 0,70. Diese drei Werte – Bodenniveau 0,30 m, Atmung 0,20 und die Konfidenzuntergrenze von 0,70 – liegen als reiner Code außerhalb jedes Modells. Auf die Richtung kommt es an: Die deterministischen Bedingungen müssen erfüllt sein, bevor der Score des Modells überhaupt herangezogen wird, sodass ein Konfidenzwert niemals von sich aus einen Alarm fabrizieren kann. Ein niedrigeres P(fall) kann einen ALERT immer noch in ein SUPPRESS umwandeln – genau die richtige Asymmetrie für eine Schicht, die schweigen darf, aber nichts erfinden darf. Ein weiterer maßgeblicher Schwellenwert befindet sich außerhalb dieses dokumentierten Blocks: ein fest codiertes p_fall >= 0.40 in gate.py, das ein Mehrpersonen-Ereignis allein anhand des Modell-Scores zur menschlichen Überprüfung weiterleiten kann. Ich nenne ihn ausdrücklich, weil die Formulierung „drei dokumentierte Schwellenwerte“ sonst mehr verspricht, als sie tatsächlich leistet.
Die Unterdrückungen sind die Nachweise, nach denen eine behördliche Prüfung tatsächlich fragt
Ich habe das Decision Ledger gebaut, noch bevor ich irgendetwas geschaffen habe, das wie ein Produkt aussieht. Denn die Frage, die ich nicht beantworten konnte, war nie: „Habt ihr den Sturz erkannt?“. Sie lautete: „Warum wurde um 2:13 Uhr in Raum 203 kein Alarm ausgelöst?“ – und die Antwort muss bereits schriftlich vorliegen, sobald jemand danach fragt. Zehn der zwölf Ereignisse in dieser Schicht sind Unterdrückungen, und jedes einzelne trägt die protokollierten Merkmalswerte mit sich: das nicht-menschliche Ziel an Cam 6 mit einem Radarquerschnitt von 0,27 gegenüber einem menschlichen Minimum von 0,55; das Bücken an Cam 7 und Cam 12, bei dem der Schwerpunkt bei 0,60 m und 0,59 m stoppt, mit einer Aufprallenergie von 0,07 gegenüber einem Schwellenwert von 0,50.
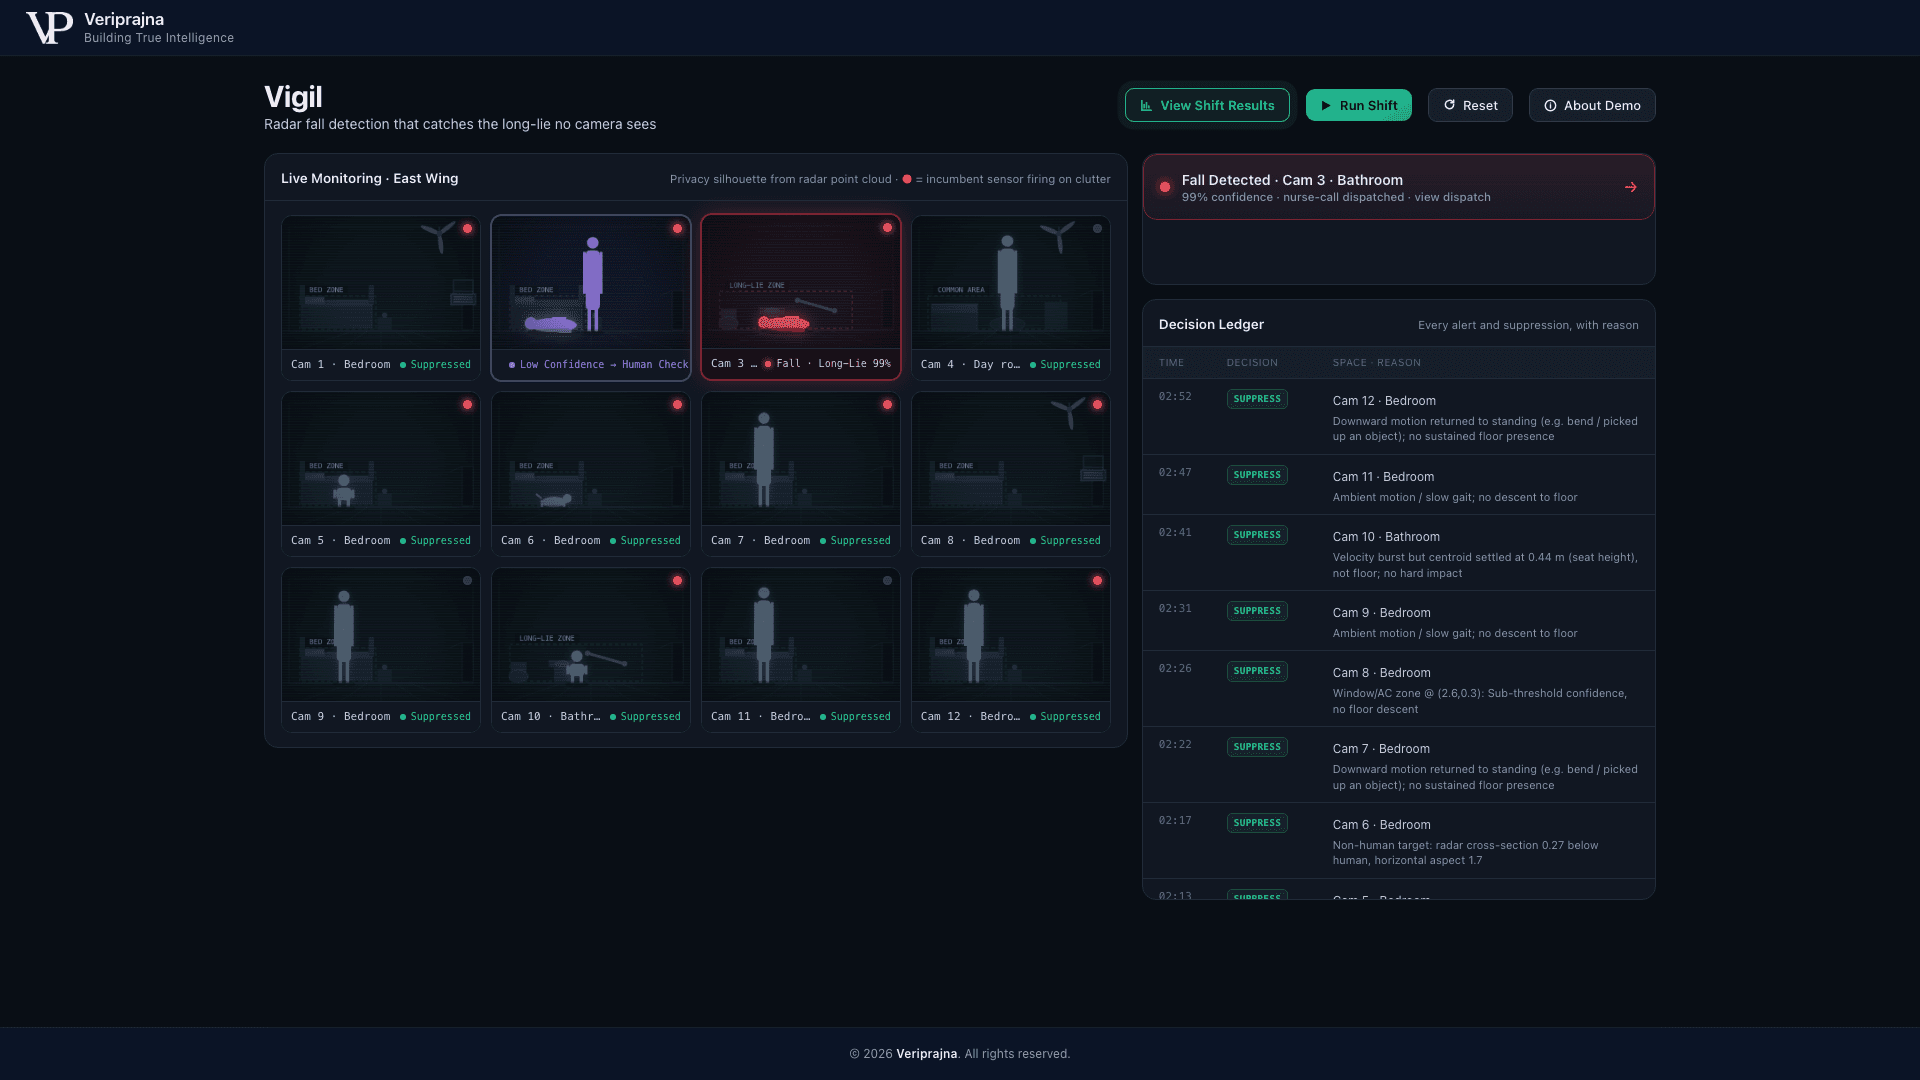
Diese zehn unterdrückten Zeilen sind genau das, wonach ein Prüfer fragt – denn es sind die Ereignisse, bei denen nichts passiert ist und dennoch jemand erklären muss, warum.
Nur ein Teil der zimmerspezifischen Kalibrierung fließt tatsächlich in eine Entscheidung ein. Der Deckenventilator an Cam 1 wird unterdrückt, weil die Clutter-Map von Raum 214 einen ortsfesten Doppler-Eintrag bei (1,5, 1,5, 2,45 m) enthält und check_clutter ihn an diesem Voxel maskiert. Dieser Pfad ist echt. Die zimmerspezifischen Sitz- und Betthöhen in rooms.json, 0,42 m im Badezimmer von Raum 118 und 0,45 m in Raum 203, sowie die Haltegriff-Einträge daneben sind Kalibrierungsdaten, die von keinem V1-Codepfad gelesen werden; der Sitzbereich, den ich zur Kennzeichnung eines harten Hinsetzens verwende, ist ein einziger globaler Test von 0,38 bis 0,60 m. Es gibt in dieser Datei sogar einen long_lie_sec: 180.0-Schlüssel, den nichts ausliest. Die zimmerspezifische Kalibrierung ist die Integrationsarbeit, für die man bei einem realen Einsatz bezahlt, und in diesem Build sind lediglich die Doppler-Masken mit einer Entscheidung verknüpft.
Der Export ist ein Schichtprüfungs-JSON, das jeden Alarm, jede Weiterleitung und jede Unterdrückung mit den ausschlaggebenden Merkmalswerten und der Richtlinienbegründung abdeckt – genau das, was eine CMS F689- oder QAPI-Dokumentenmappe erfordert. Der klinische Vorfallbericht wird separat aus diesen strukturierten Belegen generiert und im Vorfallpanel angezeigt, nicht innerhalb des JSON.
Der Alarm, den ich zuließ, und der Sturz, den ich nicht bestätigen ließ
Ich habe den Höhepunkt der Schicht ganz bewusst in ein Badezimmer gelegt. Es ist der Raum mit dem höchsten Risiko und der einzige Ort, an dem eine Kamera keine brauchbare Option darstellt: Neunzehn US-Bundesstaaten haben Gesetze über Kameras in Pflegeheimzimmern erlassen, die diese im Zimmer eines Bewohners mit dessen Einwilligung generell erlauben, während Badezimmer aus Datenschutzgründen in der Praxis ausgeschlossen bleiben. Radar-Merkmale enthalten kein Bild – genau deshalb können sie dort eingesetzt werden, wo eine Kamera nicht hin darf.
Cam 3 ist dieses Ereignis, und Vigil liefert ALERT, Kategorie long_lie, Konfidenz 0,99, Liegezeit am Boden 4,8 s, wobei die Eskalationsleiter scharfgeschaltet ist: Pflegeassistenz (CNA) sofort, Stationsleitung (Charge Nurse) nach 90 s und Pflegedienstleitung (DON) nach 180 s. Der Text auf dem Schwesternruf-Badge lautet „Room 118B Bathroom: Fall Detected, 99% confidence. Resident on floor 5s. Breathing confirmed.“ Die Weiterleitung sendet sowohl ein herkömmliches Rauland-Potenzialfreikontakt-Signal als auch eine Ascom/Austco-MQTT/REST-Payload, und beides läuft über einen protokollierten Adapter-Stub. An all dem ist keinerlei Schwesternruf-Hardware angeschlossen. Der Grund, warum es sich dennoch lohnt, das zu bauen, ist das lange Liegen: Die Hälfte der älteren Menschen, die länger als eine Stunde auf dem Boden liegen, verstirbt innerhalb von sechs Monaten.
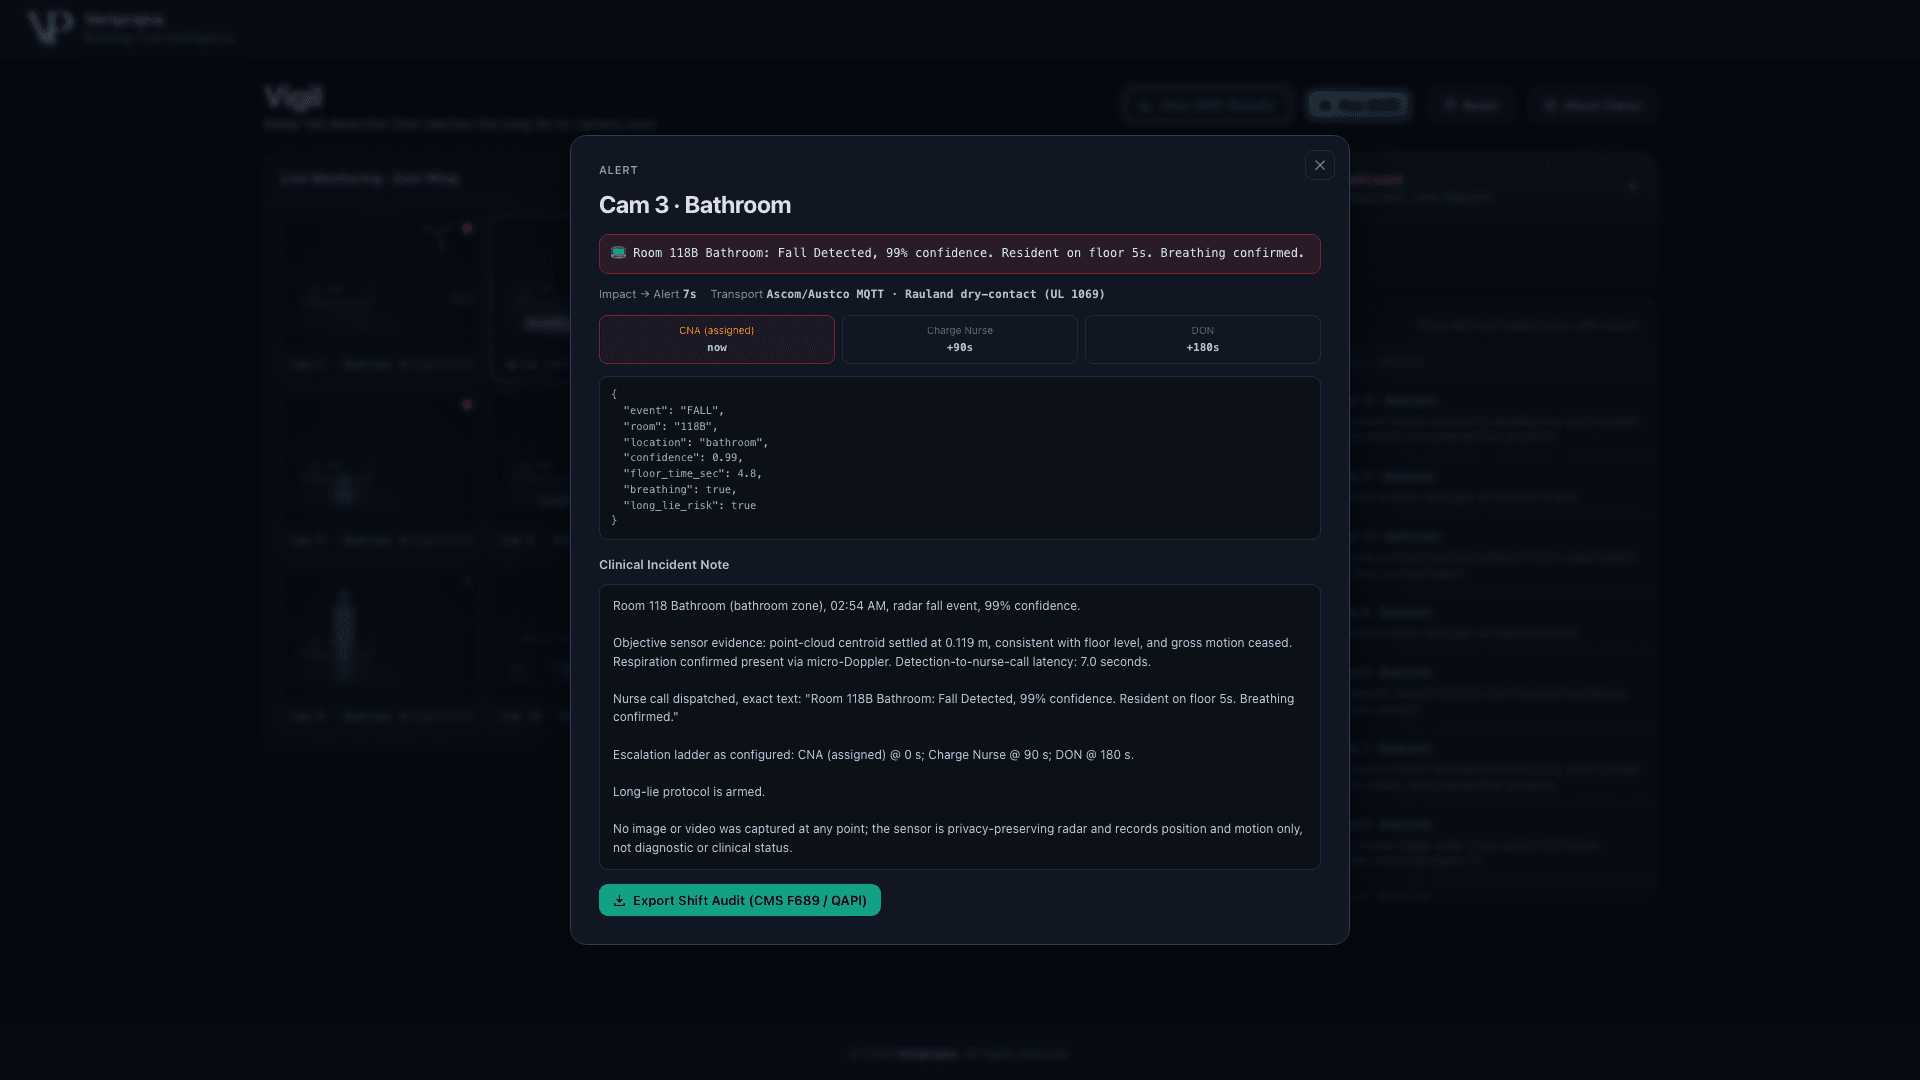
Eine Zahl auf diesem Panel weigere ich mich anzupreisen. Die 7,0 Sekunden vom Aufprall bis zum Alarm werden berechnet in gate.py als Haltetimer plus drei Sekunden, eine Konstante. Die App zeigt dies an, und ich zitiere die Anzeige, aber es ist reine Arithmetik und keine gemessene Systemgeschwindigkeit – und dies als gebenchmarkte Latenz zu bezeichnen, wäre jene Art kleiner Unwahrheit, die einen um die großen Wahrheiten direkt daneben bringt.
Das Ereignis, auf das ich stolzer bin, ist jenes, das Vigil ablehnt. Cam 2 ist ein echter Sturz in der Ground Truth und P(fall) erreicht 0,99, und dennoch bestätigt Vigil ihn nicht: Im Raum befinden sich zwei Zielobjekte, Einzelperson-Tracking liegt außerhalb des V1-Funktionsumfangs, und das Gate liefert ROUTE TO HUMAN at low confidence. Die naive Baseline löst automatisch aus und verbucht einen Treffer, den sie nicht verdient hat. In dieser Schicht gab es zwei echte Stürze. Vigil schlug bei einem Alarm und leitete den anderen an das Personal weiter – und ich werde das nicht als „Erkennen jedes Sturzes“ bezeichnen, denn das ist es nicht. Im gesamten Benchmark werden 40 von 40 Stürzen bei Mehrfachbelegung an einen Menschen weitergeleitet – ohne Überalarmierung und ohne einen einzigen übersehenen Sturz.
Was die Ergebnistafel für sich beanspruchen darf
Die Vorbehaltszeile unter dem Modal „Shift Results“ ist derjenige Teil des Panels, den ich als Erstes entworfen habe. Das Modal weist für unsere Engine in dieser Schicht 0 Fehlalarme gegenüber 7 beim Altsystem aus, 1 von 2 echten Stürzen erkannt, 1 an einen Menschen weitergeleitet, 100 % Störfaktor-Spezifität über 360 gelabelte Ereignisse und 0,0 gegenüber 25 prognostizierten Fehlalarmen pro Zimmer und Tag.
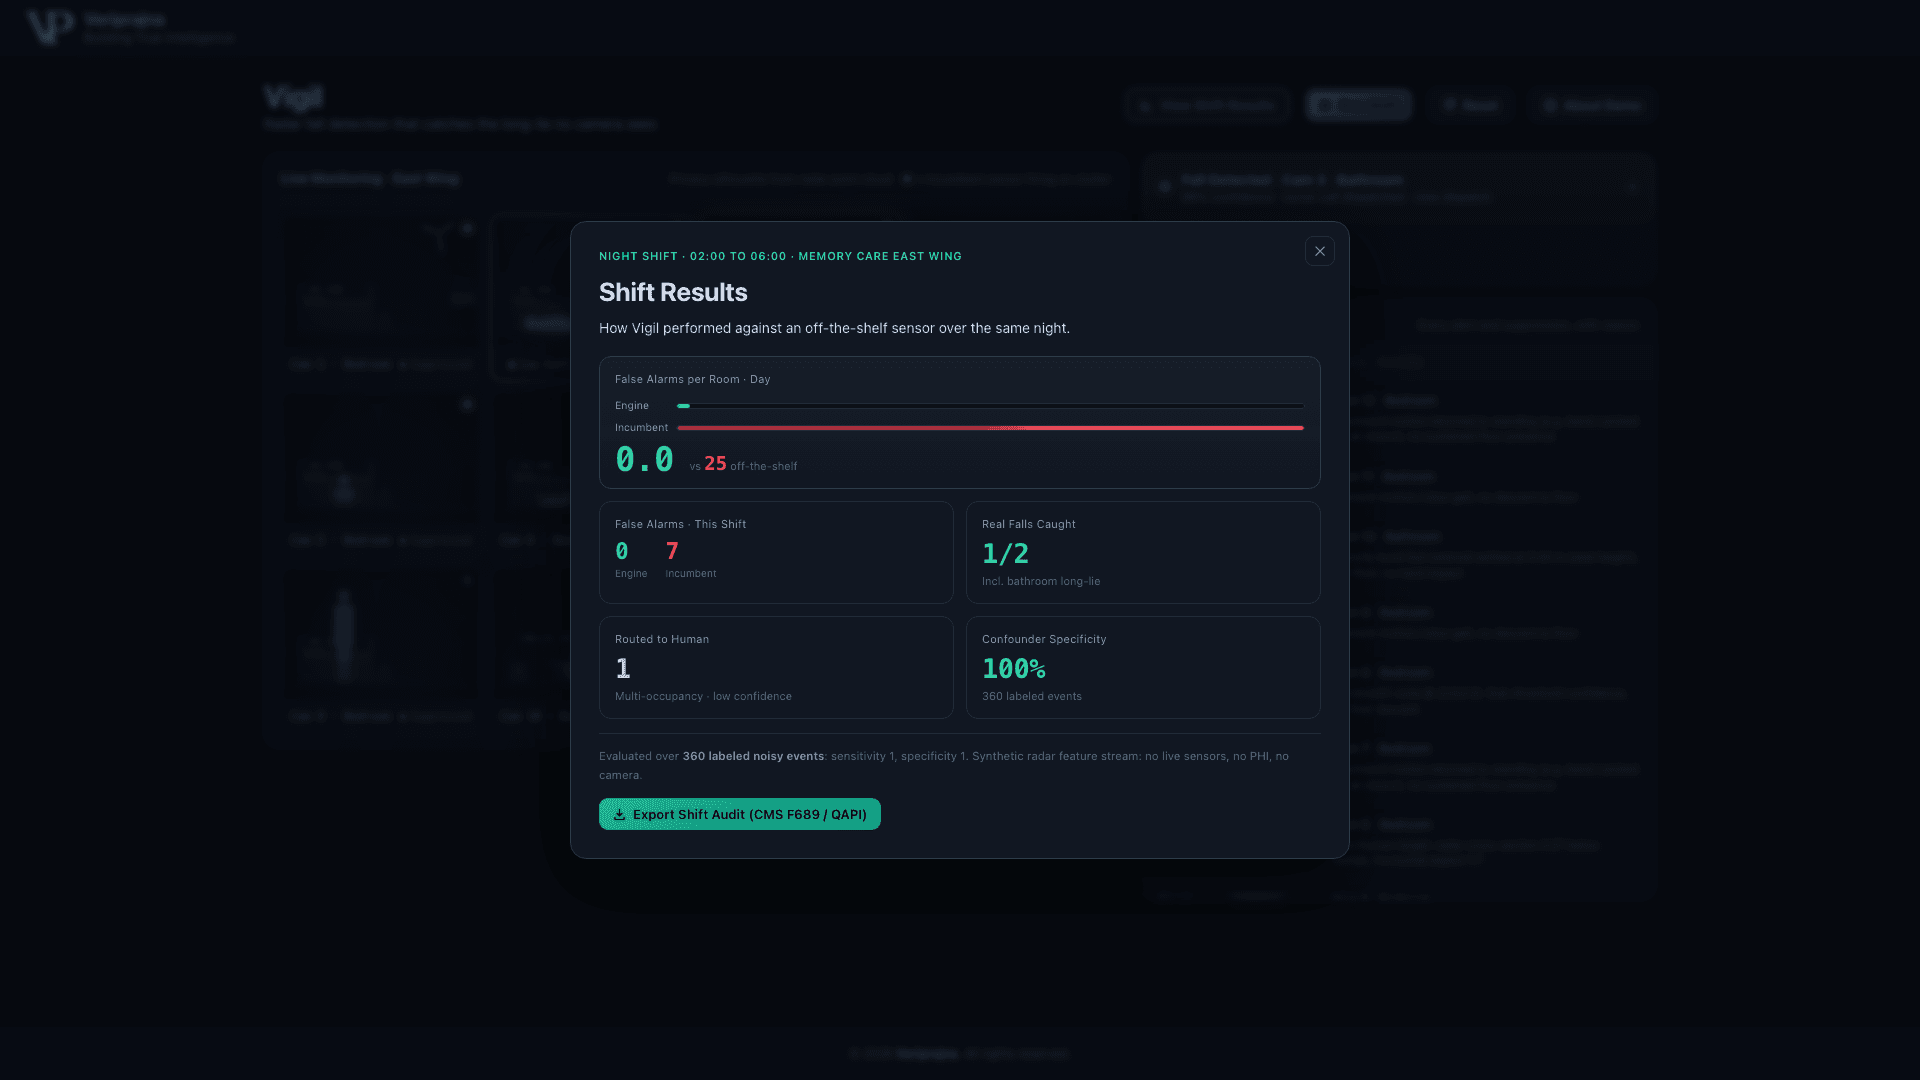
Diese Zahlen beschreiben ein festes, synthetisches Goldstandard-Set und nichts anderes. Keine Produktionsgenauigkeit, kein klinisches Ergebnis, kein validierter medizinischer Anspruch und niemals eine Garantie für eine Einrichtung. Ein realer Pilotbetrieb zielt nach einer Shadow-Mode-Kalibrierung auf unter 2 Fehlalarme pro Zimmer und Tag ab, und das ist die Zahl, die ich einer Pflegedienstleitung vorlegen würde, weil man mich daran messen kann. Die 0,0 ist der Beleg dafür, dass der Mechanismus auf einem Set, das ich Ihnen aushändigen kann, Stürze von Störfaktoren trennt; sie ist kein Heilsversprechen für ein Gebäude, das ich noch nie betreten habe.
Der Maßstab, an dem ich einen lebenssicherheitskritischen Alarm heute messe
Ich bin aus dieser Entwicklung mit einer deutlich präziseren Definition dessen hervorgegangen, was eine Sturzerkennung wirklich können muss. Die reine Erkennung ist ein Schwellenwert – und ein Schwellenwert erzielt auf meinem eigenen Testdatensatz bereits einen Recall von 1,0. Die Leistung, die die Aufmerksamkeit einer Pflegekraft verdient, ist die Verweigerung: die Clutter-Map, die genau weiß, welches Voxel der Ventilator belegt; der Aufpralltest, der sich nicht mit einem einzelnen Frame abspeisen lässt; die Bodenerreichungs-Bedingung, die ein hartes Hinsetzen von einem Sturz unterscheidet; und ein Gate, das so formuliert ist, dass eine behördliche Prüfung statt eines Modells nachvollziehen kann, warum das System wie entschieden hat.
Der vollständige Walkthrough ist abrufbar unter https://veriprajna.com/demos/smart-facility-fall-detection, und die zehn unterdrückten Zeilen im Protokoll sind es, an denen sich die Schicht tatsächlich entscheidet.
Und falls Sie die Schicht lieber ansehen möchten, statt meine Beschreibung zu lesen: Hier läuft die gesamte Nacht von Anfang bis Ende durch.
Ein System, das beim Deckenventilator Alarm schlägt, wird innerhalb einer Woche stummgeschaltet – und ein stummgeschaltetes System erkennt überhaupt nichts mehr. Das anspruchsvollste Verhalten, das ich dieser Schicht mitgeben konnte, war die Fähigkeit zur Ablehnung – nachvollziehbar dokumentiert, mit der entscheidenden Kennzahl versehen. Bei Cam 2 lag diese Zahl bei 0,99, und die richtige Entscheidung war dennoch, den Vorfall an einen Menschen zu übergeben.