Enquêter sur les avis coordonnés sans transformer le soupçon en culpabilité

Un avis peut sembler ordinaire alors que le compte qui en est à l'origine participe à une campagne coordonnée. Pour une équipe qui protège une marque, cela impose deux décisions : quelle activité mérite une enquête, et quelles preuves justifieraient une conséquence. Je souhaite qu'un système d'examen rende la première décision utile sans prétendre avoir déjà résolu la seconde.
La distinction importe car la qualité rédactionnelle constitue un indicateur incertain d'indépendance. Une prose soignée ne nous dit pas si plusieurs comptes agissent de concert. Une relation entre comptes ne nous dit pas non plus si les évaluateurs ont été rémunérés ou si leurs critiques sont infondées. Un système qui comprime ces interrogations en un verdict unique contraint son signal le plus fort à répondre à des questions qu'il ne peut résoudre.
Ce que la formulation laisse de côté
Campaign Firewall, notre démonstration de fraude aux avis synthétiques, contient une campagne modélisée de 15 avis sur la fiche d'un concurrent. Tous les enregistrements et historiques de comptes sont synthétiques. Le jeu d'essai qualifie cela de campagne rémunérée entièrement humaine, mais ce libellé décrit le scénario construit ; il ne constitue ni une preuve d'auteur humain réel, ni la preuve qu'un paiement a été perçu.
Onze de ces 15 enregistrements présentent peu d'anomalies d'écriture selon la mesure stylométrique de la démo, qui analyse les motifs dans le texte. Quatre présentent une anomalie détectable. La référence locale textuelle seule signale quatre des 15 avis. Interpréter ce résultat comme un jugement sur l'ensemble de la campagne reviendrait à écarter les preuves liées aux comptes des onze autres.
La relation pertinente réside dans l'historique de produits partagé. La démo associe les avis lorsque les historiques modélisés des comptes se chevauchent suffisamment, que les avis concernent la même fiche produit et qu'ils sont espacés de 72 heures au maximum. Le calendrier seul ne crée aucun lien. Dans cet exemple, les historiques qui se chevauchent relient les 15 enregistrements en un groupe. La combinaison de signaux achemine l'ensemble des 15 vers REVIEW, un circuit d'examen humain. Aucun avis n'est supprimé et aucun litige n'est déposé.
Le gain pratique réside dans un objet d'investigation différent. Au lieu de demander à un analyste de décider si chaque phrase semble générée par une machine, le dossier demande pourquoi ces comptes partagent des historiques et concentrent leur activité sur la même fiche dans cet intervalle. Une phrase plausible est compatible avec une coordination. Elle ne peut annuler la preuve relationnelle.
La comparaison ci-dessous présente huit enregistrements illustratifs, plutôt que la campagne complète de 15 avis. Ses lignes supérieures montrent des relations contribuant aux circuits d'examen même lorsque la référence locale ne perçoit aucun signal textuel. Ses lignes inférieures montrent l'erreur inverse : des enregistrements synthétiques étiquetés authentiques que la référence signale et que le système combiné autorise. Les deux situations comptent lorsqu'il s'agit de décider ce qu'un détecteur doit transmettre à un analyste.
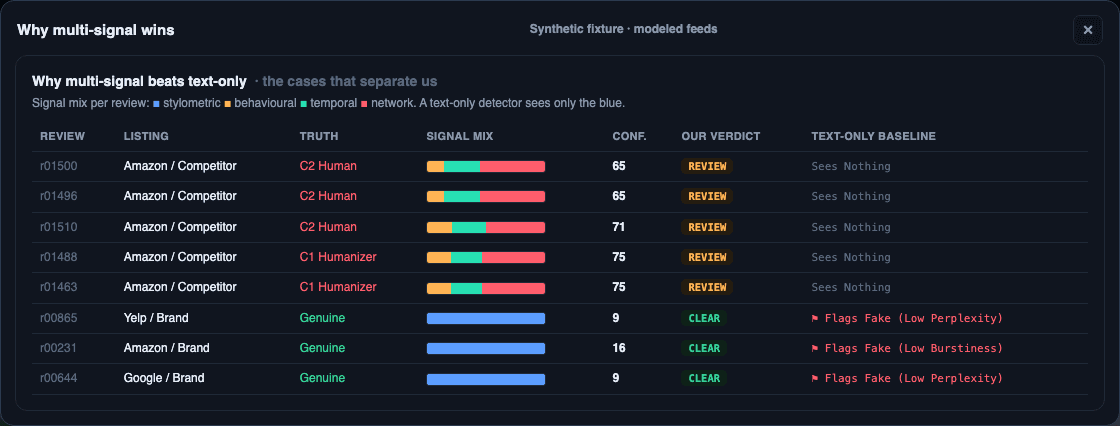
Ces résultats proviennent du même corpus synthétique ayant servi à dériver les percentiles de texte et à ajuster le seuil d'examen. Ils démontrent le chemin décisionnel configuré, et non la performance sur des avis réels inédits. L'exemple établit une distinction de conception : une décision purement textuelle peut manquer des relations pertinentes. Il ne garantit pas que cette combinaison particulière se généralisera de façon fiable.
Un groupe connecté nécessite toujours une explication
La preuve relationnelle mérite un examen attentif, mais la raison d'une connexion reste une question distincte. Imaginez un lancement hypothétique où de véritables acheteurs proviennent de la même communauté de passionnés. Ils peuvent acheter un grand nombre de produits identiques et évaluer une nouvelle fiche dans un court laps de temps. Des historiques qui se chevauchent et un calendrier concentré peuvent refléter un intérêt partagé plutôt qu'une opération rémunérée.
Valider automatiquement chaque groupe de ce type reviendrait à abandonner une piste utile. Le supprimer automatiquement reviendrait à traiter une piste comme une conclusion définitive. Je préfère un circuit intermédiaire qui préserve les relations spécifiques pour examen tout en maintenant visible l'explication non résolue. Ce choix a un coût : il crée du travail pour les réviseurs, et une file d'attente surchargée peut retarder l'attention portée aux cas plus évidents. Qualifier ce circuit d'examen humain ne fait pas disparaître ce problème de capacité.
Pour un futur système, j'évaluerais ce coût à l'aide d'exemples où des comptes légitimes partagent des centres d'intérêt, ainsi que de cas de coordination délibérée. La décision consiste à déterminer si les relations supplémentaires produisent des investigations exploitables par un analyste, à un volume que l'équipe peut réellement traiter. Un score plus élevé sans motif vérifiable n'aide guère à y répondre. Réduire la file d'attente en ignorant silencieusement les comptes connectés masque également ce compromis.
L'enquête doit ensuite distinguer ce que les preuves existantes peuvent résoudre de ce qui nécessite des informations complémentaires. Un analyste peut inspecter les historiques qui se chevauchent, la part du lien attribuable au calendrier, et vérifier si la même fiche explique cette concentration. Établir un paiement ou des déclarations mensongères exigerait des preuves allant au-delà de ces relations. Ce sont des questions d'examen proposées, et non des fonctionnalités fournies par cette démo synthétique via un accès direct à une plateforme.
Cela modifie la façon dont j'interprète un circuit d'examen. Il s'agit d'une allocation d'attention fondée sur une raison explicite. Il doit être possible de contester cette raison, d'enregistrer une explication bénigne ou de conclure que les preuves disponibles sont insuffisantes. Si le flux de travail n'autorise qu'à confirmer la suspicion du détecteur, cette étape intermédiaire a perdu sa raison d'être.
L'explication peut devenir une autre source de certitude trompeuse
Il existe un second endroit où cette distinction peut s'effondrer : le récit d'investigation. Un paragraphe fluide peut transformer « ces historiques se chevauchent » en « ces évaluateurs ont été rémunérés » sans apporter de preuves supplémentaires. La langue fournit une explication apparente à un motif dont la cause demeure non résolue.
Dans Campaign Firewall, la notation déterministe attribue les circuits avant qu'une passerelle Codex optionnelle ne génère un récit. La vidéo du fondateur associée rejoue une réponse Codex mise en cache, plutôt que de montrer une inférence en direct pendant la capture. La prose générée ne peut pas modifier les niveaux attribués. Cette séparation protège la décision de notation vis-à-vis du récit, mais un analyste pourrait toujours être influencé par une phrase non étayée dans l'explication.
La démo applique un filtre d'ancrage heuristique fondé sur le chevauchement numérique et lexical, assorti d'une vérification des verdicts inversés. Il peut éliminer la prose non fondée ; il ne prouve pas que chaque phrase conservée est vraie. Une phrase peut réutiliser les chiffres exacts tout en exagérant leur portée. Conserver l'accès aux relations sous-jacentes fait donc partie du rôle du réviseur, et non d'une tâche accomplie par un filtre validé au vert.
Je souhaite que le récit aide à examiner une inférence, y compris celle qu'il ne peut soutenir. Si un projet affirme que les comptes ont été rémunérés, le réviseur a besoin d'une preuve de paiement. Répéter la taille du groupe ou son score ne peut combler cette lacune. Si cette preuve fait défaut, l'allégation doit rester non résolue même si le schéma de comptes mérite une enquête. La préparation d'un projet de litige doit préserver cette limite jusqu'à toute décision ultérieure ; ici, le projet demeure non déposé.
Voici la présentation détaillée de cet exemple synthétique par le fondateur.
La présentation de Campaign Firewall montre les preuves relationnelles synthétiques et le dossier d'enquête sous-jacents à cet exemple. Pour un décideur technique, la question d'évaluation utile est de savoir ce qui se produit lorsqu'une connexion admet plusieurs explications plausibles. Un système mérite un circuit d'examen en mettant en évidence la connexion. Une action lourde de conséquences exige des preuves qui tranchent la raison d'agir, et un moyen explicite de s'arrêter lorsque ces preuves manquent.