Risque réglementaire et préparation au contentieux
Nous préparons les systèmes d'IA à un examen juridique contradictoire : documentation de niveau contentieux, préservation des preuves, préparation à la communication de pièces (discovery) et défense multi-juridictionnelle.
Votre système d'IA est-il défendable face à un examen contradictoire ?
Notre approche consiste à bâtir l'infrastructure technique conçue pour rendre les systèmes d'IA défendables face à un examen juridique — non pas conformes au sens du cochage de cases, mais défendables au sens où un avocat plaidant peut expliquer à un jury comment une décision a été prise, où un représentant désigné de l'entreprise au titre de la règle 30(b)(6) peut témoigner du comportement du système sans nuances évasives, et où un témoin expert peut résister à une contestation de type Daubert concernant l'interprétabilité du modèle.
Il s'agit d'un travail d'ingénierie, non de rédaction de politiques. Une mission est cadrée pour produire des architectures de préservation des preuves, une documentation de niveau contentieux et des artefacts prêts pour la phase de communication de pièces (discovery) qui existent avant que quiconque n'intente une action.
Ce ne sont pas des risques hypothétiques — ce sont des contentieux actifs assortis de dommages-intérêts réels, d'ordonnances de communication de pièces réelles et d'exigences de remédiation réelles. La question pour les organisations qui déploient l'IA n'est pas de savoir si elles s'exposent juridiquement. C'est de savoir si leurs systèmes peuvent survivre à ce qui vient ensuite : une communication de pièces contradictoire, les dépositions des ingénieurs qui ont conçu les modèles, un témoignage d'expert sur la provenance des données d'entraînement et des examens réglementaires où « nous avons utilisé un outil fournisseur » ne constitue pas une défense — une posture que nous remplaçons par une infrastructure détenue en propre, comme le montre une démonstration fonctionnelle d'un déploiement de LLM souverain et privé.
À quoi ressemble la communication de pièces dans les affaires d'IA (et pourquoi la plupart des entreprises y échouent)
En septembre 2025, le district sud de New York a établi des normes de communication de pièces relatives à l'IA dans le contentieux sur le droit d'auteur d'OpenAI. Les tribunaux imposent désormais la production d'un ensemble de base d'artefacts, et les avocats des plaignants dans les affaires de discrimination algorithmique vont considérablement plus loin.
L'ensemble de base que les tribunaux imposent désormais
- Requêtes des utilisateurs
- Sorties du modèle et brouillons générés par l'IA
- Métadonnées avec horodatages et identifiants de modèle
- Journaux d'accès
- Paramètres de configuration
Ce que les plaignants en discrimination exigent en plus
- Code source
- Composition des données d'entraînement
- Rapports de validation du modèle
- Résultats des tests A/B
- Messages Slack internes concernant des biais connus
- Données de surveillance post-déploiement
- Chaque version du modèle ayant fonctionné en production durant la période considérée
La plupart des entreprises échouent à la communication de pièces de l'une des deux manières suivantes. Soit les preuves n'existent pas parce que personne n'a construit l'infrastructure pour les capturer — ce qui entraîne des sanctions pour destruction de preuves (spoliation) et des instructions d'inférence défavorable. Soit les preuves existent mais paraissent accablantes, parce que les communications internes révèlent que des ingénieurs ont signalé des préoccupations de biais qui n'ont jamais été traitées, ou que des modifications de modèle ont été déployées sans tests documentés.
Notre approche traite ces deux modes de défaillance. Pour le premier, nous concevons des systèmes de préservation des preuves destinés à capturer automatiquement le contexte de décision au moment de l'inférence : le hachage de version du modèle, les caractéristiques d'entrée, l'état du prétraitement, les scores de confiance et les politiques de gouvernance actives. Pour le second, nous concevons des flux de travail structurés de gestion des changements de modèle où chaque modification est documentée avec sa justification, ses résultats de tests et ses chaînes d'approbation — de sorte que le dossier de communication de pièces raconte une histoire cohérente de développement responsable plutôt qu'une itération désordonnée.
Le calendrier d'application réglementaire n'attend pas
Trois grandes échéances d'application convergent au milieu de 2026.
- Le Colorado SB 205 entre en vigueur le 30 juin 2026, avec des pénalités pouvant atteindre 20 000 $ par violation et une défense affirmative disponible uniquement pour les organisations démontrant leur conformité au NIST AI RMF.
- Les obligations à haut risque de l'AI Act de l'UE entrent en application le 2 août 2026, avec des pénalités atteignant 35 millions d'EUR ou 7 % du chiffre d'affaires mondial. L'article 73 exige la notification des incidents graves dans un délai de 2 jours en cas de décès ou de perturbations d'infrastructures critiques, et de 15 jours pour les autres incidents.
- L'application existante par les procureurs généraux des États est déjà en cours : le Massachusetts a réglé une affaire de discrimination dans le prêt par IA en juillet 2025, et 36 procureurs généraux d'États se sont formellement opposés à la préemption fédérale afin de préserver leur pouvoir d'application.
Le paysage de l'application est intérieurement contradictoire. Le CFPB a proposé de mettre fin à l'application de la théorie de l'impact disparate au titre de l'ECOA en novembre 2025, tandis que des procureurs généraux d'États ont intenté des actions pour discrimination par IA au titre des lois UDAP assorties de pénalités par violation. La FTC a annulé son ordonnance sur consentement Rytr en février 2026, puis a publié un cadre complet d'application relatif aux agents d'IA en mars 2026.
Les organisations qui ont bâti des programmes de conformité calibrés sur un signal réglementaire unique sont exposées lorsque ce signal change. Notre approche consiste à concevoir des architectures de défense cartographiées sur les obligations elles-mêmes, et non sur la posture actuelle d'un régulateur donné (éclairée par nos recherches sur la responsabilité algorithmique).
Documentation de niveau contentieux vs documentation de conformité
Il existe une différence significative entre une documentation qui satisfait un audit de conformité et une documentation qui survit à un examen juridique contradictoire.
| Documentation de conformité | Documentation de niveau contentieux |
|---|---|
| Répond à « avez-vous suivi le processus ? » | Répond à « prouvez que cette décision précise n'était pas discriminatoire — avec des preuves qu'un expert adverse ne peut démonter en contre-interrogatoire. » |
| Fiches de modèle conçues pour les praticiens du ML | Documentation de modèle préparée pour une audience Daubert |
Le public, l'examen contradictoire et la norme probatoire sont fondamentalement différents.
Une mission est cadrée pour produire une documentation au niveau de la norme du contentieux : chaque décision d'IA conséquente est reconstituable à partir de son dossier — la version exacte du modèle, les données d'entrée, les valeurs des caractéristiques, l'état du pipeline de prétraitement et la logique de décision sont récupérables des mois ou des années après les faits.
Défenses spécifiques à un domaine que nous documentons
- IA d'emploi : la défense fondée sur la pertinence pour l'emploi et la nécessité commerciale (le cadre de renversement de la charge de la preuve Griggs/Wards Cove au titre du Title VII), documentée au niveau de la conception du système plutôt que comme une rationalisation a posteriori.
- IA de prêt et d'assurance : une méthodologie de test d'impact disparate documentée avec suffisamment de rigueur pour que l'expert statistique d'un plaignant ne puisse contester les tests comme inadéquats.
- IA de logement : la chaîne de preuves montrant que le traitement des titulaires de bons n'a pas été indirectement approché (proxied) par l'historique de crédit ou des facteurs d'endettement — le vecteur d'attaque exact dans les contentieux de type SafeRent, où l'algorithme notait les candidats en utilisant des facteurs désavantageant de manière disproportionnée les locataires noirs et hispaniques (détaillé dans nos recherches sur le mandat d'intégrité algorithmique SafeRent).
Communication de pièces simulée : trouver vos faiblesses avant que la partie adverse ne le fasse
Une mission peut inclure des exercices contradictoires dans lesquels nos ingénieurs endossent le rôle d'un expert technique du plaignant, sondant vos systèmes d'IA pour y déceler les faiblesses qu'un contentieux exploiterait :
- Modifications de modèle non documentées
- Propriétés d'équité non testées entre les groupes protégés
- Évaluations d'impact manquantes
- Lacunes dans la piste d'audit
- Communications internes contredisant les politiques publiées
- Lacunes de provenance des données sapant les affirmations d'intégrité des données d'entraînement
L'exercice est conçu pour produire une évaluation protégée par le secret professionnel — sous le privilège avocat-client lorsqu'il est associé à un conseil externe — faisant apparaître les faiblesses avant qu'elles ne deviennent des pièces à conviction au tribunal.
Il ne s'agit pas d'un exercice sur table. Nous rédigeons les interrogatoires et les demandes de production de documents que la partie adverse signifierait, identifions les détenteurs de dossiers (custodians) dont les fichiers seraient examinés, testons si les systèmes de préservation capturent ce que les tribunaux exigent (selon les normes de communication de pièces relatives à l'IA de 2025 du SDNY), et évaluons si votre représentant désigné au titre de la règle 30(b)(6) peut témoigner sans créer plus d'exposition qu'il n'en résout. Le résultat visé est une feuille de route de remédiation organisée par gravité du risque contentieux, assortie de spécifications d'ingénierie pour combler chaque lacune.
Défense multi-juridictionnelle sans programmes parallèles
Une entreprise ayant des clients dans l'UE, des employés dans le Colorado, des candidats à l'emploi dans l'Illinois et des activités d'assurance dans l'un quelconque des 23 États ayant adopté le NAIC AI Model Bulletin fait face à au moins cinq régimes réglementaires qui se chevauchent pour un seul système d'IA. Construire des programmes de conformité distincts par juridiction ne passe pas à l'échelle, et cela crée des incohérences que les avocats des plaignants exploitent :
« Vous avez déclaré aux régulateurs du Colorado que votre méthodologie de test de biais était X, mais votre évaluation de conformité de l'UE la décrit comme Y. Laquelle est-ce ? »
Notre approche consiste à bâtir un cadre de défense unifié où la norme applicable la plus stricte fixe la référence de base.
- Un protocole de test d'impact disparate qui satisfait la norme de discrimination algorithmique du Colorado SB 205 produit simultanément des preuves pour les exigences de gouvernance des données de l'article 10 de l'AI Act de l'UE et pour la défense fondée sur la nécessité commerciale du Title VII.
- Une procédure de réponse aux incidents qui respecte le délai de notification de 2 jours de l'article 73 satisfait automatiquement la fenêtre de 72 heures du New York RAISE Act et les attentes de notification des procureurs généraux d'États.
Des couches de documentation spécifiques à chaque juridiction génèrent les bons artefacts pour chaque régulateur ou tribunal sans qu'il soit nécessaire de maintenir des programmes parallèles. Lorsqu'une nouvelle loi d'État est adoptée ou que l'AI Office de l'UE publie des lignes directrices d'application, la surcouche est mise à jour. Les contrôles de base changent rarement, car ils sont déjà conçus au plus haut niveau d'exigence.
Responsabilité au niveau du conseil d'administration et la question du devoir fiduciaire
Les défaillances de gouvernance de l'IA créent un risque de responsabilité personnelle pour les administrateurs au titre de la norme Caremark du Delaware. Les conseils d'administration qui n'implantent pas de systèmes de reporting pour le risque lié à l'IA s'exposent à des actions dérivées d'actionnaires. La SEC a classé l'IA parmi ses principales priorités d'examen pour 2025-2026, et les conseils sont censés documenter leurs cadres de supervision de l'IA dans les circulaires de sollicitation de procurations (proxy statements) d'ici la saison des procurations 2026.
Une mission est cadrée pour produire les livrables destinés au conseil d'administration et conçus pour combler cette lacune :
- Des supports de briefing pour les dirigeants qui traduisent le risque technique lié à l'IA en langage de gouvernance
- Des registres de risques cartographiés sur les obligations fiduciaires
- Des systèmes de surveillance qui fournissent aux administrateurs des preuves documentées d'une supervision active
Non pas une présentation trimestrielle — un système d'information structuré fournissant la base permettant de démontrer une supervision de bonne foi du risque lié à l'IA, la norme précise qu'exige Caremark.
Points clés à retenir
- La défendabilité relève de l'ingénierie, non de la politique : les architectures de préservation des preuves, la documentation de niveau contentieux et les artefacts prêts pour la communication de pièces doivent exister avant qu'une action ne soit intentée.
- La communication de pièces relative à l'IA impose désormais les requêtes, les sorties, les métadonnées, le code source, les données d'entraînement et chaque version du modèle en production — capturez le contexte de décision au moment de l'inférence ou risquez des sanctions pour destruction de preuves.
- Trois échéances de 2026 convergent : le Colorado SB 205 (30 juin), les obligations à haut risque de l'AI Act de l'UE (2 août) et la notification des incidents graves de l'article 73.
- Les outils fournisseurs ne transfèrent pas la responsabilité ; un cadre unifié fondé sur la norme la plus stricte, avec des surcouches spécifiques à chaque juridiction, surpasse les programmes parallèles par régulateur.
- La supervision par le conseil du risque lié à l'IA relève désormais d'une question de devoir de diligence au sens de Caremark, étayée par les priorités d'examen de la SEC.
Risque réglementaire et préparation au contentieux
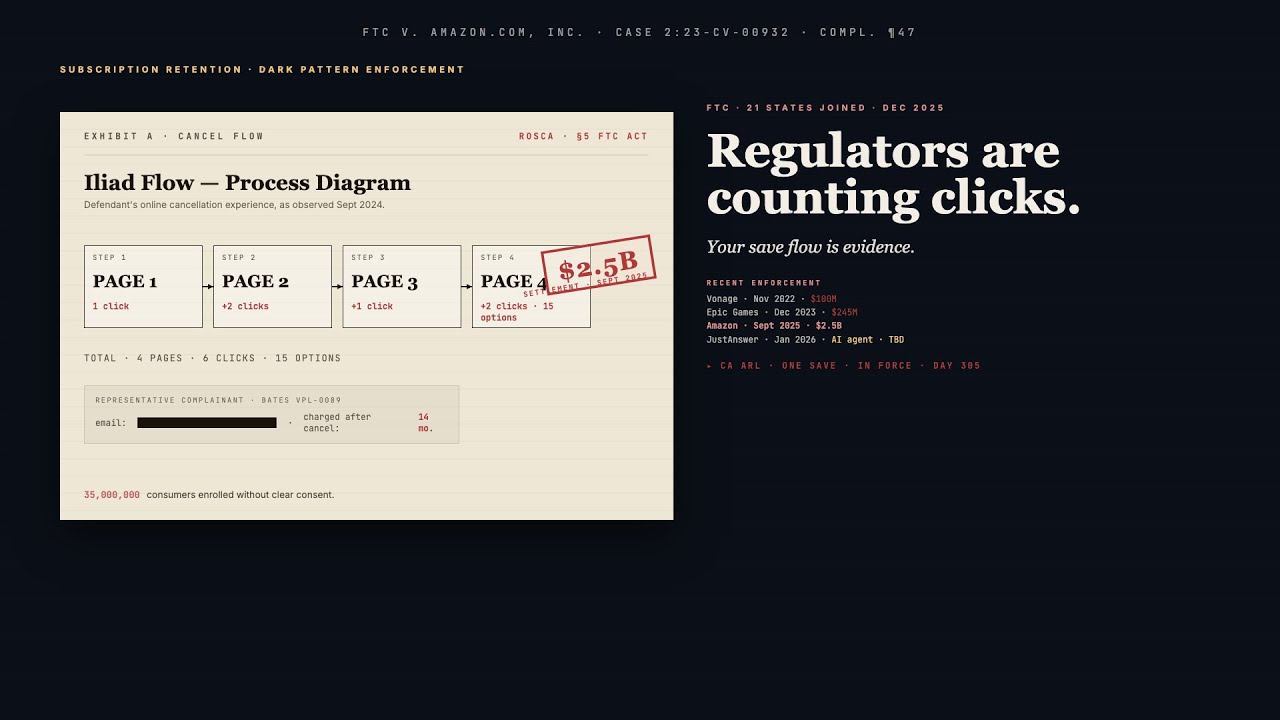 Regarder
IA éthique de rétention par abonnement | Veriprajna
Amazon a payé 2,5 milliards de dollars pour un parcours de résiliation qui exigeait 6 clics. Uber fait face à 21 procureurs généraux d'États au sujet de 23 écrans à franchir pour résilier.
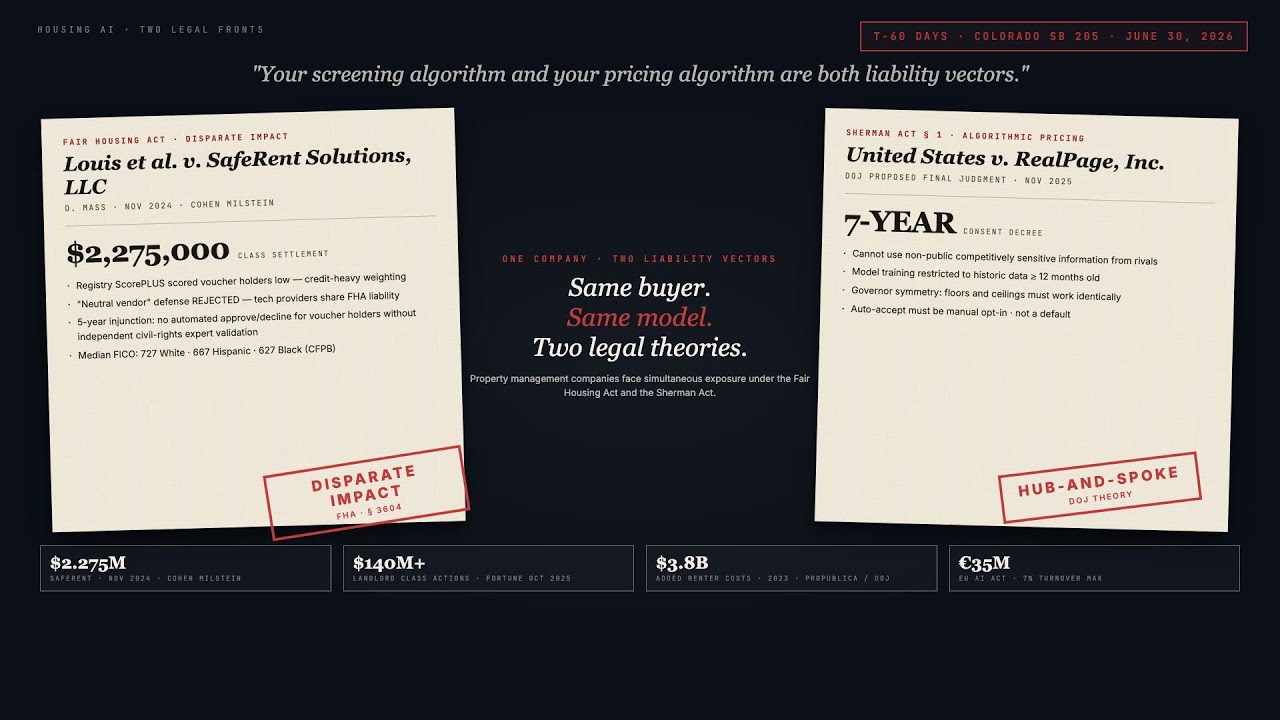 Regarder
Conformité IA pour le logement : équité du screening des locataires et tarification algorithmique | Veriprajna
Les sociétés de gestion immobilière sont exposées juridiquement sur deux fronts simultanément : le screening des locataires qui discrimine au regard du Fair Housing Act, et le revenue management qui coordonne les prix au regard du Sherman Act. Nous auditons les deux, concevons des architectures conformes et cartographions vos systèmes face à chaque juridiction qui compte.
 Regarder
IA souveraine & déploiement de LLM privés | Veriprajna
Une organisation sur cinq a déjà subi une violation de données liée à l'usage d'outils d'IA non autorisés. Interdire l'IA ne fonctionne pas. Construire des alternatives sûres et souveraines, si.
Questions fréquentes
Qu'exige réellement la communication de pièces dans un contentieux lié à l'IA et comment nous y préparer ?
Conformément aux normes de communication de pièces relatives à l'IA du SDNY de septembre 2025, les tribunaux imposent désormais la production des requêtes des utilisateurs, des sorties du modèle, des brouillons générés par l'IA, des métadonnées avec horodatages et identifiants de modèle, des journaux d'accès et des paramètres de configuration. Les avocats des plaignants dans les affaires de discrimination vont plus loin : code source, composition des données d'entraînement, rapports de validation du modèle, résultats des tests A/B, communications internes concernant des biais connus et chaque version du modèle en production durant la période considérée. La préparation consiste à bâtir une infrastructure de préservation des preuves qui capture automatiquement le contexte de décision au moment de l'inférence, et non à l'assembler rétroactivement après la signification d'une assignation. Nous concevons des systèmes qui stockent le hachage de version du modèle, les caractéristiques d'entrée, l'état du prétraitement, les scores de confiance et les politiques de gouvernance actives pour chaque décision conséquente, interrogeables par identifiant de décision, plage temporelle ou classe de résultat.
En quoi la documentation d'IA de niveau contentieux diffère-t-elle des fiches de modèle standard ou de la documentation de conformité ?
La documentation de conformité répond à « avez-vous suivi le processus ? » La documentation de niveau contentieux répond à « prouvez que cette décision précise n'était pas discriminatoire, avec des preuves qu'un expert adverse ne peut démonter en contre-interrogatoire. » Les fiches de modèle conçues pour les praticiens du ML n'ont ni la norme de scrutin contradictoire, ni la chaîne de conservation probatoire, ni la cartographie sur le cadre juridique précis (Daubert pour le témoignage d'expert, Griggs/Wards Cove pour le renversement de la charge de la preuve en impact disparate, FCRA pour les divulgations relatives aux rapports de solvabilité) qu'exige un contentieux. Nous produisons une documentation où chaque décision conséquente est reconstituable à partir de son dossier : version exacte du modèle, données d'entrée, valeurs des caractéristiques, état du pipeline de prétraitement et logique de décision, récupérables des mois ou des années après les faits avec une intégrité inviolable.
Quels sont les repères de pénalités en cas de non-conformité réglementaire de l'IA en 2026 ?
Le paysage des pénalités comporte des chiffres concrets. Colorado SB 205 (en vigueur le 30 juin 2026) : jusqu'à 20 000 $ par violation au titre du Consumer Protection Act, avec une défense affirmative réservée aux organisations démontrant leur conformité au NIST AI RMF. AI Act de l'UE (application aux systèmes à haut risque le 2 août 2026) : jusqu'à 35 millions d'EUR ou 7 % du chiffre d'affaires annuel mondial pour les pratiques interdites, 15 millions d'EUR ou 3 % pour la non-conformité des systèmes à haut risque. Illinois AIVFA : jusqu'à 5 000 $ par violation plus des poursuites privées, avec 37 affaires déposées au cours du premier mois d'application. Dommages-intérêts légaux au titre de la FCRA : de 100 $ à 1 000 $ par violation intentionnelle, qui augmentent considérablement dans les actions collectives comme le procès Eightfold AI couvrant des données sur plus d'un milliard de travailleurs. Les lois UDAP des États autorisent des pénalités par violation sans preuve de préjudice individuel.
Sommes-nous responsables de la discrimination par IA lorsque nous utilisons l'outil d'un fournisseur, et non notre propre modèle ?
Oui. Les employeurs demeurent pleinement responsables des résultats discriminatoires issus des outils d'IA de fournisseurs au titre du Title VII, de la FCRA et des lois d'État sur l'emploi. Dans l'affaire Mobley v. Workday (mai 2025), le tribunal a jugé que le « rôle de Workday dans le processus d'embauche n'est pas moins important parce qu'il se produit prétendument par l'intelligence artificielle plutôt que par un être humain vivant. » L'action collective FCRA contre Eightfold AI vise les employeurs qui ont utilisé l'outil de notation. Le Colorado SB 205 impose des obligations distinctes aux déployeurs, qu'ils aient ou non construit le système d'IA. Vous ne pouvez pas externaliser la responsabilité juridique en externalisant la technologie. Nous aidons les organisations à bâtir l'infrastructure de documentation, de tests et de supervision qui démontre que vous avez exercé une diligence raisonnable sur les outils d'IA de fournisseurs, ce qui est la défense qui compte réellement lorsque la plainte d'un plaignant est déposée.
Comment gérer la conformité de l'IA lorsque les régulateurs fédéraux et étatiques évoluent en sens opposés ?
L'environnement actuel est intérieurement contradictoire. Le CFPB a proposé de mettre fin à l'application de la théorie de l'impact disparate au titre de l'ECOA en novembre 2025, tandis que des procureurs généraux d'États ont simultanément intenté des actions pour discrimination par IA au titre des lois UDAP des États. La FTC a annulé son ordonnance sur consentement Rytr en février 2026, puis a publié un cadre complet d'application relatif aux agents d'IA en mars 2026. Un décret présidentiel de décembre 2025 a proposé la préemption fédérale des lois d'État sur l'IA, mais 36 procureurs généraux d'États s'y sont formellement opposés et, tant que les tribunaux ne se sont pas prononcés, les lois d'État demeurent applicables. Nous bâtissons des architectures de défense cartographiées sur les obligations légales elles-mêmes, et non sur la posture actuelle d'un régulateur donné. Un cadre de contrôle unifié doté de surcouches de documentation spécifiques à chaque juridiction signifie que, lorsque les priorités d'application changent, la surcouche est mise à jour tandis que les contrôles de base tiennent bon.
Qu'est-ce qu'un exercice de communication de pièces simulée et que produit-il concrètement ?
Un exercice de communication de pièces simulée est une simulation contradictoire dans laquelle nos ingénieurs jouent le rôle des experts techniques du plaignant, sondant vos systèmes d'IA pour y déceler les vulnérabilités contentieuses. Nous rédigeons les interrogatoires et demandes de production de documents réels que la partie adverse signifierait, identifions les détenteurs de dossiers (custodians) dont les fichiers seraient examinés, testons si vos systèmes de préservation capturent ce que les tribunaux exigent désormais au titre des normes de communication de pièces relatives à l'IA de 2025 du SDNY, et évaluons si votre représentant désigné au titre de la règle 30(b)(6) peut témoigner sur le système sans créer d'exposition supplémentaire. Le résultat est une feuille de route de remédiation protégée (menée sous le privilège avocat-client lorsqu'elle est associée à un conseil externe) organisée par gravité du risque contentieux, assortie de spécifications d'ingénierie pour combler chaque lacune. Cela diffère d'un audit de conformité parce que nous testons explicitement les faiblesses contradictoires, sans vérifier par rapport à un cadre de conformité.
Les membres de notre conseil d'administration encourent-ils une responsabilité personnelle pour les défaillances de gouvernance de l'IA ?
Au titre de la norme Caremark du Delaware, les administrateurs manquent à leur devoir de diligence lorsqu'ils n'implantent pas de systèmes d'information et de reporting ou ne surveillent pas adéquatement la direction. La gouvernance de l'IA relève désormais pleinement de ce cadre. La SEC a classé l'IA parmi ses principales priorités d'examen pour 2025-2026, et les conseils sont censés documenter leurs cadres de supervision de l'IA dans les circulaires de sollicitation de procurations d'ici la saison des procurations 2026. Le manquement expose à des actions dérivées d'actionnaires de type Caremark, à des recommandations de rétention de vote et à une atteinte à la réputation. Nous bâtissons les systèmes d'information structurés qui fournissent aux administrateurs des preuves documentées d'une supervision active de l'IA : registres de risques cartographiés sur les obligations fiduciaires, tableaux de bord de surveillance affichant l'état de la gouvernance, et supports de briefing qui traduisent le risque technique lié à l'IA dans le langage de gouvernance dont les administrateurs ont besoin pour démontrer une supervision de bonne foi.
Comment construire un test d'impact disparate qui tiendra face à l'expert statistique d'un plaignant ?
Les cadres de renversement de la charge de la preuve diffèrent selon la loi. Le Title VII (Griggs/Wards Cove) exige que l'employeur démontre la pertinence pour l'emploi et la nécessité commerciale si un plaignant établit un impact disparate. L'ECOA et la FHA ont leurs propres normes. L'expert statistique d'un plaignant contestera les tailles d'échantillon, la méthodologie de test, les définitions de groupes protégés et la question de savoir si la population de comparaison a été correctement constituée. Nous concevons des protocoles de test au niveau de la conception du système, et non comme une analyse a posteriori : définition de la segmentation des groupes protégés, choix des tests statistiques appropriés (règle des quatre cinquièmes, tests basés sur la régression, bayésiens), établissement des populations de comparaison de référence, et documentation de la justification de nécessité commerciale pour toute caractéristique produisant des résultats disparates. La documentation est structurée de sorte que, lorsque l'expert d'un plaignant conteste la méthodologie, la réponse figure déjà au dossier avec la justification des tests, sans être improvisée en cours de déposition.
À quoi ressemblent généralement les exigences techniques de remédiation d'un décret de consentement relatif à l'IA ?
Les décrets de consentement dans les actions coercitives relatives à l'IA suivent un schéma émergent : restitution algorithmique (destruction des données collectées de manière irrégulière et des modèles entraînés sur celles-ci), périodes d'interdiction visant des usages spécifiques de l'IA (Rite Aid a reçu une interdiction de reconnaissance faciale de 5 ans), suppression obligatoire des données de consommateurs utilisées dans le système d'IA, audits indépendants par des tiers (généralement biennaux), programmes écrits de gestion des risques et de gouvernance, mécanismes de notification et de retrait (opt-out) pour les consommateurs, et reporting continu de conformité au régulateur. Le décret de consentement Rite Aid de la FTC est le modèle actuel. Nous rétro-concevons ces exigences en une infrastructure proactive : traçabilité de la provenance des données pouvant prouver une collecte licite, documentation de lignage du modèle pouvant démontrer des données d'entraînement propres, et programmes de gouvernance qui satisfont déjà les exigences de remédiation d'un décret de consentement type. Bâtir cela avant l'application coercitive coûte plusieurs ordres de grandeur de moins que de le rénover sous supervision judiciaire.
Développez votre IA en toute confiance.
Collaborez avec une équipe forte d'une solide expérience dans la conception de la prochaine génération d'IA d'entreprise. Nous vous aidons à concevoir, développer et déployer une stratégie d'IA digne de confiance.
Veriprajna société de conseil en Deep Tech est spécialisée dans la conception de systèmes d'IA critiques pour la sûreté destinés aux secteurs de la santé, de la finance et de la réglementation. Nos architectures sont validées au regard de protocoles établis et accompagnées d'une documentation de conformité complète.