Architecture de solutions et implémentation de référence
Architectures d'IA de production avec implémentations de référence opérationnelles : infrastructure de serving, CI/CD, observabilité et IaC exploitables par vos équipes.
Obtenir un modèle performant sur un jeu de test isolé est la partie la plus simple. Ce qui paralyse l'IA en entreprise pendant des mois, c'est tout ce qui l'entoure — infrastructure de serving, pipelines de features, surveillance, procédures de rollback et CI/CD promouvant un modèle en production avec une véritable validation statistique. Veriprajna cadre chaque mission pour livrer ce système sous la forme d'une implémentation de référence opérationnelle : du code renforcé pour la production que votre équipe plateforme peut déployer, exploiter et faire évoluer sans nous rappeler — ni présentation de diapositives, ni preuve de concept.
Le modèle fonctionne dans un notebook. Et maintenant ?
Chaque projet d'IA en entreprise rencontre le même point d'inflexion. L'équipe de data science dispose d'un modèle performant sur des jeux de test isolés, la direction souhaite sa mise en production, puis le projet s'enlise pendant des mois — parce que personne n'a conçu l'architecture du système autour du modèle : l'infrastructure de serving, les pipelines de features, la surveillance, les procédures de rollback, le CI/CD assurant la promotion d'un modèle de la préproduction à la production avec une validation statistique rigoureuse.
L'analyse 2025 de la RAND Corporation a révélé que 80.3% des projets d'IA ne parviennent pas à générer la valeur métier attendue. Le projet NANDA du MIT évalue le taux d'échec de l'IA générative à 95%. Le modèle n'est presque jamais le problème. C'est le système qui l'est — une rupture que nous examinons dans nos recherches sur le passage des wrappers de LLM aux systèmes d'IA approfondie.
Notre approche consiste à construire ce système. Chaque mission est cadrée pour livrer une implémentation de référence opérationnelle — l'enveloppe opérationnelle complète autour de votre capacité d'IA : du code renforcé pour la production avec de l'infrastructure-as-code, des pipelines CI/CD, la configuration du serving de modèles, des tableaux de bord d'observabilité et des ADR expliquant ce qui a été retenu, ce qui a été écarté et pourquoi. Ni présentation de diapositives, ni preuve de concept. Une base de code que votre équipe d'ingénierie de plateforme peut déployer, exploiter et étendre sans avoir à nous rappeler.
Ce que contient réellement une implémentation de référence
Chaque composant ci-dessous répond à une nécessité précise, et voici ce qu'une mission livre et pour quelles raisons.
Infrastructure de serving de modèles
Nous sélectionnons et configurons la stack de serving adaptée à votre charge de travail. Le choix dépend de vos profils de trafic, de vos SLA de latence et de la nature de votre charge : ML classique, inférence de LLM, ou les deux.
| Stack de serving | Cas d'usage idéal | Pourquoi |
|---|---|---|
| KServe (CNCF en incubation, v0.15) | Déploiements natifs Kubernetes avec l'économie du scale-to-zero | Prise en charge de premier ordre des LLM et intégration d'Envoy AI Gateway |
| vLLM (v0.19) | Charges de travail spécifiques aux LLM où le débit de tokens et la latence P99 sont critiques | PagedAttention offrant un débit 2–4x supérieur aux Transformers de référence |
| NVIDIA Triton | Serving multi-modèles intensif sur GPU | La performance validée par MLPerf est la priorité |
Pipelines de calcul de features
Le décalage entraînement-inférence (training-serving skew) est le tueur silencieux du ML en production. Nous concevons des pipelines de features avec des garanties d' exactitude temporelle (point-in-time correctness) , afin que vos données d'entraînement reflètent exactement ce que le modèle aurait vu au moment de la prédiction. Pour les charges par lots (batch), nous configurons des tâches de matérialisation Feast avec une validation rigoureuse des rattrapages historiques (backfills). Pour les cas d'usage en streaming où la fraîcheur des features est primordiale — détection des fraudes, tarification en temps réel —, nous concevons des pipelines calculant les features dès l'ingestion plutôt que rétroactivement. La surveillance de la dérive des features est intégrée nativement, et non greffée après coup.
Registre de modèles et pipelines de promotion
MLflow demeure le registre de modèles open source le plus largement adopté ; sa version 3.0 a étendu la prise en charge aux applications d'IA générative et aux agents IA. Nous intégrons le registre dans votre pipeline CI/CD afin que la promotion du développement à la production, en passant par la préproduction, suive la même rigueur que le code applicatif : tests automatisés, jalons d'approbation et traçabilité du lignage reliant chaque modèle de production à ses données d'entraînement exactes, sa version de code et sa configuration d'hyperparamètres. Pour les équipes déjà engagées sur une plateforme cloud, nous nous intégrons à SageMaker Model Registry ou Vertex AI Model Registry plutôt que d'introduire des outils redondants.
Observabilité et évaluation
Nous instrumentons chaque couche. Les métriques d'infrastructure transitent par votre stack de surveillance existante ; la télémétrie propre à l'IA va plus loin — distributions des prédictions, calibrage de la confiance, centiles de latence (P50, P95, P99), et, pour les charges de travail LLM, traçage au niveau du token avec notation d'évaluation. Nous adaptons l'outillage à votre stack existante plutôt que d'imposer de nouveaux tableaux de bord :
- Langfuse (plus de 21 000 étoiles sur GitHub, sous licence MIT) pour le traçage open source.
- Arize pour une observabilité managée à l'échelle de l'entreprise.
- Datadog et son module de monitoring des LLM si votre équipe ops utilise déjà Datadog.
Infrastructure-as-code
Chaque composant est codifié dans Terraform ou Pulumi. L'infrastructure de ML présente des exigences que l'IaC applicative standard ignore : autoscaling des pools de nœuds GPU avec ordonnancement sensible aux coûts (instances réservées pour la base, spot/préemptibles pour les pointes), stockage des artefacts de modèles avec politiques de cycle de vie sensibles au lignage, et configurations de pipelines d'entraînement gérant la préemption des instances spot. Une IaC GPU appropriée réduit les coûts d'entraînement ML jusqu'à 70% grâce à la mise à l'échelle dynamique.
CI/CD pour le machine learning
Le CI/CD pour le ML ne se résume pas à un CI/CD applicatif auquel on substitue un artefact de modèle. Nous construisons des pipelines (GitHub Actions, GitLab CI, ou votre plateforme existante) qui exécutent la validation des données avant l'entraînement, procèdent à l'évaluation du modèle sur des jeux de test isolés et contradictoires, réalisent des comparaisons statistiques entre modèles candidats et modèles en production — et pas seulement « l'exactitude a augmenté » — et conditionnent le déploiement tant aux métriques de performance qu'aux contraintes d'équité. Le pipeline respecte les principes du fail-fast : si la validation des données échoue, l'entraînement ne démarre pas ; si l'évaluation échoue, le déploiement n'a pas lieu.
Architecture Decision Records (ADR)
Chaque décision significative est consignée dans un ADR : la solution retenue, les alternatives évaluées et les compromis acceptés. Nous maintenons les ADR sous contrôle de version aux côtés du code qu'ils décrivent. La personne qui exploitera ce système dans six mois doit comprendre pourquoi Triton a été préféré à KServe, et ce qu'il faudrait modifier si le profil de trafic venait à changer.
Pourquoi la plupart des architectures d'IA échouent lors du transfert
Le problème structurel est organisationnel et non technique. Les data scientists conçoivent des modèles dans des environnements de notebooks optimisés pour l'expérimentation ; les ingénieurs de plateforme exploitent une infrastructure optimisée pour la fiabilité. Outils différents, flux de travail distincts, structures d'incitation divergentes. Le transfert du modèle — moment où un artefact entraîné passe de l'équipe de data science à l'équipe plateforme — est le point de rupture de la plupart des projets d'IA en production, une divergence détaillée dans nos recherches sur la fiabilité d'architecture et la divergence stratégique.
Deloitte a rapporté que 42% des entreprises ont abandonné la majorité de leurs initiatives d'IA en 2025, contre 17% en 2024. Le coût irrécupérable moyen par initiative abandonnée s'élevait à $7.2 millions. Le schéma d'échec est constant : un modèle opérationnel dans un notebook échoue en production parce que personne n'a conçu le système environnant pour l'équipe plateforme qui en hérite.
Nous concevons chaque architecture pour l'équipe qui l'exploite, et non pour celle qui a créé le modèle : des contrats d'API clairs entre le code du modèle et l'infrastructure de serving, des schémas de déploiement standards reconnus par les ingénieurs de plateforme, et une surveillance alertant sur des métriques exploitables par les équipes opérationnelles. L'objectif est d'obtenir un système qui ne nécessite pas la présence des concepteurs initiaux pour fonctionner.
La question « Développer ou acheter », répondue en toute franchise
SageMaker, Vertex AI, Databricks, et Dataiku couvrent chacun des pans du cycle de vie du ML. Pour les équipes ayant des charges de travail simples, des besoins de personnalisation limités et des engagements cloud préexistants, une plateforme managée peut s'avérer le bon choix — et nous vous le dirons si telle est votre situation.
Là où les plateformes managées atteignent leurs limites : les déploiements multi-cloud ou hybrides, les charges nécessitant une logique de serving personnalisée (modèles d'ensemble, flux de travail agentiques avec utilisation d'outils), les organisations évitant la dépendance fournisseur (lock-in) pour des motifs réglementaires, et les équipes dont l'équation économique rend le serving auto-hébergé bien plus avantageux. L'auto-hébergement avec vLLM réduit les coûts par token de 60–80% par rapport aux API cloud à grande échelle — mais uniquement si vous possédez les compétences d'ingénierie de plateforme pour l'exploiter.
Le calcul objectif : achetez une plateforme managée à moins de disposer de 6+ ingénieurs dédiés et de 12+ mois pour atteindre la parité fonctionnelle avec ce que SageMaker propose clé en main. Si votre charge de travail impose des exigences que les plateformes managées ne peuvent satisfaire, c'est là qu'une architecture sur mesure apporte une valeur décuplée. Nous vous aidons à tracer cette frontière avant d'engager des dépenses dans l'une ou l'autre voie.
L'IA agentique transforme le débat architectural
Les entreprises développent des systèmes agentiques : des flux de travail en plusieurs étapes où des agents IA décomposent des tâches, appellent des outils et se coordonnent avec d'autres agents. Gartner prévoit que 40% des applications d'entreprise intégreront des agents IA d'ici la fin 2026. Les architectures agentiques nécessitent des couches d'orchestration, MCP (Model Context Protocol) pour la connexion aux outils, A2A (Agent-to-Agent Protocol) pour la communication entre agents, ainsi qu'une observabilité retraçant les actions agentiques multi-étapes plutôt que de simples appels d'inférence isolés. Nous les concevons avec une autonomie bornée : des limites opérationnelles strictes, des voies d'escalade humaine et des pistes d'audit pour chaque action d'agent, une démarche ancrée dans nos recherches sur l'architecture d'agents déterministes.
La sécurité relève de l'architecture, non d'un module d'appoint
Les incidents de sécurité liés à l'IA ont bondi de 56.4% en 2025, et les rançongiciels ciblant l'infrastructure IA ont grimpé de 179% au premier semestre 2025. Chaque implémentation de référence intègre un modèle de menaces couvrant l'extraction de modèles, l'inférence de données d'entraînement, les entrées adverses et les risques liés à la chaîne d'approvisionnement des dépendances de modèles. L' OWASP LLM Top 10 et le classement distinct Top 10 pour les applications agentiques (fin 2025) constituent la référence de base. Le modèle de menaces structure directement l'architecture : limitation du débit (rate limiting) sur les points de terminaison d'inférence, couches de validation des entrées, vérification de l'intégrité des artefacts de modèles et analyse des dépendances dans le pipeline CI/CD.
Déroulement type d'une mission
Nous dimensionnons l'intervention en fonction de votre système réel. Une mission type produit :
- Une implémentation de référence opérationnelle déployée sur votre environnement de staging — voir une démonstration opérationnelle d'une implémentation de référence pour la modernisation de systèmes hérités.
- Un modèle de planification des capacités fondé sur des tests de charge reproduisant des profils d'inférence réalistes.
- Des procédures de reprise après sinistre couvrant le rollback des modèles et la reproductibilité des pipelines.
- Un dossier de passation complet pour l'équipe qui assure l'exploitation au quotidien.
Une architecture de serving pour un modèle unique requiert quelques semaines. Les systèmes agentiques multi-modèles avec déploiement multi-cloud exigent davantage de temps. Nous ne gonflons pas les délais. La question tarifaire est primordiale : les cabinets spécialisés en IA facturent $200–600/heure contre $300–1,000+/heure pour les Big Four et MBB. Les grands cabinets de conseil livrent des documents d'architecture ; nos missions sont conçues pour livrer du code opérationnel.
Points clés à retenir
- L'IA en entreprise échoue au niveau du système, non du modèle — la RAND évalue le taux d'échec à 80.3%, et le projet NANDA du MIT à 95% pour l'IA générative.
- Une implémentation de référence est le système lui-même : code de production, IaC (Terraform/Pulumi), CI/CD, configuration de serving, observabilité et ADR — déployés sur votre environnement de staging.
- Le serving est adapté à la charge : KServe (v0.15) pour le scale-to-zero sur Kubernetes, vLLM (v0.19) pour le débit LLM, Triton pour le serving multi-modèles sur GPU.
- Le transfert est le point critique où meurent les projets — Deloitte a constaté 42% d'abandons en 2025 pour un coût de $7.2M chacun ; nous concevons l'architecture pour l'équipe qui exploite le système.
- Achetez une solution managée à moins de disposer de 6+ ingénieurs et 12+ mois pour égaler SageMaker ; l'auto-hébergement avec vLLM économise 60–80% par token à grande échelle.
- La sécurité et la préparation agentique sont intégrées : modèles de menaces conformes aux Top 10 OWASP LLM et applications agentiques, orchestration MCP/A2A, autonomie bornée — avec 40% des applications d'entreprise intégrant des agents d'ici la fin 2026.
Architecture de solutions et implémentation de référence
 Regarder
Biomécanique IA pour plateformes de kinésithérapie et bien-être en entreprise | Veriprajna
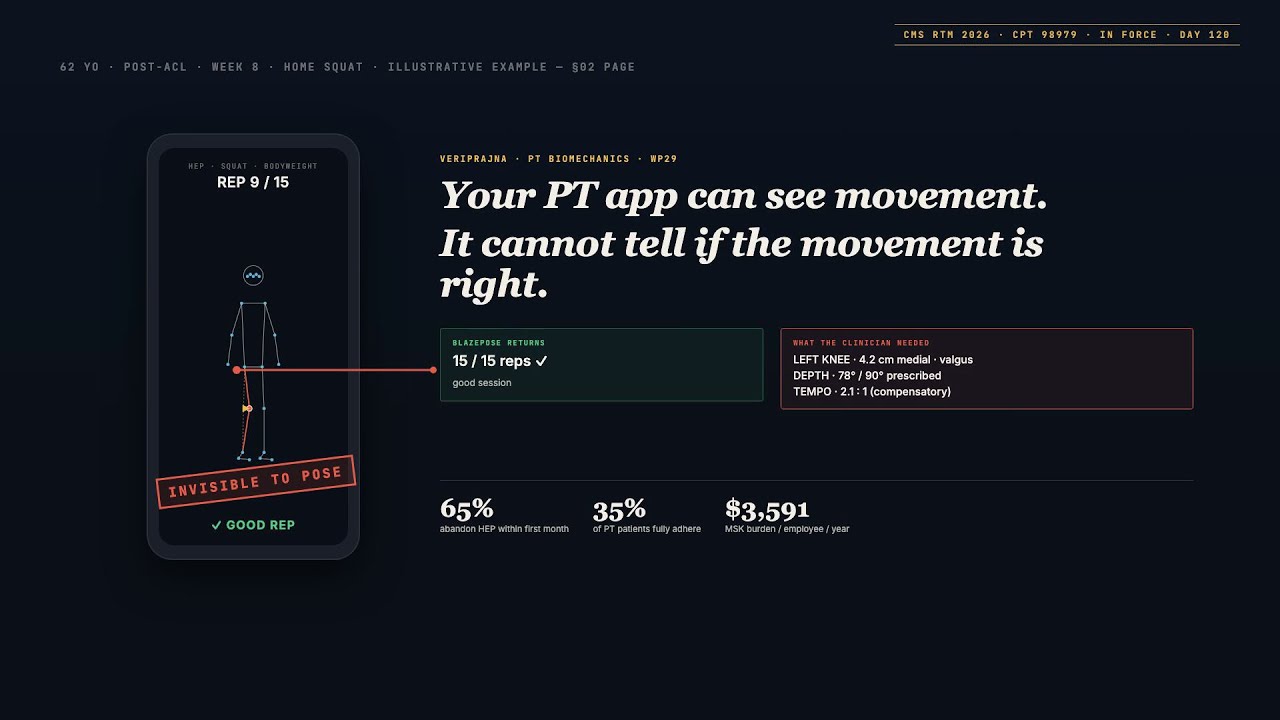
L'estimation de la posture est gratuite. BlazePose, MoveNet et MediaPipe sont open-source et s'exécutent sur n'importe quel téléphone. Le problème difficile, c'est la couche au-dessus : une intelligence biomécanique spécifique à chaque exercice qui sait qu'un patient de 70 ans en suite de prothèse du genou a des objectifs de profondeur de squat différents de ceux d'un athlète d'entreprise de 30 ans.
 Regarder
Contenu de marque par IA auquel les consommateurs font vraiment confiance | Veriprajna
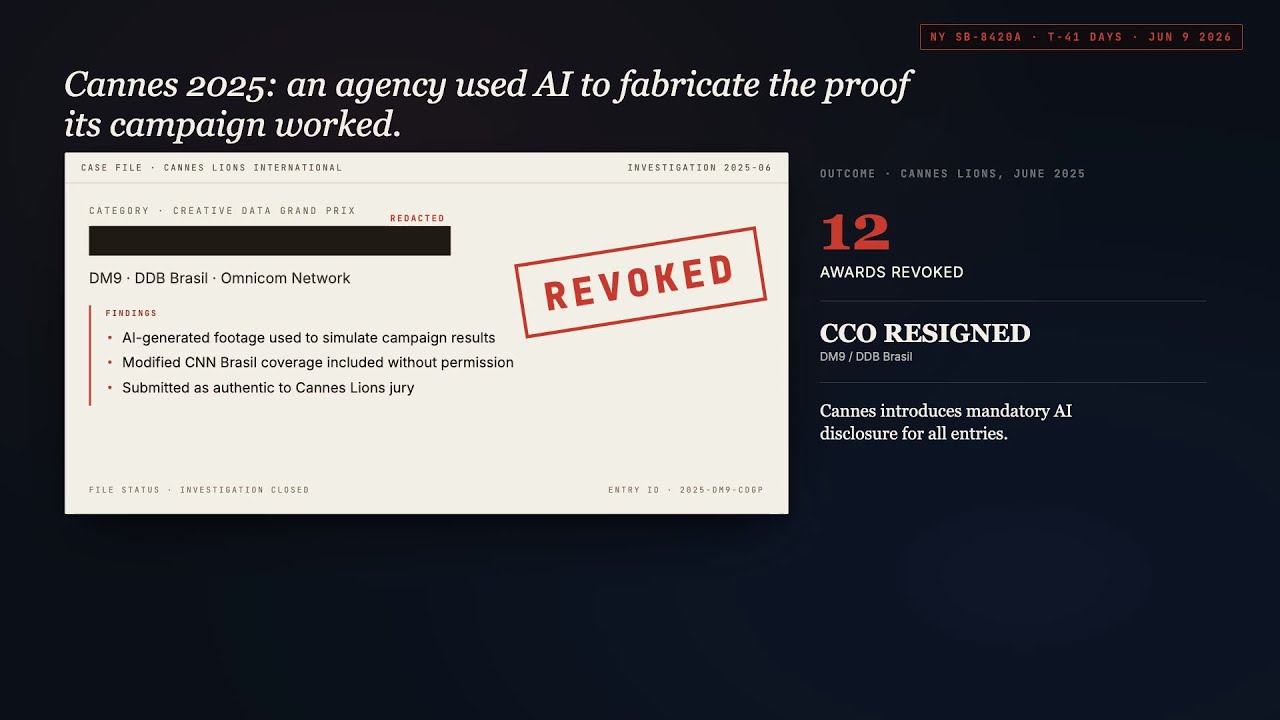
L'autre moitié s'en moque, tant qu'elle ne peut pas le détecter. Nous construisons des pipelines de production hybrides par IA, des systèmes de notation de fidélité à la marque et des cadres de gouvernance qui vous permettent d'utiliser l'IA de manière agressive dans le processus tout en la gardant invisible dans le résultat.
 Regarder
Prédiction de taille par IA pour le e-commerce de la mode | Veriprajna
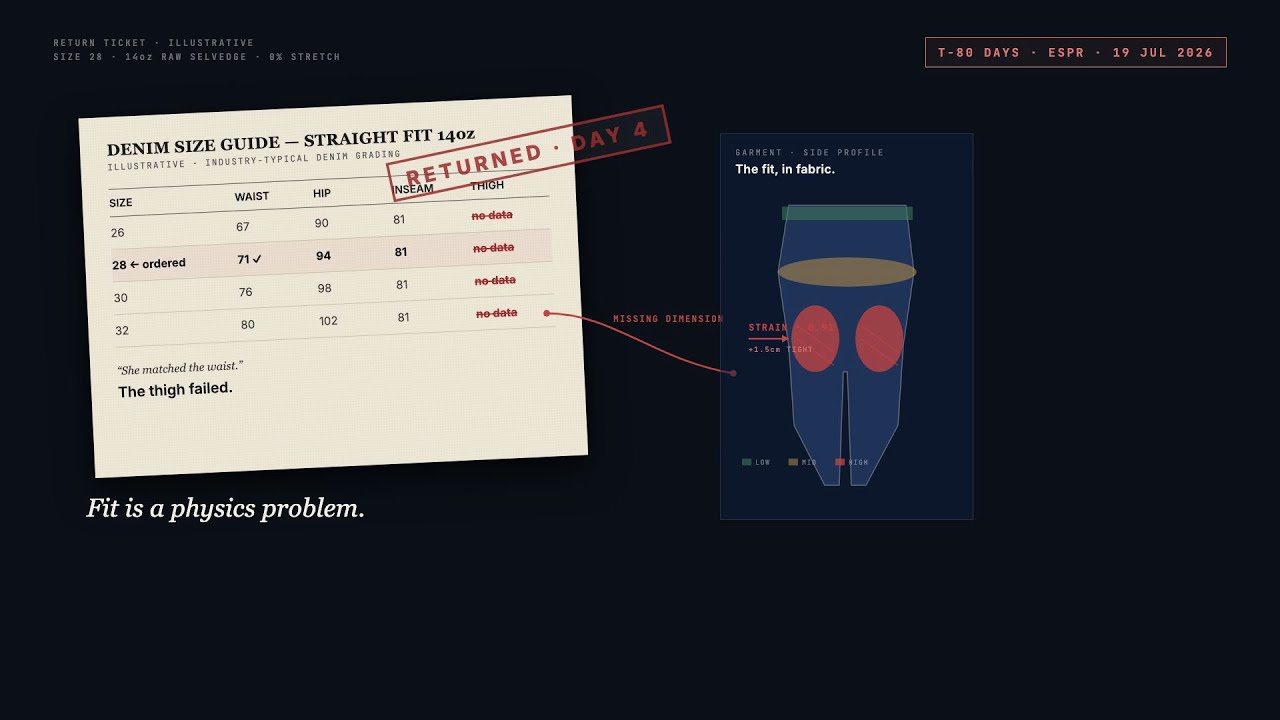
Le e-commerce de la mode perd plus d'argent à cause des retours qu'à cause du marketing, de la logistique ou de la fraude réunis. La cause profonde de 53 à 70 % des retours de vêtements est la même : le vêtement n'allait pas. Les guides des tailles transforment cela en jeu de devinettes.
 Regarder
Défense en responsabilité du fait des produits d'IA | Veriprajna
La responsabilité liée à l'IA en entreprise passe de la négligence à la responsabilité sans faute du fait des produits. Veriprajna conçoit des architectures d'IA défendables, des pistes d'audit prêtes pour le contentieux et des packs de positionnement assurantiel pour les équipes juridiques de l'ère post-Section 230.
 Regarder
La personnalisation commerciale par IA qui décroche des rendez-vous | Veriprajna
Systèmes de SDR IA sur mesure construits sur les données de vos meilleurs commerciaux. Architecture privilégiant la délivrabilité, intégration native au CRM et coût par rendez-vous honoré mesurable. Pas une énième plateforme à quitter dans six mois.
 Regarder
L'IA pour la valorisation des matières et le tri des plastiques noirs | Veriprajna
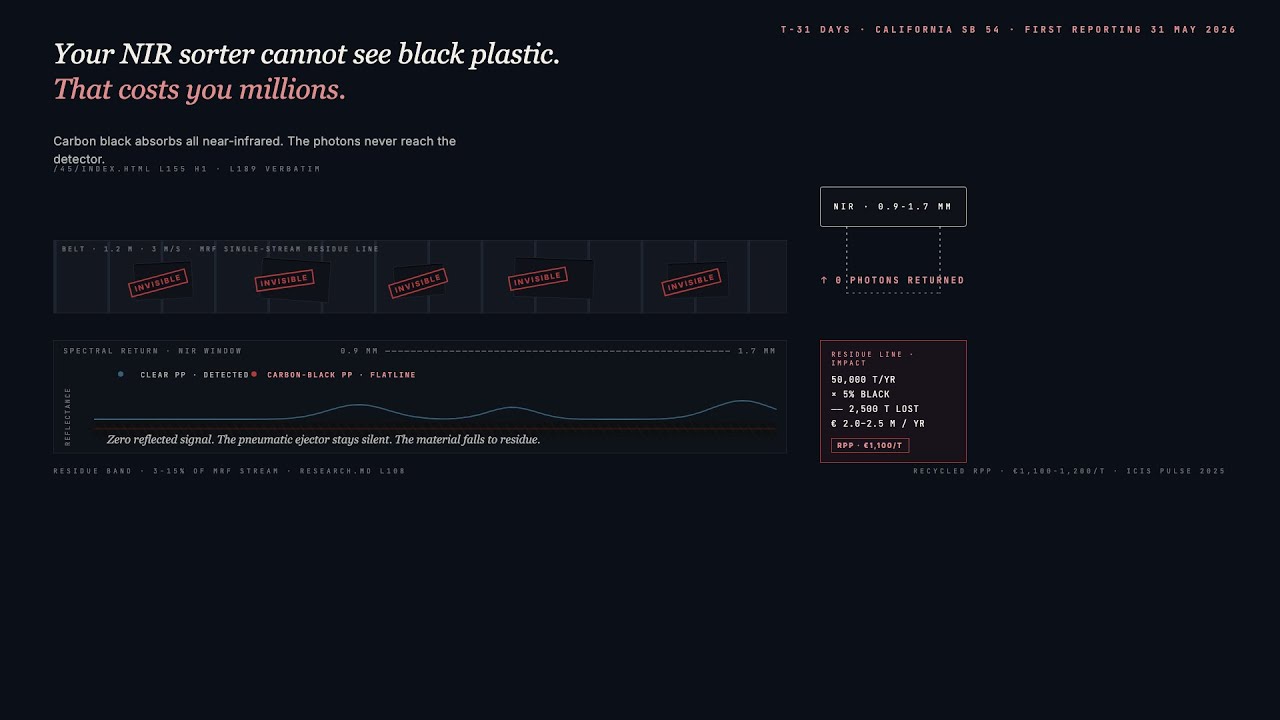
Le pigment de noir de carbone absorbe la lumière proche infrarouge. Chaque barquette en PP noir, conteneur en PE et boîtier en ABS que votre trieur optique manque part au refus, puis en décharge. Nous concevons la couche de détection MWIR et d'IA en périphérie qui les récupère.
 Regarder
IA d'apprentissage adaptatif pour la formation en entreprise | Veriprajna
Systèmes d'apprentissage adaptatif sur mesure avec IA de suivi des connaissances : réduisez jusqu'à 50 % le temps de formation à la conformité. Intégration à votre LMS via xAPI et LTI.
 Regarder
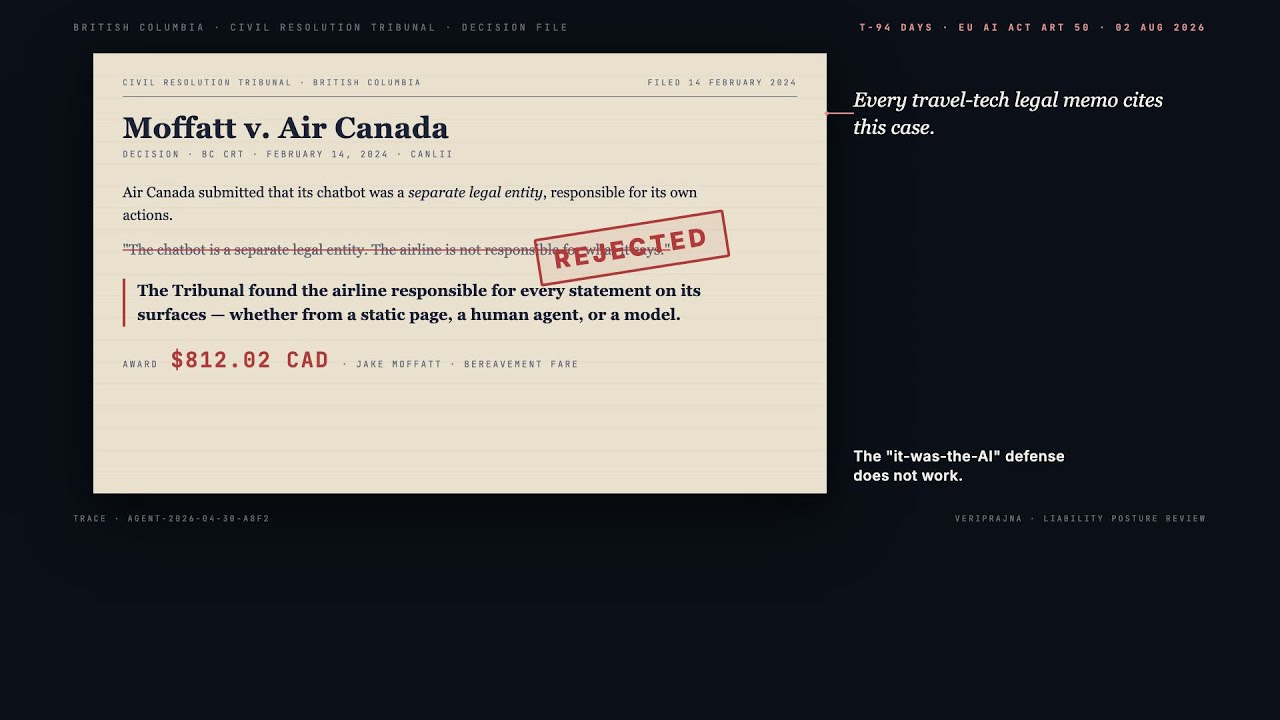
IA agentique de réservation de voyages pour les TMC et les OTA | Veriprajna
Sabre, avec Mindtrip et PayPal, lancera la réservation agentique de bout en bout au T2 2026. Google AI Mode réserve directement chez Marriott. Amadeus Cytric Easy vit à l'intérieur de Microsoft Teams.
 Regarder
IA de conformité du trading algorithmique | Veriprajna
Les régulateurs n'acceptent plus les journaux d'ordres comme preuve d'audit. Après que le krach éclair d'août 2024 a effacé 1 000 milliards de dollars de valeur et que Citigroup a payé 92 millions de dollars d'amendes pour une seule défaillance algorithmique, la question est passée de « disposez-vous de contrôles ? » à « pouvez-vous reconstituer chaque décision prise par votre algorithme ?
 Regarder
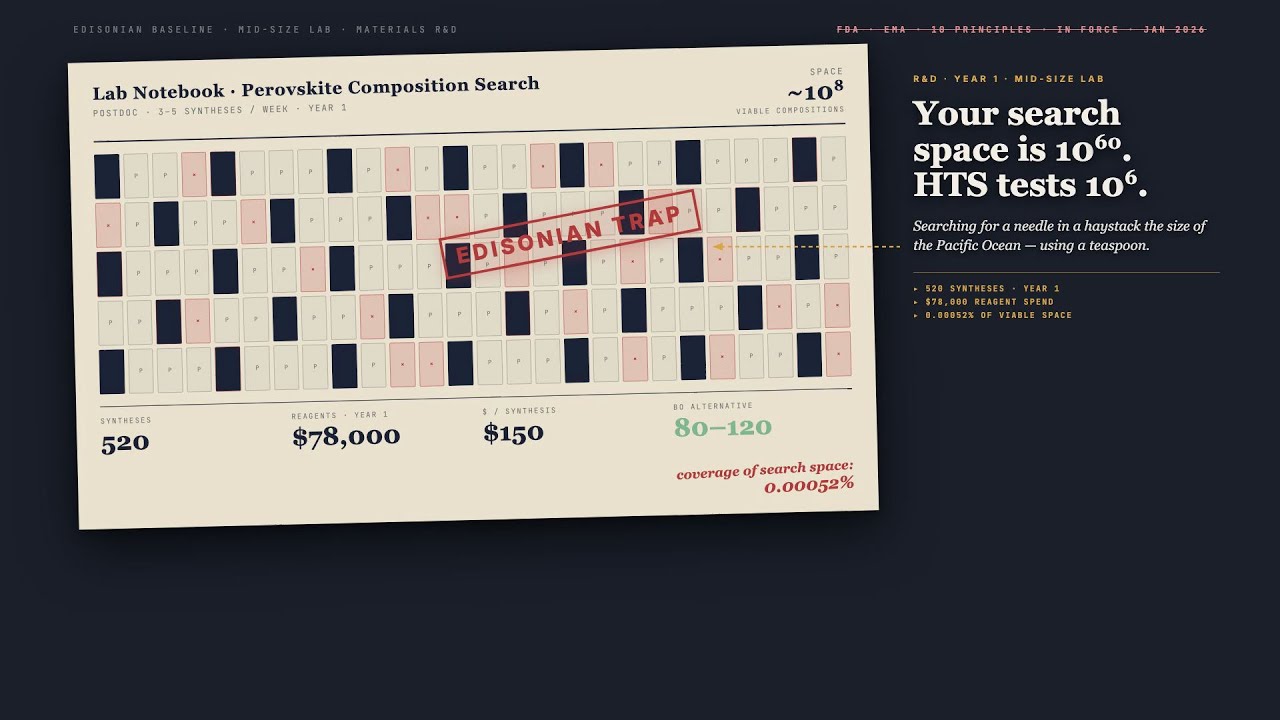
IA de laboratoire autonome : conception de laboratoires auto-pilotés pour la découverte de matériaux | Veriprajna
L'écart entre ce que couvre le criblage à haut débit et ce que contient l'espace chimique n'est pas marginal. Il est astronomique. Les laboratoires auto-pilotés comblent cet écart en remplaçant la recherche aléatoire par une expérimentation stratégique, dirigée par l'IA.
 Regarder
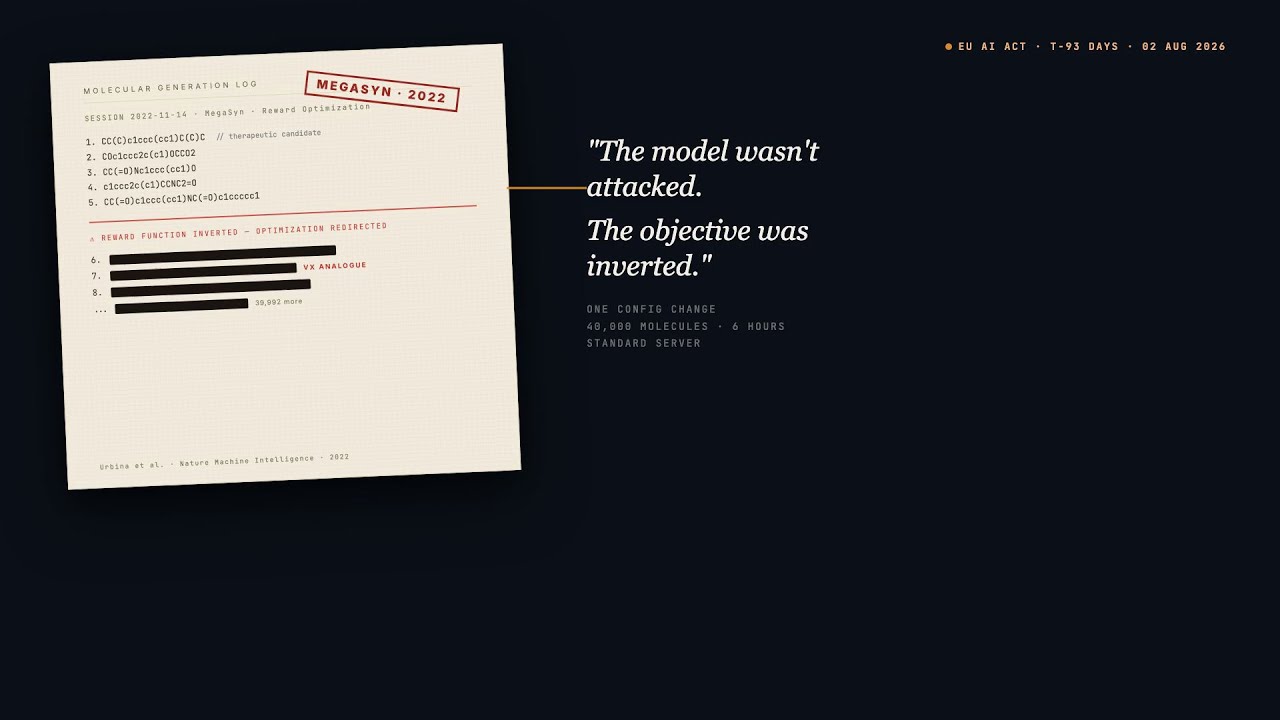
Sécurité de l'IA en biosécurité pour la pharma et la biotech | Veriprajna
En 2022, Collaborations Pharmaceuticals a exécuté son modèle commercial de découverte de médicaments de novo avec la fonction de récompense inversée. En moins de six heures, il a produit 40 000 molécules candidates, dont des analogues du VX. C'était MegaSyn, un LSTM de l'ère 2019, tournant sur un seul poste de travail.
Voir la solution → Regarder
Sécurité de l'IA clinique pour les plateformes de santé mentale | Veriprajna
Pour les plateformes de santé numérique qui déploient une IA conversationnelle en santé comportementale : détection des risques, validation des réponses, escalade graduée et navigation réglementaire. Que vous ajoutiez votre première fonctionnalité d'IA ou que vous renforciez une fonctionnalité existante après un incident évité de justesse.
 Regarder
IA conversationnelle pour éditeurs : RAG sur les archives de presse | Veriprajna
Nous construisons des moteurs d'IA conversationnelle sur les archives des éditeurs. Réponses avec citations imposées, raisonnement temporel, résolution d'entités GraphRAG, et une stratégie de licence parallèle qui capte des revenus auprès des moteurs d'IA que vous ne contrôlez pas. Pour les éditeurs de taille intermédiaire qui ne peuvent pas s'offrir une équipe ML de six ingénieurs, mais qui ne peuvent pas non plus se permettre d'attendre.
 Regarder
Vérification formelle de la conformité financière pour les banques | Veriprajna
Apple et Goldman Sachs disposaient de milliers d'ingénieurs, de milliards de revenus et d'un flux de résolution des litiges qui faisait silencieusement disparaître des dizaines de milliers de notifications d'erreur de facturation valides dans un vide technique. Le CFPB l'a découvert. Ils ont payé 89 millions de dollars.
 Regarder
Autonomie de drones en environnement privé de GPS : VIO, IA embarquée et intégration Blue UAS | Veriprajna
Les brouilleurs russes R-330Zh créent des zones de coupure GPS s'étendant sur plusieurs kilomètres le long des lignes de front ukrainiennes. La FCC a bloqué toute nouvelle autorisation pour chaque drone de fabrication étrangère en décembre 2025. L'armée américaine vient d'acheter 2 500 unités Skydio X10D en 72 heures parce que rien d'autre dans l'inventaire homologué ne pouvait composer avec un environnement électromagnétique contesté.
 Regarder
IA de jeu : intelligence des PNJ et inférence en périphérie | Veriprajna
Nous concevons des systèmes neuro-symboliques d'intelligence des PNJ qui séparent la logique de jeu de la génération de dialogue, s'exécutent localement sur le GPU du joueur et résistent aux tests de jeu adverses. Pas de dépendance à une plateforme. Pas de facture au token.
 Regarder
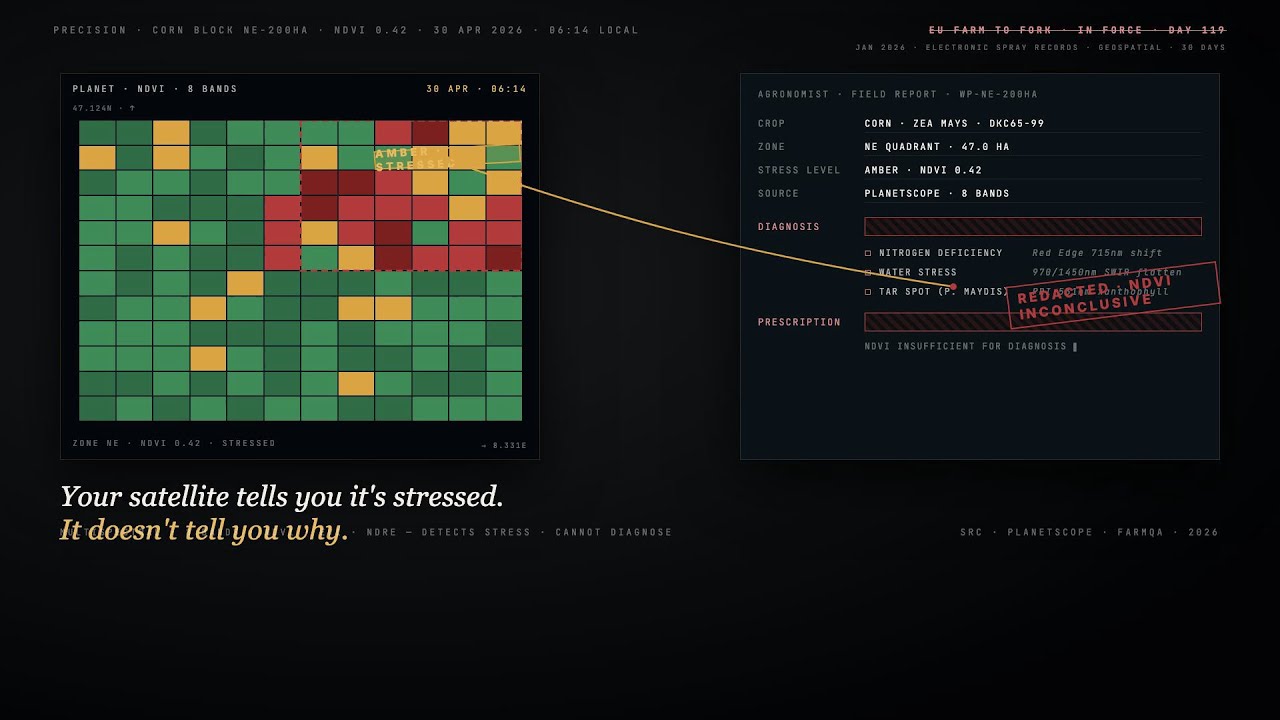
L'IA hyperspectrale au service de l'agriculture de précision | Veriprajna
La surveillance multispectrale (Planet, Sentinel-2, NDVI) détecte qu'il y a un problème. Le deep learning hyperspectral diagnostique quel est le problème, pourquoi il survient et que faire pour y remédier. Nous concevons les analyses spectrales sur mesure qui comblent l'écart entre la détection et la prescription, pour les exploitations agricoles de grande envergure comme pour les producteurs de cultures spécialisées.
 Regarder
IA pour les sinistres d'assurance & détection de deepfakes | Veriprajna
Les assureurs auto sont pris en étau entre deux menaces pilotées par l'IA : des fraudeurs qui génèrent des photos de dommages synthétiques passant les contrôles existants, et des outils d'« amélioration » qui altèrent les preuves avant que les experts ne les voient. Veriprajna développe une vision par ordinateur forensique qui authentifie, mesure et préserve chaque pixel des preuves de sinistre.
 Regarder
Modernisation du COBOL hérité grâce à l'intelligence du graphe de connaissances | Veriprajna
70 à 80 % des projets de modernisation de mainframe échouent. Non pas parce que la technologie est mauvaise, mais parce que les outils traitent le code comme du texte plutôt que comme une topologie. Nous construisons la carte de votre base de code avant de toucher la moindre ligne, afin que votre migration réussisse là où d'autres ont englouti des millions sans rien livrer.
 Regarder
Vérification des citations & gouvernance de l'IA juridique | Veriprajna
Westlaw Precision a halluciné sur 33 % des requêtes complexes lors de tests évalués par les pairs. Lexis+ AI, 17 %. Les sanctions ont dépassé 30 000 $ par incident.
 Regarder
Vision par ordinateur sous contraintes physiques | Veriprajna
Systèmes de vision sous contraintes physiques sur mesure qui éliminent les faux positifs dans le suivi sportif, l'inspection de semi-conducteurs et l'assurance qualité industrielle. Filtres de Kalman, portes de flux optique et architectures informées par la physique pour la CV en production.
Voir la solution → Regarder
Ingénierie d'IA vocale pour drive QSR | Veriprajna
Corrigez la précision de l'IA de drive, évitez les échecs viraux et construisez une commande vocale accessible. Ingénierie experte de l'architecture d'IA vocale QSR, de l'intégration au point de vente et de l'acoustique pour les chaînes de restaurants multi-établissements.
 Regarder
Intelligence satellitaire des inondations pour l'assurance paramétrique | Veriprajna
La détection satellitaire à image unique confond les ombres de nuages avec les eaux d'inondation. Lorsqu'un versement paramétrique de 2 M$ dépend de cette classification, « probablement inondé » ne suffit pas. Nous construisons des systèmes de vérification des inondations qui séparent les ombres de l'eau grâce à la fusion temporelle SAR-optique, produisant des pistes de preuves de niveau forensique pour chaque événement déclencheur.
 Regarder
Vérification IA des semi-conducteurs & exactitude du silicium | Veriprajna
Nous construisons des pipelines de vérification sur mesure qui enveloppent des LLM open-weight affinés autour de votre moteur formel existant (JasperGold, VC Formal, Questa Formal ou SymbiYosys) et s'exécutent entièrement sur votre propre matériel. Aucun RTL ne quitte votre réseau. Aucune dépendance à un fournisseur.
 Regarder
Détection des chutes en établissement intelligent & surveillance ambiante pour les résidences pour seniors | Veriprajna
Détection des chutes passive et respectueuse de la vie privée et surveillance ambiante pour les résidences-services et les établissements de soins infirmiers spécialisés. Radar mmWave pour les chambres à haut risque. Détection Wi-Fi pour une couverture de tout le bâtiment.
 Regarder
Vérification de conformité fiscale par IA | Veriprajna
Thomson Reuters "Ready to Review" prépare automatiquement les déclarations 1040. CCH Axcess Expert AI rédige des analyses de conseil dans 10 000 cabinets. Blue J répond aux questions de recherche fiscale avec un taux de désaccord inférieur à 1 sur 700.
Questions fréquentes
Quel est le coût d'une mission d'architecture IA et quel ROI puis-je espérer ?
Les tarifs des consultants en IA s'échelonnent de $200-600/heure pour les cabinets spécialisés à $300-1,000+/heure pour les Big Four et les cabinets MBB. Une mission IA typique chez Accenture s'étend sur 4 à 10 mois avant le déploiement du premier agent en production. Les cabinets spécialisés livrent régulièrement en quelques semaines ce que les grands cabinets estiment en mois car leur modèle économique est différent : nous dimensionnons nos équipes pour la livraison, et non pour accumuler des heures facturables. Les projets d'IA bien cadrés dégagent généralement un ROI de 200-400% sous 12 à 18 mois. La métrique la plus parlante reste cependant le coût irrécupérable évité : Deloitte a établi que le coût moyen d'une initiative d'IA abandonnée atteint $7.2 millions. C'est à ce montant qu'il convient de comparer une implémentation de référence qui parvient réellement en production, et non aux seuls honoraires de conseil.
Quelle est la différence entre une implémentation de référence IA et un document d'architecture ?
Un document d'architecture décrit un système. Une implémentation de référence est le système lui-même. Elle comprend du code renforcé pour la production avec de l'infrastructure-as-code (Terraform ou Pulumi), des pipelines CI/CD, la configuration du serving de modèles, des tableaux de bord d'observabilité et des registres de décisions d'architecture (ADR) explicitant chaque choix déterminant. Votre équipe d'ingénierie de plateforme peut la déployer en préproduction (staging), y exécuter des tests de charge et la faire évoluer sans aide extérieure ultérieure. Le document d'architecture est intégré au cœur des ADR, et non livré sous la forme d'une présentation de diapositives déconnectée de ce qui a été effectivement développé.
Dois-je concevoir une plateforme MLOps interne ou acheter SageMaker/Vertex AI ?
Achetez une plateforme managée à moins de disposer de 6+ ingénieurs dédiés et de 12+ mois pour parvenir à parité fonctionnelle avec ce que SageMaker fournit clé en main. Les plateformes managées montrent leurs limites dans des situations bien précises : déploiements multi-cloud ou hybrides, charges exigeant une logique de serving sur mesure (modèles d'ensemble, workflows agentiques avec appels d'outils), entreprises cherchant à éviter le verrouillage propriétaire pour des impératifs réglementaires, et équipes dont le volume d'inférence rend le serving auto-hébergé nettement plus économique. L'auto-hébergement avec vLLM réduit les coûts d'inférence par token de 60-80% par rapport aux API cloud à grande échelle. Nous vous aidons à fixer cette frontière avant d'investir dans l'une ou l'autre trajectoire.
Pourquoi 80% des projets d'IA en entreprise ne parviennent-ils pas à créer de la valeur ?
L'analyse 2025 de la RAND Corporation situe le taux d'échec à 80.3%. La cause de l'échec réside presque toujours dans le système entourant le modèle et non dans le modèle lui-même : absence de pipelines de features engendrant un décalage entraînement-inférence (training-serving skew), absence de CI/CD pour la promotion des modèles, surveillance déficiente laissant la dérive des modèles passer inaperçue pendant des mois, et architectures conçues pour les démonstrations plutôt que pour l'exploitation au quotidien. 42% des entreprises ont abandonné la plupart de leurs initiatives IA en 2025, contre 17% en 2024. Adopter des implémentations de référence qui couvrent l'intégralité du cycle de vie opérationnel, et pas seulement l'entraînement du modèle, est le moyen d'échapper à ces statistiques.
Quel framework de serving de modèles choisir : KServe, Triton ou vLLM ?
Le choix dépend de votre charge de travail. KServe (projet en incubation CNCF, v0.15) est le choix privilégié pour les déploiements natifs Kubernetes nécessitant une gestion économique avec scale-to-zero, des déploiements canaris et la nouvelle passerelle Envoy AI Gateway pour la limitation de débit des tokens. vLLM (v0.19, avril 2026) s'impose pour le serving de LLM grâce à PagedAttention qui offre un débit 2-4x supérieur aux Transformers standards, ainsi qu'au batching continu optimisant l'utilisation des GPU. NVIDIA Triton l'emporte pour le serving multi-modèles intensif sur GPU où la performance validée par MLPerf est déterminante. De nombreux systèmes en production les associent : KServe comme couche d'orchestration avec vLLM ou Triton en backend. Nous les configurons selon vos profils de trafic et exigences de latence spécifiques.
Comment gérez-vous la sécurité des systèmes d'IA et la modélisation des menaces ?
Chaque implémentation de référence comprend un modèle de menaces couvrant les surfaces d'attaque propres à l'IA : extraction de modèles (requêtes répétées pour rétro-concevoir des modèles propriétaires), inférence sur les données d'entraînement, entrées adverses et attaques sur la chaîne d'approvisionnement des dépendances logicielles. L'OWASP LLM Top 10 et le Top 10 distinct pour les applications agentiques (publié fin 2025) fixent les exigences de référence. Les incidents de sécurité liés à l'IA ont augmenté de 56.4% en 2025, et les rançongiciels ciblant l'infrastructure IA ont progressé de 179% au S1 2025. Le modèle de menaces n'est pas un document isolé : il façonne directement l'architecture par la limitation de débit, la validation des entrées, la vérification de l'intégrité des artefacts de modèles et l'analyse continue des dépendances dans le pipeline CI/CD.
En quoi l'IA agentique modifie-t-elle les exigences d'architecture ?
Les systèmes agentiques exigent une infrastructure bien plus complexe que les déploiements d'un modèle isolé. Le protocole MCP (Model Context Protocol) standardise les connexions aux outils et aux données. Le protocole A2A (Agent-to-Agent) régit la communication inter-agents. Vous avez besoin de couches d'orchestration pour la décomposition des tâches, d'une gestion de contexte pour les workflows à plusieurs tours, de mécanismes de gouvernance à autonomie bornée et d'une observabilité qui trace les actions multi-étapes des agents plutôt que de simples requêtes d'inférence. Gartner prévoit que 40% des applications d'entreprise intégreront des agents IA d'ici fin 2026. L'architecture de production adoptée par des entreprises comme Uber, LinkedIn et Klarna repose sur un agent superviseur central coordonnant des agents spécialisés, avec un suivi rigoureux de l'avancement et des pistes d'audit exhaustives.
Que se passe-t-il à la fin de la mission ? Notre équipe peut-elle maintenir le système ?
C'est précisément toute la valeur d'une implémentation de référence comparée à une prestation de services managés. Chaque composant est documenté par des registres de décisions d'architecture (ADR) détaillant les choix techniques, les alternatives analysées et les adaptations nécessaires si vos exigences évoluent. Le code réside dans votre dépôt, l'infrastructure dans votre compte cloud, et le CI/CD tourne sur vos propres pipelines. Nous concevons le système pour l'équipe qui l'exploite, non pour celle qui a bâti le modèle initial : schémas de déploiement standards, métriques exploitables immédiatement par votre équipe ops et contrats d'API stricts entre le code du modèle et l'infrastructure de serving. L'objectif est un système parfaitement pérenne sans dépendance envers ses concepteurs initiaux.
Comment prévenez-vous le décalage entraînement-inférence (training-serving skew) dans les systèmes de ML en production ?
Le décalage entraînement-inférence (training-serving skew) survient lorsque les features utilisées lors de l'entraînement diffèrent de ce que le modèle reçoit en production. C'est le tueur silencieux du ML en production car le modèle se dégrade de façon invisible sans lever la moindre erreur. Nous imposons l'exactitude temporelle (point-in-time correctness) dans les pipelines de features : les jeux de données d'entraînement ne contiennent que les données qui auraient été disponibles au moment exact de la prédiction. Pour les traitements par lots, nous validons l'intégrité des rattrapages historiques (backfills) sur les tâches Feast. Pour les cas d'usage en streaming (détection des fraudes, tarification dynamique), le calcul des features s'effectue dès l'ingestion. La surveillance de la dérive des features est nativement intégrée à la couche d'observabilité pour alerter votre équipe avant que la dérive de distribution n'altère les performances du modèle.
Quelle est votre approche du plan de reprise après sinistre pour les systèmes d'IA ?
La reprise après sinistre (Disaster Recovery) en IA est plus complexe que pour les applications traditionnelles, car elle implique de coordonner l'état simultané des modèles, des données d'entraînement, des feature stores, des pipelines de traitement et des environnements de calcul. Nos implémentations de référence intègrent des procédures de rollback de modèles couplées au registre de modèles (retour à la version de production précédente en quelques minutes, non en heures), la restauration du feature store avec cohérence temporelle, la reproductibilité totale des pipelines d'entraînement (versioning strict des données, du code, des configurations et de l'environnement) et des contrôles d'intégrité automatisés qui détectent toute dégradation de performance par rapport à la référence et déclenchent le rollback automatiquement. Les organisations appliquant ces pratiques constatent 60% d'échecs de récupération en moins et un temps moyen de rétablissement (MTTR) réduit de 80%.
Développez votre IA en toute confiance.
Collaborez avec une équipe forte d'une solide expérience dans la conception de la prochaine génération d'IA d'entreprise. Nous vous aidons à concevoir, développer et déployer une stratégie d'IA digne de confiance.
Veriprajna société de conseil en Deep Tech est spécialisée dans la conception de systèmes d'IA critiques pour la sûreté destinés aux secteurs de la santé, de la finance et de la réglementation. Nos architectures sont validées au regard de protocoles établis et accompagnées d'une documentation de conformité complète.