Infrastructure et déploiement d'IA souveraine
Constructions d'infrastructures d'IA souveraine : clusters GPU air-gap, MLOps hors ligne, audits de dépendances et cartographie réglementaire pour des environnements souverains en données.
Près de 100 milliards de dollars affluent vers le calcul d'IA souveraine en 2026. Une infrastructure d'IA qui reste à l'intérieur d'un périmètre contrôlé n'est plus une exigence de défense de niche : elle devient la posture par défaut des entreprises réglementées et des gouvernements du monde entier. Notre approche consiste à concevoir l'infrastructure qui rend l'IA souveraine opérationnellement réelle, et pas seulement déclarée sur le plan stratégique.
Ce que « souverain » signifie réellement (et ce que cela ne signifie pas)
La souveraineté n'est pas la résidence des données. La résidence des données vous indique où se trouvent vos données. La souveraineté vous indique qui contrôle la pile sur laquelle elles s'exécutent. AWS a lancé son European Sovereign Cloud en janvier 2026 avec plus de 90 services au sein d'une entité de droit allemand, physiquement distincte. Cela satisfait à la résidence des données. Cela ne satisfait pas à la souveraineté structurelle, car le US CLOUD Act accorde un accès extraterritorial aux données quel que soit leur lieu de stockage physique.
Un benchmark Callista de février 2026 a constaté que les fournisseurs natifs de l'UE comme Scaleway offrent environ 4,8 fois plus de valeur par euro par rapport à AWS, tout en assurant une véritable indépendance de Layer 3 : propriété UE, contrôle opérationnel UE et exposition nulle au CLOUD Act.
Notre méthode commence par situer précisément où, sur le spectre de la souveraineté, se placent les exigences d'un acheteur, une approche détaillée dans nos recherches sur l'architecture d'une intelligence souveraine pour l'entreprise post-confiance. Chaque posture ci-dessous est une architecture différente, une courbe de coûts différente et une cartographie de conformité différente — et nous concevons les trois :
- Isolement physique complet (air-gap) avec diodes de données et zéro connectivité réseau externe.
- Cloud privé sans aucun fournisseur ayant son siège aux États-Unis dans le chemin de contrôle.
- Infrastructure conforme à l'ITAR où les charges de travail d'IA traitant des données techniques contrôlées restent dans un périmètre réservé aux personnes américaines (US persons).
L'audit de dépendances que personne d'autre ne réalise
La plupart des déploiements « souverains » ne le sont pas. Ils fuient. Individuellement, chaque fuite est un simple oubli de configuration mineur. Collectivement, elles signifient que votre déploiement air-gap n'est pas air-gap. Coupables courants :
- Le chart Helm par défaut du NVIDIA GPU Operator tire des images de conteneurs depuis nvcr.io à chaque redémarrage de pod.
- HashiCorp Vault, depuis le changement de sa licence BSL en 2023, inclut des points de terminaison de validation de licence qui appellent leur serveur d'origine par défaut.
- Les configurations DNS par défaut de Kubernetes résolvent auprès des serveurs racine en amont.
- La synchronisation NTP cible pool.ntp.org.
- Les exportateurs Prometheus contactent leur serveur d'origine pour rechercher des mises à jour.
OpenBao, le fork de la Linux Foundation en version 2.5.0 (février 2026), élimine la dépendance d'appel au serveur d'origine de Vault tout en ajoutant des fonctionnalités entreprise comme les namespaces et la scalabilité horizontale en lecture, sous une licence MPL 2.0.
Notre pratique consiste à mener un audit de dépendances systématique avant qu'un environnement ne soit déclaré souverain, la discipline qui sous-tend nos recherches sur l'intégrité logicielle et les systèmes résilients : chaque chemin de requête DNS, chaque cible NTP, chaque chaîne de provenance d'image de conteneur, chaque point de terminaison de validation de licence et chaque balise de télémétrie enfouie dans le values.yaml d'un sous-chart. Une mission produit une nomenclature auditée où chaque dépendance externe est soit mise en miroir vers un service interne, soit éliminée de manière démontrable.
C'est le travail que les fournisseurs de matériel, les fournisseurs cloud et les éditeurs de plateformes managées ne font pas — parce que leur modèle économique ne les incite pas à trouver et corriger les 2 % de fuites restantes qui font s'effondrer les revendications de souveraineté lors d'un audit.
Une infrastructure GPU air-gap qui fonctionne réellement hors ligne
Un cluster d'IA air-gap n'est pas un déploiement Kubernetes standard dont on aurait débranché le câble Internet. Le NVIDIA GPU Operator prend en charge l'installation déconnectée via un registre d'images local, mais la configuration exige de pré-stager chaque image de conteneur, chaque paquet de pilote et chaque définition de CRD.
Le partitionnement MIG (Multi-Instance GPU) assure une isolation des locataires au niveau matériel sur des nœuds partagés, avec 19 profils de stratégie mixte pris en charge pour les GPU A100 et H100. Le KAI Schedulerde NVIDIA, mis en open source sous licence Apache 2.0 en 2025, ajoute l'allocation fractionnaire de GPU et un ordonnancement tenant compte de la topologie qui a amélioré l'utilisation des clusters de 13 % à 37 % dans des benchmarks en production.
Notre approche consiste à concevoir la chaîne d'approvisionnement complète d'artefacts hors ligne : un registre Harbor avec analyse des vulnérabilités, des dépôts de paquets en miroir avec vérification cryptographique, une autorité de certification interne pour le TLS mutuel, et une strate NTP interne utilisant des sources d'horloge GPS ou rubidium — les mêmes fondations que celles de notre démo fonctionnelle d'un LLM privé souverain.
Pour les environnements classifiés, nous intégrons des diodes de données unidirectionnelles de fournisseurs comme Owl Cyber Defense qui offrent une assurance fondée sur la physique d'un flux de données unidirectionnel jusqu'à 100 Gbps. Les poids du modèle (un modèle de 70 milliards de paramètres pèse plus de 130 Go) transitent par ces diodes sous une chaîne de traçabilité cryptographique : lots d'artefacts signés, vérification par somme de contrôle à chaque transfert, et une règle d'intégrité à deux personnes pour la promotion de la préproduction vers la production.
Le calcul confidentiel sur matériel souverain
Le NVIDIA H100 est le premier GPU doté d'un environnement d'exécution de confiance (TEE) matériel, ancré dans une racine de confiance intégrée à la puce. En mode calcul confidentiel, un tampon de rebond chiffré déplace les données entre les TEE du CPU et du GPU, garantissant que ni l'hyperviseur ni le système d'exploitation hôte ne peuvent accéder en clair aux poids du modèle ou aux données d'inférence.
Intel Trust Authority fournit une attestation composite pour les TEE des CPU Intel TDX et des GPU NVIDIA H100 au sein d'un flux de vérification unique. Cela compte lorsque le modèle de menace inclut un accès interne : un administrateur système disposant des droits root sur l'hôte peut lire la mémoire du GPU dans un déploiement standard, un risque que nous examinons dans nos recherches sur la sécurisation des LLM privés d'entreprise.
Notre méthode consiste à configurer la chaîne d'attestation complète, de la mesure du firmware jusqu'à l'attestation à distance auprès d'un service de vérification souverain, afin que l'environnement puisse produire une preuve cryptographique que le code et les données n'ont pas été altérés — même par l'exploitant de l'installation.
Les contrôles à l'exportation façonnent ce que vous pouvez construire, et où
L'approvisionnement en GPU pour l'IA souveraine est désormais un problème de contrôle à l'exportation. Les puces relevant des ECCN 3A090 et 4A090 (H100, H200, A100, B200, GB200, AMD MI300X) sont soumises à des exigences de licence d'exportation qui varient selon la destination. Une règle du BIS entrée en vigueur le 15 janvier 2026 a fait passer l'examen des H200 à destination de la Chine à un traitement au cas par cas, bien que les douanes chinoises aient ensuite bloqué les importations de leur propre initiative. Une enquête de décembre 2025 a mis au jour des puces expédiées sous une fausse marque « Sandkyan » pour contourner les contrôles.
Pour les acheteurs souverains hors des États-Unis, cela crée de véritables contraintes architecturales. Les délais d'approvisionnement s'étalent sur 8 à 16 semaines même sans complications d'exportation, et les organisations qui lancent l'approvisionnement une fois la conception achevée ajoutent couramment deux à trois mois.
Notre approche intègre la planification de l'approvisionnement dans la phase d'architecture : identifier quelles puces sont disponibles sous quelles exceptions de licence, quels autres silicium évitent les paliers restrictifs, et concevoir la pile logicielle pour la portabilité matérielle afin qu'un futur changement de puce n'impose pas une refonte de l'architecture.
La cartographie réglementaire est de l'architecture, pas de la paperasse
Les exigences de conformité façonnent les décisions d'architecture fondamentales ; elles ne se rajoutent pas après coup. Chaque régime se traduit par des contraintes techniques spécifiques :
- L'article 44 du RGPD restreint les transferts de données personnelles hors de l'UE/EEE, déterminant où les données d'entraînement peuvent résider.
- L'ITAR considère le traitement par l'IA de données techniques contrôlées sur une infrastructure non américaine comme une exportation non autorisée, imposant le recours à GovCloud ou Azure Government.
- Le CMMC Niveau 2 exige un chiffrement validé FIPS 140-3 Niveau 1 — et de nombreux outils d'IA commerciaux échouent à ce test parce qu'ils utilisent un TLS standard sans modules validés FIPS.
- Les règles DPDP 2025 de l'Inde adoptent une approche par liste noire pour la localisation des données, les régulateurs sectoriels du BFSI imposant des mandats plus stricts.
- La certification GAIA-X Label niveau 3 préfigure le schéma EUCS High+, exigeant une protection complète contre toute ingérence juridictionnelle non européenne.
Dans le Golfe, le fonds d'IA souveraine de 100 milliards de dollars de l'Arabie saoudite et le campus d'IA de 5 gigawatts des Émirats arabes unis alimentent des déploiements d'infrastructure massifs.
Notre méthode consiste à faire correspondre chaque régime réglementaire à des décisions architecturales spécifiques : normes de chiffrement, frontières de résidence des données, contrôles d'accès du personnel, granularité de la journalisation d'audit et procédures de réponse aux incidents. Cette cartographie est conçue pour vivre aux côtés de l'infrastructure-as-code, et non dans un classeur de conformité séparé qui s'éloigne de la réalité.
La conversation sur les coûts et les délais
L'étude TCO 2026 de Lenovo a constaté qu'une infrastructure d'IA sur site atteint la parité de coût avec le cloud en moins de quatre mois pour les charges de travail à forte utilisation, avec un avantage de coût pouvant atteindre 18 fois par million de tokens par rapport aux API MaaS. Pour des charges de travail typiques, le seuil de rentabilité se situe entre 10 et 15 mois.
Les délais de construction vont de 3 à 9 mois, s'étendant à 12 pour les constructions bare-metal. Les coûts initiaux s'élèvent de 50 000 à 200 000 dollars pour la mise en place d'un pipeline LLM/RAG, plus 75 000 à 350 000 dollars pour l'intégration en entreprise.
Nous sommes transparents sur les cas où l'infrastructure souveraine n'est pas la bonne réponse : charges de travail à faible volume sous le point de bascule du TCO, organisations dépourvues de capacité d'ingénierie de plateforme pour les opérations continues, et situations où un fournisseur de cloud souverain managé satisfait à l'exigence réglementaire sans infrastructure sur mesure. Dans ces cas-là, notre recommandation est de choisir le bon fournisseur plutôt que de construire sur mesure.
Pourquoi ne pas engager un grand cabinet
Accenture a engagé 3 milliards de dollars dans sa pratique IA. Deloitte propose AI Factory as a Service avec NVIDIA. QuantumBlack de McKinsey compte environ 5 000 experts en IA. Leurs missions souveraines durent de 4 à 10 mois avant le premier déploiement en production.
Nous sommes des ingénieurs d'infrastructure. Une mission est cadrée pour produire un environnement souverain fonctionnel : infrastructure-as-code (Terraform, Helm, Ansible), runbooks opérationnels, modèles de planification de capacité, reprise après sinistre avec procédures testées, et rapports de durcissement conformes aux benchmarks CIS.
Deloitte a rapporté que 42 % des entreprises ont abandonné la plupart de leurs initiatives d'IA en 2025, avec en moyenne 7,2 millions de dollars de coûts irrécupérables par projet. L'antidote est une mission conçue pour produire une infrastructure fonctionnelle plutôt qu'une nouvelle initiative abandonnée.
Points clés à retenir
- La souveraineté, c'est le contrôle de la pile, pas l'emplacement des données — le US CLOUD Act perce les dispositifs limités à la seule résidence des données, quel que soit l'endroit où les données se trouvent physiquement.
- Nous concevons les trois postures : isolement physique complet (air-gap), cloud privé sans fournisseur américain, et infrastructure conforme à l'ITAR .
- Un audit de dépendances systématique colmate les fuites (tirages depuis nvcr.io, appels au serveur d'origine de Vault, DNS/NTP/télémétrie) qui font s'effondrer la plupart des revendications de souveraineté lors d'un audit.
- Les clusters GPU air-gap utilisent l'isolation MIG, le KAI Scheduler (13 % → 37 % d'utilisation), une chaîne d'approvisionnement d'artefacts hors ligne et des diodes de données jusqu'à 100 Gbps.
- Les TEE matériels du H100 associés à l'attestation Intel Trust Authority protègent les poids du modèle même face à un initié disposant des droits root ou à l'exploitant de l'installation.
- Les régimes réglementaires (EU AI Act, RGPD art. 44, ITAR, CMMC Niveau 2, DPDP indien, GAIA-X) sont cartographiés directement dans l'infrastructure-as-code.
- Le sur site peut atteindre la parité avec le cloud en moins de quatre mois à forte utilisation (avantage pouvant atteindre 18 fois par token) ; le résultat visé est une infrastructure fonctionnelle, et non un slide deck de 4 à 10 mois.
Infrastructure et déploiement d'IA souveraine
 Regarder
Détection des deepfakes en entreprise & prévention de la fraude aux appels vidéo | Veriprajna
En février 2024, des attaquants ont utilisé des deepfakes générés par IA de toute une équipe dirigeante pour dérober 25,6 millions de dollars à Arup lors d'un seul appel vidéo. Depuis janvier 2026, les polices d'assurance cyber standard excluent explicitement la fraude par deepfake.
 Regarder
Smart Meter AI : maintenance prédictive AMI & validation des firmwares | Veriprajna
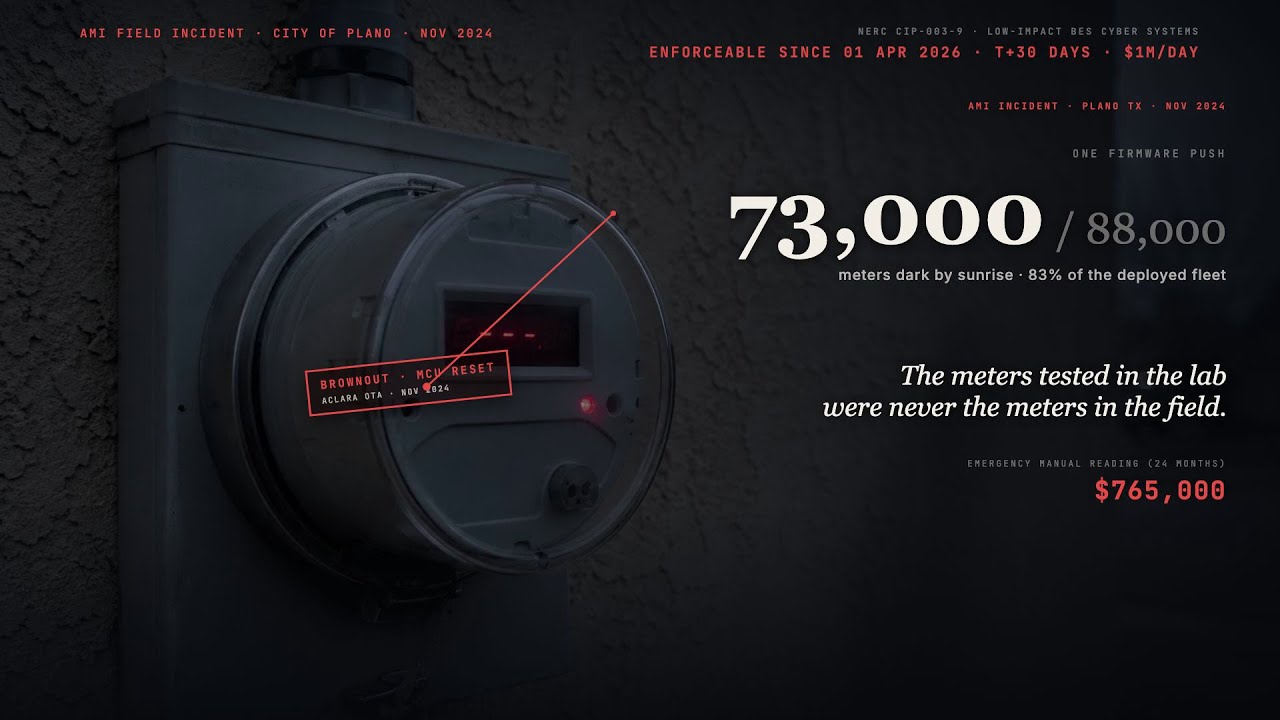
Une seule mauvaise mise à jour de firmware a coûté 765 000 $ à Plano (Texas) et mis 73 000 compteurs hors service. Memphis dépense 9 M$ en réparations. Votre tête de réseau AMI repère quels compteurs ont cessé de communiquer.
 Regarder
Intégrité du déploiement des mises à jour logicielles & résilience informatique | Veriprajna
Le 19 juillet 2024, un seul fichier de configuration a fait planter 8,5 millions de machines Windows en moins de 90 minutes. Pas un logiciel malveillant.
 Regarder
IA souveraine & déploiement de LLM privés | Veriprajna
Une organisation sur cinq a déjà subi une violation de données liée à l'usage d'outils d'IA non autorisés. Interdire l'IA ne fonctionne pas. Construire des alternatives sûres et souveraines, si.
Questions fréquentes
Combien coûte une infrastructure d'IA souveraine par rapport au cloud ?
L'économie dépend de l'utilisation. L'étude TCO 2026 de Lenovo a constaté qu'une infrastructure d'IA sur site atteint la parité de coût avec le cloud en moins de quatre mois pour les charges de travail à forte utilisation, avec un avantage de coût pouvant atteindre 18 fois par million de tokens par rapport aux API de type model-as-a-service. Pour des charges de travail d'entreprise typiques, le seuil de rentabilité se situe entre 10 et 15 mois d'utilisation continue. Les coûts de déploiement initiaux vont de 50 000 à 200 000 dollars pour la mise en place d'un pipeline LLM et RAG, plus 75 000 à 350 000 dollars pour l'intégration en entreprise. Les organisations qui n'atteindront pas le point de bascule du TCO sont mieux servies par des fournisseurs de cloud souverain managé comme OVHcloud ou Scaleway, qui offrent une souveraineté UE authentique à environ 4,8 fois plus de valeur par euro par rapport à AWS (benchmark Callista, février 2026).
Combien de temps faut-il pour déployer une infrastructure d'IA souveraine ?
Le délai va de 3 à 9 mois, s'étendant à 12 mois pour des constructions sur site complètes partant de zéro (bare metal). Le goulot d'étranglement le plus courant est l'approvisionnement en matériel : les clusters NVIDIA H100 et H200 ont des fenêtres de livraison de 8 à 16 semaines. Les organisations qui lancent l'approvisionnement une fois la conception achevée ajoutent couramment deux à trois mois. Nous intégrons la planification de l'approvisionnement dans la phase d'architecture et menons les chantiers en parallèle : commande de matériel, conception de la pile logicielle, audit de dépendances et cartographie réglementaire se déroulent simultanément. Les organisations disposant déjà d'une infrastructure de cloud privé peuvent réduire les délais de façon significative.
AWS GovCloud ou Azure Government sont-ils vraiment souverains ?
Ils satisfont à la résidence des données et à des cadres de conformité spécifiques (FedRAMP High, DoD IL4-6, CMMC Niveau 2), mais ils n'offrent pas de souveraineté structurelle. Le US CLOUD Act accorde un accès extraterritorial aux données détenues par des entreprises ayant leur siège aux États-Unis, quel que soit leur lieu de stockage physique. Pour les charges de travail ITAR et les cas d'usage de défense américains, GovCloud et Azure Government sont le bon choix car l'ITAR lui-même impose une infrastructure sous contrôle américain. Pour les organisations de l'UE cherchant à s'affranchir de la portée juridictionnelle américaine, ou pour les gouvernements bâtissant une capacité nationale d'IA, ces plateformes ne satisfont pas aux exigences de souveraineté de Layer 3. La distinction compte : 61 % des DSI d'Europe occidentale privilégient désormais les fournisseurs cloud locaux précisément pour atténuer ce risque.
Quelles dépendances cachées compromettent la souveraineté dans la plupart des déploiements ?
Les fuites les plus courantes que nous trouvons : les charts Helm du NVIDIA GPU Operator tirant des images de conteneurs depuis nvcr.io au redémarrage des pods. Les appels au serveur d'origine pour la validation de licence de HashiCorp Vault (introduits avec le passage à la BSL en 2023). Le DNS par défaut de Kubernetes résolvant auprès des serveurs racine en amont. La synchronisation NTP ciblant pool.ntp.org. Les exportateurs Prometheus recherchant des mises à jour. Des fichiers values.yaml de sous-charts Helm avec des URL de registre externe codées en dur. Des balises de télémétrie dans les agents de supervision. Des vérifications de révocation de certificats sollicitant des répondeurs OCSP externes. Individuellement mineures, collectivement elles signifient que votre déploiement air-gap communique vers l'extérieur. Nous menons un audit systématique de chaque dépendance réseau avant de déclarer un environnement souverain.
Quels GPU NVIDIA puis-je acquérir pour un déploiement souverain hors des États-Unis ?
La disponibilité des GPU dépend de votre juridiction. Les puces de calcul avancé relevant des ECCN 3A090 et 4A090 (H100, H200, A100, B200, GB200, AMD MI300X) sont soumises à des exigences de licence d'exportation qui varient selon le pays de destination et l'utilisation finale. Une règle finale du BIS entrée en vigueur le 15 janvier 2026 a ajusté les politiques d'examen pour des combinaisons puce-pays spécifiques, mais l'application reste fluctuante. Nous aidons à naviguer l'approvisionnement : identifier quelles puces sont disponibles sous quelles exceptions de licence, si l'AMD MI300X ou l'Intel Gaudi évite les paliers les plus restrictifs pour votre juridiction, et concevoir la pile logicielle pour la portabilité matérielle afin qu'un futur changement de puce n'impose pas une refonte complète de l'architecture.
Comment mettez-vous à jour les modèles d'IA dans un environnement air-gap ?
Par un pipeline de chaîne de traçabilité cryptographique. Un modèle de 70 milliards de paramètres pèse plus de 130 Go, le transfert exige donc une planification. Pour les environnements équipés de diodes de données unidirectionnelles (Owl Cyber Defense, Waterfall Security), des lots d'artefacts signés circulent vers l'intérieur par des canaux unidirectionnels fondés sur la physique jusqu'à 100 Gbps. Pour les environnements en sneakernet, nous utilisons des supports physiques chiffrés avec vérification par somme de contrôle à chaque transfert et une règle d'intégrité à deux personnes pour la promotion en production. Le pipeline comprend : l'empaquetage du modèle avec des signatures cryptographiques traçables jusqu'à l'environnement d'entraînement, la vérification d'intégrité à l'ingestion, le déploiement en préproduction avec des tests de validation automatisés, et une porte de promotion exigeant une double autorisation. Chaque étape est journalisée dans une piste d'audit inviolable.
Quelles réglementations imposent une infrastructure d'IA souveraine ?
Plusieurs cadres réglementaires imposent désormais, ou incitent fortement à, un déploiement souverain. Le règlement européen sur l'IA (pleinement applicable le 2 août 2026) exige la journalisation automatique des événements et le suivi de la lignée des données pour les systèmes à haut risque. L'article 44 du RGPD restreint les transferts de données personnelles hors de l'UE/EEE. L'ITAR considère le traitement par l'IA de données techniques contrôlées sur une infrastructure non américaine comme une exportation non autorisée. Le CMMC Niveau 2 (s'appliquant aux contrats du DoD d'ici le 9 novembre 2026) exige un chiffrement validé FIPS 140-3. Les règles DPDP 2025 de l'Inde permettent une localisation des données propre à chaque secteur. Les directives DORA et NIS2 de l'UE rendent le cloud souverain obligatoire pour certaines charges de travail financières et d'infrastructures critiques. Le GAIA-X Label niveau 3 préfigure la certification EUCS High+ exigeant une protection contre toute ingérence juridictionnelle non européenne.
Quand une infrastructure d'IA souveraine N'EST-ELLE PAS le bon choix ?
Trois situations. Premièrement, les charges de travail d'inférence à faible volume qui n'atteindront pas le point de bascule du TCO où l'investissement sur site s'amortit. Si votre dépense annuelle de cloud IA est inférieure à 100 000 dollars, le coût en capital et la charge opérationnelle d'une infrastructure souveraine l'emportent probablement sur les économies. Deuxièmement, les organisations dépourvues de la capacité interne d'ingénierie de plateforme (ou du budget pour des opérations managées) permettant d'exploiter des clusters Kubernetes accélérés par GPU après le transfert. Une infrastructure souveraine exige un investissement opérationnel continu. Troisièmement, les charges de travail où un fournisseur de cloud souverain managé (OVHcloud, Scaleway, Deutsche Telekom) satisfait à vos exigences réglementaires et où une infrastructure sur mesure ajoute de la complexité sans bénéfice. Nous aidons les clients à tracer cette ligne avant d'engager du capital.
Développez votre IA en toute confiance.
Collaborez avec une équipe forte d'une solide expérience dans la conception de la prochaine génération d'IA d'entreprise. Nous vous aidons à concevoir, développer et déployer une stratégie d'IA digne de confiance.
Veriprajna société de conseil en Deep Tech est spécialisée dans la conception de systèmes d'IA critiques pour la sûreté destinés aux secteurs de la santé, de la finance et de la réglementation. Nos architectures sont validées au regard de protocoles établis et accompagnées d'une documentation de conformité complète.