« Nous avons retiré la race du modèle » : la phrase qui perd le procès de tarification

En décembre 2025, la FTC a conclu un accord transactionnel de 60 millions de dollars avec Instacart au sujet des expérimentations tarifaires Eversight, la plainte documentant des écarts de prix atteignant jusqu'à 23 % sur des articles identiques. La FTC n'a jamais eu besoin d'établir ce qui avait été communiqué à l'algorithme ; l'accusation reposait sur les tarifs réellement affichés à différents acheteurs pour un même produit.
La phrase réflexe de chaque équipe de tarification est l'antithèse d'un argument axé sur les résultats : nous avons supprimé l'origine ethnique et le revenu du modèle. Je crois la sincérité des équipes qui l'affirment. Je pense également que c'est la phrase qui leur fait perdre le procès. Plutôt que de disserter dans l'abstrait, j'ai développé un moteur de tarification capable de prononcer honnêtement cette phrase à son propre sujet, puis je l'ai audité. Ce moteur est un bandit contextuel LinUCB à sept leviers de prix, initialisé avec la graine 42, optimisé pour le chiffre d'affaires sur une population synthétique de 10 000 acheteurs que j'ai générée en y intégrant volontairement une structure de variables d'approximation (proxys). J'ai nommé ce cybermarchand fictif ShopMart. Aucun véritable distributeur n'a été audité et aucun vrai client n'a été surfacturé, et c'est précisément pourquoi je connais la vérité terrain et peux évaluer l'audit en conséquence. La couche supérieure est une console que j'ai baptisée Equity, conçue pour opérer sur n'importe quel moteur de tarification préexistant ; dans cette version, le moteur évalué est mon propre bandit. La démonstration complète est consultable à l'adresse veriprajna.com/demos/ai-pricing-compliance.
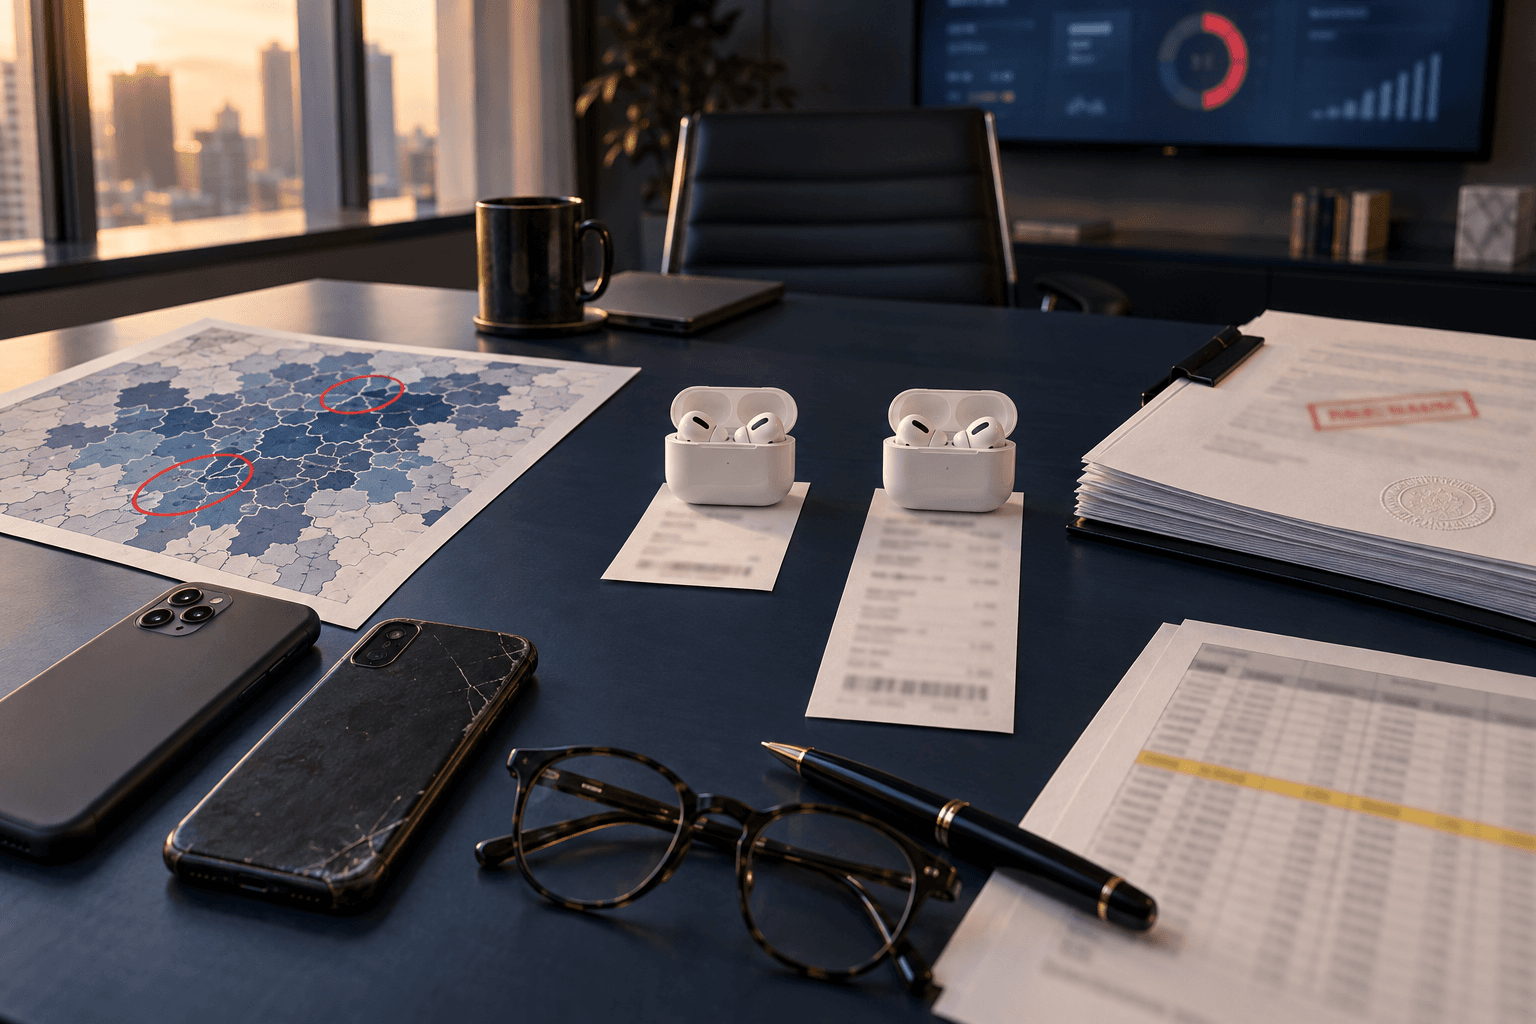
Mêmes écouteurs, demande appariée, 26 % plus cher
J'ai fourni neuf variables d'entrée au bandit, dont aucune ne constitue un attribut protégé : l'indice de revenu du code postal, la catégorie d'appareil, la source de redirection, le temps de visite, la taille du panier, le taux de réachat, le nombre de sessions, l'abonnement fidélité et l'heure de la journée, assortis de termes croisés redirection-visite. Les moteurs réels intègrent souvent des interactions ou des arbres décisionnels, et je souhaitais que le mien réplique ces capacités. Je lui ai ensuite demandé de tarifier une référence unique, les Aura Wireless Earbuds, affichés à un prix catalogue de 79.00 $, sur l'ensemble des 10 000 décisions.
La fiche principale de la console apparaît en premier à l'écran avant toute exécution. Deux cohortes, un même produit, signaux de demande appariés. L'ensemble de décisions A représente la cohorte code postal aisé et appareil récent, 2 880 décisions, figurée par un code postal de l'Upper East Side et un iPhone neuf : prix affiché 74.06 $. L'ensemble de décisions B représente la cohorte code postal à forte mixité ethnique et appareil ancien, 3 037 décisions, figurée par le South Bronx et un ancien terminal Android : 93.47 $. Variance mesurée : +26.2 %. Il s'agit de moyennes de cohortes portant sur environ 3 000 décisions chacune ; ce résultat traduit le comportement systématique de la politique tarifaire et non le sort d'un acheteur isolé. Le code postal et le smartphone affichés représentent le profil type de chaque groupe, non sa définition.
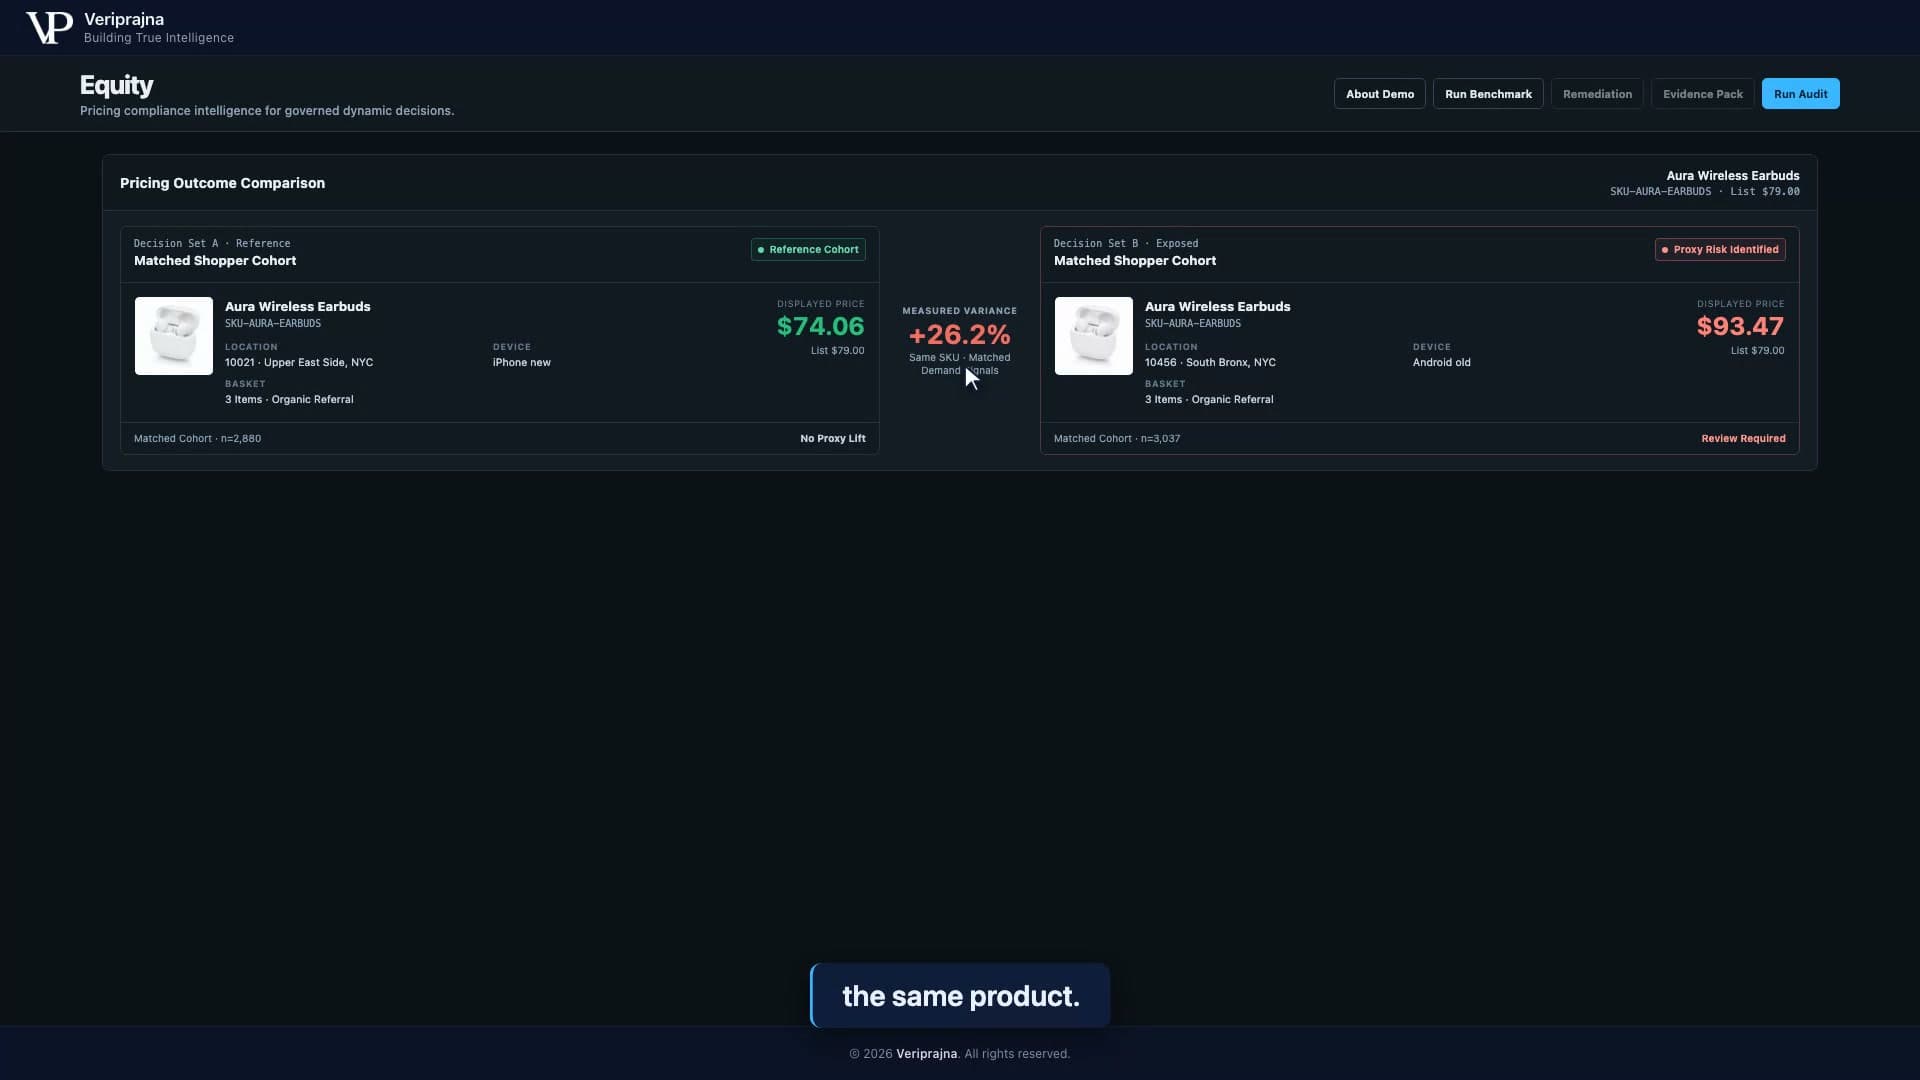
Ce qui m'a déconcerté, c'est que je n'avais rédigé aucune règle pouvant être qualifiée de discriminatoire. J'avais codé un maximisateur de revenus en l'alimentant de signaux prédictifs de la propension à payer. Le code postal corrèle avec le revenu, le revenu corrèle avec l'élasticité-prix, un vieil Android signale une moindre comparaison des offres. Aucun de ces critères n'est la race. Tous évoluent de concert avec elle, et un bandit optimisé pour le profit détecte chaque corrélation. Cet écart de 26 % est l'illustration pure de ce à quoi ressemble l'optimalité financière lorsque les signaux véhiculent la cohorte.
La variable d'approximation tapie entre deux entrées irréprochables
J'ai conçu l'audit pour évaluer chaque entrée sous trois angles, car chaque test individuel recèle une faille : la corrélation absolue de Pearson avec la cohorte protégée (un label que l'audit ne reçoit jamais), l'information mutuelle normalisée (NMI) et un rejeu contrefactuel des prix. Ce rejeu remplace l'entrée ciblée pour la cohorte protégée par la valeur de référence de la cohorte favorisée, fige toutes les autres variables, réexécute la politique du moteur et mesure l'amplitude de variation tarifaire. Cette procédure est agnostique au modèle : elle fait varier l'entrée et observe la sortie, peu importe qu'il s'agisse d'un bandit, d'un arbre ou d'une boîte noire.
Les deux premières lignes du tableau d'audit des entrées confirment les intuitions. Indice de revenu du code postal : |r| 0.95, MI 1.00, contrefactuel +7.8 %, VIOLATION. La géographie encode intégralement la catégorie protégée dans cette population et le moteur fonde sa tarification dessus. Catégorie d'appareil : 0.32, 0.08, +2.9 %, VIOLATION, un signal d'apparence neutre qui franchit le seuil de corrélation de 0.30 et le seuil d'information mutuelle de 0.05 programmés dans le code.
La troisième VIOLATION échappe totalement aux audits variable par variable. La source de redirection isolée : |r| 0.00, MI 0.00, PASS. Le temps de visite isolé : 0.17, 0.03, PASS. Un audit univarié valide les deux. La ligne d'interaction Source de redirection × Temps de visite indique un |r| de 0.00 et une information mutuelle conjointe de 0.73, contrefactuel +1.7 %, VIOLATION. Cela représente un gain d'interaction de 0.71 par rapport à la meilleure variable prise isolément.
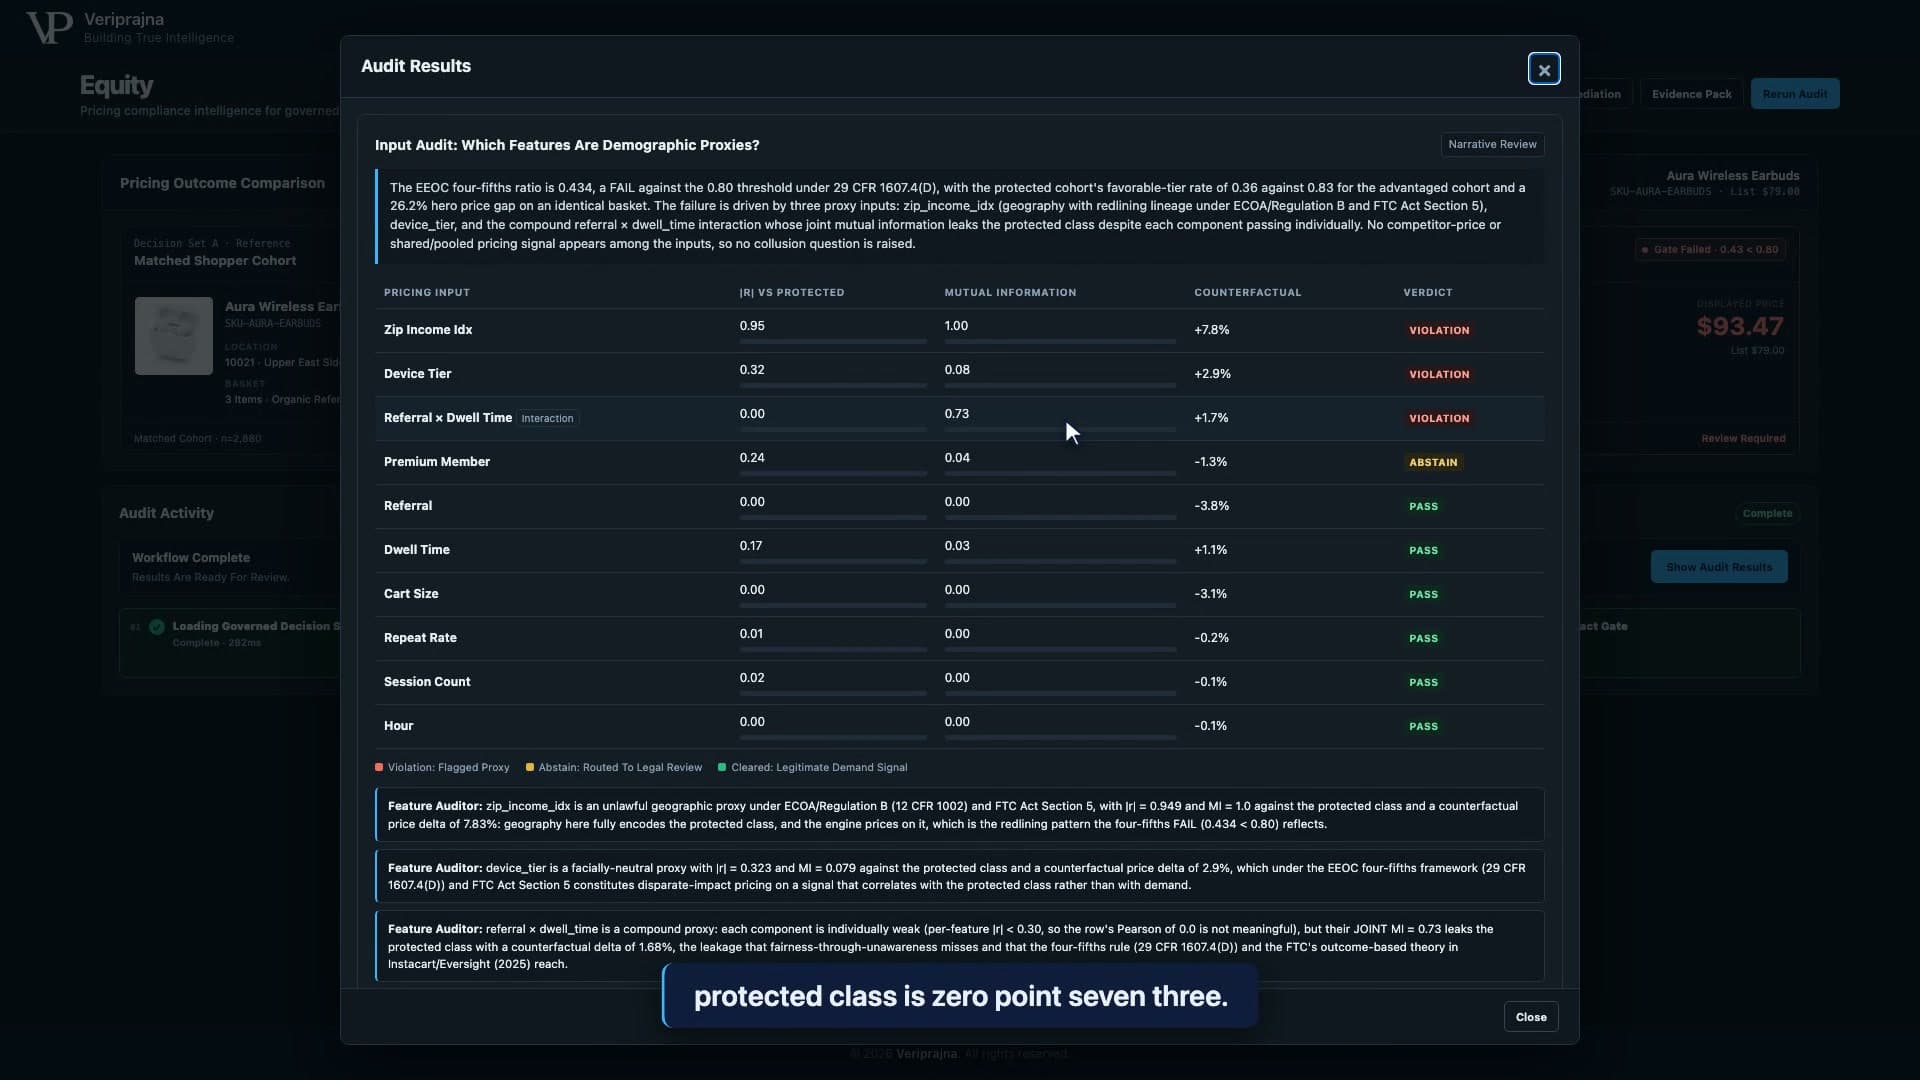
J'avais implanté cette structure selon une porte XOR. Une redirection organique associée à une longue visite caractérise la cohorte protégée. Une redirection par comparateur avec une visite brève la caractérise également. Les combinaisons organique-brève et comparateur-longue définissent la cohorte favorisée. Ni le canal d'arrivée ni la durée de navigation ne discriminent les groupes à eux seuls ; seul leur croisement y parvient. La corrélation, instrument unidimensionnel, ne peut le voir. L'information mutuelle conjointe le révèle immédiatement. Un programme de conformité qui audite les variables une par une examine le mauvais objet, et je n'ai trouvé aucun autre moyen de le prouver qu'en bâtissant une population au sein de laquelle l'analyse univariée est infailliblement trompeuse.
La ligne de défense que j'aurais moi-même plaidée
J'ai testé la défense que j'aurais jadis présentée à un régulateur, à savoir l'équité par ignorance (fairness through unawareness) : retirer le code postal et l'appareil, réentraîner le moteur et présenter le résultat. Je savais que le proxy composite demeurait actif. Ce que j'ignorais, c'était la part des 0.43 attribuable au code postal et à l'appareil seuls par rapport au couple latent. Supprimer le code postal et l'appareil puis réentraîner a fait remonter le ratio des quatre cinquièmes de 0.43 à 0.59. Toujours un échec, et l'écart résiduel constitue la part exacte qui déjoue les contrôles univariés. La fiche de référence en résume la cause en quatre mots : Compound Proxy Still Leaks.
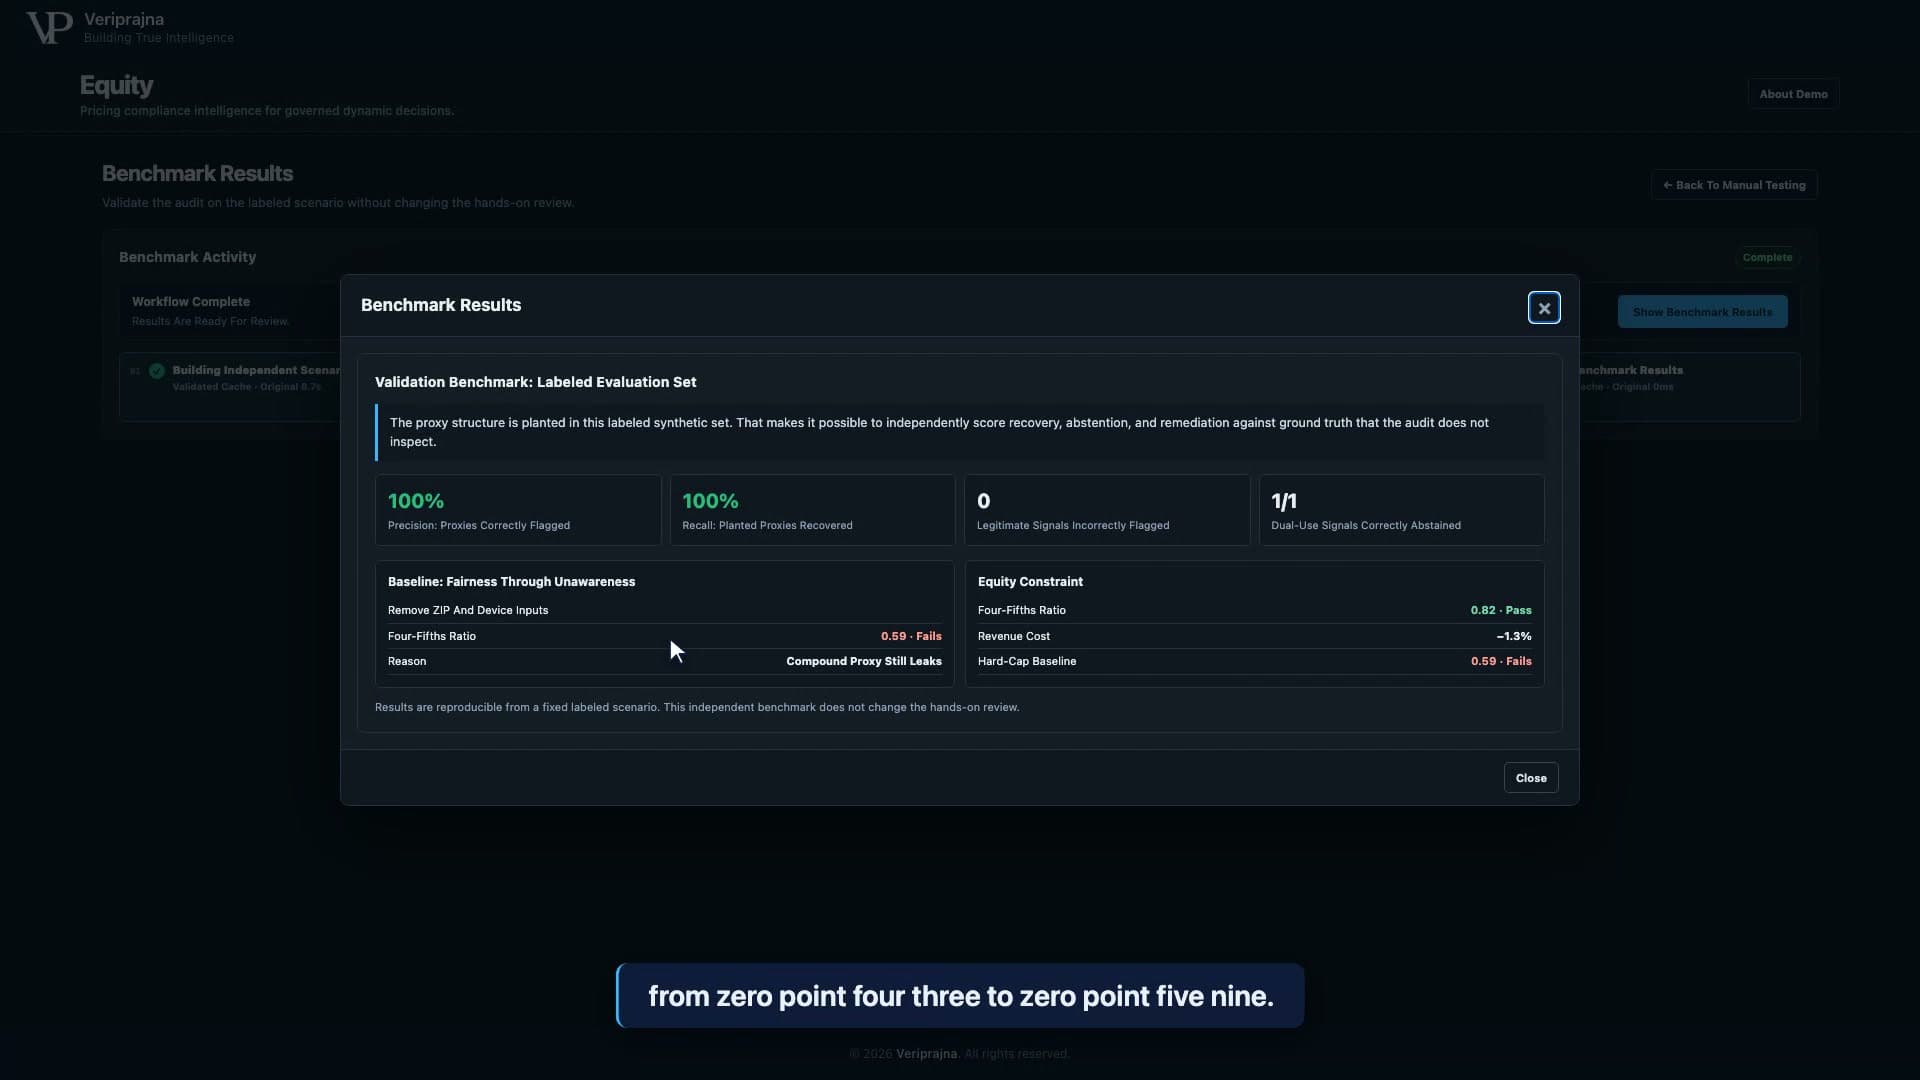
Ce constat a radicalement transformé ma perception de cette formule. Le moteur a identifié la cohorte malgré tout, par l'intermédiaire de deux signaux réputés vierges à chaque test individuel, et il continuera de le faire, car la rentabilité récompense cette découverte. L'argument de l'ignorance ne coûte rien à formuler mais aboutit à un chiffre indéfendable lors des expertises judiciaires.
Le 100 % figurant sur cette carte a une signification circonscrite. Le benchmark reconstruit la population initiale générée avec la graine 42 et mesure la détection face aux proxys implantés ; une précision et un rappel de 100 % signifient 3 proxys introduits sur 3 détectés sans aucun faux positif sur ce jeu de données de synthèse. C'est une vérification interne face à une vérité maîtrisée, que je ne transposerais pas comme taux de précision sur des journaux de vente réels, truffés de facteurs confondants impossibles à modéliser.
La signification de 0.43 et pourquoi aucun modèle ne devait en décider
J'ai refusé d'inventer une métrique d'équité maison, car un régulateur n'a aucune raison d'accorder du crédit à un chiffre arbitraire. Le seuil retenu dans Equity provient d'un standard juridique externe : la règle des quatre cinquièmes de l'EEOC (29 CFR 1607.4(D)), adaptée des taux de sélection aux échelons de prix. Être favorisé signifie ici accéder à un palier tarifaire inférieur au palier maximal. Avec le moteur d'origine, 36 % de la cohorte protégée bénéficie du tarif préférentiel contre 83 % pour la cohorte favorisée. 0.36 divisé par 0.83 donne 0.43, pour un seuil légal fixé à 0.80 : le voyant vire au rouge sur Fail. À ses côtés : 64 % de la cohorte protégée cantonnée dans la tranche tarifaire la plus haute, et une surfacturation moyenne de +15.6 % par rapport au groupe favorisé.
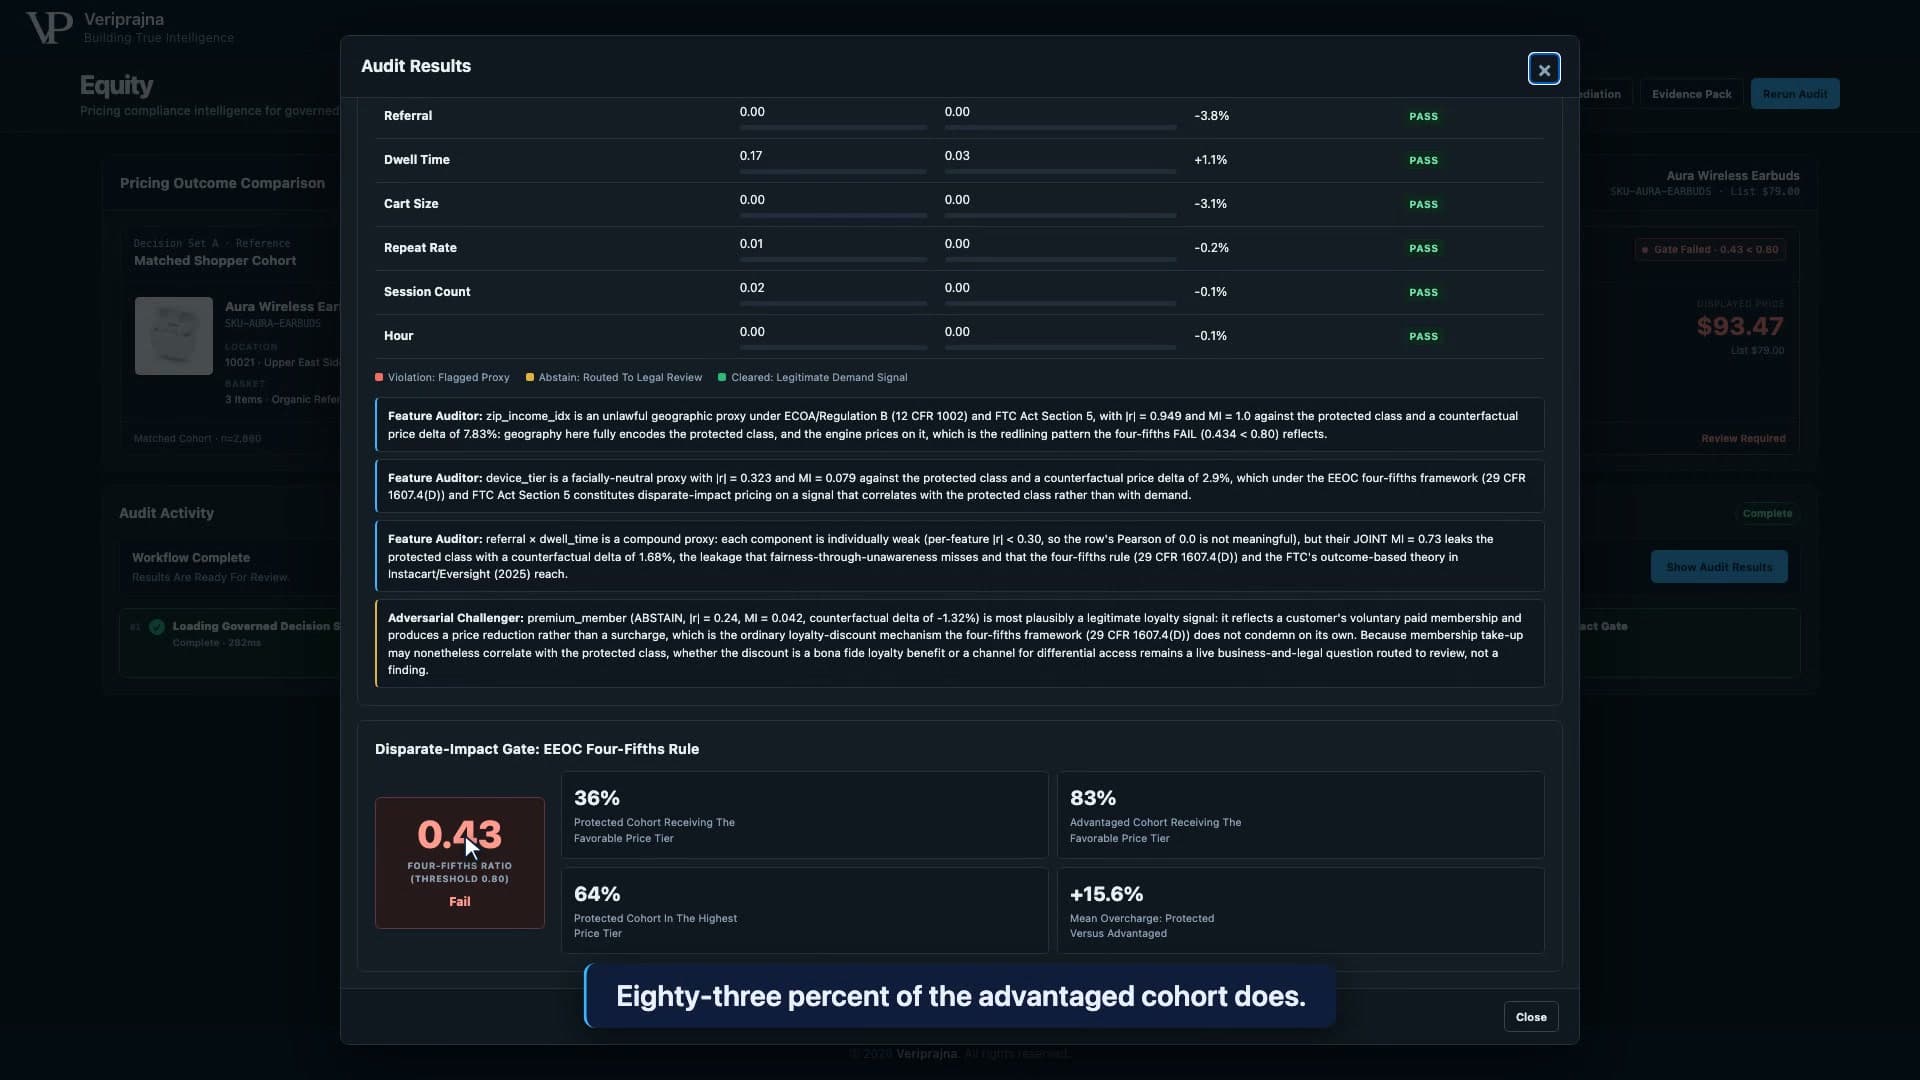
La logique d'évaluation s'exécute en pur NumPy, à l'extérieur de la couche d'agents, selon un ordre rigoureux que je peux exposer sans détours à un magistrat. Les signaux à double usage sont inspectés avant le test de violation : Membre Premium présente une corrélation de 0.24 avec la cohorte protégée tout en constituant un signal d'engagement commercial légitime ; le code renvoie alors ABSTAIN et le transmet à la revue juridique plutôt que de l'incriminer ou de l'absoudre aveuglément, et aucun processus aval n'est autorisé à le requalifier en infraction. Suivent les seuils d'infraction, la plage d'abstention, puis la mention PASS. Panier, réachat, sessions et créneau horaire sont tous validés. L'audit n'incrimine pas aveuglément l'ensemble des données, et un audit qui sanctionne tout est aussi inutile face à une assignation d'enquête civile (CID) qu'un audit qui ne décèle rien.
Les agents du collectif – un auditeur de variables et un contradicteur – rédigent des argumentaires ; le troisième rôle prévu, le cartographe réglementaire, consiste ici en une table de correspondance immuable plutôt qu'en un modèle. La mission du contradicteur est de plaider avec force la légitimité du programme de fidélité pour le signal abstenu, et il s'y emploie à l'écran. En revanche, il ne peut ni modifier le 0.24, ni altérer un verdict, ni décider si 0.43 est inférieur à 0.80. J'ai instauré ce cloisonnement dès le départ : les agents conseillent, le code tranche, et le modèle est libre de se montrer aussi éloquent qu'il le désire au sujet de valeurs auxquelles il lui est interdit de toucher.
La correction que j'espérais voir fonctionner
La première correction que j'ai éprouvée fut un plafonnement, car c'est la solution réflexe de toute équipe de tarification : ne jamais fixer un tarif excédant de 15 % le prix de référence équitable. Je l'ai intégrée sous le nom de Hard-Cap Baseline en pensant qu'elle constituerait une réponse ordinaire et suffisante. Elle a amputé 0.2 % du chiffre d'affaires tout en échouant au test avec un ratio de 0.59. La signature de contournement affichée en clarifie la raison : 29 % des membres de la cohorte protégée ont vu leur prix fixé à moins de 1 % sous la limite du plafond. Le verdict indique Gamed To The Boundary. Le plafond s'avère économique précisément parce que le moteur a repositionné la cohorte pénalisée juste sous la frontière – et le binôme économique-mais-défaillant est séduisant en réunion budgétaire mais fatal lors de la communication de pièces au tribunal.
Un système axé sur le chiffre d'affaires traite un plafond comme une cible.
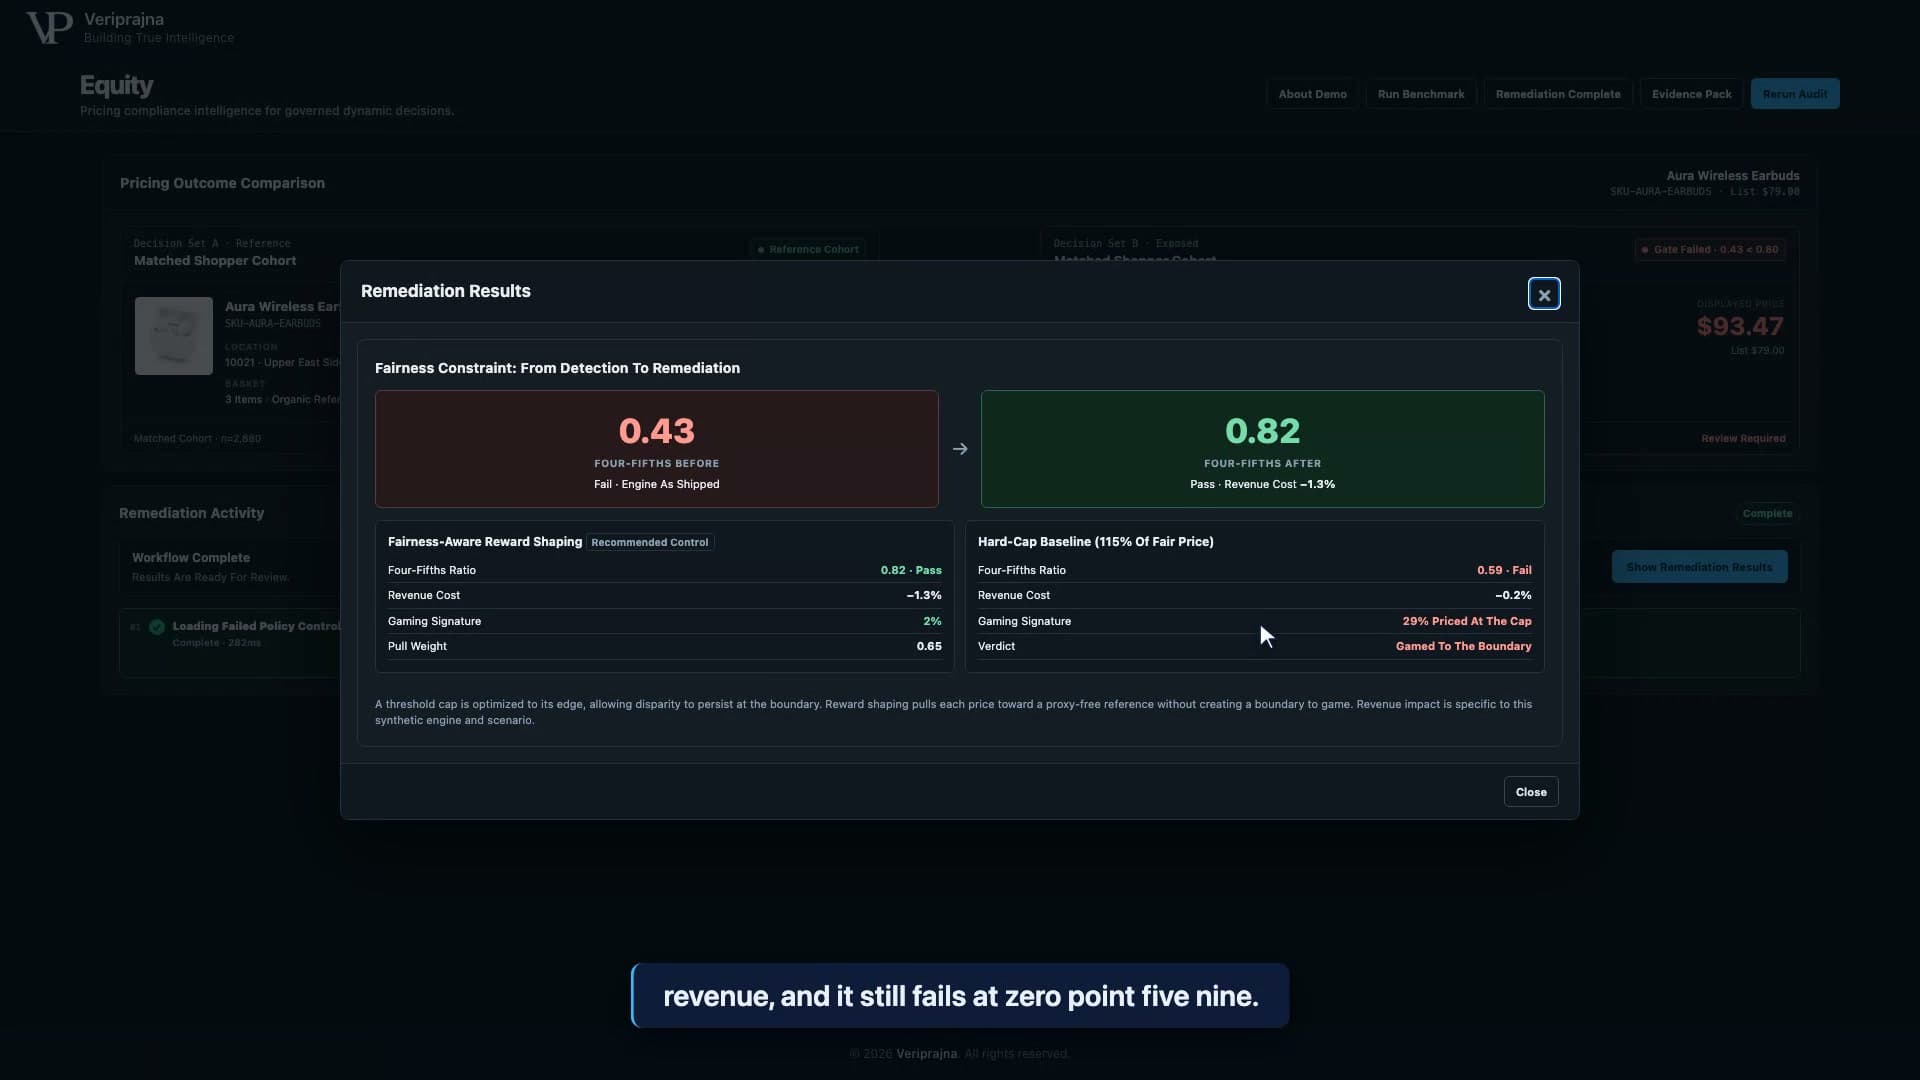
Le dispositif qui a tenu ses promesses est l'ajustement équitable des récompenses (Fairness-Aware Reward Shaping). Au lieu d'une barrière rigide, il tire en continu chaque tarif vers un prix de référence exempt de proxys – issu d'un second bandit entraîné sans variables biaisées mais avec tous les signaux légitimes – et détermine par recherche dichotomique le coefficient minimal permettant de dépasser 0.80. Sur ce moteur, ce coefficient est de 0.65 ; un cran plus bas, à 0.625, le score plafonnait à 0.778. Ratio des quatre cinquièmes après ajustement : 0.82, Pass. Coût sur le chiffre d'affaires : 1.3 %. Signature de contournement de 2 %, car il n'y a aucun seuil à exploiter. Les mentions légales de la console précisent que l'incidence financière est propre à ce moteur de synthèse, et je le répète avec insistance : ces 1.3 % constituent une mesure sur un échantillon synthétique, nullement un barème universel du coût de l'équité.
L'utilité du dossier de conformité
J'ai conçu le dossier probatoire en dernier lieu, car rien de ce qui précède n'a de valeur si un avocat ne peut le verser aux débats. Lorsqu'une assignation d'enquête civile (CID) est notifiée, l'entreprise qui n'a pas consigné les données idoines s'épuise en mois d'extractions médico-légales. Equity scelle la production de l'audit au sein d'un paquet JSON assorti d'une version HTML imprimable : nom et version du moteur, 10 000 décisions auditées, seuil de conformité, disparité représentative, constat et justification de chaque entrée, issue de la remédiation et empreinte SHA-256 du corps du dossier pour garantir l'intégrité. Chaque VIOLATION est corrélée à cinq régimes juridiques : la règle des quatre cinquièmes de l'EEOC, l'Algorithmic Pricing Disclosure Act de New York (applicable au 10 novembre 2025, sanction civile jusqu'à 1 000 $ par infraction), l'AI Act du Colorado (SB 24-205, en vigueur le 30 juin 2026), les articles 13 et 14 de l'IA Act européen (obligations à haut risque dès le 2 août 2026) et l'article 5 du FTC Act. L'entrée réservée est renvoyée à une ligne de revue juridique.
La correspondance réglementaire est une table immuable. Il eût été commode de la faire rédiger par un modèle, mais j'ai délibérément exclu ce choix : chaque VIOLATION reçoit invariablement les cinq mêmes lignes juridiques, l'abstention reçoit sa mention d'arbitrage, et aucun texte narratif n'est généré pour ce volet. Un modèle qui disserte sur l'applicabilité des textes est un modèle dont l'argumentaire fluctuera à la version suivante – et un dossier dont la qualification dérive avec le modèle est un dossier qu'un expert judiciaire démolira. Les synthèses narratives du dossier sont produites par modèle et mises en cache ; les chiffres, les verdicts et les correspondances légales relèvent du code pur. Le dossier conserve sa force probante quel que soit le modèle sous-jacent. L'analyse complète, avec démonstration détaillée du dossier à l'écran, est disponible sur veriprajna.com/demos/ai-pricing-compliance.
Veriprajna ne fixe aucun tarif, ne se substitue pas à Pricefx, PROS, Zilliant ou Competera, et ne prononce aucun jugement de droit. Le moteur du client poursuit sa tarification. Je fournis les éléments probatoires ; leur direction juridique prend la décision finale.
Et si vous préférez visualiser l'exécution de l'audit plutôt que d'en lire la relation, en voici l'intégralité d'un bout à l'autre.
Je reviens sans cesse à l'argument énoncé par l'équipe tarifaire, car il est exact : l'origine et le revenu ne figurent pas dans le modèle. Dans le moteur que j'ai développé, cette affirmation véridique côtoie pourtant un écart de 26 % sur les mêmes écouteurs, un score d'équité de 0.43 et un plafonnement qui a échoué tout en donnant l'illusion de fonctionner. Personne n'a précisé au moteur le profil de l'acheteur. Une fonction de récompense financière a suffi, car deviner ce profil était l'estimation la plus rentable qui soit – et l'audit a quantifié avec exactitude l'ampleur de la dérive. La phrase qui résiste au prétoire est bien plus exigeante : nous savions que le moteur déduirait la cohorte sans consigne explicite, nous avons mesuré jusqu'où il allait, et voici ce qu'il nous en a coûté pour l'arrêter.