Une alerte de reconnaissance faciale a obtenu 0.83 : j'ai conçu le filtre qui l'a bloquée

Un score brut FaceFirst de 0.83 n'a pas pu créer de consentement pour une alerte synthétique de reconnaissance faciale à Chicago, le filtre déterministe de politique l'a donc bloquée. J'ai construit ce scénario pour tester si un système biométrique traite la gouvernance comme une composante de la décision ou comme une simple formalité ajoutée alors que la décision est déjà engagée.
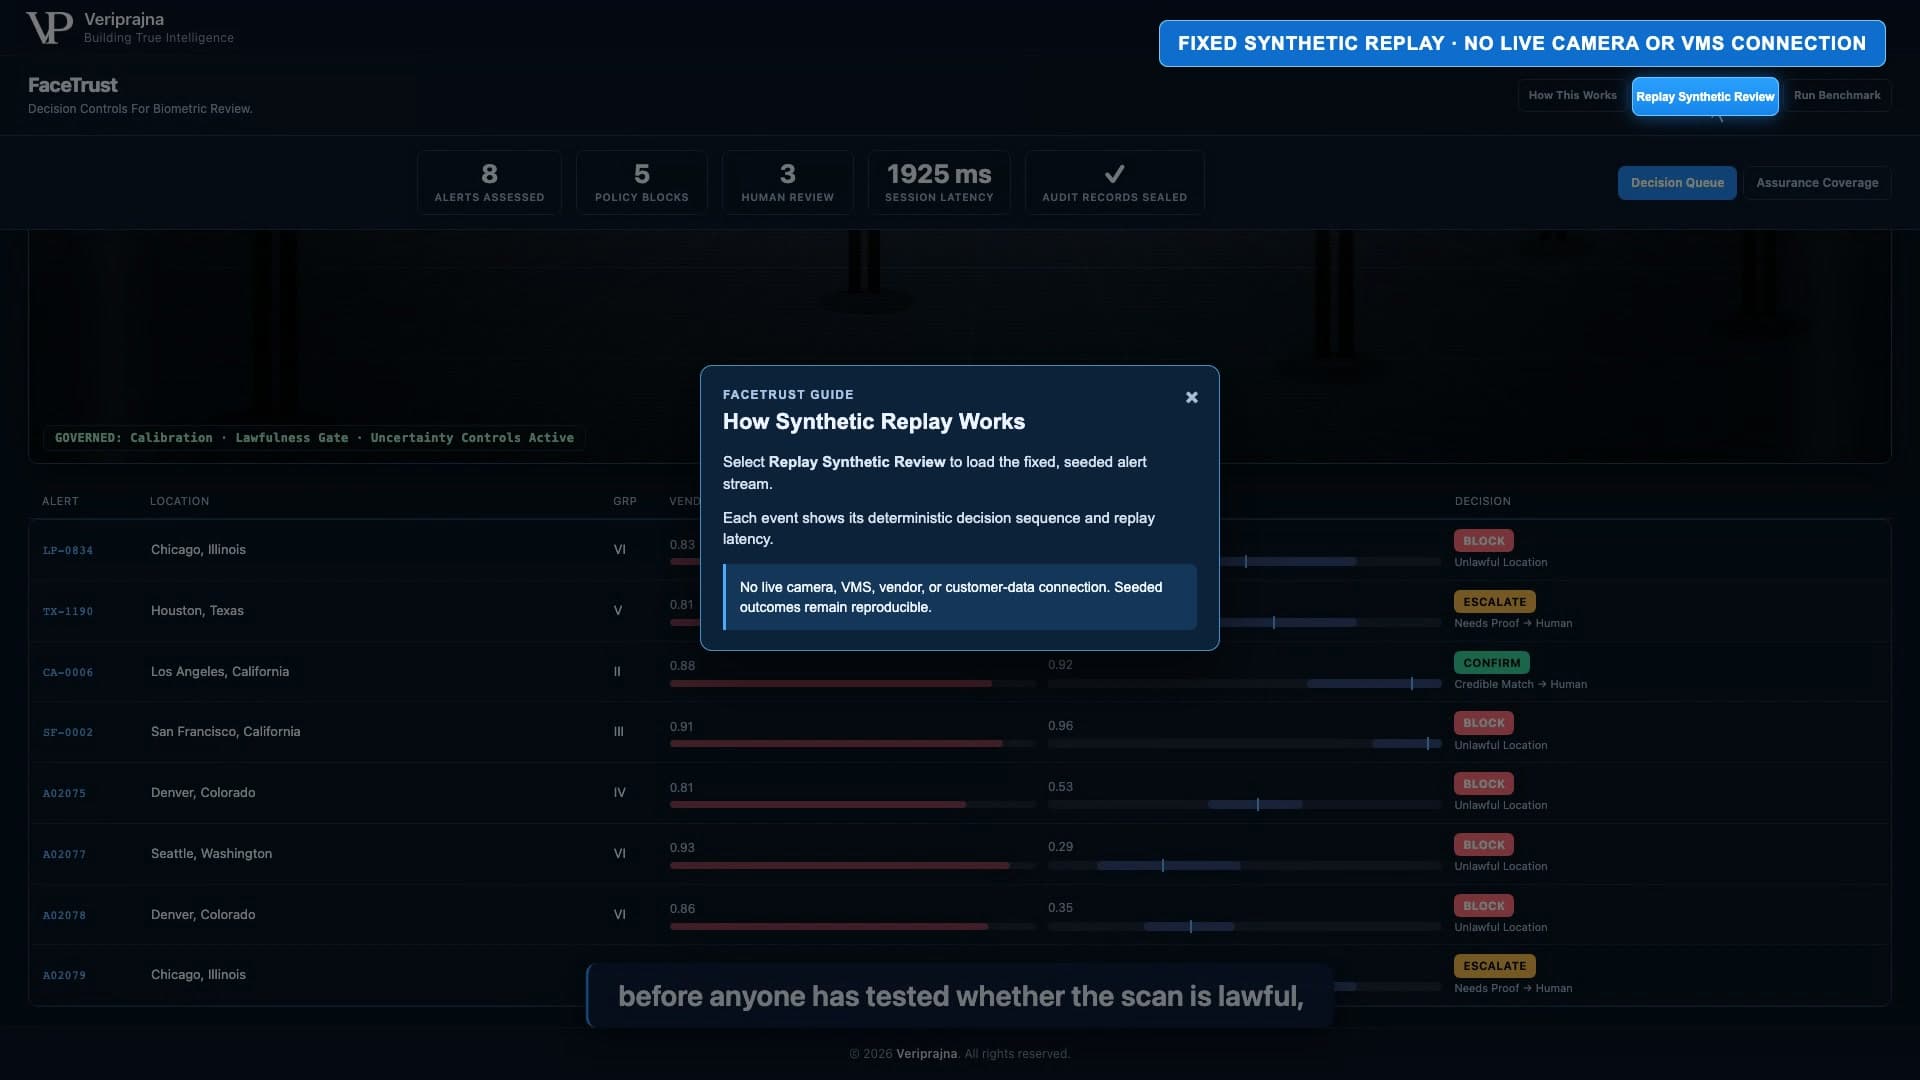
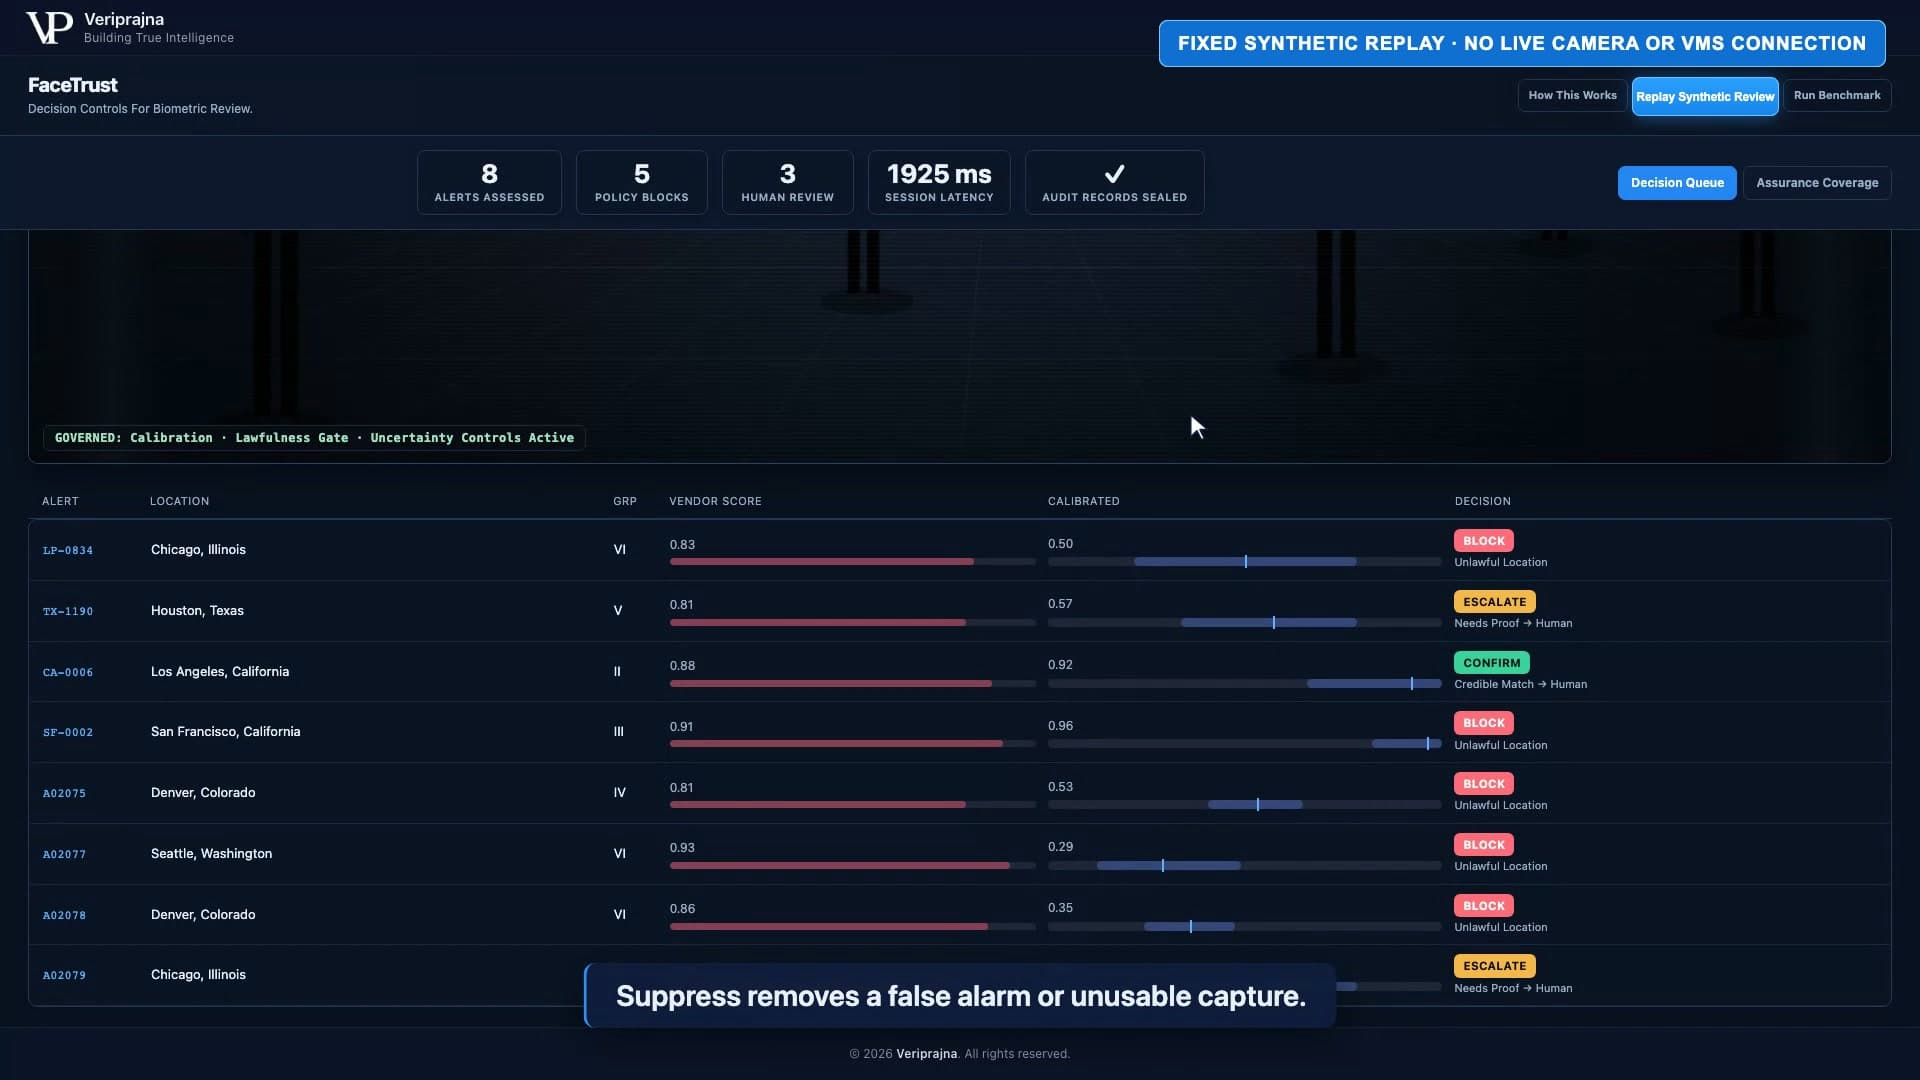
L'alerte est LP-0834, un scénario délibérément simulé à Chicago. Il ne s'agit pas d'un événement client, d'un flux en direct ou du cas d'une personne réelle. La capture test est une image basse lumière de 80 pixels comparée à une photo d'identification judiciaire vieille de 15 ans. FaceTrust calibre le score brut à 0.50, avec un intervalle de [0.217, 0.783] et un ensemble de prédiction conforme à 93% contenant à la fois {mate, no_mate}. Mais le fait décisif est plus simple : aucun consentement n'est enregistré, le filtre déterministe bloque donc l'analyse en vertu de la règle BIPA simulée dans la démo.
Je reviens sans cesse à cet ordre des priorités. Un modèle peut fournir des éléments probants. Il ne doit pas pouvoir décider qu'une condition légale préalable manquante peut être ignorée sous prétexte que son score semble convaincant.
L'analyse complète présente l'interface, la vidéo et le fonctionnement du mécanisme. Ce qui suit constitue la leçon la plus exigeante tirée de sa conception : si un contrôle ne peut expliquer une mauvaise action qu'après coup, il est arrivé trop tard.
Ce que je pensais que 0.83 signifiait
J'ai commencé par le chiffre, car c'est là que le regard se porte naturellement. Dans la file d'attente simulée, LP-0834 côtoie d'autres alertes affichant des scores bruts compris entre 0.81 et 0.91. Un coup d'œil les fait paraître comme des variantes d'une même situation : de fortes correspondances en attente d'une intervention opérationnelle. La file d'attente encourageait mon propre réflexe de classer d'abord et de questionner ensuite.
C'est précisément ce réflexe que je voulais disséquer. Un score brut de fournisseur est une donnée issue d'un unique système de reconnaissance. Il ne m'indique pas si la collecte était autorisée, si la capture était suffisante pour la décision à prendre, ou si l'incertitude entourant un résultat calibré englobe encore une non-correspondance. Pourtant, un score affiché avec deux décimales semble définitif. Sa précision visuelle devance son autorité décisionnelle.
J'ai trouvé les lignes voisines instructives car elles me refusaient une règle facile. TX-1190 affiche un score brut de 0.81 et est orienté vers ESCALATE parce que sa preuve calibrée demeure non résolue. CA-0006 affiche 0.88 et est orienté vers CONFIRM, ce qui signifie qu'un examinateur qualifié peut agir, et non que le système peut interpeller quiconque automatiquement. SF-0002 affiche le score brut le plus élevé des quatre, 0.91, et est pourtant orienté vers BLOCK car la table de juridiction simulée marque la reconnaissance faciale comme prohibée à San Francisco.
Ces lignes sont synthétiques par conception, mais l'enjeu architectural est concret : quelles informations ont le droit de primer sur le score ? Si la réponse est « aucune », le processus de conformité périphérique n'est qu'ornemental. Si la légalité et l'incertitude peuvent modifier le routage avant qu'une alerte n'atteigne une équipe opérationnelle, la gouvernance est alors devenue exécutable.
Un score élevé peut renforcer un faisceau d'indices. Il ne peut ni créer de consentement ni abroger une interdiction.
Le moment où le score a perdu le contrôle
J'ai ouvert le dossier de LP-0834 en m'attendant à ce que le panneau de calibration domine la scène. Le score brut de 0.83 chute à une probabilité de correspondance calibrée de 0.50. L'intervalle s'étend de 0.217 à 0.783, et l'ensemble de prédiction contient les deux étiquettes possibles. Les éléments disponibles n'autorisent aucune certitude.
Puis mon attention s'est portée plus bas sur le constat relatif au consentement. C'est là que le routage se tranche. La capture compte 80 pixels, elle dépasse donc le seuil plancher de 72 pixels de la démo. La photo judiciaire a 15 ans, ce que le dossier consigne comme indicateur d'audit et de révision, sans en faire un filtre de routage autonome. L'absence de consentement est différente : elle déclenche BLOCK.
J'ai lutté avec cette hiérarchie plus que prévu. La calibration est mathématiquement captivante, et un intervalle ressemble à une réponse sophistiquée. Mais si je laisse le récit de l'incertitude prendre le dessus, je risque de laisser entendre qu'une probabilité plus favorable pourrait sauver l'analyse. Elle ne peut pallier une condition préalable manquante. Le filtre déterministe de politique doit évaluer la légalité indépendamment de la confiance du modèle.
Cela a transformé ma manière d'expliquer le produit. FaceTrust démontre le Biometric Decision Firewall. Il ne s'agit pas d'un énième moteur de reconnaissance faciale. Un adaptateur fournisseur normalise l'alerte, un calibrateur local quantifie l'incertitude, et des contrôles déterministes sélectionnent BLOCK, SUPPRESS, ESCALATE ou CONFIRM. Le Compliance Reviewer peut rédiger une note explicative après l'établissement de ces faits structurés, mais il ne contrôle pas le routage. Dans cette démo, cette note est précalculée et mise en cache ou provient d'un modèle déterministe de secours.
Je voulais que cette frontière soit manifeste car les modèles de langage excellent à générer des explications d'apparence cohérente. Une note cohérente ne constitue pas une base légale. L'avis doit intervenir après que le routage a été fixé par des règles inspectables, et non en amont comme un substitut persuasif.
J'ai dû cesser de traiter la calibration comme un verdict
Je persistais à vouloir qu'une probabilité calibrée accomplisse plus qu'elle ne pouvait. C'était mon modèle mental erroné au départ : remplacer un score brut par un meilleur score, puis utiliser ce meilleur score comme décision. LP-0834 a brisé ce raccourci, car le résultat de 0.50 nécessitait encore un intervalle, un ensemble de prédiction, une vérification du consentement, un contrôle de juridiction et une procédure humaine encadrant toute action autorisée.
L'ensemble de prédiction conforme à 93% est essentiel car il modifie le vocabulaire du système. Lorsque l'ensemble contient à la fois {mate, no_mate}, FaceTrust ne comprime pas l'ambiguïté en une étiquette péremptoire. Il peut router une alerte légale mais non résolue vers ESCALATE. Lorsque la preuve exclut une correspondance, il peut appliquer SUPPRESS. Quand l'ensemble contient {mate}, une issue CONFIRM implique toujours l'intervention d'un examinateur qualifié, jamais une interpellation, une rétention ou une accusation automatique.
Je suis passé de la file d'attente à la vue d'assurance statistique car un dossier isolé ne pouvait répondre à la question de couverture. Sur l'échantillon de test synthétique déterministe de 3,000 alertes, les ensembles conformes nominaux à 93% ont atteint au moins 91.5% de couverture empirique sur les six groupes Fitzpatrick évalués. Le minimum de la référence brute était de 40.6%. L'interface expose la couverture à travers les six groupes Fitzpatrick évalués.
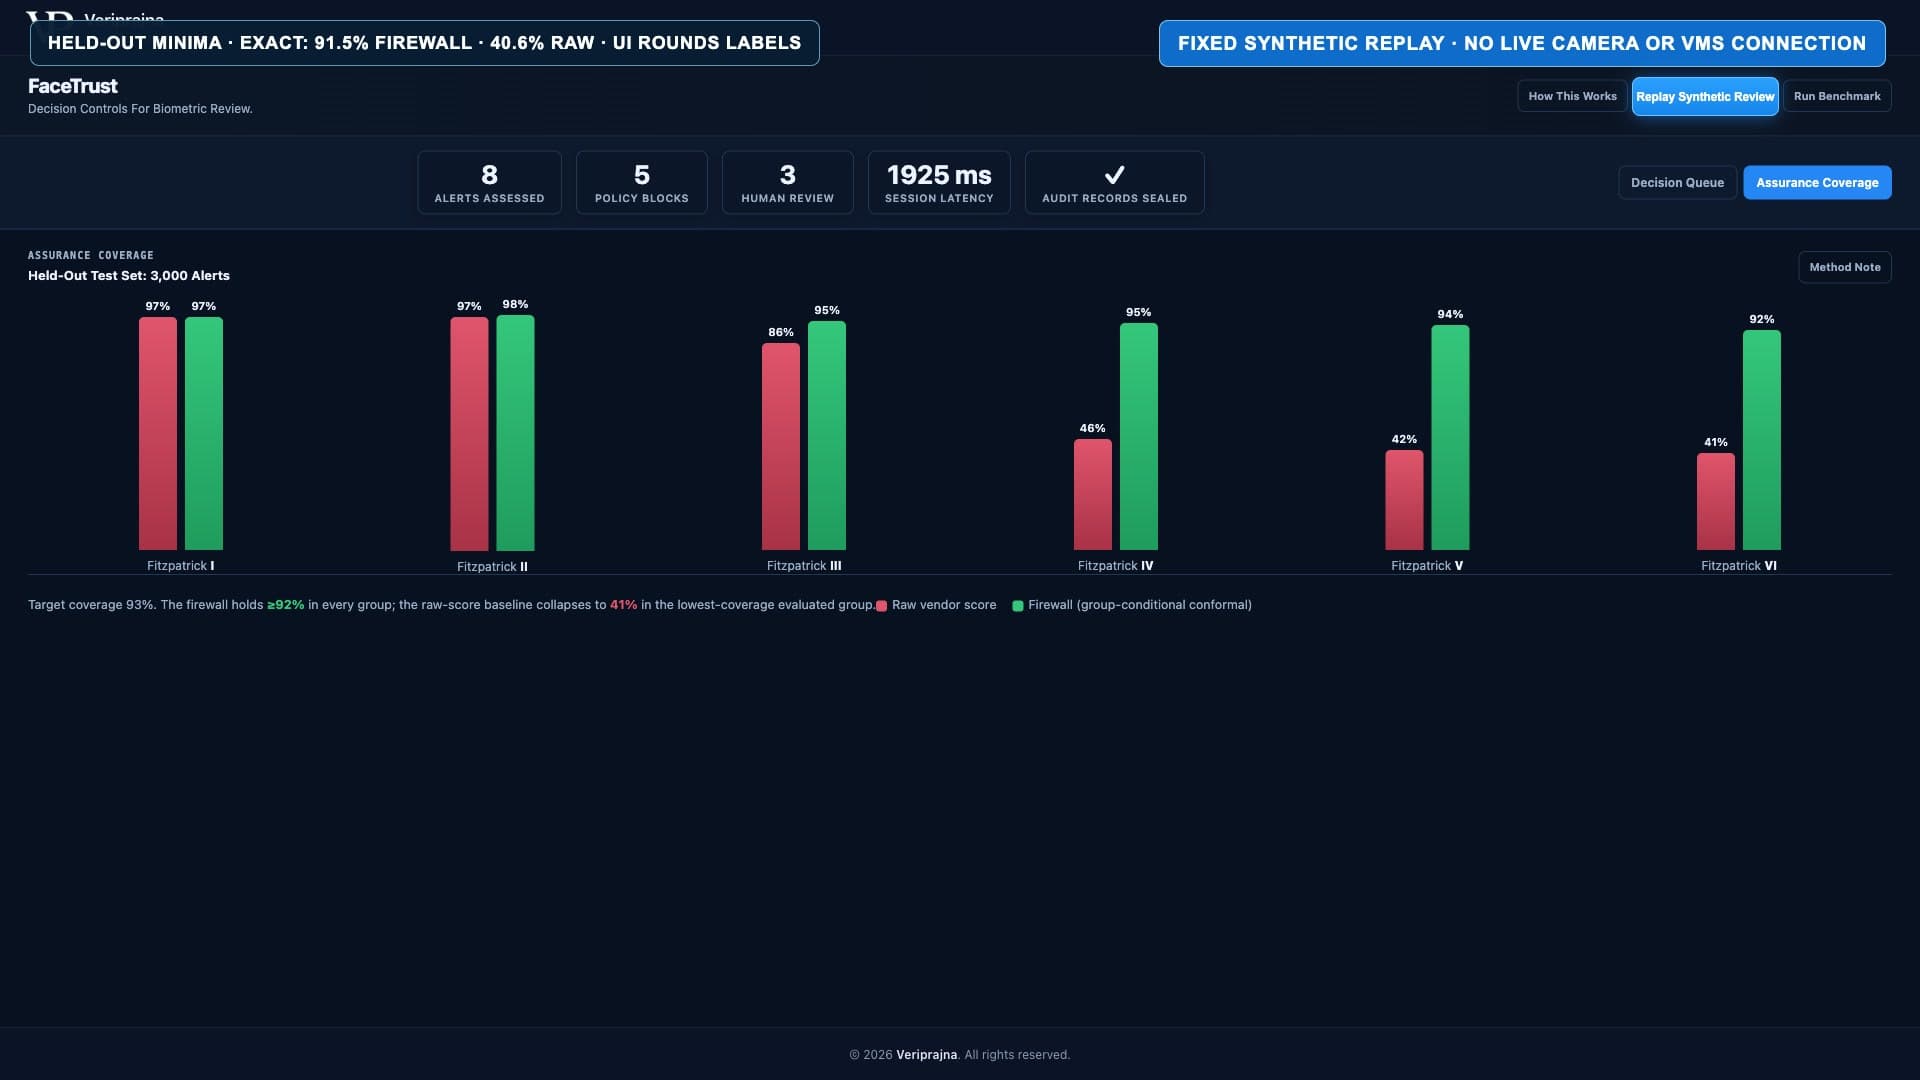
Ces données ne constituent pas des revendications en production. Le jeu de test est synthétique, conçu pour modéliser des modes de défaillance documentés, et une calibration en production exigerait l'historique arbitré d'un client. J'inclus ce résultat car il illustre ce qu'il convient d'inspecter plutôt que d'admirer un score global : le groupe évalué le plus vulnérable, selon un protocole de test explicite auquel un périmètre est rattaché.
Le graphique a également tempéré mon réflexe de célébrer la cible nominale. Un objectif de 93% ne signifie pas que chaque groupe atteint exactement 93%, et ne signifie nullement que le système est fiable à 93% en conditions réelles. L'affichage fournit un diagnostic de couverture, non une licence de généralisation au-delà du jeu de test synthétique.
L'incertitude ne devient utile que lorsque le flux opérationnel est autorisé à agir différemment en sa présence.
Le rejeu a rendu le coût opérationnel visible
J'ai exécuté le rejeu synthétique figé pour observer le comportement de la hiérarchie à l'échelle du flux opérationnel. Sur ses 364 alertes, le seuil brut produirait 303 interpellations. Le pare-feu génère à l'inverse 121 parcours de révision humaine et bloque 179 alertes, soit une réduction de 60.1% selon le mode de calcul de ce rejeu. Cette réduction s'applique à ce rejeu simulé, non à un déploiement client ou à une promesse de production.
Je n'ai pas interprété ce résultat comme « l'automatisation en a traité davantage ». En réalité, la valeur de cette conception réside dans son refus d'automatiser la conséquence humaine finale. Elle écarte les scans prohibés ou sans consentement, supprime les indices qui écartent une concordance, et oriente les cas incertains ou plausibles vers des procédures de révision qualifiées. Le basculement opérationnel s'opère de la dynamique dictée par le score vers une responsabilité propre à chaque routage.
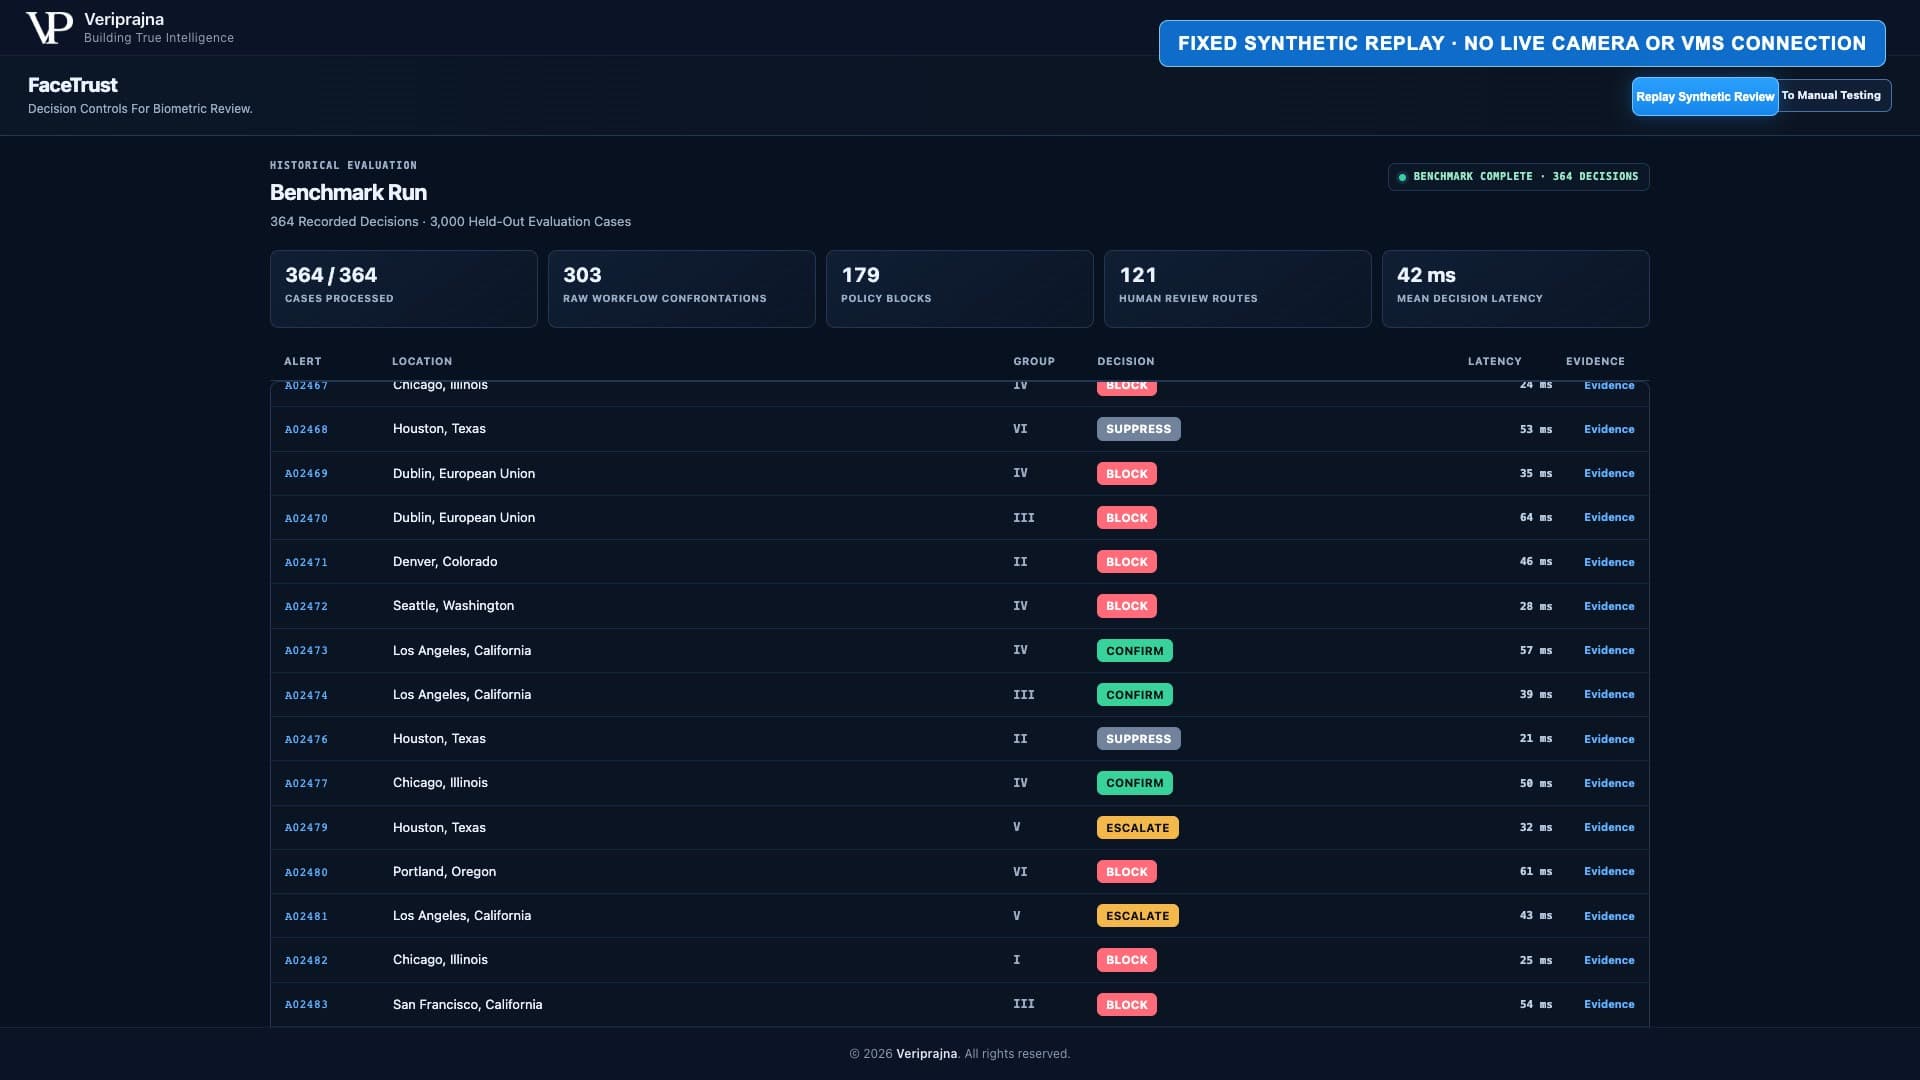
Le benchmark de test livre un constat tout aussi circonscrit. Parmi 1,566 alertes synthétiques d'imposteurs, la référence brute confronterait à un taux de 69.3%, alors que le taux de confirmation du pare-feu est de 3.8%, soit une réduction de 94.5% selon cette définition. Sur 1,434 alertes synthétiques de correspondances réelles, la cible demeure dans l'ensemble de prédiction du pare-feu 93.1% du temps, contre 99.3% pour le seuil brut de référence. Cette mise en parallèle met en lumière un compromis : préserver davantage de vraies correspondances est aisé si le système accepte d'agir sur un nombre considérablement plus grand d'imposteurs.
Cet arbitrage a modifié ma lecture de la promesse de « moins d'alertes », qui serait un piètre objectif en soi. Un système pourrait réduire la charge de travail en éliminant indistinctement les cas épineux. Ici, le motif de chaque routage demeure indexé : consentement, juridiction, seuil de capture, ensemble de prédiction calibré ou exclusion probatoire. Le routage est explicable car les paramètres qui le déterminent sont explicites.
C'est aussi pourquoi l'ancienneté du profil reste un simple indicateur contextuel plutôt qu'un filtre autonome dans la démo. La photo judiciaire de LP-0834 datant de 15 ans apporte un éclairage utile pour l'examinateur et l'audit. Prétendre que la démo dispose d'une règle universelle sur l'âge introduirait une certitude que ni le cahier des charges ni la mise en œuvre ne justifient.
Je voulais que le refus résiste à l'audit
J'ai ouvert la vue des preuves après le rejeu et examiné le routage en regard de son enregistrement. LP-0834 ne se résume pas à un badge coloré. Chaque décision produit un enregistrement chaîné par hachage SHA-256, et l'interface peut exporter un rapport d'audit HTML imprimable. Le refus possède une traçabilité établie.
Je suis devenu méfiant envers les systèmes dont l'explicabilité repose uniquement sur un paragraphe généré. Un texte peut résumer des faits, mais il ne peut prouver que le routage a été fixé avant sa rédaction, ni que l'enregistrement n'a pas été discrètement altéré. La chaîne de hachage ne rend pas la décision juste par elle-même. Elle rend toute altération ultérieure détectable au sein de la chaîne et remet à l'enquêteur un artefact stable.
Cette distinction garantit l'intégrité de la démarche d'audit. Cette démonstration ne constitue pas une certification de conformité, une consultation juridique ou un substitut à un avis de droit. Elle s'appuie sur un environnement synthétique simulé, des adaptateurs de test et des tables réglementaires fictives. Elle ne comporte aucun lien avec des caméras réelles, des VMS, des moteurs de fournisseurs, le NIST, des tests de vivacité ou des données clients. Elle valide un mécanisme et un ordonnancement, non un résultat opérationnel en production.
J'anticipe nettement les interrogations futures : non pas « montrez-moi la note de synthèse », mais « montrez-moi ce que le système savait, quelle règle déterministe s'est déclenchée, qui est resté responsable de l'action, et si l'enregistrement a été modifié ultérieurement ». Le rapport d'audit est conçu pour répondre précisément à cet enchaînement.
La règle que j'ai retenue de ce développement
Je ne conçois plus la gouvernance de la reconnaissance faciale comme un dispositif qui débute une fois la correspondance déclarée. À ce stade, l'alerte a déjà acquis sa propre force d'inertie. Quelqu'un aperçoit un score élevé, le processus opérationnel s'enclenche, et chaque garde-fou ultérieur doit batailler contre une conclusion perçue comme acquise.
Le cas de LP-0834 m'impose une règle plus rigoureuse : la légalité doit être évaluée avant que la confiance probante ne puisse autoriser un routage, et la confiance probante doit être énoncée avec son degré d'incertitude avant qu'un humain ne soit appelé à agir. L'examinateur qualifié conserve la responsabilité des suites données à un routage CONFIRM ou ESCALATE. BLOCK et SUPPRESS doivent constituer des issues légitimes, et non des anomalies attendant d'être contournées.
Telle est la conviction qui sous-tend le Biometric Decision Firewall. Les agents peuvent élaborer des synthèses lisibles, mais ce sont des contrôles déterministes qui fixent la route. La démonstration guidée et l'analyse complète illustrent comment FaceTrust matérialise cette distinction.
Et si vous préférez observer le dispositif plutôt que de me lire, voici l'ensemble du système en fonctionnement d'un bout à l'autre.
J'ai commencé avec un score qui paraissait suffisamment affirmé pour emporter l'adhésion. J'ai abouti à un refus fondé sur une condition préalable manquante, une preuve circonscrite et un registre vérifiable. La décision la plus responsable dans le système est parfois celle qui empêche le score de se convertir en action.