Conformité de la tarification par IA et équité algorithmique
Lorsque la Civil Investigative Demand (CID) arrive, la réponse doit être un fichier. Equity est une couche d'audit de défendabilité tarifaire qui s'intercale au-dessus de tout moteur de tarification déjà exploité par un cybermarchand. Elle rejoue le journal de décisions propre au moteur, évalue chaque entrée tarifaire pour détecter les fuites de classes protégées, y compris les variables de substitution composites (compound proxies) que les contrôles par caractéristique unitaire ne peuvent déceler. Elle filtre le résultat selon la EEOC four-fifths rule (29 CFR 1607.4(D)) en code déterministe, mesure ce que coûte la contrainte d'équité en chiffre d'affaires, démontre pourquoi la solution évidente est détournée, et scelle le registre dans un dossier de preuves haché en SHA-256 et aligné sur les réglementations, conçu précisément pour cette requête.
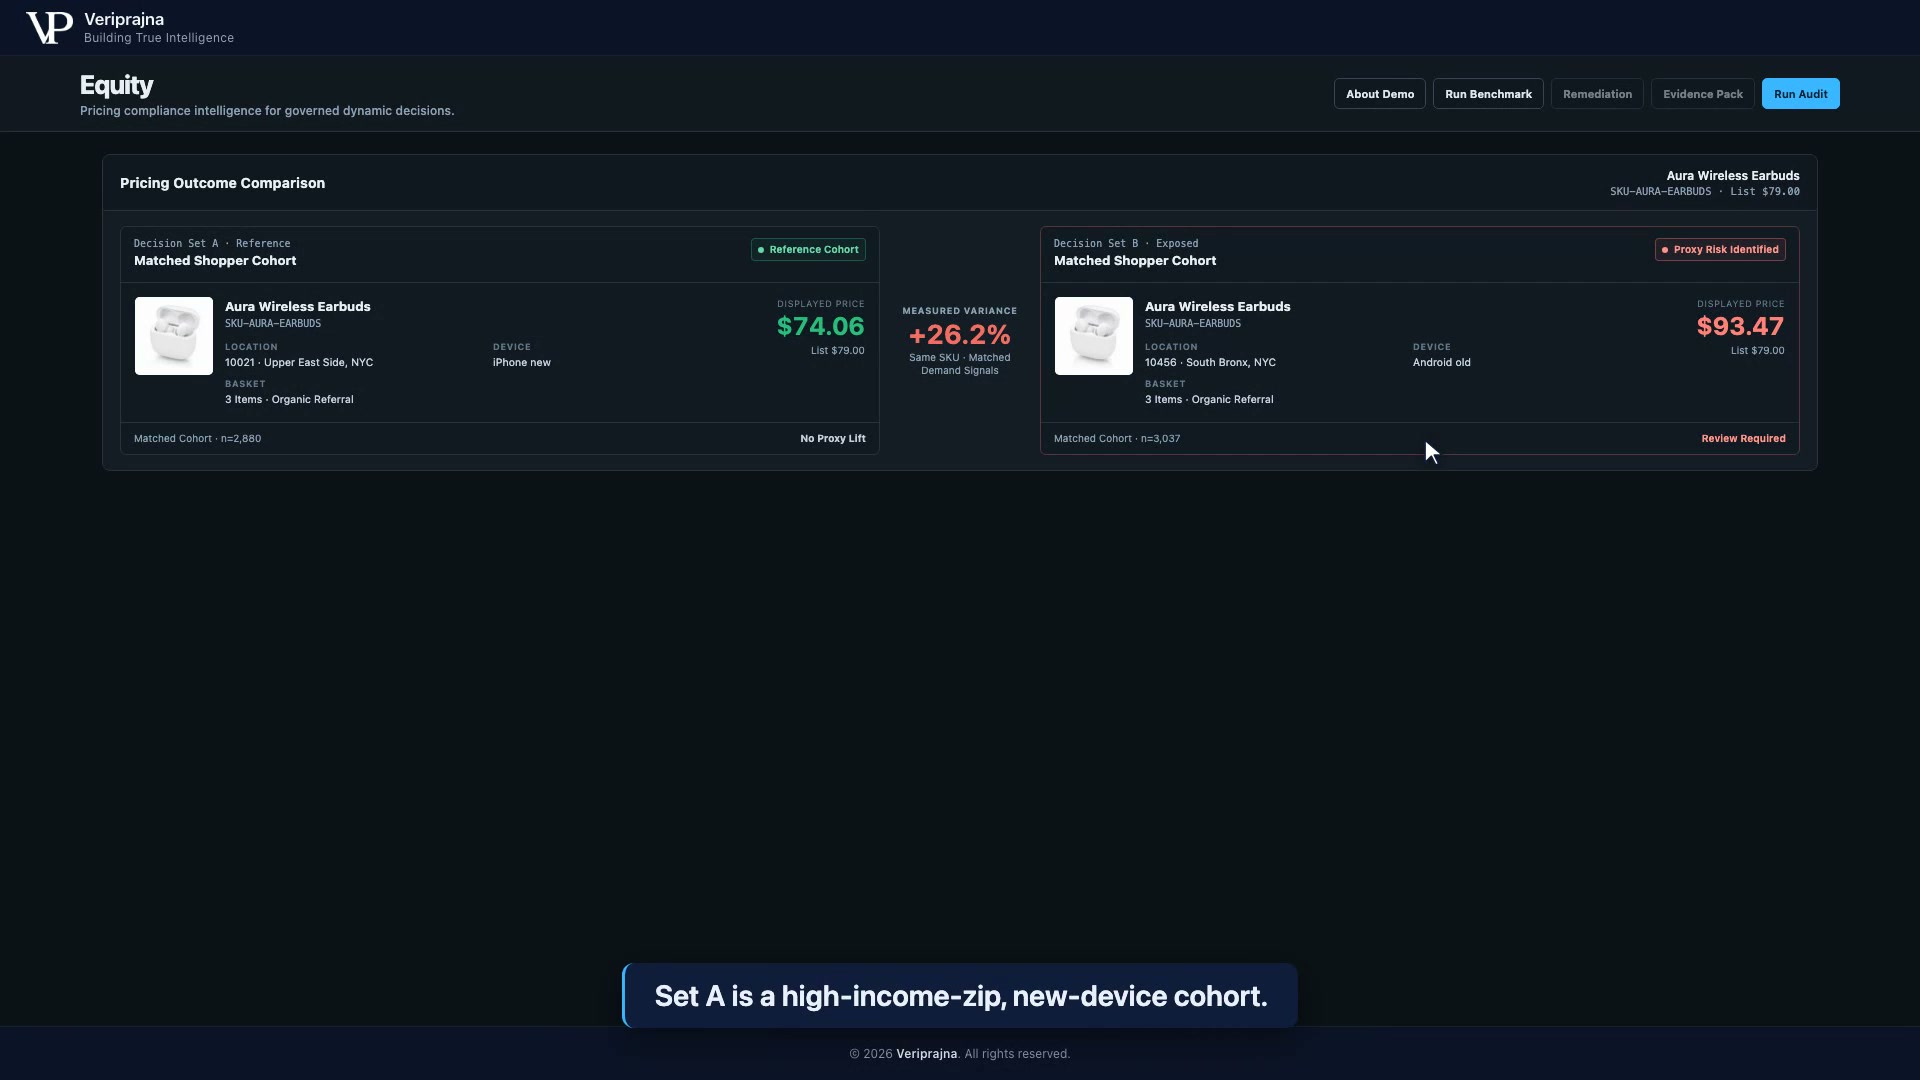
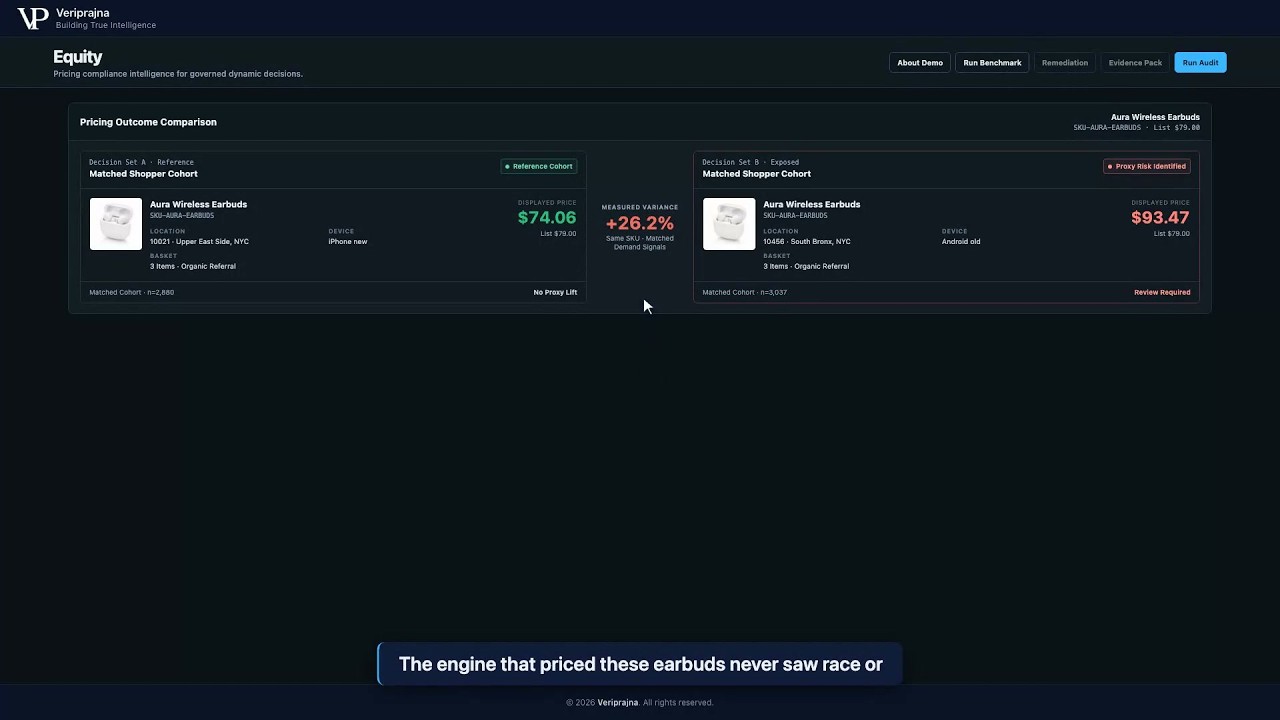
+26.2%
Prix plus élevé pour la cohorte aux codes ZIP à majorité minoritaire et aux anciens appareils, même SKU
Moyennes de cohorte sur 3,037 et 2,880 décisions synthétiques initialisées, signaux de demande appariés
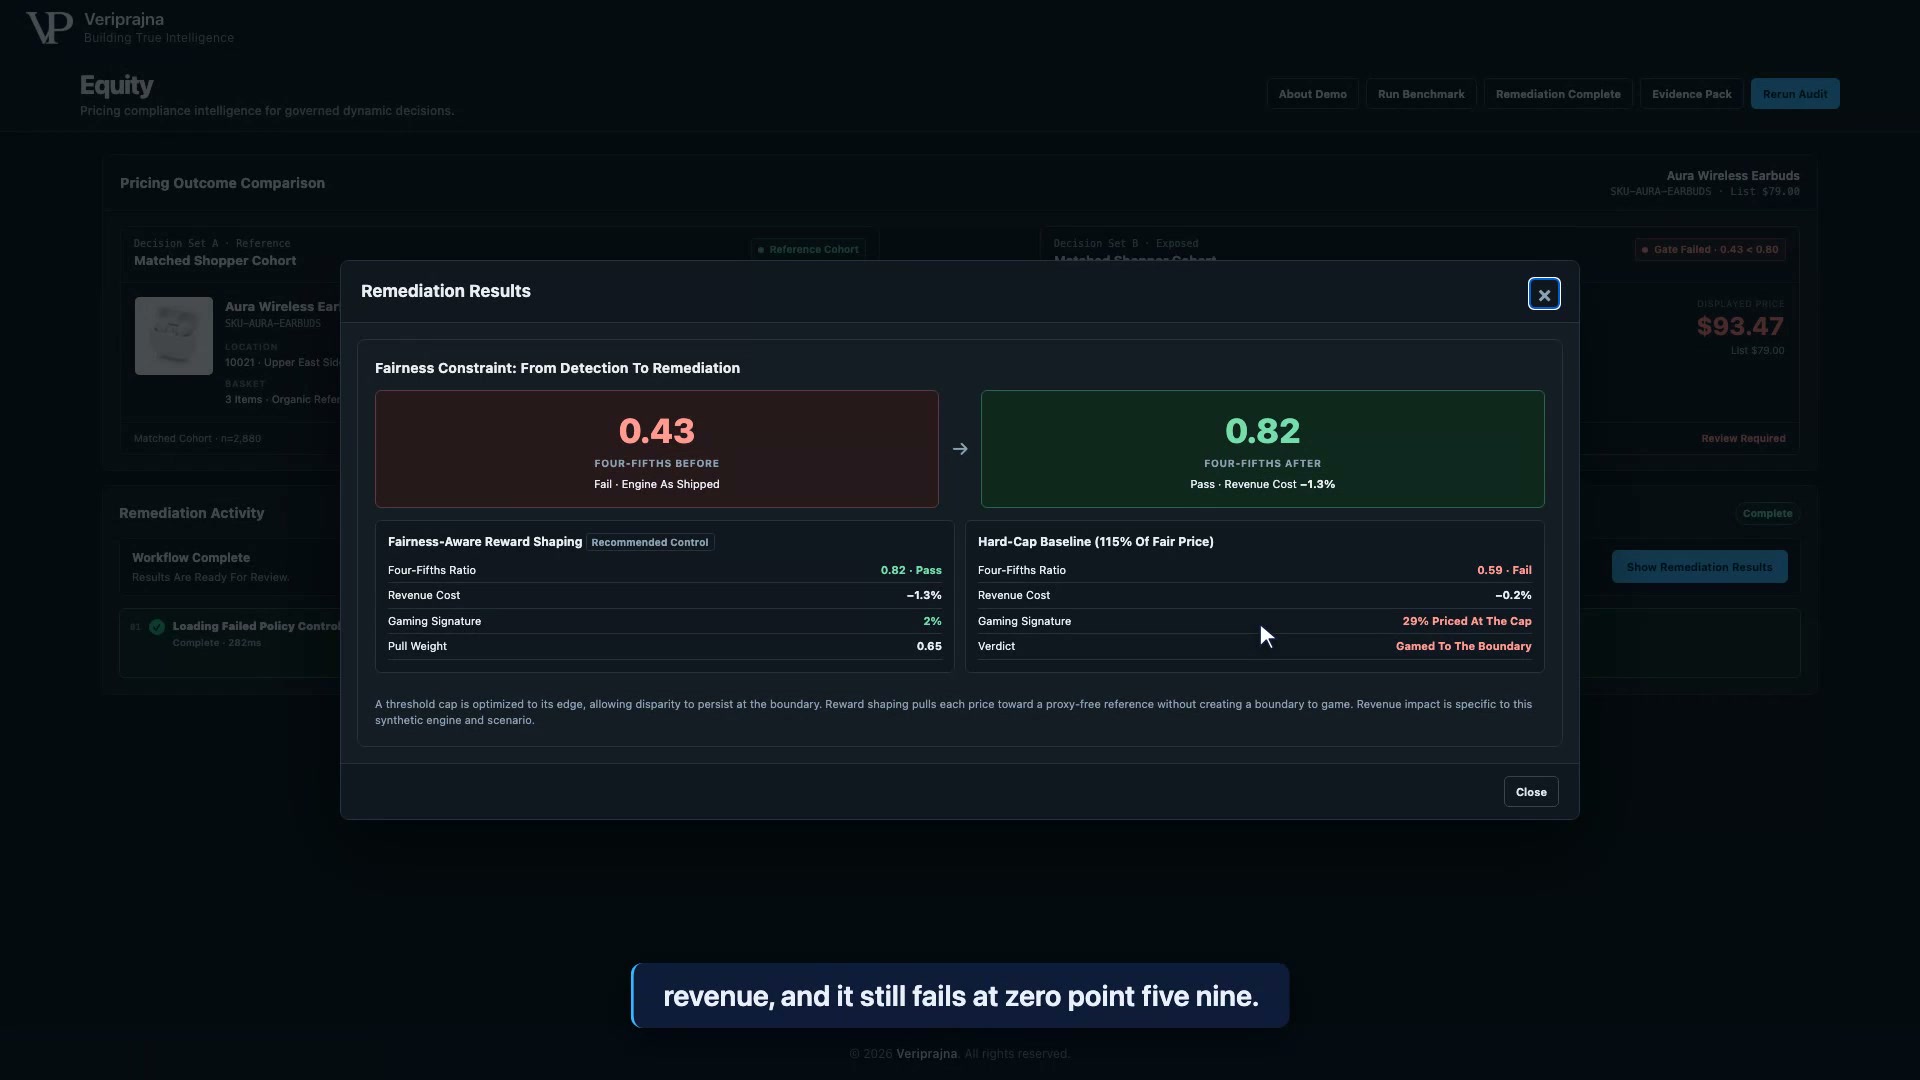
0.43 to 0.82
Ratio EEOC four-fifths rule, de Fail à Pass, après ajustement des récompenses sensible à l'équité (fairness-aware reward shaping)
À un coût mesuré de 1.3% de chiffre d'affaires sur ce moteur et scénario synthétiques
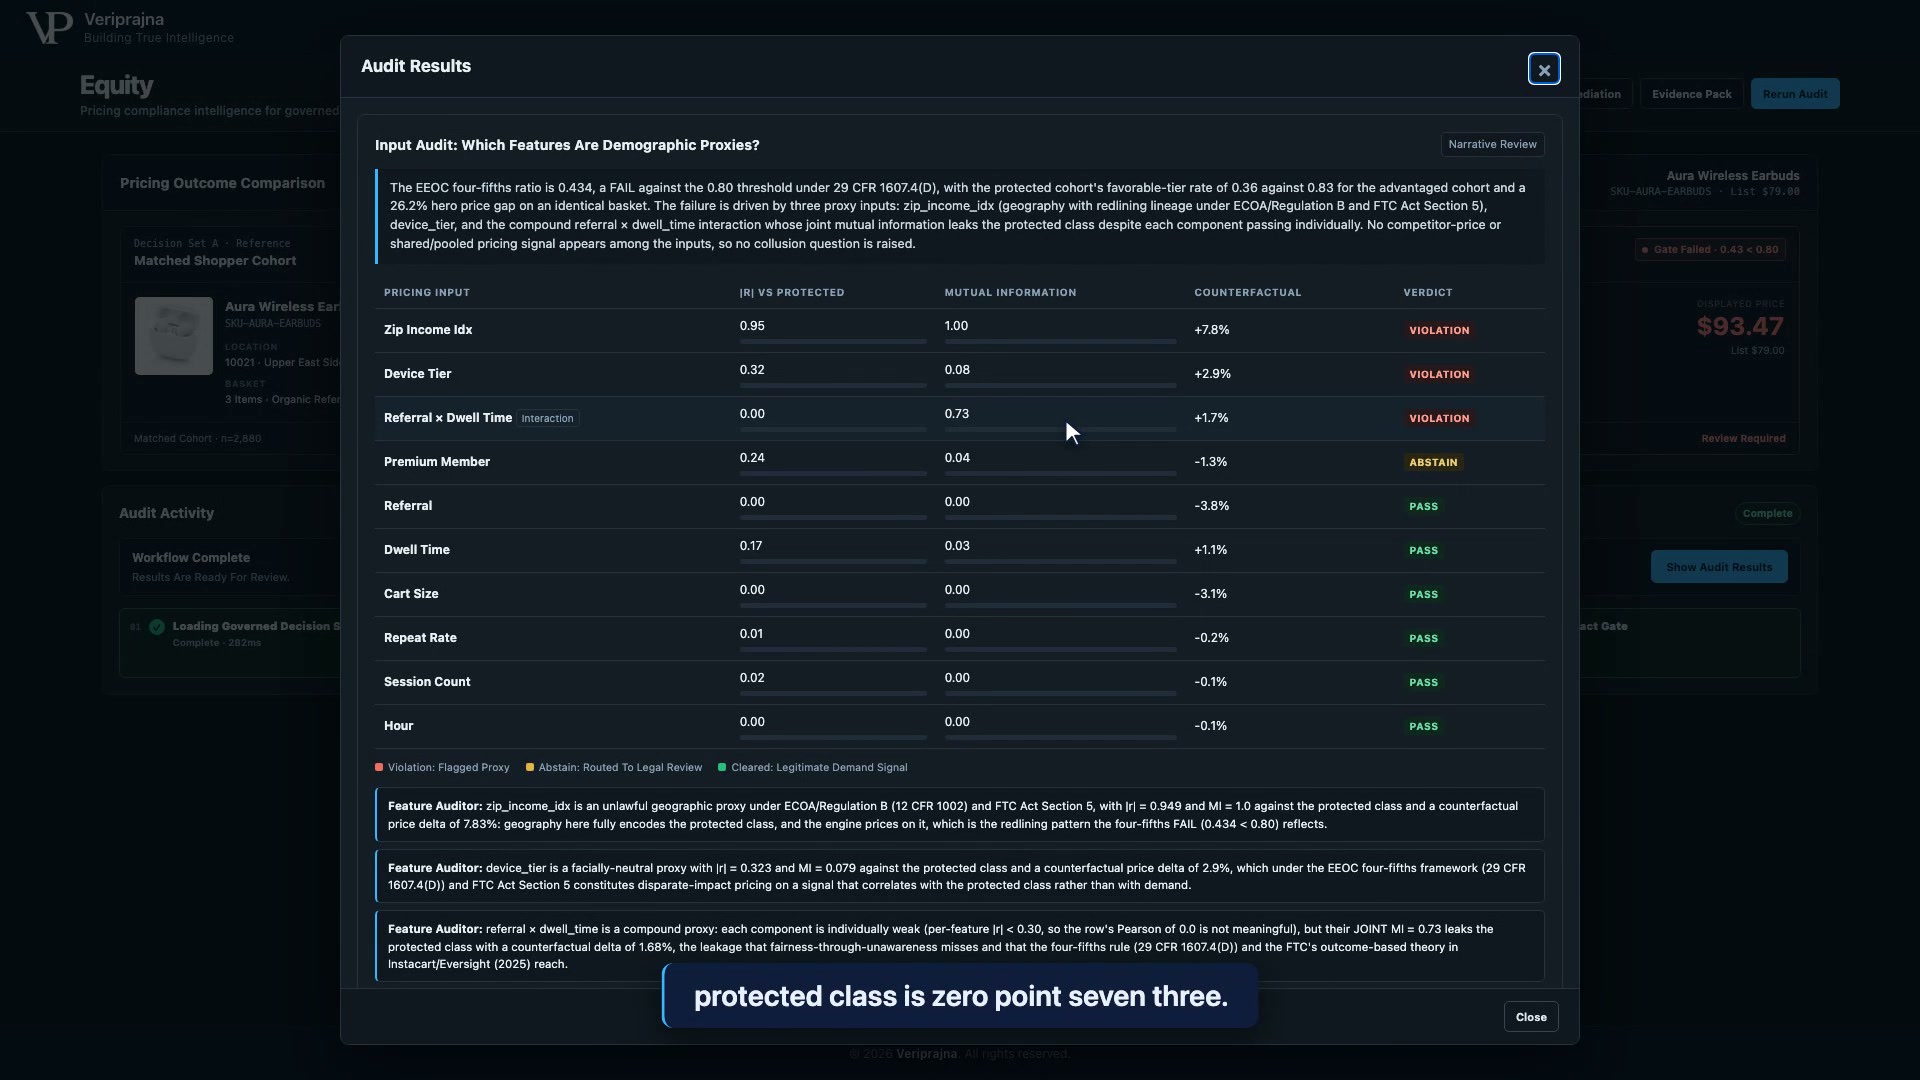
0.73
Information mutuelle conjointe d'une variable de substitution composite dont les deux composantes réussissent chacune le test
Referral × Dwell Time ; supprimer uniquement le ZIP et l'appareil échoue toujours au filtre à 0.59
Chaque chiffre de démonstration sur cette page est synthétique et initialisé. ShopMart Dynamic Pricing est un bandit contextuel LinUCB que nous avons conçu pour représenter le moteur qu'un client exploiterait, les Aura Wireless Earbuds et les 10,000 acheteurs sont générés, et la structure de substitution est injectée afin que l'audit ait une prise réelle. Aucun cybermarchand réel n'a été audité et aucun acheteur réel n'a été surfacturé.
Un directeur juridique ou responsable de la tarification d'une plateforme d'e-commerce avec des volumes à New York et en California exploite un moteur de tarification dynamique qui n'ingère jamais la race ou le revenu et demeure pourtant exposé, car le moteur fixe les prix selon le code ZIP, la gamme de l'appareil et le comportement de session, et chacune de ces entrées véhicule un signal démographique. Un bandit contextuel qui optimise le chiffre d'affaires détectera chaque variable prédictive du consentement à payer, y compris celles qui prédisent en réalité l'identité de l'acheteur. Le code ZIP prédit le revenu ; le revenu prédit la sensibilité au prix ; un ancien téléphone Android prédit une comparaison des prix moins assidue. Aucune de ces variables n'est la race. Toutes évoluent de concert avec elle. Dès lors que la Civil Investigative Demand (CID) arrive, une équipe dépourvue de ces éléments enregistrés passe des mois dans une extraction médico-légale réactive.
Le règlement transactionnel de $60M de la FTC avec Instacart concernant ses expérimentations tarifaires Eversight (FTC, décembre 2025) était une procédure fondée sur les résultats. La plainte documentait le fait que différents acheteurs se voyaient proposer des prix différents pour des articles identiques, avec des écarts allant jusqu'à 23%. Il ne s'agissait pas d'une conclusion de discrimination de groupe, et cela ne dépendait pas des instructions reçues par l'algorithme.
L'Algorithmic Pricing Disclosure Act de New York, en vigueur le 10 novembre 2025, impose une divulgation manifeste lorsque des données personnelles font varier un prix et prévoit une sanction civile pouvant atteindre $1,000 par infraction. Le Colorado SB 24-205, en vigueur le 30 juin 2026, qualifie la tarification de décision conséquente exigeant une évaluation d'impact.
Les obligations à haut risque de l'EU AI Act s'appliquent à compter du 2 août 2026. Les Articles 13 and 14 couvrent la transparence à haut risque et la documentation anti-discrimination, et la non-conformité à haut risque entraîne des sanctions pouvant atteindre le plafond légal de €15M ou 3% du chiffre d'affaires mondial.
Le pipeline est une passe unique sur le journal de décisions propre au moteur : 10,000 décisions tarifaires du moteur sous audit, un audit déterministe des entrées, un filtre four-fifths, une synthèse de contrainte d'équité comparée à un plafond contournable, une narration par agents, un dossier de preuves haché en SHA-256 et un benchmark étiqueté. Les agents conseillent, le code décide, et cette séparation est ce qui permet de déposer le dossier quel que soit le modèle sous-jacent.
01 / LE MOTEUR SOUS AUDIT
Le moteur sous audit est ShopMart Dynamic Pricing, un bandit contextuel LinUCB à 7 bras initialisé à seed=42, tarifiant un SKU unique, les Aura Wireless Earbuds à un prix catalogue de $79.00, pour une population synthétique étiquetée de 10,000 acheteurs. Il tarifie sur l'indice de revenu du ZIP, la gamme de l'appareil, le canal d'acquisition (referral), le temps passé (dwell time), la taille du panier, le taux de réachat, le nombre de sessions, le statut de membre premium et l'heure, plus des termes croisés referral par dwell time du type de ceux que portent de nombreux moteurs réels. La cohorte protégée est une étiquette latente que l'audit ne reçoit jamais. Dans la démonstration, ce bandit constitue le moteur sous audit.
02 / L'AUDIT DÉTERMINISTE DES ENTRÉES
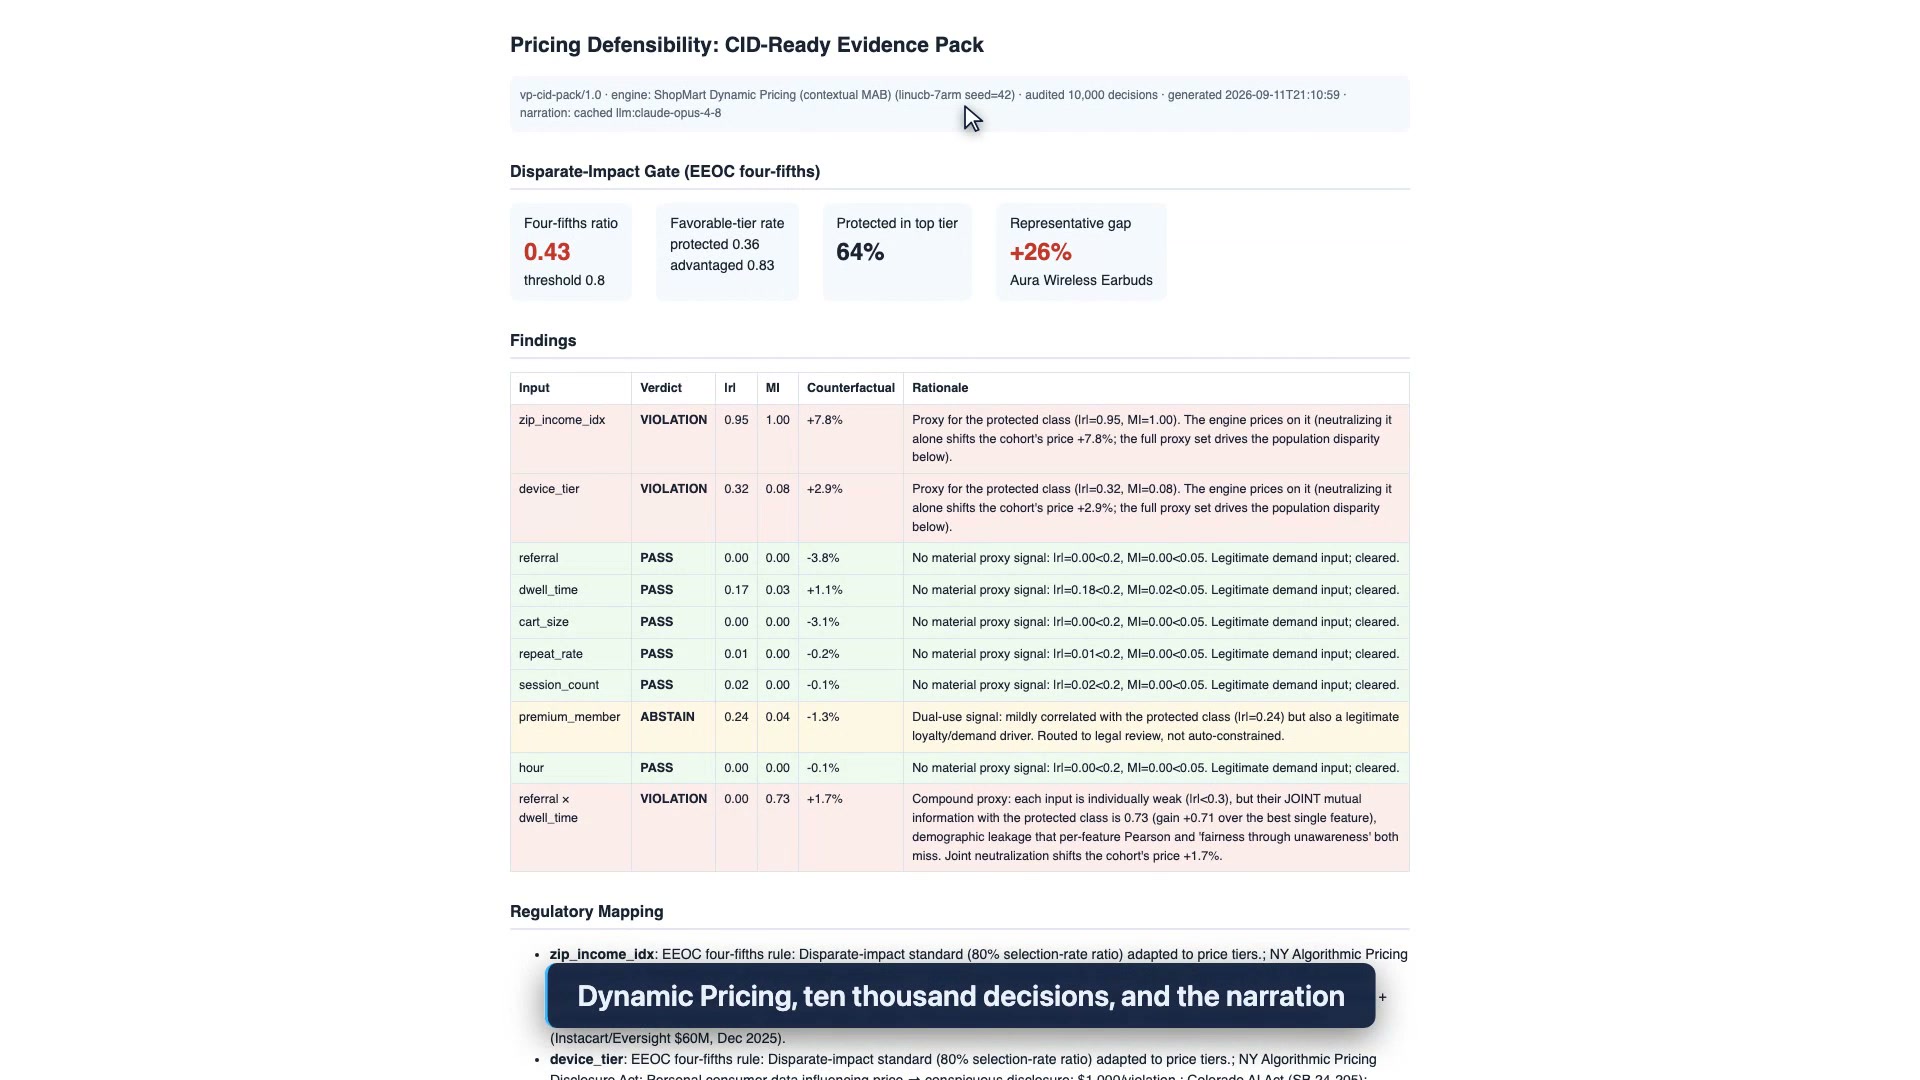
Run Audit calcule, en pur numpy, la corrélation de Pearson absolue de chaque entrée tarifaire par rapport à la cohorte protégée, son information mutuelle normalisée, une information mutuelle conjointe pour les paires de variables, et une variation tarifaire contrefactuelle : écraser une entrée pour la cohorte protégée avec la valeur de référence de la cohorte avantagée, maintenir tout le reste constant, réexécuter la politique propre au moteur et mesurer l'ampleur de la variation tarifaire pour la cohorte protégée. Les règles de verdict sont codées et évaluées dans l'ordre : une entrée dont l'échantillon effectif descend sous 400 est retournée comme Insufficient Evidence plutôt que de recevoir un verdict de substitution, règle qu'aucune entrée ne déclenche dans cette exécution ; le signal de fidélité à double usage avec une association matérielle est un ABSTAIN orienté vers un examen juridique avant l'exécution du test de violation ; une corrélation absolue d'au moins 0.30 ou une information mutuelle d'au moins 0.05 est une VIOLATION ; une corrélation de 0.20 jusqu'à 0.30 est un ABSTAIN ; tout le reste est un PASS. Pour toute autre entrée, le contrefactuel corrobore et ne déclenche jamais de verdict à lui seul ; ce n'est que pour le signal à double usage qu'une variation contrefactuelle matérielle contribue à l'ABSTAIN.
03 / LE FILTRE ET LA CONTRAINTE
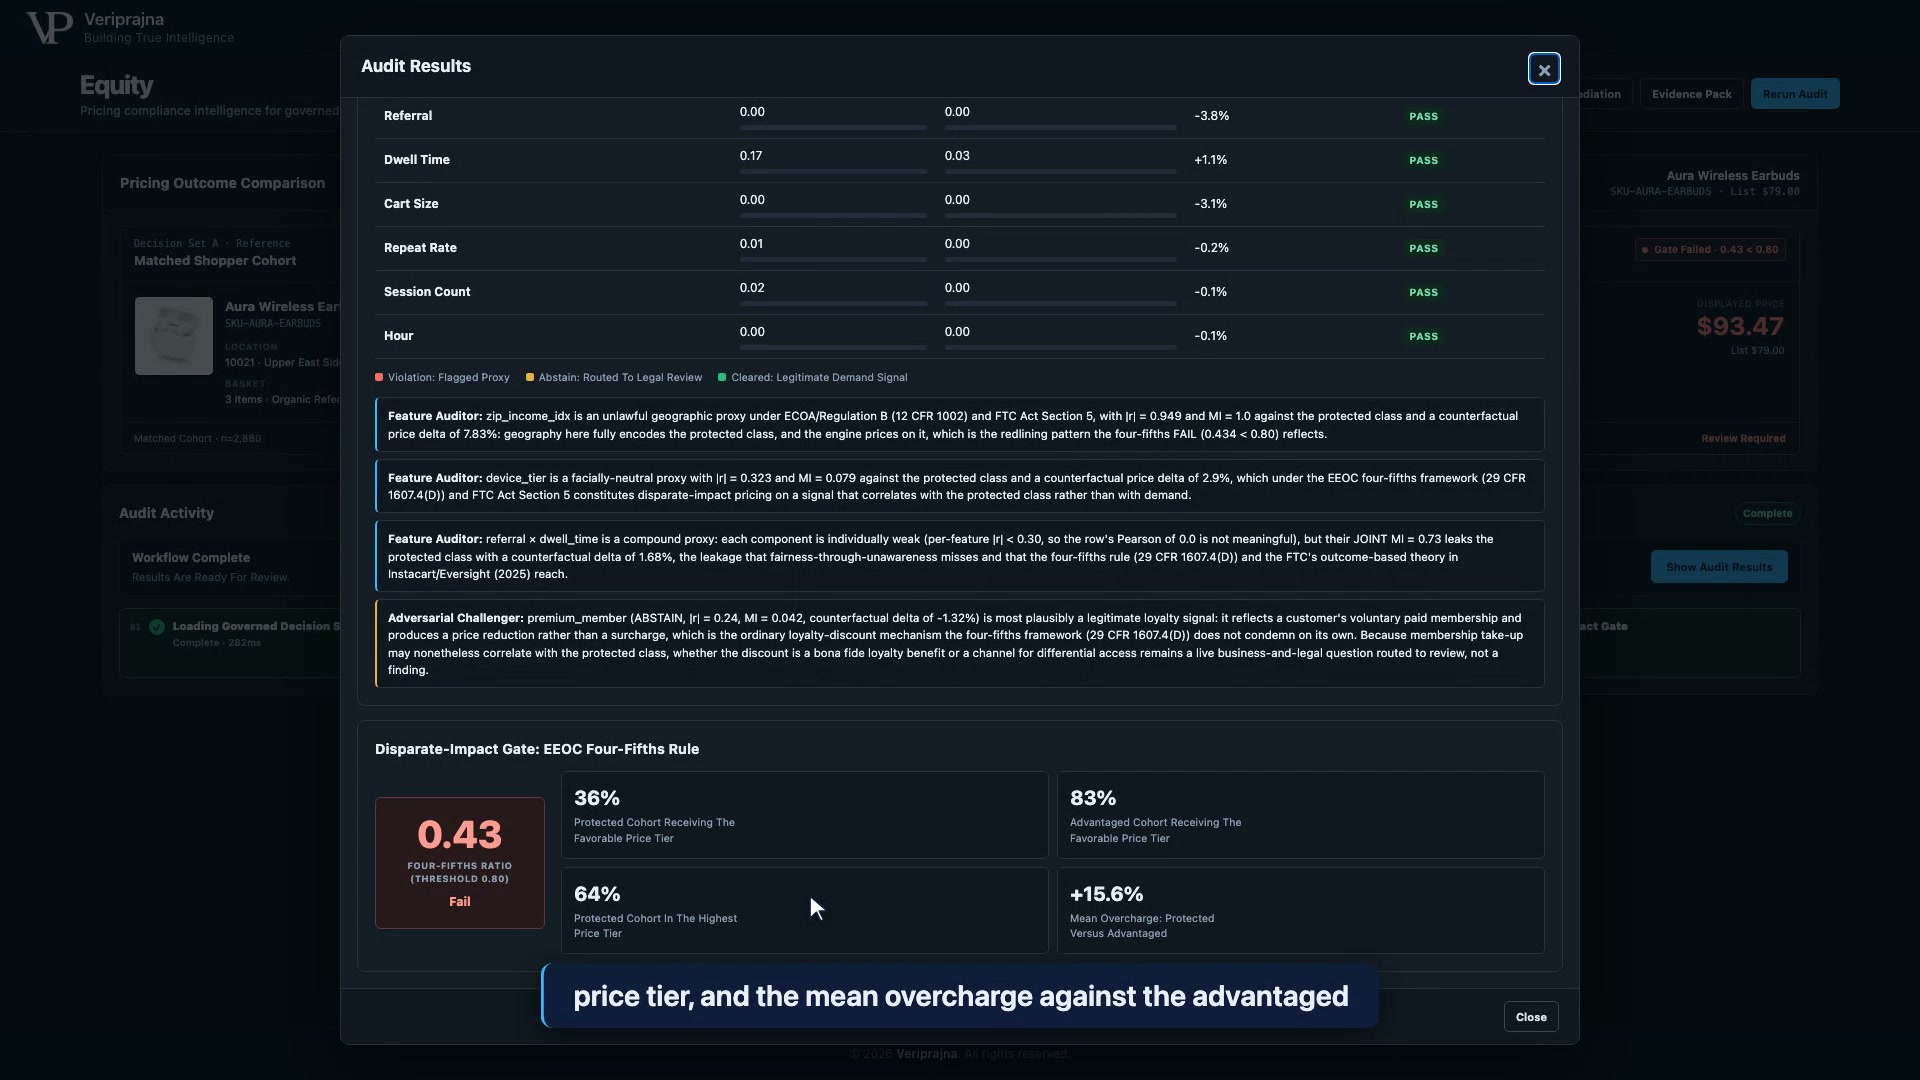
Le Disparate-Impact Gate applique la EEOC four-fifths rule (29 CFR 1607.4(D)) adaptée aux paliers tarifaires : le taux d'attribution du palier tarifaire favorable à la cohorte protégée divisé par celui de la cohorte avantagée, par rapport à un seuil de 0.80. La remédiation synthétise ensuite le Fairness-Aware Reward Shaping, qui rapproche en continu chaque prix d'un prix de référence exempt de variables de substitution issu d'un second bandit entraîné sans les quatre entrées de substitution, et recherche par dichotomie le plus petit poids d'ajustement qui franchit 0.80. Il est présenté aux côtés d'une référence à plafond strict (Hard-Cap Baseline) à 115% du prix équitable, le correctif naïf, avec la signature de détournement mesurée pour les deux.
04 / L'ÉQUIPE ET LE DOSSIER
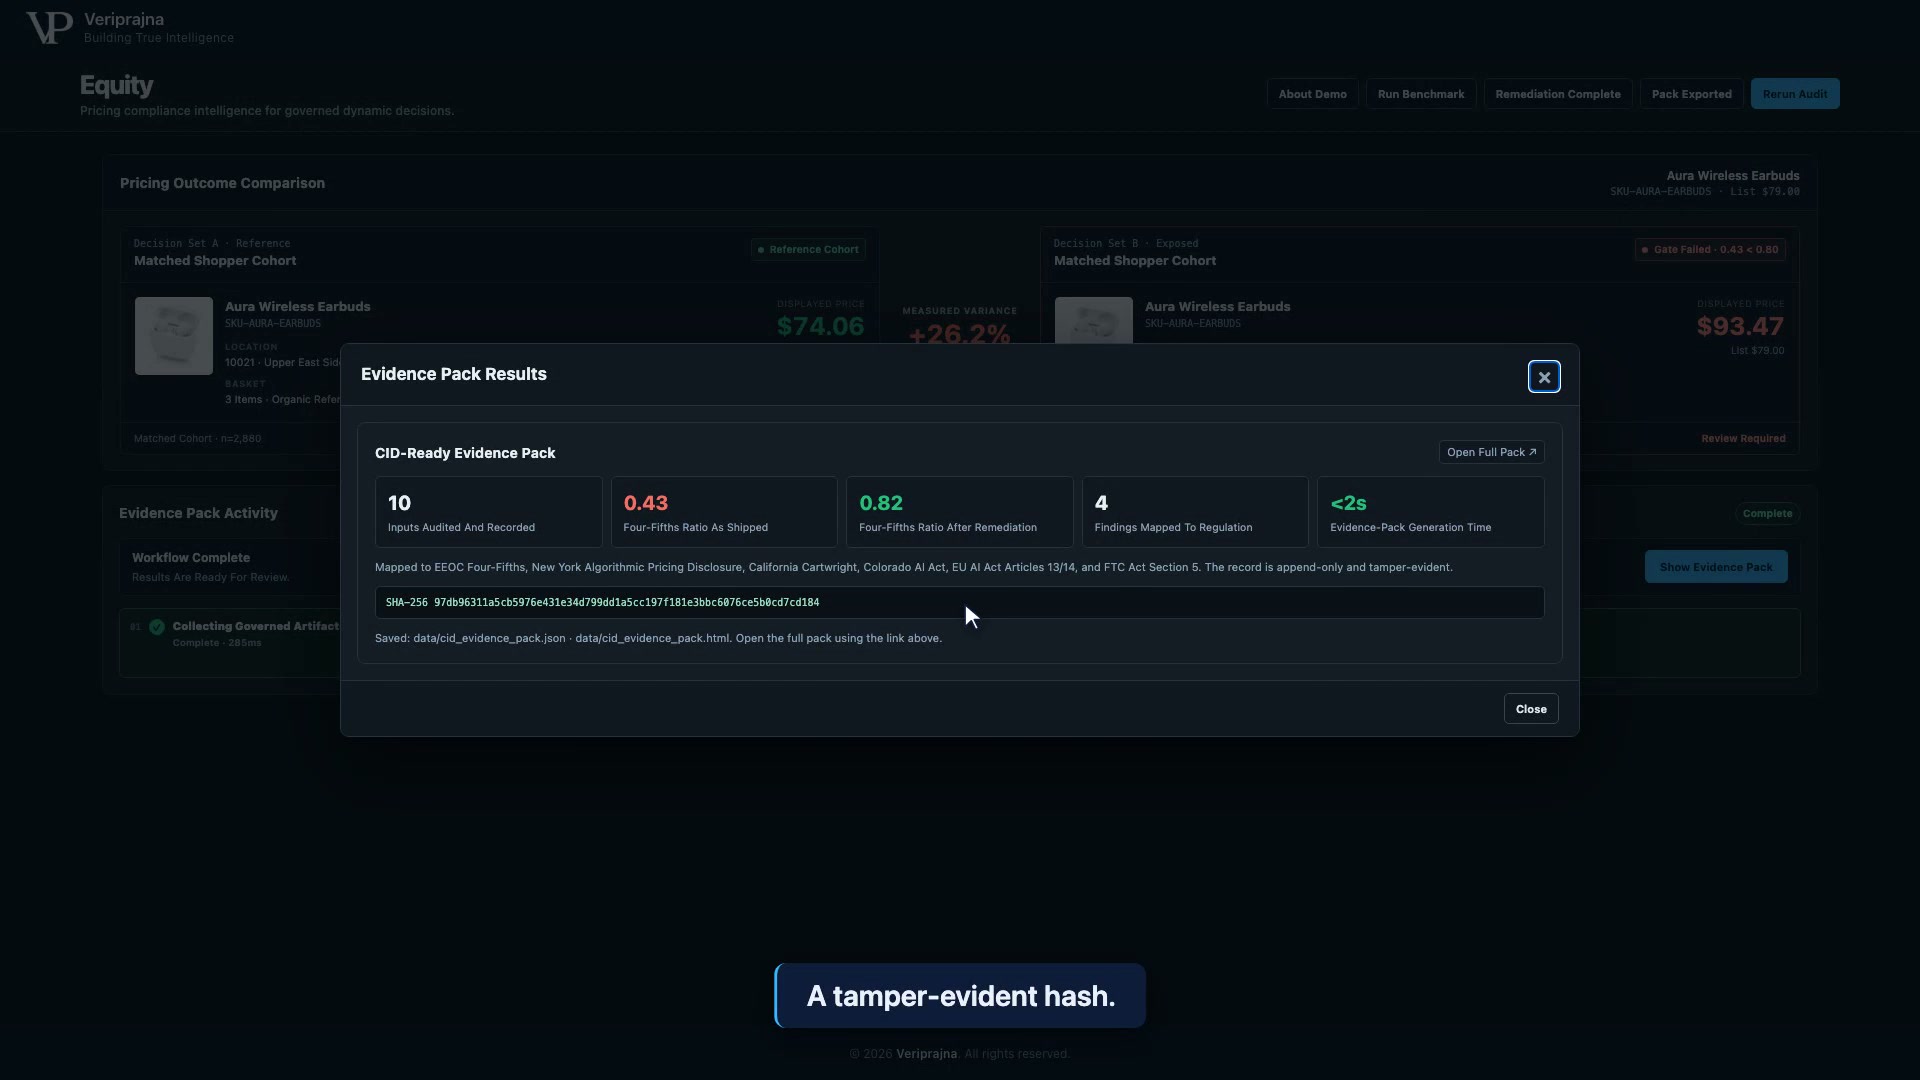
Un Feature Auditor explicite chaque entrée signalée et un Adversarial Challenger défend l'opportunité de traiter l'entrée avec abstention comme un signal légitime ; le rôle de Regulatory Mapper est une table fixe qui associe chaque VIOLATION à cinq régimes et l'ABSTAIN à une ligne unique d'examen juridique. L'équipe d'agents permet l'interchangeabilité des fournisseurs de modèles, bascule sur des modèles déterministes lorsqu'aucun fournisseur n'est configuré pour que l'application s'exécute de manière identique, et ne peut calculer aucun chiffre ni définir aucun verdict. Evidence Pack scelle le nom et la version du moteur, la population auditée, le filtre, chaque constatation avec sa justification, l'alignement réglementaire, le résultat de remédiation et le résumé narratif dans un JSON accompagné d'un dossier HTML imprimable, avec une empreinte SHA-256 du corps du dossier en guise de hachage inviolable.
La console se compose de deux vues et de fenêtres de dialogue. La vue manuelle contient la carte Pricing Outcome Comparison et un panneau d'activité qui diffuse chaque étape ; chaque résultat s'ouvre sous forme de boîte de dialogue intitulée Audit Results, Remediation Results ou Evidence Pack Results, et Remediation ainsi qu'Evidence Pack restent désactivés jusqu'à ce que Run Audit soit terminé. Run Benchmark bascule vers une vue Benchmark Results distincte. About Demo précise à l'écran les limites du scénario : un moteur synthétique avec vérité terrain connue, dont les résultats démontrent la méthode et ne constituent pas une preuve d'intention validée sur le terrain. Chaque chiffre ci-dessous s'inscrit dans ces limites.
La démonstration audite 10,000 décisions de tarification synthétiques initialisées sur un seul SKU. Ce qui suit correspond à ce que l'exécution affiche à l'écran, dans l'ordre d'apparition.


Les chiffres ci-dessus sont issus d'une population synthétique initialisée de 10,000 décisions tarifaires sur un SKU avec une structure de substitution injectée et reproductible. Les résultats montrent que la méthode retrouve la structure injectée avec l'exactitude d'un jeu étiqueté. Ils ne constituent pas un taux d'exactitude sur des données tarifaires réelles, ni un benchmark face aux concurrents, ni une affirmation concernant un cybermarchand réel.
| Question | Ce que fait Equity dans cette démonstration | Ce qui reste en dehors de la démonstration |
|---|---|---|
| Intégration | Audite le bandit LinUCB que l'application de démonstration utilise comme moteur de substitution, et est conçu pour qu'un moteur client puisse s'interfacer derrière un adaptateur. | Tout code d'adaptateur ou connecteur en direct vers une plateforme de tarification. Aucun n'existe dans cette version, et aucun éditeur mentionné n'est client ou partenaire. |
| Données démographiques | Lit une table de référence sélectionnée de dix codes ZIP de New York et de California ainsi qu'un biais d'appareils initialisé et codé en dur dans l'application. | Un flux de données de recensement en direct ou de possession d'appareils. La table est restreinte et constituée manuellement, et la cohorte protégée est une étiquette injectée. |
| Constatations | Retrouve la structure de substitution injectée et consigne le verdict de chaque entrée avec sa justification dans le dossier. | Preuve d'une discrimination ou d'une intention dans le monde réel ; le dispositif n'émet aucun verdict d'intention. |
Equity ne fixe aucun prix pour aucun client et ne remplace ni Pricefx, ni PROS, ni Zilliant, ni Competera ; le moteur tarifie, Equity audite et contraint. Elle ne certifie pas la conformité, ne garantit pas la réussite aux tests et ne dispense aucun conseil juridique ; le dossier constitue un élément de preuve destiné aux avocats du client. Cette version couvre un SKU unique et le parcours de disparité d'impact depuis l'audit jusqu'au dossier de preuves ; la collusion algorithmique, les middlewares de divulgation multi-juridictionnels, la surveillance en flux continu et l'interface de paiement restent hors de son périmètre. Les profils South Bronx et Upper East Side figurant sur la carte Pricing Outcome Comparison sont des étiquettes représentatives de cohortes multi-ZIP et multi-appareils, et non des affirmations sur des quartiers réels.
Parce que le moteur n'a pas besoin de voir la race ou le revenu pour tarifier en fonction de ceux-ci. Dans la démonstration, le moteur sous audit tarifie sur l'indice de revenu du code ZIP, la gamme de l'appareil et le comportement de session, et ces entrées véhiculent la classe protégée : l'indice de revenu du ZIP présente une corrélation de 0.95 avec celle-ci et la gamme de l'appareil de 0.32. Sur la population synthétique initialisée, le résultat est un prix supérieur de 26.2% pour la cohorte aux codes ZIP à majorité minoritaire et aux anciens appareils pour les mêmes écouteurs avec des signaux de demande appariés, et un ratio four-fifths de 0.43 par rapport au seuil de 0.80. La procédure de la FTC contre Instacart portait sur les résultats (des acheteurs différents voyant des prix différents pour des articles identiques), et non sur ce qui avait été instruit à l'algorithme.
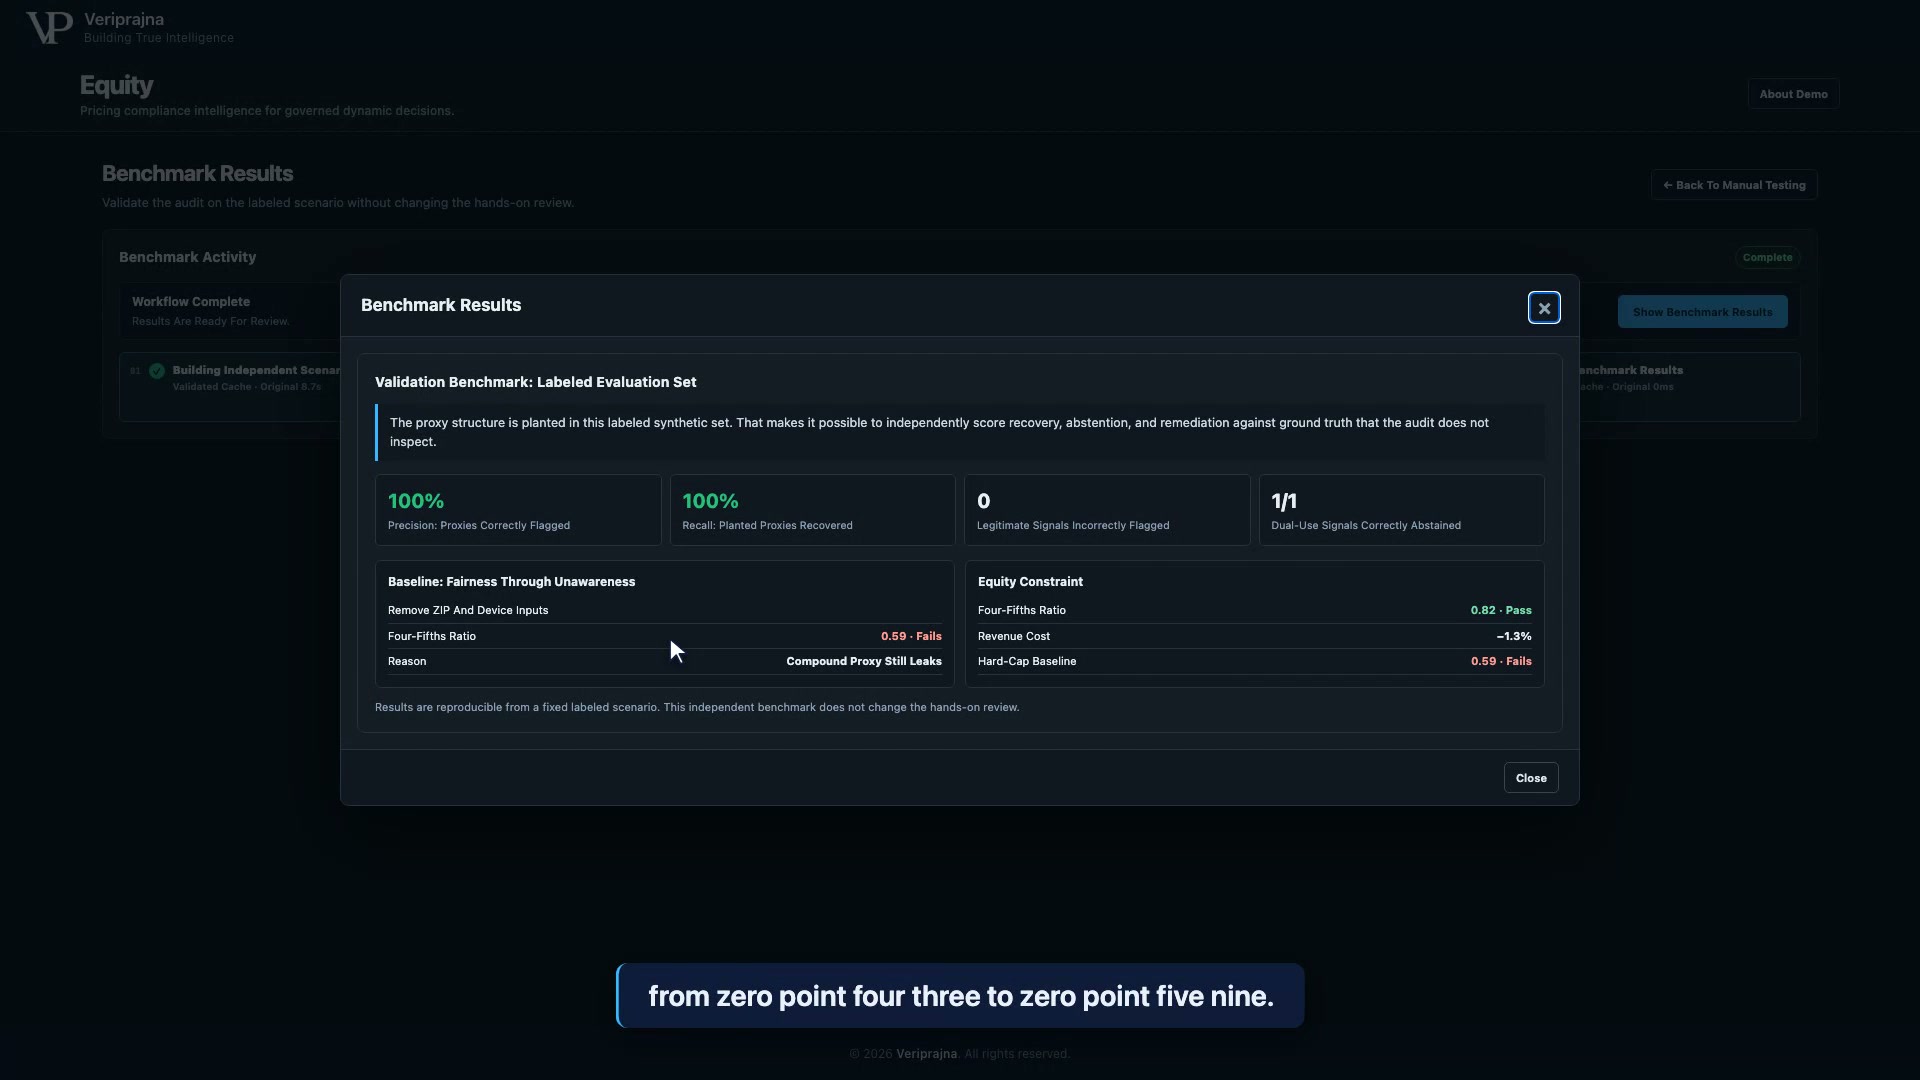
Sur ce moteur, non. La référence Fairness Through Unawareness dans le benchmark réentraîne le modèle sans les entrées de code ZIP ni d'appareil, et le ratio four-fifths ne progresse que de 0.43 à 0.59, ce qui reste un échec (fail). La manière dont l'acheteur est arrivé et la durée de sa visite obtiennent chacune PASS isolément, mais encodent conjointement la cohorte avec une information mutuelle de 0.73. La corrélation par variable unitaire est aveugle à cette paire ; une vérification d'information mutuelle conjointe ne l'est pas, c'est pourquoi l'audit évalue les interactions tout comme les entrées unitaires.
Vous le pouvez, et la démonstration montre ce qu'en fait un optimiseur de chiffre d'affaires. La Hard-Cap Baseline interdit tout prix supérieur à 115% du prix de référence équitable. Le moteur renonce à 0.2% de son chiffre d'affaires pour respecter la lettre de la contrainte et place 29% de la cohorte protégée à moins de 1% du plafond, de sorte que le ratio four-fifths n'atteint que 0.59 et que le filtre échoue toujours. Un plafond est une cible. Fairness-Aware Reward Shaping n'offre aucune limite vers laquelle converger, et il réussit à 0.82 pour un coût de 1.3% de chiffre d'affaires sur ce moteur synthétique.
Non. Equity ne fixe jamais de prix. Elle audite les décisions du moteur et propose une contrainte ; votre moteur, qu'il s'agisse de Pricefx, PROS, Zilliant, Competera ou d'un bandit sur mesure, continue d'exécuter la tarification. L'interface d'accueil du moteur client constitue un point de substitution documenté ; dans la démonstration, il n'y a pas de code d'adaptateur ni d'intégration en direct, le bandit LinUCB que nous avons construit constitue donc le moteur et fait l'objet d'un audit direct.
Rien de ce qu'un avocat aurait à défendre ne provient d'une sortie de modèle : les statistiques, la comparaison de seuil, chaque verdict, la contrainte et le hachage du dossier proviennent tous d'un code numpy déterministe en dehors de la couche d'agents. Le Feature Auditor et l'Adversarial Challenger rédigent de la prose ; ils ne calculent jamais aucun nombre et ne peuvent ni définir ni modifier un verdict, et l'alignement réglementaire est une table fixe plutôt qu'une sortie de modèle. En l'absence de fournisseur de modèle, l'équipe bascule sur des modèles prédéfinis déterministes et l'application produit les mêmes verdicts. La narration dans la présentation enregistrée est une sortie de modèle validée et mise en cache, et l'en-tête du dossier le précise explicitement.
Un dossier de preuves prêt pour la CID sous format JSON et HTML imprimable. Il consigne le nom et la version du moteur, les 10,000 décisions auditées, le filtre four-fifths avant et après remédiation, le verdict de chaque entrée avec sa justification, l'association de chaque entrée signalée avec la EEOC four-fifths rule, l'Algorithmic Pricing Disclosure Act de NY, le Colorado SB 24-205, les Articles 13 and 14 de l'EU AI Act et le FTC Act Section 5, le résultat de la remédiation et une empreinte SHA-256 du corps du dossier. Nous fournissons les preuves ; votre équipe juridique prend la décision.
Il s'agit d'un autocontrôle sur jeu étiqueté, et il doit être interprété comme tel. Le benchmark régénère la population synthétique initialisée de 10,000 décisions de la démonstration et lui pose une seule question : l'audit a-t-il identifié les trois variables de substitution injectées et rien d'autre ? C'est le cas. Toutes les trois ont été signalées, aucun des quatre signaux de demande légitimes n'a été signalé, et l'unique signal à double usage a fait l'objet d'une abstention (ABSTAIN) plutôt que d'être signalé ou validé (Cleared). Cela démontre que la méthode retrouve la structure injectée. Les journaux tarifaires réels comportent des facteurs de confusion, et il n'est pas éthiquement envisageable de mener des tests A/B en appliquant des prix distincts selon les groupes démographiques ; lors d'une mission, le même mécanisme produit donc des éléments de preuve pour examen juridique, jamais un verdict automatisé.
La recherche sous-jacente à cette démonstration — l'architecture, la conception de la vérification et le schéma directeur d'entreprise.
Solution complète
Découvrir la solution AI Pricing Compliance & Algorithmic Fairness →Nous sommes une équipe d'ingénierie en IA, ni un éditeur de solutions tarifaires, ni un organisme de certification de conformité. Nous partons du journal de décisions propre à votre moteur pour aboutir à un dossier que vos avocats peuvent déposer ; l'appréciation de ce qu'il révèle leur appartient.
Un premier échange utile est concret : quel moteur tarifie votre catalogue, quelles entrées il reçoit, s'il intègre des termes croisés ou des arbres décisionnels susceptibles de tarifier sur une variable de substitution composite, et quelles régions parmi New York, la California, le Colorado ou l'UE votre volume d'activité concerne. Nous pouvons concevoir l'audit, la synthèse de la contrainte et le format du dossier de preuves aux côtés de vos équipes de tarification, juridiques et de données.