Détection de contenu synthétique & de faux avis
Campaign Firewall montre comment les preuves relationnelles peuvent étayer un parcours d'examen humain lorsque le texte seul ne décèle pas le schéma. Tous les avis et historiques de comptes présentés ici sont synthétiques.
4 sur 15
Signalés par la référence locale basée sur le texte seul
Campagne modélisée entièrement humaine, même jeu d'essai
15 sur 15
Acheminés vers un examen humain par l'ensemble
Enregistrements synthétiques, aucune action sur la plateforme
105 paires de comptes
Liées par un historique de produits partagé
Preuves relationnelles au sein du même cluster
Ces observations issues du jeu d'essai expliquent un choix de conception. Les deux méthodes utilisent des centiles de texte dérivés du corpus, et le seuil d'examen de l'ensemble a été ajusté sur les mêmes étiquettes ; il ne s'agit pas d'une performance sur des données non observées.
Une équipe de protection de marque doit comprendre pourquoi des avis semblent liés avant de décider de ce qu'il convient d'escalader. Une formulation fluide ne suffit pas à établir que des comptes ont agi de manière indépendante, et une opinion négative ne constitue pas à elle seule une fraude.
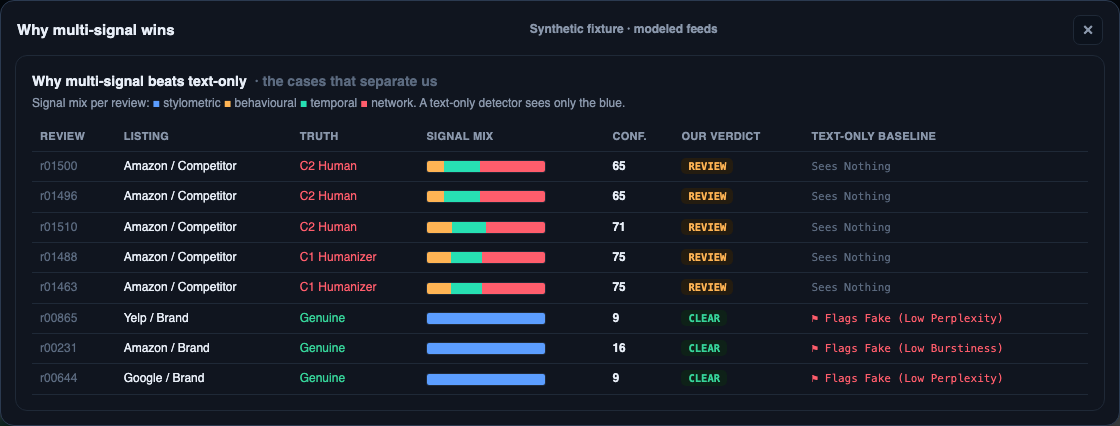
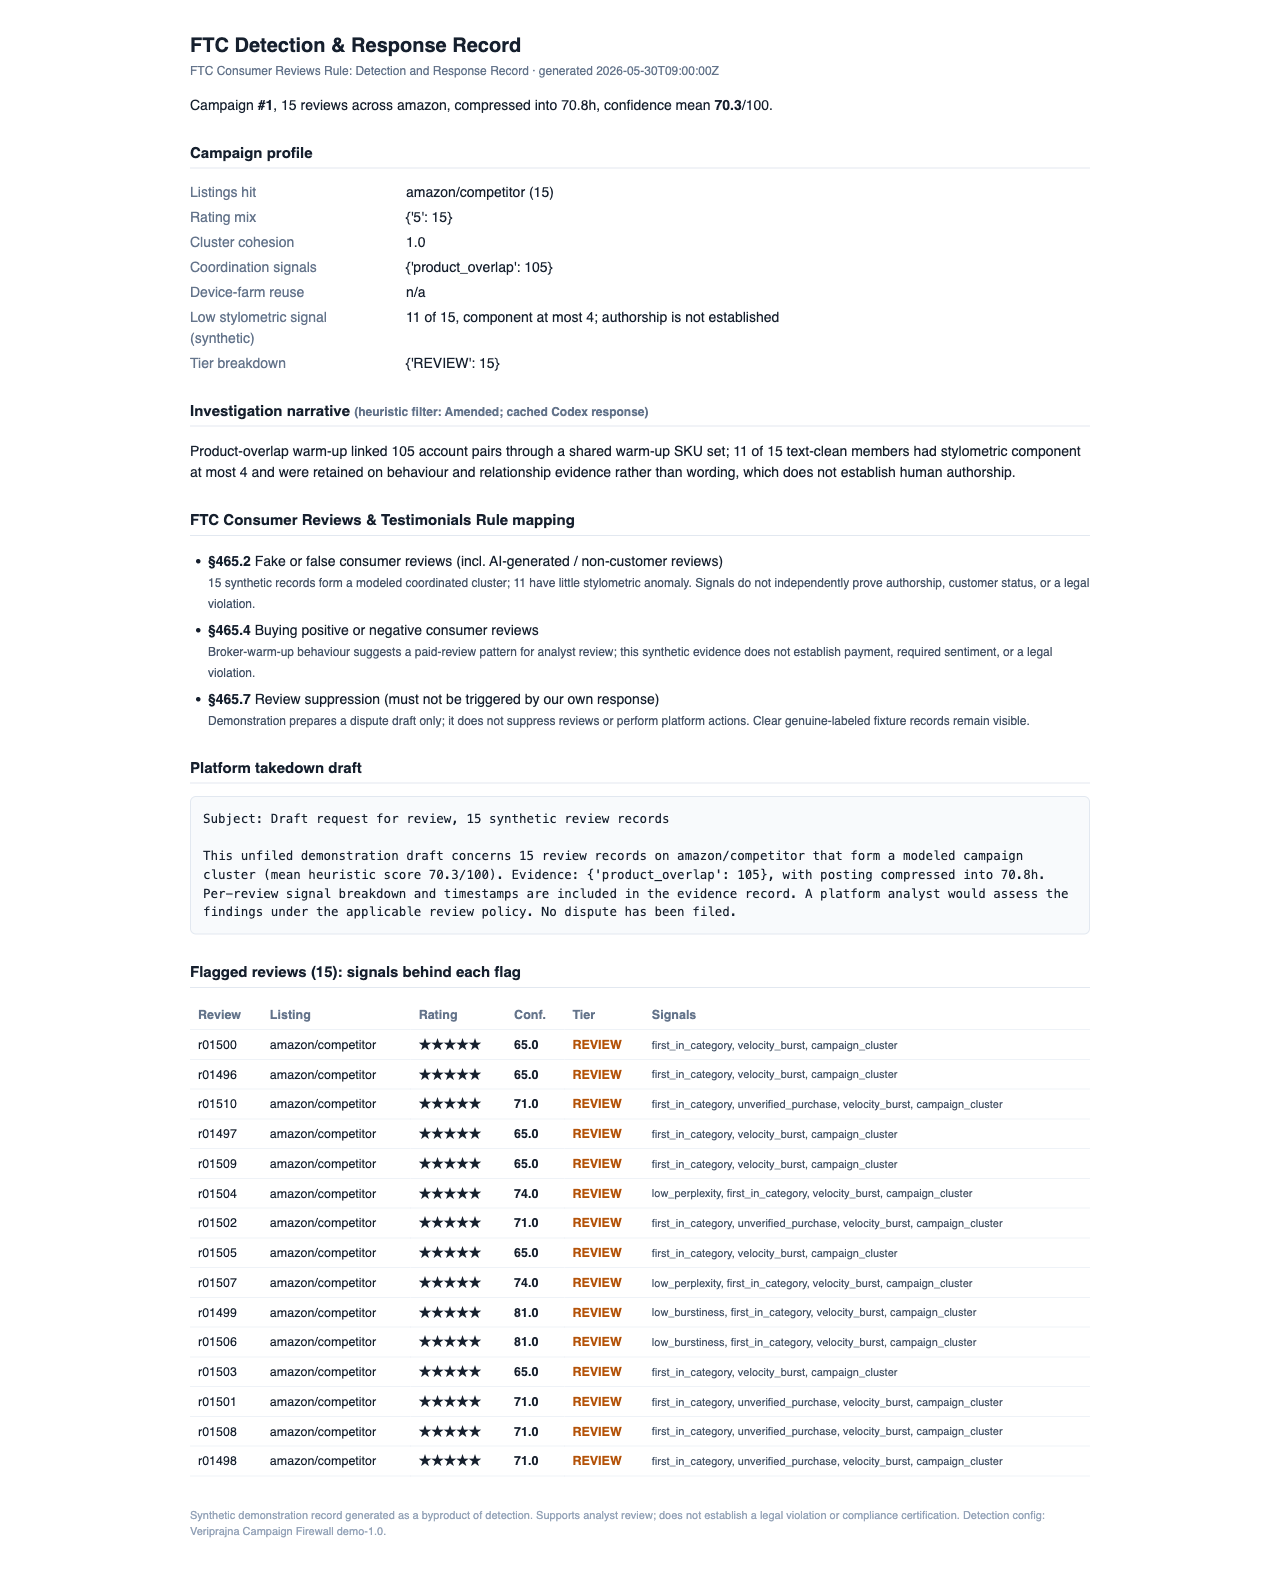
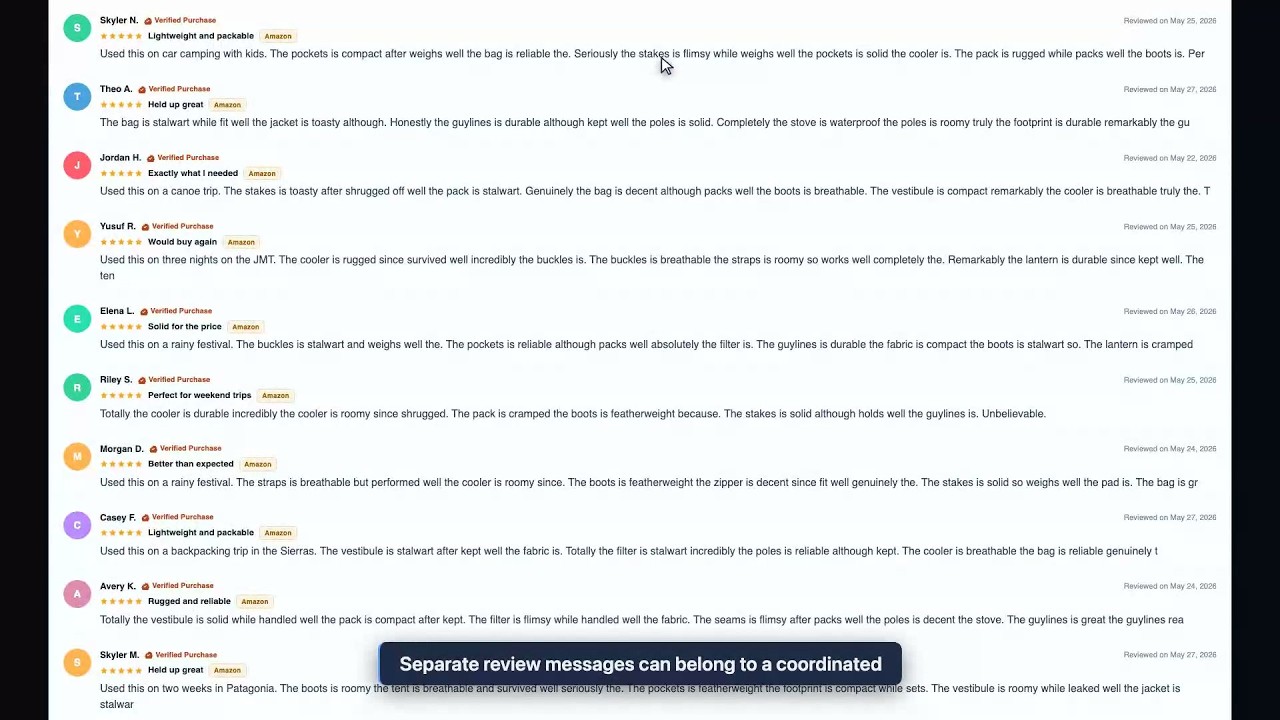
Notre exemple synthétique modélise une campagne de 15 avis sur la fiche d'un concurrent. Onze enregistrements présentent peu d'anomalies stylométriques, mais le chevauchement de leurs historiques de produits relie les comptes. La référence locale basée sur le texte seul en signale quatre sur les 15 ; l'ensemble achemine les 15 vers un examen.
Ce parcours préserve l'incertitude. L'étiquette modélisée entièrement humaine constitue la vérité terrain du jeu d'essai, et non la preuve que de véritables personnes ont rédigé ces avis ou qu'une rémunération a eu lieu.
Les schémas rédactionnels, le comportement des comptes, la temporalité des pics et les relations entre comptes contribuent à un score heuristique plafonné. Le jeu d'essai modélise 90 jours d'historique ; le détecteur temporel examine des fenêtres de pic de 72 heures. Le score n'est pas une probabilité calibrée.
Des appareils partagés ou des historiques de produits se chevauchant suffisamment créent des arêtes de graphe. Le chevauchement de produits nécessite une similarité Jaccard d'au moins 0,5 au sein de la même fiche et un intervalle maximal de 72 heures entre les enregistrements. La temporalité seule ne crée aucun lien.
Les composantes connexes deviennent des clusters de campagne lorsque leur taille et leur cohésion satisfont aux règles configurées. Une notation déterministe attribue l'éligibilité CLEAR, REVIEW ou AUTO modélisé avant la rédaction d'un récit. REVIEW demeure un parcours destiné au jugement humain, et non une enquête achevée.
L'investigation enregistrée rejoue une réponse Codex en cache après la notation. Un filtre déterministe vérifie les nombres, le chevauchement de tokens et les inversions de verdict ; il n'établit pas la véracité de chaque phrase retenue. Le JSON conserve l'appartenance à la campagne, les scores numériques des composantes et un projet de litige non déposé. Le HTML imprimable affiche le profil de la campagne, les noms des signaux par avis et le projet ; il n'affiche pas la décomposition numérique des composantes.
Le graphe utilise un partitionnement en composantes connexes interprétable. Aucun réseau de neurones sur graphe entraîné ni aucune intégration de plateforme en production ne sont implémentés dans cette démonstration.
Tous les avis, historiques de comptes, appareils et flux de plateformes dans ces captures réelles d'application sont synthétiques. L'exemple principal suit 15 avis modélisés de concurrents, depuis la détection d'une campagne jusqu'à l'enregistrement exporté, en passant par un parcours d'examen humain.
Le jeu d'essai étiquette ce cas comme une campagne rémunérée entièrement humaine, mais ni la paternité rédactionnelle ni le paiement ne sont établis par le détecteur. Onze de ses 15 avis ont une composante stylométrique d'au plus 4 : peu d'anomalies de rédaction dans cette implémentation. Leurs historiques de comptes fournissent la raison de les examiner ensemble.
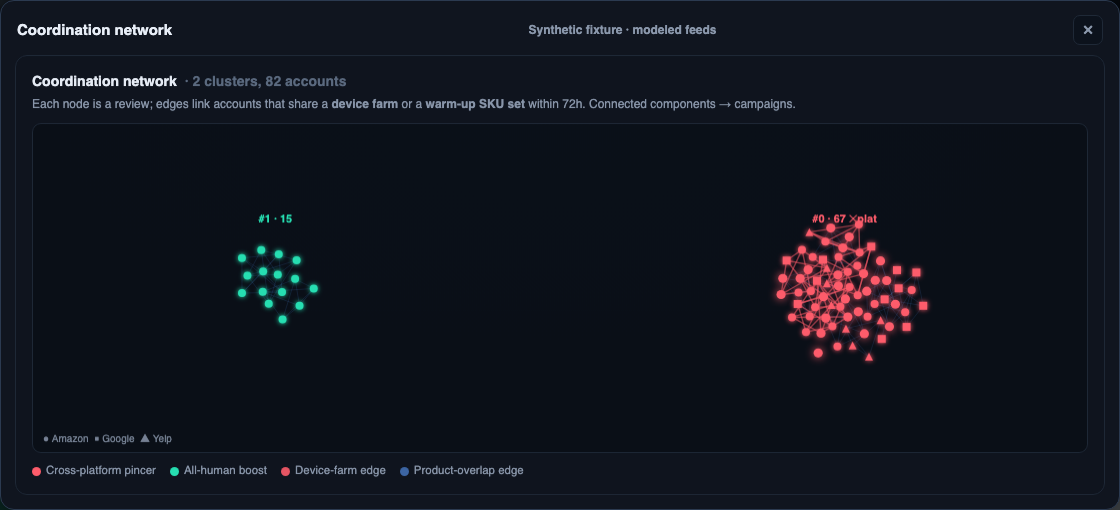
Les 15 avis partagent des historiques de produits se chevauchant suffisamment sur la même fiche dans la limite configurée de 72 heures. Cela crée 105 arêtes de paires par chevauchement de produits, reliant chaque paire du cluster, avec une cohésion de 1,0. Il n'y a aucune arête d'appareil partagé dans ce cas ; le constat ne dépend pas de la réutilisation d'appareils. La temporalité seule ne créerait pas d'arête.
La référence locale basée sur le texte seul signale quatre des 15 enregistrements. Elle manque donc la détection au niveau de la campagne selon la règle de ce banc d'essai exigeant qu'au moins 60% d'une étiquette implantée soit signalée. L'ensemble combine les composantes d'écriture, de comportement, de temporalité et de réseau, et achemine les 15 vers REVIEW plutôt que vers AUTO.
| Preuve ou décision | Résultat observé | Interprétation |
|---|---|---|
| Signal de schéma rédactionnel | 11 sur 15 ont une composante stylométrique d'au plus 4 | Une faible anomalie ne constitue pas un certificat de paternité humaine. |
| Relation entre comptes | 105 arêtes de paires par chevauchement de produits ; aucune arête d'appareil partagé | Un schéma d'historique partagé justifie d'examiner les comptes ensemble. |
| Référence locale basée sur le texte seul | 4 sur 15 signalés | Ce comparateur implémenté manque la campagne en vertu de la règle des 60%. |
| Parcours de l'ensemble | 15 REVIEW ; 0 AUTO | Les 15 sont acheminés vers un jugement humain. Aucun avis n'est supprimé. |
La notation déterministe définit les niveaux avant que le modèle optionnel ne décrive le constat. L'investigation enregistrée rejoue une réponse en cache issue de la passerelle Codex réelle. Son filtre d'ancrage vérifie les nombres, le chevauchement de tokens et les inversions de verdict ; la prose retenue nécessite toujours l'examen d'un analyste et ne peut modifier le score ou le niveau.
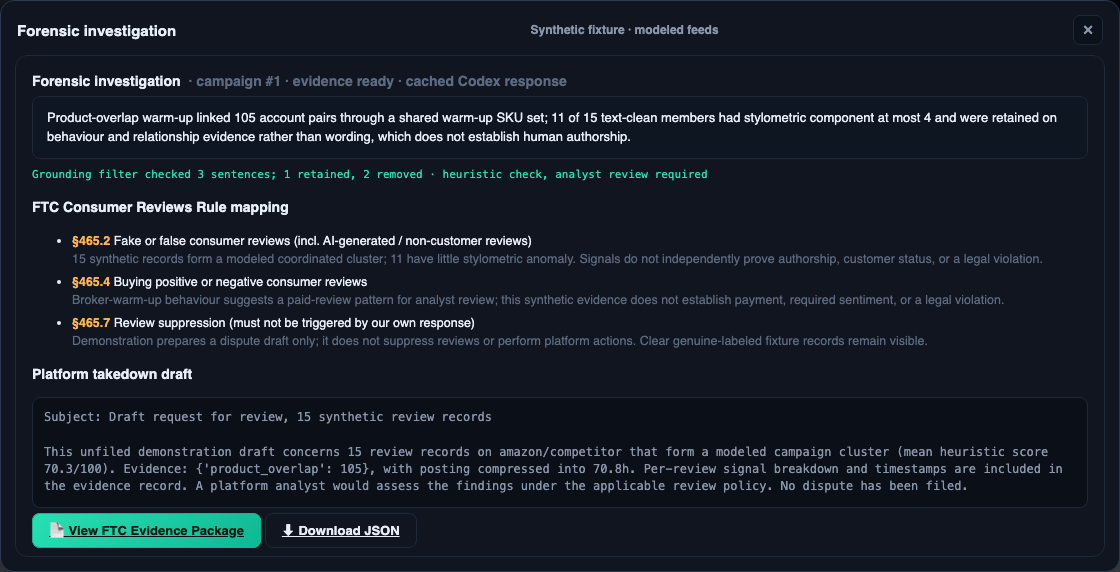
L'export JSON réel conserve l'appartenance à la campagne, la répartition par niveau, les signaux contributifs et les scores des composantes de chaque enregistrement. Le HTML imprimable affiche un profil de campagne, la narration en cache, une correspondance indicative de règles, un projet de litige non déposé et l'ensemble des 15 lignes signalées. Un analyste peut vérifier pourquoi un enregistrement a été acheminé au lieu de s'en remettre uniquement à la narration. Le projet de litige natif surestime la couverture des horodatages : le rapport JSON et le rapport imprimable incluent un horodatage de génération d'enregistrement, mais aucun horodatage par avis. Ceux-ci devraient être ajoutés et vérifiés avant toute utilisation externe.
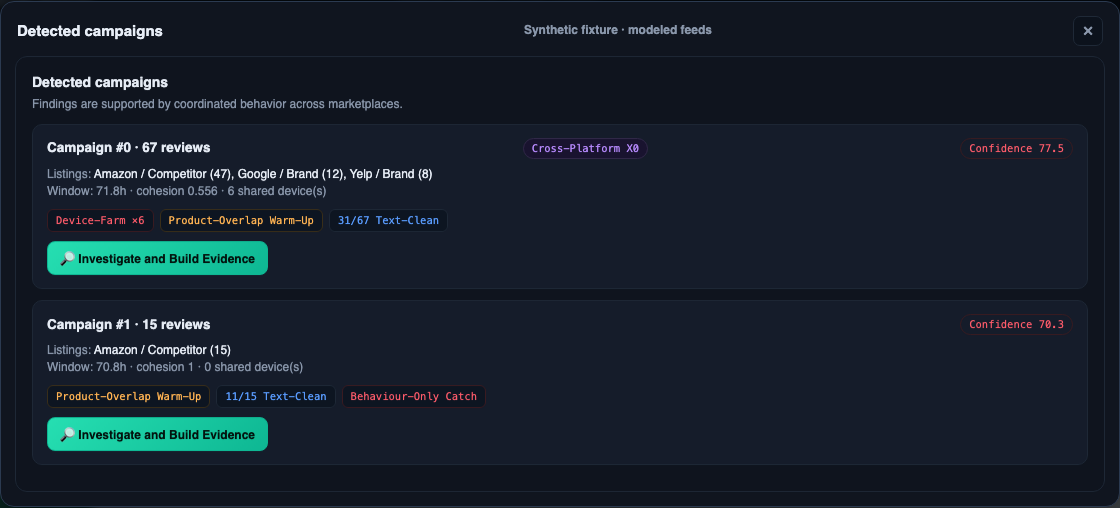
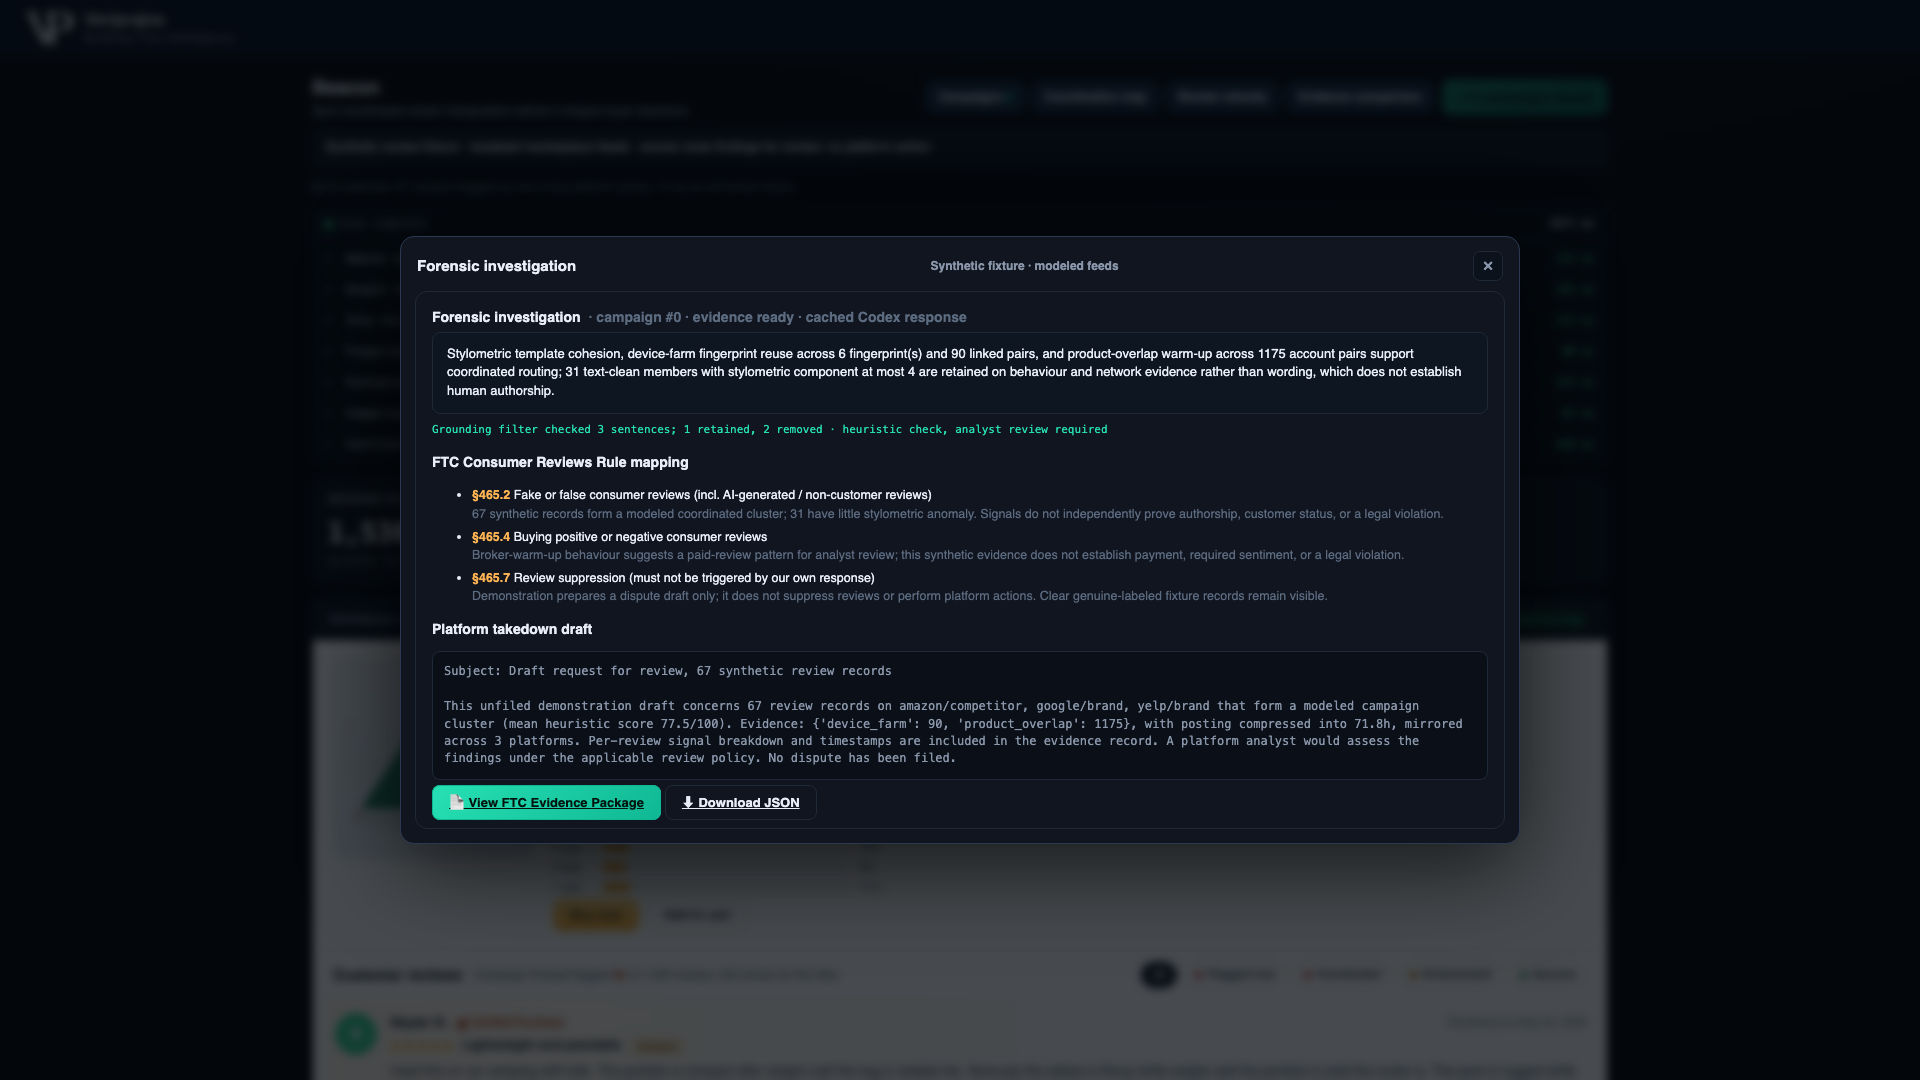
Un cluster synthétique distinct relie 67 enregistrements : 47 avis cinq étoiles sur la fiche modélisée d'un concurrent Amazon, plus 12 avis Google et huit avis Yelp ciblant la marque modélisée. Sur 71,8 heures, le cluster compte 90 arêtes de paires par appareils partagés et 1 175 arêtes de paires par chevauchement de produits. Il contient 24 enregistrements AUTO et 43 enregistrements REVIEW ; AUTO représente l'éligibilité selon une politique modélisée, non une suppression automatique.
Ce cas montre pourquoi un réviseur peut avoir besoin de relations à travers plusieurs flux modélisés plutôt que d'un simple décompte de messages négatifs. Trente et un des 67 enregistrements présentent peu d'anomalies stylométriques. Même avec un schéma connecté, le détecteur n'établit pas de paiement réel, de statut de client ou de culpabilité.
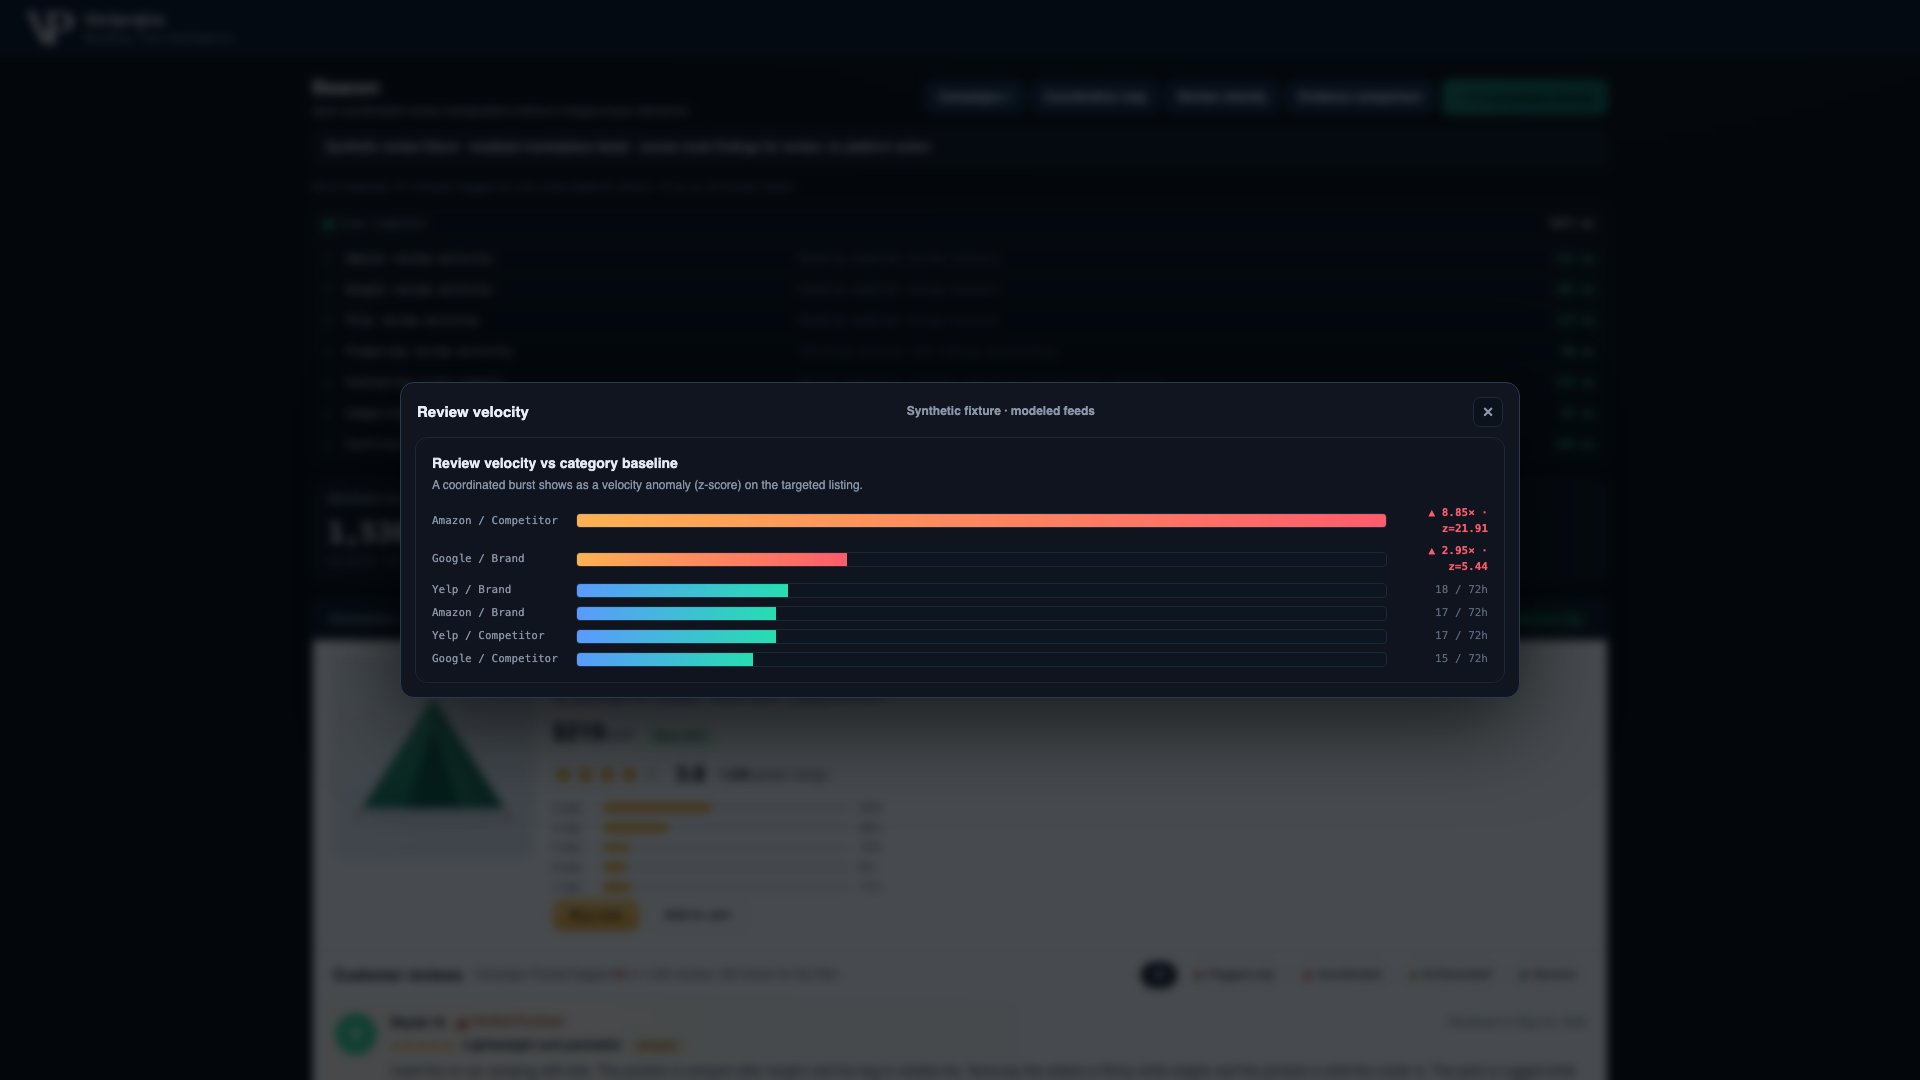
La fiche du concurrent Amazon modélisée culmine à 69 avis dans une fenêtre de 72 heures par rapport à une valeur attendue de 7,8, soit environ 8,85 fois la référence configurée. Ce décompte au sein de la fenêtre de la fiche n'est pas la taille du cluster multiplateforme de 67 enregistrements. Une explosion apporte un signal temporel ; les relations entre comptes fournissent les liens du graphe.
Le jeu d'essai élargi contient 1 530 enregistrements synthétiques sur un historique modélisé de 90 jours. Les résultats suivants reproduisent les seuils actuellement chargés sur ce même corpus étiqueté. Les deux méthodes en dérivent des centiles de texte, et le seuil REVIEW de l'ensemble a été ajusté sur ses étiquettes. Il ne s'agit pas de résultats d'exactitude en production ou sur des données réservées.
| Mesure | Ensemble Campaign Firewall | Référence locale basée sur le texte seul |
|---|---|---|
| Enregistrements d'avis implantés signalés | 82 sur 82 | 40 sur 82 |
| Enregistrements étiquetés authentiques signalés à tort | 0 sur 1 448 | 306 sur 1 448 |
| Étiquettes de campagnes implantées détectées | 3 sur 3 | 0 sur 3 |
Le signalement inclut REVIEW et AUTO, non des suppressions. Les trois étiquettes implantées forment deux clusters de graphe car les étiquettes de valorisation et de miroir se connectent au sein du même cluster multiplateforme. Le contraste des faux positifs s'applique uniquement à cette référence implémentée et à ce jeu d'essai ajusté, non à des détecteurs commerciaux ou à de nouveaux avis.
| Couche | Preuve utile | Limite |
|---|---|---|
| Référence locale basée sur le texte seul | Anomalies de schéma rédactionnel dans des enregistrements individuels | Signale quatre sur 15 dans la campagne modélisée ; aucune revendication de détecteur commercial |
| Ensemble Campaign Firewall | Écriture, comportement, temporalité et relations entre comptes | Achemine les 15 vers un examen dans ce jeu d'essai synthétique ajusté |
| Documentation d'investigation | Appartenance, scores des composantes, narration et projet de litige | Permet l'inspection ; ne dépose aucun litige et ne prouve aucune infraction |
Tous les enregistrements d'avis, historiques de comptes, empreintes d'appareils et connexions de plateformes sont synthétiques. Les flux sont modélisés, sans connecteurs en direct ni avis collectés par scraping. La démonstration n'authentifie pas les auteurs réels, ne supprime pas d'avis, n'achève pas d'enquêtes humaines et ne dépose pas de litiges.
Aucune évaluation sur des données réservées, taux de faux positifs en production, gain d'heures d'analyste, ROI ou taux de réussite des litiges n'a été mesuré. Les résultats sur le même jeu d'essai montrent un comportement configuré reproductible ; ils n'établissent pas de généralisation.
Campaign Firewall combine les schémas rédactionnels avec le comportement des comptes, la temporalité et les preuves relationnelles. Dans une campagne synthétique de 15 avis, la référence locale basée sur le texte seul signale quatre enregistrements tandis que l'ensemble achemine les 15 vers un examen humain. Ce cas modélisé démontre la détection de coordination ; il n'établit ni une paternité humaine réelle ni une performance sur de nouveaux avis.
Des empreintes d'appareils partagées et des historiques de produits qui se chevauchent créent des relations entre comptes dans les données modélisées. Les liens d'historique de produits nécessitent une fiche partagée, une similarité Jaccard d'au moins 0,5 et des horodatages distants d'au plus 72 heures ; la temporalité seule ne crée aucune arête. L'appartenance à la campagne, les scores des composantes et les signaux contributifs restent disponibles dans l'export de preuves.
La démonstration utilise des enregistrements synthétiques et des historiques modélisés étiquetés pour Amazon, Google et Yelp. Elle ne dispose d'aucun connecteur de plateforme en direct, d'aucun avis collecté par scraping ni d'aucun accès à de véritables historiques de comptes, d'appareils ou d'achats. L'accès aux données de production, les autorisations et les intégrations nécessiteraient une implémentation et une validation distinctes.
Campaign Firewall exporte des preuves descriptives en JSON et HTML imprimable avec un projet de litige non déposé. REVIEW désigne un parcours d'examen humain, et AUTO désigne l'éligibilité selon la politique modélisée. Aucun de ces états ne supprime un avis, ne soumet de litige ni ne conclut une enquête.
L'ensemble actuel valide l'ensemble des 1 448 enregistrements synthétiques étiquetés authentiques dans ce jeu d'essai. Son seuil d'examen a été ajusté sur les mêmes étiquettes, et les deux méthodes dérivent des centiles de texte à partir de ce corpus, de sorte que ce résultat ne peut établir un taux de faux positifs pour des données non observées. Une évaluation sur des données indépendantes demeure nécessaire avant d'utiliser ces parcours de manière opérationnelle.
Les signaux de coordination n'établissent ni rémunération, ni sentiment imposé, ni statut de client, ni infraction légale. La FTC distingue les avis faux ou trompeurs des incitations conditionnées à un sentiment positif ou négatif ainsi que de la suppression d'avis. La démonstration fournit une correspondance indicative de règles et un projet non déposé pour examen de fond ; elle ne certifie aucune conformité.
Contexte juridique : Federal Trade Commission, Consumer Reviews and Testimonials Rule Q&A (consulté en 2026). La correspondance est descriptive et requiert un examen juridique de fond avant toute utilisation externe.
Explorez les recherches associées pour un contexte plus large sur cette démonstration.
Solution complète
Découvrez la solution Synthetic Content & Fake Review Detection →Discutez de vos exigences de preuves et d'escalade avec Veriprajna.
Nous pouvons définir le périmètre d'accès aux données, l'évaluation indépendante et le flux de travail d'examen nécessaires à votre cas d'usage. La démonstration offre une base concrète pour cet échange.