Audit d'équité et atténuation des biais de l'IA
Nous auditons les systèmes d'IA pour détecter les résultats discriminatoires dans le recrutement, le crédit, l'assurance et la santé, puis nous concevons les pipelines d'atténuation qui corrigent les causes profondes.
Votre audit de biais a réussi. Votre système continue pourtant de discriminer.
La plupart des audits de biais de l'IA appliquent la règle des quatre cinquièmes selon la race et le genre, produisent un PDF et déclarent la conformité. Cette approche présente trois problèmes.
- La règle des quatre cinquièmes est un instrument grossier. Tirée des Uniform Guidelines (29 CFR 1607), c'est un seuil de dépistage conçu pour les pratiques de recrutement de 1978. Elle ne peut pas détecter la discrimination par variable de substitution, où le code postal, la distance de trajet domicile-travail ou l'établissement scolaire encodent la même information que la race sans la nommer.
- Les métriques agrégées masquent les disparités intersectionnelles. Une étude de l'Université de Washington a constaté que les outils de présélection de CV fondés sur des LLM favorisaient les noms associés aux personnes blanches 85 % du temps et ne favorisaient jamais les noms associés aux hommes noirs par rapport aux noms associés aux hommes blancs. Les métriques raciales agrégées passeraient entièrement à côté de cet effet cumulatif.
- Un audit ponctuel traite l'équité comme si elle était permanente. Les modèles dérivent, les distributions d'entrée évoluent et de nouvelles caractéristiques sont ajoutées. Un système qui a réussi un audit en janvier peut discriminer dès mars, et personne ne le saura jusqu'à ce qu'une plainte soit déposée.
Notre approche consiste à concevoir des audits d'équité pensés pour aller plus loin que le dépistage statistique, comme détaillé dans nos recherches sur les architectures de confiance au-delà de l'IA superficielle. Le point de départ est de comprendre ce que « équitable » signifie pour votre système spécifique, car les mathématiques garantissent que vous ne pouvez pas tout avoir à la fois.
Chaque audit est un choix explicite, non un paramètre par défaut
Le théorème d'impossibilité de Chouldechova (2017) prouve que lorsque les taux de base diffèrent d'un groupe à l'autre, aucun classifieur imparfait ne peut satisfaire simultanément la calibration et l'égalité des taux d'erreur. Kleinberg, Mullainathan et Raghavan ont prouvé un résultat plus général : trois conditions d'équité intuitives ne peuvent pas être satisfaites simultanément, sauf dans des cas triviaux.
Ce ne sont pas des notes de bas de page académiques. Elles signifient que chaque audit d'équité exige un choix explicite quant aux critères à prioriser, et que ce choix entraîne des conséquences juridiques, éthiques et commerciales. Nous mettons en évidence ce compromis avant que quiconque ne commence à optimiser.
Discrimination par variable de substitution : les caractéristiques que vous avez retirées sont toujours dans le modèle
Retirer la race, le genre ou l'âge des entrées d'un modèle n'élimine pas la discrimination. Cela supprime la preuve directe de celle-ci tout en laissant les mécanismes intacts.
- Un modèle de crédit qui abandonne la race mais conserve le code postal hérite des schémas de ségrégation résidentielle qui font du code postal une variable de substitution quasi parfaite de la race dans de nombreuses zones géographiques.
- Un outil de recrutement qui abandonne l'âge mais utilise l'année d'obtention du diplôme, les années d'expérience et l'ancienneté de la pile technologique (COBOL contre Kubernetes) reconstitue l'âge avec une grande fidélité.
Notre méthode utilise l'analyse par graphe causal pour retracer comment les attributs protégés circulent à travers l'espace des caractéristiques jusqu'aux prédictions, une approche détaillée dans nos recherches sur l'IA causale pour un recrutement et une embauche équitables. La question n'est pas de savoir si une caractéristique est corrélée à la race. C'est de savoir si la disparité qui circule à travers cette caractéristique représente un facteur commercial légitime (l'historique de crédit prédit réellement le remboursement) ou une variable de substitution du statut protégé (les scores d'historique de crédit encodent la discrimination historique en matière de prêt).
Cette distinction requiert un jugement propre au domaine, et pas seulement des tests statistiques. La mission construit le diagramme causal de chaque système en collaboration avec les personnes qui comprennent le domaine, identifie chaque chemin des attributs protégés vers les résultats, et classe chaque chemin comme légitime, problématique ou nécessitant une investigation plus poussée. Le résultat visé est une cartographie des endroits où la discrimination pénètre dans le système, et pas seulement un chiffre indiquant qu'elle existe.
Audit intersectionnel : là où les tests à axe unique échouent
Tester la race et le genre indépendamment passe à côté des pires disparités. Le biais algorithmique à l'encontre des femmes noires ne peut pas s'expliquer comme la somme du biais anti-Noirs et du biais anti-femmes. L'effet cumulatif crée un désavantage unique qui n'apparaît que lorsqu'on examine l'intersection. Une étude d'analyse faciale de 2024 a constaté que les algorithmes de classification du genre présentaient des taux de mauvaise classification d'environ 30 % pour les femmes à la peau foncée, dépassant de loin les taux d'erreur pour tout axe démographique isolé.
Le défi pratique est celui de la puissance statistique. Les sous-groupes intersectionnels (femmes noires de plus de 50 ans dans des codes postaux ruraux) sont de petite taille, et les tests d'hypothèses standard perdent rapidement leur puissance à mesure que la taille des échantillons diminue. Une analyse naïve des sous-groupes soit passe à côté de disparités réelles parce que les échantillons sont trop petits pour atteindre la significativité, soit produit de fausses alertes issues d'estimations instables.
Notre méthode répond à cela avec des modèles hiérarchiques bayésiens qui empruntent de la force à travers des sous-groupes apparentés, fournissant des intervalles de crédibilité même pour de petites populations. Elle applique également des cadres de tests séquentiels qui accumulent des preuves au fil du temps plutôt que d'exiger toute la puissance statistique dans un seul instantané. Le résultat est une surveillance intersectionnelle conçue pour détecter les disparités émergentes avant qu'elles n'atteignent les niveaux où les métriques agrégées les détecteraient.
Auditer à travers les domaines : recrutement, crédit, assurance, santé
Chaque domaine a son propre cadre réglementaire, ses critères d'équité et ses schémas de discrimination par variable de substitution.
| Domaine | Paysage réglementaire |
|---|---|
| Recrutement | À New York, la LL144 impose des audits de biais annuels indépendants avec publication d'un résumé public. L' audit de décembre 2025 du Contrôleur de l'État de New York a constaté que 75 % des appels de plainte relatifs aux AEDT étaient mal orientés, et l'agence n'a identifié qu'un seul cas de non-conformité là où les auditeurs ont relevé 17 violations potentielles. L'application se durcit : l'Illinois HB 3773 (en vigueur depuis janvier 2025) interdit les décisions d'emploi discriminatoires prises par l'IA, et Mobley v. Workday est devenue en mai 2025 la première action collective certifiée à l'échelle nationale portant sur les biais de l'IA. |
| Crédit | L'application fédérale se fragmente. Le CFPB a proposé en novembre 2025 d'éliminer l'analyse de l'impact disparate au titre de l' ECOA , mais les procureurs généraux des États comblent le vide. Le Massachusetts a réglé une affaire de 2,5 millions de dollars de discrimination dans la souscription par IA en juillet 2025. |
| Assurance | La Colorado SB 21-169 interdit l'usage injustement discriminatoire d'algorithmes et de modèles prédictifs, les assureurs auto et santé devant soumettre des rapports de conformité annuels d'ici juillet 2026. |
| Santé | Les corrections fondées sur la race dans les algorithmes cliniques font l'objet d'un examen soutenu : les oxymètres de pouls qui surestiment les niveaux d'oxygène chez les patients à la peau foncée ont entraîné des diagnostics tardifs. Mais retirer la race peut aussi nuire à certaines populations lorsqu'elle sert de substitut à des facteurs de risque réels que le modèle ne peut autrement capturer. |
Pour l'IA de recrutement, une mission est cadrée pour aller au-delà du minimum de la LL144 avec une analyse intersectionnelle, des tests de caractéristiques de substitution et des vérifications d'équité contrefactuelle, éclairée par nos recherches sur la responsabilité liée au recrutement par IA.
Une atténuation qui corrige les causes profondes, non les symptômes
L'atténuation des biais se répartit en trois étapes du pipeline, et choisir la mauvaise gaspille des efforts ou introduit de nouveaux problèmes.
| Étape | Techniques | Ce qu'elle fait bien | Là où elle échoue |
|---|---|---|---|
| Prétraitement | Rééchantillonnage, repondération, apprentissage de représentation équitable | Corrige les biais qui trouvent leur origine dans la collecte des données | Échoue lorsque le biais provient de différences distributionnelles légitimes |
| Traitement en cours d'apprentissage | Contraintes d'équité, débiaisage adversarial, régularisateurs d'équité | Donne un contrôle direct sur le compromis exactitude-équité | Imposer la parité démographique lorsque les taux de base diffèrent réellement dégrade la calibration. En matière de crédit, le modèle soit sur-approuve les demandeurs à haut risque, soit sous-approuve les demandeurs à faible risque dans le groupe contraint. |
| Post-traitement | Seuils propres à chaque groupe, ThresholdOptimizer de Fairlearn | Le plus rapide à mettre en œuvre | Ne fonctionne que pour la classification, exige les étiquettes de groupe au moment de l'inférence et traite les symptômes sans s'attaquer aux mécanismes |
Notre approche sélectionne l'étape d'intervention en fonction de l'endroit où le biais pénètre dans le pipeline, de ce qu'exige le cadre réglementaire et du compromis exactitude-équité que l'organisation peut tolérer. Chaque atténuation est cadrée pour produire une évaluation documentée montrant son effet à la fois sur les métriques d'équité et sur la performance du système, le compromis étant énoncé explicitement.
Surveillance continue contre audits annuels
Un audit annuel est un minimum réglementaire, non une suffisance technique. Les modèles qui interagissent avec des boucles de rétroaction peuvent développer des biais entre deux audits : les outils de recrutement où les décisions passées façonnent les viviers de candidats futurs, ou les modèles de crédit où les schémas d'approbation influencent les données des bureaux de crédit.
Notre approche consiste à mettre en place une surveillance continue de l'équité à l'aide de tests d'hypothèses séquentiels qui détectent les disparités émergentes en temps réel plutôt que d'attendre d'avoir assez de données pour effectuer un test de significativité traditionnel, un modèle de responsabilité exploré dans nos recherches sur l'ingénierie de la rétention et la responsabilité algorithmique. La surveillance déclenche des alertes lorsque les métriques d'équité franchissent des seuils configurables, avec un suivi distinct des performances agrégées et des sous-groupes intersectionnels. C'est la différence entre découvrir un problème de discrimination dans votre rapport d'audit annuel et le détecter deux semaines après son apparition.
Pour les systèmes d'IA agentique, la surveillance de l'équité est encore plus cruciale : les orchestrations multi-agents peuvent développer un biais émergent à travers les interactions entre agents et les boucles de rétroaction qu'aucun audit à agent unique ne détecterait.
Là où les boîtes à outils et les plateformes s'arrêtent et où le travail sur mesure commence
IBM AIF360 fournit 71 métriques d'équité et 13 algorithmes d'atténuation des biais. Fairlearn propose ThresholdOptimizer, ExponentiatedGradient et la réduction par GridSearch. Les deux sont de précieux points de départ. Ni l'un ni l'autre ne font le plus difficile.
- Les deux exigent des étiquettes d'attributs protégés en entrée, que les organisations ne peuvent souvent pas collecter.
- Les deux supposent que l'utilisateur sait quelle métrique d'équité optimiser, ce qui exige de naviguer parmi les théorèmes d'impossibilité pour le domaine spécifique.
- Ni l'un ni l'autre ne construit le graphe causal qui sépare la discrimination par variable de substitution des facteurs de risque légitimes.
- Ni l'un ni l'autre ne gère l'analyse intersectionnelle où les tests statistiques standard perdent leur puissance.
Les plateformes de gouvernance comme Holistic AI et Credo AI fournissent un suivi de la conformité, un inventaire des modèles et un scoring des risques. Elles vous disent quels modèles ont besoin d'un audit et si les résultats d'audit sont à jour. Elles ne réalisent pas la méthodologie d'audit elle-même : l'analyse causale, les tests intersectionnels, la sélection de l'atténuation, la documentation du compromis exactitude-équité. Nos missions s'intègrent à n'importe quelle plateforme ou boîte à outils que le client utilise déjà. La couche méthodologique, c'est ce que nous apportons.
Points clés à retenir
- La règle des quatre cinquièmes (29 CFR 1607) est un seuil de dépistage de l'ère 1978 qui passe à côté de la discrimination par substitution et intersectionnelle.
- Chouldechova (2017) et Kleinberg, Mullainathan & Raghavan prouvent qu'aucun classifieur ne satisfait tous les critères d'équité à la fois, de sorte que chaque audit est un choix de priorisation explicite.
- L'analyse par graphe causal cartographie comment des attributs retirés comme la race et l'âge réintègrent le modèle par des variables de substitution telles que le code postal et l'année d'obtention du diplôme.
- Les méthodes de tests hiérarchiques bayésiens et séquentiels font apparaître les disparités intersectionnelles que les métriques à axe unique et agrégées masquent.
- Les réglementations diffèrent selon le domaine — NYC LL144, Illinois HB 3773, ECOA, Colorado SB 21-169 — de sorte que l'étape d'atténuation et la surveillance doivent être choisies système par système.
- Les boîtes à outils (AIF360, Fairlearn) et les plateformes de gouvernance (Holistic AI, Credo AI) sont des points de départ ; la méthodologie causale, intersectionnelle et de compromis, c'est le travail sur mesure.
Audit d'équité et atténuation des biais de l'IA
 Regarder
IA éthique de rétention par abonnement | Veriprajna
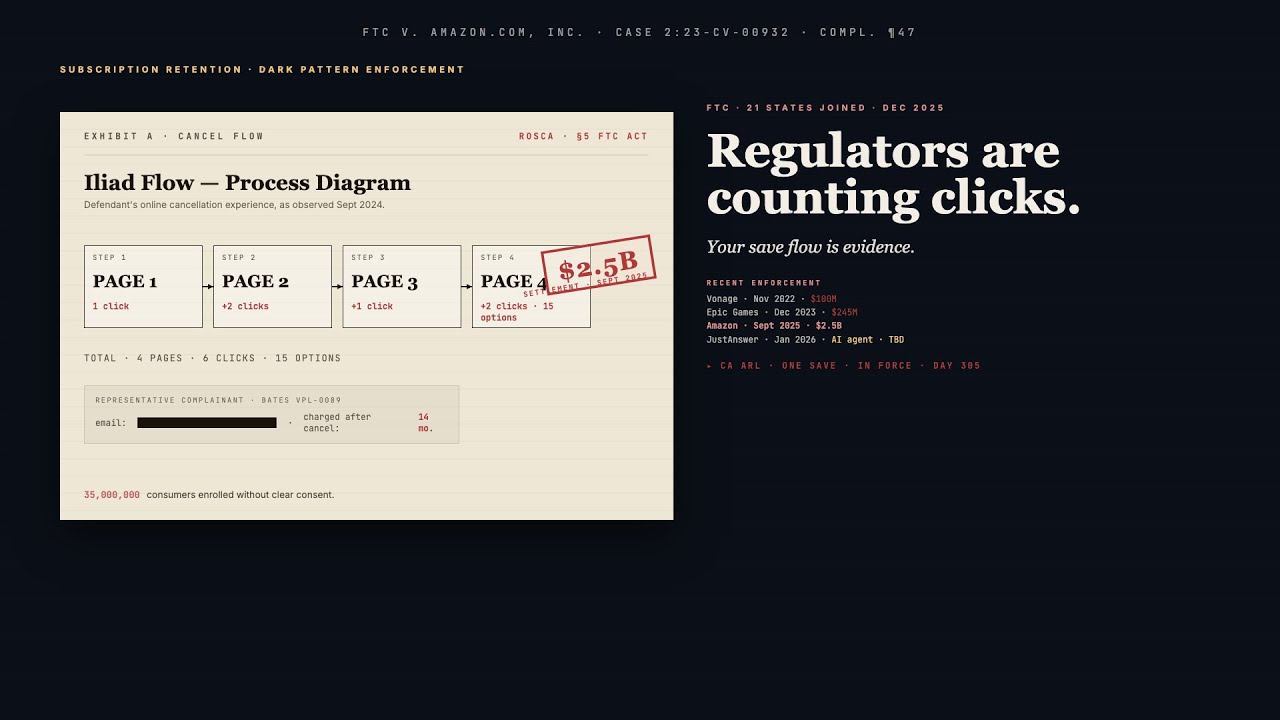
Amazon a payé 2,5 milliards de dollars pour un parcours de résiliation qui exigeait 6 clics. Uber fait face à 21 procureurs généraux d'États au sujet de 23 écrans à franchir pour résilier.
Questions fréquentes
Combien coûte un audit de biais de l'IA, et combien de temps prend-il ?
Le périmètre détermine le coût plus que tout autre facteur. Un audit ciblé et conforme à la LL144 d'un seul outil de recrutement avec une analyse standard par la règle des quatre cinquièmes peut être réalisé en deux semaines. C'est la case à cocher. Un audit complet avec analyse causale des variables de substitution, tests de sous-groupes intersectionnels, évaluation de l'équité contrefactuelle et recommandations d'atténuation documentées prend de 6 à 10 semaines selon la complexité du système, la disponibilité des données et le nombre de cadres réglementaires applicables. La vraie question de coût que la plupart des acheteurs devraient poser est ce que coûte la non-conformité. Les pénalités de la LL144 de New York s'élèvent de 500 à 1 500 dollars par violation et par jour. La Colorado SB 205 autorise jusqu'à 20 000 dollars par violation. Le Massachusetts vient de régler une affaire de discrimination dans le crédit par IA pour 2,5 millions de dollars. L'investissement dans l'audit représente une fraction d'une seule action coercitive.
Quelle métrique d'équité devrions-nous utiliser si nous ne pouvons pas toutes les satisfaire simultanément ?
Vous ne pouvez pas toutes les satisfaire. Chouldechova (2017) a prouvé que lorsque les taux de base diffèrent d'un groupe à l'autre, aucun classifieur imparfait ne peut atteindre simultanément la calibration et l'égalité des taux de faux positifs et de faux négatifs. Kleinberg, Mullainathan et Raghavan ont prouvé une impossibilité plus générale. Le choix de la métrique dépend du domaine et du cadre juridique. En matière de crédit, la calibration importe car les scores de risque doivent refléter les probabilités réelles de défaut pour que la tarification fonctionne. L'égalité des chances (equalized odds) importe car des taux d'erreur disparates créent une responsabilité pour impact disparate au titre de l'ECOA. En matière de recrutement, la parité des taux de sélection (parité démographique) est le point de départ car la règle des quatre cinquièmes l'opérationnalise, mais l'égalité des chances et la parité prédictive importent pour la validation des tests au titre des Uniform Guidelines. Nous passons en revue les compromis d'impossibilité pour le système spécifique et le contexte réglementaire de chaque client avant que quiconque ne commence à optimiser.
Nous avons retiré la race de notre modèle. Pourquoi montre-t-il encore un impact disparate ?
Parce que d'autres caractéristiques portent la même information. Le code postal encode la ségrégation résidentielle. L'année d'obtention du diplôme et l'ancienneté de la pile technologique reconstituent l'âge. Les interruptions d'emploi sont corrélées au handicap et aux responsabilités familiales. L'établissement scolaire est corrélé à la race et au statut socio-économique. La distance de trajet domicile-travail est corrélée à la composition du quartier. Retirer l'étiquette ne retire pas le signal. Nous utilisons l'analyse par graphe causal pour retracer chaque chemin des attributs protégés à travers l'espace des caractéristiques jusqu'à la sortie du modèle. Certains de ces chemins passent par des facteurs commerciaux légitimes (l'historique de crédit prédit réellement le remboursement). D'autres passent par des variables de substitution qui encodent une discrimination historique. L'audit identifie quels chemins sont lesquels, et l'atténuation cible les chemins de substitution sans perturber les chemins légitimes.
Pouvons-nous être poursuivis pour discrimination par l'IA lorsque nous utilisons l'outil de recrutement d'un fournisseur ?
Oui. Les employeurs restent responsables des résultats discriminatoires issus des outils d'IA de fournisseurs au titre du Title VII, du FCRA et des lois d'emploi des États. Dans l'affaire Mobley v. Workday (mai 2025), le tribunal a jugé qu'un fournisseur d'IA peut être directement responsable de discrimination à l'emploi en tant qu'agent de l'employeur. Dans l'action collective Eightfold AI (janvier 2026), la plateforme comme les employeurs qui l'utilisent sont exposés. La Colorado SB 205 impose des obligations distinctes aux déployeurs, peu importe qui a construit le système. Utiliser l'outil d'un fournisseur ne déplace pas le risque juridique. Cela déplace la complexité technique, car vous devez auditer un système que vous n'avez pas construit. Nous auditons les outils d'IA de fournisseurs à l'aide de méthodes de test fondées sur les sorties qui n'exigent pas l'accès au code source ou aux internes du modèle du fournisseur.
Quelle est la différence entre un audit de conformité LL144 et un audit d'équité complet ?
La LL144 exige un audit de biais indépendant examinant les taux de sélection par catégories de race/origine ethnique et de sexe/genre, avec des résultats publiés publiquement. C'est un plancher, pas un plafond. L'audit de décembre 2025 du Contrôleur de l'État de New York a constaté que l'application par le DCWP était superficielle : 75 % des plaintes étaient mal orientées, et les auditeurs ont identifié 17 violations potentielles là où le DCWP n'en avait trouvé qu'une seule. Un audit complet va plus loin : analyse intersectionnelle à travers des attributs protégés combinés, détection causale des variables de substitution pour les caractéristiques qui encodent indirectement des informations protégées, tests d'équité contrefactuelle, analyse de sensibilité quantifiant la robustesse des affirmations d'équité face à des facteurs de confusion non mesurés, et analyse documentée du compromis exactitude-équité avec les implications du théorème d'impossibilité explicitées. La version complète est celle qui résiste à l'examen lorsque l'application devient sérieuse.
Comment tester les biais lorsque nous n'avons pas accès aux données d'attributs protégés ?
C'est l'un des problèmes pratiques les plus difficiles de l'audit d'équité. Toutes les principales boîtes à outils (AIF360, Fairlearn) exigent les attributs protégés en entrée. En pratique, de nombreuses organisations ne peuvent pas collecter de données individuelles sur la race, le genre ou le handicap, en particulier en dehors des contextes d'emploi. Les options incluent le Bayesian Improved Surname Geocoding (BISG) pour inférer la race à partir du nom et de la géographie (utilisé par le CFPB pour l'analyse d'équité en matière de crédit), les méthodes d'inférence écologique qui estiment les disparités au niveau des groupes à partir de données agrégées, et les tests par perturbation des sorties où l'on construit des entrées contrefactuelles ne faisant varier que les variables de substitution des attributs protégés et où l'on mesure les changements de décision. Chaque méthode a ses limites. Le BISG introduit son propre biais pour les personnes multiraciales et certains groupes ethniques. Nous sélectionnons et validons la méthode de substitution par rapport à la population spécifique et au contexte réglementaire, en documentant l'incertitude introduite par l'imputation plutôt qu'en traitant les attributs estimés comme une vérité de terrain.
Avons-nous besoin d'une surveillance continue des biais, ou un audit annuel suffit-il ?
Un audit annuel est ce que les régulateurs exigent au minimum. Ce n'est pas ce qui vous protège. Les modèles qui interagissent avec des boucles de rétroaction développent des biais entre deux audits : un outil de recrutement qui rejette des candidats issus de certains milieux s'entraîne sur ses propres exclusions, renforçant le schéma. Les modèles de crédit où les schémas d'approbation influencent les données des bureaux de crédit créent des prophéties autoréalisatrices. Les distributions d'entrée évoluent à mesure que la démographie des clients ou les viviers de candidats changent. Nous mettons en place une surveillance continue avec des tests d'hypothèses séquentiels qui détectent la dégradation émergente de l'équité en temps réel, déclenchant des alertes lorsque les métriques franchissent des seuils. La surveillance suit séparément les performances agrégées et celles des sous-groupes intersectionnels. La différence pratique : un audit annuel vous apprend que le modèle a été biaisé pendant des mois. La surveillance continue vous le dit en quelques semaines.
Comment auditer les LLM et l'IA générative pour les biais lorsque les métriques d'équité traditionnelles ne s'appliquent pas ?
Les métriques d'équité traditionnelles (égalité des chances, parité démographique) ont été conçues pour des classifieurs binaires avec des groupes protégés définis et des résultats mesurables. L'IA générative produit du texte, des images ou des recommandations ouvertes où le biais se manifeste sous forme d'associations stéréotypées, de qualité différenciée ou de schémas de refus selon les contextes démographiques. Nous évaluons le biais des LLM par un sondage fondé sur des scénarios (variation systématique des signaux démographiques dans les invites et mesure des différences de sortie), des suites de référence (BBQ, StereoSet, CrowS-Pairs) adaptées au contexte de déploiement spécifique, et un audit des sorties où les sorties de production sont échantillonnées et évaluées à la recherche de schémas de traitement disparate. Le défi est que les LLM montrent des erreurs alignées sur les stéréotypes jusqu'à 77 % du temps dans les contextes ambigus (recherche sur le benchmark BBQ), et que ces biais sont plus difficiles à atténuer que le biais des classifieurs car ils sont répartis sur des milliards de paramètres plutôt que concentrés dans quelques caractéristiques.
Quelles sont les pénalités réelles pour un échec à un audit de biais ou pour ne pas en avoir mené un ?
Les pénalités s'intensifient rapidement d'une juridiction à l'autre. NYC LL144 : de 500 à 1 500 dollars par violation et par jour, multipliés par chaque candidat affecté. Colorado SB 205 (en vigueur en juin 2026) : jusqu'à 20 000 dollars par violation au titre du Consumer Protection Act. Règlement européen sur l'IA (application en août 2026) : jusqu'à 35 millions d'euros ou 7 % du chiffre d'affaires mondial pour les pratiques interdites, 15 millions d'euros ou 3 % pour la non-conformité à haut risque. Au-delà des pénalités légales, l'exposition au contentieux est réelle : le procureur général du Massachusetts a obtenu 2,5 millions de dollars d'un seul règlement pour discrimination dans le crédit par IA en juillet 2025. SafeRent a payé 2,275 millions de dollars pour la discrimination d'un algorithme de sélection de locataires. Mobley v. Workday est la première action collective certifiée à l'échelle nationale portant sur les biais de l'IA. Le coût d'un audit complet est une erreur d'arrondi comparé à l'un quelconque de ces résultats.
Quelles exigences réglementaires s'appliquent aux biais de l'IA dans la souscription d'assurance ?
La Colorado SB 21-169 est la plus prescriptive. Elle interdit aux assureurs d'utiliser des données de consommateurs externes, des algorithmes et des modèles prédictifs de manière à produire des résultats injustement discriminatoires fondés sur des caractéristiques protégées. Les assureurs auto et santé doivent soumettre des rapports de conformité annuels d'ici le 1er juillet 2026. La Division des assurances du Colorado a proposé des tests quantitatifs comparant les modèles avec et sans variables de race estimées afin d'identifier les caractéristiques discriminatoires. Par ailleurs, 24 États ont adopté le NAIC Model Bulletin exigeant que les assureurs intègrent la transparence et l'équité dans leurs programmes de gouvernance de l'IA. La question de l'équité actuarielle est distincte de l'équité statistique : une différenciation du risque justifiée sur le plan actuariel peut produire des disparités statistiques légalement permises au titre du droit des assurances mais qui seraient discriminatoires au titre du droit de l'emploi ou du crédit. Nous aidons les équipes d'assurance à naviguer cette distinction avec des cadres de test conçus pour le contexte réglementaire propre à l'assurance.
Développez votre IA en toute confiance.
Collaborez avec une équipe forte d'une solide expérience dans la conception de la prochaine génération d'IA d'entreprise. Nous vous aidons à concevoir, développer et déployer une stratégie d'IA digne de confiance.
Veriprajna société de conseil en Deep Tech est spécialisée dans la conception de systèmes d'IA critiques pour la sûreté destinés aux secteurs de la santé, de la finance et de la réglementation. Nos architectures sont validées au regard de protocoles établis et accompagnées d'une documentation de conformité complète.