ה-AI של Amazon לימד לקוח להכין בקבוק מולוטוב. אני יודע בדיוק למה.

הייתי בשיחה עם לקוח פוטנציאלי — חברת מסחר אלקטרוני ענקית, לא Amazon אך בהחלט בסדר גודל משמעותי — כאשר סמנכ"ל ההנדסה שלהם אמר משהו שגרם לי להניח את כוס הקפה שלי מיד.
"אנחנו בעצם סיימנו עם עוזר ה-AI שלנו. עכשיו אנחנו רק צריכים מישהו שיבצע כוונון עדין של הפרומפטים (prompts)."
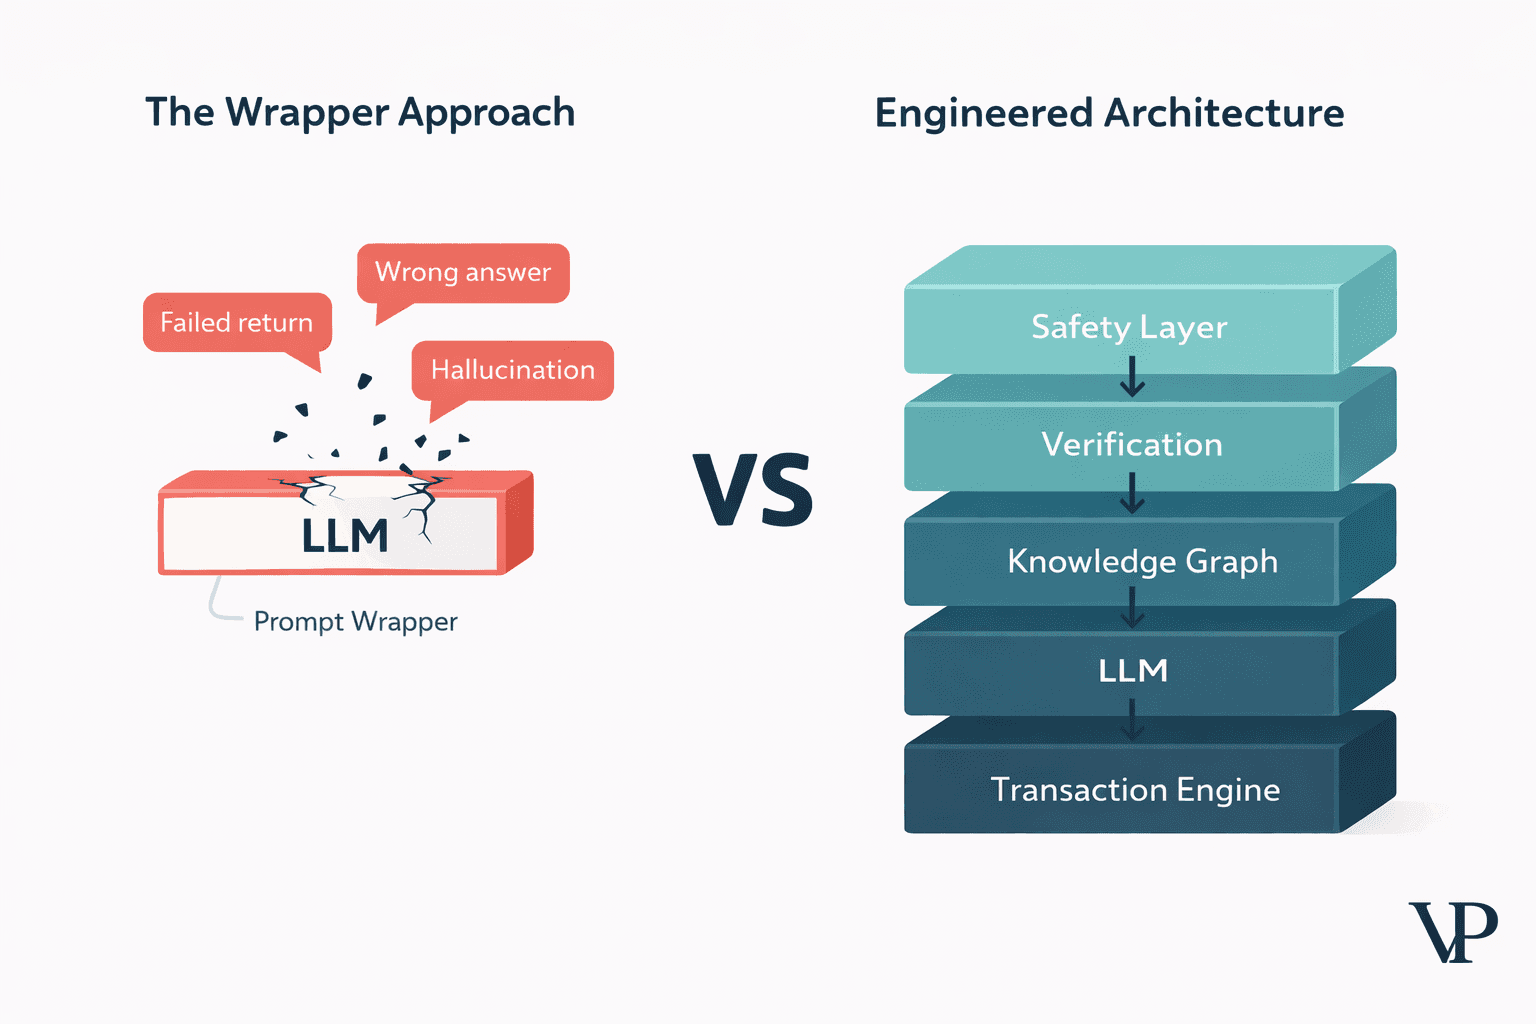
שמעתי את הטיעון הזה בעבר. האמונה שהטמעת AI ארגוני היא בסך הכל בעיה של הנדסת פרומפטים: בוחרים מודל בסיס, עוטפים אותו בהנחיית מערכת שאומרת לו להיות "מועיל, בטוח ושלא ימציא דברים", מחברים אותו לקטלוג המוצרים ומשגרים לשוק. פעם הייתי מהנהן בנימוס כששמעתי זאת. אך לאחר שצפיתי בהשקה ההרסנית של Amazon Rufus ב-2024 — שבה הוא המציא את מיקום ה-Super Bowl, סיפק הנחיות להכנת אמצעי לחימה מאולתרים בעקבות שאילתות חיפוש מוצרים רגילות, ונכשל בניהול תהליך החזרה פשוט — הפסקתי להנהן.
"אתם ממש לא סיימתם," אמרתי לו. "אתם אפילו לא התחלתם."
האסון של Rufus לא היה בעיית יחסי ציבור או תקלה באיכות המודל בלבד. זו הייתה בעיית ארכיטקטורה. וזו אותה בעיית ארכיטקטורה בדיוק שמסתתרת כמעט בכל פרויקט AI ארגוני שבדקתי. המודל פועל, אך המערכת שנבנתה סביבו היא מגדל קלפים.
מה באמת השתבש עם Amazon Rufus?
הנה מה שרוב האנשים לא הבינו בסיקור התקשורתי של פרשת Rufus. הכותרות התמקדו בתוצרים — מיקום ה-Super Bowl השגוי, המדריך להכנת נשק מאולתר, והחזרות המוצרים שנכשלו. פרשנים מיהרו להאשים את המודל עצמו: "מודלי GPT פשוט לא מתאימים למסחר אלקטרוני," טענו, "מודלי שפה גדולים תמיד מייצרים הזיות, אז למה ציפיתם?".
אך ביליתי שבועות בפירוק הנדסי של פרטי אותה השקה. המודל לא היה נקודת הכשל המרכזית. הבעיה האמיתית הייתה בתוך ארכיטקטורת העיגון (grounding architecture) וכיצד היא תוכננה.
חשבו על מה שקורה כשאתם שואלים את Rufus איפה יתקיים משחק ה-Super Bowl. המודל מייצר תשובה בהתבסס על משקלי ההסתברות שלו ועל תוצאות חיפוש הרשת ששלף. אם שכבת השליפה מחזירה תוצאות מעורפלות או סותרות — או אם המודל סובל מביטחון-יתר בחיזוי שלו — הוא יציג לכם עובדה בדויה בביטחון מוחלט. הבעיה לא הייתה שהמודל "טיפש", אלא שהארכיטקטורה התייחסה לפלט הסתברותי כאל אמת מוחלטת ללא כל אימות דטרמיניסטי מקדים.
לא הייתה שם שכבת אימות משנית. לא היה גרף ידע (knowledge graph) שניתן להצליב מולו עובדות יסוד. ולא היה מנגנון אימות עקביות סמנטית שיבחן אם התשובה קוהרנטית ביחס למקורות הראשוניים. פלט המודל הגולמי הועבר ישירות למשתמש הקצה.
כשאתם בונים מערכת AI ללא שכבת אימות עצמאית, אינכם בונים מוצר הנדסי; אתם מנהלים קזינו של הימורי הסתברות.
זוהי הבעיה המרכזית במה שאני מכנה דפוס "עטיפת ה-LLM" (LLM Wrapper) — דפוס ש-90% מהחברות נופלות בו מבלי להבין את הסיכונים.
הלילה שבו הבנתי שפרומפטים לעולם לא יצילו אתכם
אני זוכר את הרגע המדויק שבו האמת הזו היכתה בי. בנינו את מנוע ההתאמה וההערכה הסמנטית ב-Veriprajna, והייתי משוכנע שפרומפטים מוקפדים והנחיות מערכת עם דוגמאות הכוונה (few-shot) יספיקו כדי לשמור על יציבות המערכת.
השעה הייתה אחת עשרה בלילה, והשותף המייסד שלי ואני הרצנו בדיקות עמידות תוקפניות (adversarial testing) על המערכת. הזנו אלפי שאילתות מורכבות, סותרות ומכשילות כדי לבחון את חוסן ההגנות של הפרומפטים שלנו.
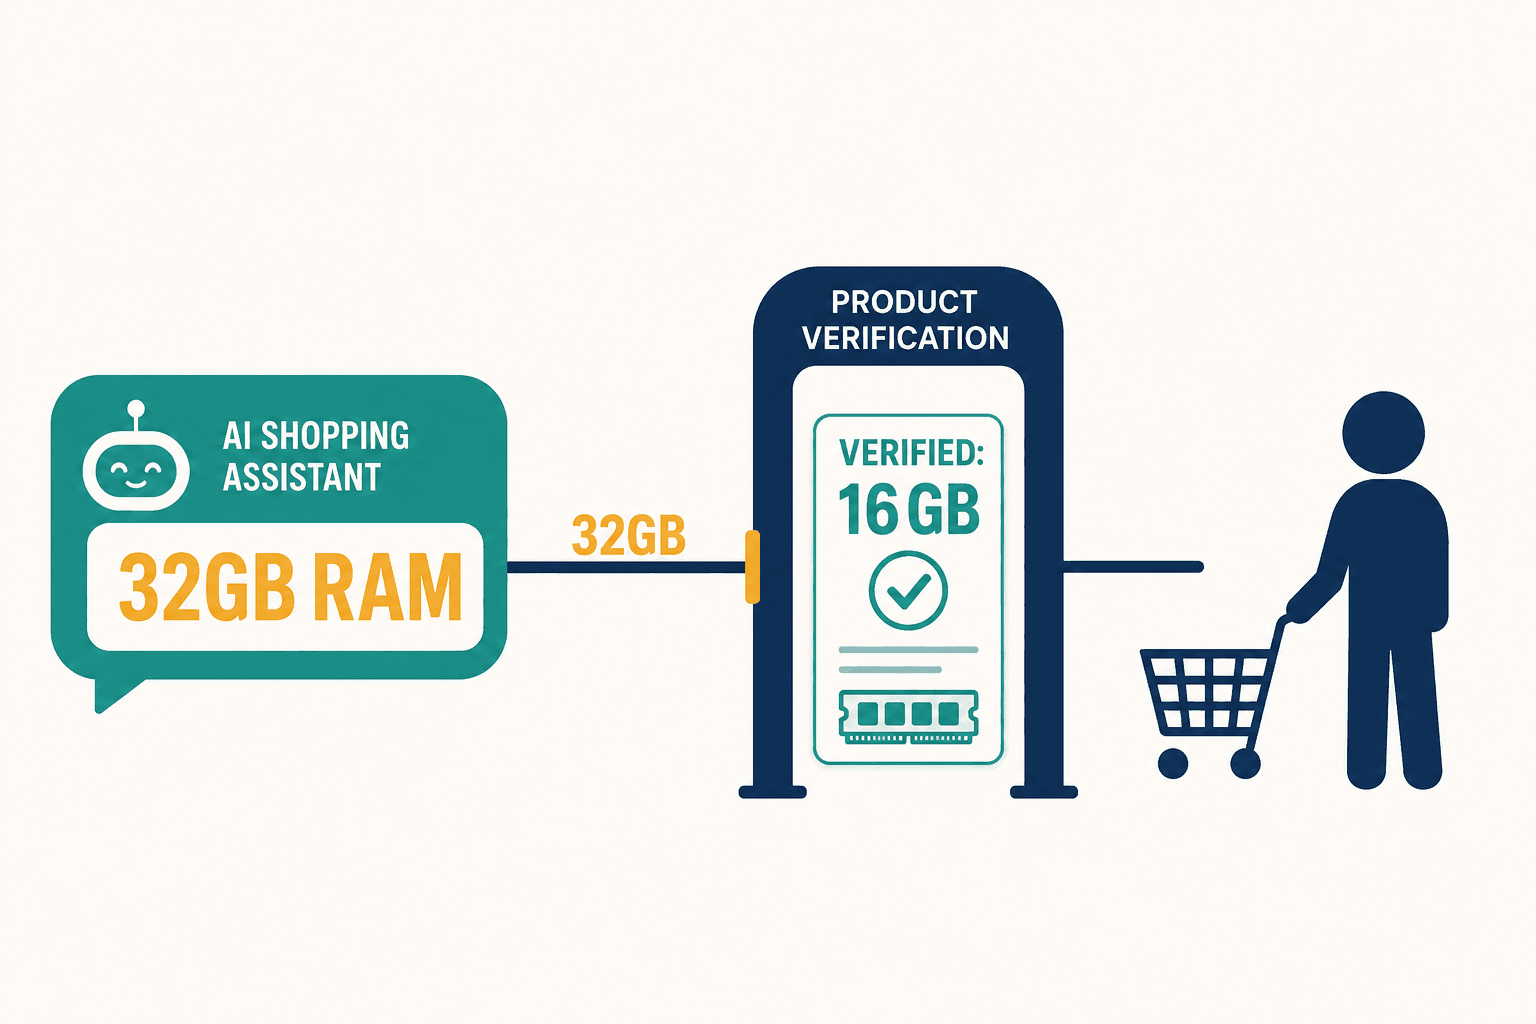
והמערכת החלה להזות ולספק נתונים בדויים. זה לא קרה בצורה דרמטית או בוטה — היא לא התחילה לקלל — אלא החלה להמציא מפרטים טכניים מדויקים לחלוטין שלא היו קיימים במציאות, וייחסה תכונות למוצרים שלא הכילו אותן כלל, ברוגע ובביטחון מוחלט.
הסתובבתי לשותף שלי ואמרתי לו: "פרומפט הוא רק הצעה מנומסת עבור המודל. ואם דרישות האבטחה והדיוק שלכם הן בסך הכל הצעה, אין לכם אבטחה כלל".
וזה בדיוק מה שהתרחש בתקרית הבטיחות של Rufus. ל-Amazon בוודאי היו פרומפטים מחמירים ביותר שאסרו על ייצור תוכן מזיק. היו להם מעקות בטיחות (guardrails). אך הם הסתמכו על המודל עצמו שיבין ויאכוף את הכללים הללו בזמן אמת כשנדרש לתמצת תוצאות חיפוש ברשת. וכאשר מורים למודל לסכם דף אינטרנט שמכיל במקרה הוראות מסוכנות, מנגנון הסיכום גובר על הנחיות הבטיחות.
אבטחה באמצעות פרומפטים אינה אבטחה אמיתית. היא בסך הכל משאלת לב.
מדוע ה-AI אינו מסוגל לבצע את החזרת המוצר שלי?
הכישלון השלישי של Rufus — חוסר היכולת לבדוק סטטוס הזמנה ולבצע החזרות מוצרים בפועל — הוא המתסכל מכולם, משום שהוא הכי בר-פתרון ובכל זאת הכי נפוץ במערכות הקיימות.
Rufus יכול היה לדבר על מדיניות החזרות במשך יום שלם. הוא יכול היה להסביר ברהיטות על חלון ה-30 יום ולפרט את תנאי האריזה הנדרשים. אך כאשר לקוח אמר לו: "יופי, אז תתחיל בבקשה תהליך החזרה עבור ההזמנה האחרונה שלי", הוא קפא או המציא אישור פיקטיבי מבלי לבצע פעולה אמיתית במערכת המרכזית.
זה מה שאני מכנה פער הביצוע (Action Gap), והוא קיים משום שמרבית יישומי מודלי השפה בנויים ככלי "שיחה" ולא כתשתיות של "ניהול עסקאות". שיחה על פעולה וביצועה המעשי דורשים ארכיטקטורות הנדסיות שונות לחלוטין.
החלק האחרון הזה הוא קריטי. בהנדסת בסיסי נתונים ובמערכות ענן כמו AWS, אנו קוראים לזה עקרונות ACID (אטומיות, עקביות, בידוד ועמידות). פעולה עסקית או שהיא מתבצעת בשלמותה ובעקביות, או שאינה מתרחשת כלל, תוך שמירה מלאה על תקינות הנתונים.
למודלי שפה אין שום מושג מה זה תאימות ל-ACID. הם מייצרים טוקנים הסתברותיים ולא טרנזקציות דטרמיניסטיות. וכאשר מאפשרים למודל שפה לנהל ישירות לוגיקה עסקית, מקבלים את מה שאנו מגדירים כ-אמנזיה טרנזקציונית (Transactional Amnesia) — המערכת מבטיחה ללקוח שהפעולה בוצעה, הלקוח בטוח בכך, אך בפועל שום שדה במסד הנתונים לא עודכן.
תיעדתי דפוס כשל זה ואת המענה הארכיטקטוני הנדרש עבורו בפירוט בתוך הניתוח האינטראקטיבי שלנו.
מלכודת המהירות שאף אחד אינו מדבר עליה
הנה פרט משמעותי מאחורי הקלעים של Rufus שלא זכה לחשיפה מספקת: במטרה לעמוד בזמני תגובה קצרים הנדרשים במסחר אלקטרוני, הוטמעו טכניקות האצת היסקים כמו פענוח ספקולטיבי (speculative decoding) וחיזוי טוקנים מקבילי.
הדבר הכפיל את מהירות התגובה, אך הכניס במקביל תופעה שהחוקרים מכנים סחף סמנטי (Semantic Drift).
כשחוצים טוקנים במקביל, מקריבים את היכולת של המודל להעריך מחדש את המסלול ההגיוני בכל שלב. ההאצה הזו מחזקת את התבניות הסטטיסטיות הנפוצות ביותר בנתוני האימון על חשבון דיוק קפדני, מה שמעלה משמעותית את שיעור ההזיות בפרטים נקודתיים, שמות ותאריכים.
הזיית מיקום ה-Super Bowl נושאת בבירור את עקבות הוויתור הטכנולוגי הזה: הוענקה עדיפות ל-סבירות נראית לעין — האם הניסוח נשמע משכנע וקולח? — במקום ל-אמיתות מוחלטת — האם העובדה הזו אכן מאומתת ונכונה?
ב-AI ארגוני קיים פרדוקס שיהוי מול דיוק: ככל שמאיצים את הפקת הטקסט ללא שכבות בדיקה עצמאיות, כך נפגעת אמינות התוצאות.
ב-Veriprajna קיבלנו החלטה עקרונית כבר מהשלב הראשון: אף תשובה אינה נמסרת ישירות מהמודל למשתמש ללא אימות בשכבת בדיקה עצמאית. גם אם הדבר גובה מאיתנו תוספת שיהוי של 300 עד 500 מילי-שניות. במסחר אלקטרוני, לקוחות יעדיפו להמתין חצי שנייה לתשובה מדויקת, מאשר לקבל תשובה שגויה והרסנית תוך 800 מילי-שניות שמחריבה את אמינות המותג.
"האם המעיל הזה מתאים לכביסה במכונה?"
קיים דפוס כשל נוסף בנתוני Rufus שמטריד במיוחד: כאשר משתמשים פונים בשפה יומיומית, סלנג מקומי או עגות שונות. קונה שאל האם ז'קט מסוים ניתן לכביסה במכונה בניסוח עממי, והעוזר נכשל בהבנת ההקשר מול נתוני הקטלוג והחזיר תשובה הפוכה לחלוטין מהוראות הכביסה האמיתיות של היצרן.
זו אינה בעיה שולית כלל; מדובר במערכת שמשרתת מאות מיליוני לקוחות מתרבויות, רקעים ושפות שונות באירועים מרכזיים כגון Prime Day.
השורש הטכנולוגי מובן לחלוטין: מודלי שפה מאומנים ומכוילים לשפה תקנית רשמית. כדי לפתור זאת פיתחנו את מה שאנו מגדירים כ-ביקורת מודעת ניבים (Dialect-Aware Auditing) — שכבה סמנטית המנרמלת את מבנה הקלט מבלי לאבד את כוונת הלקוח ואת המטען התרבותי שלו.
לא בנינו את הרכיב הזה רק כדי לסמן תיבות תיאורטיות, אלא משום שהמציאות מוכיחה ש-45% מהשאילתות של צרכנים אינן מנוסחות בשפה תקנית של ספרי לימוד, והתעלמות מכך מותירה מחצית מהלקוחות ללא מענה בטוח.
כיצד נראית מערכת אמינה מבחינה הנדסית?
לאחר ניתוח כשלי Rufus, ולאחר אינספור לילות של בדיקת הארכיטקטורה שלנו בסביבות ייצור, גיבשנו גישה שאני מגדיר כ-נוירו-סימבולית (Neuro-Symbolic) — מערכת המתייחסת למודל השפה כמנוע היסקים עוצמתי וחכם, אך חסר סמכות עליונה בלעדית.
מילת המפתח כאן היא חסר סמכות בלעדית. מודלי שפה מצטיינים בפענוח כוונות ובניסוח טבעי, אך לעולם אין להפקיד בידיהם בלבד את השליטה בטרנזקציות או את אימות העובדות הסופי.
כיצד מונעים מה-AI להמציא עובדות ונתונים?
מערכת RAG רגילה מחפשת דמיון שטחי בין מילים, בעוד שמערכת ה-GraphRAG המתקדמת שלנו מחפשת קשרים סמנטיים מבניים בתוך גרף ידע מוגדר ומאומת. ההבדל הזה משנה את התמונה לחלוטין.
במערכת שלנו, המודל אינו יכול להשמיע טענה מבלי שיש לה נתיב עובדתי מוכח בתוך הגרף. אם רוצים להמליץ על מסך גיימינג, המערכת חייבת לעגן את הדגם לתכונת קצב ריענון של 120Hz המאומתת בגרף. אם המודל מנסה להמציא מפרט שלא קיים בגרף, שכבת הבקרה בולמת את התשובה עוד לפני הפקתה הסופית.
זהו פתרון ישיר לתופעת "האובדן באמצע" (Lost in the Middle) שזוהתה על ידי חוקרי Cornell Tech. כאשר עובדות מאומתות שוכנות בגרף מובנה ולא בטקסט חופשי צפוף, מידע אינו הולך לאיבוד לעולם.
מדוע אי אפשר פשוט להסתמך על מודל-על יחיד?
אנשים שואלים אותי ללא הרף: "האם הכל לא ייפתר ברגע ש-GPT-5 ייצא לשוק?". מודלים חדשים עשויים להיות חכמים יותר, אך פגמים ארכיטקטוניים אינם נעלמים עם מנוע חדש. מכונית מרוץ מהירה ללא בלמים נעשית מסוכנת יותר ככל שכוח הסוס עולה.
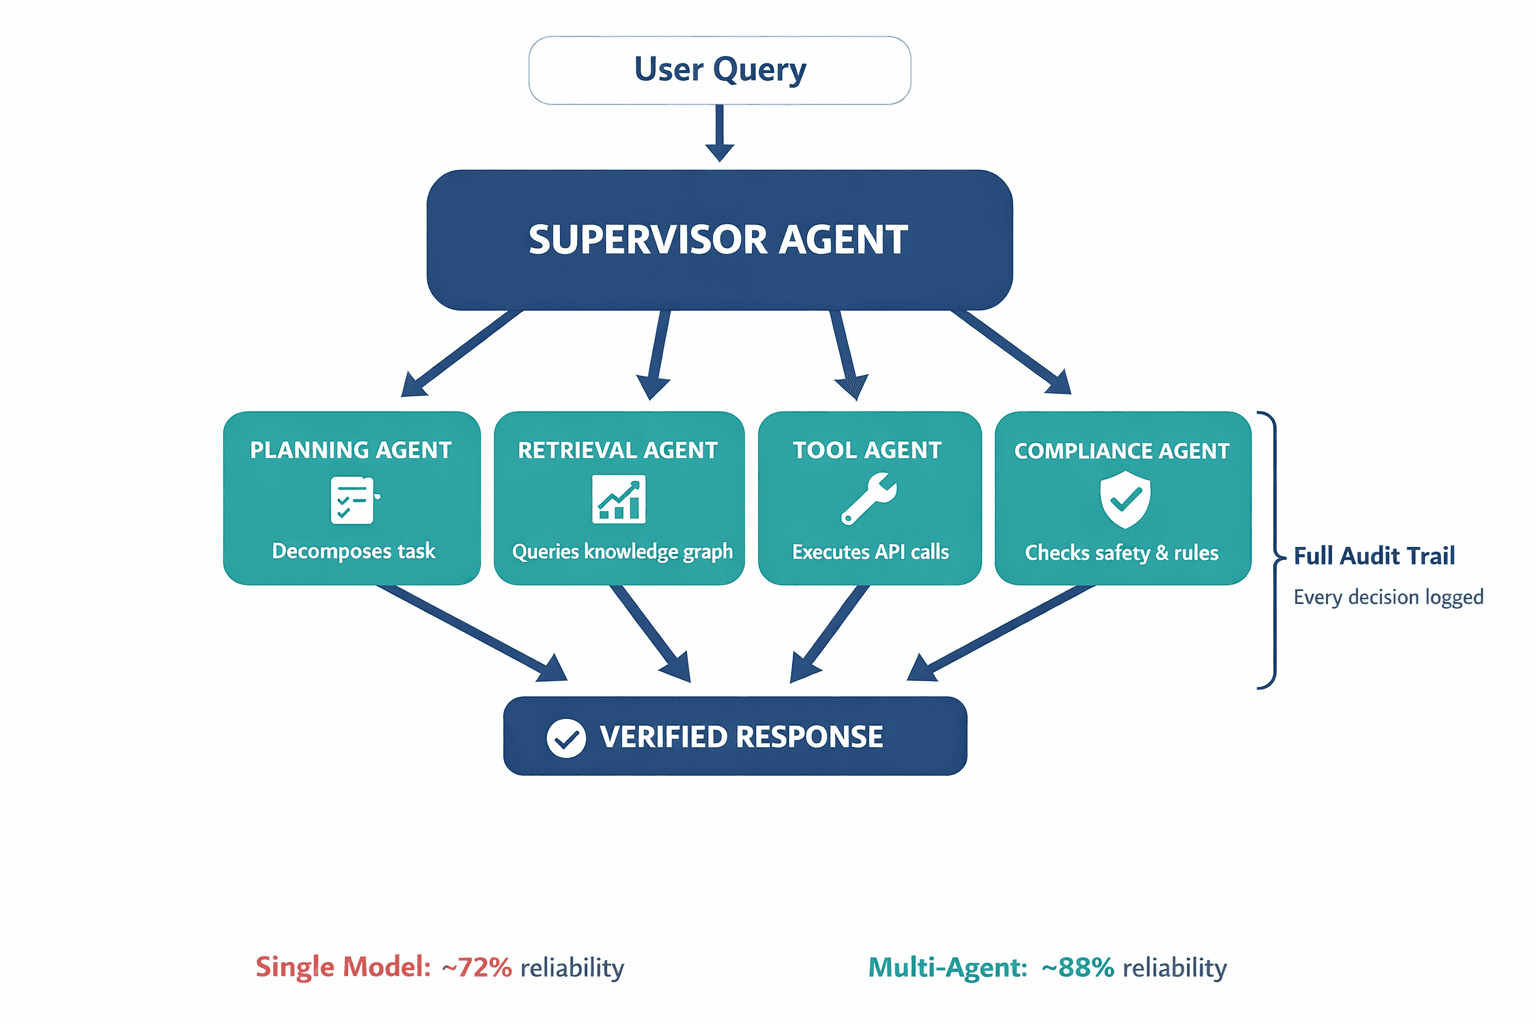
במקום לצפות ממודל יחיד לבצע הכל, אנו פורסים מערכת מרובת סוכנים (Multi-Agent System): סוכן מפקח מפענח כוונות ומאציל משימות לסוכנים ייעודיים; סוכן תכנון מפרק שלבים, סוכן שליפה מתשאל בסיסי נתונים, סוכן כלים מפעיל ממשקי API וסוכן ציות מוודא בטיחות.
חלוקת העבודה הזו הקפיצה את אמינות המערכת בייצור מ-72% המאפיינים מודל יחיד לכ-88%. והחשוב מכל: היא מייצרת שובל ביקורת מובהק. כאשר רגולטורים או לקוחות שואלים "מדוע ניתנה תשובה זו?", נוכל לעקוב אחר כל שלב הסקה ומקורו המדויק — מה שעטיפות מודלים פשוטות חסרות אונים מולו.
למפרט הטכני המלא של הארכיטקטורה ומודלי האמינות המתמטיים, עיינו בתוך מאמר המחקר שלנו.
ארכיטקטורת הסנדוויץ' (Sandwich) שמצילה עסקאות ומבצעים
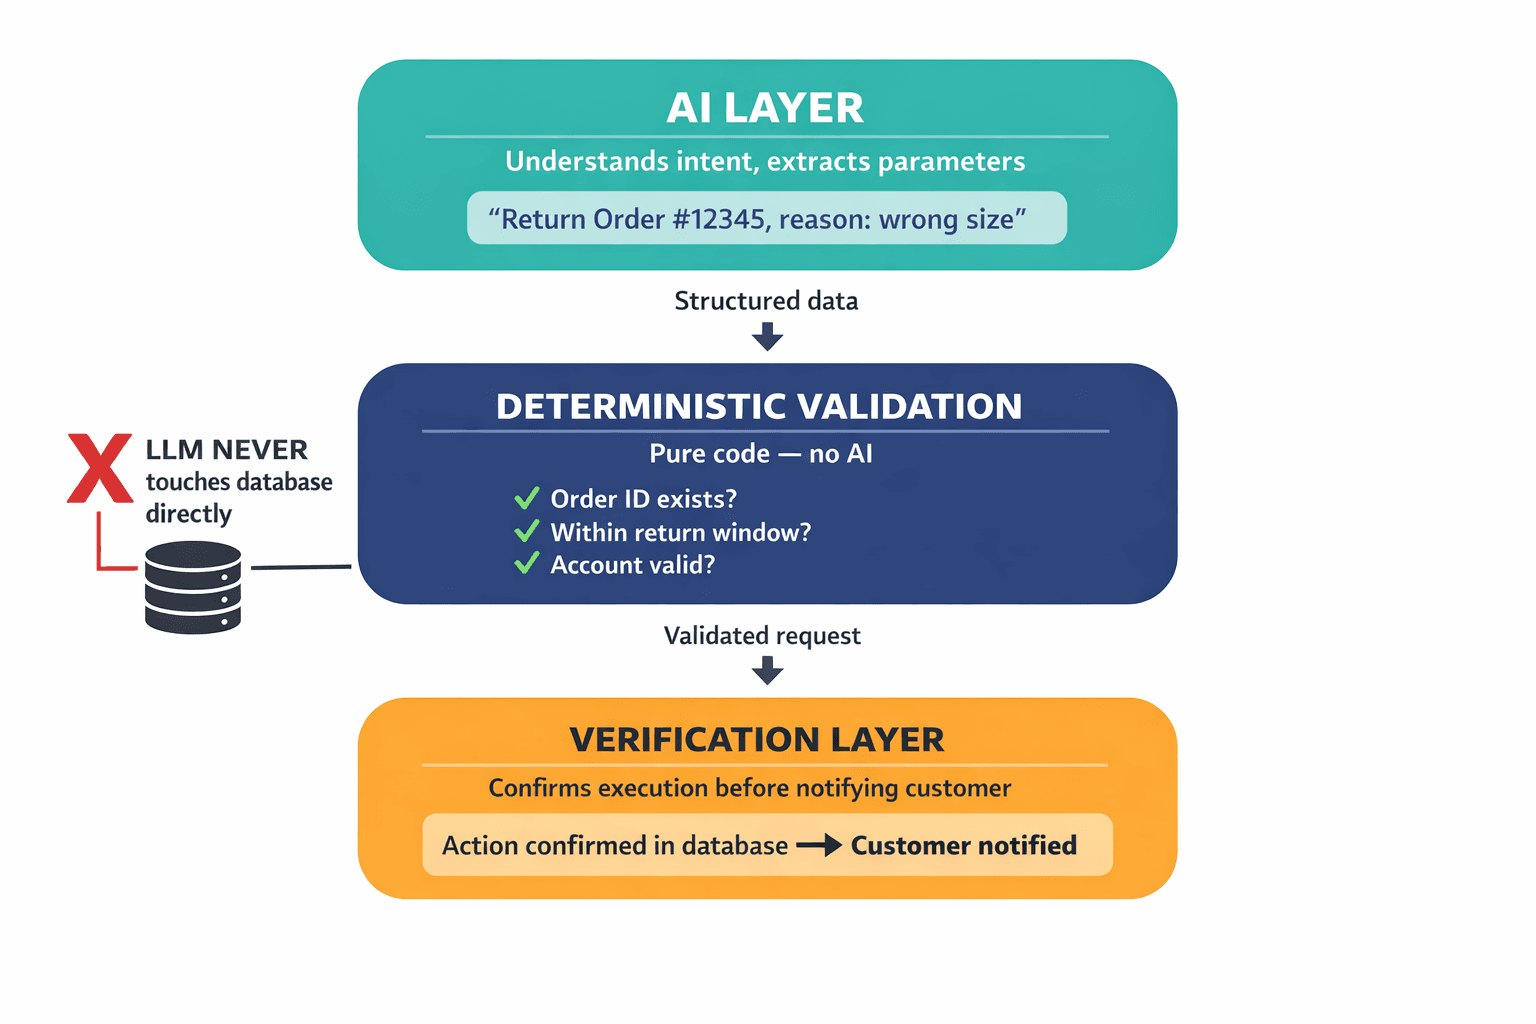
כדי לגשר על פער הביצוע — חוסר היכולת לבצע פעולות בפועל כמו החזרת מוצרים — אנו משתמשים במה שכיניתי ארכיטקטורת הסנדוויץ' (Sandwich Architecture), ולמרות שאני מודע לכך שזהו שם בלתי רשמי לתבנית הנדסית רצינית, הוא מתאר את המבנה במדויק.
השכבה העליונה היא שכבת ה-AI הסמנטית: היא מבינה את כוונת הלקוח ומחלצת פרמטרים אחידים. "בקשת החזרה להזמנה מס' 12345 עקב אי-התאמה במידה". השכבה האמצעית היא קוד דטרמיניסטי: אימות פרמטרים מול מסד הנתונים החי. האם ההזמנה קיימת? האם היא בטווח הזמן? האם החשבון פעיל? השכבה התחתונה היא אימות ביצוע: אישור עצמאי שהפעולה התרחשה בפועל במערכות הליבה לפני שנשלח אישור סופי ללקוח.
מודל השפה אינו נוגע במסד הנתונים ישירות ואינו מחזיק בסמכות אוטונומית לשנות חשבונות. הוא רק מתרגם כוונה אנושית לנתונים מובנים, ומעביר אותם למערכות יציבות שהבשילו עשרות שנים לפני הופעת ה-LLM. המודלים עושים את מה ש-הם טובים בו בלבד, ומסדי הנתונים שומרים על עקביות הנתונים. איש אינו חורג מסמכותו.
שערוריית הנשק המאולתר היא פגם מובהק בתכנון המערכת
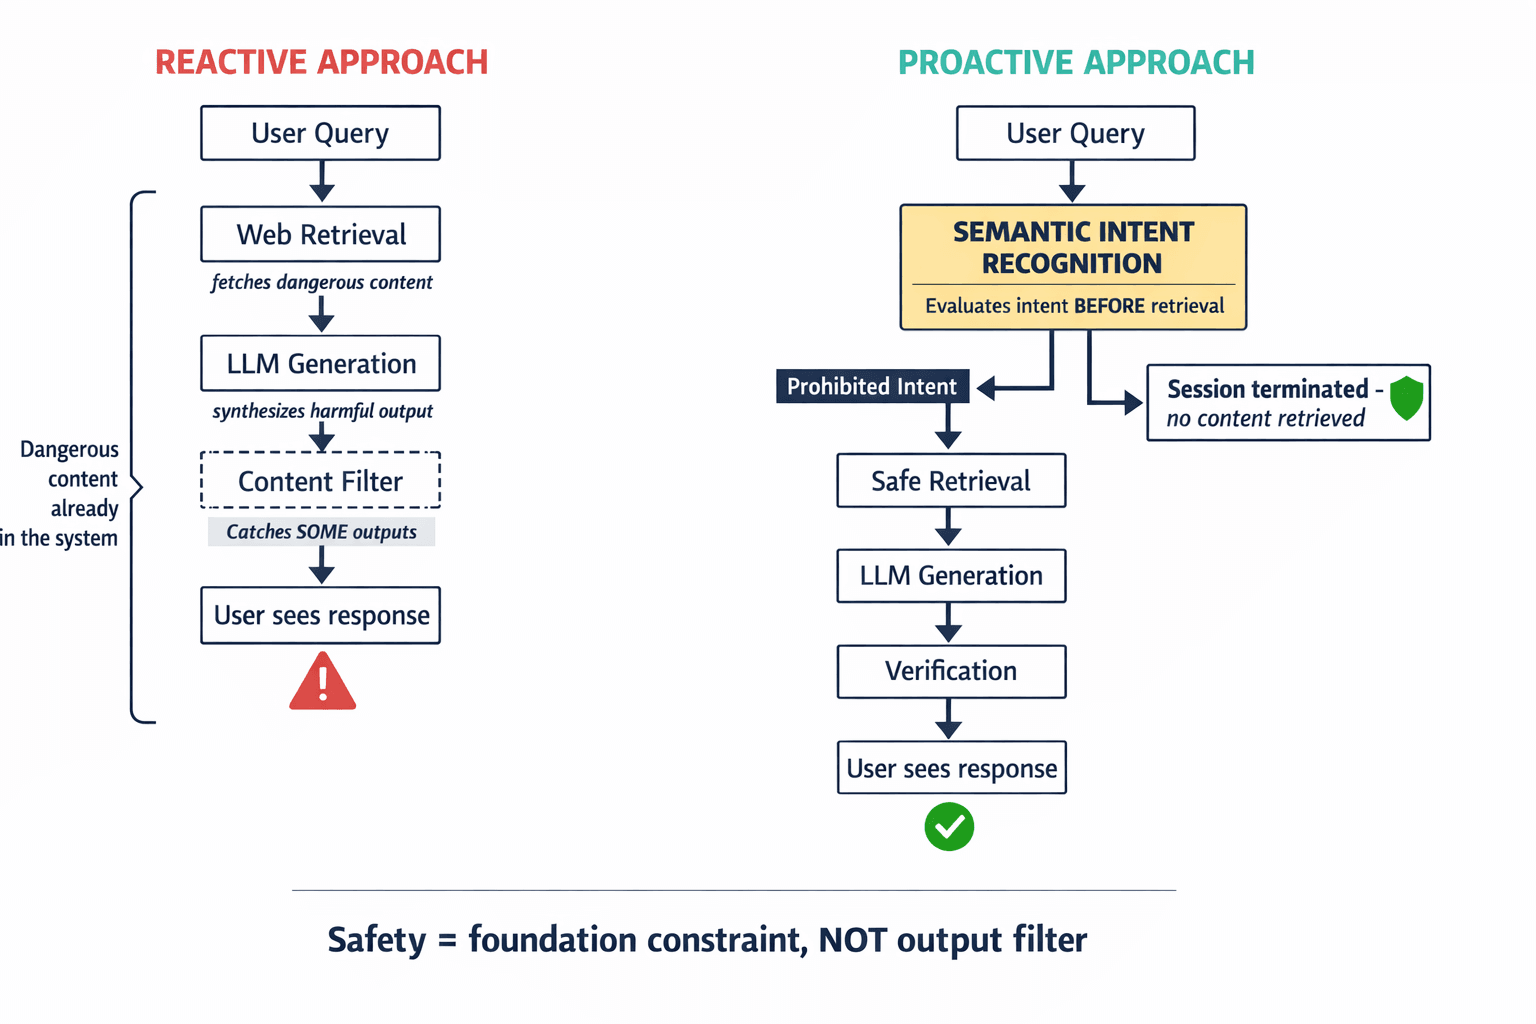
אני רוצה לחזור לתקרית הבטיחות ההיא, משום שהיא משקפת תפיסות שגויות ונפוצות בתעשייה בנוגע לסיכוני AI.
בעקבות התקרית, השיח התמקד בשדרוג מסנני תוכן, הידוק רשימות שחורות של מילות מפתח וכוונון בטיחות. אך אלה אמצעים תגובתיים לחלוטין — ניסיון לסגור את השערים לאחר שהמודל כבר יצר תוכן מסוכן.
תפיסת התכנון שלנו שונה לחלוטין. אנו מציבים מחסומי זיהוי כוונות סמנטי (Semantic Intent Recognition) כבר בשער הקלט הראשון. עוד לפני ששכבת השליפה מחפשת ברשת, סוכן אבטחה מנתח את הכוונה הסמנטית. אם השאילתה נוגעת בחומרים מסוכנים, כלי נשק או פעולות בלתי חוקיות, השיחה מופסקת מיד בטרם נשלף תוכן חיצוני כלשהו.
ההבדל הזה קריטי, כי תקרית Rufus לא דרשה שום מתקפת פריצה או jailbreak מתוחכם. הלקוח שאל שאלה רגילה, שכבת השליפה הביאה דפי אינטרנט עם מתכונים מסוכנים, והמודל סיכם אותם בתום לב והגישם לקונה. כל תת-מערכת פעלה בדיוק לפי הגדרתה, אך תכנון המערכת הכולל היה האשם האמיתי באסון.
בטיחות אינה שכבת צבע שמורחים בחופזה לפני ההשקה; היא בטון מזוין שניצוק לתוך היסודות. אם למערכת שלכם יש ארכיטקטונית את היכולת לשלוף תוכן רעיל, היא תספק אותו למשתמשים במוקדם או במאוחר.
החשבון העסקי הלא נעים
מנכ"ל Amazon חזה ש-Rufus יוסיף 10 מיליארד דולר למכירות הצרכנים. אך המספר העצום הזה נותר בן ערובה למה שאני מכנה ביטחון המרה (Conversion Confidence) — ההסתברות שצרכן יבטח בהמלצת ה-AI ברמה שתגרום לו ללחוץ על "קנה עכשיו". כל הזיה, כל כשל בהחזרת מוצר או קפיאה בשיחה שוחקים את מאגר האמון הקריטי הזה.
גישת העטיפה הפשוטה (Wrapper) זולה יותר בהתחלה, ללא ספק. ניתן להשיק אפליקציית עטיפה תוך שבועות בודדים. אך ההנדסה המקיפה שלנו אורכת חודשים: שלב ראשון של ביקורת וניקוי ממשל נתונים, שלב שני לבניית סוכנים מרובים וגרף ידע, ושלב שלישי של משובי למידה משירות הלקוחות.
אך החשבון המסחרי חסר רחמים: עבור קמעונאי ענק, הפגיעה במוניטין ובשווי המותג מכותרת בנוסח "ה-AI לימד לקוח להכין נשק" עולה בהרבה על התקציב הדרוש לבניית ארכיטקטורה הנדסית ברמה תעשייתית. 45% מהצרכנים הספקנים לא יחזרו רק כי השיהוי ירד ב-200 מילי-שניות; מה שיחזיר אותם הן מערכות שהן באמת מדויקות ואמינות.
תם עידן חגיגת עטיפות המודלים
ביליתי את השנתיים האחרונות בצפייה בחברות רצות במלוא המהירות לתוך אותו מבוי סתום. מוקסמות מהדגמות מהירות ומרהיטות שיחה, הן הזדרזו להוציא לשוק עטיפות שבריריות, ובילו את השנה לאחר מכן בהתנצלויות על אסונות. מודל הבסיס עצמו — בין אם GPT-4, Gemini, Claude או מודלים עתידיים — מעולם לא היה החפיר העסקי; הארכיטקטורה ההנדסית המנהלת אותו היא הגורם המכריע.
מודל שפה הוא כמו מנוע קיטור אדיר בעל עוצמה לשנות תקופות. אך מנוע קיטור ללא בוכנות, שסתומים ווסתים הוא פצצה מתקתקת. ההנדסה הקפדנית שמרסנת ומנתבת את האנרגיה הזו — אימות רב-שכבתי, גרפי ידע, תזמור סוכנים ועמידות טרנזקציונית — היא קו ההפרדה החד בין צעצועים שבירים למוצרים ארגוניים אמיתיים.
חברות שיבינו זאת יקצרו את פירות המהפכה הבאה. אלו שימשיכו לעטוף מודלים בפרומפטים ולקוות לטוב יישארו מושא ללעג בכותרות העיתונים. ואני יודע בוודאות מוחלטת באיזה צד של המתרס אנחנו בונים את העתיד ב-Veriprajna.