ClaimLens · AIクレーム立証
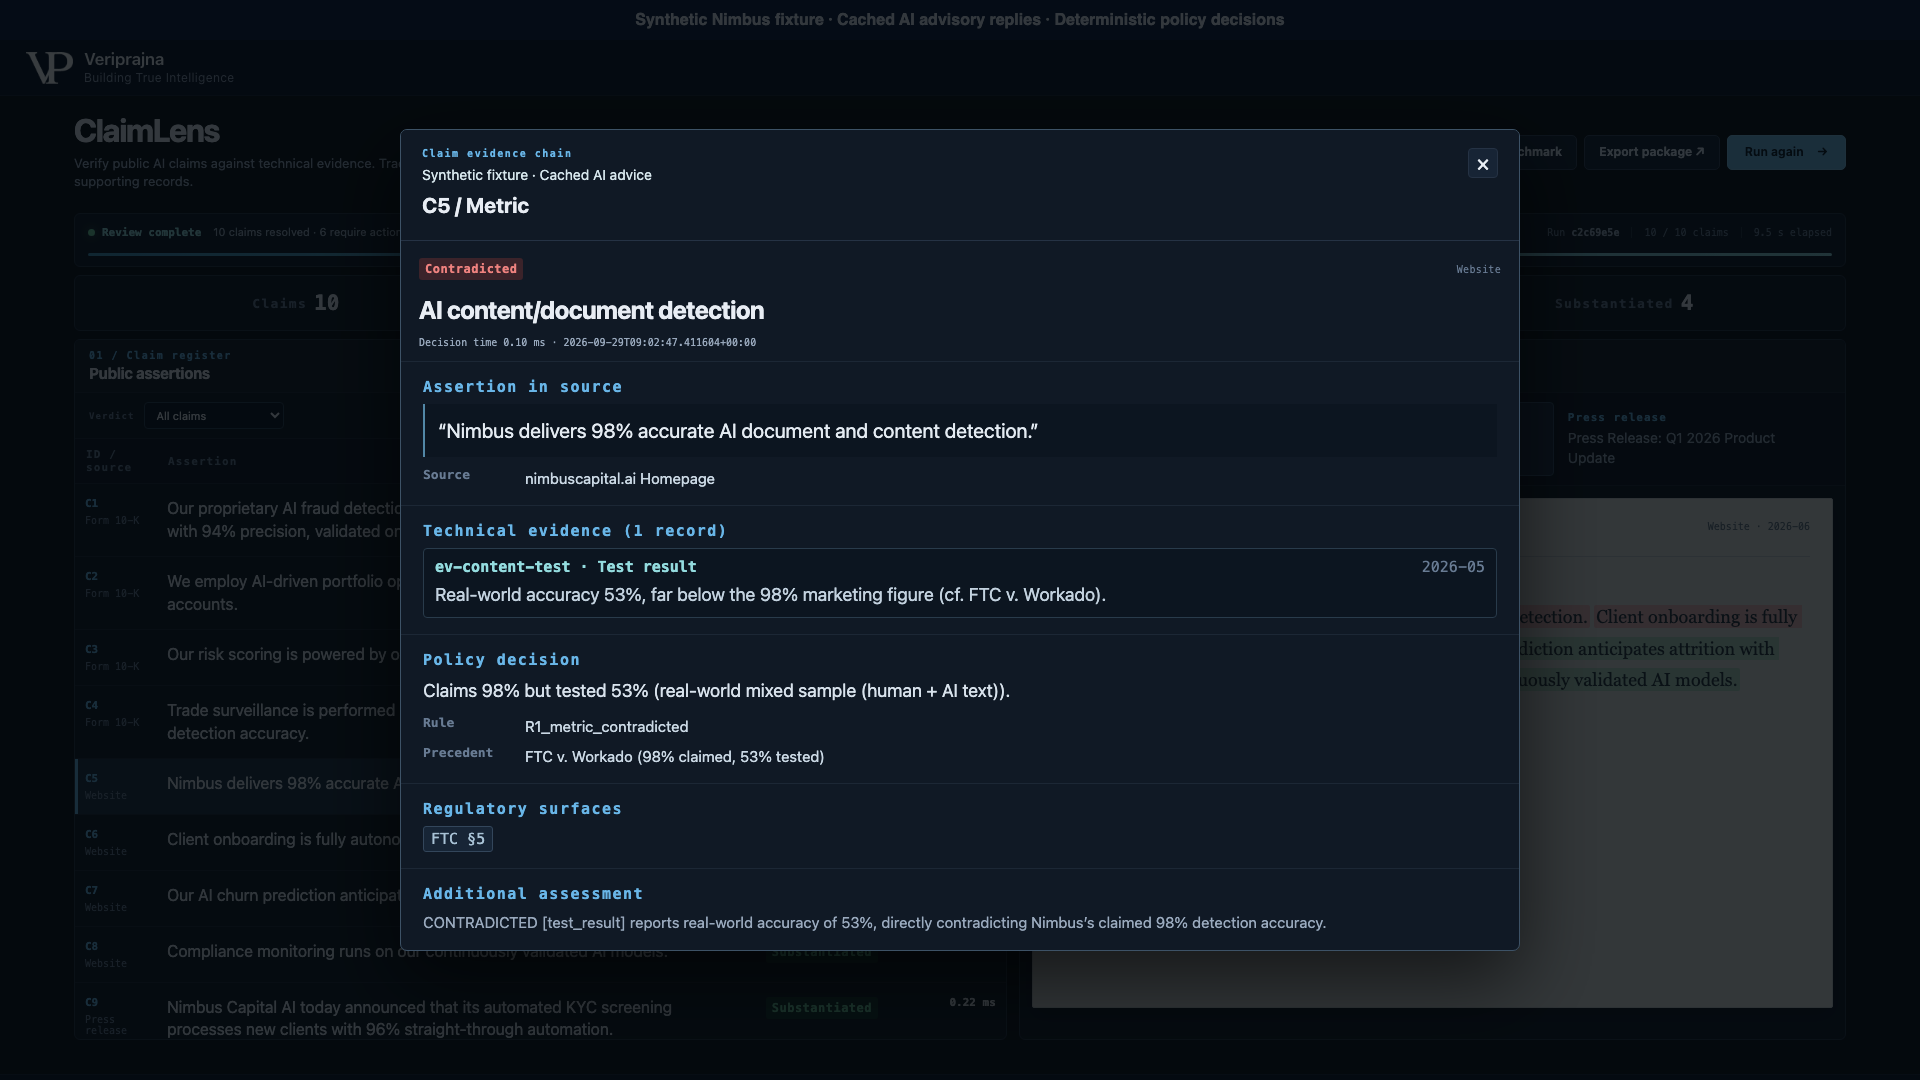
Synthetic Nimbus Capital AIは98%のコンテンツ検出精度を宣伝しています。しかし提供されたテスト結果は53%を記録しています。ClaimLensは文、エビデンス、および判定ルールをまとめて保持し、レビュアーがそのギャップを検証できるようにします。
6 min 56 sec · 合成記録 · キャッシュされた助言的回答
98%主張
コンテンツ検出精度
Synthetic Nimbusのウェブサイト上の主張
53%記録
提供された混在テキストのテスト結果
Synthetic Nimbusのテストフィクスチャ
45ポイントのギャップ
設定された許容値を超過
デモのルール: 5パーセントポイント超
法務、コンプライアンス、マーケティング、およびエンジニアリングチーム向けの、提供された記録のレビューです。デモの判定は法令遵守を確立するものではなく、エビデンスを独自に検証するものでもありません。
精度の主張は、チームを特定のタスクと測定された結果にコミットさせます。完全な自律性に関する言明もまた、人間の関与についての主張を伴います。レビューでは、文言の背後にある記録と比較できるよう、それらのコミットメントを保持し続ける必要があります。
Nimbusの例において重要な発見は、宣伝された精度と提供されたテストとの間の関係です。レビュアーはどの文に注意を払うべきか、そしてその理由を確認できます。同じ記録は次の問いも具体化します。すなわち、文言が誤っているのか、エビデンスが不完全なのか、それとも根本的なテストを調査する必要があるのか、ということです。
本稿では、3件の合成開示情報と14件の提供されたエビデンス記録を対象とした境界づけられたワークフローを実証します。10件のクレームを抽出し、その主題を記録にリンクさせ、設定された各判定の根拠を保持します。
01 / EXTRACT
決定論的な文分割とAIキーワードまたは主題マッチングにより、バンドルされた開示情報からクレームを選択します。元の文言は可視化されたまま保持されます。
02 / LINK
情報検索は構造化された主題フィールドをテスト記録および運用記録と照合します。セマンティック検索を実行したり、それらの記録を認証したりすることはありません。
03 / DECIDE
プレーンなPythonコードが設定されたチェックを適用します。実証された指標の例では、5パーセントポイントを超える数値ギャップがCONTRADICTEDを出力します。
Substantiation Judgeはゲート決定を変更することなく助言を提供します。Adversarial Examinerはゲートで立証されたクレームに対して実行され、REFUTEDを返した場合はそれらをPARTIALLY_SUBSTANTIATEDへダウングレードすることがありますが、アップグレードすることはできません。この録画では、決定論的チェックが実行される間、キャッシュされた助言的回答を再生します。4件のキャッシュされた審査役の回答はすべて、裏付けられた結果を支持しています。
完了した実行からは、JSON形式のSubstantiation Packageをエクスポートできます。これにはフォローアップのためのクレーム、出典、判定、ルール、根拠、およびエビデンス識別子に加え、サマリーとバージョン情報が保持されます。これは根本的な記録を参照するものであり、完全なエビデンスアーカイブを埋め込むものではありません。
これらの画面はローカルのClaimLens実証デモのものです。ここに表示されているすべてのNimbusの企業、開示情報、テスト、および運用記録は合成されたものです。
別個のオンボーディングに関する主張では、人間の関与がないことを約束しています。その合成運用ログには68%の人間の介入が記録されています。設定されたno-humanルールは、10%を超える介入に対してCONTRADICTEDを返します。この閾値はデモ上の設定であり、法的に十分な境界ではありません。
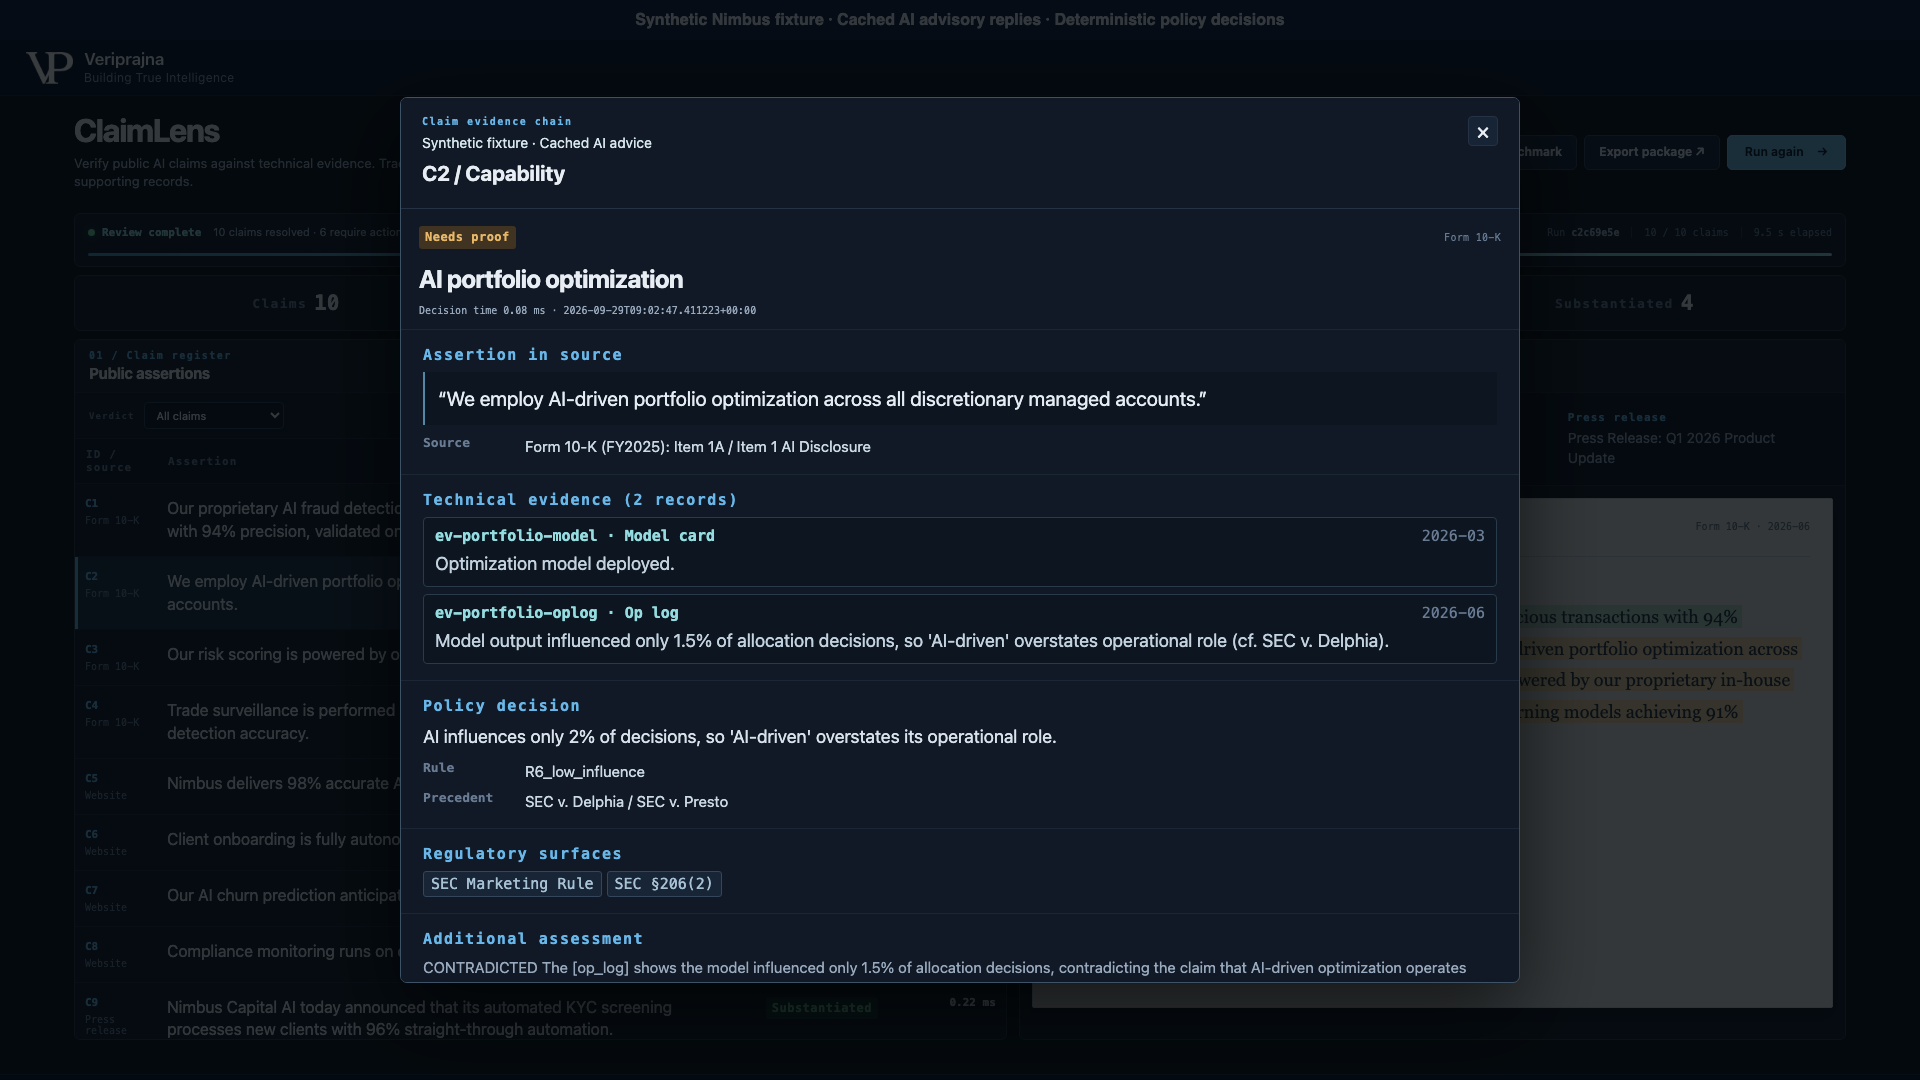
ポートフォリオモデルは存在しますが、提供されたログには配分決定のわずか1.5%にしか影響を与えていないことが記録されています。ゲートはNEEDS_PROOFを返します。キャッシュされた判定役はこれを矛盾と呼んでおり、助言的意見と最終結果になぜ別々のラベルが必要であるかを示しています。
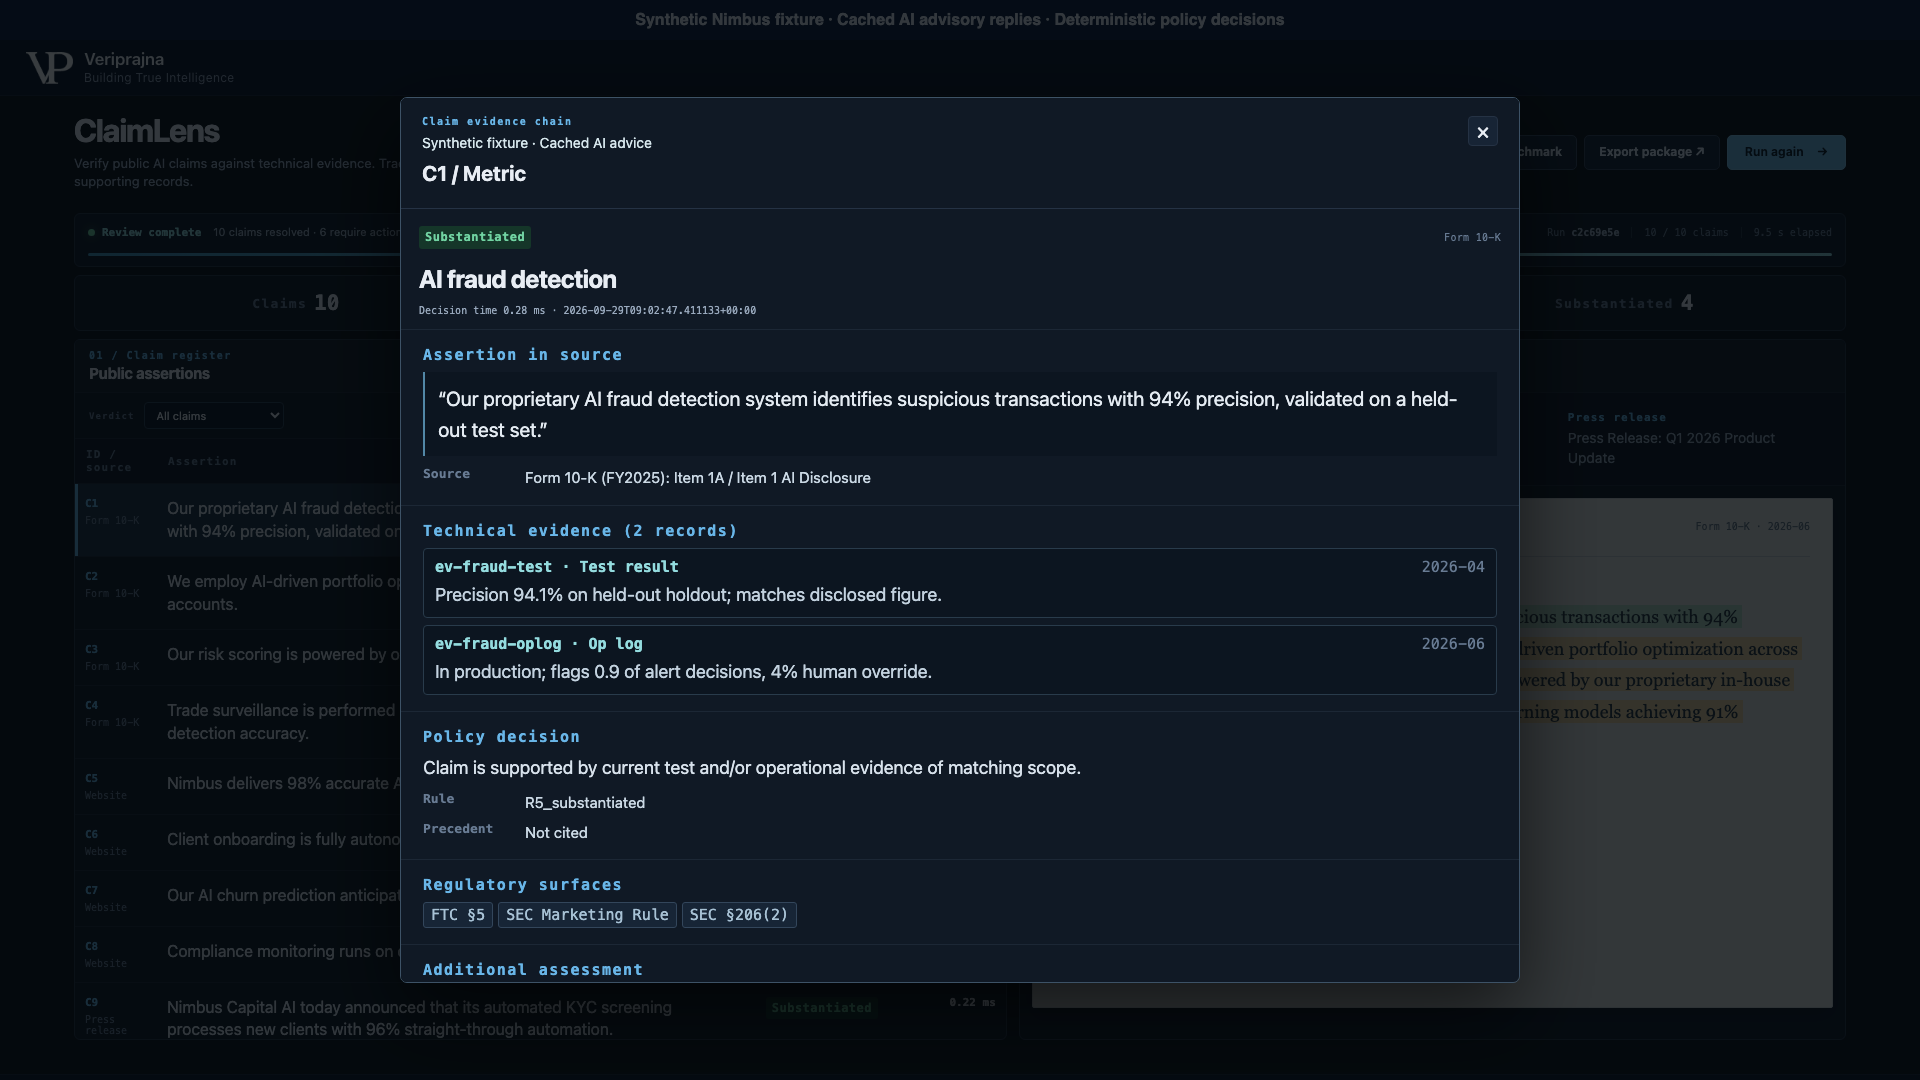
合成不正検知のクレームは、開示された94%の適合率と、裏付けとなるテスト記録および運用記録によって立証された状態を維持しています。裏付けられたフィクスチャの結果であっても、依然として提供された記録に関する主張に過ぎません。レビュアーは実際の文言に依拠する前に、実際の測定値とその妥当性を検証する必要があります。
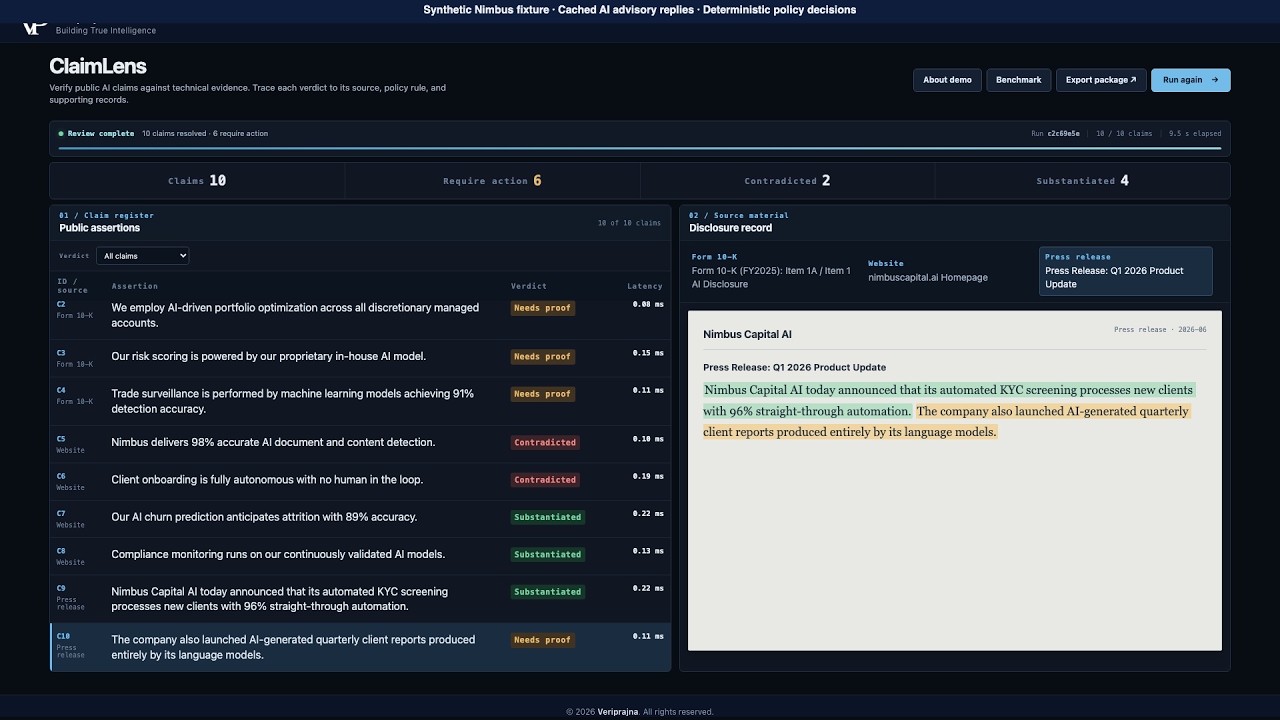
ClaimLensは、クレームと記録を照合するレビューを実証します。以下の表は、録画されたワークフローが検証可能にする内容と、実際のレビューで依然として必要とされる作業を区別して示しています。
| レビューのタスク | 本実証が提供するもの | 本実証の対象外として残るもの |
|---|---|---|
| コミットメントの特定 | 提供された出典にリンクされた文 | 一般的なドキュメント取り込みおよび完全なクレーム発見 |
| 裏付けの比較 | 主題に基づく記録リンクおよび設定されたチェック | エビデンスの真正性確認および独自のテスト評価 |
| 結果の把握 | 判定、判定ルール、および根拠 | 法的助言または規制当局の承認 |
| レビュー結果の引き継ぎ | エビデンス識別子を含むJSONパッケージ | 完全なエビデンスアーカイブまたは改ざん防止の保管管理 |
本デモは、バンドルされた合成データを使用したローカル実証です。ライブのウェブサイトや提出書類のクローラー、任意のドキュメントのアップロード、本番AIBOMやCI/CD統合、セマンティック検索、自律的な法的評価、またはHTMLバインダーのエクスポート機能は備えていません。その閾値は、統計的信頼性や法的な十分性を確立するものではありません。本ページは録画されたワークフローを説明するものであり、ローカルアプリケーションへのアクセスを提供するものではありません。
ClaimLensは、設定されたデモ用ルールを用いて、提供された文言と技術記録を比較します。立証された結果は法的な承認(クリアランス)ではなく、インターフェースに表示される規制ラベルは例示的なルーティングラベルです。根本的な記録に対する人的レビューと検証が引き続き必要です。
本実証では、バンドルされた合成Nimbusデータセットを使用しています。任意のドキュメントのアップロードを受け付けたり、ウェブサイト、提出書類、または社内システムをクロールしたりすることはありません。本ページは録画されたワークフローとそのエビデンスビューを紹介するものです。
本デモは、構造化された主題フィールドを通じて、抽出された文を提供された技術記録にリンクさせます。これらの記録にはテストや運用ログが含まれます。チェック処理は設定された値と条件を比較するものであり、記録の真正性を確認したり、テスト方法論を独自に評価したりするものではありません。
Substantiation Judgeは、ポリシーゲートの決定を変更することなく助言を提供します。Adversarial Examinerは論駁を返した場合にゲートで立証されたクレームをダウングレードできますが、クレームをアップグレードすることはできません。この録画では、助言的な回答はキャッシュされており、4件の審査役の回答はすべて裏付けられた結果を支持しています。
モデルの記録はコンポーネントが文書化されていることを確立しますが、運用上のクレームにはそれが何を行っているかを示すエビデンスも必要です。合成ポートフォリオの例では、提供されたログに配分決定の1.5%に対する影響しか記録されていません。設定されたゲートはNEEDS_PROOFを返し、そのギャップをレビューのために保持します。
ブラウザの「Export」ボタンをクリックすると、完了した実行から各クレーム、出典、判定、判定ルール、根拠、およびエビデンス識別子を含むJSONパッケージが保存されます。また、サマリー、エンジンバージョン、および生成タイムスタンプも含まれます。完全なエビデンス記録、助言のトランスクリプト、または改ざん防止の保管管理チェーンは埋め込まれません。
Veriprajnaとクレーム立証ワークフローについてご相談ください。
実装を定義する前に、貴社チームが必要とする記録、レビューの境界、および人間の意思決定について協議できます。