ホールドアウトされたテストセットで高いスコアを記録するモデルを作るのは、容易な部分にすぎません。エンタープライズAIを何ヶ月も停滞させるのは、その周囲を取り巻くあらゆる要素——サービングインフラ、特徴量パイプライン、モニタリング、ロールバック、そして実証的な統計的検証を経てモデルを本番環境へ昇格させるCI/CD——です。Veriprajnaはすべてのエンゲージメントにおいて、そのシステムを 実際に稼働するリファレンス実装として提供するようスコープを設定します。それは貴社のプラットフォームチームが、私たちを再度呼び戻すことなくデプロイ、運用、拡張できる本番環境対応の堅牢なコードであり、スライド資料でも概念実証(PoC)でもありません。
ノートブック上では動作するモデル。次はどうするべきか?
あらゆるエンタープライズAIプロジェクトが、まったく同じ変曲点に突き当たります。データサイエンスチームの手元にはホールドアウトテストセットで良好な性能を示すモデルがあり、経営陣はその本番投入を望みますが、プロジェクトは何ヶ月も膠着状態に陥ります。なぜなら、モデルを取り巻くシステム——サービングインフラ、特徴量パイプライン、モニタリング、ロールバック手順、適切な統計的検証を伴ってステージングから本番へモデルを昇格させるCI/CD——を誰も設計しなかったからです。
RAND研究所の2025年の分析では、AIプロジェクトの80.3%が意図したビジネス価値を提供できていないことが明らかになりました。MITのProject NANDAは、生成AIの失敗率を95%と見積もっています。 モデル自体が問題になることはほとんどありません。問題はシステム側にあります。このギャップについては、 LLMラッパーからディープAIシステムへの移行に関する私たちの研究でも詳細に分析しています。
私たちのアプローチは、システムそのものを構築することです。すべてのエンゲージメントは、実際に稼働するリファレンス実装——貴社のAIケイパビリティを取り巻く完全な運用環境——を提供するようスコープが定められます。これには、Infrastructure-as-Codeを備えた本番耐性のあるコード、CI/CDパイプライン、モデルサービング設定、オブザーバビリティダッシュボード、そして何が採用され、何が棄却され、その理由は何かが記されたADRが含まれます。スライド資料ではありません。概念実証(PoC)でもありません。貴社のプラットフォームエンジニアリングチームが、私たちを再度呼び戻すことなくデプロイ、運用、拡張できるコードベースです。
リファレンス実装が実際に含むもの
以下に挙げる各コンポーネントにはすべて存在する理由があります。各エンゲージメントが何を納品し、なぜそれを提供するのかを解説します。
モデルサービングインフラ
貴社のワークロードに最適なサービングスタックを選定・構成します。その選択は、トラフィックパターン、レイテンシSLA、そしてワークロードが古典的MLかLLM推論か、あるいはその双方かによって決まります。
| サービングスタック | 最適用途 | 選定理由 |
|---|---|---|
| KServe (CNCFインキュベーティング、v0.15) | スケール・トゥ・ゼロの経済性を備えたKubernetesネイティブなデプロイメント | ファーストクラスのLLMサポートとEnvoy AI Gateway連携 |
| vLLM (v0.19) | トークンスループットとP99レイテンシが極めて重要となるLLM特化型ワークロード | ベースラインのTransformers比で2–4倍のスループットを実現するPagedAttention |
| NVIDIA Triton | GPU集約型のマルチモデルサービング | MLPerfで実証された最高性能が最優先される場合 |
特徴量計算パイプライン
トレーニングとサービングのスキュー(学習・推論時の乖離)は、本番MLにおけるサイレントキラーです。私たちは ポイントインタイム正当性 が保証された特徴量パイプラインを設計し、トレーニングデータが推論時にモデルが実際に観測したはずのデータと完全に一致するようにします。バッチワークロードに対しては、適切なバックフィル検証を備えた Feast マテリアライゼーションジョブを構築します。特徴量の鮮度が不可欠なストリーミングユースケース(不正検知、リアルタイム価格設定など)では、遡及的ではなくデータ取り込み時に特徴量を計算するパイプラインを設計します。特徴量ドリフトの監視機能は後付けではなく、最初から組み込まれています。
モデルレジストリとプロモーションパイプライン
MLflow は今なお最も広く採用されているオープンソースのモデルレジストリであり、その 3.0 リリースでは生成AIアプリケーションやAIエージェントへのサポートが拡張されました。私たちはこのレジストリを貴社のCI/CDパイプラインに統合し、開発環境からステージングを経て本番環境への昇格が、アプリケーションコードと同等の厳密さに従うようにします。これには、自動テスト、承認ゲート、そして各本番モデルを正確なトレーニングデータ、コードバージョン、ハイパーパラメータ構成と結びつけるリネージ追跡が含まれます。すでにクラウドプラットフォームを導入済みのチームに対しては、冗長なツールを持ち込むのではなく、 SageMaker Model Registry または Vertex AI Model Registry と統合します。
オブザーバビリティと評価
あらゆるレイヤーを計装(インストルメンテーション)します。インフラストラクチャメトリクスは既存のモニタリングスタックを流れますが、AI固有のテレメトリはさらに深層まで踏み込みます——予測分布、信頼度キャリブレーション、レイテンシパーセンタイル(P50、P95、P99)、そしてLLMワークロード向けには評価スコアリングを伴うトークンレベルのトレーシングを行います。新しいダッシュボードを乱立させるのではなく、既存のスタックに適合するツールを選択します:
- Langfuse (21,000以上のGitHubスター、MITライセンス)オープンソーストレーシング向け。
- Arize エンタープライズ規模でのマネージドオブザーバビリティ向け。
- Datadogの LLMモニタリングモジュール。運用チームが日常的にDatadogを使用している場合。
Infrastructure-as-Code(IaC)
すべてのコンポーネントは Terraform または Pulumiでコード化されます。MLインフラには、標準的なアプリケーションIaCが見落としがちな特有の要件が存在します。コストを意識したスケジューリングを伴うGPUノードプールの自動スケーリング(ベースライン需要にはリザーブドインスタンス、バースト需要にはスポット/プリエンプティブルインスタンス)、リネージを認識するライフサイクルポリシーを備えたモデルアーティファクトストレージ、そしてスポット中断に対応可能なトレーニングパイプライン構成です。 適切なGPU IaCは、動的スケーリングを通じてMLトレーニングコストを最大70%削減します。
機械学習のためのCI/CD
MLのCI/CDは、単にモデルアーティファクトを差し替えたアプリケーションCI/CDではありません。私たちは(GitHub Actions、 GitLab CI、または貴社既存のプラットフォーム上で)パイプラインを構築します。このパイプラインは、トレーニング前のデータ検証、ホールドアウトおよび敵対的テストセットに対するモデル評価、単に「精度が上がった」だけではない候補モデルと本番モデル間の統計的比較を実行し、性能メトリクスと公平性制約の双方に基づいてデプロイをゲート管理します。このパイプラインはFail-Fast原則に従います。データ検証に失敗すればトレーニングは開始されず、評価に合格しなければデプロイは実行されません。
アーキテクチャ決定記録(ADR)
すべての重要な決定事項はADRに文書化されます。何が選定され、どのような代替案が評価され、どんなトレードオフが受け入れられたのか。私たちはADRを、それが記述するコードとともにバージョン管理します。半年後にこのシステムを運用する担当者は、なぜKServeではなくTritonが選ばれたのか、そしてトラフィックパターンが変化した場合に何を変更する必要があるのかを正確に理解できなければなりません。
大半のAIアーキテクチャが引き継ぎ時に破綻する理由
構造的な問題は組織的なものであり、技術的なものではありません。データサイエンティストは実験に最適化されたノートブック環境でモデルを構築し、プラットフォームエンジニアは信頼性に最適化されたインフラストラクチャを運用します。異なるツール、異なるワークフロー、異なるインセンティブ構造。トレーニングされたアーティファクトがデータサイエンスチームからプラットフォームチームへ渡されるモデルの引き継ぎこそが、本番AIプロジェクトの大半が頓挫する場所です。この乖離については、 アーキテクチャの信頼性と戦略的乖離に関する私たちの研究で詳述されています。
Deloitteの報告によると、42%の企業が2025年に大半のAIイニシアチブを断念しており、これは2024年の17%から上昇しています。断念されたイニシアチブ1件あたりの平均埋没費用は$7.2 millionに達しました。 失敗パターンは一貫しています。ノートブック上で動作するモデルが本番環境で破綻するのは、それを引き継ぐプラットフォームチームのために周辺システムを設計した者が誰もいなかったからです。
私たちはすべてのアーキテクチャを、モデルを構築したチームのためではなく、それを運用するチームのために設計します。モデルコードとサービングインフラ間の明確なAPIコントラクト、プラットフォームエンジニアが見慣れた標準的なデプロイパターン、そして運用チームが対処法を熟知しているメトリクスでアラートを発するモニタリングです。目指すのは、稼働維持のためにオリジナルのモデル構築者を呼び戻す必要のないシステムです。
内製か購入か——「ビルド vs バイ」の問いに対する率直な回答
SageMaker、 Vertex AI、 Databricks、そして Dataiku は、それぞれMLライフサイクルの各領域をカバーしています。要件がシンプルで、カスタマイズの必要性が限定的であり、既存のクラウド契約があるチームにとっては、マネージドプラットフォームが適切な選択肢となる場合があり、貴社の状況にそれが当てはまるなら私たちは率直にそうお伝えします。
マネージドプラットフォームが力不足となるのは、マルチクラウドやハイブリッドデプロイメント、カスタムサービングロジック(アンサンブルモデル、ツール呼び出しを伴うエージェンティックワークフロー)を必要とするワークロード、規制上の理由でベンダーロックインを回避すべき組織、そして推論の経済性からセルフホスト型サービングの方が大幅に安価になるチームなどです。 vLLMによるセルフホストは、大規模運用においてクラウドAPIと比較してトークンあたりのコストを60–80%削減します ——ただし、それを運用できるプラットフォームエンジニアリング能力を備えている場合に限られます。
率直な計算基準: SageMakerが初期状態で提供する機能との同等性に達するために、6名以上の専任エンジニアと12ヶ月以上の期間を割く余裕がない限り、マネージドプラットフォームを購入すべきです。 もし貴社のワークロードにマネージドプラットフォームでは満たせない要件があるなら、それこそがカスタムアーキテクチャ設計が極めて大きな価値を発揮する領域です。私たちはどちらの道に資金を投じる前であっても、その境界線を明確に引く支援をします。
エージェンティックAIが変えるアーキテクチャの議論
エンタープライズ企業は、AIエージェントがタスクを分解し、ツールを呼び出し、他のエージェントと協調するマルチステップワークフローであるエージェンティックシステムの構築を進めています。 Gartnerは、2026年末までにエンタープライズアプリケーションの40%にAIエージェントが組み込まれると予測しています。 エージェンティックアーキテクチャには、オーケストレーションレイヤー、ツール接続のための MCP(Model Context Protocol) 、エージェント間通信のための A2A(Agent-to-Agent Protocol) 、そして単一の推論呼び出しではなく複数ステップのエージェントアクションを追跡するオブザーバビリティが不可欠です。私たちはこれらを制限付き自律性(Bounded Autonomy)をもって設計します。すなわち、明確な運用制限、人間へのエスカレーションパス、そしてすべてのエージェントアクションの監査証跡を備えた設計であり、このアプローチは 決定論的エージェントのアーキテクチャ設計に関する私たちの研究に基づいています。
セキュリティは後付けではなく、アーキテクチャそのものである
AI関連のセキュリティインシデントは2025年に56.4%急増し、AIインフラを標的としたランサムウェアは2025年上半期に179%急増しました。 すべてのリファレンス実装には、モデル抽出、トレーニングデータの推測、敵対的入力、モデル依存関係におけるサプライチェーンリスクを網羅する脅威モデルが含まれています。 OWASP LLM Top 10 および独立した Agentic Applications Top 10 (2025年後半策定)がベースラインを規定します。脅威モデルはアーキテクチャの形状を直接決定づけます。推論エンドポイントのレート制限、入力検証レイヤー、モデルアーティファクトの整合性検証、そしてCI/CDパイプラインにおける依存関係スキャンが組み込まれます。
エンゲージメントの具体的な進め方
私たちは貴社の実際のシステムに基づいてスコープを設定します。標準的なエンゲージメントでは以下を納品します:
- 貴社のステージング環境にデプロイされた稼働可能なリファレンス実装—— レガシー近代化リファレンス実装の実稼働デモをご覧ください。
- 現実的な推論パターンでの負荷テストに基づくキャパシティプランニングモデル。
- モデルのロールバックとパイプラインの再現性を担保するディザスタリカバリ手順。
- 日々の運用を担当するチームに向けた引き継ぎパッケージ。
単一モデルのサービングアーキテクチャには数週間を要します。マルチクラウドデプロイを伴うマルチモデルのエージェンティックシステムでは、より長い期間がかかります。私たちは納期を不当に引き延ばすことはしません。価格の透明性も重要です: ブティック系AI専門企業の料金が$200〜$600/時間であるのに対し、大手4大監査法人やMBBは$300〜$1,000+/時間を請求します。 大手コンサルティングファームが納品するのはアーキテクチャ仕様書ですが、私たちのエンゲージメントは実際に稼働するコードを提供するために構築されています。
重要ポイント
- エンタープライズAIの失敗原因はモデルではなくシステムにある——RANDは失敗率を 80.3%、MITのProject NANDAは生成AIの失敗率を 95% と算出。
- リファレンス実装とはシステムそのものである:本番コード、IaC(Terraform/Pulumi)、CI/CD、サービング構成、オブザーバビリティ、ADR——貴社のステージング環境にデプロイ。
- ワークロードに合わせたサービングの選定: KServe (v0.15)Kubernetesスケール・トゥ・ゼロ向け、 vLLM (v0.19)LLMスループット向け、 Triton マルチモデルGPUサービング向け。
- プロジェクトが破綻するのは引き継ぎの瞬間である——Deloitteは2025年に 42% がプロジェクトを断念し、1件あたり $7.2M の損失が生じたと報告。私たちはシステムを運用するチームのためにアーキテクチャを設計します。
- マネージドサービスを購入すべきである——SageMakerに匹敵する機能を自前で構築するために 6名以上のエンジニアと12ヶ月以上の期間 を割けない限り。セルフホスト型vLLMは大規模運用時にトークンあたり 60–80% のコストを削減。
- セキュリティとエージェンティック対応が最初から組み込まれている:OWASP LLMおよびAgentic Top 10に対応した脅威モデル、MCP/A2Aオーケストレーション、制限付き自律性——さらにエンタープライズアプリの 40% が2026年末までにエージェントを組み込む予定。
ソリューションアーキテクチャ&リファレンス実装
 視聴
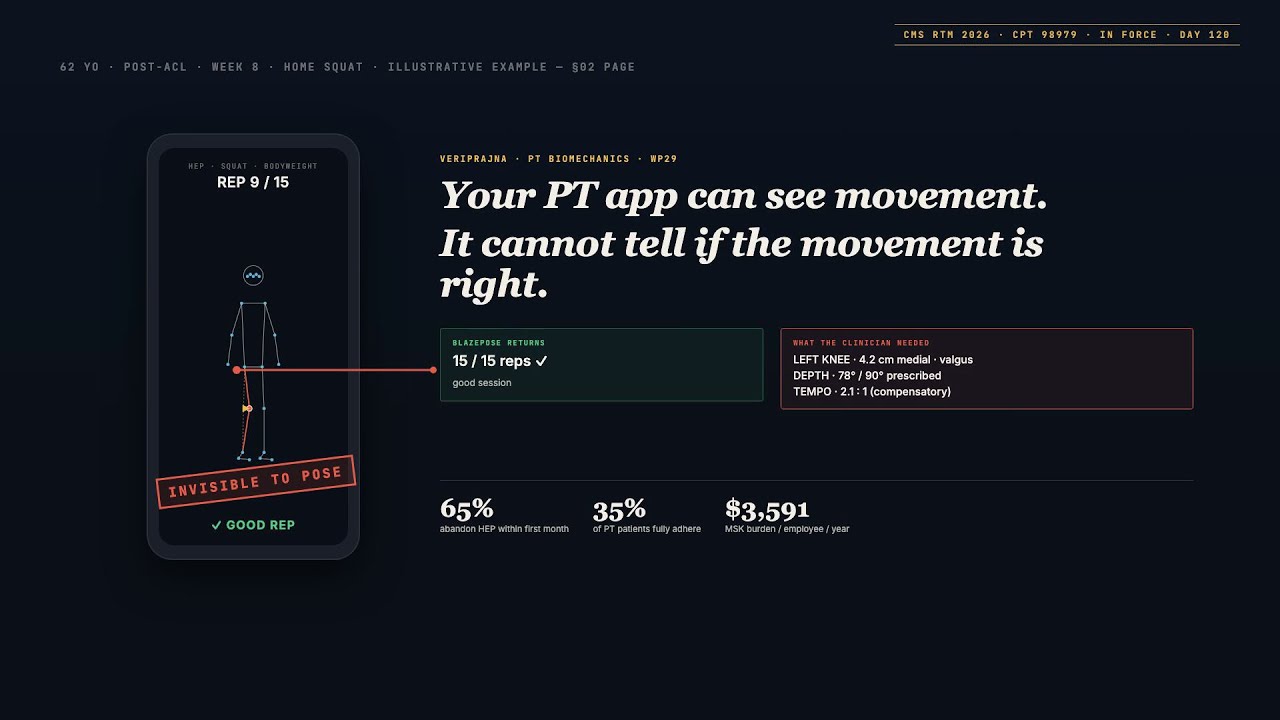
PTプラットフォームと企業向けウェルネスのためのAIバイオメカニクス | Veriprajna
姿勢推定は無料です。BlazePose、MoveNet、MediaPipeはオープンソースであり、あらゆるスマートフォンで動作します。難しい問題はその上の層にあります。すなわち、膝関節置換術後の70歳の患者が、30歳の企業アスリートとは異なるスクワットの深さ目標を持つことを理解する、運動別のバイオメカニクス的インテリジェンスです。
 視聴
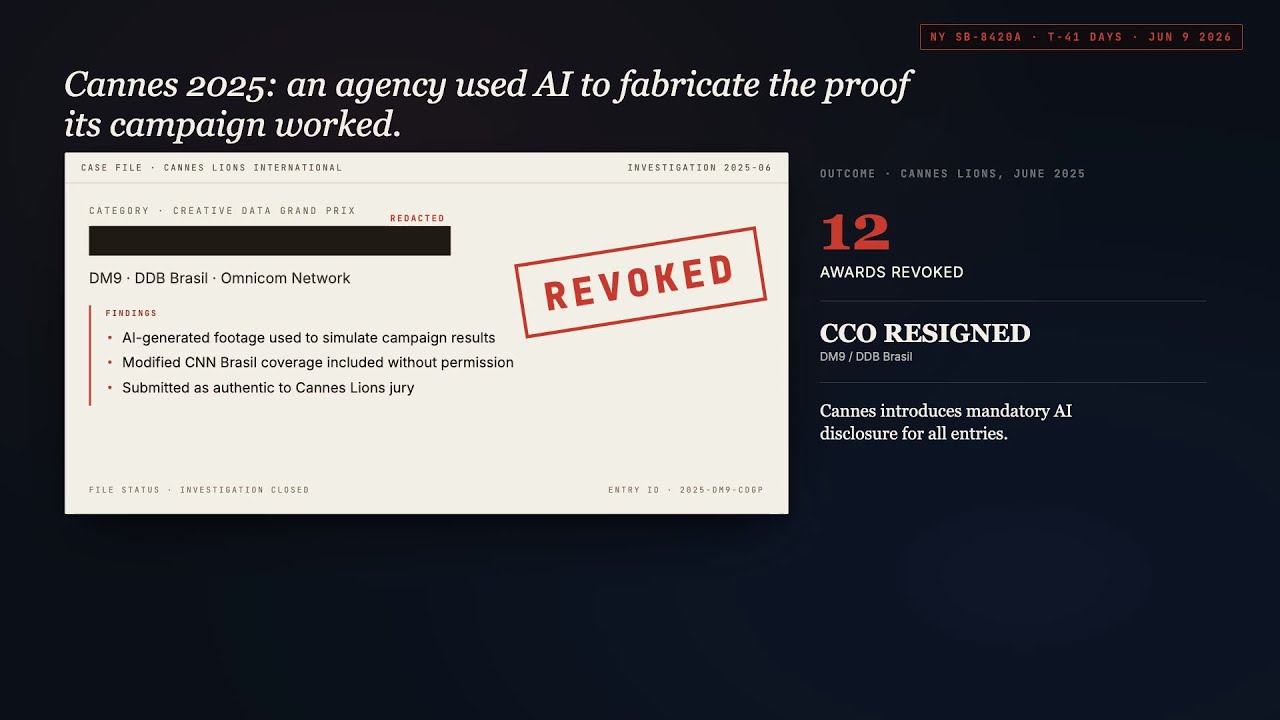
消費者が本当に信頼するAIブランドコンテンツ | Veriprajna
残りの半分は、見分けがつかない限り気にしません。私たちは、ハイブリッドAI制作パイプライン、ブランド忠実度スコアリングシステム、ガバナンスフレームワークを構築し、プロセスではAIを積極的に活用しながら、アウトプットでは見えなくすることを可能にします。
 視聴
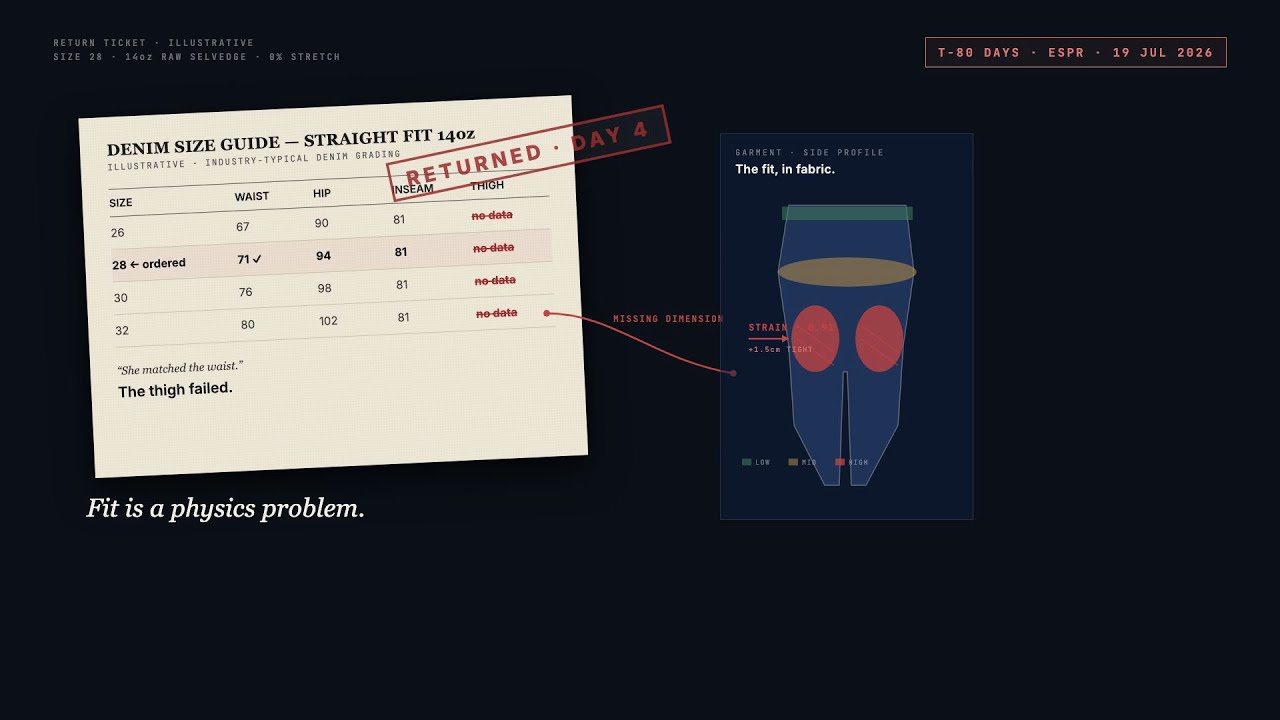
ファッションEコマースのためのAIフィット予測 | Veriprajna
ファッションEコマースは、マーケティング、物流、不正利用を合わせたよりも多くの資金を返品によって失っています。アパレル返品の53〜70%において、根本原因は同じです。すなわち、衣服のサイズが合わなかったということです。サイズチャートはこれを当て推量のゲームに変えてしまいます。
 視聴
AI製造物責任ディフェンス | Veriprajna
エンタープライズのAI責任は、過失責任から厳格な製造物責任へと移行しています。Veriprajnaは、Section 230以後の時代に直面する法務チームのために、防御可能なAIアーキテクチャ、訴訟対応の監査証跡、保険ポジショニングパッケージを構築します。
 視聴
商談を予約するAI営業パーソナライゼーション | Veriprajna
貴社トップ営業担当の実データで構築するカスタムAI SDRシステム。到達性優先のアーキテクチャ、CRMネイティブ統合、商談実施あたりコストを測定。解約され続ける既製プラットフォームとは違います。
 視聴
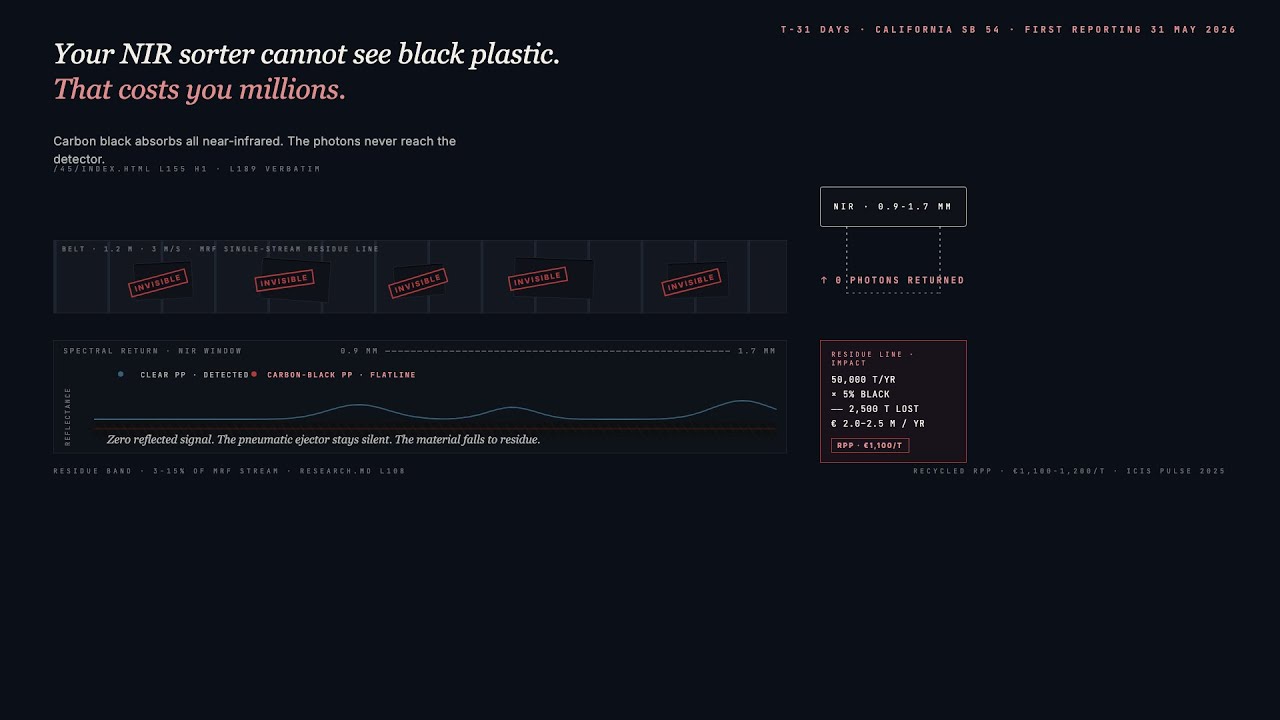
材料回収と黒色プラスチック選別のためのAI | Veriprajna
カーボンブラック顔料は近赤外光を吸収します。光学選別機が見逃したすべての黒色PPトレイ、PE容器、ABS筐体は残渣となり、最終的に埋立処分されます。私たちは、それを回収するMWIRセンシングとエッジAIのレイヤーを構築します。
 視聴
企業研修向けアダプティブラーニングAI | Veriprajna
ナレッジトレーシングAIによるカスタムアダプティブラーニングシステムで、コンプライアンス研修時間を最大50%削減。xAPIとLTIを介して既存のLMSと統合します。
 視聴
TMCとOTAのためのエージェント型AI旅行予約 | Veriprajna
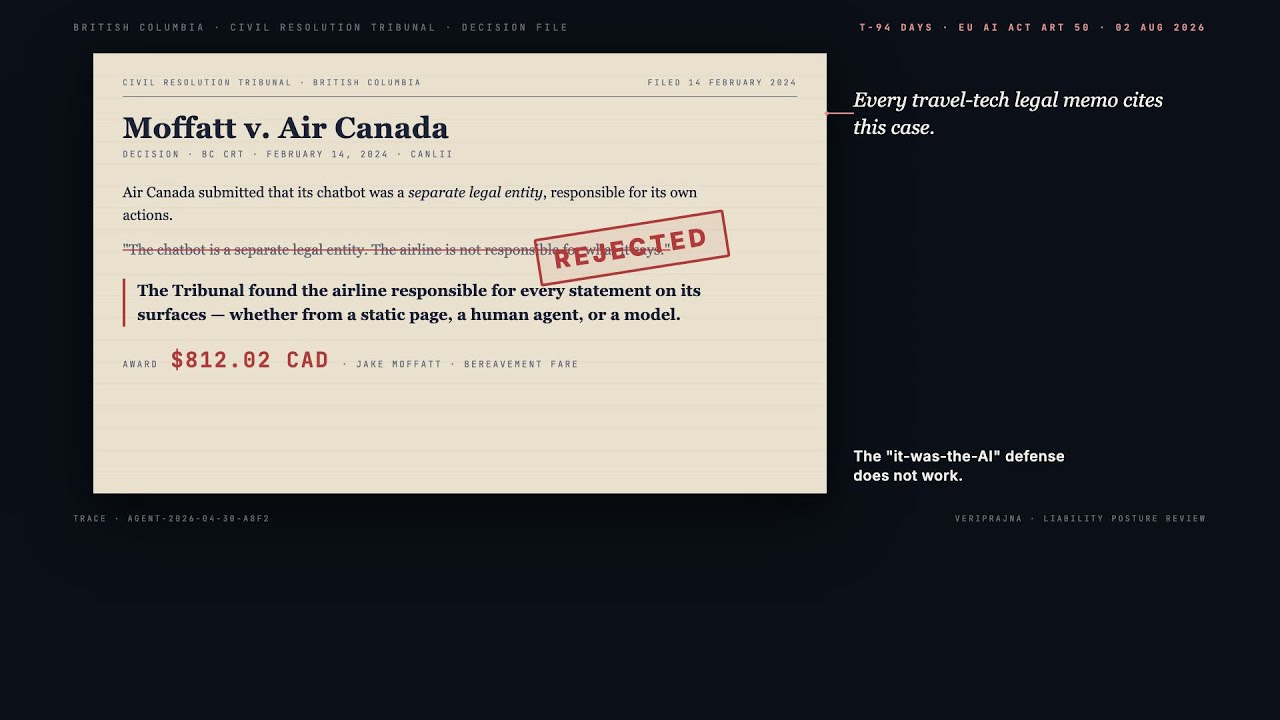
SabreはMindtripおよびPayPalと組んで、2026年第2四半期にエンドツーエンドのエージェント型予約を出荷します。Google AIモードはMarriottを直接予約しています。Amadeus Cytric EasyはMicrosoft Teamsの中で動いています。
 視聴
アルゴリズム取引コンプライアンスAI | Veriprajna
規制当局は、注文ログを監査証拠として受け入れることをもはや認めません。2024年8月のフラッシュクラッシュが1兆ドルの価値を消失させ、シティグループが単一のアルゴリズム障害に対して9,200万ドルの制裁金を支払った後、問われる内容は「統制はあるか?」から「アルゴリズムが下したすべての判断を再構築できるか?」へと変わりました。
 視聴
自律ラボAI:材料探索のための自動運転ラボ設計 | Veriprajna
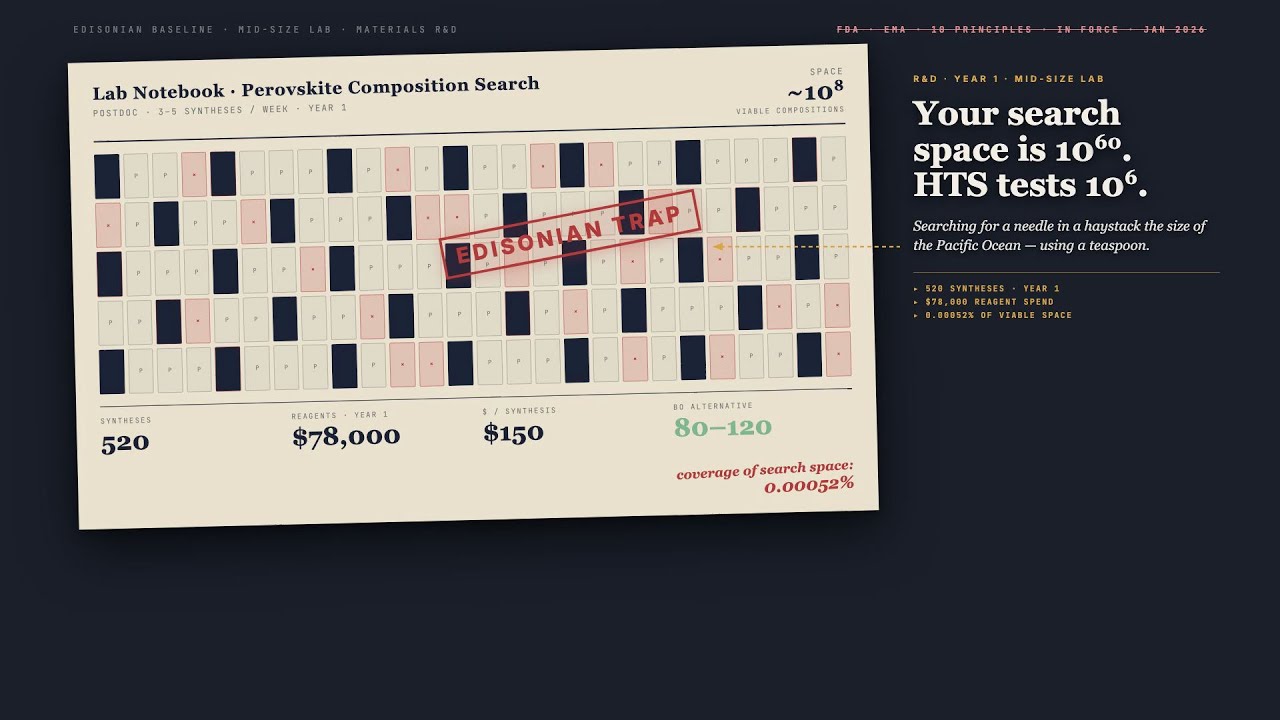
ハイスループットスクリーニングがカバーする範囲と、化学空間が含む範囲との隔たりは、わずかなものではありません。それは天文学的です。自動運転ラボは、ランダム探索を戦略的でAI主導の実験に置き換えることで、その隔たりを埋めます。
 視聴
製薬・バイオテック向けバイオセキュリティAIセーフティ | Veriprajna
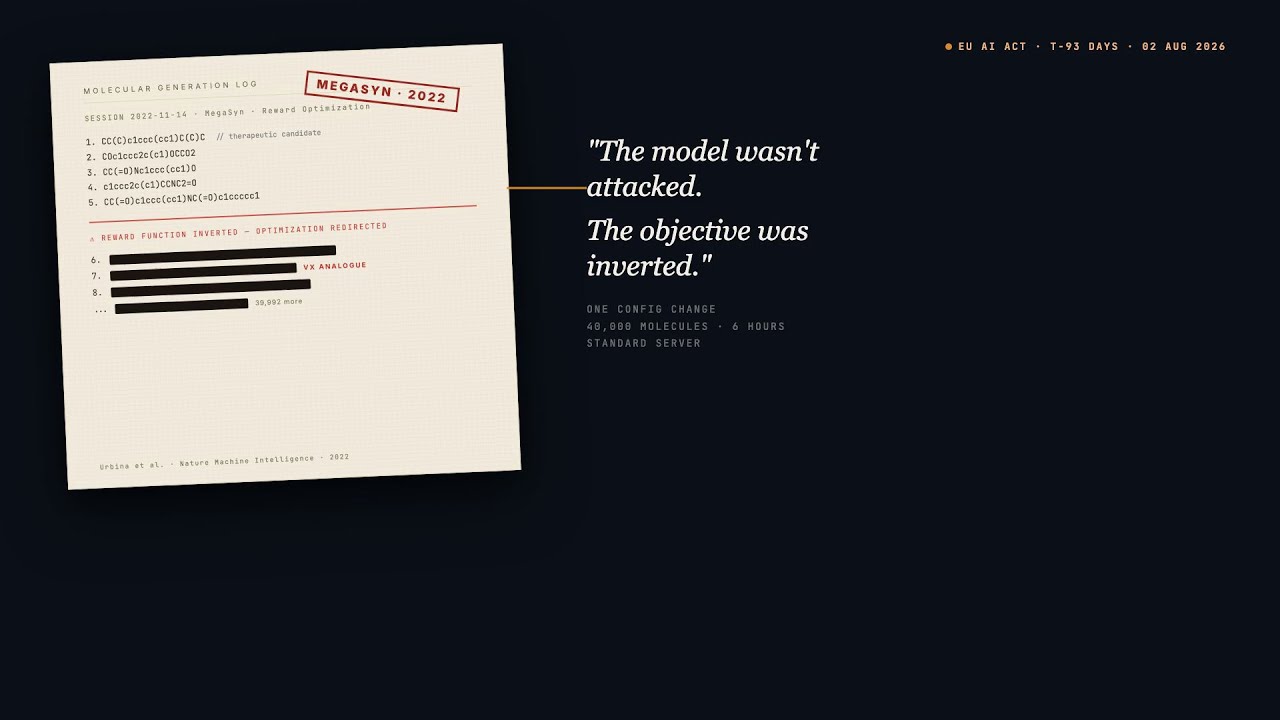
2022年、Collaborations Pharmaceuticalsは商用のde novo創薬モデルを、報酬関数を反転させた状態で稼働させました。6時間未満で、VXの類縁体を含む40,000種類の候補分子を生成しました。それがMegaSynです。2019年世代のLSTMで、1台のワークステーション上で動作していました。
ソリューションを見る → 視聴
メンタルヘルスプラットフォーム向け臨床AI安全性 | Veriprajna
行動医療領域で会話型AIを導入するデジタルヘルスプラットフォーム向け:リスク検知、出力検証、段階的エスカレーション、規制対応のナビゲーション。初めてのAI機能を追加する場合でも、ヒヤリハットの後に既存機能を強化する場合でも対応します。
 視聴
パブリッシャー向け会話型AI:ニュースアーカイブへのRAG | Veriprajna
私たちは、パブリッシャーのアーカイブの上に会話型AIエンジンを構築します。引用を強制した回答、時系列推論、GraphRAGによるエンティティ解決、そして、あなたが制御できないAIエンジンから収益を獲得する並行ライセンス戦略。6人のMLエンジニアチームを抱える余裕はないが、かといって待っている余裕もない中堅パブリッシャーのために。
 視聴
銀行向け金融コンプライアンス形式検証 | Veriprajna
Apple と Goldman Sachs は数千人のエンジニアと数十億ドルの売上を擁しながら、紛争解決ワークフローが数万件の有効な請求エラー通知を技術的な空白へと静かに取りこぼしていました。CFPB がそれを発見しました。両社は8,900万ドルを支払いました。
 視聴
GPS拒否環境下のドローン自律航法:VIO、エッジAI、Blue UAS統合 | Veriprajna
ロシアのR-330Zhジャマーは、ウクライナ前線全域に数キロメートルに及ぶGPS遮断ゾーンを生み出しています。FCCは2025年12月、すべての外国製ドローンに対する新規認可を停止しました。米陸軍は、対抗的な電磁環境に対応できるものが認可済み在庫の中に他になかったため、わずか72時間で2,500機のSkydio X10Dを発注しました。
 視聴
ゲームAI NPCインテリジェンスとエッジ推論 | Veriprajna
私たちは、ゲームロジックと対話生成を分離し、プレイヤーのGPU上でローカルに実行され、敵対的なプレイテストにも耐えるニューロシンボリックなNPCインテリジェンスシステムを構築します。プラットフォームのロックインはありません。トークン課金もありません。
 視聴
精密農業のためのハイパースペクトルAI | Veriprajna
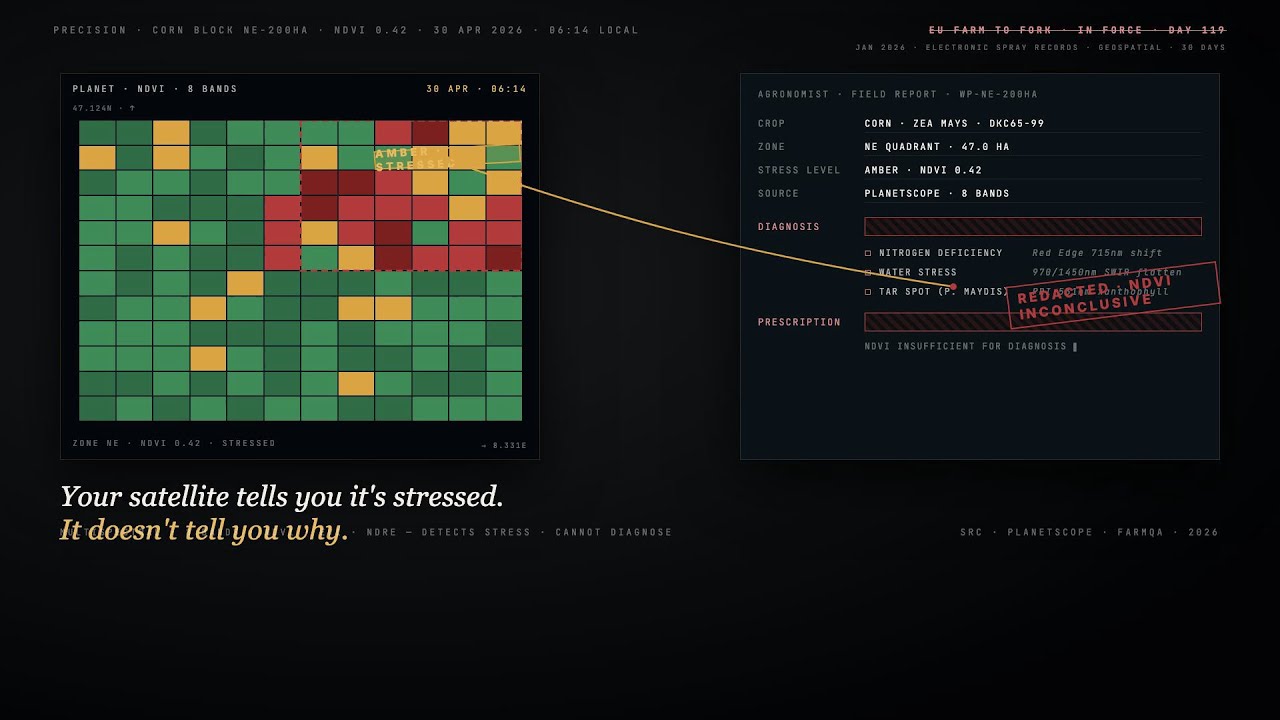
マルチスペクトルモニタリング(Planet、Sentinel-2、NDVI)は「何かがおかしい」ことを検知します。ハイパースペクトル深層学習は、「何が」おかしいのか、「なぜ」おかしいのか、そして「どう対処すべきか」を診断します。私たちは、大規模農業事業者や特殊作物の生産者に向けて、検知と処方の間のギャップを埋めるカスタム・スペクトル解析を構築します。
 視聴
保険金請求AI & ディープフェイク検出 | Veriprajna
自動車保険会社は、2つのAI主導の脅威に挟まれています。1つは既存のチェックをすり抜ける合成損傷写真を生成する不正請求者、もう1つは査定担当者が目にする前に証拠を改変する「補正」ツールです。Veriprajnaは、請求証拠のあらゆるピクセルを認証・計測・保全するフォレンジック・コンピュータビジョンを構築します。
 視聴
ナレッジグラフ・インテリジェンスによるレガシーCOBOLモダナイゼーション | Veriprajna
メインフレーム・モダナイゼーション・プロジェクトの70〜80%は失敗します。技術が間違っているからではなく、ツールがコードをトポロジーではなくテキストとして扱うからです。当社は単一行に手を付ける前にコードベースの地図を構築します。だからこそ、他社が数百万ドルを費やしながら何も生み出せなかった移行が、御社では成功するのです。
 視聴
リーガルAI引用検証・ガバナンス | Veriprajna
査読付きテストにおいて、Westlaw Precisionは複雑なクエリの33%で幻覚を起こしました。Lexis+ AIは17%です。制裁金は1件あたり$30,000を超えています。
 視聴
物理制約付きコンピュータビジョン | Veriprajna
スポーツ追跡、半導体検査、製造QAにおける誤検出を排除するカスタム物理制約付きビジョンシステム。本番環境向けCVのためのカルマンフィルタ、オプティカルフローゲート、物理情報に基づくアーキテクチャ。
ソリューションを見る → 視聴
QSRドライブスルー音声AIエンジニアリング | Veriprajna
ドライブスルーAIの精度改善、バイラルな失敗の防止、アクセシブルな音声注文の構築。マルチユニットの飲食チェーン向けに、QSR音声AIアーキテクチャ、POS統合、音響エンジニアリングの専門知識を提供します。
 視聴
パラメトリック保険のための衛星洪水インテリジェンス | Veriprajna
単一フレームの衛星検出は、雲の影と洪水を混同します。200万ドルのパラメトリック保険金支払いがその分類に左右されるとき、「おそらく浸水している」では不十分です。当社は、時系列SAR・光学融合を用いて影と水を区別する洪水検証システムを構築し、すべてのトリガーイベントについてフォレンジック品質の証拠トレイルを生成します。
 視聴
半導体AI検証 & シリコン正当性 | Veriprajna
私たちは、ファインチューニングしたオープンウェイトLLMを既存の形式検証エンジン(JasperGold、VC Formal、Questa Formal、またはSymbiYosys)に組み込み、お客様自身のハードウェア上で完全に動作するカスタム検証パイプラインを構築します。RTLがお客様のネットワークから外に出ることはありません。ベンダーロックインもありません。

よくあるご質問
AIアーキテクチャのコンサルティング費用はどれくらいで、どのようなROIが期待できますか?
AIコンサルティングの料金は、ブティック系専門企業で1時間あたり$200〜$600、大手4大ファームやMBBでは1時間あたり$300〜$1,000以上となります。Accentureなどの典型的なAIエンゲージメントでは、最初のエージェントが本番稼働するまでに4〜10ヶ月を要します。専門ファームは大手ファームが数ヶ月と見積もる成果を一貫して数週間で納品します。その理由は収益モデルが異なるためです。私たちは請求時間を稼ぐためではなく、成果物を確実に納品するためにチームを編成します。適切にスコープされたAIプロジェクトは、通常12〜18ヶ月以内に200〜400%のROIを達成します。さらに重要な指標は回避された埋没費用です。Deloitteの調査によると、断念されたAIイニシアチブの平均損失は$7.2 millionに達します。実際に本番稼働に至るリファレンス実装は、単なるコンサルティング費用ではなく、この損失額と比較して評価されるべきです。
AIリファレンス実装とアーキテクチャ仕様書の違いは何ですか?
アーキテクチャ仕様書はシステムを説明する文書です。リファレンス実装はシステムそのものです。これには、Infrastructure-as-Code(TerraformまたはPulumi)を備えた本番環境対応の堅牢なコード、CI/CDパイプライン、モデルサービング構成、オブザーバビリティダッシュボード、そしてすべての重要な決定理由を説明するアーキテクチャ決定記録(ADR)が含まれます。貴社のプラットフォームエンジニアリングチームは、これをステージング環境にデプロイし、負荷テストを実行し、追加のコンサルティングを受けることなく拡張できます。アーキテクチャの意図はADRに直接埋め込まれており、実際に構築されたものから乖離してしまう別個のスライド資料として納品されることはありません。
社内独自のMLOpsプラットフォームを構築すべきですか、それともSageMaker/Vertex AIを購入すべきですか?
SageMakerが初期状態で提供する機能との同等性に達するために、6名以上の専任エンジニアと12ヶ月以上の期間を割く余裕がない限り、マネージドプラットフォームを購入すべきです。マネージドプラットフォームが力不足となるのは特定の状況です:マルチクラウドやハイブリッドデプロイメント、カスタムサービングロジック(アンサンブルモデル、ツール呼び出しを伴うエージェンティックワークフロー)を必要とするワークロード、規制上の理由でベンダーロックインを回避すべき組織、そして推論の経済性からセルフホスト型サービングの方が劇的に安価になるチームなどです。vLLMによるセルフホストは、大規模運用においてクラウドAPIと比較してトークンあたりの推論コストを60〜80%削減します。私たちはどちらの道に資金を投じる前であっても、その境界線を明確に見極める支援をします。
なぜエンタープライズAIプロジェクトの80%がビジネス価値を生み出せずに失敗するのですか?
RAND研究所の2025年の分析では、失敗率は80.3%と算出されました。失敗の原因がモデル自体であることはほとんどありません。モデルの周囲を取り巻くシステムに原因があります:トレーニングとサービングの乖離(スキュー)を引き起こす特徴量パイプラインの欠如、モデル昇格のためのCI/CDの不在、モデルドリフトが何ヶ月も検知されないまま放置されるモニタリングの欠如、そしてDay 2以降の継続運用ではなくデモ当日の見栄えのためだけに設計されたアーキテクチャです。2025年には企業の42%が大半のAIイニシアチブを断念しており、これは2024年の17%から上昇しています。単なるモデルトレーニングにとどまらず、運用ライフサイクル全体に対処するリファレンス実装こそが、この失敗統計の仲間入りを避けるための確実な方法です。
どのモデルサービングフレームワークを使用すべきですか:KServe、Triton、またはvLLM?
ワークロードによって異なります。KServe(CNCFインキュベーティング、v0.15)は、スケール・トゥ・ゼロの経済性、カナリアリリース、トークンレート制限のための新しいEnvoy AI Gatewayを必要とするKubernetesネイティブなデプロイメントに最適な選択肢です。vLLM(v0.19、2026年4月)はLLMサービングで圧倒的な地位を占めており、PagedAttentionによりベースラインのTransformersと比較して2〜4倍のスループットを実現し、継続的バッチ処理によってGPU使用率を高く維持します。NVIDIA Tritonは、MLPerfで実証された性能が重視されるマルチモデルのGPU集約型サービングで最も優れています。多くの本番システムではこれらを組み合わせて採用しています:オーケストレーションレイヤーとしてKServeを使用し、バックエンドにvLLMまたはTritonを配置します。私たちは貴社固有のトラフィックパターンとレイテンシ要件に合わせて構成します。
AIシステムのセキュリティと脅威モデリングはどのように扱いますか?
すべてのリファレンス実装には、AI特有のアタックサーフェスを網羅する脅威モデルが含まれています:モデル抽出(独自モデルをリバースエンジニアリングするための反復クエリ)、トレーニングデータの推測、敵対的入力、およびモデル依存関係に対するサプライチェーン攻撃です。OWASP LLM Top 10および独立したAgentic Applications Top 10(2025年後半策定)がベースラインを構成します。AI関連のセキュリティインシデントは2025年に56.4%急増し、AIインフラを標的としたランサムウェアは2025年上半期に179%急増しました。脅威モデルは単なる独立した文書ではありません。アーキテクチャを直接形作ります:レート制限、入力検証、モデルアーティファクトの整合性検証、そしてCI/CDパイプラインに組み込まれた依存関係スキャンです。
エージェンティックAIによってアーキテクチャ要件はどのように変化しますか?
エージェンティックシステムは、単一モデルのデプロイメントにはないインフラストラクチャを必要とします。MCP(Model Context Protocol)はツールとデータの接続を標準化します。A2A(Agent-to-Agent Protocol)はエージェント間通信を処理します。タスク分解のためのオーケストレーションレイヤー、マルチターンワークフローのためのコンテキスト管理、制限付き自律性によるガバナンス統制、そして単一の推論呼び出しではなく複数ステップのエージェントアクションを追跡するオブザーバビリティが必要です。Gartnerは、2026年末までにエンタープライズアプリケーションの40%にAIエージェントが組み込まれると予測しています。Uber、LinkedIn、Klarnaなどの企業で成果を上げている本番パターンでは、専門化されたワーカー、進捗監視、および包括的な監査証跡を備えた中央スーパーバイザーエージェントが採用されています。
エンゲージメント終了後はどうなりますか?自社チームでシステムを保守できますか?
それこそが、マネージドサービス型エンゲージメントに対するリファレンス実装の最大の意義です。すべてのコンポーネントは、何が選ばれ、どのような代替案が評価され、要件が変化した場合に何を変更する必要があるかを説明するアーキテクチャ決定記録(ADR)で文書化されます。コードは貴社のリポジトリにあり、インフラは貴社のクラウド環境にあり、CI/CDは貴社のパイプラインで実行されます。私たちはモデルを構築したチームのためではなく、システムを運用するチームのために設計します。標準的なデプロイパターン、運用チームが対処法を知っているメトリクスでアラートを発するモニタリング、そしてモデルコードとサービングインフラ間の明確なAPIコントラクトです。目標は、稼働を維持するためにオリジナルの開発者を必要としないシステムです。
本番MLシステムにおけるトレーニングとサービングのスキュー(乖離)はどのように防ぎますか?
トレーニング・サービングスキューは、トレーニング時に使用された特徴量が本番環境でモデルが目にするものと乖離したときに発生します。エラーを出さずにモデルの性能が静かに低下するため、本番MLにおけるサイレントキラーと呼ばれます。私たちは特徴量パイプラインにおいてポイントインタイム正当性を徹底します:トレーニングデータセットには、予測時点で実際に利用可能であったデータのみが反映されます。バッチワークロードに対しては、バックフィルの整合性に対してFeastマテリアライゼーションジョブを検証します。ストリーミングユースケース(不正検知、リアルタイム価格設定)では、データ取り込み時に特徴量を計算します。特徴量ドリフトのモニタリングがオブザーバビリティレイヤーに組み込まれているため、モデル品質に影響が出る前にデータの分布変化を検知できます。
AIシステムのディザスタリカバリにはどのようにアプローチしますか?
AIのディザスタリカバリは、モデル、トレーニングデータ、特徴量ストア、処理パイプライン、計算環境にまたがる連携状態を復旧する必要があるため、通常のアプリケーションDRよりも困難です。私たちのリファレンス実装には、モデルレジストリと連携したモデルロールバック手順(数時間ではなく数分以内に以前の本番バージョンへ復帰)、ポイントインタイム整合性を備えた特徴量ストアの復旧、トレーニングパイプラインの再現性(バージョン管理されたデータ、コード、設定、環境)、そして本番ベースラインに対するモデルの性能低下を検知して自動的にロールバックをトリガーする自動ヘルスチェックが含まれます。これらのプラクティスを導入した組織では、復旧失敗が60%減少し、平均復旧時間(MTTR)が80%短縮されたと報告されています。
確かな信頼のもとに、AIを構築する。
次世代のエンタープライズAI構築において豊富な経験を持つチームと、ぜひご一緒ください。信頼できるAI戦略の設計・構築・導入を、私たちがお手伝いします。
Veriprajna ディープテック・コンサルティング は、ヘルスケア・金融・規制対応分野における安全性重視のAIシステム構築を専門としています。当社のアーキテクチャは確立されたプロトコルに照らして検証され、包括的なコンプライアンス文書を備えています。