AIシステムを取り巻く脅威環境は、2025年に学術研究の領域から実運用環境での悪用へと移行しました。数百万人の開発者が利用する商用AIツールにおいて高いCVSSスコアを持つCVEが報告され、攻撃対象領域はソフトウェア、サプライチェーン、ハードウェアのすべてにわたって同時に拡大しており、規制遵守へのカウントダウンも進んでいます。個別ソリューションを提供するベンダーやガバナンスフレームワークはその一部を解決するに過ぎず、稼働中のAI導入環境における全体的なセキュリティポスチャを設計するものではありません。それこそが、私たちが解決するギャップです。
本番運用のAIは活発な攻撃に晒されており、大半のセキュリティプログラムは追いついていない
2025年、AIの悪用は概念実証(PoC)の段階から、数百万人の開発者が依存するツールにおける文書化されたCVEへと移行しました:
- Microsoft 365 Copilot — ゼロクリック・プロンプトインジェクションの脆弱性(CVE-2025-32711、CVSS 9.3)により、細工された1通の電子メールから遠隔データ持ち出しが引き起こされました。
- GitHub Copilot — パブリックリポジトリに埋め込まれたコードコメントを通じて侵害され(CVE-2025-53773)、リモートコード実行へとエスカレーションしました。
- Cursor IDE — 大文字・小文字の区別に関するバグ(CVE-2025-59944)により、攻撃者がエージェントの挙動を操作して任意のコマンドを実行させることが可能になりました。
これらは単なる実演ではありません。実運用ツールでCVSSスコアが付与された実在のCVEです。そして攻撃対象領域は、同時に3つの方向へと拡大しています。
エージェント型システムと信頼境界
エージェント型AIシステムは、従来の境界防御型セキュリティでは対処できない信頼境界の問題を生み出します。わずか 29%の組織 しかエージェント型運用のセキュリティ確保に対する準備が整っていると報告しておらず、 MITRE ATLAS v5.4.0 (2026年2月)には、「ポイズニングされたAIエージェントツールの公開」や「ホストへのエスケープ」など、エージェント固有の脅威に対する専用手法が追加されました。
AIサプライチェーン攻撃
サプライチェーン攻撃は理論から実践へと移行しました。 JFrog は、コード実行ペイロードが埋め込まれた約 100件の悪意あるモデル をHugging Face上で特定し、 Palo Alto Unit 42 は、削除されたHugging Faceネームスペースが誰でも再登録可能であり、サプライチェーン乗っ取りが可能になることを実証しました。
ハードウェアレベルの脆弱性
GDDRHammer攻撃(2026年) は、権限のないCUDAカーネルがGDDR6のRowhammerを通じてGPUメモリへの任意の読み取り/書き込みアクセス権を取得できることを示しました。これは、マルチテナントGPU環境にはいかなるソフトウェア層の防御でも塞ぐことのできないハードウェア攻撃対象領域が存在することを意味します。
重層化する規制圧力
規制の強化も並行して進んでいます。 EU AI法 の禁止される慣行は2025年2月に発効し、高リスクシステムの要件は2026年8月に適用され、罰則は最大で EUR 35 millionまたは全世界売上高の7%に達します。 CISA は2025年9月にプロンプトインジェクションを重大なAI脆弱性に分類しました; NIST は2026年1月に AI RMF 2.0 を公開し、プロンプトインジェクションに関する具体的なガイダンスを提示しました。また、生体情報プライバシー法 CUBIに基づき、テキサス州は2025年単年で Googleから$1.375 billion、Metaから$1.4 billion の和解金を徴収しました。コンプライアンスの負担は四半期ごとに重くなっています。
AIサプライチェーン:大半の組織が完全な不可視状態にある領域
私たちが企業のAI導入環境をアセスメントする際、サプライチェーンのギャップは一貫して最も危険な発見事項となっています。大半の組織は、本番環境でどのモデルが稼働しているかの完全なインベントリを作成することすらできず、その出所(プロバナンス)を検証することはなおさら困難です(これは 企業のモデルをポイズニングから保護するための調査研究のテーマでもあります)。 Lineajeの調査(2025年6月) によると、 セキュリティ専門家の48% が、自組織はすでに基本的なソフトウェア部品表(SBOM)要件において後れを取っていると回答しています。ML-BOM(機械学習部品表)の導入率はこれを大幅に下回ります。
このリスクは理論上のものではなく、実証されています:
- Anthropic、英国AI安全研究所、およびアラン・チューリング研究所 の研究では、わずか 250件の悪意ある文書 によって、 600 millionから13 billionパラメータの大規模言語モデルにバックドアを仕掛けることに成功したことが実証されました。
- DeepSeekのDeepThink-R1 モデル(2025年1月)では、トレーニング中にGitHubのコードコメントに仕込まれた隠蔽プロンプトによって作成されたバックドアが発見されました。このモデルは、トレーニング完了から数カ月後、インターネット接続が不要な状態でも、特定のトリガーフレーズに遭遇すると攻撃者が仕組んだ指示に従いました。
- Qwen 2.5の 検索ツールは敵対的なWebコンテンツを通じてポイズニングされ、アライメント調整済みのモデルであるにもかかわらず、わずか 11語のクエリから有害な出力を生成させられました。
従来のセキュリティスキャンではこれらの問題を検出できません。Hugging Faceは悪意あるpickleファイルを検出するために Picklescan を実行していますが、悪意あるLoRAアダプタ、汚染されたトレーニングデータセット、再登録されたネームスペースなどはすべてモデルレベルのスキャンを回避します。標準規格は存在します — CycloneDX は2023年にML-BOM仕様を策定し、 SPDX 3.0.1 はAIおよびデータセットプロファイルを定義し、 OWASP はAI-BOMプロジェクトを発足させました — しかし、仕様の策定状況と組織での実導入との間には依然として大きな隔たりがあります。AIのサプライチェーン整合性を確立するには、10年前にアプリケーションセキュリティがソフトウェア依存関係にもたらしたのと同様の規律が必要です。すなわち、自動スキャン、出所検証、継続的監視、そして防御を突破された際のインシデント対応プレイブックです。
既存のセキュリティエコシステムがアーキテクチャレベルのギャップを残す理由
AIセキュリティベンダーのランドスケープは急速に拡大しており、そのポイントソリューションは優れています:
- Protect AI は $108 million を超える資金を調達し、AI/ML脆弱性を対象としたhuntr.comバグバウンティを運営しています。同社はモデルアーティファクトの既知の脆弱性をスキャンします。
- HiddenLayer ($56 million)はランタイム時のモデル動作監視に注力しています。
- Lakera は、多くの専門家から最良のプロンプトインジェクション検出製品と評価されているLakera Guardを開発しました。
- Cisco は2024年にRobust Intelligenceを買収しました; F5 は2025年に CalypsoAIを$180 millionで買収 しました。
AIレッドチーミング市場だけでも、 $1.3 billion(2025年)から2035年までに$18.6 billionへと成長すると予測されています。しかし、これらのツールはセンサーやフィルターに過ぎず、構造的な統制ではありません — AI導入環境全体のセキュリティポスチャを設計するものは一つもありません。これらのコンポーネントからプログラムを構築するCISOは、エージェント型システムにおける信頼境界をどこに配置すべきか、モデルの出所検証をCI/CDパイプラインにどのように統合するか、導入後に活性化したバックドアをどのような監視で検知するか、そしてコンプライアンスチームが管轄区域外での推論を禁じた際にソブリン(主権型)導入を実際にどう機能させるかを設計する人材を依然として必要としています。
四大監査法人(Big Four)は2023年以降、AIに対して総額 $10 billion 以上を投資してきました: PwC は $1 billion規模の生成AIプログラム とOpenAIとのパートナーシップを展開しています; KPMG は正式な ISO 42001対応の10本柱からなるAIガバナンスフレームワークを保有しています; Deloitte は 100以上の生成AIアクセラレータを構築しました; EY は規制対象業界向けにNVIDIA AI Factoryインフラを展開しています。彼らのガバナンスおよびコンプライアンスに関する取り組みは確かなものです。
しかし、クライアントがRAGパイプラインの実践的な敵対的テスト、マルチエージェントシステムにおける間接的プロンプトインジェクションに対するアーキテクチャの堅牢化、あるいはモデル重みの整合性検証を備えたソブリンAIインフラの実運用展開を必要とする場合、ガバナンスフレームワークだけでは不十分です。リスクが何であるかを認識することと、それを構造的に防ぐエンジニアリング能力を持つこととの間にはギャップが存在するのです。
私たちがAIセキュリティプログラムのために構築するもの
私たちがアーキテクチャレベルで取り組むのは、そこで下されるセキュリティ上の決定こそが構造的な影響力を持つからです。入力レイヤーでのプロンプトインジェクションフィルタリングは、適応型攻撃に対して一定の失敗率が記録されています。ダウンロード後のモデルスキャンは既知のパターンを捕捉できますが、新規のサプライチェーン攻撃を見逃します。ガバナンスフレームワークは何を監視すべきかを教えてくれますが、監視機構そのものを構築してはくれません。私たちは、セキュリティポスチャが維持されるかどうかをアーキテクチャが左右する4つの領域に注力しています — これには、私たちが 実動するプライベートLLMデモで実証したソブリン(主権型)展開も含まれます。
ソブリンAIインフラストラクチャ
データ主権の制約下で展開する組織に対して、私たちのアプローチは、モデル、推論、トレーニングデータが管理された境界内に留まるインフラを構築することです。これはAPI呼び出しを単にVPCでラップするようなものではありません。オンプレミスハードウェア向けにモデルを選定・量子化し( GPTQ、AWQ、およびGGUF による量子化のトレードオフは、性能とセキュリティの双方にとって極めて重要です)、マルチテナント環境向けのGPU分離を構成し、モデル重みの暗号学的構成証明(attestation)を実装し、異常な推論挙動を検出する監視スタックを構築することを意味します。ソブリン展開はラッパーを組み合わせるのではなく、エンドツーエンドで設計される 6カ月間のエンジニアリングプロジェクトとして定義され、単なる設定変更ではありません。
サプライチェーンの整合性
私たちは、いかなるモデルも本番環境に触れる前に実行される検証パイプラインを設計します(詳細は MLライフサイクル全体にわたるAIサプライチェーン整合性に関する調査研究に記載):モデルの重みとトレーニングデータの自動出所チェック、シリアライズ形式の検証(pickleではなく常にsafetensorsを採用)、LoRAアダプタの整合性検証、そしてネームスペース乗っ取りや重みの改ざんを検知するためのアップストリームリポジトリの継続的監視です。目的とする成果物は、 ML-BOM であり、すべてのコンポーネントの出所、すべての依存関係のバージョン、そしてすべてのトレーニングデータセットの来歴をマッピングします。
敵対的攻撃への堅牢化
私たちはレッドチーミングとアーキテクチャの是正を組み合わせ、 MITRE ATLAS タクソノミおよび OWASP LLM Top 10 v2.0 に照らしてテストを実施します — しかし、テストだけでは問題は解決しません。エージェント型システムのツール呼び出しインターフェースが取得文書を通じた間接的プロンプトインジェクションに対して脆弱である場合、私たちは信頼できないコンテンツと特権的操作を構造的に分離する信頼境界アーキテクチャを構築します( 人間とAIのフロンティアを保護するための調査研究を参照)。また、RAGパイプラインが精巧に細工されたクエリによってシステムプロンプトを漏洩する場合(2025年版で新設されたOWASP LLM07)、それを防止するために検索および生成パイプラインを再設計します。
規制マッピング
私たちは、お客様の導入環境に適用される規制要件に特定の技術的統制を紐付けます: EU AI法 の高リスク義務、 NIST AI RMF 2.0、 OWASP LLM Top 10、州の生体認証法(BIPA、CUBI、コロラド州法H.B. 24-1130)、および業界固有の要件です。目的とする成果物はスプレッドシート上のコンプライアンスマトリクスではありません。規制当局を納得させ、AI関連のデータ侵害による $4.63 million の平均損害額を削減する、監視、証拠生成、および監査証跡を備えた実装済みの統制です。
重要なポイント
- AIの悪用は学術的なものではなく実運用上の脅威です:2025年にはMicrosoft 365 Copilot、GitHub Copilot、Cursor IDEで実稼働中のCVEが報告され、2026年にはGPUレベルのGDDRHammer攻撃が発生しました。
- サプライチェーンは最も危険な死角です — わずか250件の悪意ある文書でモデルにバックドアを仕掛けることが可能であり、CycloneDX ML-BOM、SPDX 3.0.1、OWASP AI-BOMなどの標準規格の策定が組織での導入ペースを上回っています。
- ポイントソリューションベンダーと四大監査法人のガバナンスプログラムはいずれも同じギャップを残しています:導入環境全体のセキュリティポスチャを設計する者は存在しません。
- 私たちは、ソブリンAIインフラストラクチャ、サプライチェーンの整合性、敵対的攻撃への堅牢化、規制マッピングの4領域にわたりアーキテクチャレベルで構築を行い、リスク認識を構造的に強制される統制へと変換します。
AIセキュリティ&レジリエンス
 視聴
AIサプライチェーンセキュリティとモデル完全性 | Veriprajna
AIサプライチェーンセキュリティのコンサルティング。規制業界企業のCISO向けに、モデル審査パイプライン、ML-BOMアーキテクチャ、シャドーAIガバナンスを構築します。NIST AI 100-2およびEU AI法に準拠。
 視聴
生体認証・顔認識コンプライアンス監査 | Veriprajna
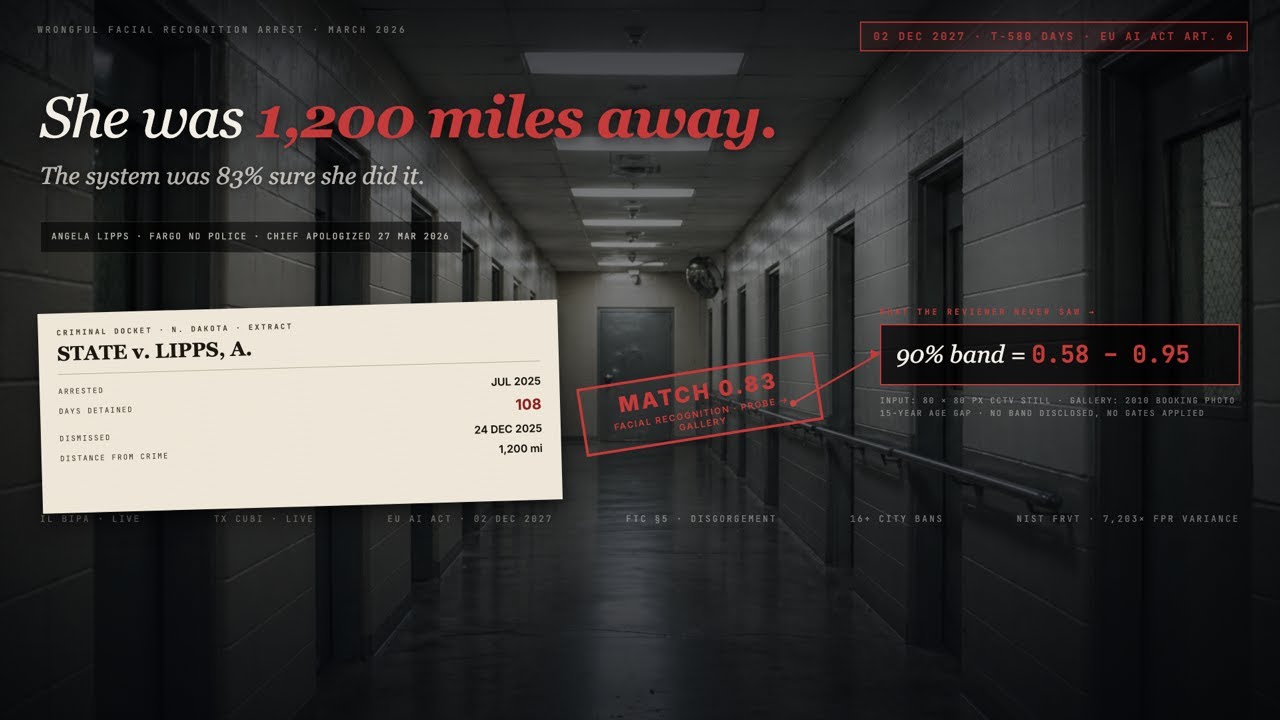
顔認識を導入済みでリスク状況を把握したい場合も、ベンダーを評価中で最初から正しく導入したい場合も、私たちは実際に重要な規制・ベンチマーク・運用基準に照らして生体認証システムを監査します。


よくあるご質問
AIセキュリティのコンサルティング会社を採用すべきか、それとも社内AIセキュリティチームを構築すべきか?
率直な答えを言えば、双方の要素が必要であり、そのタイミングが重要です。ゼロから社内AIセキュリティチームを立ち上げるには、採用、育成、実運用化までに12〜18カ月を要します。人材プールは極めて限られており、本番LLMシステムをレッドチーミングした上でアーキテクチャ上の修正を設計できる攻撃的AIセキュリティ研究者は決して多くありません。コンサルティング会社を活用すれば、社内能力を育成している間にも、より迅速に防御可能なセキュリティポスチャを確立できます。当社は通常3〜6カ月間参画し、現在のAI導入環境の評価、セキュリティアーキテクチャ(サプライチェーン検証、信頼境界、監視)の構築、重要システムのレッドチーミング、そして社内チームが維持管理できるようプログラムの文書化を行います。円滑な引き継ぎこそが私たちの目標です。当社がプログラムとツールを構築し、お客様のチームがそれを運用します。6カ月間のコンサルティング費用は、単一のAI関連データ侵害や生体認証集団訴訟の和解金(テキサス州は2025年単年でGoogleとMetaから$2.8 billionを徴収)に比べればごくわずかです。
AIセキュリティアセスメントにはどのくらいの期間がかかり、どのような内容を網羅しますか?
包括的なAIセキュリティアセスメントは、対象となるAIシステムの数に応じて通常4〜8週間かかります。第1週ではAIインベントリをマッピングします:本番稼働中のすべてのモデル、その出所、展開方法、データフロー、およびアクセス制御です。大半の組織は、稼働していることすら知らなかったモデルを発見します。第2週から第4週にかけては、MITRE ATLASタクソノミおよびOWASP LLM Top 10 v2.0に沿った敵対的テストを実施します。これにはプロンプトインジェクション(直接・間接)、サプライチェーン整合性検証、データ持ち出しテスト、ツール呼び出しインターフェースを通じた権限昇格が含まれます。最終フェーズでは、単なる検出事項のリストにとどまらず、アーキテクチャ上の推奨事項を伴う優先順位付けされた改善計画を策定します。すべての検出事項を適用される規制要件(EU AI法、NIST AI RMF、生体認証システムが対象の場合はBIPA/CUBI)に紐付けることで、改善作業がセキュリティギャップとコンプライアンスギャップを同時に解消できるようにします。
本番環境におけるプロンプトインジェクションに対して、実際に有効な対策は何ですか?
プロンプトインジェクションを確実に阻止できる単一の防御策は存在しません。フィルターが有限のパターンを対象とするのに対し、インジェクションの可能性空間は無限です。制御されたテスト環境において、単一の防御層に対する適応型攻撃の成功率は85%を超えています。実際に有効なのは、多層的なアーキテクチャ防御です。入力検証は明らかな攻撃を捕捉します。LLM-as-a-Critic(批評役LLM)による出力検証は、入力フィルタリング単独と比較して検出精度を21%向上させます(HackAPromptデータセットの60万件以上の敵対的プロンプトに基づく)。しかし、最も重要なのは構造的な統制です:アーキテクチャレベルで信頼できないコンテンツと特権的指示を分離すること、ツール呼び出しインターフェースに最小特権の原則を適用すること、影響の大きい操作には人間の承認を義務付けること、そして取得文書がシステムレベルの指示を上書きできないように検索パイプラインを設計することです。特にエージェント型システムでは、エージェント間の信頼境界を前提とするのではなく、明示的に設定・強制しなければなりません。私たちはフィルタリングを外付けするのではなく、こうしたアーキテクチャ上の統制をシステム内部に組み込みます。
Hugging Faceのオープンソースモデルを使用する場合、AIモデルのサプライチェーンをどのように保護すべきですか?
まず、Hugging Faceは公開レジストリであり、審査済みのサプライチェーンではないと認識することから始めてください。JFrogはコード実行ペイロードが埋め込まれた約100件の悪意あるモデルを発見しました。Palo Alto Unit 42は、削除されたネームスペースが攻撃者によって再登録可能であることを示しました。悪意あるLoRAアダプタは、整合性検証を行わなければ正当なファインチューニングと区別がつきません。実践的な防御には4つのレイヤーがあります。第1に、本番環境でpickle形式のモデルを決してロードしないことです。設計上実行不可能なsafetensors形式を必須とします。第2に、モデルの出所を検証することです。コミット履歴、コントリビューターの評価、および既知の正常ベースラインに対する重みのチェックサムを確認します。第3に、CycloneDXまたはSPDX 3.0.1を使用してML-BOM(機械学習部品表)を作成し、すべてのモデルコンポーネントの出所、バージョン、依存関係を追跡することです。第4に、CI/CDパイプラインに入る前のすべてのモデル更新に対して自動スキャンを実行し、アップストリームリポジトリのネームスペース変更や予期せぬ重みの改ざんを監視することです。私たちはこの検証パイプラインを、独立した手動プロセスではなく、MLOpsワークフローの統合部分として構築します。
2026年8月に発効するEU AI法の高リスクAIシステム向けセキュリティ要件とはどのようなものですか?
EU AI法の高リスク要件(2026年8月2日施行)は、敵対的攻撃に対する堅牢性、トレーニングデータセットのデータガバナンス、AIシステムの設計およびテストに関する技術文書、人的監視メカニズム、システムライフサイクル全体を通じた精度・信頼性の監視など、特定のセキュリティ統制を義務付けています。最も重大な違反に対する罰則は、最大でEUR 35 millionまたは全世界年間売上高の7%に達します。実践上の課題は、同法の要件が規範的(具体的)ではなく原則ベースである点です。「適切なレベルの堅牢性」という文言は、どの敵対的テストを実行すべきかを教えてくれません。当社は同法の要件を具体的な技術的統制に対応付けます:MITRE ATLASに準拠した敵対的テストプロトコル、同法の透明性要件を満たすサプライチェーン整合性チェック、規制当局が求めるコンプライアンス証拠を生成する監視システム、そして規制要件から実装された統制までを追跡する文書化です。これを単なるチェックボックス式の事務作業として扱う組織は、同法の法執行メカニズムがガバナンスの書類を透過して実際の技術的実装まで精査するように設計されていることを思い知ることになるでしょう。
組織全体におけるシャドーAIの利用状況をどのように可視化すべきですか?
シャドーAIは現在、最大の運用上のAIリスクとなっています。調査によると、69%の組織が従業員による未承認の生成AIツールの利用を疑っており、平均的な企業では機密データがAIアプリケーションに送信されるインシデントが月間223件発生しています。シャドーAIに起因するデータ侵害の平均損害額は$4.63 millionであり、通常の侵害を大幅に上回ります。AIツールの禁止は機能しません。従業員が禁止令を回避することは研究により一貫して示されています。SANS Instituteの「Sunlight AI」アプローチがより正解に近いと言えます:禁止しようとするのではなく、シャドー利用を可視化することです。技術的には、AI APIトラフィックに対するネットワークレベルの検知の配備、適切なデータ分類管理を備えた承認済みツールカタログの構築、AIサービスエンドポイントに特化したDLP(データ損失防止)ルールの適用、そして従業員に認可されたAI導入経路を提供する利用ポリシーの策定を意味します。当社は技術的な監視レイヤーを構築し、既存のSIEM/SOARスタックと統合することで、SOCが日常的に監視している同一のダッシュボード上にAI利用状況が表示されるようにします。
エージェントがツールを呼び出し自律的な決定を下すエージェント型AIシステムは、どのようにセキュリティを確保すべきですか?
エージェント型AIは、単一モデルの導入環境には存在しないセキュリティ上の課題をもたらします。制御された実験では、マルチエージェントシステムに対する攻撃成功率は84%に達し、単一エージェントアーキテクチャの約50%を大きく上回っています。本質的な問題は信頼の伝播です:エージェントAがエージェントBの出力を信頼してツール呼び出しを行う場合、エージェントBの入力が侵害されると(例えば取得文書内の間接的プロンプトインジェクションなど)、その侵害はエージェントネットワーク全体に連鎖します。MITRE ATLAS v5.4.0では、ポイズニングされたツールの公開やホストへのエスケープなど、エージェント特有の手法がカタログ化されています。アーキテクチャによる防御には、エージェント間の明示的な信頼境界、すべてのツール呼び出しインターフェースにおける最小特権の原則(読み取り権限のみを必要とするエージェントに書き込み権限を与えてはならない)、エージェント間のハンドオフごとの入力サニタイズ、そして現実世界に影響を及ぼす操作に対するHuman-in-the-Loop(人間の関与)ゲートが必要です。当社は特定の各エージェント型導入環境に合わせてこれらの信頼アーキテクチャを設計します。適切な境界の配置は、各エージェントの役割、呼び出し可能なツール、および処理するデータによって異なるからです。
AIセキュリティフレームワークとしてMITRE ATLASとOWASP LLM Top 10のどちらを採用すべきですか?
双方を活用すべきです。両者は目的が異なり、相互に補完し合う関係にあります。OWASP LLM Top 10 v2.0(2025年版)は、LLMアプリケーションにおける優先順位付けされたリスクリストです:プロンプトインジェクション、機密情報の漏洩、サプライチェーンの脆弱性、過剰なエージェンシー、システムプロンプトの漏洩、ベクトル/埋め込みの弱点など、まず何を懸念すべきかを教えてくれます。一方、MITRE ATLASは16の戦術、84の手法、56のサブ手法からなる敵対的脅威タクソノミであり、攻撃者が実際にMLシステムをどのように侵害するかを示します。ATLASは攻撃チェーンをマッピングし、OWASPはリスクに優先順位を付けます。実務において、当社はアセスメントの対象範囲を決定するためにOWASPを用い、各リスク領域をどのようにテストするかを構造化するためにMITRE ATLASを用います。AIセキュリティプログラムを構築する組織にとって、NIST AI 600-1(AI RMFの生成AIプロファイル)は、両フレームワークを組織のリスク管理に結びつけるガバナンスの枠組みを提供します。この3つを組み合わせることで、リスクの優先順位付け(OWASP)、攻撃シミュレーション手法(ATLAS)、およびガバナンス構造(NIST)が揃います。
確かな信頼のもとに、AIを構築する。
次世代のエンタープライズAI構築において豊富な経験を持つチームと、ぜひご一緒ください。信頼できるAI戦略の設計・構築・導入を、私たちがお手伝いします。
Veriprajna ディープテック・コンサルティング は、ヘルスケア・金融・規制対応分野における安全性重視のAIシステム構築を専門としています。当社のアーキテクチャは確立されたプロトコルに照らして検証され、包括的なコンプライアンス文書を備えています。