お客様のAIアプリケーションは、わずか1回の不正な出力で訴訟に発展するリスクを孕んでいます。エア・カナダのチャットボットは社内規定に反する忌引運賃の払い戻しを約束し、カナダの裁判所は航空会社の法的責任を認めました。シボレー販売店のチャットボットは、プロンプトインジェクション攻撃を受け、タホを1ドルで販売することに同意しました。DPDの配送ボットはジェイルブレイク(脱獄)されて暴言を吐くようになり、24時間で800,000回の閲覧数を記録しました。
これらは仮定の話ではありません。適切な安全レイヤーを備えずにAIをリリースした企業で実際に発生した本番環境のインシデントです。「デモで動く」と「本番環境で安全である」の間のギャップこそが、大半のAI導入が頓挫する原因であり、私たちの安全インフラストラクチャが解消するために設計されているギャップです。
本番環境のガードレールが実際にどのような構造を持つか
本番向けガードレールスタックは単一のツールではありません。他の層が見落としたものを各層が捕捉し、単一レイヤーの障害がシステム全体を破綻させることのない階層型アーキテクチャです。私たちのアプローチは、これらのスタックを5つの独立した層から設計・構築することです。
入力スクリーニング
プロンプトインジェクション検知には、正規表現ではなくファインチューニングされた分類器を使用します。最高のオープンソース検知器でもF1スコアは約0.91にとどまりますが、本番グレードの検知には新たな攻撃パターンに対する継続的な再学習が不可欠です。私たちはハイブリッド検知を展開します。信頼できない入力に対しては高速分類器が高スループットのスキャンを処理し、判断が不確実なケースは推論ベースのLLMバックストップにルーティングされます。カナリートークン監視により、両方の層をすり抜けたインジェクション試行を捕捉します(詳細は 敵対的AI防御に関する当社の研究を参照)。
コンテンツ分類
安全性分類器は、設定可能なタクソノミに基づいて入力と出力を評価します。Llama Guard 3、ShieldGemma、Qwen3Guardは、それぞれ異なる精度プロファイルで異なるリスクカテゴリーをカバーしています。2025〜2026年のベンチマークから得られた重要な知見として: Llama Guardは無害な入力に対して97〜99%の精度を達成するものの、敵対的コンテンツはわずか4.5〜21.8%しか検知できません。
総合で最高の性能を示したQwen3Guard-8B(85.3%)であっても、公開データセットに由来しない未知のプロンプトに対しては33.8%まで低下します。既製の分類器はベースラインにすぎず、完全な防御にはなり得ません。私たちは、お客様固有の脅威モデルに基づいてこれらを選定、統合、拡張します。
ポリシー適用
ランタイムルールは、AIが発言、確約、あるいは実行できる内容を制約します。これこそがエア・カナダとシボレーの失敗が生じた領域です。モデルは契約上の確約や価格決定を含むあらゆる出力を生成可能であり、生成とユーザーの間には何も介在していませんでした。
私たちのアプローチでは、出力がダウンストリームの利用者に届く前に、すべての出力をビジネスルールに照らして評価するように設計された決定論的ポリシーエンジンを実装します(詳細は 確率的モデルを決定論的アーキテクチャでラップすることに関する当社の技術ホワイトペーパーを参照)。価格の確約、法的文言、認可スコープ、データ開示境界は、プロンプトの指示ではなく、それぞれ機械的に評価可能なルールとして定義されます。
出力バリデーション
このレイヤーは、PII(個人を特定できる情報)の墨消し(秘匿化)、有害性フィルタリング、事実の一貫性チェック、ドメイン固有の制約検証をカバーします。PII検知は階層化が重要である理由を如実に示しています。正規表現ベースの検知は約65%の再現率にとどまり、機密データの最大35%を漏洩させます。NER(固有表現認識)ベースの検知は標準的なエンティティに対して94〜96%のF1スコアを達成しますが、新規のフォーマットや敵対的な難読化には対処できません。
私たちは、構造化パターン(クレジットカード番号、SSN、電話番号)を処理する正規表現と、コンテキスト依存のエンティティ(氏名、住所、自由形式の識別子)を捕捉するMLモデルの双方を実行し、お客様の誤検知許容度に合わせてキャリブレーションします。
エージェント型AIの安全性
ツールを使用したり、コードを実行したり、APIを呼び出したりするAIシステムにおいて、出力フィルタリングだけでは不十分です。ガードレールは実行後ではなく、実行前に介入しなければなりません。私たちのアプローチは、何らかのアクションがトリガーされる前に、ツール呼び出し、パラメータ値、実行計画を検査するよう設計された計画段階のバリデーションを構築することです(詳細は エンタープライズAI法的責任ガードレールの実稼働デモを参照)。リスク階層化承認により、低リスクのアクションは自動的に通過し、中リスクのアクションはロギング用にフラグ付けされ、データベース書き込み、金融取引、外部通信などの高リスクな操作には人間による承認が義務付けられます。
誰も語らない誤検知(偽陽性)問題
安全性分類器を重ねることは、数学的な計算をするまでは優れたエンジニアリングのように思えます。仮に各ガードが90%の精度を達成しており、それらを5つ実行した場合、所定のリクエストに対して5つすべてが正解である確率は59%まで低下します。これは、正当なリクエストの41%が誤ってフラグ付けされることを意味します。ユーザーはシステムを信頼しなくなり、サポートチームはエスカレーションに忙殺され、安全性への投資はUX上の負債へと変貌します。
私たちのアプローチは、力任せの積み重ねではなく、階層型アーキテクチャを通じてこれを解決します。高速なルールベースチェック(マイクロ秒単位のレイテンシ)が明白な違反を処理します。ML分類器(50〜200ms)がニュアンスを含むコンテンツを処理します。LLM-as-a-judge(秒単位)は、より安価なレイヤーでは解決できない曖昧なエッジケースのみを処理します。
各レイヤーにはキャリブレーションされた信頼度閾値が設定されており、前のレイヤーの信頼度がその閾値を下回った場合にのみ、リクエストはより高コストなレイヤーへとエスカレーションされます。この設計により、真正な脅威に対する高い検知率を維持しながら、リクエストの90%以上においてガードレール全体のオーバーヘッドを200ms未満に抑えます。
既製のガードレールが必要条件であっても十分条件ではない理由
ガードレール市場は、オープンソースフレームワーク、マネージドプラットフォーム、クラウドプロバイダーの機能へと細分化されています。それぞれがパズルのピースの1つを解決しますが、エンドツーエンドで解決できるものは存在しません。
| ツール | 提供機能 |
|---|---|
| Guardrails AI | 50以上の事前構築済みチェックを備えた構成可能なバリデータ。 |
| NeMo Guardrails | Colangベースの対話ポリシー管理。 |
| AWS Bedrock Guardrails | 複数のモデルプロバイダーに対応し、PII墨消しおよび自動推論チェックを提供。 |
| Lakera Guard | 100以上の言語に対応した50ms未満のプロンプトインジェクション検知。 |
2026年の本番運用チームでは、同一システム内で会話管理にNeMo Guardrailsを、出力バリデーションにGuardrails AIを実行するのが一般的です。その統合はカスタム開発となります。クラウドプロバイダーは強力なベースラインのカバレッジを提供しますが、ドメイン固有のポリシーに対するカスタマイズ性には限界があります。
フロンティアモデル全体で単純な画像変換を通じて攻撃が75〜82%の成功率を達成しているにもかかわらず、マルチモーダルガードレール(画像、音声、動画の入力)のツール環境はほとんど整備されていません。プラットフォームが提供するものと本番環境の安全性が要求するものの間にあるギャップこそ、私たちが取り組む支援内容です。
現実味を帯びる規制圧力と、未整備の標準規格
EU AI法の高リスク規制条項は、 2026年8月2日に完全施行されます。CEN/CENELEC JTC 21は高リスクAIシステムにおける「適切なリスク緩和」の意味を定義する整合技術規格を策定中ですが、当初の2025年8月の期限に間に合わず、現在は2026年第4四半期を目標としています。コンプライアンスの判断基準となる規格は、いまだ存在していません。
NIST AI RMF 1.0および生成AIプロファイル(AI-600-1)は、コンテンツフィルターを含むガードレールを想定される管理策として規定しています。OWASPのLLMアプリケーション向けTop 10(2025年版)には、システムプロンプトの漏洩とベクトル/埋め込みの脆弱性が新たなカテゴリーとして追加され、大半のエンタープライズセキュリティチームがいまだ対策を講じていない脅威を反映しています。
安全アーキテクチャの構築にあたって最終的な規格を待つ組織は、猶予期間のないまま期限に追われることになります。私たちは、現行の規制枠組みに対して抗弁可能であり、ドラフト段階にある規格にも適応可能なガードレールアーキテクチャを設計します(詳細は エンタープライズAIエージェント向け法的責任ファイアウォールに関する当社の研究を参照)。
私たちの提供内容
すべてのプロジェクトは、貴社のアプリケーション、データ、規制上のエクスポージャーに特化した脅威モデルから始まります。私たちはプラットフォームを販売するわけではありません。私たちのアプローチは、貴社のレイテンシバジェット、誤検知許容度、コンプライアンス要件に合わせて、ベストオブブリードのツール(オープンソースおよびマネージド)を一貫したスタックへと統合するよう設計されたガードレールアーキテクチャを構築することです。
支援内容には以下が含まれます:
- レイヤーごとに測定されたレイテンシバジェットを備えた階層型ガードレールアーキテクチャ。
- ハイブリッド検知(分類器+LLMバックストップ+カナリー監視)によるプロンプトインジェクション防御。
- 貴社のエンティティタイプと誤検知許容度に合わせてキャリブレーションされたPII墨消しパイプライン。
- 一般的なテンプレートではなく、貴社のビジネス上の制約から導出されたポリシー適用ルール。
- ツール使用、コード実行、API呼び出しのためのエージェント型AI安全管理策。
- 最新の攻撃手法(PAIR、GCG、間接的インジェクション、マルチモーダルインジェクション)を用いて各レイヤーの回避を試みる敵対的テストスイート。
- ドリフト検知、分類器の劣化アラート、インシデントトリガーによる再学習パイプラインを備えたガードレール可観測性。
- EU AI法、NIST AI RMF、OWASP LLM Top 10の管理策への規制マッピング。
私たちはまた、率直な評価も提供します。すなわち、既存のプラットフォームガードレールですでにカバーされているリスク、カスタム開発が必要なギャップ、そして上に安全レイヤーを重ねるのではなく、上流のアーキテクチャ変更(データガバナンス、モデル選定、アクセス制御)によってより適切に対処できる脅威を明確にします。
セーフティガードレール&バリデーションレイヤー
 視聴
AIプライシングコンプライアンス & アルゴリズムの公平性 | Veriprajna
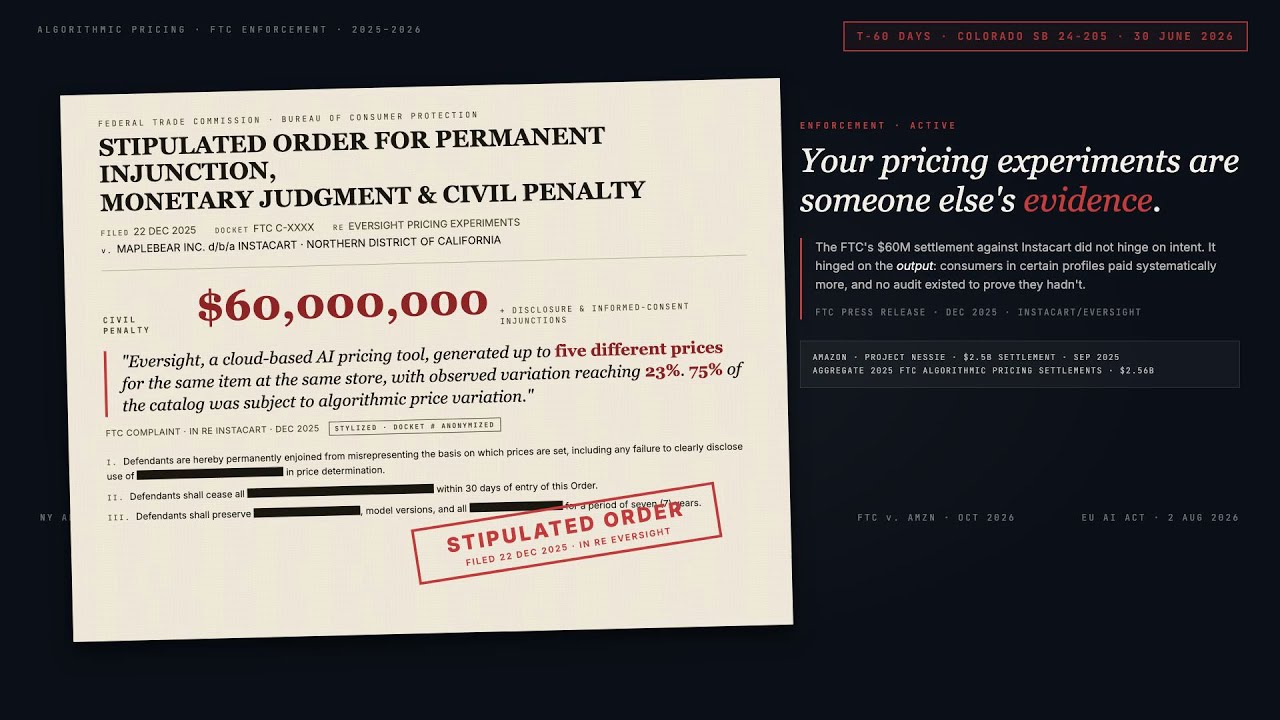
2025年、FTCは2社からアルゴリズム的プライシングに関する和解金として25億6,000万ドルを徴収しました。ニューヨーク州、カリフォルニア州、コロラド州は、あらゆるAI主導の価格を潜在的な違反となり得るものにする法律を制定しました。
 視聴
AI検証 & アンチAIウォッシング・コンプライアンス | Veriprajna
規制当局に問われる前に、あなたのAIの主張を実証する。VeriprajnaはSEC、FTC、州司法長官のコンプライアンス向けに、AI検証アーキテクチャ、AIBOMシステム、主張の実証パッケージを構築します。
 視聴
エンタープライズAIの法的責任とガードレール | Veriprajna
2023年12月、あるチャットボットが76,000ドルのシボレー・タホを1ドルで売ることに同意しました。2024年1月、ある配送チャットボットが自社を無用だと評する詩を書きました。2024年2月、ある遺族向けチャットボットが存在しない払い戻し期間を捏造し、審判所はその航空会社に責任があると判断しました。


よくあるご質問
AIガードレールの実装にはどのくらいのコストがかかり、何が予算の主な要因になりますか?
コストは3つの変数によって決まります。必要なレイヤーの数、許容されるレイテンシバジェット、そしてポリシーがどの程度ドメイン固有であるかです。オープンソースの分類器(Llama Guard、Guardrails AIバリデータ)とクラウドプロバイダーのガードレール(Bedrock、Azure)を組み合わせた基本スタックは実装コストを抑えられますが、継続的なチューニングが必要です。カスタムのプロンプトインジェクション分類器、ドメイン固有のポリシーエンジン、エージェント型安全管理策には、より高度なエンジニアリングが必要となります。AI固有のセキュリティ管理策を導入している組織は侵害コストを平均210万ドル削減しており、ガードレールの導入を見送ることは、構築するよりも常に高くつきます。私たちはプラットフォーム利用料ではなく、お客様の実際の脅威モデルに基づいて支援範囲を策定します。
複数の安全性分類器を重ねる際、誤検知(偽陽性)を削減するにはどうすればよいですか?
精度の複合問題は現実の課題です。精度90%の分類器が5つある場合、正当なリクエストの59%しか5つすべてをクリーンに通過できません。解決策は分類器を増やすことではなく、階層型アーキテクチャの導入です。私たちは、高速なルールベースチェック(マイクロ秒単位のレイテンシ)が明白な違反を処理し、ML分類器(50〜200ms)がニュアンスを含むコンテンツを処理し、LLM-as-a-judge(秒単位)がより安価なレイヤーでは解決できない曖昧なケースのみを処理する階層型スタックを設計します。各レイヤーにはキャリブレーションされた信頼度閾値が設定されているため、リクエストは必要な場合にのみエスカレーションされます。これにより、検知品質を維持しながら、トラフィックの90%以上で総オーバーヘッドを200ms未満に抑えます。
NeMo Guardrails vs Guardrails AI vs Llama Guard:本番環境ではどれを使用すべきですか?
これらは異なる課題を解決するものであり、併用されることが多くあります。NeMo GuardrailsはColangポリシーを使用して5つのパイプラインステージ全体で会話フローを管理します(レイテンシは100〜300ms、NVIDIAインフラ上ではさらに低下)。Guardrails AIは50以上の事前構築済みチェックを備えた構成可能な出力バリデータを提供します(バリデーションあたり50〜200ms)。Llama Guardはコンテンツモデレーション用の安全性分類器です(総合精度において、1Bモデルが59.9%対48.4%で実際に8Bモデルを上回ります)。2026年の本番運用チームでは、同一システム内で対話管理にNeMoを、出力バリデーションにGuardrails AIを実行し、Llama GuardやShieldGemmaでコンテンツ分類を処理するのが一般的です。私たちは、お客様のレイテンシバジェットと脅威サーフェスに基づいて統合アーキテクチャを設計します。
ツールを使用しAPIを呼び出すAIエージェントにはどのようなガードレールが必要ですか?
エージェント型システムにおいて、出力フィルタリングだけでは不十分です。AIエージェントがコードを実行し、APIを呼び出し、データベースに書き込み、または通信を送信できる場合、ガードレールは実行前、すなわち計画段階で介入しなければなりません。私たちは、何らかのアクションがトリガーされる前に、すべての関数呼び出し、パラメータ値、実行計画を検査するツール使用バリデーションを構築します。これには、パラメータの型チェック(エージェントがパラメータ名を捏造したり不正なデータ型を渡したりする問題への対策)、スコープ適用(エージェントは明示的に許可されたツールにのみアクセスすべきであることの徹底)、およびリスク階層化承認ルーティングが含まれます。低リスクのアクションは自動的に進行し、中リスクは記録・フラグ付けされ、高リスクの操作(金融取引、データベース変更、外部通信)には人間による承認が義務付けられます。
本番環境におけるプロンプトインジェクション攻撃をどのように防ぐべきですか?
あらゆるプロンプトインジェクションを阻止できる単一の技術は存在しません。最善の本番向け防御は階層化されています。高速なファインチューニング済み分類器(ドメイン固有の検知器でF1約0.91)が、信頼できないすべての入力を高スループットでスクリーニングします。不確実なケースは、より詳細な分析のために推論ベースのLLMへとルーティングされます。プロンプトに埋め込まれたカナリートークンは抽出の試行を検知します。パープレキシティに基づく異常スコアリングは、敵対的なトークンシーケンスを捕捉します。間接的インジェクション(取得されたドキュメント、画像、PDF内の隠し指示)に対しては、モデルのコンテキストに到達する前にコンテンツが個別にスキャンされます。プロンプトインジェクションがOWASPのLLMリスク第1位であり続けるのには正当な理由があり、適切な防御のない商用モデルに対して自動攻撃は80〜94%の成功率を達成するため、防御は継続的に進化しなければなりません。
EU AI法コンプライアンスにはどのようなAI安全ガードレールが求められますか?
EU AI法の高リスク規制条項は2026年8月2日に完全施行されますが、「適切なリスク緩和」を定義する整合技術規格(CEN/CENELEC JTC 21が策定中)は当初の期限に間に合わず、現在は2026年第4四半期を目標としています。同法は、高リスクAIに対して文書化された緩和措置を備えたリスク管理システムを義務付けています。NIST AI RMFおよびその生成AIプロファイル(AI-600-1)は、コンテンツフィルターを含むガードレールを規定しています。OWASPの2025年LLM Top 10では、システムプロンプトの漏洩とベクトル埋め込みの脆弱性が新たな脅威カテゴリーとして追加されました。私たちは、現行の枠組みの下で抗弁可能であり、現在策定中の規格にも適応可能なガードレールアーキテクチャを設計します。違反には最大3,500万ユーロまたは全世界年間売上高の7%の制裁金が科されます。
本番環境でガードレールが実際に機能しているかどうかをどのように監視すべきですか?
安全性分類器は静かに劣化します。2025〜2026年のベンチマークで最高の性能を示したモデル(総合85.3%のQwen3Guard-8B)であっても、学習データの分布に含まれない未知のプロンプトに対しては精度が33.8%まで低下します。監視がなければ、これがいつ発生したのかを知ることはできません。私たちは、検知率、誤検知率、レイヤーごとのレイテンシ、分類器の信頼度分布の経時変化を追跡するガードレール可観測性を構築します。入力分布が分類器の学習対象から乖離した際にはドリフト検知がアラートを発行します。インシデントトリガーによる再学習パイプラインは、新たな攻撃パターンが特定された際に分類器を更新します。これは単なるダッシュボードではありません。脅威の進化に合わせてガードレールの有効性を維持するための運用インフラストラクチャです。
モデルレベルの安全性(RLHF、Constitutional AI)だけで十分ですか、それともランタイムガードレールも必要ですか?
モデルレベルの安全性は必要ですが、それ単体では不十分であることが実証されています。RLHFやConstitutional AI(憲法AI)が生み出すのは行動上の選好であり、アーキテクチャ上の制約ではありません。OWASPの2025年ガイダンスは明快です。LLMは決定論的ではなく確率論的であり、監査可能なセキュリティ境界として機能することが本質的に不可能であるため、システムプロンプトはセキュリティ管理策ではありません。自動化されたジェイルブレイク攻撃は、行動的アライメントと構造的強制の間のギャップを突くことで、商用モデルに対して80〜94%の成功率を達成しています。ランタイムガードレールは、モデルの生成プロセスの外部にある決定論的コード内で動作するため、監査可能で、テスト可能であり、モデルの挙動から独立しています。有害な出力の基準頻度を下げるモデルレベルの安全性と、モデルのアライメントが見落としたものを捕捉するランタイムガードレールの双方が必要です。
確かな信頼のもとに、AIを構築する。
次世代のエンタープライズAI構築において豊富な経験を持つチームと、ぜひご一緒ください。信頼できるAI戦略の設計・構築・導入を、私たちがお手伝いします。
Veriprajna ディープテック・コンサルティング は、ヘルスケア・金融・規制対応分野における安全性重視のAIシステム構築を専門としています。当社のアーキテクチャは確立されたプロトコルに照らして検証され、包括的なコンプライアンス文書を備えています。