ナレッジグラフによってエンタープライズ採用における公平性・説明可能性・精度を設計する
HRテクノロジーの「ムーブ・ファスト・アンド・ブレイク・シングス」の時代は終わりました。女性に対する差別を学習したAmazonのAI採用ツールの失敗は異常事態ではなく、 数学的必然 ——偏ったデータで訓練された統計的相関エンジンの帰結でした。
Veriprajnaの説明可能なナレッジグラフアーキテクチャは成功を予測するのではなく、 スキル距離を測定します。これにより、人材評価を人口統計的バイアスから切り離しながら、NYC Local Law 144、EU AI法、GDPRのコンプライアンス要件を満たします。
Veriprajnaは、フォーチュン500企業、採用プラットフォーム、HRテクノロジープロバイダーと協働し、公平で透明かつコンプライアンス準拠の人材評価システムを設計しています。
「Amazonモーメント」を排除します。当社のアーキテクチャは人口統計データと意思決定ロジックを物理的に分離します。性別/人種のノードが推論エンジン内に存在しなければ、バイアスを誤って学習することはあり得ません。
EU AI法は採用AIを「高リスク」に分類します。当社のガラスボックスは、決定論的なグラフ走査アルゴリズムによって第13条の透明性および第14条の人間による監視の要件を満たします。
候補者が「SQL」ではなく「Pandas DataFrames」を使っていたというだけで、有能な人材を不合格にするのはやめましょう。グラフベースの意味的マッチングは、キーワード型ATSが完全に見逃す移転可能なスキルを明らかにします。
ナレッジグラフが必要な理由を理解するには、従来の統計的AIが採用領域でなぜ壊滅的に失敗するのかをまず解剖しなければなりません。
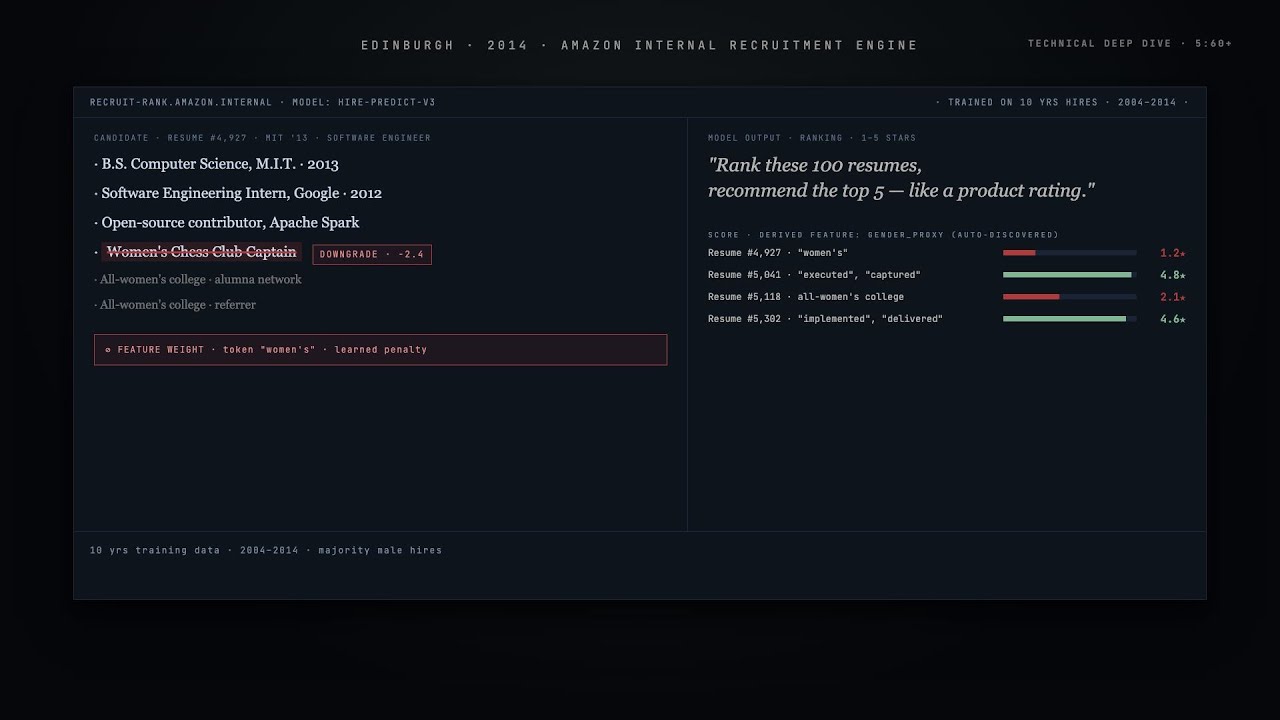
Amazonの2014年のエディンバラチームは、10年分の履歴書でモデルを訓練しました。テック業界は男性が支配的だったため、「採用に成功した」人の大多数は男性でした。
AIは単にバイアスを複製するのではなく、増幅します。男性が労働力の60%であれば、過去の傾向に対する精度を最大化するため、モデルはしばしば80〜90%の男性採用へと最適化されます。
このシステムは、「women's」という語を含む履歴書(例:「Women's Chess Club Captain」)を組織的に低く評価し、女子大学の卒業生を格下げしました。Amazonが3年後にツールを廃止したのは、ブラックボックスゆえに、 予測能力を破壊することなくバイアスを外科的に除去できなかったからです。
深層学習は 相関であって因果ではないものに基づいて動作します。モデルは、データサイエンスにとって「Python」がなぜ重要なのかを理解しておらず、成功した履歴書に「Python」という文字列が含まれていたことだけを知っています。
精度を上げるために技術者は複雑さ(より多くの層、何十億ものパラメータ)を追加します——その結果、モデルはかえって解釈しにくくなります。ところが規制はシンプルな説明を要求します。
現代のベンダーはGPT/Claudeを「ブラックボックス」として使います。これにより新たな失敗モードが持ち込まれます。ハルシネーション(存在しないスキルの創出)、確率的挙動(同じ履歴書で異なる結果)、そして知識のカットオフです。
従来型の「ブラックボックス」AIは、説明ゼロでスコアだけを返します。Veriprajnaの「ガラスボックス」ナレッジグラフは、 どのスキルが一致し、どれが欠けているか、そして両者間の意味的距離を正確に示します。
採用担当者には見通しがなく、候補者には申し立ての手段がなく、監査人には公平性を検証する方法がありません。
採用担当者は判断を理解し、候補者は実行可能なフィードバックを受け取り、監査証跡は完全です。
世界各国の政府が、不透明なアルゴリズムによる意思決定に対する防壁を築いています。説明可能なAIはもはや選択肢ではなく、法的要件です。
2023年7月から、NYCは自動雇用意思決定ツール(AEDT)に対する独立したバイアス監査を義務付けています。
世界初の包括的なAI法は、採用AI(求人広告、フィルタリング、評価)を高リスクに明示的に分類します。
一般データ保護規則(GDPR)は、自動化された意思決定に関して個人に明示的な権利を与えています。
ブラックボックスモデルが黒人男性に対して0.4のインパクト比率を示した場合、雇用主は手詰まりになります。説明可能性がなければ、モデルが彼らを不合格にする理由を特定できないのです——大学名?郵便番号?方言?
Veriprajnaのアプローチなら、格差が見つかった場合に、その原因となっている特定のグラフノード(例:低所得の候補者をふるい落とす高額な資格要件)を特定して調整できます。
当社の「ガラスボックス」アーキテクチャの中核はエンタープライズ・ナレッジグラフ(EKG)です。スキル、ロール、関係性を構造化して表現し、決定論的で監査可能な、バイアスのないマッチングを可能にします。
ナレッジグラフとは、現実世界の事実を構造化して表現したものであり、 ノード (エンティティ)と エッジ (リレーションシップ)のネットワークとしてモデル化されます。リレーショナルデータベース(硬直した行と列)とは異なり、グラフは人間の連想記憶を映し出す、柔軟で相互接続されたウェブとしてデータを格納します。
オントロジー(スキーマ)は、この世界に何が存在し、エンティティ同士がどう関係するかを定義します:
システムはキーワードだけでなく、リレーションシップを「知って」います:
試してみましょう: ノードをクリック&ドラッグして、スキル同士がどうつながっているかを探ってみてください。「Pandas」と「SQL」は異なる技術でありながら意味的に近い——どちらもデータ操作ツールだからです——ことに注目してください。
当社が大規模言語モデルを使用するのは 情報抽出(IE)と 固有表現認識(NER)のためのみであり、LLMは非構造化テキストを読んでエンティティを抽出します。採用の意思決定は一切行いません。
エンティティが抽出されると、ナレッジグラフに取り込まれます。マッチング、スコアリング、ランキングのすべては 決定論的なグラフ走査によって実行されます。
グラフアーキテクチャの最も強力な機能は サブグラフフィルタリングです。マッチングアルゴリズムは、人口統計ノードを明示的に除外した制限付きの「推論グラフ」上で動作します。
含まれるのは以下のみです:
マッチングエンジンには一切見えません:
当社のシステムでは、「Women's Chess Club」は抽出フェーズでLLMによって中性化されたノードへマッピングされます:
性別を示す修飾語は、推論エンジンに進入する 前に 剥ぎ取られます。バイアスは構造的に断ち切られます。
Veriprajnaは成功を「予測」しません。当社は スキル距離を測定し、採用を主観的概率から客観的幾何学へと移行させます。
従来のATSはブールロジックを使います:履歴書に「Java」は含まれているか?(はい/いいえ)。これは脆く、才能を見逃します。
当社は グラフ埋め込み (Node2Vec、GraphSAGE)を用いて連続的なベクトル空間を構築します:
候補者を求人に対して採点する際、ベクトル集合間のコサイン類似度を計算します:
意味的マッチングが、キーワード型システムが見逃す隠れた人材をどう発見するかをご覧ください
ブール型キーワードマッチング:「SQL」なし ❌ | 「Tableau」なし ❌ → 自動不採用
結果:偽陰性。用語の違いというだけで、有能な候補者がふるい落とされます。非伝統的な経歴へのバイアスはこうして生まれるのです。
透明な「カバレッジ」スコアを提供します。例:「候補者は必須要件の70%をカバー」。ベクトル類似度ほど精緻ではありませんが、監査において極めて解釈しやすい指標です。
不足しているスキルについて、グラフ位相内の最短経路を計算します:
EKGアーキテクチャの採用は、既存のATSプラットフォームとシームレスに統合しながら、採用ワークフローを変革します。
| コンポーネント | 役割 | 機能 | 信頼性 |
|---|---|---|---|
| ナレッジグラフ | ファクト | 明示的なリレーションシップ、階層、ルール(例:「Pythonは言語である」)を格納 | 高 (キュレーション済み、決定論的) |
| LLM | インターフェース | 自然言語入力を処理し、出力を合成(例:「ギャップを要約して」) | 可変 (グラフによる接地) |
| グラフアルゴリズム | ロジック | 実際のマッチング/スコアリング計算を実行 | 高 (監査対応可能) |
理由の記載はありません。 潜在的な隠れたバイアス:候補者は小規模な大学の出身(社会経済状況の代理変数)。不服申立ての手段はありません。
結果: 偽陰性を採用へと転換しました。人材プールを拡大し、非伝統的な経歴に対するバイアスを低減しました。
説明可能なナレッジグラフへの移行は、罰金の回避だけが目的ではありません——より優れた、より競争力のあるビジネスを築くことなのです。
Amazonの失敗は重大な評判の損失をもたらし、何年分ものエンジニアリングの時間を無駄にしました。人口統計データを意思決定ロジックから物理的に分離することで、Veriprajnaの顧客はバイアス増幅のリスクから自らを守ります。
従来のキーワードマッチング(ATS)は、異なる用語を使う有能な候補者を無視します。ブラックボックスAIは、品質の代理指標として「血統」(有名大学、大手企業)に過剰に依存しがちです。
採用担当者は「ブラックボックス」を嫌います。理由を説明せずに「この人を採用せよ」と言う機械は信頼できません。透明で視覚的、かつ説明可能な根拠を提供することで、Veriprajnaは採用担当マネージャーによる導入を促進します。
| 特徴 | レガシーATS (キーワードマッチ) |
「ブラックボックス」AI (深層学習) |
生成AIラッパー (LLM) |
Veriprajna EKG (グラフAI) |
|---|---|---|---|---|
| 中核ロジック | ブール型文字列マッチング | 統計的相関 | 確率的トークン生成 | 意味的グラフ走査 |
| バイアスメカニズム | キーワードバイアス(語彙) | バイアス増幅(代理変数) | 訓練コーパスのバイアス | 構造的マスキング |
| 説明可能性 | 高(欠落が明確) | ゼロ(ブラックボックス) | 低(ハルシネーションのリスク) | 高(経路追跡が可能) |
| 意思決定の一貫性 | 高 | 高 | 低(確率的) | 高(決定論的) |
| 規制適合性 | 良好 | 不良(第13条を満たさず) | 不良(監査に不合格) | 優秀(監査にネイティブ対応) |
| 同義語の扱い | 失敗(「React」 ≠ 「ReactJS」) | 良好 | 良好 | 完璧(エンティティ解決) |
| 新スキルの取り込み | 手動更新が必要 | モデルの再訓練が必要 | 知識のカットオフに制限 | 即時(ノード追加のみ) |
Amazonからの教訓は厳然としています: データは鏡である。 過去のデータでモデルを訓練すれば、過去を再現することになります。公平を追求する世界において、過去の再現は失敗条件です。
エンタープライズAIの未来は、より大きなモデルや、より不透明なニューラルネットワークにあるのではありません。鍵となるのは 構造、セマンティクス、そして説明可能性です。つまり、私たちの価値観をシステムのオントロジーそのものに刻み込むことなのです。
隠れたパターンに基づいて推測し、歴史的バイアスを増幅し、人生を左右する意思決定について一切の説明を提供しないブラックボックスモデル。
数学的精度でスキル距離を測定し、構造的なバイアスマスキングと完全な監査証跡を備えたガラスボックス・ナレッジグラフ。
Veriprajnaは前進への道を提示します。
当社が提供するのは、当てずっぽうを行う魔法の箱ではありません。提供するのは 測定するための精密機器です。 説明可能なナレッジグラフを活用することで、企業は人材の真の地形を地図化できます——歴史的偏見という歪んだ地図ではなく、スキルと潜在能力という星に導かれて航海するために。
Veriprajnaのナレッジグラフはサブグラフフィルタリングを使用して、氏名、性別、住所、卒業年月日、大学の所属といったすべての人口統計ノードを明示的に除外する、制限付きの「推論グラフ」を作成します。これらのノードは推論エンジン内に存在しないため、グラフの経路探索アルゴリズムは物理的にそれらをスコアリングに利用できません。これは、「gender」フィールドを削除しても、モデルが「Women's Chess Club」のような代理変数から性別を推測できてしまう統計的アプローチとは根本的に異なります。ナレッジグラフでは、性別を示す修飾語は抽出時に剥ぎ取られ、推論レイヤーに入る前に中性化されたノードへマッピングされます。
ナレッジグラフは、スキルを意味的リレーションシップで相互接続されたノードとして格納します。求人が「SQL」を要求しているのに候補者が「Pandas DataFrames」を持っている場合、グラフは両者を意味的距離わずか0.15のデータ操作ツールとして認識します——これは高い移転可能性を示します。同様に、「PowerBI」と「Tableau」は「ビジネスインテリジェンス」クラスタにおける意味的近傍として認識されます(距離: 0.09)。グラフ埋め込み(Node2Vec、GraphSAGE)に対するコサイン類似度を使用することで、候補者は関連スキルについて部分点を得られます。従来のATSは完全なキーワード一致がないという理由でこうした候補者を自動的に不合格にし、非伝統的な経歴に不釣り合いな影響を与える偽陰性を生み出します。
EU AI法は採用AIを「高リスク」に分類し、第13条の透明性(解釈可能な出力)と第14条の人間による監視(上書きする能力)を要求します。Veriprajnaの決定論的グラフ走査は、同一の入力に対して同一のスコアを生成し、完全な監査再現性を可能にします。すべての意思決定は、グラフノードを通る可視の経路(候補者 → スキル → 求人要件)をトレースします。NYC LL 144については、システムは4分の4ルールのしきい値(0.8)に対してリアルタイムのインパクト比率(各人口統計カテゴリーの選択率)を監視します。格差が検出された場合には、原因となっている特定のグラフノードを特定して調整できます——予測能力を破壊することなくバイアスを外科的に除去できないブラックボックスモデルとは異なります。
Veriprajnaのナレッジグラフアーキテクチャは、コンプライアンスのチェックボックスを埋めるだけのものではありません——構造的な設計によってバイアス問題を根本的に解決します。
EKGプラットフォームが既存のATSやHRシステムとどう統合されるかを探るための技術相談をお申し込みください。
完全な技術レポート:グラフオントロジー設計、ベクトル埋め込みの数学、GDPR/EU AI法コンプライアンスアーキテクチャ、人口統計マスキングアルゴリズム、包括的な参考文献。